
课程
使用 OpenAI API
3 小时
179.5K
想象一下,一个结账流程在购物车里显示 $48,但在审核页显示 $24。顾客在同一次结账中看到两个总计。
团队通常用浏览器脚本做质量保证(QA)测试:点这个按钮、打开那个页面、检查这个数值。脚本化测试只会检查作者写下的那些状态。
AI 代理是能够为实现目标而采取行动的模型。OpenAI 的 Agents API 管理代理循环并将其工作保存在会话中。在本教程中,电脑操作(Computer Use)还提供托管浏览器。
Northstar Checkout 是一个虚构的测试商店,暗藏小计错误。
代理会收到正确的结账结果,但不会得到错误所在的位置,也没有一串“该点哪些按钮”的清单。一个称为“harness(挂载程序/测试驱动器)”的小型 Python 程序会比较代理上报的值,然后要求在同一会话中测试已修复的商店。
本教程将介绍如何:
代码和测量基于 openai Python 包的 3.22.1 版本。
如果您只有一分钟,这里是关键结论。
computer_use_call 项。这只是一个植入单一错误的测试商店,并非可靠性基准。
电脑操作是 OpenAI Agents API 中的一种工具,使代理可以操作运行在 OpenAI 服务器上的浏览器。您的代码会跟随会话事件并回答其请求。OpenAI 将网站测试列为一种用途。
OpenAI 负责代理循环、会话及恢复机制。我们的OpenAI Agents API 教程涵盖这些基础。
更早的电脑操作方案(如我们的GPT-5.4 电脑操作教程)则由开发者代码来运行“截图—操作”的循环。
在浏览器端 QA 中,页面本身就是被测对象。
直接调用结账 API 会跳过 Northstar 的错误所在页面,因此代理要沿着顾客相同的路径前进:从产品页到购物车、结账,再到审核。
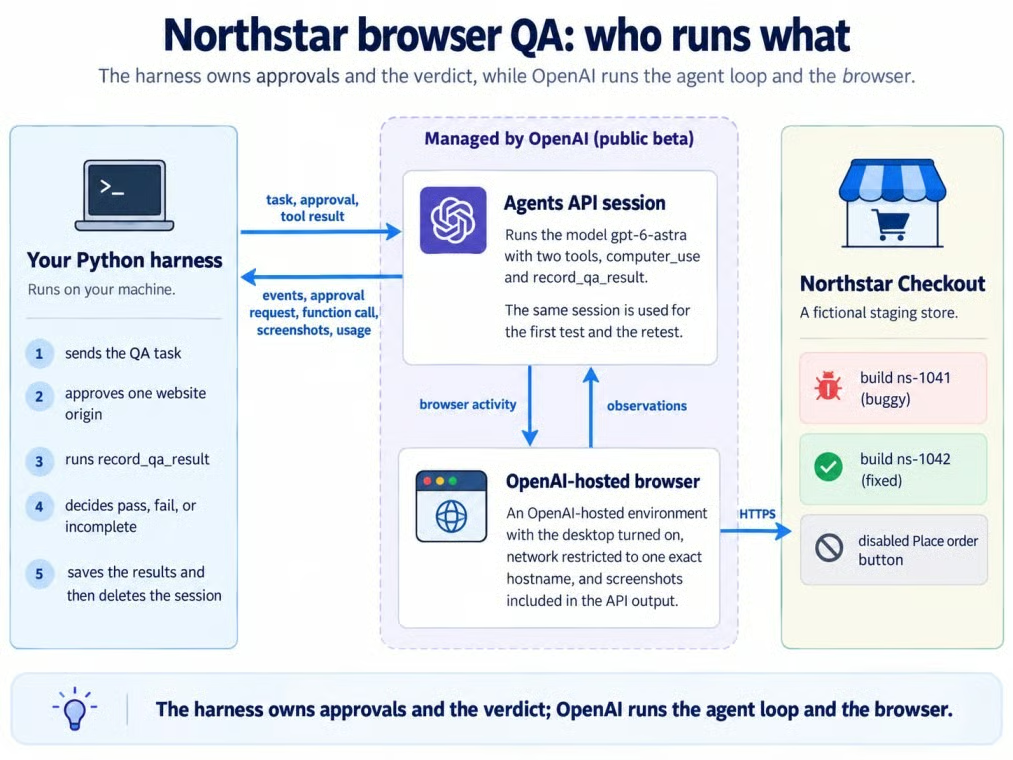
挂载程序、会话、托管浏览器、预发布站点。作者供图。
OpenAI 在灰色区域内管理会话与浏览器;挂载程序和 Northstar 位于其外部。
本项目包含一个虚构的预发布商店、一个 Python 挂载程序,以及一个 Agents API 会话。
完整代码见此 GitHub 仓库。
Northstar 只售 $24 的 Trail Bottle(一款水壶)。测试从产品页到购物车、结账、审核;无运费、税费、登录,也没有可用的购买按钮。
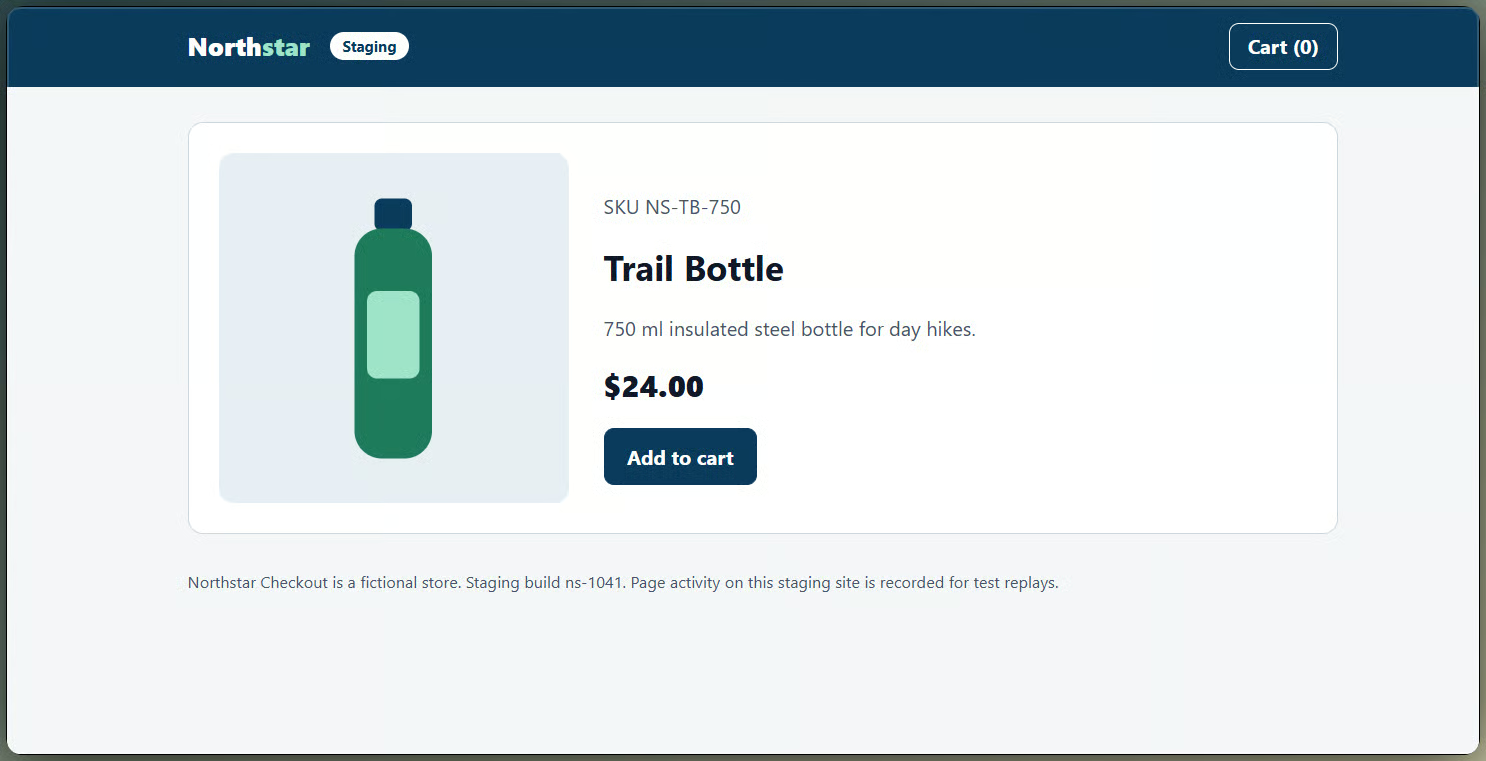
测试前的 Northstar 产品页。作者供图。
构建 ns-1041 含有错误,ns-1042 含有修复。在构建的起始 URL 后添加 ?reset=1 可在两次测试前清空购物车。
QA 请求以“目标”形式书写。其验收标准要求代理:
另有一条安全约束:不得下单、提交或支付。请求定义的是结果,而非点击步骤。
有缺陷的构建在审核页只对单价求和,忽略了数量。两页的数量都显示为 2,但购物车小计为 $48.00,审核页小计为 $24.00。
答案键保存在应用代码中。说明和任务消息均未提及该错误。
代理通过一个 函数工具 record_qa_result 上报构建 ID 和 4 个观测值。
挂载程序先检查上报的构建是否为被测构建(因二者共用主机名),再将数值与答案键比对。
只有当代理调用函数工具时它才会运行。缺少记录、缺少值或构建不符都会使结果为 incomplete,且永不计为通过。
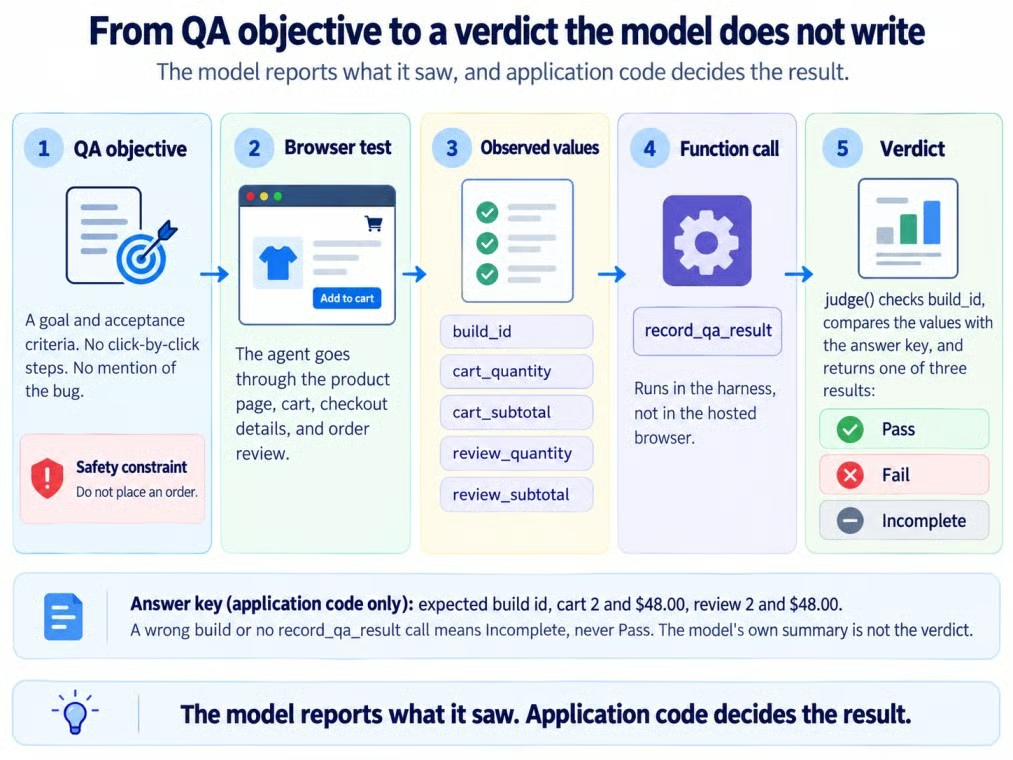
从 QA 目标到应用裁决。作者供图。
您需要 Python、带权限范围的 API 密钥、对 GPT-6 Astra 的访问权限,以及一个启用电脑操作的会话。
openai==3.22.1(SDK 会代您发送 OpenAI-Beta: agents=v1 头)api.agents.read、api.agents.write、api.responses.write 范围的 API 密钥,且所属项目可使用 gpt-6-astraAgents API 处于公开测试阶段,因此字段名与行为可能会在 SDK 版本之间变化。仓库在 requirements.txt 中固定为 3.22.1 版本。
托管浏览器需要可达 URL,示例代码使用了 Northstar 的 Vercel 部署。
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py关于隔离依赖的更多信息,请参见我们的虚拟环境指南。在 macOS 或 Linux 上,请使用 source .venv/bin/activate 激活,并使用 cp 复制文件。将密钥保存在 .env 中,不要写入代码。
本实验使用 GPT-6 Astra,即 OpenAI 电脑操作示例中的模型。我们的GPT-6 Astra 概览介绍了该模型。
代码使用 Agents API(client.beta.agents),而非 Agents SDK 或我们在GPT-6 Astra API 教程中使用的 Responses API computer 工具。
创建一个包含 computer_use 工具和 OpenAI 托管桌面的会话,然后在两次测试中复用:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True 会暴露 API 返回的任何截图,而受限网络访问会将浏览器限制在 Northstar。
环境使用默认的 medium 规格(2 vCPU、4 GB 内存)。
该函数记录代理所见。如果代理无法读取 4 个受检的数量或小计中的某一个,它必须将该字段上报为 null。
在 required 下列出每个属性,会指示模型回答所有字段,对未见到的内容使用 null。挂载程序仍会将缺少字段判为 incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
挂载程序将每个显示的价格转为美分、核验构建 ID,并将这些值与答案键比对:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
不可读或缺失的值会产生 incomplete 裁决,绝不会通过。
来源错误的报告会在其数值影响裁决之前就返回 incomplete。
同一组指令适用于两次测试:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
两次测试之间,只有网站构建发生变化。
打开事件流,发送一次 QA 目标,然后处理审批与函数调用,直到该回合结束。
先打开事件流,然后仅发送一次任务:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
流不会重放错过的事件。如果连接中断,请打开一个新流,然后在连接保持期间检索会话及其已保存的条目。
任务消息会指明构建、验收标准与安全约束,但不会提及错误:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
请保存会话 ID,以便复测。
托管浏览器在打开每个新的网站来源之前都会请求批准。
事件流会发出 agent.session.requires_action;检索会话并读取 required_actions 获取此请求。
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])浏览器工作会展示为 computer_use_call 项,每项带有简短标题和状态。第一次测试的事件流如下:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
约 47 秒后才出现首次浏览器活动。
全部 7 个 computer_use_call 项均已完成,但条目状态并非 QA 裁决;函数结果才是。
是的。更重要的是,函数调用将失败定位到一个字段:审核页小计。
record_qa_result 调用包含:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
每个值都与有缺陷页面一致。审核页的数量仍为 2,排除了可见的数量不一致。
judge() 确认构建为 ns-1041,将 4 个数值与期望值比对,发现只有审核页小计错误。
本实验只使用这一裁决:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}修复上线后,向同一会话再发送一条消息即可。
这是一项小型回归测试,沿用相同的指令与裁决函数。
构建 ns-1042 的修复仅为 Northstar 一行 JavaScript:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);起始链接包含 ?reset=1,因此复测从空购物车开始。随后将后续任务发送到同一会话:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
复测保留了托管环境,也无需新的来源审批。不要依赖浏览器状态,因为 Cookie 可能过期,且回收环境会清空状态。
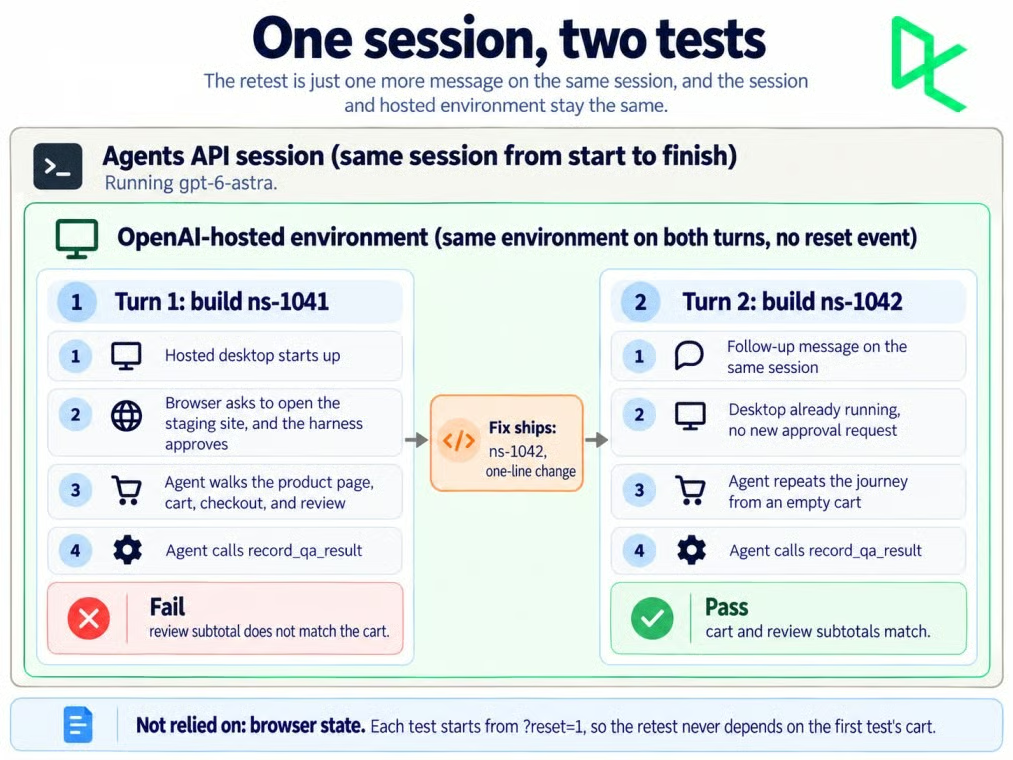
一个会话承载了两次 QA 测试。作者供图。
若 1 小时内无活动与保活,托管沙箱可能被删除。注意 agent.session.environment.reset,并让每次复测从已知状态开始。
是。复测报告购物车数量为 2、小计 $48.00,审核页数量为 2、小计 $48.00,judge() 返回通过,且无失败检查。
本次耗时 38.9 秒,共 5 个浏览器活动项;而第一次测试为 96.5 秒、7 个活动项,其中包含在浏览器活动开始前的 47 秒等待。
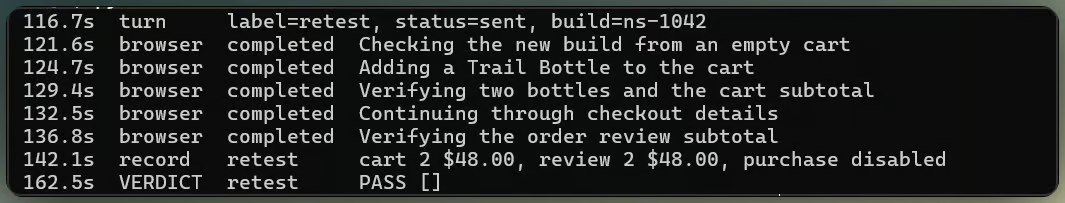
复测在无新审批的情况下通过。作者供图。
不一定。即便设置了 include_screenshots,第一次测试在 7 个浏览器活动项中返回了 2 张截图,复测在 5 个活动项中返回了 2 张。
有些条目的 output 为 null,因此报告不能假设每个活动都有截图。
事件流并非托管浏览器的连续视频流;它会返回浏览器活动项,并在可用时返回截图。
Northstar 使用 rrweb 捕获文档对象模型(DOM)更改和交互,将其发送到同一主机,并在下方回放两次流程。
代理在两个预发布构建中的浏览器。作者制作视频。
回放显示在 ns-1041 上数量为 2、小计 $24.00,随后在 ns-1042 上为 $48.00;被禁用的购买按钮保持未操作状态。
该仓库还包含一个小型 Streamlit 查看器,用于查看已保存的裁决、浏览器证据、会话详情、成本与事件日志。
尽力统计的用量计数为两次测试给出了标准费率下 $0.9469 的令牌估算。
| 指标 | 测试 1(ns-1041) |
复测(ns-1042) |
|---|---|---|
| 输入令牌 | 255,550 | 223,533 |
| 缓存的输入令牌 | 217,041 (84.9%) | 219,449 (98.2%) |
| 输出令牌 | 982 | 708 |
| 估算令牌成本 | $0.6512 | $0.2957 |
| 回合耗时 | 96.5 秒 | 38.9 秒 |
| 浏览器活动项 | 7 | 5 |
复测使用了更少的输入令牌,其中 98.2% 来自提示缓存。两次测试合计成本为 $0.9469。
可观测性指南指出,当未知时用量可能为 null,且记录的计数可能变更,因此在删除会话前请再次核对。
我运行测试时,OpenAI 定价页面上的 GPT-6 Astra 标准费率如下:
| 令牌类型 | 每 100 万令牌费率 |
|---|---|
| 输入 | $10.00 |
| 缓存输入 | $1.00 |
| 缓存写入 | $12.50 |
| 输出 | $50.00 |
272K 长上下文门槛按每次请求计算。两次回合的合并输入低于该值,因此没有任何单次请求会触发更高的长上下文费率。
该估算仍无法还原最终账单,因为 Agents API 用量为尽力统计,且不会单独暴露缓存写入计数。
托管沙箱按标准容器费率单独计费。定价页面列出 4 GB 的 medium 容器为每 20 分钟会话 $0.12,符合条件的容器会话按分钟计费,最少 5 分钟。
安全性取决于浏览器能接触到什么,以及页面允许它做什么。
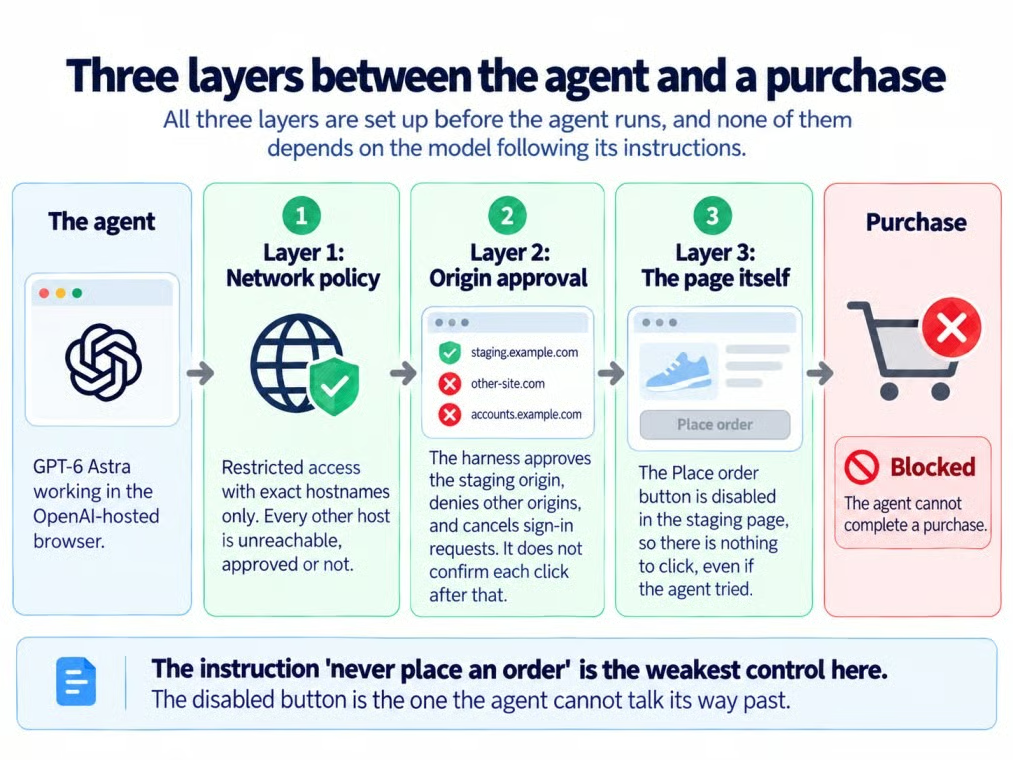
代理与结账之间的三层防护。作者供图
网络策略控制浏览器可达的主机,而来源审批决定它是否可以打开每个新来源。两者都不确认单个浏览器动作。
因此,批准 northstar-checkout-staging.vercel.app 并不意味着每次点击都被批准。
禁止购买是安全约束,purchase_control 作为证据保存,而非作为验收标准进行裁决。Northstar 禁用的“Place order”按钮是执行该约束的控制手段。
在 restricted 模式下,浏览器只能访问您列出的主机名。
OpenAI 的沙箱指南允许 1 到 100 个精确主机名,不支持通配符、协议、路径或端口。内容分发网络(CDN)、子域和重定向目标需要分别添加。
截图与 rrweb 录制会包含页面展示的任何内容,因此 Northstar 使用虚构数据、无登录,并在页脚披露记录行为。
录制器会遮罩输入,但生产部署仍需针对页面制定合适的数据政策与遮罩方案。
Agents API 仅支持美国的数据驻留,即便使用自托管沙箱也不符合零数据保留(ZDR)。
保存您需要的结果与截图,然后删除会话,而不是将预发布结账留在保留的会话状态中。
删除 Agents API 会话不会删除由站点存储的 rrweb 录制。请根据录制策略单独移除。
当购物车与审核小计出现分歧时,Northstar 判为失败;修复后在同一会话中通过。裁决由挂载程序作出,而非模型摘要。
我会保留针对已知不变量的脚本化回归测试,同时将基于目标的浏览器代理用于更难以用断言表达的探索性路径。代理负责探索;应用代码负责裁决。
关于 API 基础,我推荐我们的Working with the OpenAI API课程。
DataCamp 热门课程
课程
学习路径
课程