Curso
Trabalhar com a API da OpenAI
3 h
179.5K
Imagine um checkout que mostra US$ 48 no carrinho e US$ 24 na página de revisão. O cliente vê dois totais no mesmo checkout.
Times geralmente rodam testes de garantia de qualidade (QA) nesse fluxo com um script de navegador: clique neste botão, abra aquela página, verifique este valor. Um teste roteirizado só valida os estados que a pessoa autora especificou.
Um agente de IA é um modelo capaz de agir em direção a um objetivo. A Agents API da OpenAI gerencia o loop do agente e mantém seu trabalho em uma sessão. Neste tutorial, o Computer Use também fornece o navegador hospedado.
Northstar Checkout é uma loja de teste fictícia com um bug escondido no subtotal.
O agente recebe o resultado correto do checkout, mas não a localização do bug nem uma lista de botões para clicar. Um pequeno programa em Python, o harness, compara os valores reportados pelo agente e depois pede, na mesma sessão, para testar a loja corrigida.
Neste tutorial, vou mostrar como:
O código e as medições usam a versão 3.22.1 do pacote Python openai.
Se você só tem um minuto, aqui vai o essencial.
computer_use_call, respectivamente.Este é um único site de teste com um bug plantado — não é um benchmark de confiabilidade.
Computer Use é uma ferramenta da OpenAI Agents API que permite a um agente operar um navegador rodando nos servidores da OpenAI. Seu código acompanha os eventos da sessão e responde às solicitações. A OpenAI lista teste de sites como um dos usos.
A OpenAI gerencia o loop do agente, a sessão e a recuperação. Nosso tutorial da OpenAI Agents API cobre esses fundamentos.
Configurações mais antigas de computer use, como a do nosso tutorial de computer use com GPT-5.4, colocam o loop de captura de tela e ação para rodar no código do desenvolvedor.
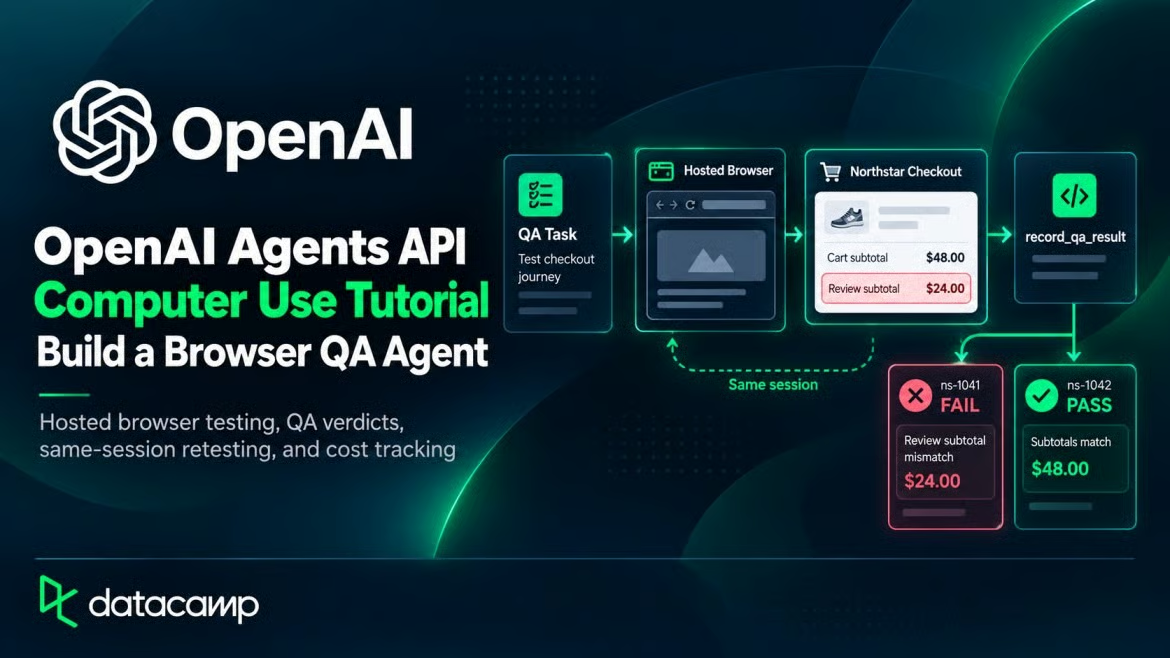
Em QA de navegador, a página em si é o objeto do teste.
Chamar diretamente uma API de checkout pularia a página onde o bug do Northstar está, então o agente segue o mesmo caminho de um cliente: da página do produto ao carrinho, checkout e revisão.
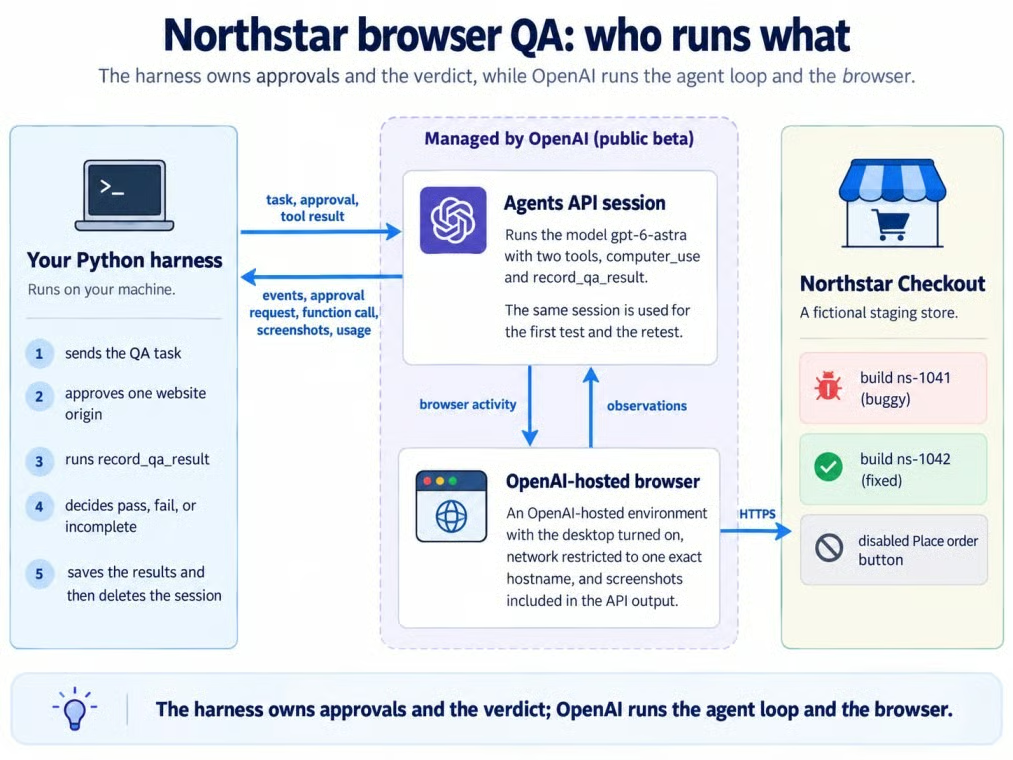
Harness, sessão, navegador hospedado, ambiente de staging. Imagem do autor.
A OpenAI gerencia a sessão e o navegador dentro da área cinza; o harness e o Northstar ficam fora dela.
O projeto inclui uma loja de staging fictícia, um harness em Python e uma sessão da Agents API.
O código completo está neste repositório no GitHub.
Northstar vende uma Trail Bottle de US$ 24. O teste passa por produto, carrinho, checkout e revisão; não há frete, impostos, login nem botão de compra funcional.
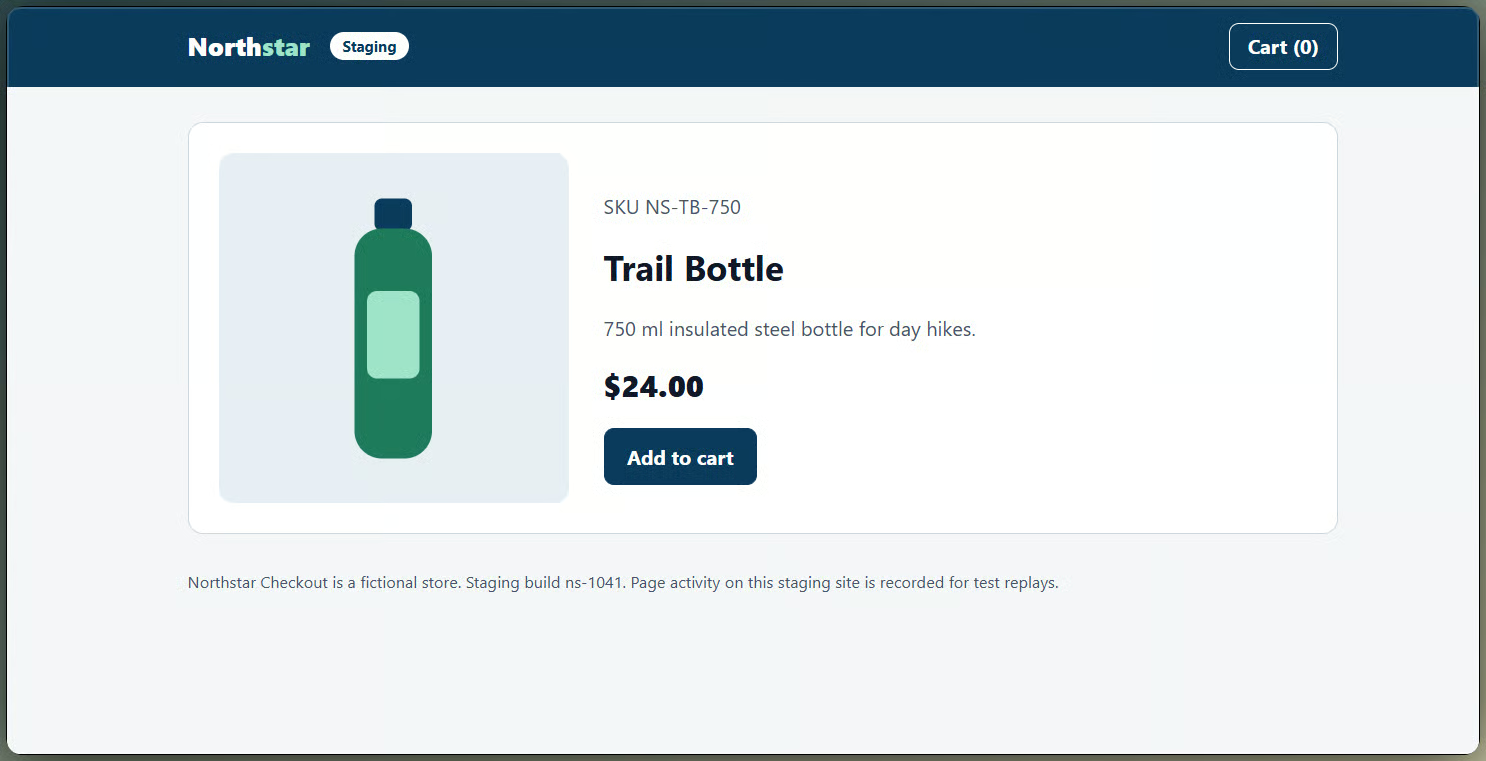
Página de produto do Northstar antes do teste. Imagem do autor.
O build ns-1041 contém o bug, enquanto o ns-1042 contém a correção. Adicionar ?reset=1 à URL inicial de um build esvazia o carrinho antes de qualquer teste.
O pedido de QA é escrito como um objetivo. Seus critérios de aceitação pedem que o agente:
Uma restrição de segurança separada diz para nunca finalizar, enviar ou pagar por um pedido. O pedido define o resultado, não os cliques.
O build com bug soma os preços unitários na página de revisão e esquece a quantidade. Ambas as páginas mostram quantidade 2, mas o subtotal do carrinho é US$ 48,00 e o da revisão é US$ 24,00.
O gabarito fica no código da aplicação. Nem as instruções nem a mensagem da tarefa mencionam o bug.
O agente informa o ID do build e 4 valores observados por meio de uma function tool, record_qa_result.
O harness primeiro verifica se o build informado é o que está em teste, já que ambos compartilham o mesmo hostname, e depois compara os valores com o gabarito.
Uma function tool só roda se o agente chamá-la. Um registro ausente, valor faltante ou build errado torna o resultado incomplete, que nunca conta como aprovado.
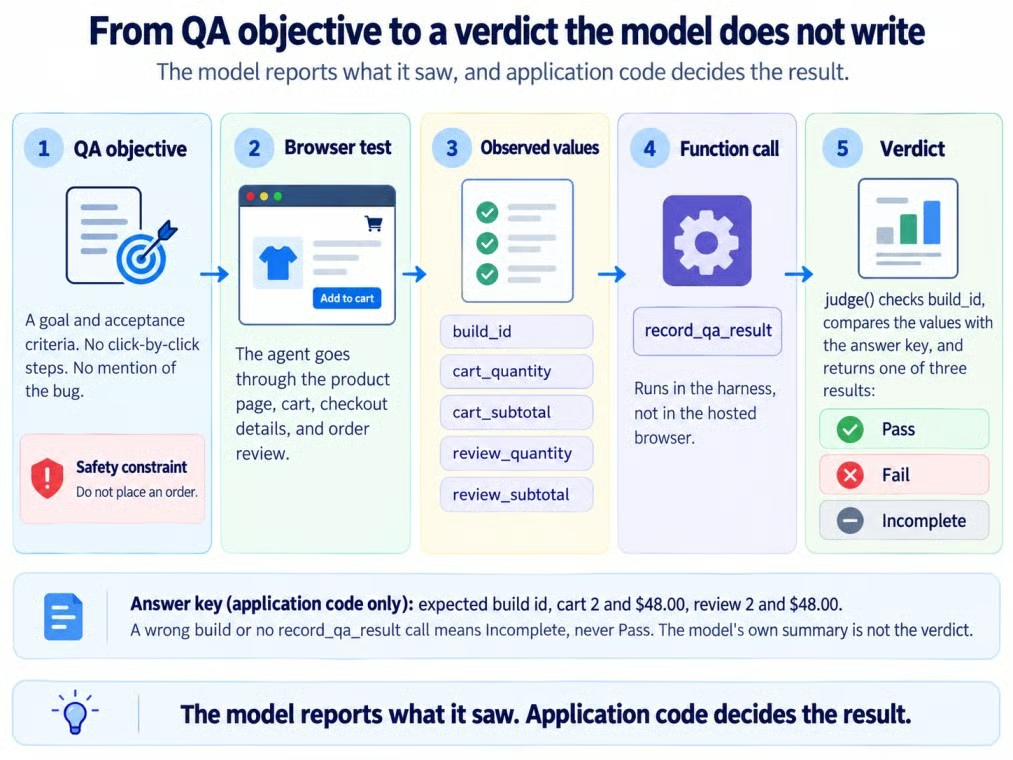
Do objetivo de QA ao veredito da aplicação. Imagem do autor.
Você vai precisar de Python, uma chave de API com escopos, acesso ao GPT-6 Astra e uma sessão com Computer Use.
openai==3.22.1 (o SDK envia o header OpenAI-Beta: agents=v1 para você)api.agents.read, api.agents.write e api.responses.write, em um projeto que possa usar gpt-6-astraA Agents API está em beta público, então nomes de campos e comportamentos podem mudar entre versões do SDK. O repositório fixa a versão 3.22.1 em requirements.txt.
O navegador hospedado precisa de uma URL acessível, então o código usa um deploy do Northstar na Vercel.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # então adicione seu OPENAI_API_KEY
python run_qa.py
Para saber mais sobre dependências isoladas, veja nosso guia de ambiente virtual. No macOS ou Linux, ative com source .venv/bin/activate e copie o arquivo com cp. Mantenha a chave em .env, nunca no código.
O experimento usa o GPT-6 Astra, o modelo dos exemplos de Computer Use da OpenAI. Nosso overview do GPT-6 Astra traz mais detalhes do modelo.
O código usa a Agents API (client.beta.agents), não o Agents SDK nem a ferramenta computer da Responses API usada no nosso tutorial da GPT-6 Astra API.
Crie uma sessão com a ferramenta computer_use e um desktop hospedado pela OpenAI, e depois reutilize-a para ambos os testes:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", definido explicitamente
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True expõe as capturas de tela retornadas pela API, enquanto o acesso de rede restrito limita o navegador ao Northstar.
O ambiente usa o tamanho padrão medium (2 vCPU, 4 GB de RAM).
A função registra o que o agente observou. Se o agente não conseguir ler um dos 4 valores de quantidade ou subtotal verificados, ele deve reportar esse campo como null.
Listar todas as propriedades em required orienta o modelo a responder a todas, usando null para o que não viu. Ainda assim, o harness trata campo ausente como incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
O harness converte cada preço exibido para centavos, verifica o ID do build e compara os valores com o gabarito:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": ["build_id=" + expected_build, *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Um valor ilegível ou ausente produz veredito incomplete, nunca aprovação.
Um relatório do build errado retorna incomplete antes que seus valores possam afetar o veredito.
As mesmas instruções valem para os dois testes:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Somente o build do site muda entre os testes.
Abra o stream de eventos, envie o objetivo de QA uma vez e depois trate aprovações e chamadas de função até a conclusão do turno.
Abra primeiro o stream de eventos e então envie a tarefa exatamente uma vez:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # abra o stream primeiro e envie a tarefa exatamente uma vez
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconectado: aja sobre o que ainda está pendente, nunca reenvie a tarefa
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Streams não reproduzem eventos perdidos. Se o stream cair, abra outro, recupere a sessão e seus itens salvos enquanto a conexão se mantiver.
A mensagem da tarefa informa o build, os critérios de aceitação e a restrição de segurança, mas não fala nada sobre o bug:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Guarde o ID da sessão para o reteste.
O navegador hospedado pede aprovação antes de abrir cada nova origem de site.
O stream emite agent.session.requires_action; recupere a sessão e leia required_actions para ver a solicitação.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar não tem login, então o sign-in é recusado
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])O trabalho no navegador aparece como itens computer_use_call, cada um com um título curto e um status. O stream de eventos do primeiro teste mostrou:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Foram cerca de 47 segundos até a primeira atividade no navegador.
Todos os 7 itens computer_use_call foram concluídos, mas o status do item não é o veredito de QA; quem decide é o resultado da função.
Sim. Mais importante: a chamada de função isolou a falha em um único campo — o subtotal da revisão.
A chamada record_qa_result continha:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Todos os valores batem com a página com bug. A quantidade permaneceu 2 na revisão, descartando um erro visível de quantidade.
judge() confirmou o build ns-1041, comparou os 4 valores com os esperados e encontrou somente o subtotal da revisão incorreto.
Este é o único veredito que o experimento usa:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Depois que a correção estiver no ar, envie mais uma mensagem para a mesma sessão.
Este pequeno teste de regressão usa as mesmas instruções e a mesma função de veredito.
A correção no build ns-1042 é uma linha no JavaScript do Northstar:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);O link inicial inclui ?reset=1, então o reteste começa com o carrinho vazio. Em seguida, o follow-up vai para a mesma sessão:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
O reteste manteve o ambiente hospedado e não exigiu nova aprovação de origem. Não dependa do estado do navegador, pois cookies podem expirar e a reciclagem do ambiente pode limpá-lo.
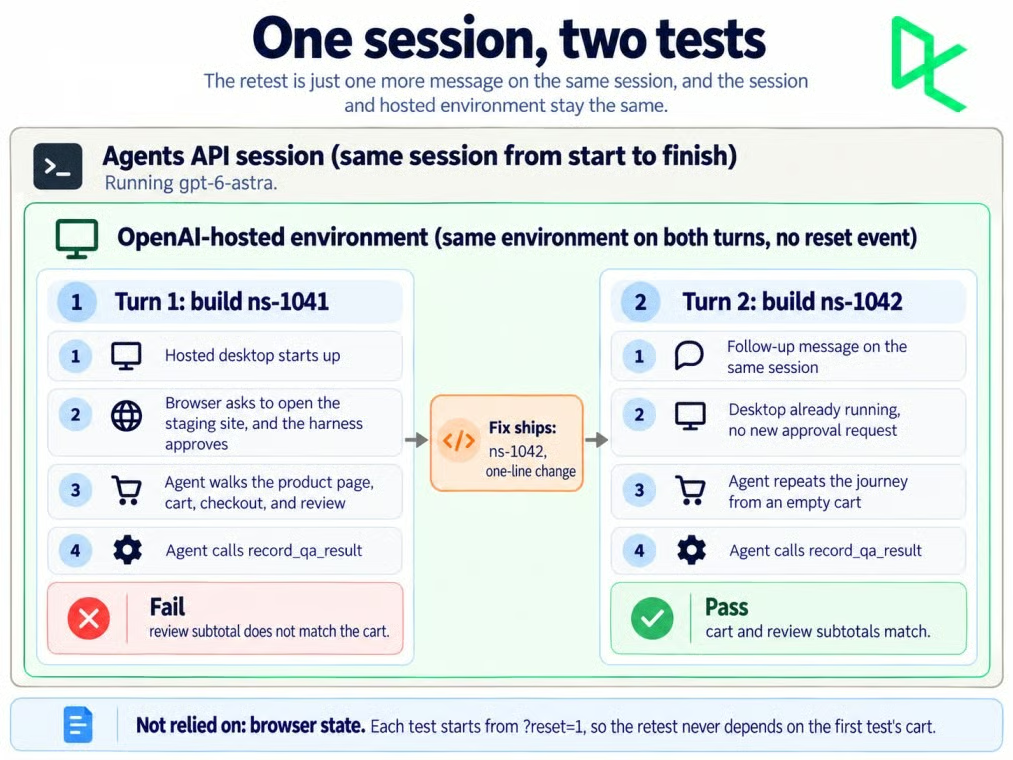
A mesma sessão carregou os dois testes de QA. Imagem do autor.
Um sandbox hospedado pode ser excluído se a atividade e os keep-alives pararem por 1 hora. Fique de olho em agent.session.environment.reset e inicie cada reteste de um estado conhecido.
Sim. O reteste reportou quantidade 2 e US$ 48,00 no carrinho, depois quantidade 2 e US$ 48,00 na revisão, e judge() retornou aprovação sem falhas.
Levou 38,9 segundos com 5 itens de atividade do navegador, contra 96,5 segundos e 7 itens no primeiro teste, que incluiu 47 segundos de espera antes da primeira atividade.
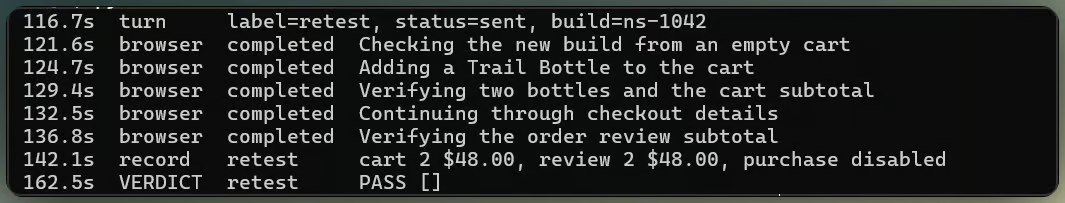
O reteste passou sem nova aprovação. Imagem do autor.
Nem sempre. Mesmo com include_screenshots ativado, o primeiro teste retornou 2 capturas de tela de 7 atividades, e o reteste retornou 2 de 5.
Alguns itens retornam output: null, então relatórios não podem assumir uma imagem para cada atividade.
O stream de eventos não é um vídeo contínuo do navegador hospedado; ele retorna itens de atividade do navegador e capturas de tela quando disponíveis.
O Northstar usa o rrweb para capturar mudanças no DOM e interações, enviar para o mesmo host e reproduzir as duas jornadas abaixo.
O navegador do agente em ambos os builds de staging. Vídeo do autor.
A reprodução mostra quantidade 2 e US$ 24,00 em ns-1041, depois US$ 48,00 em ns-1042; o botão de compra desativado permanece intocado.
O repositório também inclui um pequeno visualizador em Streamlit para o veredito salvo, evidências do navegador, detalhes da sessão, custo e log de eventos.
Os contadores de uso (best effort) estimaram US$ 0,9469 em tokens na tarifa padrão pelos dois testes.
| Métrica | Teste 1 (ns-1041) |
Reteste (ns-1042) |
|---|---|---|
| Tokens de entrada | 255.550 | 223.533 |
| Tokens de entrada em cache | 217.041 (84,9%) | 219.449 (98,2%) |
| Tokens de saída | 982 | 708 |
| Custo estimado de tokens | US$ 0,6512 | US$ 0,2957 |
| Tempo do turno | 96,5 segundos | 38,9 segundos |
| Itens de atividade do navegador | 7 | 5 |
O reteste usou menos tokens de entrada, e 98,2% vieram do cache de prompt. Juntos, os dois testes custaram US$ 0,9469.
O guia de observabilidade diz que o uso pode ser null quando desconhecido e que contagens registradas podem mudar, então confira de novo antes de excluir a sessão.
Quando rodei os testes, estas eram as tarifas padrão do GPT-6 Astra na página de preços da OpenAI:
| Tipo de token | Tarifa por 1M de tokens |
|---|---|
| Entrada | US$ 10,00 |
| Entrada em cache | US$ 1,00 |
| Cache writes | US$ 12,50 |
| Saída | US$ 50,00 |
O limite de contexto longo de 272 mil tokens se aplica por requisição. A soma de entrada dos dois turnos ficou abaixo disso, então nenhuma requisição isolada poderia acionar a tarifa mais alta de contexto longo.
Ainda assim, a estimativa não reproduz a fatura final porque o uso da Agents API é estimativo e não expõe contagens separadas de gravação em cache.
O sandbox hospedado é cobrado separadamente nas tarifas padrão de contêiner. A página de preços lista o contêiner medium de 4 GB por US$ 0,12 a cada sessão de 20 minutos, com sessões elegíveis cobradas por minuto e mínimo de 5 minutos.
A segurança depende do que o navegador consegue acessar e do que a página permite fazer.
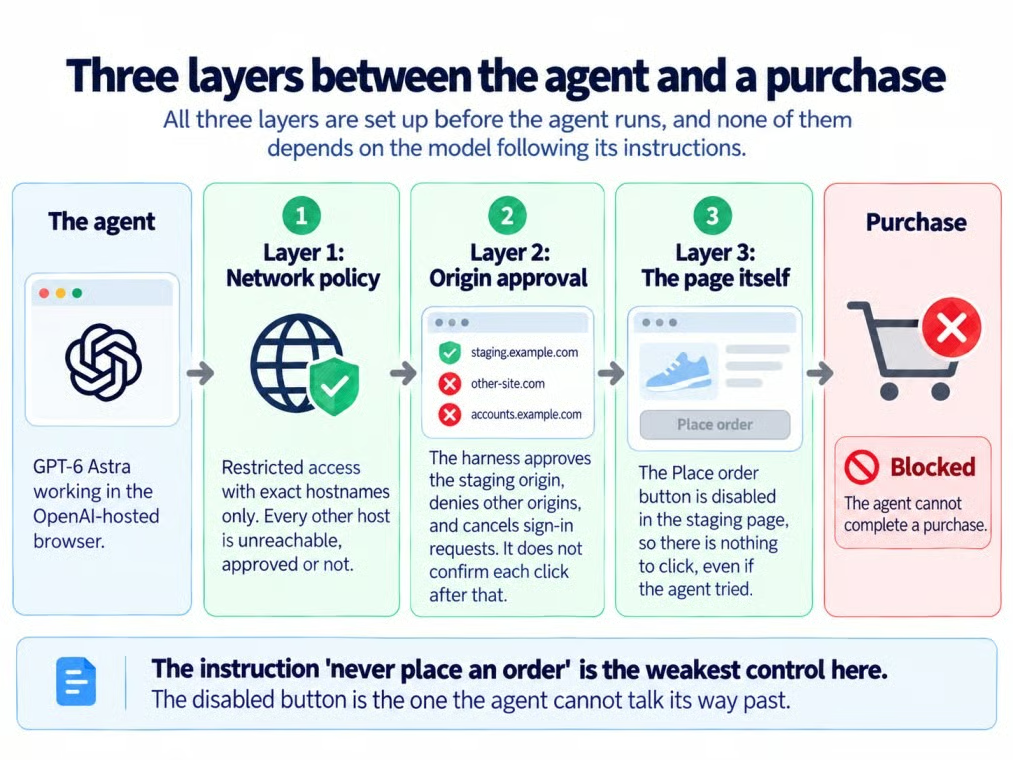
Três camadas entre o agente e o checkout. Imagem do autor
A política de rede controla quais hosts o navegador pode alcançar, e a aprovação de origem decide se ele pode abrir cada nova origem. Nenhuma das duas confirma ações individuais do navegador.
Aprovar northstar-checkout-staging.vercel.app portanto não aprova cada clique separadamente.
A regra de não compra é uma restrição de segurança, e purchase_control é salvo como evidência em vez de julgado como critério de aceitação. O botão desativado "Place order" do Northstar é o controle que a impõe.
Com restricted, o navegador só alcança os hostnames que você listar.
O guia de sandbox da OpenAI aceita de 1 a 100 hostnames exatos, sem curingas, protocolos, paths ou portas. CDNs, subdomínios e destinos de redirecionamento precisam de entradas separadas.
Capturas de tela e gravações do rrweb contêm tudo que a página mostrar, então o Northstar usa dados fictícios, não tem login e informa a gravação no rodapé.
O gravador mascara inputs, mas um deploy de produção ainda precisaria de política de dados e mascaramento adequados à página.
A Agents API oferece residência de dados apenas nos Estados Unidos e não é elegível para Zero Data Retention (ZDR), mesmo com sandbox self-hosted.
Salve os resultados e capturas de que você precisa e depois exclua a sessão, em vez de deixar um checkout de staging em estado retido.
Excluir a sessão da Agents API não apaga as gravações do rrweb armazenadas pelo site. Remova-as separadamente conforme a política de gravação.
O Northstar falhou quando os subtotais do carrinho e da revisão divergiram e depois passou com a correção na mesma sessão. Foi o harness, e não o resumo do modelo, que decidiu ambos os vereditos.
Eu manteria testes de regressão roteirizados para invariantes conhecidas e usaria agentes de navegador guiados por objetivos para jornadas exploratórias mais difíceis de expressar como uma asserção. O agente explora; o código da aplicação decide.
Para os fundamentos da API, recomendo nosso curso Working with the OpenAI API.
Principais cursos da DataCamp
Curso
Programa
Curso
Tutorial
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Tutorial