Curso
Trabajar con la API de OpenAI
3 h
179.5K
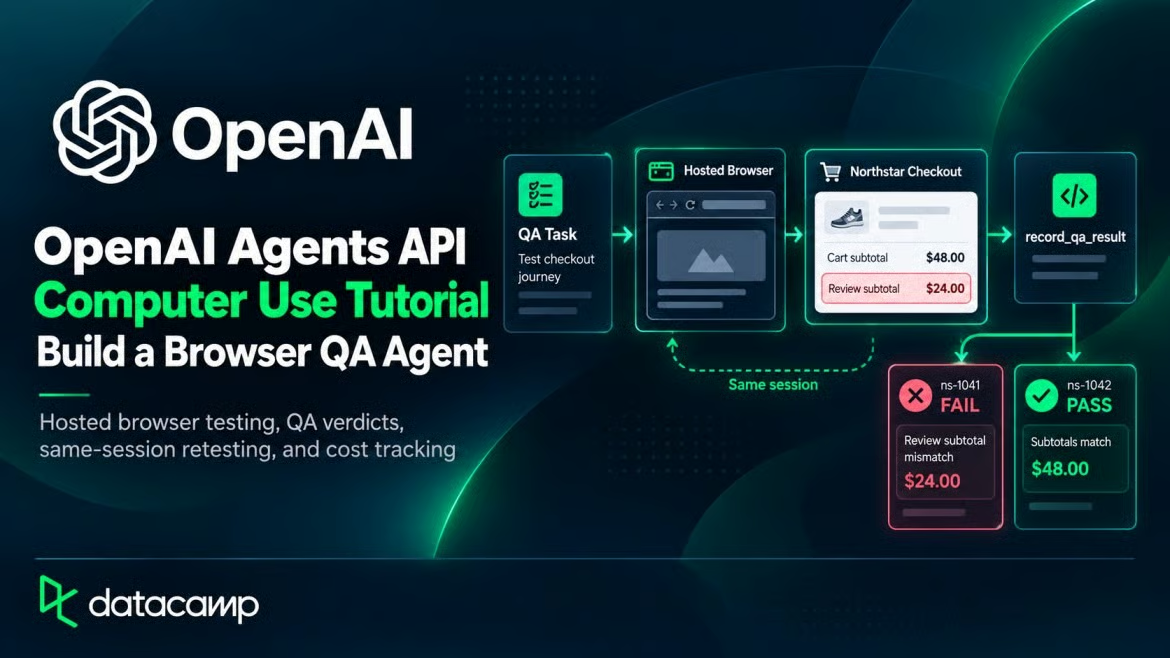
Imagina un checkout que muestra 48 $ en el carrito y 24 $ en la página de revisión. El cliente ve dos totales en el mismo proceso de compra.
Normalmente, los equipos hacen pruebas de aseguramiento de calidad (QA) en este flujo con un script de navegador: haz clic en este botón, abre aquella página, comprueba este valor. Una prueba con guion solo valida los estados que su autor dejó escritos.
Un agente de IA es un modelo que puede realizar acciones con un objetivo. La Agents API de OpenAI gestiona el bucle del agente y conserva su trabajo en una sesión. En este tutorial, Computer Use además proporciona el navegador alojado.
Northstar Checkout es una tienda de prueba ficticia con un bug oculto en el subtotal.
El agente recibe el resultado correcto del checkout, pero no la ubicación del bug ni una lista de botones que pulsar. Un pequeño programa en Python, el harness, compara los valores que reporta el agente y luego pide a esa misma sesión que pruebe la tienda corregida.
En este tutorial, verás cómo:
El código y las mediciones usan la versión 3.22.1 del paquete de Python openai.
Si solo tienes un minuto, aquí tienes las claves.
computer_use_call respectivamente.Esto es una sola tienda con un bug introducido a propósito, no un benchmark de fiabilidad.
Computer Use es una herramienta de la Agents API de OpenAI que permite a un agente manejar un navegador ejecutándose en los servidores de OpenAI. Tu código sigue los eventos de la sesión y responde a sus solicitudes. OpenAI incluye la prueba de sitios web como uno de sus usos.
OpenAI gestiona el bucle del agente, la sesión y la recuperación. Nuestro tutorial de la Agents API de OpenAI cubre esos fundamentos.
Configuraciones anteriores de computer use, como la de nuestro tutorial de Computer Use con GPT-5.4, hacían que el código del desarrollador ejecutara el bucle de capturas y acciones.
En QA de navegador, la propia página es el objeto de la prueba.
Llamar directamente a una API de checkout se saltaría la página donde está el bug de Northstar, así que el agente sigue el mismo camino que un cliente: de la página del producto al carrito, el checkout y la revisión.
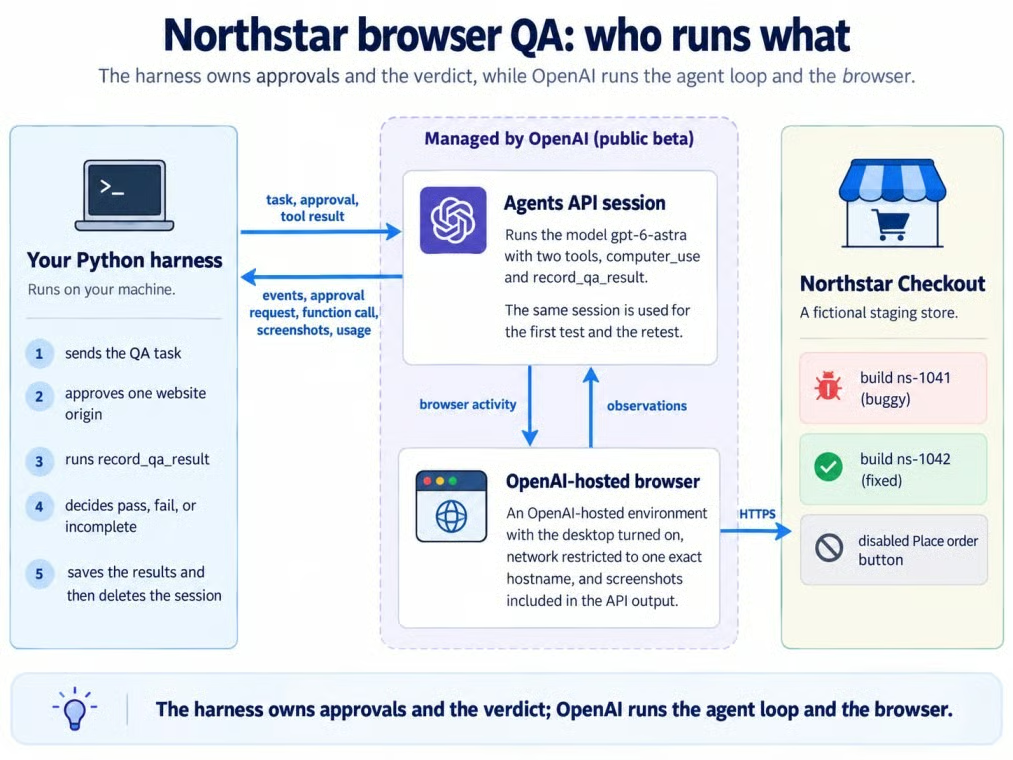
Harness, sesión, navegador alojado, sitio de staging. Imagen del autor.
OpenAI gestiona la sesión y el navegador dentro de la zona gris; el harness y Northstar permanecen fuera.
El proyecto incluye una tienda de staging ficticia, un harness en Python y una sesión de la Agents API.
El código completo está en este repositorio de GitHub.
Northstar vende una única Trail Bottle por 24 $. La prueba recorre producto, carrito, checkout y revisión; no hay envío, impuestos, inicio de sesión ni botón de compra funcional.
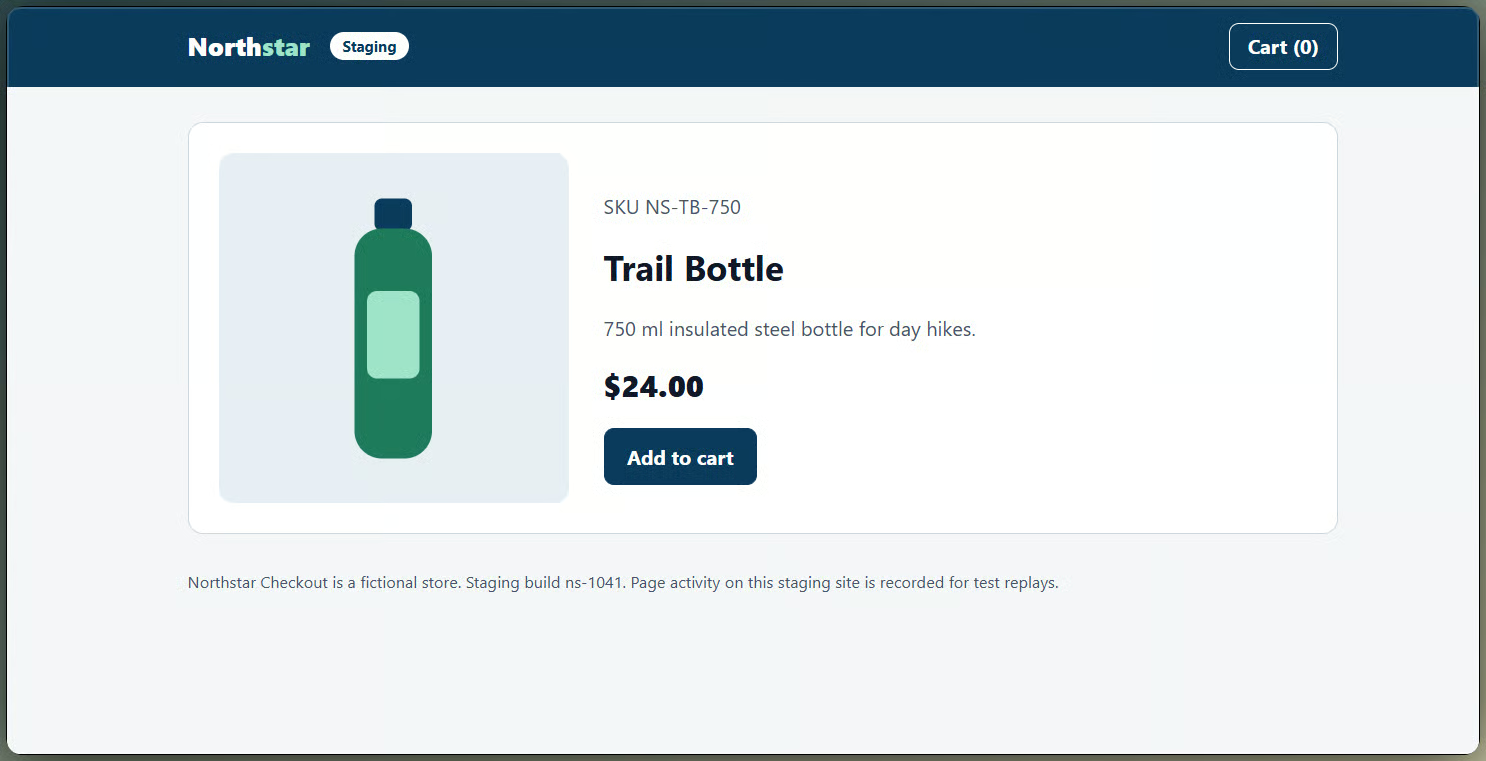
Página de producto de Northstar antes de la prueba. Imagen del autor.
La build ns-1041 contiene el bug, mientras que ns-1042 contiene la corrección. Añadir ?reset=1 a la URL inicial de una build vacía el carrito antes de cada prueba.
La solicitud de QA está escrita como un objetivo. Sus criterios de aceptación piden al agente:
Una restricción de seguridad independiente indica no realizar, enviar ni pagar nunca un pedido. La solicitud define el resultado, no los clics.
La build con bug suma los precios unitarios en la página de revisión y olvida la cantidad. Ambas páginas muestran cantidad 2, pero el subtotal del carrito es 48,00 $ y el de revisión es 24,00 $.
La solución de referencia vive en el código de la aplicación. Ni las instrucciones ni el mensaje de la tarea mencionan el bug.
El agente informa del id de build y 4 valores observados a través de una function tool, record_qa_result.
El harness primero comprueba que la build reportada es la que se está probando, ya que ambas comparten hostname, y luego compara los valores con la solución de referencia.
Una function tool solo se ejecuta si el agente la llama. Un registro ausente, un valor faltante o una build incorrecta convierte el resultado en incomplete, que nunca cuenta como aprobado.
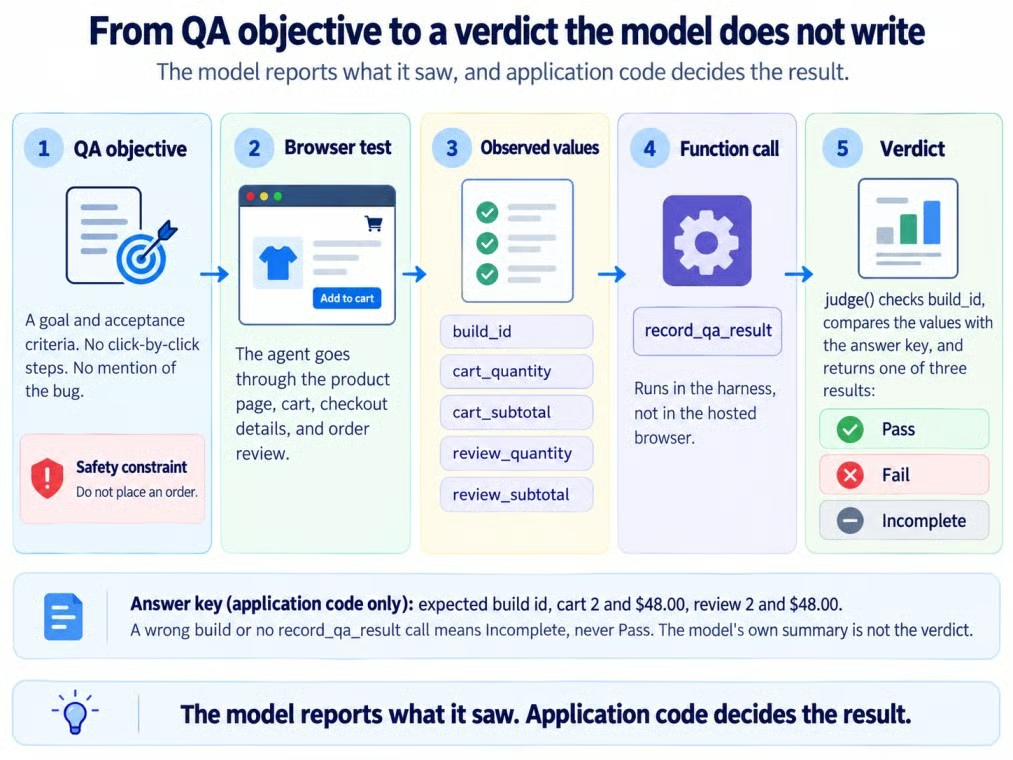
Del objetivo de QA al veredicto de la aplicación. Imagen del autor.
Necesitas Python, una clave de API con permisos acotados, acceso a GPT-6 Astra y una sesión con Computer Use.
openai==3.22.1 (el SDK envía por ti la cabecera OpenAI-Beta: agents=v1)api.agents.read, api.agents.write y api.responses.write, en un proyecto que pueda usar gpt-6-astraLa Agents API está en beta pública, por lo que los nombres de campos y el comportamiento pueden cambiar entre versiones del SDK. El repositorio fija la versión 3.22.1 en requirements.txt.
El navegador alojado necesita una URL accesible, así que el código usa un despliegue en Vercel de Northstar.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
Para más información sobre dependencias aisladas, consulta nuestra guía de entornos virtuales. En macOS o Linux, activa con source .venv/bin/activate y copia el archivo con cp. Mantén la clave en .env, nunca en el código.
El experimento usa GPT-6 Astra, el modelo de los ejemplos de Computer Use de OpenAI. Nuestro resumen de GPT-6 Astra cubre el modelo en sí.
El código usa la Agents API (client.beta.agents), no el Agents SDK ni la herramienta computer de la Responses API que usamos en nuestro tutorial de la API de GPT-6 Astra.
Crea una sesión con la herramienta computer_use y un escritorio alojado por OpenAI, y reutilízala para ambas pruebas:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True expone cualquier captura de pantalla que devuelva la API, mientras que el acceso de red restringido limita el navegador a Northstar.
El entorno usa el tamaño medium por defecto (2 vCPU, 4 GB de RAM).
La función registra lo que observó el agente. Si el agente no puede leer uno de los 4 valores de cantidad o subtotal, debe informar ese campo como null.
Enumerar cada propiedad en required indica al modelo que responda a todas, usando null para cualquier valor que no haya visto. Aun así, el harness trata un campo faltante como incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
El harness convierte cada precio mostrado a céntimos, verifica el id de build y compara los valores con la solución de referencia:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Un valor ilegible o ausente produce un veredicto incomplete, nunca un aprobado.
Un informe de la build equivocada devuelve incomplete antes de que sus valores puedan afectar al veredicto.
Las mismas instrucciones rigen ambas pruebas:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Solo cambia la build del sitio web entre pruebas.
Abre el stream de eventos, envía el objetivo de QA una vez y luego gestiona aprobaciones y llamadas a funciones hasta que termine el turno.
Abre primero el stream de eventos y, a continuación, envía la tarea exactamente una vez:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Los streams no reproducen eventos perdidos. Si el stream se cae, abre uno nuevo y luego recupera la sesión y sus elementos guardados mientras permanezca conectado.
El mensaje de la tarea nombra la build, los criterios de aceptación y la restricción de seguridad, pero no dice nada del bug:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Guarda el id de sesión para la segunda prueba.
El navegador alojado pide aprobación antes de abrir cada nuevo origen del sitio.
El stream emite agent.session.requires_action; recupera la sesión y lee required_actions para ver la solicitud.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])El trabajo en el navegador aparece como elementos computer_use_call, cada uno con un título breve y un estado. El stream de eventos de la primera prueba mostró:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Pasaron unos 47 segundos antes de la primera actividad del navegador.
Los 7 elementos computer_use_call se completaron, pero el estado de un elemento no es el veredicto de QA; lo es el resultado de la función.
Sí. Y, más importante, la llamada a la función aisló el fallo a un único campo: el subtotal de la revisión.
La llamada record_qa_result contenía:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Cada valor coincide con la página con bug. La cantidad se mantuvo en 2 en la revisión, lo que descarta una discrepancia visible en la cantidad.
judge() confirmó la build ns-1041, comparó los 4 valores con los esperados y encontró incorrecto solo el subtotal de la revisión.
Este es el único veredicto que usa el experimento:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Cuando la corrección esté desplegada, envía un mensaje más a la misma sesión.
Esta pequeña prueba de regresión usa las mismas instrucciones y la misma función de veredicto.
La corrección en la build ns-1042 es una línea del JavaScript de Northstar:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);El enlace de inicio incluye ?reset=1, así que la segunda prueba empieza con el carrito vacío. Luego, el seguimiento va a la misma sesión:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
La repetición mantuvo el entorno alojado y no requirió una nueva aprobación del origen. No dependas del estado del navegador, porque las cookies pueden caducar y al reciclar el entorno se borra.
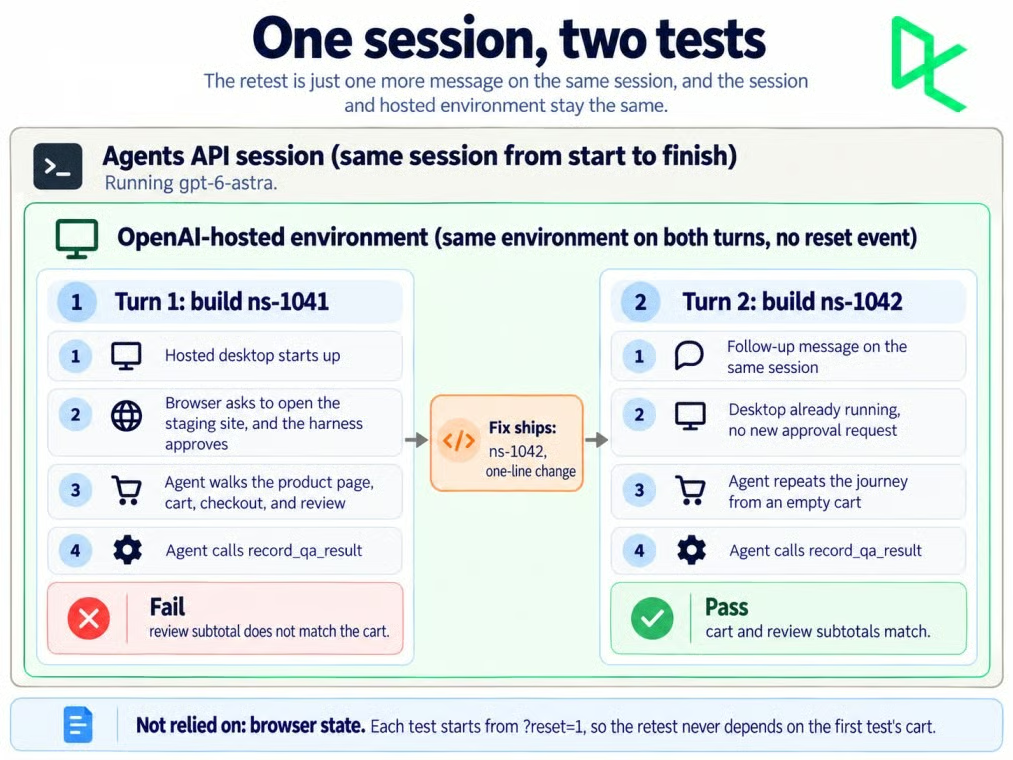
Una sola sesión llevó ambas pruebas de QA. Imagen del autor.
Un sandbox alojado puede eliminarse si la actividad y los keep-alives se detienen durante 1 hora. Vigila agent.session.environment.reset y empieza cada repetición desde un estado conocido.
Sí. La repetición informó cantidad del carrito 2 y 48,00 $, luego cantidad en revisión 2 y 48,00 $, y judge() devolvió un aprobado sin comprobaciones fallidas.
Tardó 38,9 segundos con 5 elementos de actividad del navegador, frente a 96,5 segundos y 7 elementos en la primera prueba, que incluyó una espera de 47 segundos antes de que comenzara la actividad del navegador.
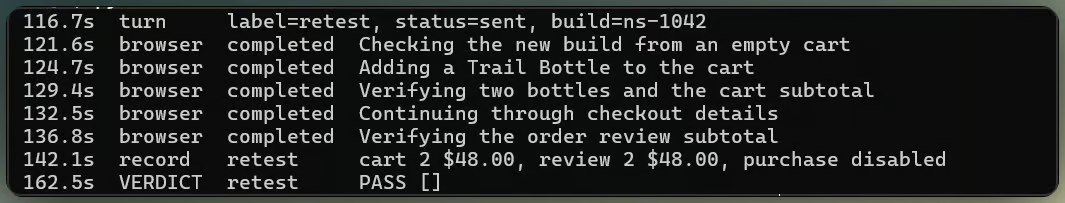
La repetición pasó sin una nueva aprobación. Imagen del autor.
No necesariamente. Incluso con include_screenshots activado, la primera prueba devolvió 2 capturas de 7 elementos de actividad del navegador, y la repetición devolvió 2 de 5.
Algunos elementos devuelven output: null, así que los informes no pueden asumir una imagen por cada actividad.
El stream de eventos no es un vídeo continuo del navegador alojado; devuelve elementos de actividad del navegador y capturas cuando están disponibles.
Northstar usa rrweb para capturar cambios e interacciones del Document Object Model (DOM), enviarlos al mismo host y reproducir ambos recorridos a continuación.
El navegador del agente en ambas builds de staging. Vídeo del autor.
La reproducción muestra cantidad 2 y 24,00 $ en ns-1041, y luego 48,00 $ en ns-1042; el botón de compra deshabilitado permanece sin tocar.
El repositorio también incluye un pequeño visor en Streamlit para el veredicto guardado, las evidencias del navegador, los detalles de la sesión, el coste y el registro de eventos.
Los contadores de uso orientativos arrojaron una estimación de tokens a tarifa estándar de 0,9469 $ para ambas pruebas.
| Métrica | Prueba 1 (ns-1041) |
Repetición (ns-1042) |
|---|---|---|
| Tokens de entrada | 255.550 | 223.533 |
| Tokens de entrada en caché | 217.041 (84,9%) | 219.449 (98,2%) |
| Tokens de salida | 982 | 708 |
| Coste estimado de tokens | 0,6512 $ | 0,2957 $ |
| Tiempo del turno | 96,5 segundos | 38,9 segundos |
| Elementos de actividad del navegador | 7 | 5 |
La repetición usó menos tokens de entrada, y el 98,2% provinieron de la caché de prompts. En conjunto, las 2 pruebas costaron 0,9469 $.
La guía de observabilidad indica que el uso puede ser null cuando se desconoce y que los conteos registrados pueden cambiar, así que revísalos de nuevo antes de borrar la sesión.
Cuando ejecuté las pruebas, estas eran las tarifas estándar de GPT-6 Astra en la página de precios de OpenAI:
| Tipo de token | Tarifa por 1 M de tokens |
|---|---|
| Entrada | 10,00 $ |
| Entrada en caché | 1,00 $ |
| Escrituras en caché | 12,50 $ |
| Salida | 50,00 $ |
El umbral de 272 K para contexto largo se aplica por solicitud. La entrada combinada de ambos turnos se mantuvo por debajo, así que ninguna solicitud individual podría haber activado las tarifas más altas de contexto largo.
Aun así, la estimación no puede reproducir la factura final porque el uso de la Agents API es orientativo y no expone conteos separados de escrituras en caché.
El sandbox alojado se factura por separado a tarifas estándar de contenedores. La página de precios lista el contenedor medium de 4 GB a 0,12 $ por sesión de 20 minutos, con sesiones de contenedor elegibles facturadas por minuto y un mínimo de 5 minutos.
La seguridad depende de a qué puede acceder el navegador y de lo que la página le permite hacer.
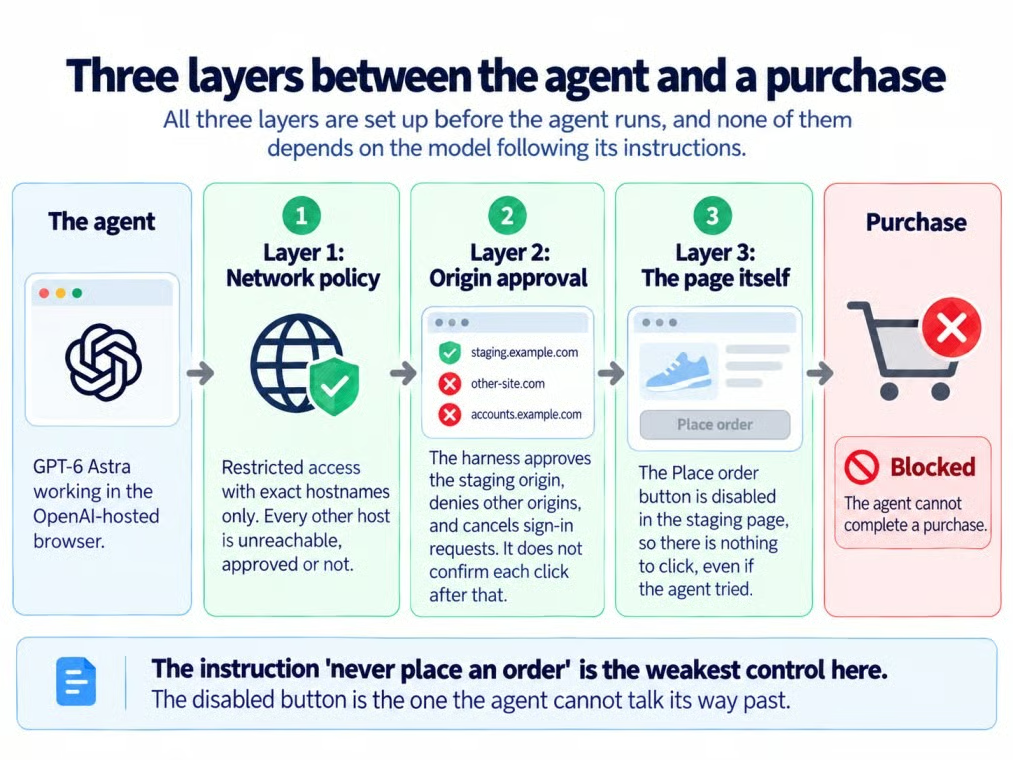
Tres capas entre el agente y el checkout. Imagen del autor
La política de red controla a qué hosts puede llegar el navegador, y la aprobación de origen decide si puede abrir cada nuevo origen. Ninguna de las dos confirma acciones individuales en el navegador.
Aprobar northstar-checkout-staging.vercel.app por tanto no aprueba cada clic por separado.
La norma de no compra es una restricción de seguridad, y purchase_control se guarda como evidencia en lugar de juzgarse como criterio de aceptación. El botón deshabilitado "Place order" de Northstar es el control que la aplica.
Con restricted, el navegador solo puede llegar a los hostnames que indiques.
La guía del sandbox de OpenAI acepta de 1 a 100 hostnames exactos, sin comodines, protocolos, rutas ni puertos. Las CDNs, subdominios y destinos de redirección necesitan entradas separadas.
Las capturas y las grabaciones de rrweb contienen lo que muestre la página, así que Northstar usa datos ficticios, no tiene login y avisa de la grabación en su pie de página.
El grabador enmascara entradas, pero un despliegue en producción aún necesitaría una política de datos y un enmascarado acordes con la página.
La Agents API solo admite residencia de datos en Estados Unidos y no es apta para Zero Data Retention (ZDR), incluso con un sandbox autohospedado.
Guarda los resultados y las capturas que necesites y luego elimina la sesión en lugar de dejar un checkout de staging en estado retenido.
Eliminar la sesión de la Agents API no borra las grabaciones de rrweb almacenadas por el sitio. Elimínalas por separado según la política de grabación.
Northstar falló cuando el subtotal del carrito y el de revisión divergieron, y aprobó tras la corrección en la misma sesión. El veredicto lo decidió el harness, no el resumen del modelo.
Yo mantendría pruebas de regresión con scripts para invariantes conocidas y usaría agentes de navegador orientados a objetivos para recorridos exploratorios que son más difíciles de expresar como una aserción. El agente explora; el código de aplicación decide.
Para los fundamentos de la API, te recomiendo nuestro curso Working with the OpenAI API.
Los mejores cursos de DataCamp
Curso
Programa
Curso
blog
Abid Ali Awan
10 min
Tutorial
Arunn Thevapalan
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
12 min