
Cours
Travailler avec l'API OpenAI
3 h
179.5K
Imaginez un checkout qui affiche 48 $ dans le panier et 24 $ sur la page de récapitulatif. Le client voit deux totaux dans le même parcours d'achat.
Les équipes exécutent généralement des tests d'assurance qualité (QA) de ce flux à l'aide d'un script navigateur : cliquez sur ce bouton, ouvrez cette page, vérifiez cette valeur. Un test scripté ne vérifie que les états que son auteur a décrits.
Un agent IA est un modèle capable d'agir pour atteindre un objectif. L'Agents API d'OpenAI orchestre la boucle de l'agent et conserve son travail dans une session. Dans ce tutoriel, Computer Use fournit également le navigateur hébergé.
Northstar Checkout est une boutique de test fictive avec un bug caché sur le sous-total.
L'agent reçoit le résultat correct attendu au checkout, mais pas l'emplacement du bug ni une liste de boutons à cliquer. Un petit programme Python, appelé le harnais (harness), compare les valeurs rapportées par l'agent puis demande, dans la même session, de tester la version corrigée.
Dans ce tutoriel, je vous montre comment :
Le code et les mesures utilisent la version 3.22.1 du package Python openai.
Si vous n'avez qu'une minute, voici l'essentiel.
computer_use_call respectivement.Il s'agit d'une seule boutique de test avec un bug volontaire, pas d'un benchmark de fiabilité.
Computer Use est un outil de l'Agents API d'OpenAI qui permet à un agent de piloter un navigateur exécuté sur les serveurs d'OpenAI. Votre code suit les événements de la session et répond à ses requêtes. OpenAI cite le test de sites web parmi ses cas d'usage.
OpenAI gère la boucle de l'agent, la session et la reprise. Notre tutoriel OpenAI Agents API couvre ces bases.
Les anciens montages de computer use, comme dans notre tutoriel GPT-5.4 computer use, confiaient plutôt au code développeur la boucle capture d'écran + action.
En QA navigateur, c'est la page elle‑même qui est testée.
Appeler directement une API de checkout ignorerait la page où se trouve le bug de Northstar, donc l'agent suit le même parcours qu'un client : page produit, panier, checkout, puis récapitulatif.
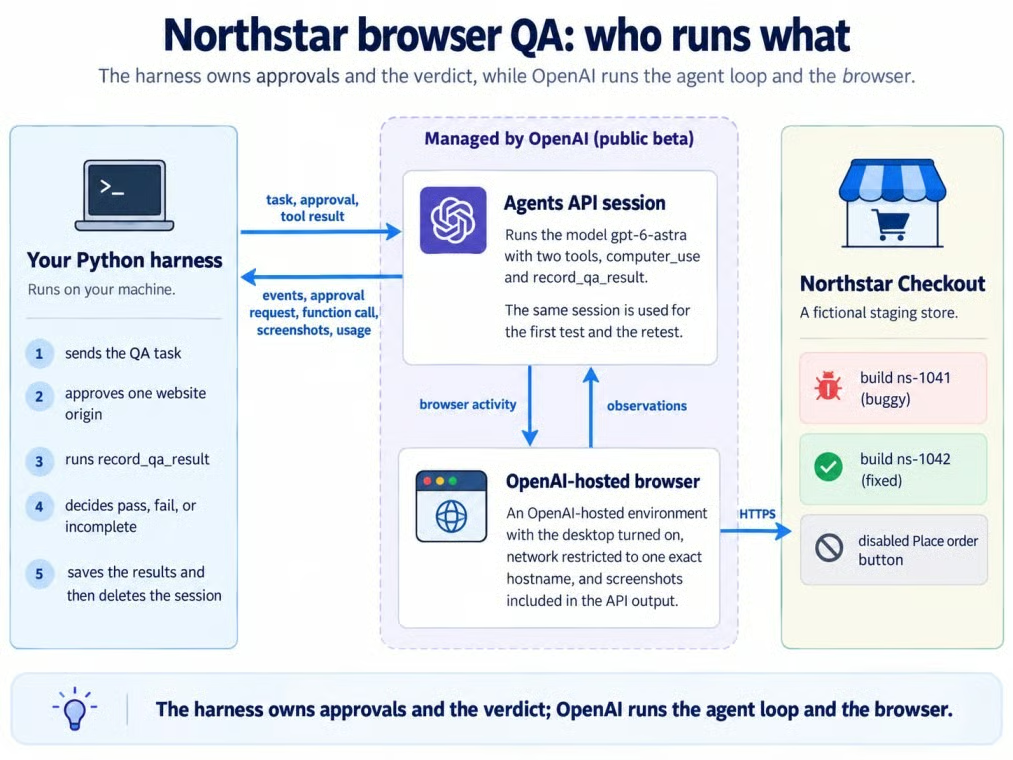
Harnais, session, navigateur hébergé, site de préproduction. Image de l'auteur.
OpenAI gère la session et le navigateur dans la zone grisée ; le harnais et Northstar restent en dehors.
Le projet comprend une boutique de préproduction fictive, un harnais Python et une session Agents API.
Le code complet est dans ce dépôt GitHub.
Northstar vend une Trail Bottle à 24 $. Le test va du produit au panier, puis au checkout et au récapitulatif ; pas d'expédition, taxes, connexion ni bouton d'achat fonctionnel.
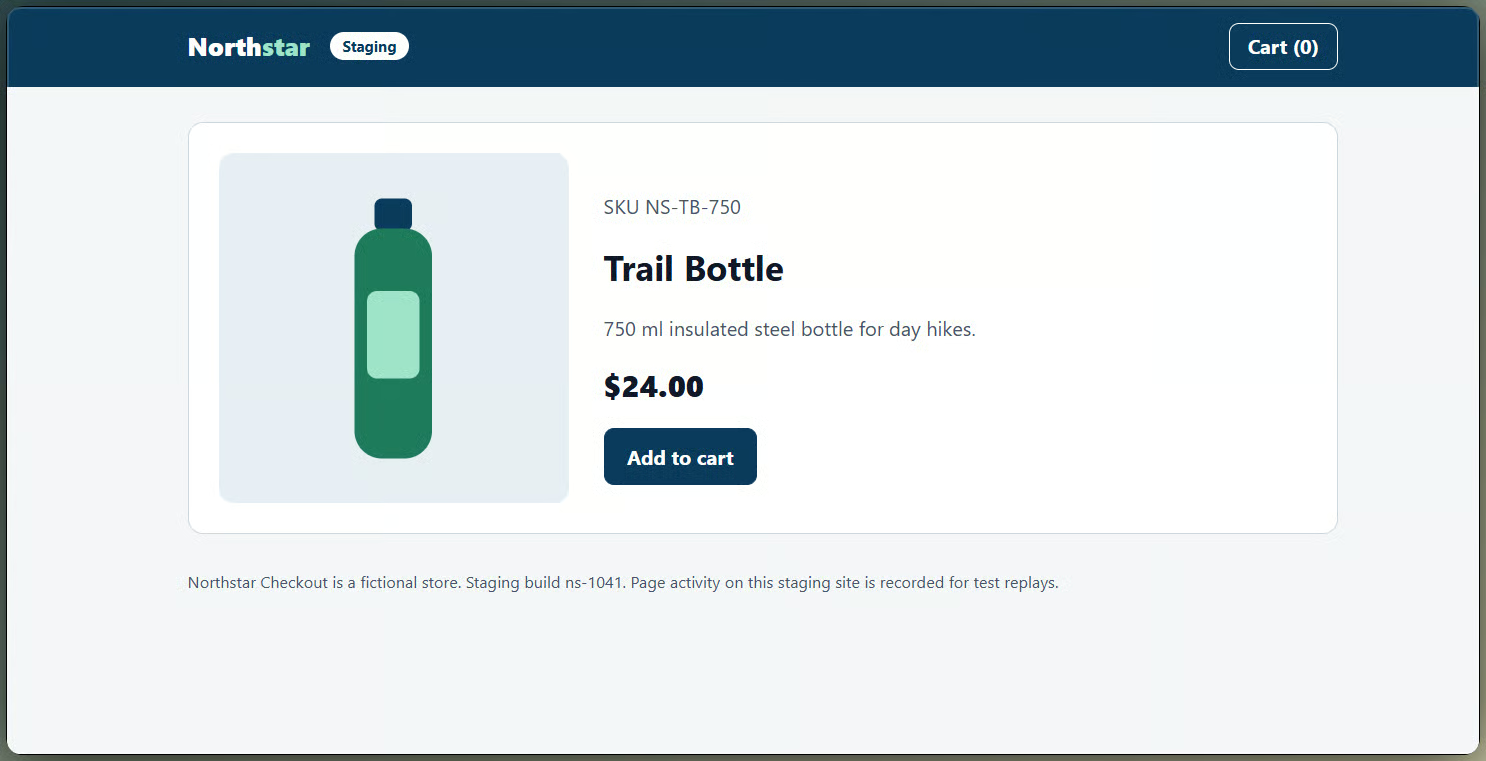
Page produit Northstar avant le test. Image de l'auteur.
La build ns-1041 contient le bug, tandis que ns-1042 contient le correctif. Ajouter ?reset=1 à l'URL de départ d'une build vide le panier avant chaque test.
La demande QA est formulée comme un objectif. Ses critères d'acceptation demandent à l'agent de :
Une contrainte de sécurité séparée impose de ne jamais passer, soumettre ou payer une commande. La demande définit l'issue, pas les clics.
La build défectueuse additionne les prix unitaires sur la page de récapitulatif et oublie la quantité. Les deux pages affichent une quantité de 2, mais le sous-total du panier est 48,00 $ et celui du récapitulatif 24,00 $.
Le corrigé de référence est dans le code de l'application. Ni les instructions ni le message de tâche ne mentionnent le bug.
L'agent transmet l'ID de build et 4 valeurs observées via un seul outil de fonction, record_qa_result.
Le harnais vérifie d'abord que la build rapportée est bien celle testée, car les deux builds partagent le même hostname, puis compare les valeurs au corrigé.
Un outil de fonction n'est exécuté que si l'agent l'appelle. Un enregistrement manquant, une valeur manquante ou une build erronée donnent un résultat incomplete, qui ne compte jamais comme un succès.
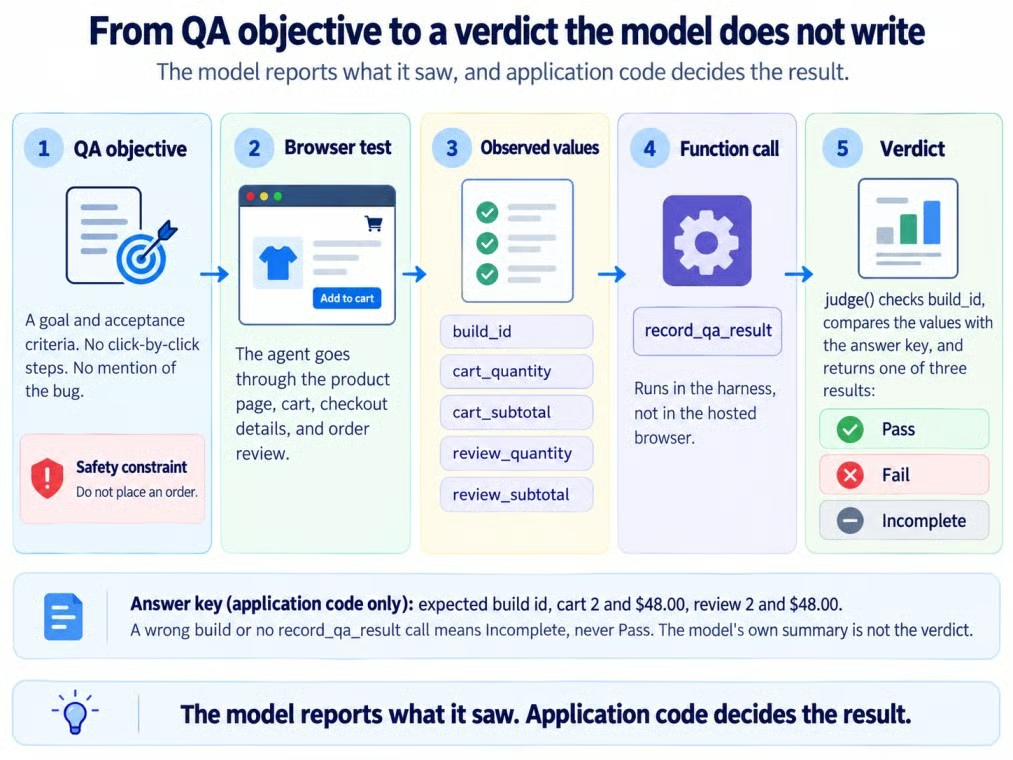
De l'objectif QA au verdict applicatif. Image de l'auteur.
Il vous faut Python, une clé API avec les bons scopes, l'accès à GPT-6 Astra, et une session avec Computer Use.
openai==3.22.1 (le SDK envoie pour vous l'en-tête OpenAI-Beta: agents=v1)api.agents.read, api.agents.write et api.responses.write, sur un projet autorisé à utiliser gpt-6-astraL'Agents API est en bêta publique, les noms de champs et comportements peuvent donc évoluer entre versions du SDK. Le dépôt fige la 3.22.1 dans requirements.txt.
Le navigateur hébergé a besoin d'une URL accessible ; le code utilise un déploiement Vercel de Northstar.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # puis ajoutez votre OPENAI_API_KEY
python run_qa.py
Pour en savoir plus sur l'isolement des dépendances, consultez notre guide sur les environnements virtuels. Sous macOS ou Linux, activez avec source .venv/bin/activate et copiez le fichier avec cp. Gardez la clé dans .env, jamais en dur dans le code.
L'expérience utilise GPT-6 Astra, le modèle des exemples Computer Use d'OpenAI. Notre présentation de GPT-6 Astra couvre le modèle lui‑même.
Le code utilise l'Agents API (client.beta.agents), pas le Agents SDK ni l'outil computer de la Responses API utilisé dans notre tutoriel GPT-6 Astra API.
Créez une session avec l'outil computer_use et un bureau hébergé par OpenAI, puis réutilisez‑la pour les deux tests :
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", défini explicitement
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True expose toutes les captures renvoyées par l'API, tandis que l'accès réseau restreint limite le navigateur à Northstar.
L'environnement utilise la taille par défaut medium (2 vCPU, 4 Go de RAM).
La fonction consigne ce que l'agent a observé. Si l'agent ne peut pas lire l'une des 4 valeurs (quantité ou sous-total), il doit renseigner ce champ à null.
Lister chaque propriété sous required indique au modèle de répondre à toutes, en utilisant null pour ce qu'il n'a pas vu. Le harnais traite malgré tout un champ manquant comme incomplete :
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
Le harnais convertit chaque prix affiché en cents, vérifie l'ID de build et compare les valeurs au corrigé :
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Une valeur illisible ou manquante produit un verdict incomplete, jamais un succès.
Un rapport provenant de la mauvaise build renvoie incomplete avant que ses valeurs puissent influer sur le verdict.
Les mêmes instructions régissent les deux tests :
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Seule la version du site change entre les tests.
Ouvrez le flux d'événements, envoyez l'objectif QA une fois, puis traitez les approbations et appels de fonction jusqu'à la fin du tour.
Ouvrez d'abord le flux d'événements, puis envoyez la tâche une seule fois :
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Les flux ne rejouent pas les événements manqués. Si le flux tombe, ouvrez‑en un nouveau, puis récupérez la session et ses éléments sauvegardés tant qu'il reste connecté.
Le message de tâche indique la build, les critères d'acceptation et la contrainte de sécurité, mais rien sur le bug :
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Conservez l'ID de session pour le re-test.
Le navigateur hébergé demande une approbation avant d'ouvrir chaque nouvelle origine de site.
Le flux émet agent.session.requires_action ; récupérez la session et lisez required_actions pour obtenir la demande.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Le travail du navigateur apparaît sous forme d'éléments computer_use_call, chacun avec un court titre et un statut. Le flux d'événements du premier test a montré :
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Environ 47 secondes se sont écoulées avant la première activité du navigateur.
Les 7 éléments computer_use_call se sont terminés, mais le statut d'un élément n'est pas le verdict QA ; c'est le résultat de la fonction qui fait foi.
Oui. Plus important encore, l'appel de fonction a isolé l'échec à un seul champ : le sous-total du récapitulatif.
L'appel record_qa_result contenait :
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Toutes les valeurs correspondent à la page défectueuse. La quantité est restée à 2 sur la page de récapitulatif, ce qui écarte un écart visible sur la quantité.
judge() a confirmé la build ns-1041, comparé les 4 valeurs aux attentes, et trouvé que seul le sous-total du récapitulatif était erroné.
C'est le seul format de verdict utilisé dans l'expérience :
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Une fois le correctif déployé, envoyez un message supplémentaire dans la même session.
Ce petit test de non-régression réutilise les mêmes instructions et la même fonction de verdict.
Le correctif de la build ns-1042 tient en une ligne de JavaScript de Northstar :
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);Le lien de départ inclut ?reset=1, donc le re‑test commence avec un panier vide. Ensuite, le suivi part dans la même session :
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
Le re‑test a conservé l'environnement hébergé et n'a pas nécessité de nouvelle approbation d'origine. Ne dépendez pas de l'état du navigateur, car les cookies peuvent expirer et le recyclage de l'environnement les efface.
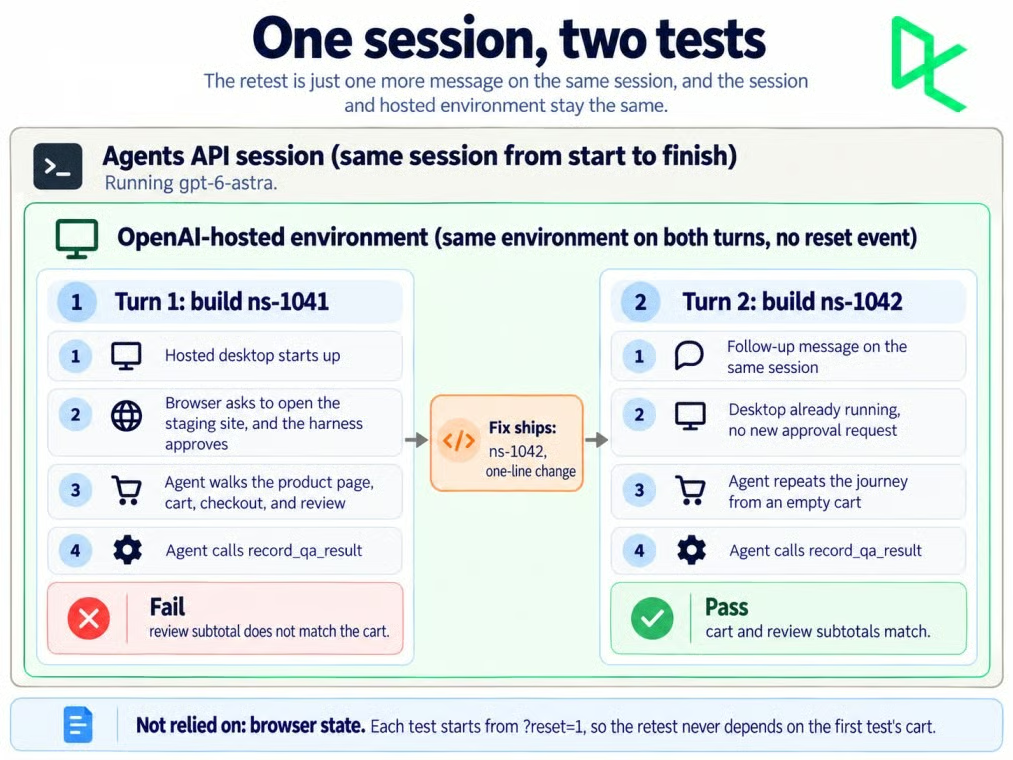
Une seule session a porté les deux tests QA. Image de l'auteur.
Un sandbox hébergé peut être supprimé si l'activité et les keep‑alives cessent pendant 1 heure. Surveillez agent.session.environment.reset et démarrez chaque re‑test depuis un état connu.
Oui. Le re‑test a rapporté une quantité panier de 2 et 48,00 $, puis une quantité récapitulatif de 2 et 48,00 $, et judge() a renvoyé un succès sans échec.
Il a pris 38,9 secondes avec 5 éléments d'activité navigateur, contre 96,5 secondes et 7 éléments pour le premier test, qui incluait 47 secondes d'attente avant la première activité.
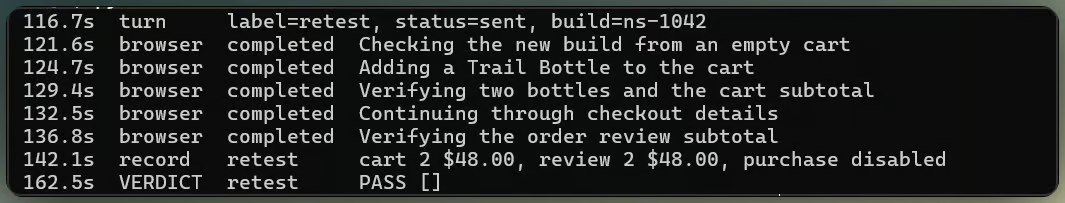
Le re‑test a réussi sans nouvelle approbation. Image de l'auteur.
Pas nécessairement. Même avec include_screenshots activé, le premier test a renvoyé 2 captures d'écran pour 7 actions, et le re‑test 2 pour 5.
Certains éléments renvoient output: null, donc les rapports ne peuvent pas supposer une image pour chaque action.
Le flux d'événements n'est pas un flux vidéo continu du navigateur hébergé ; il renvoie des actions navigateur et des captures quand elles sont disponibles.
Northstar utilise rrweb pour capturer les changements du DOM et les interactions, les envoyer au même hôte et rejouer les deux parcours ci‑dessous.
Le navigateur de l'agent sur les deux builds de préproduction. Vidéo de l'auteur.
La relecture montre la quantité 2 et 24,00 $ sur ns-1041, puis 48,00 $ sur ns-1042 ; le bouton d'achat désactivé reste intact.
Le dépôt inclut également un petit visualiseur Streamlit pour le verdict sauvegardé, les preuves navigateur, les détails de session, le coût et le journal des événements.
Les compteurs d'usage indicatifs ont produit une estimation standard de 0,9469 $ en tokens pour les deux tests.
| Métrique | Test 1 (ns-1041) |
Re‑test (ns-1042) |
|---|---|---|
| Tokens en entrée | 255 550 | 223 533 |
| Tokens d'entrée mis en cache | 217 041 (84,9 %) | 219 449 (98,2 %) |
| Tokens en sortie | 982 | 708 |
| Coût estimé en tokens | 0,6512 $ | 0,2957 $ |
| Durée du tour | 96,5 secondes | 38,9 secondes |
| Actions navigateur | 7 | 5 |
Le re‑test a utilisé moins de tokens en entrée, dont 98,2 % issus du cache d'invite. Ensemble, les 2 tests coûtent 0,9469 $.
Le guide d'observabilité précise que l'usage peut être null s'il est inconnu et que les comptages enregistrés peuvent évoluer ; re‑vérifiez avant de supprimer la session.
Lors de mes essais, voici les tarifs standard de GPT-6 Astra sur la page de tarification d'OpenAI :
| Type de token | Tarif pour 1 M de tokens |
|---|---|
| Entrée | 10,00 $ |
| Entrée mise en cache | 1,00 $ |
| Écritures de cache | 12,50 $ |
| Sortie | 50,00 $ |
Le seuil long-contexte de 272 K s'applique par requête. L'entrée combinée des deux tours est restée en dessous, donc aucune requête n'a pu déclencher les tarifs long-contexte plus élevés.
L'estimation ne peut toujours pas reproduire la facture finale, car l'usage Agents API est indicatif et n'expose pas les écritures de cache séparément.
Le sandbox hébergé est facturé séparément aux tarifs standard des conteneurs. La page de tarification liste le conteneur medium 4 Go à 0,12 $ par session de 20 minutes, avec une facturation à la minute pour les sessions éligibles et un minimum de 5 minutes.
La sécurité dépend de ce que le navigateur peut atteindre et de ce que la page lui permet de faire.
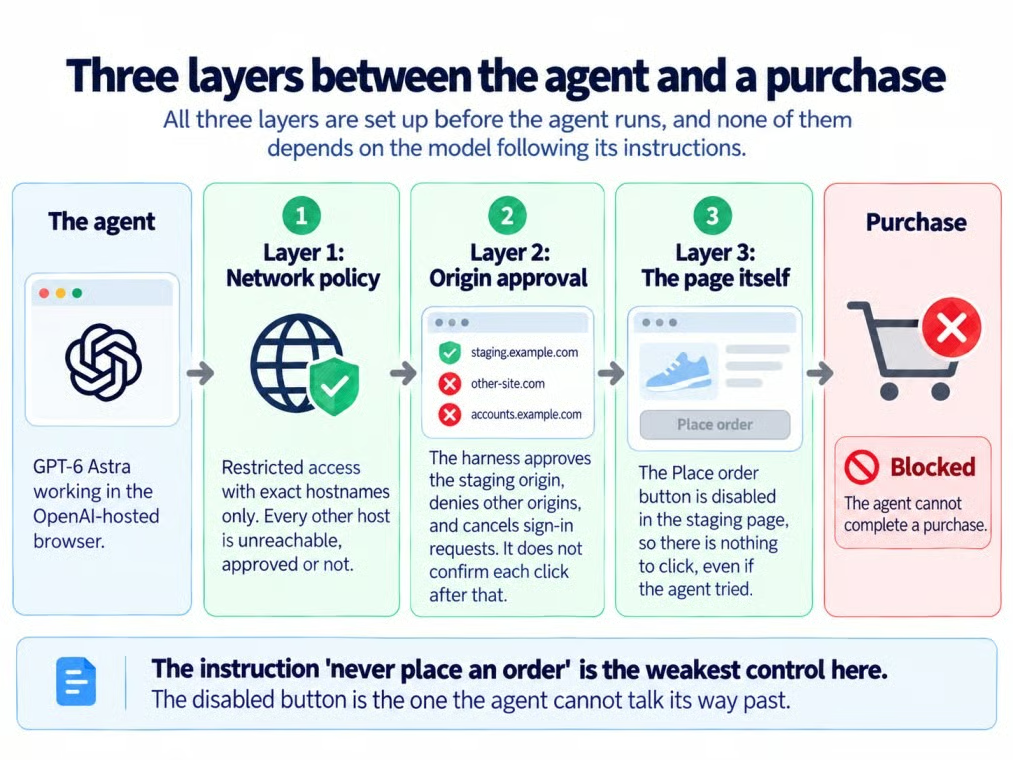
Trois couches entre l'agent et le checkout. Image de l'auteur
La politique réseau contrôle quels hôtes le navigateur peut atteindre, et l'approbation d'origine décide s'il peut ouvrir chaque nouvelle origine. Aucune ne confirme les actions individuelles du navigateur.
Approuver northstar-checkout-staging.vercel.app n'approuve donc pas chaque clic séparément.
La règle « pas d'achat » est une contrainte de sécurité, et purchase_control est conservé comme preuve plutôt que jugé comme un critère d'acceptation. Le bouton « Place order » désactivé de Northstar est le contrôle qui la fait respecter.
En mode restricted, le navigateur ne peut atteindre que les noms d'hôtes que vous listez.
Le guide du sandbox d'OpenAI accepte de 1 à 100 noms d'hôtes exacts, sans jokers, protocoles, chemins ni ports. Les CDNs, sous-domaines et cibles de redirection exigent des entrées séparées.
Les captures et enregistrements rrweb contiennent tout ce que la page affiche, donc Northstar utilise des données fictives, n'a pas de connexion et signale l'enregistrement en pied de page.
L'enregistreur masque les saisies, mais un déploiement en production nécessiterait tout de même une politique de données et un masquage adaptés à la page.
L'Agents API prend en charge la résidence des données uniquement aux États‑Unis et n'est pas éligible au Zero Data Retention (ZDR), même avec un sandbox auto‑hébergé.
Enregistrez les résultats et captures nécessaires, puis supprimez la session au lieu de laisser un checkout de préproduction dans un état de session conservé.
Supprimer la session Agents API ne supprime pas les enregistrements rrweb stockés par le site. Retirez‑les séparément conformément à la politique d'enregistrement.
Northstar a échoué lorsque les sous‑totaux panier et récapitulatif ont divergé, puis a réussi après correctif dans la même session. C'est le harnais, et non le résumé du modèle, qui a tranché les deux verdicts.
Je conserverais des tests de régression scriptés pour les invariants connus et j'utiliserais des agents navigateurs pilotés par objectif pour les parcours exploratoires, plus difficiles à exprimer sous forme d'assert. L'agent explore ; le code applicatif décide.
Pour les bases de l'API, je vous recommande notre cours Working with the OpenAI API.
Meilleures formations DataCamp
Cours
Cursus
Cours
blog
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
DataCamp Team
4 min
Tutoriel
Sejal Jaiswal
9 min
Tutoriel
Satyabrata Pal
15 min



