คอร์ส
การทำงานกับ OpenAI API
3 ชม.
179.5K
ลองนึกภาพขั้นตอนชำระเงินที่ตะกร้าแสดง $48 แต่หน้ารีวิวแสดง $24 ลูกค้าเห็นยอดรวมสองค่าในขั้นตอนเดียวกัน
ทีมงานมักรันทดสอบประกันคุณภาพ (QA) ของโฟลว์นี้ด้วยสคริปต์เบราว์เซอร์: คลิกปุ่มนี้ เปิดหน้านั้น ตรวจค่านี้ การทดสอบแบบสคริปต์จะตรวจเฉพาะสถานะที่ผู้เขียนระบุไว้เท่านั้น
เอเจนต์ AI คือโมเดลที่สามารถลงมือทำเพื่อบรรลุเป้าหมาย Agents API ของ OpenAI จัดการลูปของเอเจนต์และเก็บงานไว้ในเซสชัน ในบทเรียนนี้ Computer Use ยังให้บริการเบราว์เซอร์แบบโฮสต์ด้วย
Northstar Checkout เป็นร้านทดสอบสมมติที่ซ่อนบั๊กที่ยอดย่อยไว้
เอเจนต์จะได้รับผลลัพธ์ขั้นตอนชำระเงินที่ถูกต้อง แต่จะไม่ได้รับตำแหน่งของบั๊กหรือรายการปุ่มที่ต้องกด โปรแกรม Python ขนาดเล็กที่เรียกว่า harness จะเปรียบเทียบค่าที่เอเจนต์รายงาน แล้วขอให้ทดสอบร้านที่แก้ไขแล้วในเซสชันเดียวกัน
ในบทเรียนนี้ จะครอบคลุมวิธี:
โค้ดและการวัดผลใช้แพ็กเกจ Python openai เวอร์ชัน 3.22.1
ถ้ามีเวลาเพียงนาทีเดียว นี่คือประเด็นสำคัญ
computer_use_call 7 และ 5 รายการตามลำดับนี่คือร้านทดสอบหนึ่งร้านที่มีบั๊กที่ฝังไว้หนึ่งจุด ไม่ใช่เกณฑ์ชี้วัดความน่าเชื่อถือ
Computer Use เป็นเครื่องมือใน OpenAI Agents API ที่ให้อเอเจนต์ใช้งานเบราว์เซอร์ที่รันบนเซิร์ฟเวอร์ของ OpenAI โค้ดของคุณจะติดตามอีเวนต์ของเซสชันและตอบคำขอของมัน OpenAI ระบุการทดสอบเว็บไซต์เป็นหนึ่งในกรณีใช้งาน
OpenAI จัดการลูปของเอเจนต์ เซสชัน และการกู้คืน เราได้ครอบคลุมพื้นฐานเหล่านี้ไว้ใน บทเรียน OpenAI Agents API
การตั้งค่า computer use แบบเก่า เช่นใน บทเรียน computer use ของ GPT-5.4 ทำให้โค้ดนักพัฒนาต้องรันลูปสกรีนช็อตและการคลิกเองแทน
ในการทำ QA บนเบราว์เซอร์ หน้าเว็บเองคือสิ่งที่อยู่ภายใต้การทดสอบ
การเรียก API ของขั้นตอนชำระเงินโดยตรงจะข้ามหน้าที่บั๊กของ Northstar อยู่ ดังนั้นเอเจนต์จึงเดินตามเส้นทางเดียวกับลูกค้า ตั้งแต่นหน้าสินค้า ไปยังตะกร้า ชำระเงิน และรีวิว
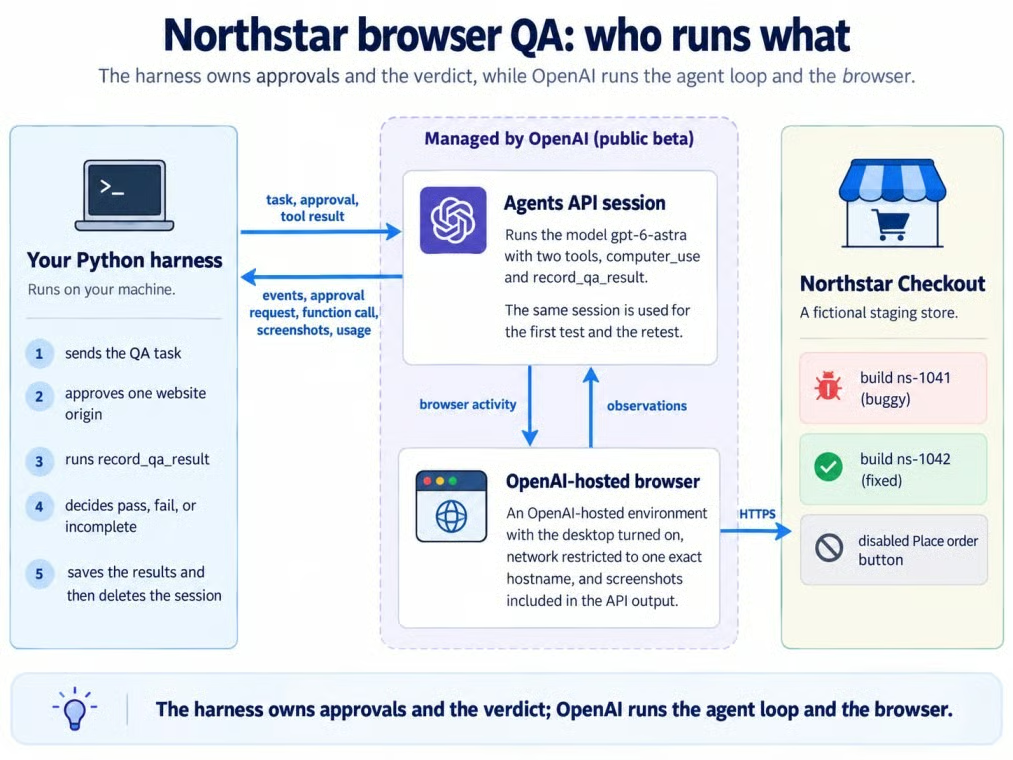
Harness, เซสชัน, เบราว์เซอร์แบบโฮสต์, และไซต์ staging ภาพโดยผู้เขียน
OpenAI จัดการเซสชันและเบราว์เซอร์ภายในพื้นที่สีเทา ส่วน harness และ Northstar อยู่นอกพื้นที่นั้น
โปรเจกต์นี้ประกอบด้วยร้าน staging สมมติ, harness ภาษา Python และหนึ่งเซสชันของ Agents API
โค้ดทั้งหมดอยู่ใน ที่เก็บ GitHub นี้
Northstar ขาย Trail Bottle ราคา $24 รายการเดียว การทดสอบไล่จากหน้าสินค้าไปตะกร้า ชำระเงิน และรีวิว; ไม่มีค่าจัดส่ง ภาษี ล็อกอิน หรือปุ่มซื้อที่ใช้งานได้
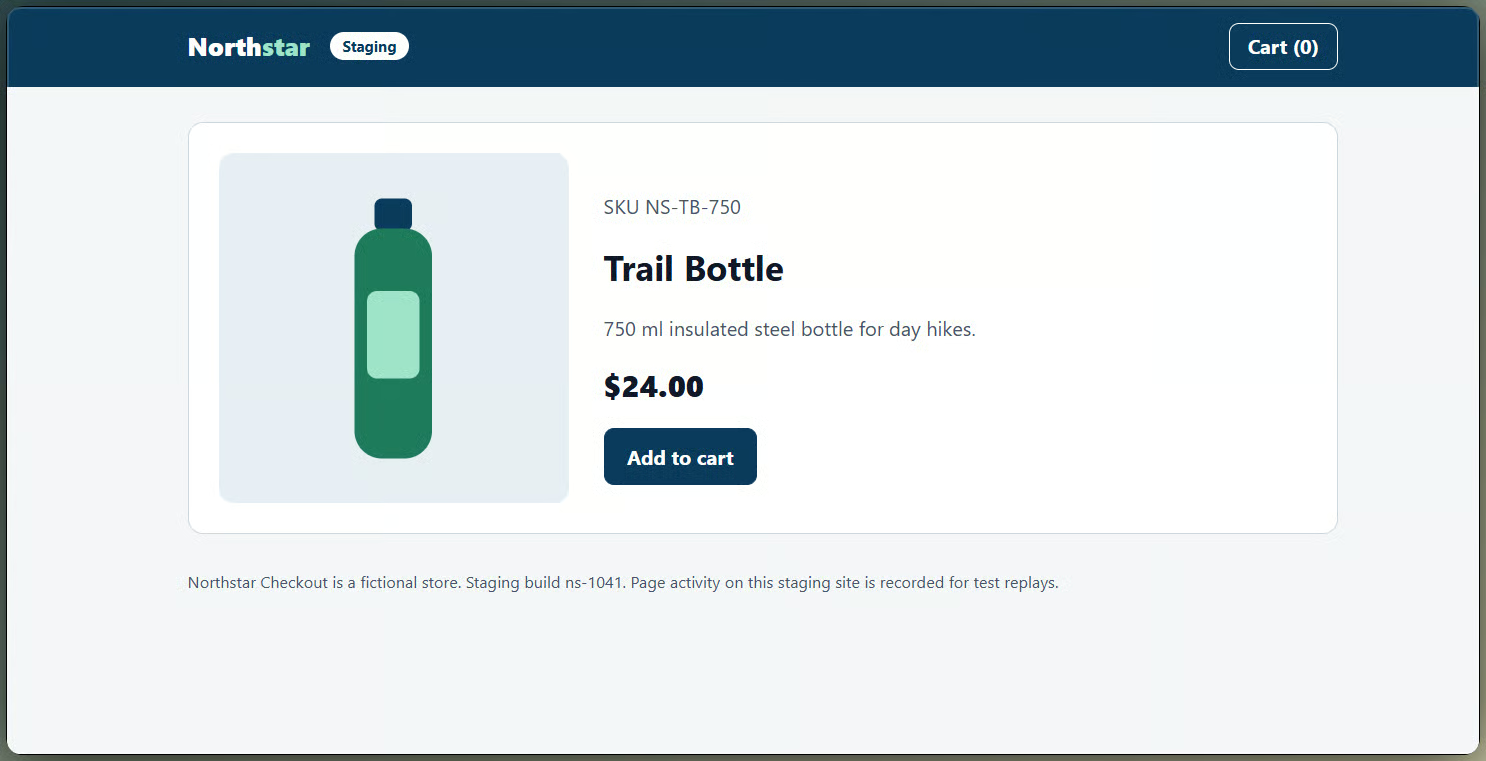
หน้าสินค้า Northstar ก่อนการทดสอบ ภาพโดยผู้เขียน
บิลด์ ns-1041 มีบั๊ก ส่วน ns-1042 มีการแก้ไข การเติม ?reset=1 ใน URL เริ่มต้นของแต่ละบิลด์จะล้างตะกร้าก่อนทดสอบ
คำขอ QA ถูกเขียนเป็นเป้าหมาย เกณฑ์การยอมรับขอให้เอเจนต์:
ข้อจำกัดด้านความปลอดภัยแยกต่างหากระบุว่า ห้ามสั่ง ส่ง หรือจ่ายเงินสำหรับคำสั่งซื้อ คำขอกำหนดผลลัพธ์ ไม่ใช่ชุดของการคลิก
บิลด์ที่มีบั๊กจะบวกเฉพาะราคาต่อหน่วยบนหน้ารีวิวและลืมคูณจำนวน ทั้งสองหน้าจะแสดงจำนวน 2 แต่ยอดย่อยในตะกร้าคือ $48.00 และยอดย่อยในหน้ารีวิวคือ $24.00
เฉลยอยู่ในโค้ดของแอปพลิเคชัน คำสั่งหรือข้อความงานไม่ได้เอ่ยถึงบั๊กแต่อย่างใด
เอเจนต์รายงานรหัสบิลด์และค่าที่สังเกต 4 ค่า ผ่านหนึ่ง ฟังก์ชันทูล ชื่อ record_qa_result
harness จะตรวจว่ารายงานบิลด์ตรงกับที่กำลังทดสอบก่อน เพราะทั้งสองบิลด์ใช้โฮสต์เนมเดียวกัน แล้วจึงเปรียบเทียบค่ากับเฉลย
ฟังก์ชันทูลจะทำงานก็ต่อเมื่อเอเจนต์เรียกใช้เท่านั้น การไม่มีเรคอร์ด ไม่มีค่า หรือบิลด์ไม่ตรง จะให้ผลลัพธ์เป็น incomplete ซึ่งจะไม่นับว่าผ่าน
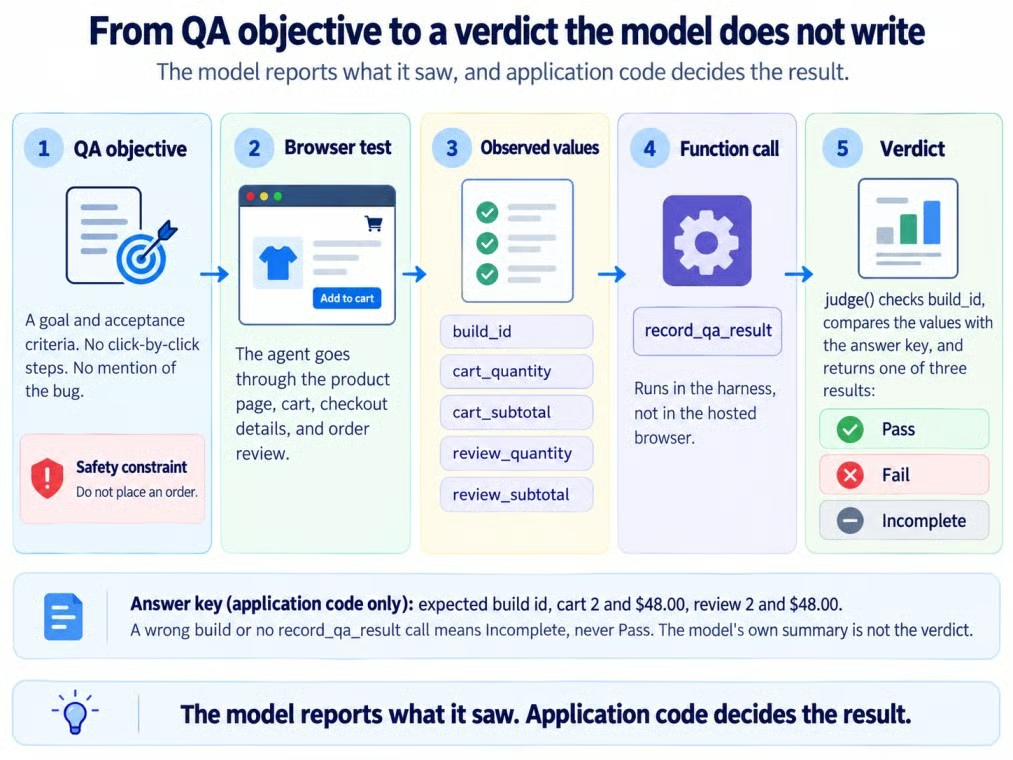
จากวัตถุประสงค์ QA ไปสู่คำตัดสินของแอป ภาพโดยผู้เขียน
ต้องมี Python, คีย์ API ที่กำหนดขอบเขตสิทธิ์, การเข้าถึง GPT-6 Astra และหนึ่งเซสชันที่เปิดใช้ Computer Use
openai==3.22.1 (SDK จะส่งเฮดเดอร์ OpenAI-Beta: agents=v1 ให้โดยอัตโนมัติ)api.agents.read, api.agents.write และ api.responses.write บนโปรเจกต์ที่ใช้ gpt-6-astra ได้Agents API อยู่ในช่วง public beta ดังนั้นชื่อฟิลด์และพฤติกรรมอาจเปลี่ยนระหว่างรุ่นของ SDK ที่เก็บโค้ดจึงปักหมุดเวอร์ชัน 3.22.1 ใน requirements.txt
เบราว์เซอร์แบบโฮสต์ต้องการ URL ที่เข้าถึงได้ จึงใช้ดีพลอย Northstar บน Vercel
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
ดูรายละเอียดการแยกการพึ่งพาเพิ่มเติมได้ในคู่มือ virtual environment บน macOS หรือ Linux ใช้ source .venv/bin/activate เพื่อเปิดใช้งาน และคัดลอกไฟล์ด้วย cp เก็บคีย์ไว้ใน .env ไม่ใส่ลงในโค้ด
การทดลองนี้ใช้ GPT-6 Astra ซึ่งเป็นโมเดลที่ใช้ในตัวอย่าง Computer Use ของ OpenAI ดูรายละเอียดโมเดลใน ภาพรวม GPT-6 Astra
โค้ดนี้ใช้ Agents API (client.beta.agents) ไม่ใช่ Agents SDK หรือเครื่องมือ computer ของ Responses API ที่ใช้ใน บทเรียน GPT-6 Astra API
สร้างหนึ่งเซสชันที่มีเครื่องมือ computer_use และเดสก์ท็อปแบบโฮสต์ของ OpenAI แล้วใช้ซ้ำสำหรับทั้งสองการทดสอบ:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True ทำให้เข้าถึงสกรีนช็อตที่ API ส่งกลับมาได้ ขณะที่ การจำกัดการเข้าถึงเครือข่าย บังคับให้เบราว์เซอร์เปิดได้เฉพาะ Northstar
สภาพแวดล้อมใช้ขนาดเริ่มต้น medium (2 vCPU, RAM 4 GB)
ฟังก์ชันนี้บันทึกสิ่งที่เอเจนต์สังเกต หากเอเจนต์อ่านค่าใดค่าหนึ่งจาก 4 ค่าของจำนวนหรือยอดย่อยไม่ได้ ต้องรายงานฟิลด์นั้นเป็น null
การใส่ทุกพร็อพเพอร์ตีไว้ใต้ required บอกโมเดลให้ตอบทุกฟิลด์ โดยใช้ null สำหรับสิ่งที่มองไม่เห็น อย่างไรก็ดี harness จะถือว่าฟิลด์ที่หายไปเป็น incomplete อยู่ดี:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
harness จะแปลงราคาที่แสดงเป็นเซ็นต์ ยืนยันรหัสบิลด์ และเทียบค่ากับเฉลย:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
ค่าที่อ่านไม่ได้หรือหายไปจะให้คำตัดสินเป็น incomplete เสมอ ไม่เคยนับว่าผ่าน
รายงานจากบิลด์ที่ผิดจะคืนค่า incomplete ก่อนที่ค่าของมันจะมีผลกับคำตัดสิน
ใช้คำสั่งเดียวกันกับการทดสอบทั้งสอง:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
มีเพียงบิลด์ของเว็บไซต์ที่เปลี่ยนไประหว่างการทดสอบ
เปิดสตรีมอีเวนต์ ส่งวัตถุประสงค์ QA หนึ่งครั้ง จากนั้นจัดการการอนุมัติและการเรียกฟังก์ชันจนกว่ารอบจะเสร็จ
เปิดสตรีมอีเวนต์ก่อน จากนั้นจึงส่งงานเพียงครั้งเดียว:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
สตรีมจะไม่เล่นอีเวนต์ที่พลาดไปซ้ำ หากสตรีมหลุด ให้เปิดใหม่ แล้วดึงข้อมูลเซสชันและรายการที่บันทึกไว้ขณะยังเชื่อมต่ออยู่
ข้อความงานระบุบิลด์ เกณฑ์การยอมรับ และข้อจำกัดด้านความปลอดภัย แต่ไม่เอ่ยถึงบั๊ก:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
เก็บ session ID ไว้สำหรับการทดสอบซ้ำ
เบราว์เซอร์แบบโฮสต์จะขออนุมัติก่อนเปิดเว็บไซต์ origin ใหม่ทุกครั้ง
สตรีมส่งอีเวนต์ agent.session.requires_action; ดึงข้อมูลเซสชันแล้วอ่าน required_actions เพื่อดูคำขอ
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])งานของเบราว์เซอร์จะแสดงเป็นรายการ computer_use_call แต่ละรายการมีหัวเรื่องสั้น ๆ และสถานะ สตรีมอีเวนต์ของการทดสอบแรกแสดงว่า:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
ใช้เวลาประมาณ 47 วินาทีก่อนกิจกรรมเบราว์เซอร์รายการแรก
รายการ computer_use_call ทั้ง 7 รายการเสร็จสมบูรณ์ แต่สถานะของรายการไม่ใช่คำตัดสิน QA; ผลลัพธ์ของฟังก์ชันต่างหากที่เป็นตัวตัดสิน
ได้ และที่สำคัญกว่านั้น การเรียกฟังก์ชันช่วยแยกความล้มเหลือให้เหลือเพียงฟิลด์เดียว: ยอดย่อยในหน้ารีวิว
การเรียก record_qa_result มีข้อมูลดังนี้:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
ทุกค่าตรงกับหน้าที่มีบั๊ก จำนวนยังคงเป็น 2 บนหน้ารีวิว ซึ่งตัดความเป็นไปได้ของจำนวนไม่ตรงที่มองเห็นได้
judge() ยืนยันบิลด์ ns-1041 เทียบ 4 ค่ากับค่าที่คาดหวัง และพบว่ามีเพียงยอดย่อยหน้ารีวิวที่ผิด
นี่คือคำตัดสินเดียวที่การทดลองใช้อยู่:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}หลังจากปล่อยการแก้ไขแล้ว ให้ส่งข้อความอีกหนึ่งครั้งไปยังเซสชันเดิม
การทดสอบถดถอย ขนาดเล็กนี้ใช้คำสั่งและฟังก์ชันตัดสินคำเดิม
การแก้ไขในบิลด์ ns-1042 เป็นโค้ด JavaScript ของ Northstar เพียงหนึ่งบรรทัด:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);ลิงก์เริ่มต้นมี ?reset=1 ดังนั้นการทดสอบซ้ำจะเริ่มจากตะกร้าว่าง แล้วจึงส่งข้อความติดตามไปยังเซสชันเดิม:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
การทดสอบซ้ำคงสภาพแวดล้อมแบบโฮสต์ไว้ และไม่ต้องอนุมัติ origin ใหม่ หลีกเลี่ยงการพึ่งพาสถานะของเบราว์เซอร์ เพราะคุ๊กกี้อาจหมดอายุ และการรีไซเคิลสภาพแวดล้อมจะล้างสถานะ
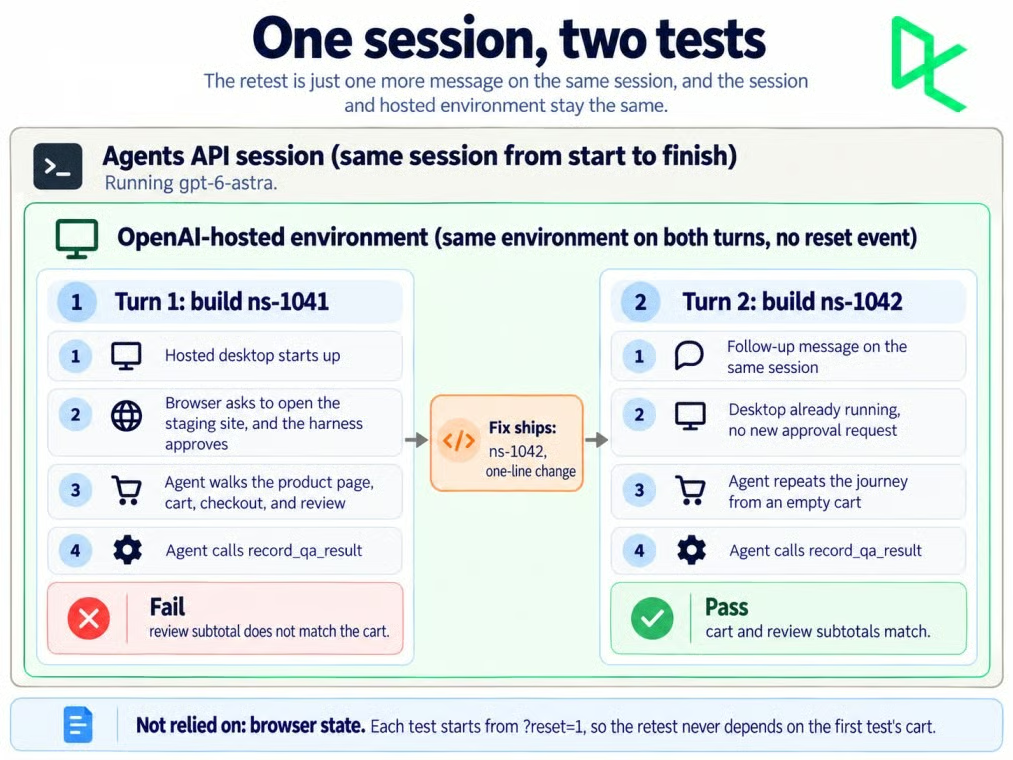
หนึ่งเซสชันรองรับการทดสอบ QA ทั้งสองครั้ง ภาพโดยผู้เขียน
sandbox แบบโฮสต์อาจถูกลบได้หากไม่มีการใช้งานและ keep-alive เกิน 1 ชั่วโมง ให้เฝ้าดู agent.session.environment.reset และเริ่มการทดสอบซ้ำแต่ละครั้งจากสถานะที่ทราบแน่
ผ่าน การทดสอบซ้ำรายงานจำนวนในตะกร้า 2 และ $48.00 จากนั้นจำนวนหน้ารีวิว 2 และ $48.00 และ judge() คืนผลผ่านโดยไม่มีเช็คที่ล้มเหลว
ใช้เวลา 38.9 วินาทีพร้อมรายการกิจกรรมเบราว์เซอร์ 5 รายการ เทียบกับ 96.5 วินาทีและ 7 รายการในการทดสอบแรก ซึ่งรวมเวลารอ 47 วินาทีก่อนเริ่มกิจกรรมเบราว์เซอร์
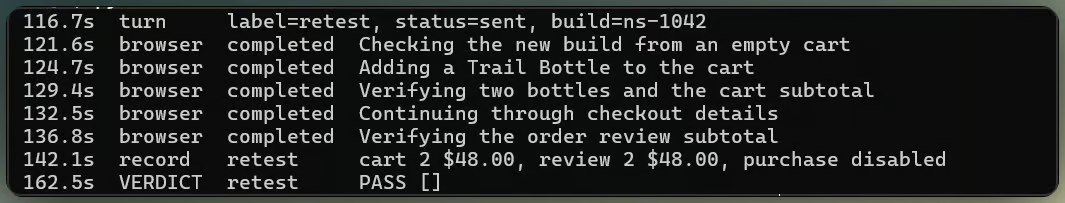
การทดสอบซ้ำผ่านโดยไม่ต้องอนุมัติใหม่ ภาพโดยผู้เขียน
ไม่จำเป็น แม้ตั้งค่า include_screenshots ไว้ การทดสอบแรกส่งคืนสกรีนช็อต 2 ภาพจากกิจกรรมเบราว์เซอร์ 7 รายการ และการทดสอบซ้ำส่งคืน 2 ภาพจาก 5 รายการ
บางรายการคืนค่า output: null ดังนั้นรายงานไม่ควรถือว่าจะมีรูปภาพสำหรับทุกกิจกรรม
สตรีมอีเวนต์ไม่ใช่วิดีโอต่อเนื่องของเบราว์เซอร์แบบโฮสต์ มันส่งคืนรายการกิจกรรมของเบราว์เซอร์และสกรีนช็อตเมื่อมี
Northstar ใช้ rrweb เพื่อบันทึกการเปลี่ยนแปลงและการโต้ตอบของ Document Object Model (DOM) ส่งไปยังโฮสต์เดียวกัน และเล่นซ้ำทั้งสองเส้นทางด้านล่าง
เบราว์เซอร์ของเอเจนต์บนบิลด์ staging ทั้งสอง วิดีโอโดยผู้เขียน
การเล่นซ้ำแสดงจำนวน 2 และ $24.00 บน ns-1041 แล้วเป็น $48.00 บน ns-1042; ปุ่มสั่งซื้อที่ถูกปิดการใช้งานยังคงไม่ถูกกด
ที่เก็บยังมีตัวดู Streamlit ขนาดเล็กสำหรับคำตัดสินที่บันทึก หลักฐานจากเบราว์เซอร์ รายละเอียดเซสชัน ค่าใช้จ่าย และบันทึกอีเวนต์
ตัวนับการใช้งานแบบประมาณการให้มูลค่าโทเคนอัตรามาตรฐาน $0.9469 สำหรับทั้งสองการทดสอบ
| ตัวชี้วัด | ทดสอบ 1 (ns-1041) |
ทดสอบซ้ำ (ns-1042) |
|---|---|---|
| โทเคนขาเข้า | 255,550 | 223,533 |
| โทเคนขาเข้าที่แคชไว้ | 217,041 (84.9%) | 219,449 (98.2%) |
| โทเคนขาออก | 982 | 708 |
| ค่าโทเคนโดยประมาณ | $0.6512 | $0.2957 |
| เวลาเทิร์น | 96.5 วินาที | 38.9 วินาที |
| รายการกิจกรรมเบราว์เซอร์ | 7 | 5 |
การทดสอบซ้ำใช้โทเคนขาเข้าน้อยลง และ 98.2% มาจาก แคชพรอมต์ รวมกันทั้งสองการทดสอบมีค่าใช้จ่าย $0.9469
คู่มือการสังเกตการณ์ ระบุว่าการใช้งานอาจเป็น null เมื่อไม่ทราบ และจำนวนที่บันทึกอาจเปลี่ยนแปลงได้ จึงควรตรวจสอบอีกครั้งก่อนลบเซสชัน
ขณะรันทดสอบ อัตรามาตรฐานของ GPT-6 Astra บนหน้าราคา OpenAI เป็นดังนี้:
| ประเภทโทเคน | อัตราต่อ 1M โทเคน |
|---|---|
| ขาเข้า | $10.00 |
| ขาเข้าที่แคช | $1.00 |
| การเขียนแคช | $12.50 |
| ขาออก | $50.00 |
เกณฑ์ long-context ที่ 272K ใช้ต่อคำขอ แต่ละเทิร์นรวมโทเคนขาเข้าต่ำกว่าเกณฑ์นี้ ดังนั้นไม่มีคำขอใดทริกเกอร์อัตรา long-context ที่สูงกว่า
ถึงอย่างนั้น การประมาณก็ไม่สามารถทำซ้ำใบแจ้งหนี้สุดท้ายได้ เพราะการใช้งาน Agents API เป็นแบบประเมินโดยประมาณ และไม่เปิดเผยจำนวนการเขียนแคชแยกต่างหาก
sandbox แบบโฮสต์คิดค่าบริการแยกต่างหากตามอัตราคอนเทนเนอร์มาตรฐาน หน้าราคา ระบุคอนเทนเนอร์ medium ขนาด 4 GB ที่ $0.12 ต่อเซสชัน 20 นาที โดยเซสชันคอนเทนเนอร์ที่เข้าเงื่อนไขคิดตามนาทีและมีขั้นต่ำ 5 นาที
ความปลอดภัยขึ้นกับสิ่งที่เบราว์เซอร์เข้าถึงได้และสิ่งที่หน้าเว็บอนุญาตให้ทำ
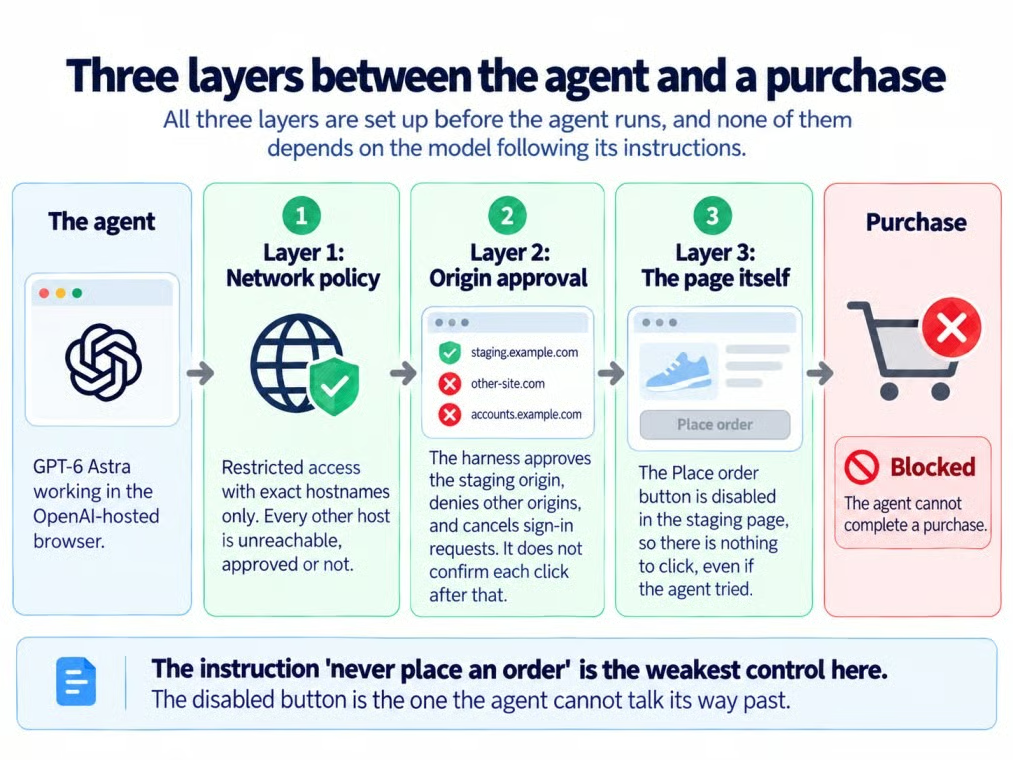
สามชั้นระหว่างเอเจนต์กับการเช็คเอาต์ ภาพโดยผู้เขียน
นโยบายเครือข่ายควบคุมว่าเบราว์เซอร์เข้าถึงโฮสต์ใดได้บ้าง และการอนุมัติ origin ตัดสินว่าอนุญาตให้เปิด origin ใหม่แต่ละแห่งได้หรือไม่ ทั้งสองอย่างไม่ยืนยันการกระทำแต่ละคลิกของเบราว์เซอร์
ดังนั้นการอนุมัติ northstar-checkout-staging.vercel.app จึงไม่ได้อนุมัติการคลิกแต่ละครั้งโดยปริยาย
กฎห้ามซื้อเป็นข้อจำกัดด้านความปลอดภัย และ purchase_control ถูกบันทึกเป็นหลักฐาน ไม่ใช่ตัดสินเป็นเกณฑ์การยอมรับ ปุ่ม "Place order" ที่ปิดการใช้งานของ Northstar คือกลไกควบคุมที่บังคับใช้กฎนี้
ภายใต้ค่า restricted เบราว์เซอร์จะเข้าถึงได้เฉพาะโฮสต์เนมที่ระบุไว้
คู่มือ sandbox ของ OpenAI ยอมรับโฮสต์เนมที่แน่นอน 1 ถึง 100 รายการ โดยไม่รองรับไวล์การ์ด โปรโตคอล พาธ หรือพอร์ต CDN ซับโดเมน และปลายทางรีไดเร็กต์ต้องใส่เป็นรายการแยกต่างหาก
สกรีนช็อตและการบันทึก rrweb มีทุกอย่างที่หน้าเว็บแสดง ดังนั้น Northstar จึงใช้ข้อมูลสมมติ ไม่มีล็อกอิน และประกาศการบันทึกไว้ในส่วนท้าย
ตัวบันทึกจะปิดบังข้อมูลที่ป้อน แต่ดีพลอยจริงยังต้องมีนโยบายข้อมูลและการปิดบังที่เหมาะสมกับหน้า
Agents API รองรับการเก็บข้อมูลเฉพาะในสหรัฐอเมริกา และไม่สามารถใช้ Zero Data Retention (ZDR) ได้ แม้กับ sandbox ที่โฮสต์เอง
บันทึกผลลัพธ์และสกรีนช็อตที่ต้องการ แล้วลบเซสชัน แทนที่จะปล่อยให้ขั้นตอนชำระเงินใน staging ค้างอยู่ในสถานะเซสชันที่ถูกเก็บไว้
การลบเซสชันของ Agents API ไม่ได้ลบการบันทึก rrweb ที่จัดเก็บโดยไซต์ ต้องลบแยกต่างหากตามนโยบายการบันทึก
Northstar ล้มเหลวเมื่อยอดย่อยในตะกร้าและหน้ารีวิวต่างกัน จากนั้นผ่านหลังแก้ไขในเซสชันเดียวกัน ทั้งหมดนี้ harness ต่างหากที่ตัดสินคำตัดสิน ไม่ใช่สรุปของโมเดล
แนะนำให้คงการทดสอบถดถอยแบบสคริปต์สำหรับอินเวเรียนต์ที่ทราบดี และใช้เอเจนต์เบราว์เซอร์แบบกำหนดเป้าหมายสำหรับการสำรวจเส้นทางที่ยากจะนิยามเป็น assertion เอเจนต์ทำการสำรวจ; โค้ดแอปเป็นผู้ตัดสิน
สำหรับพื้นฐาน API แนะนำคอร์ส Working with the OpenAI API ของเรา
คอร์สยอดนิยมของ DataCamp
คอร์ส
แทร็ก
คอร์ส