
Cursus
Werken met de OpenAI API
3 uur
179.5K
Stel je een checkout voor die $48 in de winkelwagen toont en $24 op de beoordelingspagina. De klant ziet twee totalen in dezelfde checkout.
Teams voeren doorgaans quality assurance (QA)-tests op deze flow uit met een browserscript: klik op deze knop, open die pagina, controleer deze waarde. Een gescripte test controleert alleen de toestanden die de auteur heeft vastgelegd.
Een AI-agent is een model dat acties kan ondernemen richting een doel. OpenAI's Agents API beheert de agent-loop en bewaart zijn werk in een sessie. In deze tutorial levert Computer Use ook de gehoste browser.
Northstar Checkout is een fictieve testwinkel met een verborgen bug in het subtotaal.
De agent ontvangt het juiste checkoutresultaat, maar niet de locatie van de bug of een lijst met knoppen om in te drukken. Een klein Python-programma, de harness genoemd, vergelijkt de waarden die de agent rapporteert en vraagt vervolgens in dezelfde sessie om de gefixte winkel te testen.
In deze tutorial behandel ik hoe je:
De code en metingen gebruiken versie 3.22.1 van het Python-pakket openai.
Heb je maar een minuut, dan zijn dit de belangrijkste punten.
computer_use_call-items.Dit is één testwinkel met één geplante bug, geen betrouwbaarheidstest.
Computer Use is een tool in de OpenAI Agents API waarmee een agent een browser kan bedienen die op de servers van OpenAI draait. Je code volgt de gebeurtenissen van de sessie en beantwoordt de verzoeken. OpenAI noemt website testen als een toepassing.
OpenAI beheert de agent-loop, de sessie en herstel. Onze OpenAI Agents API-tutorial behandelt die basis.
Oudere computer-use-setups, zoals die in onze GPT-5.4 computer use-tutorial, laten ontwikkelaarscode in plaats daarvan de screenshot-en-actie-loop draaien.
Bij browser-QA is de pagina zelf het testobject.
Een checkout-API direct aanroepen zou de pagina overslaan waar de bug van Northstar zit, dus de agent volgt hetzelfde pad als een klant, van de productpagina naar winkelwagen, checkout en review.
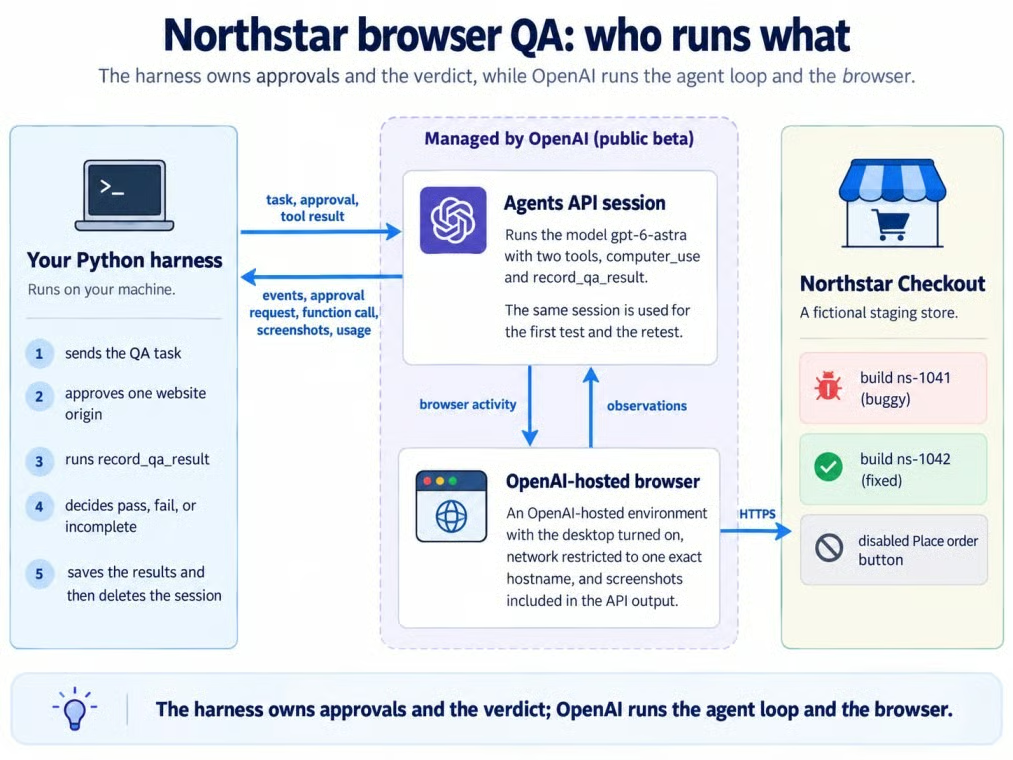
Harness, sessie, gehoste browser, staging-site. Afbeelding door de auteur.
OpenAI beheert de sessie en browser binnen de grijze zone; de harness en Northstar blijven daarbuiten.
Het project is een fictieve staging-winkel, een Python-harness en één Agents API-sessie.
De volledige code staat in deze GitHub-repository.
Northstar verkoopt één Trail Bottle van $24. De test gaat van product naar winkelwagen, checkout en review; er is geen verzending, belasting, login of werkende koopknop.
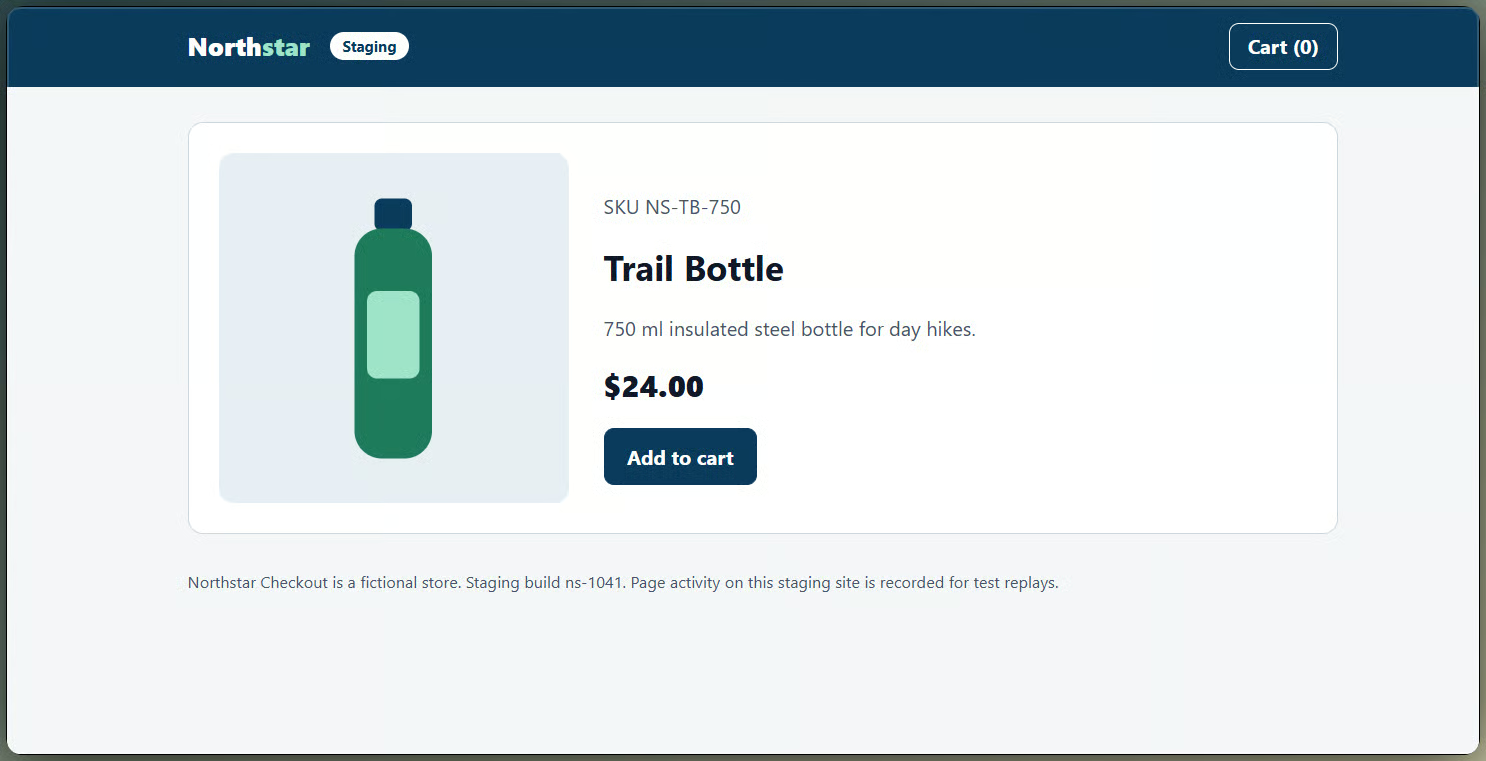
Northstar-productpagina vóór de test. Afbeelding door de auteur.
Build ns-1041 bevat de bug, en ns-1042 bevat de fix. ?reset=1 toevoegen aan de start-URL van een build leegt de winkelwagen vóór beide tests.
De QA-aanvraag is als een doel geformuleerd. De acceptatiecriteria vragen de agent om:
Een aparte veiligheidsrestrictie zegt om nooit een bestelling te plaatsen, in te dienen of te betalen. De aanvraag definieert de uitkomst, niet de kliks.
De buggy build telt op de review-pagina de eenheidsprijzen op en vergeet de hoeveelheid. Op beide pagina's staat hoeveelheid 2, maar het subtotaal in de winkelwagen is $48.00 en het review-subtotaal is $24.00.
De antwoordsleutel zit in de applicatiecode. Noch de instructies, noch het taakbericht noemen de bug.
De agent rapporteert de build-ID en 4 geobserveerde waarden via één function-tool, record_qa_result.
De harness controleert eerst of de gerapporteerde build de geteste build is, omdat beide builds een hostnaam delen, en vergelijkt vervolgens de waarden met de antwoordsleutel.
Een function-tool draait alleen als de agent hem aanroept. Een ontbrekend record, ontbrekende waarde of verkeerde build maakt het resultaat incomplete, wat nooit als een pass telt.
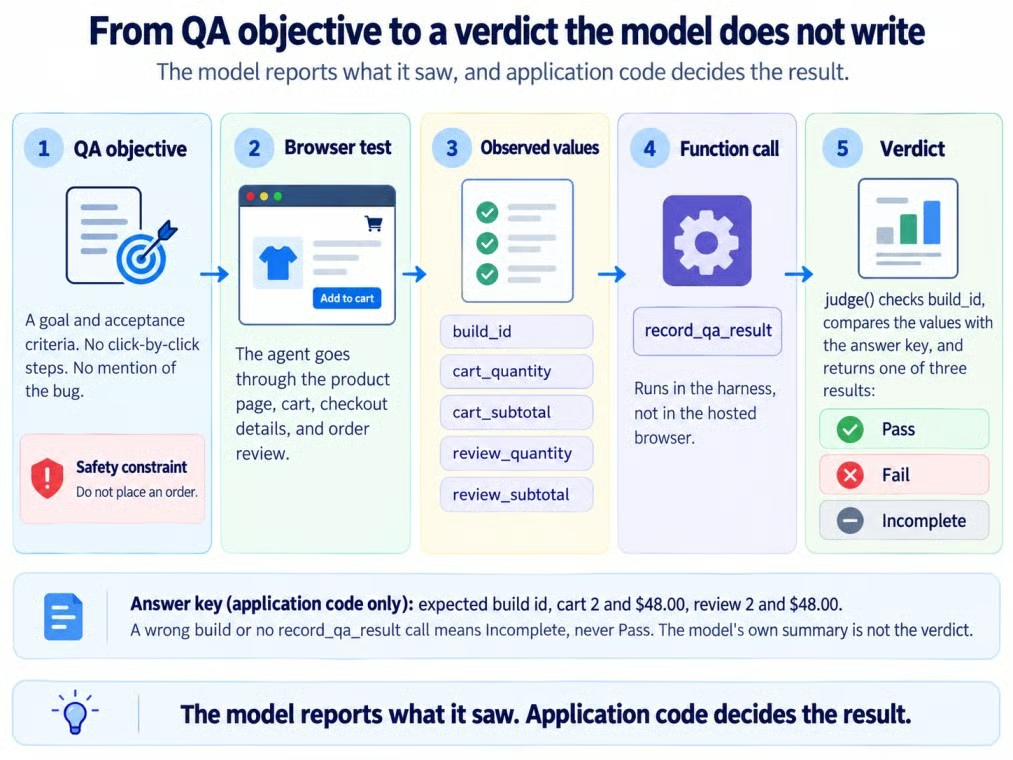
Van QA-doel naar applicatie-uitspraak. Afbeelding door de auteur.
Je hebt Python, een gescopele API-sleutel, GPT-6 Astra-toegang en één sessie met Computer Use nodig.
openai==3.22.1 (de SDK stuurt voor je de header OpenAI-Beta: agents=v1)api.agents.read, api.agents.write en api.responses.write, op een project dat gpt-6-astra kan gebruikenDe Agents API is in publieke bèta, dus veldnamen en gedrag kunnen tussen SDK-releases veranderen. De repository pint versie 3.22.1 in requirements.txt.
De gehoste browser heeft een bereikbaar URL nodig, dus de code gebruikt een Vercel-deployment van Northstar.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
Zie voor meer over geïsoleerde dependencies onze gids over virtuele omgevingen. Op macOS of Linux activeer je met source .venv/bin/activate en kopieer je het bestand met cp. Bewaar de sleutel in .env, nooit in code.
Het experiment gebruikt GPT-6 Astra, het model in OpenAI's Computer Use-voorbeelden. Onze GPT-6 Astra-overzicht behandelt het model zelf.
De code gebruikt de Agents API (client.beta.agents), niet de Agents SDK of de Responses API computer-tool die we in onze GPT-6 Astra API-tutorial gebruikten.
Maak één sessie met de tool computer_use en een door OpenAI gehost desktop, en hergebruik die voor beide tests:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True stelt alle screenshots beschikbaar die de API retourneert, terwijl beperkte netwerktoegang de browser tot Northstar beperkt.
De omgeving gebruikt de standaardgrootte medium (2 vCPU, 4 GB RAM).
De functie legt vast wat de agent heeft waargenomen. Als de agent een van de 4 gecontroleerde waarden voor hoeveelheid of subtotaal niet kan lezen, moet die dat veld rapporteren als null.
Elk property onder required opsommen vertelt het model om ze allemaal te beantwoorden, met null voor alles wat hij niet zag. De harness behandelt een ontbrekend veld nog steeds als incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
De harness zet elke getoonde prijs om naar centen, verifieert de build-ID en vergelijkt de waarden met de antwoordsleutel:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Een onleesbare of ontbrekende waarde levert een incomplete-uitspraak op, nooit een pass.
Een rapport uit de verkeerde build retourneert incomplete voordat de waarden de uitspraak kunnen beïnvloeden.
Dezelfde instructies gelden voor beide tests:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Alleen de websitebuild verandert tussen de tests.
Open de eventstream, stuur de QA-doelstelling één keer, en handel approvals en functieaanroepen af totdat de beurt voltooid is.
Open eerst de eventstream en stuur dan de taak precies één keer:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Streams spelen gemiste events niet opnieuw af. Als de stream wegvalt, open dan een nieuwe, en haal vervolgens de sessie en zijn opgeslagen items op terwijl de verbinding blijft staan.
Het taakbericht noemt de build, de acceptatiecriteria en de veiligheidsrestrictie, maar niets over de bug:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Bewaar de sessie-ID voor de hertest.
De gehoste browser vraagt om goedkeuring voordat elke nieuwe websiteherkomst wordt geopend.
De stream geeft agent.session.requires_action uit; haal de sessie op en lees required_actions voor het verzoek.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Browserwerk verschijnt als computer_use_call-items, elk met een korte titel en status. De eventstream voor de eerste test liet zien:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Ongeveer 47 seconden gingen voorbij voordat de eerste browseractiviteit begon.
Alle 7 computer_use_call-items werden voltooid, maar een itemstatus is niet het QA-oordeel; het resultaat van de functie is dat wel.
Ja. Belangrijker: de functieaanroep isoleerde de fout tot één veld: het review-subtotaal.
De aanroep record_qa_result bevatte:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Elke waarde komt overeen met de buggy pagina. De hoeveelheid bleef 2 op de review-pagina, wat een zichtbare mismatch in hoeveelheid uitsluit.
judge() bevestigde build ns-1041, vergeleek de 4 waarden met de verwachte waarden, en vond alleen het review-subtotaal onjuist.
Dit is de enige uitspraak die het experiment gebruikt:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Stuur, nadat de fix live is, nog één bericht naar dezelfde sessie.
Deze kleine regressietest gebruikt dezelfde instructies en dezelfde uitspraakfunctie.
De fix in build ns-1042 is één regel in de JavaScript van Northstar:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);De startlink bevat ?reset=1, dus de hertest begint met een lege winkelwagen. Daarna gaat de follow-up naar dezelfde sessie:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
De hertest behield de gehoste omgeving en vereiste geen nieuwe herkomstgoedkeuring. Vertrouw niet op browserstaat, omdat cookies kunnen verlopen en het recyclen van de omgeving die wist.
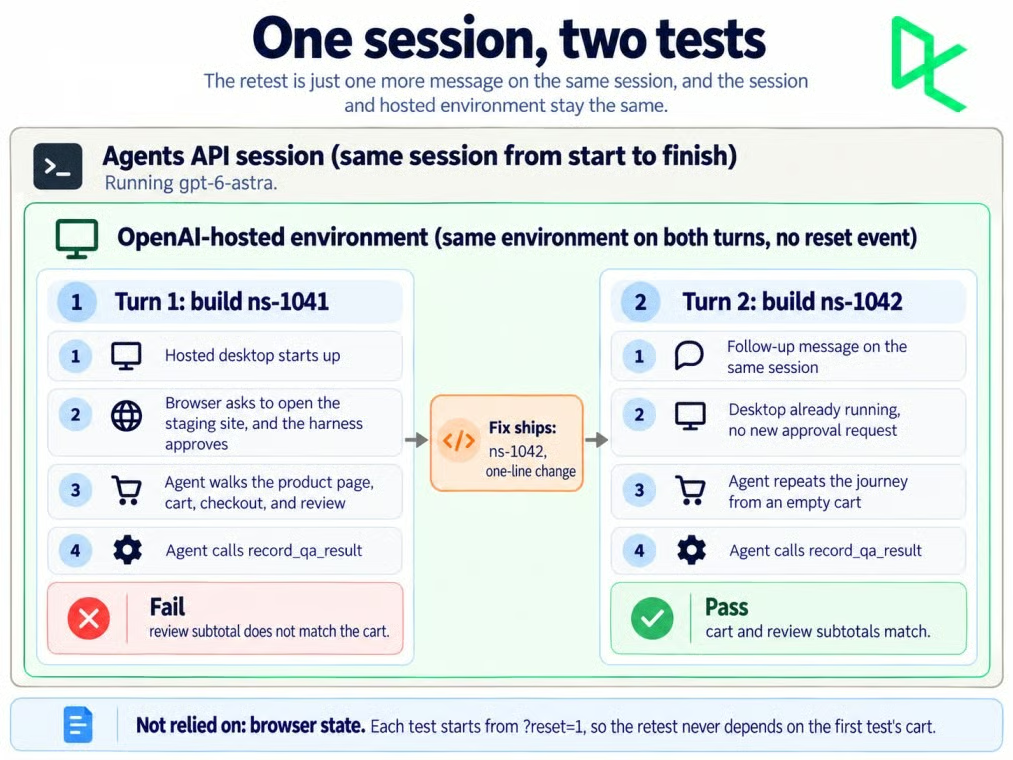
Eén sessie droeg beide QA-tests. Afbeelding door de auteur.
Een gehoste sandbox kan worden verwijderd als activiteit en keep-alives 1 uur stoppen. Let op agent.session.environment.reset en begin elke hertest vanuit een bekende staat.
Ja. De hertest rapporteerde winkelwagenhoeveelheid 2 en $48.00, vervolgens reviewhoeveelheid 2 en $48.00, en judge() gaf een pass terug zonder mislukte checks.
Het duurde 38,9 seconden met 5 browseractiviteiten, tegenover 96,5 seconden en 7 items voor de eerste test, die een wachttijd van 47 seconden vóór de eerste browseractiviteit omvatte.
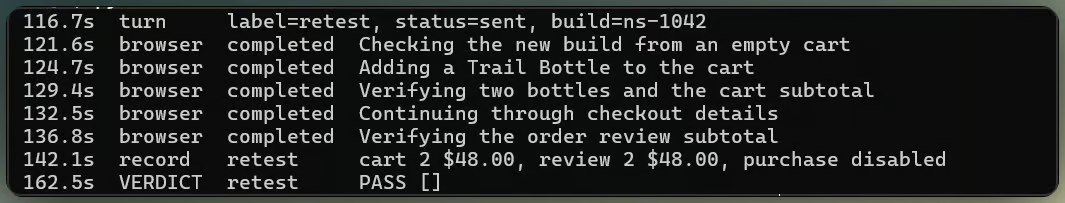
Hertest geslaagd zonder nieuwe goedkeuring.
Niet per se. Zelfs met include_screenshots ingeschakeld, gaf de eerste test 2 screenshots terug uit 7 browseractiviteiten, en de hertest 2 uit 5.
Sommige items retourneren output: null, dus rapporten kunnen niet van elke activiteit een afbeelding aannemen.
De eventstream is geen continue videofeed van de gehoste browser; hij retourneert browseractiviteiten en screenshots wanneer beschikbaar.
Northstar gebruikt rrweb om Document Object Model (DOM)-wijzigingen en interacties vast te leggen, naar dezelfde host te sturen en beide journeys hieronder terug te spelen.
De browser van de agent op beide staging-builds. Video door de auteur.
De replay toont hoeveelheid 2 en $24.00 op ns-1041, daarna $48.00 op ns-1042; de uitgeschakelde koopknop blijft onaangeroerd.
De repository bevat ook een kleine Streamlit-viewer voor de opgeslagen uitspraak, browserbewijsmateriaal, sessiedetails, kosten en eventlog.
De best-effort usage-counters gaven een standaardtariefschatting van $0.9469 aan tokens voor beide tests.
| Metric | Test 1 (ns-1041) |
Hertest (ns-1042) |
|---|---|---|
| Inputtokens | 255.550 | 223.533 |
| Gecachete inputtokens | 217.041 (84,9%) | 219.449 (98,2%) |
| Outputtokens | 982 | 708 |
| Geschatte tokenkosten | $0.6512 | $0.2957 |
| Tijd per beurt | 96,5 seconden | 38,9 seconden |
| Browseractiviteiten | 7 | 5 |
De hertest gebruikte minder inputtokens, en 98,2% daarvan kwam uit de promptcache. Samen kostten de 2 tests $0.9469.
De observability-gids zegt dat gebruik null kan zijn als het onbekend is en dat geregistreerde tellingen kunnen veranderen, dus controleer ze opnieuw voordat je de sessie verwijdert.
Toen ik de tests draaide, waren dit de standaardtarieven voor GPT-6 Astra op de pricing-pagina van OpenAI:
| Tokentype | Tarief per 1M tokens |
|---|---|
| Input | $10.00 |
| Gecachete input | $1.00 |
| Cache-schrijfsels | $12.50 |
| Output | $50.00 |
De drempel van 272K long-context is van toepassing per request. De gecombineerde input van beide beurten bleef eronder, dus geen enkel request had de hogere long-contexttarieven kunnen triggeren.
De schatting kan de uiteindelijke factuur nog steeds niet reproduceren omdat Agents API-gebruik best effort is en geen afzonderlijke cache-write-tellingen blootlegt.
De gehoste sandbox wordt apart gefactureerd tegen standaard containertarieven. De pricing-pagina vermeldt de 4 GB-medium-container op $0,12 per sessie van 20 minuten, met in aanmerking komende containersessies per minuut gefactureerd en een minimum van 5 minuten.
Veiligheid hangt af van wat de browser kan bereiken en wat de pagina toestaat.
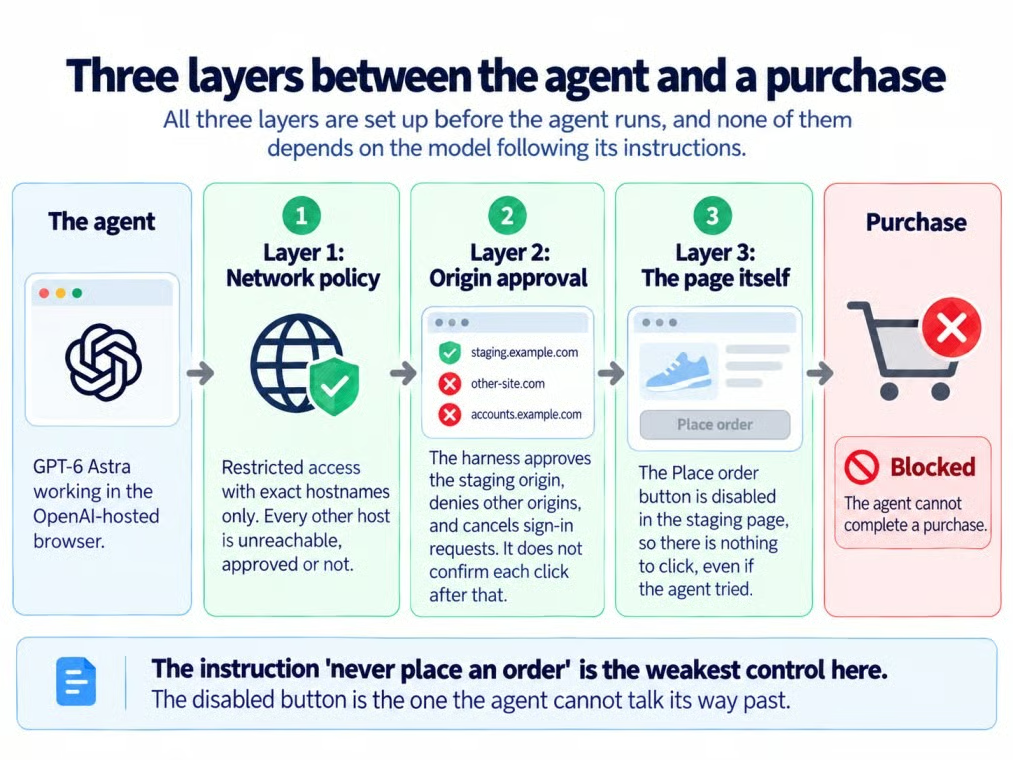
Drie lagen tussen agent en checkout. Afbeelding door de auteur
Netwerkbeleid bepaalt welke hosts de browser kan bereiken, en herkomstgoedkeuring beslist of hij elke nieuwe herkomst mag openen. Geen van beide bevestigt individuele browseracties.
Het goedkeuren van northstar-checkout-staging.vercel.app keurt dus niet elke klik afzonderlijk goed.
De niet-kopen-regel is een veiligheidsrestrictie, en purchase_control wordt opgeslagen als bewijs in plaats van beoordeeld als acceptatiecriterium. Northstars uitgeschakelde knop "Place order" is de controle die dit afdwingt.
Onder restricted kan de browser alleen de hostnamen bereiken die je opgeeft.
OpenAI's sandboxgids accepteert 1 tot 100 exacte hostnamen, zonder wildcards, protocollen, paden of poorten. Content delivery-netwerken (CDN's), subdomeinen en redirectdoelen hebben aparte vermeldingen nodig.
Screenshots en rrweb-opnames bevatten wat de pagina toont, dus Northstar gebruikt fictieve data, heeft geen login en vermeldt opname in de footer.
De recorder maskeert invoer, maar een productie-implementatie heeft nog steeds een databeleid en masking nodig die passen bij de pagina.
De Agents API ondersteunt datalokalisatie alleen in de Verenigde Staten en komt niet in aanmerking voor Zero Data Retention (ZDR), zelfs niet met een zelf-gehoste sandbox.
Sla de resultaten en screenshots op die je nodig hebt, en verwijder vervolgens de sessie in plaats van een staging-checkout in behouden sessiestatus achter te laten.
Het verwijderen van de Agents API-sessie verwijdert geen rrweb-opnames die door de site zijn opgeslagen. Verwijder die apart volgens het opnamebeleid.
Northstar faalde toen de subtotals van winkelwagen en review uiteenliepen, en slaagde daarna met de fix in dezelfde sessie. De harness, niet de samenvatting van het model, bepaalde beide uitspraken.
Ik zou gescripte regressietests behouden voor bekende invarianten en doelgebaseerde browseragents gebruiken voor verkennende journeys die lastiger als een assertie zijn uit te drukken. De agent verkent; applicatiecode beslist.
Voor API-basiskennis raad ik onze cursus Working with the OpenAI API aan.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

