
Khóa học
Làm việc với OpenAI API
3 giờ
179.5K
Hãy tưởng tượng một quy trình thanh toán hiển thị $48 trong giỏ và $24 trên trang xem lại. Khách hàng thấy hai tổng tiền khác nhau trong cùng một lần thanh toán.
Các nhóm thường chạy kiểm thử đảm bảo chất lượng (QA) cho luồng này bằng script trình duyệt: nhấp nút này, mở trang kia, kiểm tra giá trị này. Một bài kiểm thử có kịch bản chỉ kiểm tra những trạng thái mà tác giả đã ghi lại.
Một agent AI là một mô hình có thể thực hiện hành động để đạt mục tiêu. Agents API của OpenAI quản lý vòng lặp của agent và giữ công việc của nó trong một phiên. Trong hướng dẫn này, Computer Use cũng cung cấp trình duyệt được lưu trữ.
Northstar Checkout là một cửa hàng thử nghiệm hư cấu với một lỗi ẩn ở phần tạm tính.
Agent nhận được kết quả thanh toán đúng, nhưng không biết vị trí lỗi hay danh sách nút cần bấm. Một chương trình Python nhỏ, gọi là harness, so sánh các giá trị agent báo cáo rồi yêu cầu kiểm thử lại bản đã sửa trong cùng phiên.
Trong hướng dẫn này, tôi sẽ trình bày cách:
Mã và số đo sử dụng phiên bản 3.22.1 của gói Python openai.
Nếu bạn chỉ có một phút, đây là các điểm chính.
computer_use_call.Đây là một cửa hàng thử nghiệm với một lỗi cài cắm, không phải thước đo độ tin cậy.
Computer Use là một công cụ trong OpenAI Agents API cho phép agent vận hành một trình duyệt chạy trên máy chủ của OpenAI. Mã của bạn theo dõi các sự kiện của phiên và trả lời các yêu cầu của nó. OpenAI liệt kê kiểm thử website là một trường hợp sử dụng.
OpenAI quản lý vòng lặp agent, phiên và khôi phục. Hướng dẫn OpenAI Agents API của chúng tôi bao quát các kiến thức cơ bản đó.
Các thiết lập computer use cũ hơn, như trong hướng dẫn computer use GPT-5.4 của chúng tôi, khiến mã của nhà phát triển phải tự vận hành vòng lặp chụp ảnh và hành động.
Trong QA trên trình duyệt, chính trang web là đối tượng được kiểm thử.
Gọi trực tiếp một API thanh toán sẽ bỏ qua trang nơi lỗi của Northstar tồn tại, vì vậy agent đi theo đúng lộ trình như khách hàng: từ trang sản phẩm đến giỏ hàng, thanh toán và trang xem lại.
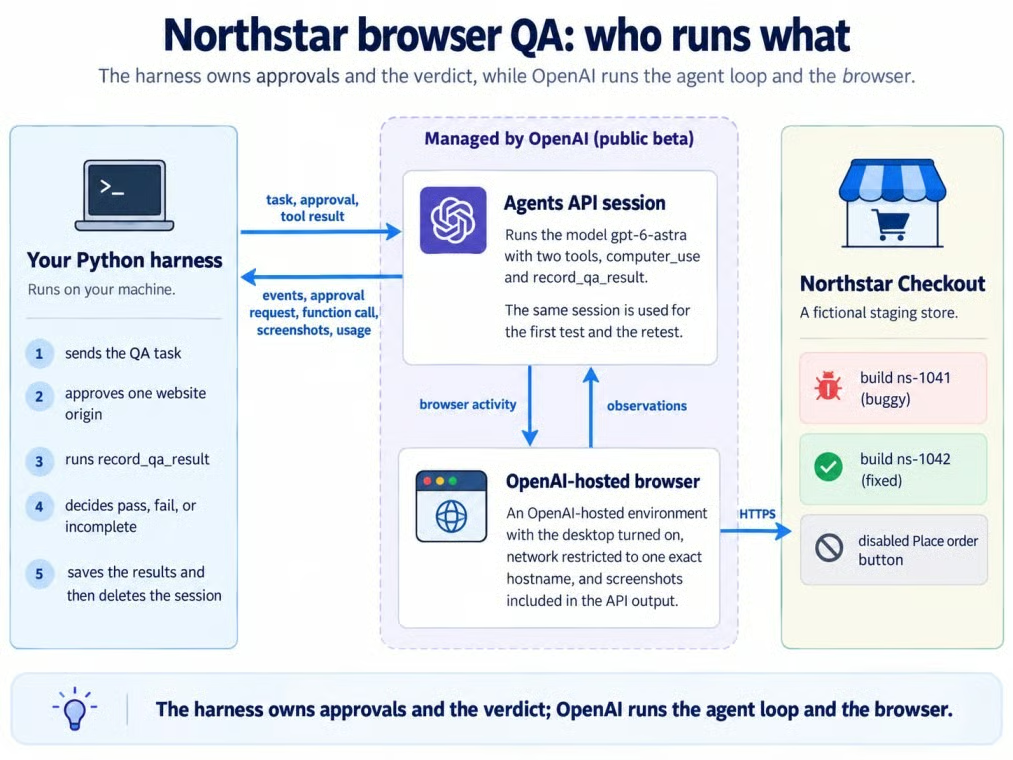
Harness, phiên, trình duyệt lưu trữ, trang dàn dựng. Ảnh: Tác giả.
OpenAI quản lý phiên và trình duyệt trong vùng xám; harness và Northstar nằm ngoài nó.
Dự án gồm một cửa hàng dàn dựng hư cấu, một harness bằng Python và một phiên Agents API.
Mã hoàn chỉnh nằm trong kho GitHub này.
Northstar bán một chai Trail Bottle giá $24. Bài kiểm thử đi từ sản phẩm đến giỏ, thanh toán và xem lại; không có vận chuyển, thuế, đăng nhập hay nút mua hoạt động.
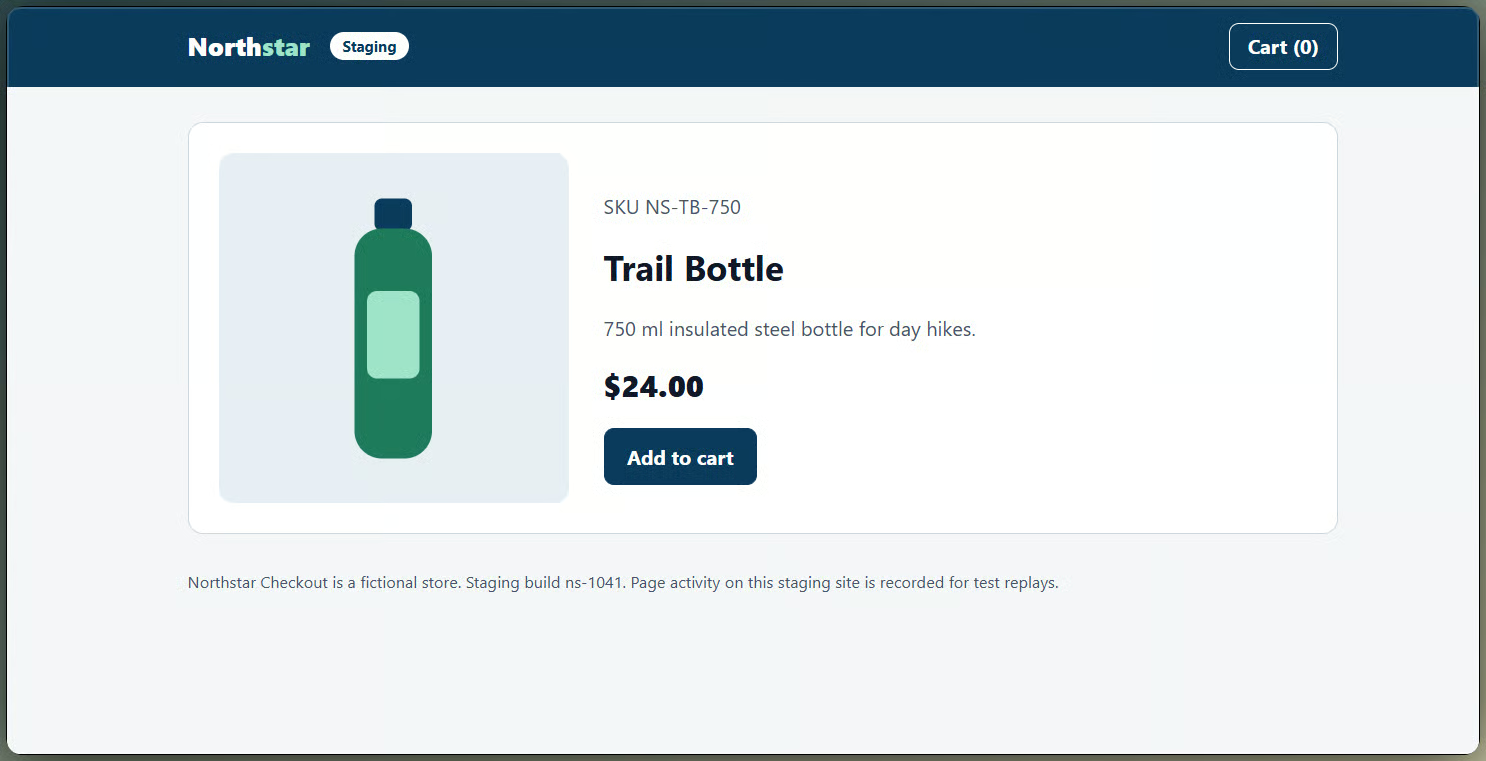
Trang sản phẩm Northstar trước khi kiểm thử. Ảnh: Tác giả.
Bản ns-1041 chứa lỗi, còn ns-1042 chứa bản sửa. Thêm ?reset=1 vào URL bắt đầu của bản dựng sẽ làm trống giỏ trước mỗi lần kiểm thử.
Yêu cầu QA được viết dưới dạng mục tiêu. Tiêu chí chấp nhận yêu cầu agent:
Một ràng buộc an toàn riêng yêu cầu không bao giờ đặt, gửi hoặc thanh toán đơn hàng. Yêu cầu định nghĩa kết quả, không phải các cú nhấp.
Bản lỗi cộng các đơn giá trên trang xem lại và quên số lượng. Cả hai trang đều hiển thị số lượng 2, nhưng tạm tính giỏ là $48.00 còn tạm tính xem lại là $24.00.
Đáp án ở trong mã ứng dụng. Cả hướng dẫn lẫn thông điệp tác vụ đều không nhắc đến lỗi.
Agent báo cáo ID bản dựng và 4 giá trị quan sát được thông qua một công cụ hàm, record_qa_result.
Harness trước tiên kiểm tra bản dựng được báo có đúng bản đang kiểm thử không, vì cả hai bản dùng chung hostname, sau đó so sánh các giá trị với đáp án.
Một công cụ hàm chỉ chạy nếu agent gọi nó. Một bản ghi thiếu, giá trị thiếu, hoặc sai bản dựng khiến kết quả là incomplete, và không bao giờ được tính là đạt.
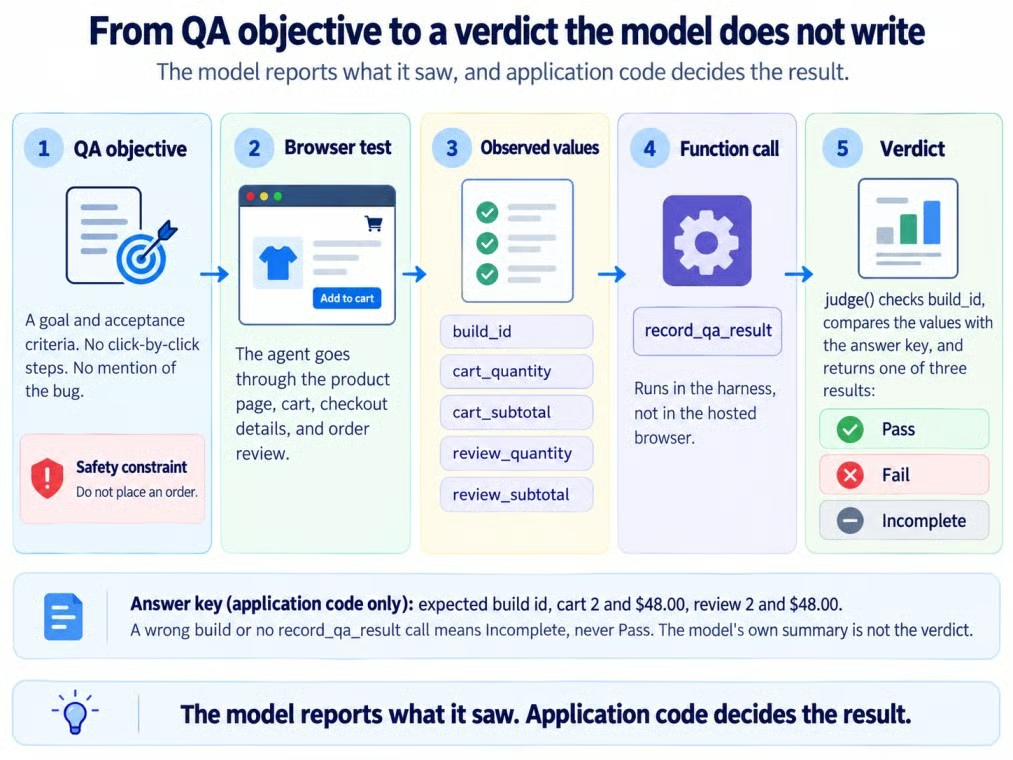
Từ mục tiêu QA đến phán quyết của ứng dụng. Ảnh: Tác giả.
Bạn cần Python, một khóa API có phạm vi, quyền truy cập GPT-6 Astra và một phiên có Computer Use.
openai==3.22.1 (SDK sẽ gửi sẵn header OpenAI-Beta: agents=v1)api.agents.read, api.agents.write và api.responses.write, trên một dự án có thể dùng gpt-6-astraAgents API đang ở giai đoạn public beta, nên tên trường và hành vi có thể thay đổi giữa các bản phát hành SDK. Kho đã cố định phiên bản 3.22.1 trong requirements.txt.
Trình duyệt lưu trữ cần URL có thể truy cập, nên mã dùng một triển khai Northstar trên Vercel.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
Để biết thêm về phụ thuộc cách ly, xem hướng dẫn môi trường ảo của chúng tôi. Trên macOS hoặc Linux, kích hoạt bằng source .venv/bin/activate và sao chép tệp bằng cp. Giữ khóa trong .env, không để trong mã.
Thử nghiệm dùng GPT-6 Astra, mô hình trong các ví dụ Computer Use của OpenAI. Tổng quan GPT-6 Astra của chúng tôi trình bày về chính mô hình.
Mã dùng Agents API (client.beta.agents), không dùng Agents SDK hay công cụ computer của Responses API trong hướng dẫn GPT-6 Astra API của chúng tôi.
Tạo một phiên với công cụ computer_use và desktop do OpenAI lưu trữ, sau đó tái sử dụng cho cả hai bài kiểm thử:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True cho phép truy xuất mọi ảnh chụp màn hình API trả về, trong khi truy cập mạng bị hạn chế giới hạn trình duyệt vào Northstar.
Môi trường dùng kích thước mặc định medium (2 vCPU, 4 GB RAM).
Hàm ghi lại những gì agent quan sát được. Nếu agent không thể đọc một trong 4 giá trị số lượng hoặc tạm tính được kiểm tra, nó phải báo cáo trường đó là null.
Liệt kê mọi thuộc tính dưới required yêu cầu mô hình trả lời tất cả, dùng null cho bất cứ thứ gì nó không thấy. Harness vẫn coi trường thiếu là incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
Harness chuyển đổi mỗi giá hiển thị sang số cent, xác minh ID bản dựng và so sánh các giá trị với đáp án:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Một giá trị không đọc được hoặc thiếu sẽ cho ra phán quyết incomplete, không bao giờ là đạt.
Báo cáo từ sai bản dựng trả về incomplete trước khi các giá trị của nó có thể ảnh hưởng phán quyết.
Cùng một bộ hướng dẫn áp dụng cho cả hai kiểm thử:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Chỉ bản dựng website thay đổi giữa các lần kiểm thử.
Mở luồng sự kiện, gửi mục tiêu QA một lần, rồi xử lý phê duyệt và lời gọi hàm cho đến khi lượt hoàn tất.
Mở luồng sự kiện trước, rồi gửi tác vụ đúng một lần:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Luồng sẽ không phát lại các sự kiện bị bỏ lỡ. Nếu luồng rơi, hãy mở luồng mới, rồi truy xuất phiên và các mục đã lưu trong khi kết nối vẫn còn.
Thông điệp tác vụ nêu tên bản dựng, tiêu chí chấp nhận và ràng buộc an toàn, nhưng không nói gì về lỗi:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Giữ lại ID phiên để kiểm tra lại.
Trình duyệt lưu trữ sẽ yêu cầu phê duyệt trước khi mở mỗi nguồn gốc trang web mới.
Luồng phát ra agent.session.requires_action; truy xuất phiên và đọc required_actions để lấy yêu cầu.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Công việc của trình duyệt xuất hiện dưới dạng các mục computer_use_call, mỗi mục có tiêu đề ngắn và trạng thái. Luồng sự kiện của bài kiểm thử đầu tiên cho thấy:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Mất khoảng 47 giây trước hoạt động trình duyệt đầu tiên.
Cả 7 mục computer_use_call đều hoàn tất, nhưng trạng thái mục không phải là phán quyết QA; kết quả của lời gọi hàm mới là phán quyết.
Có. Quan trọng hơn, lời gọi hàm đã cô lập lỗi vào một trường: tạm tính trên trang xem lại.
Lời gọi record_qa_result chứa:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Mọi giá trị đều khớp với trang lỗi. Số lượng vẫn là 2 trên trang xem lại, loại trừ khả năng lệch số lượng nhìn thấy được.
judge() xác nhận bản dựng ns-1041, so sánh 4 giá trị với giá trị kỳ vọng và chỉ thấy sai ở tạm tính trang xem lại.
Đây là phán quyết duy nhất thử nghiệm sử dụng:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Sau khi bản sửa hoạt động, gửi thêm một thông điệp vào cùng phiên.
Bài kiểm thử hồi quy nhỏ này dùng cùng hướng dẫn và hàm phán quyết.
Bản sửa trong bản dựng ns-1042 là một dòng JavaScript của Northstar:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);Liên kết bắt đầu bao gồm ?reset=1, nên lần kiểm tra lại bắt đầu với giỏ trống. Sau đó thông điệp theo dõi được gửi vào cùng phiên:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
Lần kiểm tra lại giữ nguyên môi trường lưu trữ và không cần phê duyệt nguồn gốc mới. Đừng phụ thuộc vào trạng thái trình duyệt, vì cookie có thể hết hạn và việc tái chế môi trường sẽ xóa sạch.
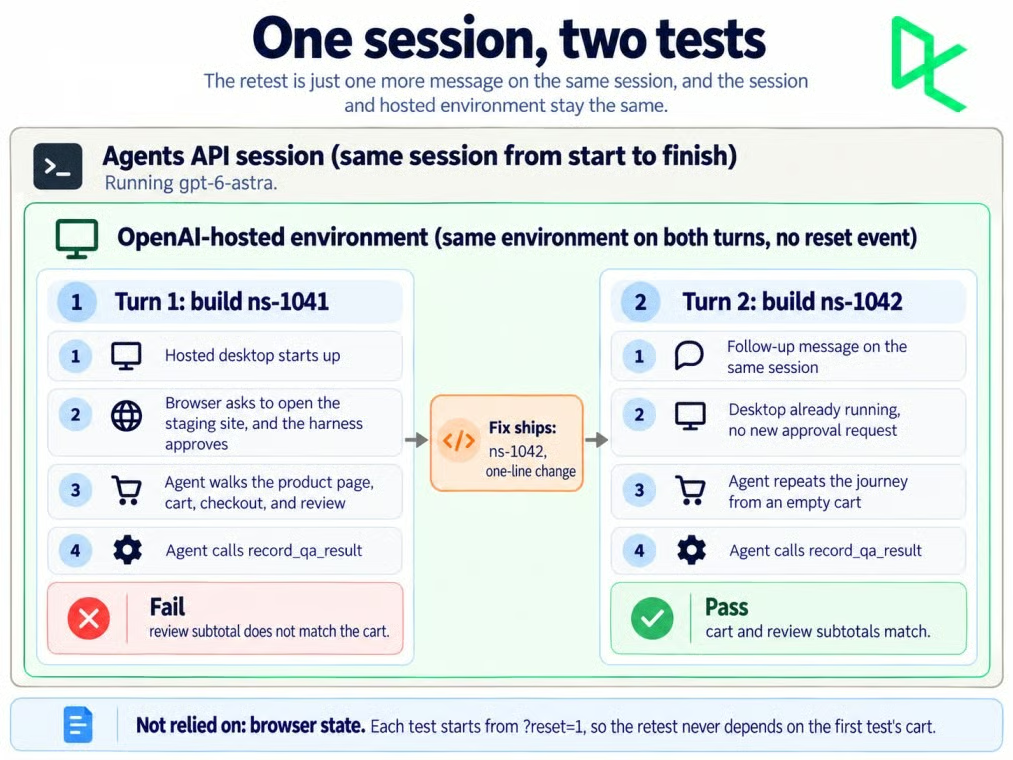
Một phiên bao trọn cả hai kiểm thử QA. Ảnh: Tác giả.
Một sandbox lưu trữ có thể bị xóa nếu hoạt động và keep-alive ngừng trong 1 giờ. Theo dõi agent.session.environment.reset và bắt đầu mỗi lần kiểm tra lại từ trạng thái đã biết.
Có. Lần kiểm tra lại báo số lượng giỏ là 2 và $48.00, rồi số lượng xem lại là 2 và $48.00, và judge() trả về đạt mà không có kiểm tra nào trượt.
Mất 38,9 giây với 5 mục hoạt động trình duyệt, so với 96,5 giây và 7 mục cho bài đầu, trong đó có 47 giây chờ trước khi bắt đầu hoạt động trình duyệt.
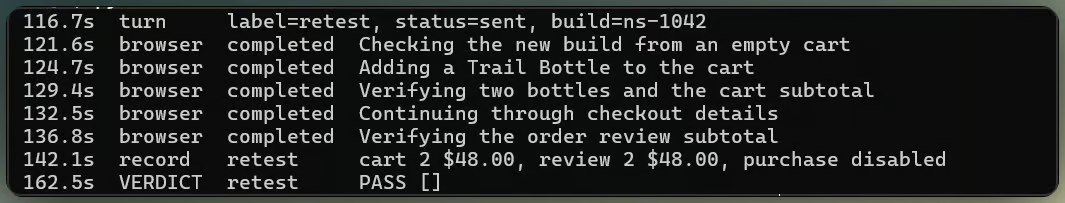
Lần kiểm tra lại đạt mà không cần phê duyệt mới. Ảnh: Tác giả.
Không nhất thiết. Ngay cả khi bật include_screenshots, bài kiểm thử đầu trả về 2 ảnh chụp từ 7 mục hoạt động, và lần kiểm tra lại trả về 2 từ 5.
Một số mục trả output: null, nên báo cáo không thể giả định có ảnh cho mọi hoạt động.
Luồng sự kiện không phải video liên tục của trình duyệt lưu trữ; nó trả về các mục hoạt động trình duyệt và ảnh chụp khi có.
Northstar dùng rrweb để ghi lại thay đổi DOM và tương tác, gửi về cùng máy chủ và phát lại cả hai hành trình bên dưới.
Trình duyệt của agent trên cả hai bản dàn dựng. Video: Tác giả.
Bản phát lại hiển thị số lượng 2 và $24.00 trên ns-1041, rồi $48.00 trên ns-1042; nút mua bị vô hiệu vẫn không bị chạm tới.
Kho cũng bao gồm một trình xem Streamlit nhỏ cho phán quyết đã lưu, bằng chứng từ trình duyệt, chi tiết phiên, chi phí và nhật ký sự kiện.
Các bộ đếm mức sử dụng theo nỗ lực tốt nhất ước tính chi phí token theo mức chuẩn là $0.9469 cho cả hai bài.
| Chỉ số | Bài 1 (ns-1041) |
Kiểm tra lại (ns-1042) |
|---|---|---|
| Token đầu vào | 255,550 | 223,533 |
| Token đầu vào được cache | 217,041 (84,9%) | 219,449 (98,2%) |
| Token đầu ra | 982 | 708 |
| Chi phí token ước tính | $0.6512 | $0.2957 |
| Thời gian lượt | 96,5 giây | 38,9 giây |
| Mục hoạt động trình duyệt | 7 | 5 |
Lần kiểm tra lại dùng ít token đầu vào hơn, và 98,2% trong số đó đến từ bộ nhớ đệm prompt. Cả hai bài cộng lại tốn $0.9469.
Hướng dẫn quan sát cho biết mức sử dụng có thể là null khi không biết và số đếm ghi nhận có thể thay đổi, nên hãy kiểm tra lại trước khi xóa phiên.
Khi tôi chạy thử, đây là mức giá chuẩn của GPT-6 Astra trên trang giá của OpenAI:
| Loại token | Giá cho 1M token |
|---|---|
| Đầu vào | $10.00 |
| Đầu vào được cache | $1.00 |
| Ghi cache | $12.50 |
| Đầu ra | $50.00 |
Ngưỡng ngữ cảnh dài 272K áp dụng cho mỗi yêu cầu. Tổng đầu vào của cả hai lượt gộp lại vẫn dưới mức đó, nên không yêu cầu đơn lẻ nào có thể kích hoạt mức giá ngữ cảnh dài cao hơn.
Ước tính vẫn không thể tái tạo hóa đơn cuối cùng vì mức sử dụng Agents API là nỗ lực tốt nhất và không cung cấp số đếm ghi cache riêng.
Sandbox lưu trữ được tính riêng theo mức giá container chuẩn. Trang giá liệt kê container medium 4 GB là $0,12 cho mỗi phiên 20 phút, với các phiên container đủ điều kiện được tính theo phút và tối thiểu 5 phút.
An toàn phụ thuộc vào những gì trình duyệt có thể truy cập và những gì trang cho phép thực hiện.
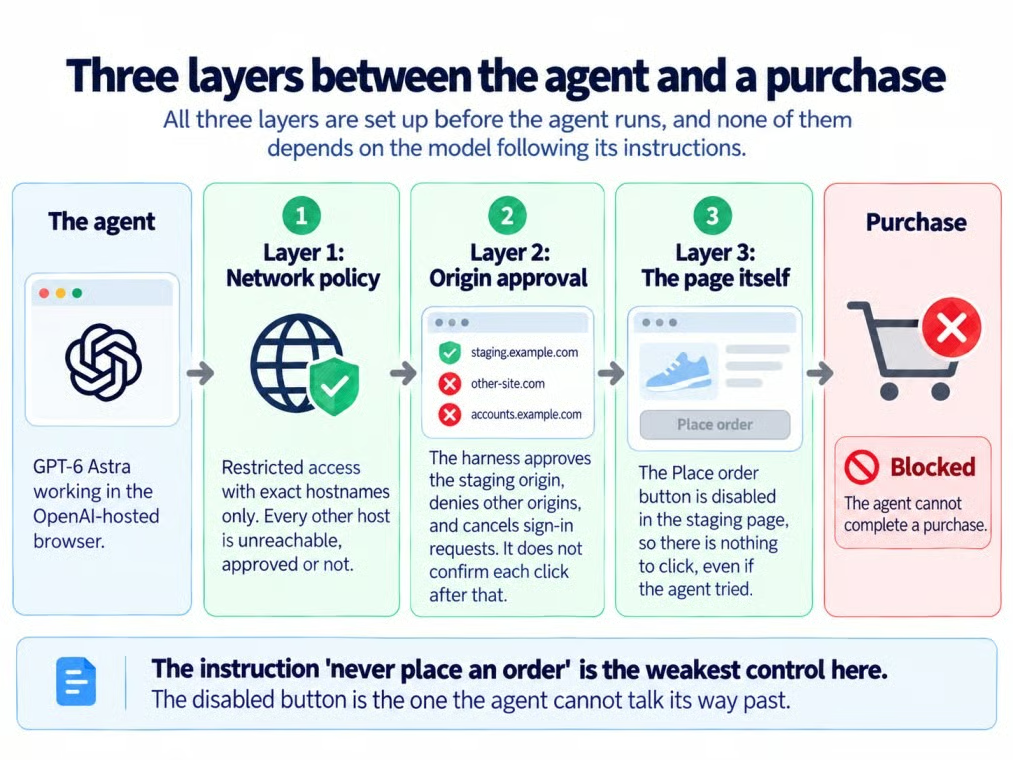
Ba lớp giữa agent và thanh toán. Ảnh: Tác giả
Chính sách mạng kiểm soát những máy chủ mà trình duyệt có thể truy cập, và phê duyệt nguồn gốc quyết định liệu có thể mở mỗi nguồn gốc mới hay không. Không bên nào xác nhận từng hành động trong trình duyệt.
Vì vậy, phê duyệt northstar-checkout-staging.vercel.app không đồng nghĩa phê duyệt từng cú nhấp riêng lẻ.
Quy tắc không mua là một ràng buộc an toàn, và purchase_control được lưu làm bằng chứng thay vì được đánh giá như tiêu chí chấp nhận. Nút "Place order" bị vô hiệu của Northstar là cơ chế thực thi quy tắc.
Ở chế độ restricted, trình duyệt chỉ có thể truy cập các hostname bạn liệt kê.
Hướng dẫn sandbox của OpenAI chấp nhận từ 1 đến 100 hostname chính xác, không có wildcard, giao thức, đường dẫn hay cổng. CDN, tên miền con và đích chuyển hướng cần mục riêng.
Ảnh chụp màn hình và bản ghi rrweb chứa bất cứ thứ gì trang hiển thị, nên Northstar dùng dữ liệu hư cấu, không có đăng nhập và thông báo ghi hình ở chân trang.
Trình ghi hình che mặt nạ các ô nhập, nhưng triển khai sản xuất vẫn cần chính sách dữ liệu và che mặt nạ phù hợp với trang.
Agents API chỉ hỗ trợ lưu trữ dữ liệu tại Hoa Kỳ và không đủ điều kiện cho Zero Data Retention (ZDR), ngay cả với sandbox tự lưu trữ.
Lưu lại kết quả và ảnh chụp bạn cần, rồi xóa phiên thay vì để một quy trình thanh toán dàn dựng trong trạng thái phiên được lưu.
Xóa phiên Agents API không xóa các bản ghi rrweb do trang lưu trữ. Gỡ bỏ chúng riêng theo chính sách ghi hình.
Northstar trượt khi tạm tính giỏ và xem lại lệch nhau, rồi đạt sau khi sửa trong cùng phiên. Harness, chứ không phải bản tóm tắt của mô hình, quyết định cả hai phán quyết.
Tôi sẽ giữ các bài kiểm thử hồi quy theo kịch bản cho những bất biến đã biết và dùng agent trình duyệt dựa trên mục tiêu cho các hành trình khám phá khó diễn đạt dưới dạng một mệnh đề assert. Agent khám phá; mã ứng dụng quyết định.
Về kiến thức API cơ bản, tôi khuyến nghị khóa học Working with the OpenAI API của chúng tôi.
Các khóa học nổi bật trên DataCamp
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
