コース
OpenAI APIを使いこなす
3時間
179.5K
カートでは$48、レビュー画面では$24と表示されるチェックアウトを想像してください。1回のチェックアウトで合計が2種類見えてしまいます。
品質保証(QA)では、このフローをブラウザスクリプトでテストするのが一般的です。ボタンをクリックし、このページを開いて、この値を確認する——といった具合です。スクリプト化されたテストは、作者が書いた状態しか確認しません。
AIエージェントは、目標に向けて行動できるモデルです。OpenAIのAgents APIは、エージェントループを管理し、その作業をセッションに保持します。本チュートリアルでは、Computer Useがホスト型ブラウザも提供します。
Northstar Checkoutは、小計にバグを抱えた架空のテストストアです。
エージェントは正しいチェックアウト結果は受け取りますが、バグの場所や押すべきボタンの一覧は知りません。ハーネスと呼ばれる小さなPythonプログラムが、エージェントが報告した値を比較し、同じセッションで修正済みストアのテストも依頼します。
このチュートリアルでは、次の方法を解説します。
コードと計測は、openai Pythonパッケージのバージョン3.22.1を使用しています。
時間がない場合は、以下のポイントを押さえてください。
computer_use_callはそれぞれ7件、5件でした。これは、1つのテストストアに1つの埋め込みバグを仕込んだ例であり、信頼性のベンチマークではありません。
Computer Useは、OpenAIのサーバー上で動作するブラウザをエージェントが操作できるようにする、OpenAI Agents APIのツールです。あなたのコードはセッションのイベントを追跡し、その要求に回答します。用途の一つとして、OpenAIはWebサイトのテストを挙げています。
OpenAIはエージェントループ、セッション、リカバリを管理します。基本事項はOpenAI Agents APIチュートリアルで解説しています。
私たちのGPT-5.4のComputer Useチュートリアルのような旧来のセットアップでは、スクリーンショット取得と操作のループを開発者コード側で回していました。
ブラウザQAでは、ページ自体がテスト対象です。
チェックアウトAPIを直接呼ぶと、Northstarのバグが潜むページをスキップしてしまいます。そのためエージェントは、顧客と同じ経路——商品ページからカート、チェックアウト、レビューへ——をたどります。
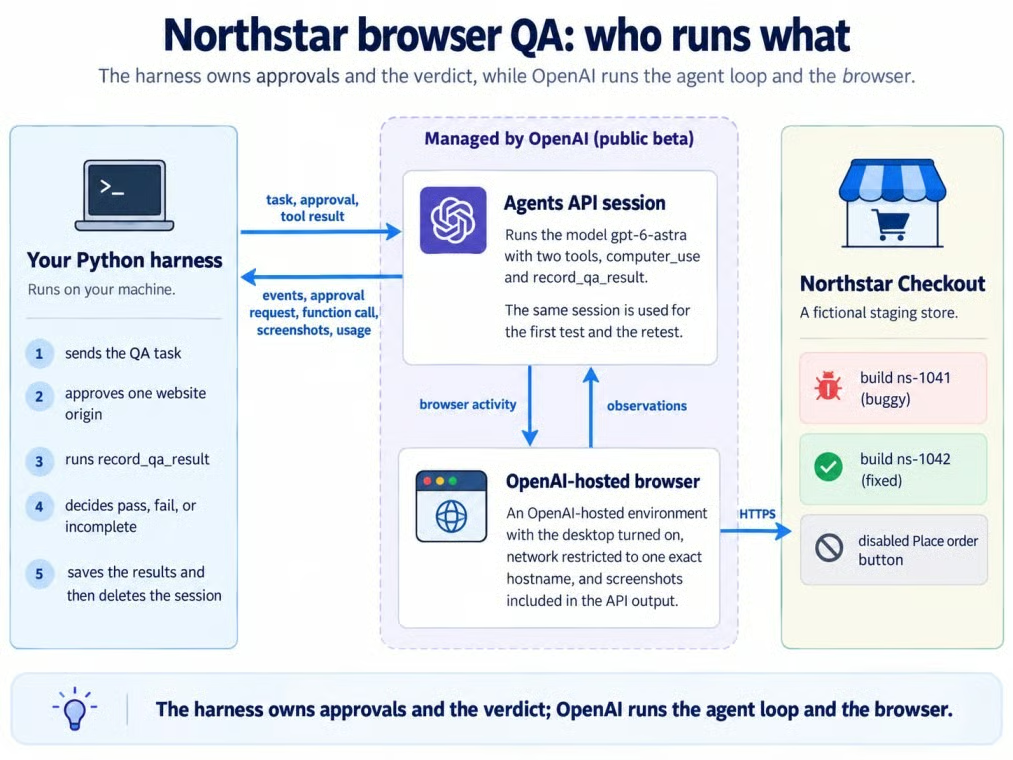
ハーネス、セッション、ホスト型ブラウザ、ステージングサイト。画像:著者
OpenAIは灰色の領域内でセッションとブラウザを管理し、ハーネスとNorthstarはその外側にあります。
このプロジェクトは、架空のステージングストア、Python製ハーネス、そして1つのAgents APIセッションで構成します。
完全なコードはGitHubリポジトリにあります。
Northstarは$24のTrail Bottleを1商品だけ販売しています。テストは商品からカート、チェックアウト、レビューへと進みます。配送、税、ログイン、購入ボタンの動作はありません。
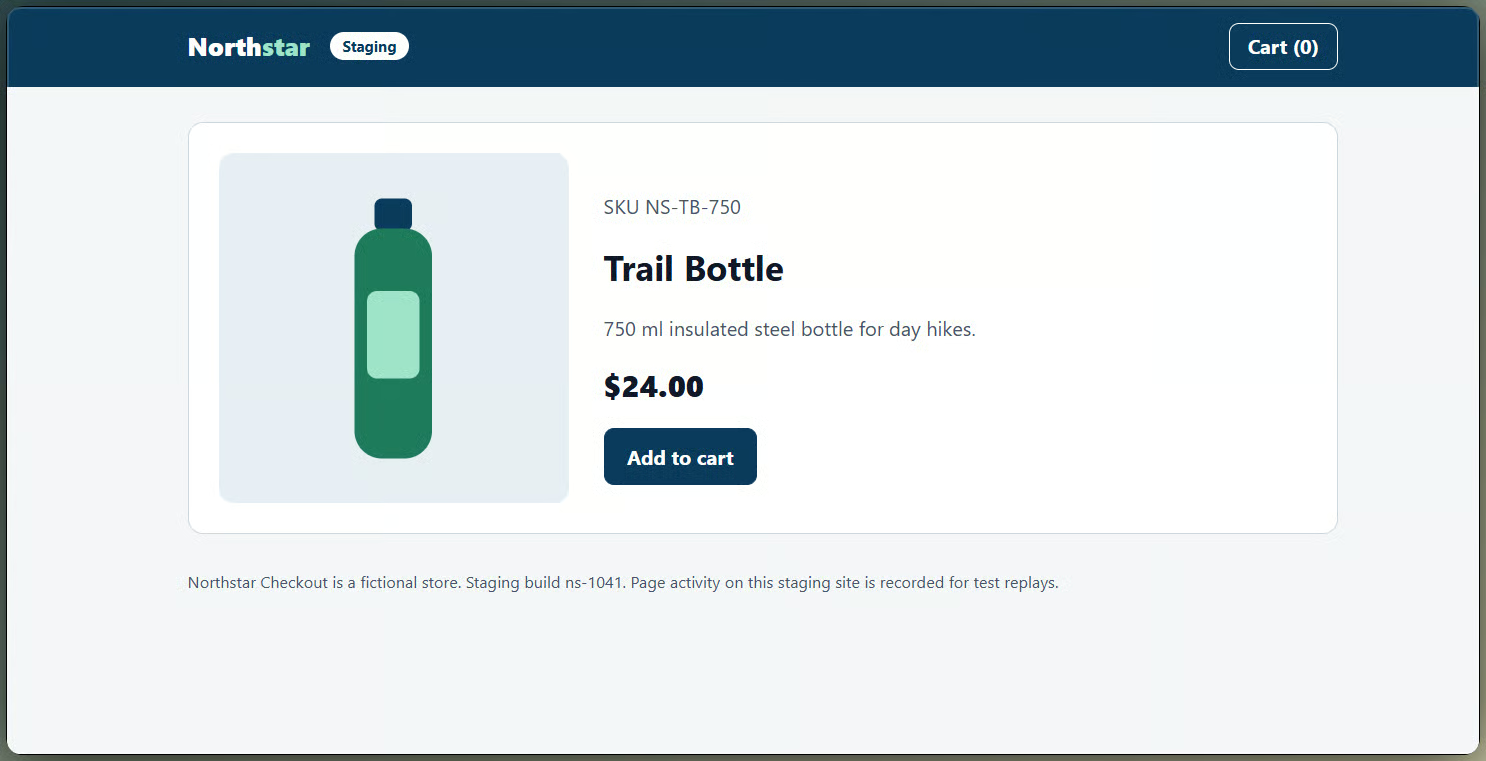
テスト前のNorthstar商品ページ。画像:著者
ビルドns-1041にバグがあり、ns-1042に修正が含まれます。ビルドの開始URLに?reset=1を付けると、どちらのテストでも事前にカートを空にできます。
QAリクエストはゴールとして記述されます。受け入れ条件ではエージェントに次を求めます。
別の安全制約として、注文を確定・送信・支払いを決して行わないことが定義されています。リクエストが定義するのは結果であり、クリック手順ではありません。
バギーなビルドは、レビュー画面で単価を合計し数量を無視します。どちらのページでも数量は2ですが、カートの小計は$48.00、レビューの小計は$24.00になります。
答え合わせの鍵はアプリケーションコード側にあります。指示やタスクメッセージはバグについて何も触れていません。
エージェントは1つの関数ツールrecord_qa_resultを通して、ビルドIDと4つの観測値を報告します。
ハーネスはまず、報告されたビルドがテスト対象と一致しているか(両ビルドは同一ホスト名を共有)を確認し、続いて値を答え合わせキーと比較します。
関数ツールは、エージェントが呼び出した場合にのみ実行されます。記録の欠落、値の欠落、ビルドの不一致は結果をincompleteにし、合格にはなりません。
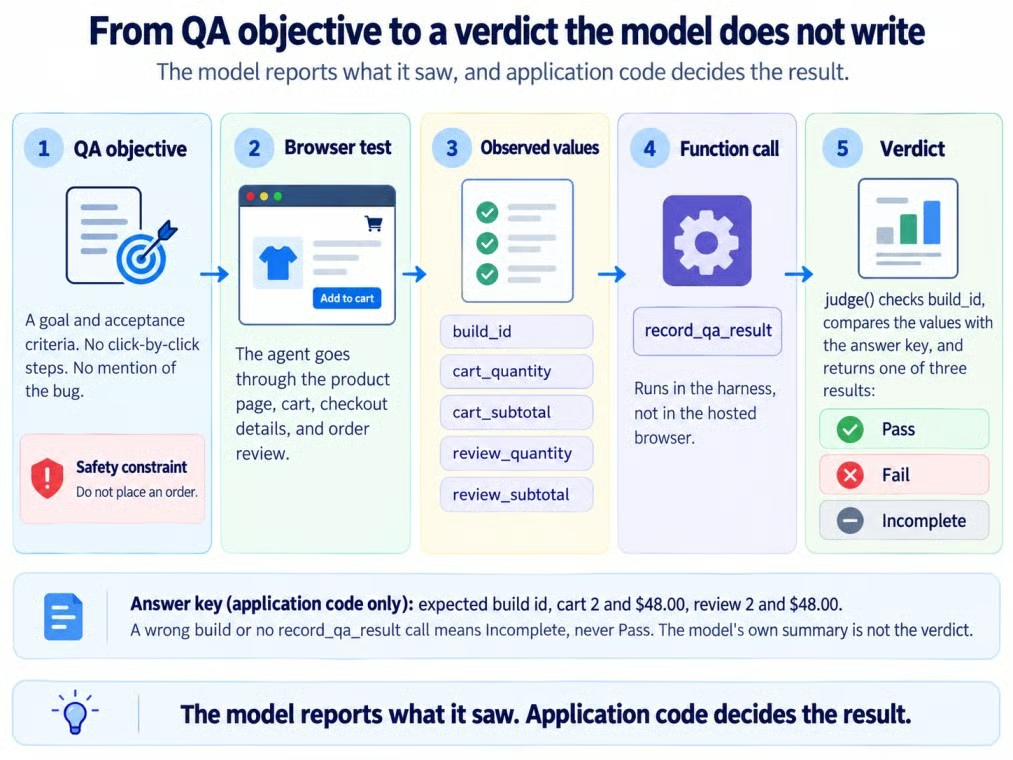
QA目標からアプリケーションの判定へ。画像:著者
Python、スコープ付きAPIキー、GPT-6 Astraへのアクセス、そしてComputer Use付きの1つのセッションが必要です。
openai==3.22.1(SDKがOpenAI-Beta: agents=v1ヘッダーを自動送信)gpt-6-astraを利用できるプロジェクト上で、api.agents.read、api.agents.write、api.responses.writeスコープを持つAPIキーAgents APIはパブリックベータのため、SDKのリリース間でフィールド名や動作が変わる可能性があります。リポジトリではrequirements.txtでバージョン3.22.1を固定しています。
ホスト型ブラウザは到達可能なURLを必要とするため、コードはNorthstarのVercelデプロイを使用します。
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py依存関係の分離については、仮想環境ガイドを参照してください。macOSやLinuxではsource .venv/bin/activateで有効化し、ファイルコピーはcpで行います。キーはコードではなく.envに保持してください。
本実験では、OpenAIのComputer Useの例で使われているモデルであるGPT-6 Astraを使用します。モデル自体についてはGPT-6 Astraの概要を参照してください。
コードはAgents API(client.beta.agents)を使用し、Agents SDKや、GPT-6 Astra APIチュートリアルで使用したResponses APIのcomputerツールは使用しません。
computer_useツールとOpenAIホストのデスクトップで1つのセッションを作成し、両方のテストで再利用します。
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: TrueはAPIが返すスクリーンショットを公開し、制限付きネットワークアクセスはブラウザをNorthstarに限定します。
環境はデフォルトのmediumサイズ(2 vCPU、4 GB RAM)を使用します。
この関数は、エージェントが観測した内容を記録します。4つの数量または小計のうち1つでも読めない場合、そのフィールドをnullで報告しなければなりません。
requiredにすべてのプロパティを列挙すると、モデルは見えなかったものにnullを使って全項目に回答するよう誘導されます。ハーネス側では、フィールドの欠落は引き続きincompleteとして扱います。
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
ハーネスは表示価格をセント単位に変換し、ビルドIDを検証し、答え合わせキーと値を比較します。
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}読めない値や欠落した値があると、判定はincompleteとなり、合格にはなりません。
誤ったビルドからの報告は、値が判定に影響する前にincompleteを返します。
同じインストラクションが両方のテストを制御します。
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
テスト間で変わるのはWebサイトのビルドだけです。
イベントストリームを開き、QA目標を1回だけ送信し、ターンが完了するまで承認と関数呼び出しを処理します。
まずイベントストリームを開き、その後タスクを正確に1回送ります。
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
ストリームは取り逃したイベントを再生しません。ストリームが切れたら新たに開き、接続が維持されている間にセッションと保存済みアイテムを取得します。
タスクメッセージには、ビルド、受け入れ条件、安全制約が記載されますが、バグについては何も述べません。
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
再テストのためにセッションIDを保持しておきます。
ホスト型ブラウザは、新しいWebサイトのオリジンを開く前に承認を求めます。
ストリームはagent.session.requires_actionを出力します。セッションを取得し、リクエストをrequired_actionsから読み取ります。
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])ブラウザ作業は、短いタイトルとステータスを持つcomputer_use_call項目として現れます。1回目のテストのイベントストリームは次のとおりでした。
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
最初のブラウザ動作まで約47秒かかりました。
7つのcomputer_use_call項目はすべて完了しましたが、項目のステータスはQAの判定ではありません。判定は関数の結果です。
はい。さらに重要なのは、関数呼び出しによって失敗がレビュー小計という1つのフィールドに切り分けられたことです。
record_qa_result呼び出しには次が含まれていました。
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
すべての値がバギーなページと一致しています。レビュー画面でも数量は2のままで、目視できる数量不一致は排除されました。
judge()はビルドns-1041を確認し、4つの値を期待値と比較して、レビュー小計だけが不正であると判断しました。
本実験で使用した判定は次のとおりです。
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}修正が反映されたら、同じセッションにもう1つメッセージを送ります。
この小さな回帰テストは、同じインストラクションと判定関数を使います。
ビルドns-1042の修正は、NorthstarのJavaScript1行です。
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);開始リンクに?reset=1が含まれているため、再テストは空のカートから始まります。次に、同じセッションへフォローアップを送ります。
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
再テストではホスト型環境が維持され、新たなオリジン承認は不要でした。クッキーの有効期限切れや環境再作成で状態が消える可能性があるため、ブラウザ状態に依存しないでください。
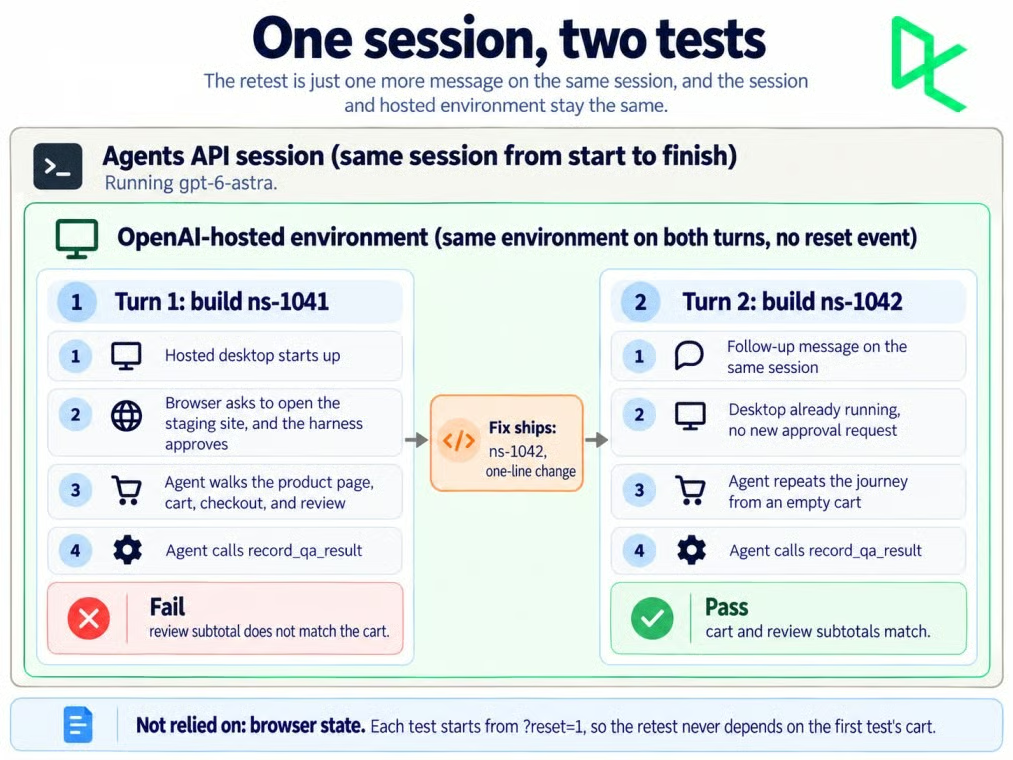
1つのセッションで両方のQAテストを実施。画像:著者
ホスト型サンドボックスは、アクティビティとキープアライブが1時間途絶えると削除されることがあります。agent.session.environment.resetに注意し、各再テストは既知の状態から開始してください。
はい。再テストはカート数量2・$48.00、レビュー数量2・$48.00を報告し、judge()は不合格項目なしの合格を返しました。
所要は38.9秒、ブラウザ動作は5件でした。初回は96.5秒で7件、うち最初の動作までに47秒を要しました。
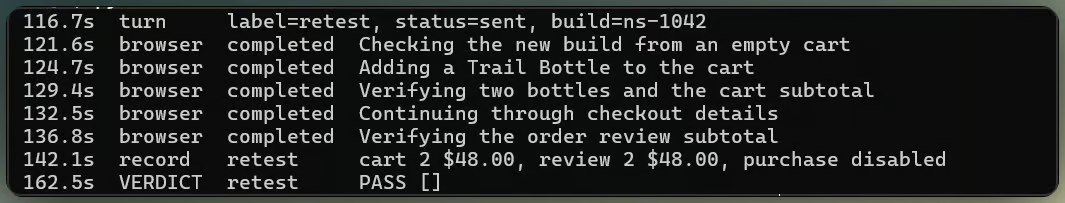
再承認なしで再テスト合格。画像:著者
必ずしもそうではありません。include_screenshotsを設定していても、初回テストは7件のブラウザ動作から2枚、再テストは5件から2枚のスクリーンショットでした。
一部の項目はoutput: nullを返すため、すべてのアクティビティに画像がある前提では報告できません。
イベントストリームはホスト型ブラウザの連続動画フィードではなく、ブラウザのアクティビティ項目と、可能な場合にスクリーンショットを返します。
Northstarはrrwebを利用して、DOMの変更と操作を同一ホストに送信し、以下の両方のジャーニーを再生します。
両方のステージングビルドにおけるエージェントのブラウザ。動画:著者
リプレイでは、ns-1041で数量2・$24.00、その後ns-1042で$48.00が確認でき、無効化された購入ボタンには触れていません。
リポジトリには、保存された判定、ブラウザ証拠、セッション詳細、コスト、イベントログを表示する小さなStreamlitビューアも含まれています。
ベストエフォートの使用量カウンタでは、2回のテスト合計で標準レートのトークン見積もりが$0.9469となりました。
| Metric | Test 1 (ns-1041) |
Retest (ns-1042) |
|---|---|---|
| Input tokens | 255,550 | 223,533 |
| Cached input tokens | 217,041 (84.9%) | 219,449 (98.2%) |
| Output tokens | 982 | 708 |
| Estimated token cost | $0.6512 | $0.2957 |
| Turn time | 96.5 seconds | 38.9 seconds |
| Browser activity items | 7 | 5 |
再テストでは入力トークンが少なく、うち98.2%がプロンプトキャッシュから供給されました。2回の合計コストは$0.9469です。
オブザーバビリティガイドでは、使用量は不明な場合にnullとなり得て、記録値は変動する可能性があると述べています。セッション削除前に再確認してください。
私がテストを実行した時点で、OpenAIの料金ページに掲載されていたGPT-6 Astraの標準レートは次のとおりです。
| Token type | Rate per 1M tokens |
|---|---|
| Input | $10.00 |
| Cached input | $1.00 |
| Cache writes | $12.50 |
| Output | $50.00 |
272Kの長文コンテキストしきい値はリクエストごとに適用されます。2ターンの合計入力はこれを下回っていたため、単一のリクエストで高い長文コンテキストレートが発動することはありませんでした。
それでも見積もりは最終請求を再現できません。Agents APIの使用量はベストエフォートであり、キャッシュ書き込みの個別カウントは公開されないためです。
ホスト型サンドボックスは標準的なコンテナ料金で別途課金されます。料金ページでは、4 GBのmediumコンテナが20分のセッションあたり$0.12で、対象コンテナセッションは分単位で課金、最小5分と記載されています。
安全性は、ブラウザが到達できる範囲と、ページが許可する操作に依存します。
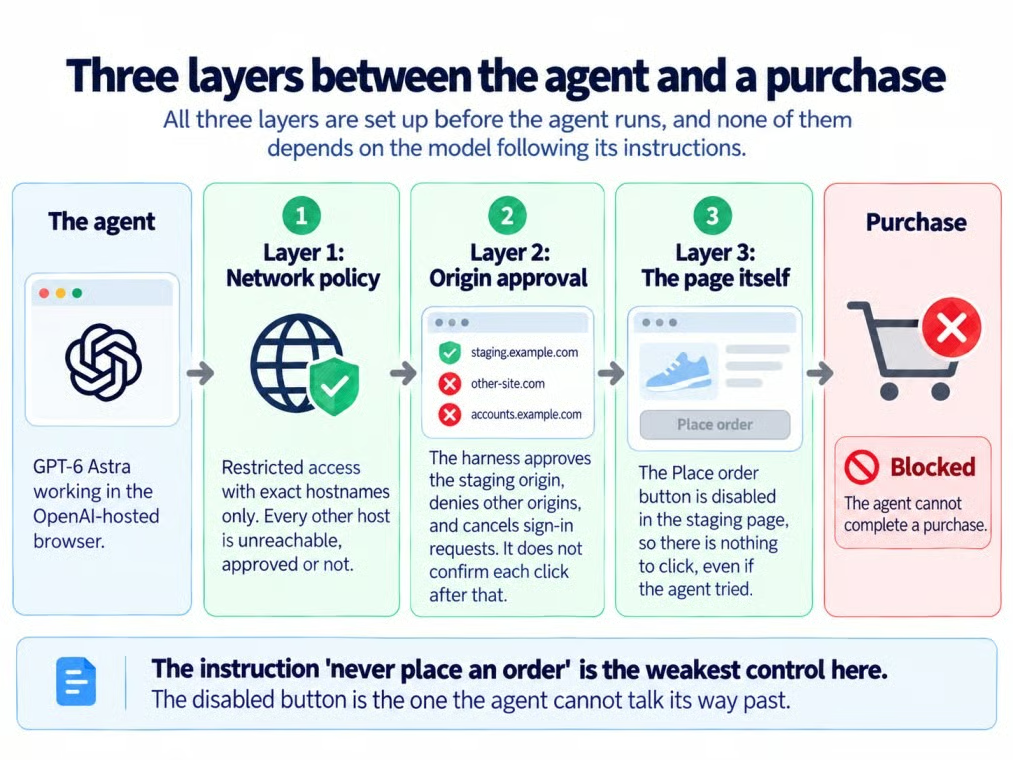
エージェントとチェックアウトの間の3層。画像:著者
ネットワークポリシーはブラウザが到達できるホストを制御し、オリジン承認は各新規オリジンを開けるかを決めます。どちらも個々のブラウザ操作を確認するものではありません。
したがって、northstar-checkout-staging.vercel.appの承認は、各クリックを個別に承認するものではありません。
購入禁止ルールは安全制約であり、purchase_controlは受け入れ条件としてではなく証拠として保存されます。Northstarの無効化された「Place order」ボタンが、このルールを実際に強制するコントロールです。
restrictedでは、ブラウザは列挙したホスト名にのみ到達できます。
OpenAIのサンドボックスガイドでは、ワイルドカードなしの厳密なホスト名を1〜100個受け入れ、プロトコルやパス、ポートは指定できません。CDN、サブドメイン、リダイレクト先は別途エントリが必要です。
スクリーンショットやrrweb記録にはページに表示された内容が含まれます。そのためNorthstarは架空データを使用し、ログイン機能を持たず、フッターで記録について開示しています。
記録ツールは入力をマスクしますが、本番デプロイではページに適したデータポリシーとマスキングが依然として必要です。
Agents APIは米国内のみデータレジデンシーをサポートし、セルフホスト型サンドボックスでもZero Data Retention(ZDR)の対象にはなりません。
必要な結果とスクリーンショットを保存し、ステージングのチェックアウトをセッション状態のまま保持しないよう、セッションは削除してください。
Agents APIセッションを削除しても、サイト側に保存されたrrweb記録は削除されません。記録ポリシーに従って別途削除してください。
Northstarはカートとレビューの小計が分裂して不合格となり、同一セッションでの修正後は合格しました。どちらの判定も、モデルの要約ではなくハーネス(アプリケーションコード)が決めています。
既知の不変条件にはスクリプト化した回帰テストを維持し、assertで表しにくい探索的な経路にはゴールベースのブラウザエージェントを使うのがよいと考えます。エージェントは探索し、判定はアプリケーションコードが行います。
APIの基本を学ぶには、DataCampのWorking with the OpenAI APIコースをおすすめします。
人気のDataCampコース
コース
トラック
コース