Курс
Работа с OpenAI API
3 ч
179.5K
Представьте оформление заказа, где в корзине отображается $48, а на странице подтверждения — $24. Покупатель видит две разные суммы в одном и том же чекауте.
Команды обычно проводят QA-тесты этого сценария с помощью браузерного скрипта: нажми эту кнопку, открой ту страницу, проверь это значение. Скриптовый тест проверяет только те состояния, которые задал автор.
AI-агент — это модель, которая может выполнять действия для достижения цели. Agents API OpenAI управляет циклом агента и сохраняет его работу в сессии. В этом руководстве инструмент Computer Use также предоставляет хостируемый браузер.
Northstar Checkout — вымышленный тестовый магазин со скрытой ошибкой в промежуточном итоге.
Агент получает правильный результат чекаута, но не знает местоположение бага и не имеет списка кнопок для нажатия. Небольшая программа на Python, называемая «harness», сравнивает значения, которые сообщает агент, а затем просит ту же сессию протестировать исправленный магазин.
В этом руководстве мы рассмотрим, как:
Код и замеры используют версию 3.22.1 пакета Python openai.
Если у вас есть всего минута, вот основные выводы.
computer_use_call соответственно.Это один тестовый магазин с одним «посаженным» багом, а не эталон надёжности.
Computer Use — это инструмент в OpenAI Agents API, который позволяет агенту управлять браузером, запущенным на серверах OpenAI. Ваш код отслеживает события сессии и отвечает на её запросы. Среди вариантов использования OpenAI указывает тестирование веб-сайтов.
OpenAI управляет циклом агента, сессией и восстановлением. Базу покрывает наше руководство по OpenAI Agents API.
В старых конфигурациях компьютерного взаимодействия, как в нашем руководстве по использованию компьютера с GPT-5.4, цикл «скриншот-действие» выполнял код разработчика.
В браузерном QA самой проверяемой сущностью является страница.
Прямой вызов API чекаута обошёл бы страницу, где скрывается баг Northstar, поэтому агент идёт тем же путём, что и покупатель: со страницы товара в корзину, затем оформление и обзор заказа.
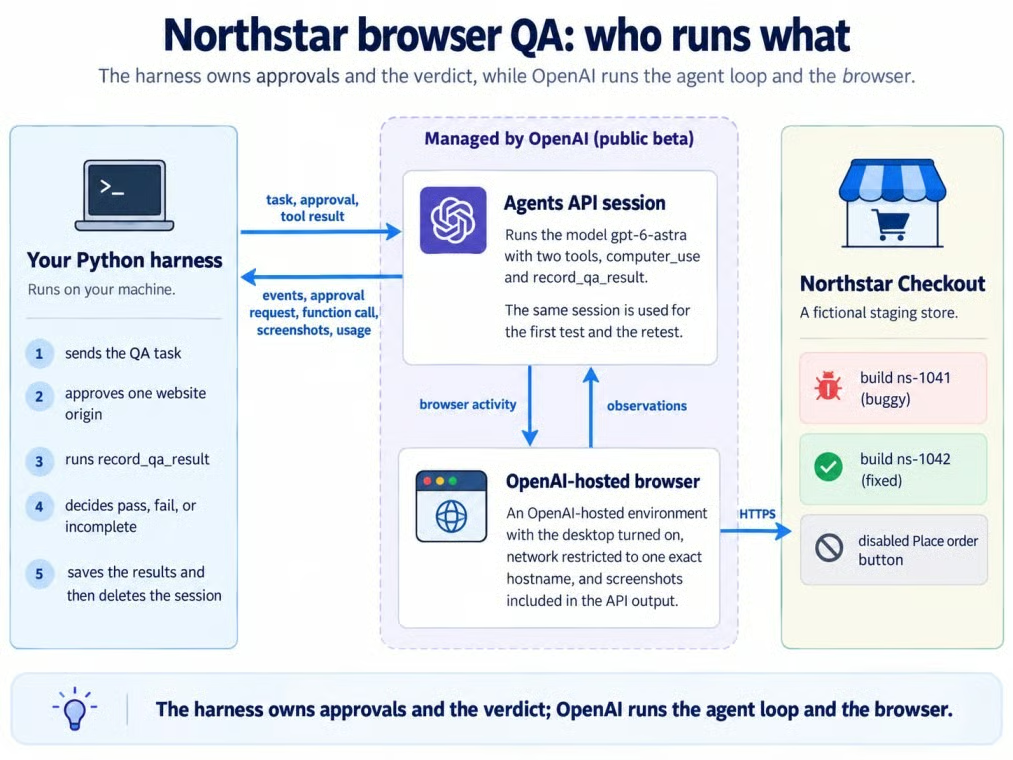
Harness, сессия, хостируемый браузер, стендовый сайт. Изображение автора.
OpenAI управляет сессией и браузером внутри серой зоны; harness и Northstar остаются вне её.
Проект включает вымышленный стендовый магазин, Python-harness и одну сессию Agents API.
Полный код — в этом репозитории GitHub.
Northstar продаёт одну бутылку Trail Bottle за $24. Тест проходит путь от товара к корзине, оформлению и обзору заказа; нет доставки, налогов, логина и рабочей кнопки покупки.
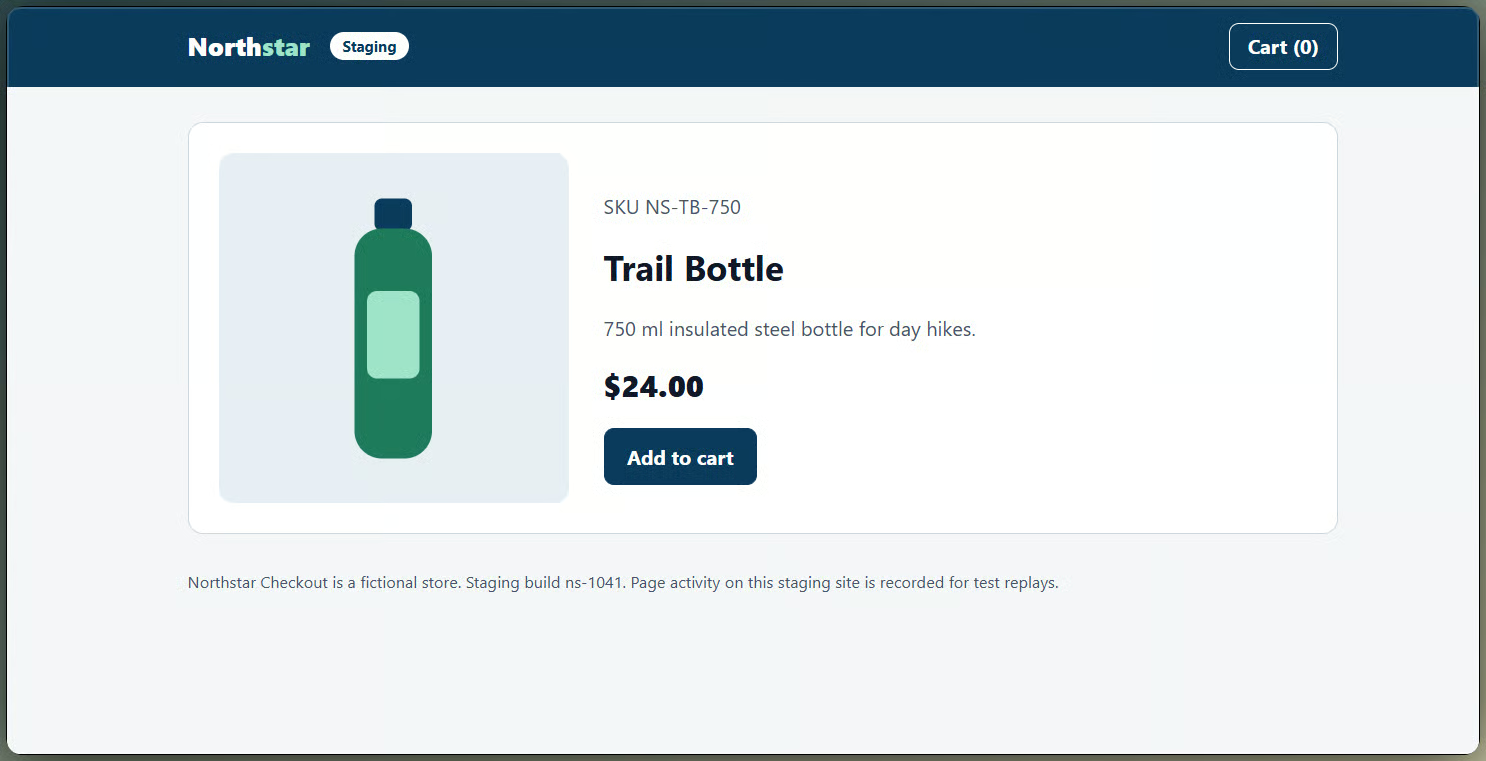
Страница товара Northstar до теста. Изображение автора.
Сборка ns-1041 содержит баг, а ns-1042 — исправление. Добавление ?reset=1 к стартовому URL сборки очищает корзину перед каждым тестом.
Запрос QA сформулирован как цель. Критерии приёмки требуют от агента:
Отдельное ограничение по безопасности предписывает никогда не оформлять, не отправлять и не оплачивать заказ. Запрос определяет результат, а не клики.
Сбойная сборка на странице обзора суммирует цены за единицу и «забывает» количество. На обеих страницах количество 2, но в корзине промежуточный итог $48.00, а в обзоре — $24.00.
Ключ ответа хранится в коде приложения. Ни инструкции, ни сообщение с задачей не упоминают баг.
Агент передаёт ID сборки и 4 наблюдаемых значения через один инструмент-функцию, record_qa_result.
Harness сначала проверяет, что указанная сборка — именно та, которая тестируется, поскольку обе сборки используют одно имя хоста, а затем сравнивает значения с ключом ответа.
Инструмент-функция запускается только если агент его вызвал. Отсутствующая запись, отсутствующее значение или неверная сборка дают результат incomplete, который никогда не засчитывается как pass.
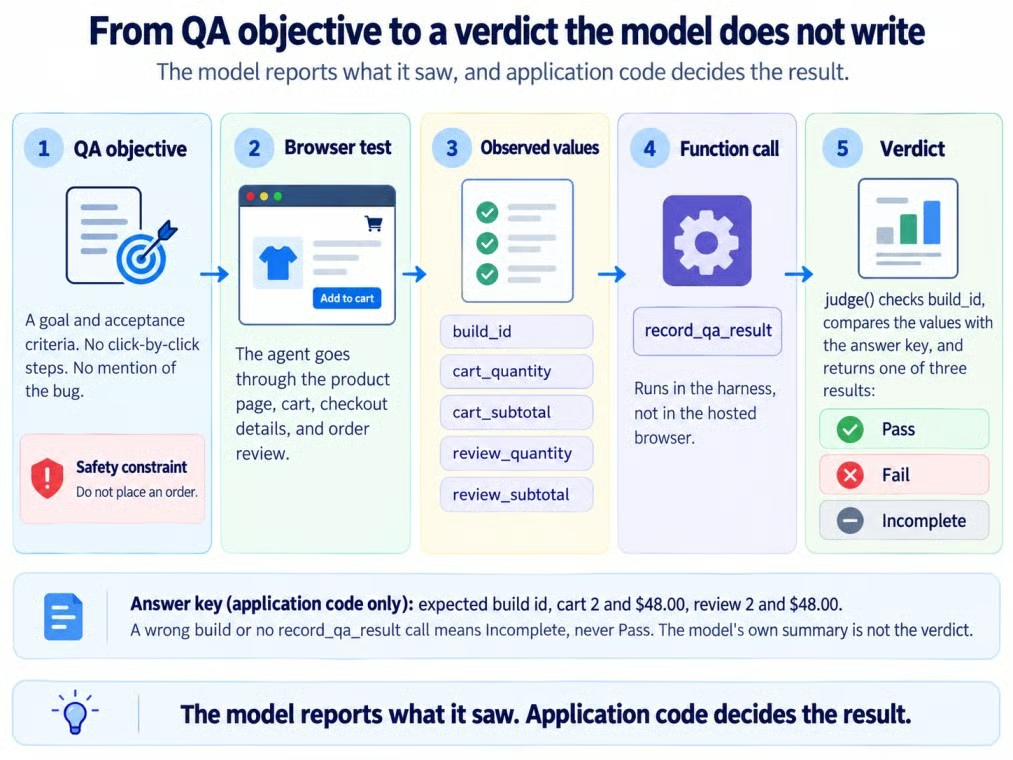
От цели QA к вердикту приложения. Изображение автора.
Понадобятся Python, ключ API с нужными скоупами, доступ к GPT-6 Astra и одна сессия с Computer Use.
openai==3.22.1 (SDK сам отправляет заголовок OpenAI-Beta: agents=v1)api.agents.read, api.agents.write и api.responses.write в проекте, который может использовать gpt-6-astraAgents API находится в публичной бете, поэтому названия полей и поведение могут меняться между релизами SDK. Репозиторий фиксирует версию 3.22.1 в requirements.txt.
Хостируемому браузеру нужен доступный URL, поэтому в коде используется деплой Northstar на Vercel.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
Подробнее об изоляции зависимостей — в нашем руководстве по виртуальным окружениям. В macOS или Linux активируйте командой source .venv/bin/activate и копируйте файл через cp. Храните ключ в .env, не в коде.
В эксперименте используется GPT-6 Astra — модель из примеров OpenAI по Computer Use. Наш обзор GPT-6 Astra рассказывает о самой модели.
Код использует Agents API (client.beta.agents), а не Agents SDK и не инструмент computer в Responses API из нашего руководства по GPT-6 Astra API.
Создайте одну сессию с инструментом computer_use и хостируемым OpenAI десктопом, затем используйте её для обоих тестов:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True открывает доступ к любым скриншотам, которые возвращает API, а ограниченный сетевой доступ ограничивает браузер Northstar.
Окружение использует размер по умолчанию medium (2 vCPU, 4 ГБ ОЗУ).
Функция записывает то, что наблюдал агент. Если агент не смог прочитать одно из 4 проверяемых значений количества или промежуточного итога, он должен указать это поле как null.
Перечислив каждое свойство в required, мы просим модель ответить по всем полям, используя null для того, чего не видела. Harness всё равно трактует пропущенное поле как incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
Harness конвертирует каждую отображаемую цену в центы, проверяет ID сборки и сравнивает значения с ключом ответа:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Нечитаемое или отсутствующее значение даёт вердикт incomplete, никогда не pass.
Отчёт от неверной сборки возвращает incomplete ещё до того, как его значения повлияют на вердикт.
Одни и те же инструкции управляют обоими тестами:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Между тестами меняется только сборка сайта.
Откройте поток событий, один раз отправьте цель QA, затем обрабатывайте одобрения и вызовы функций до завершения хода.
Сначала откройте поток событий, затем отправьте задачу ровно один раз:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Потоки не воспроизводят пропущенные события. Если поток оборвался, откройте новый, затем извлеките сессию и её сохранённые элементы, пока соединение активно.
Сообщение с задачей указывает сборку, критерии приёмки и ограничение безопасности, но ничего не говорит о баге:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Сохраните ID сессии для повторного теста.
Хостируемый браузер запрашивает одобрение перед открытием каждого нового источника сайта.
Поток генерирует agent.session.requires_action; извлеките сессию и прочитайте required_actions для запроса.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Работа в браузере появляется как элементы computer_use_call, каждый с коротким заголовком и статусом. Поток событий для первого теста показал:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Около 47 секунд прошло до первой активности браузера.
Все 7 элементов computer_use_call завершились, но статус элемента — это не вердикт QA; вердикт даёт результат функции.
Да. И что важнее, вызов функции изолировал сбой в одном поле: промежуточный итог на странице обзора.
Вызов record_qa_result содержал:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Каждое значение соответствует сбойной странице. Количество осталось 2 на странице обзора, что исключает видимое несоответствие количества.
judge() подтвердил сборку ns-1041, сравнил 4 значения с ожидаемыми и обнаружил ошибку только в промежуточном итоге на обзоре.
Эксперимент использует только такой вердикт:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}После выхода фикса отправьте ещё одно сообщение в ту же сессию.
Этот небольшой регрессионный тест использует те же инструкции и ту же функцию вердикта.
Исправление в сборке ns-1042 — одна строка JavaScript-кода Northstar:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);Стартовая ссылка включает ?reset=1, поэтому повторный тест начинается с пустой корзины. Затем продолжение уходит в ту же сессию:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
Повторный тест сохранил хостируемое окружение и не потребовал нового одобрения источника. Не полагайтесь на состояние браузера: куки могут истечь, а переразвёртывание окружения очищает его.
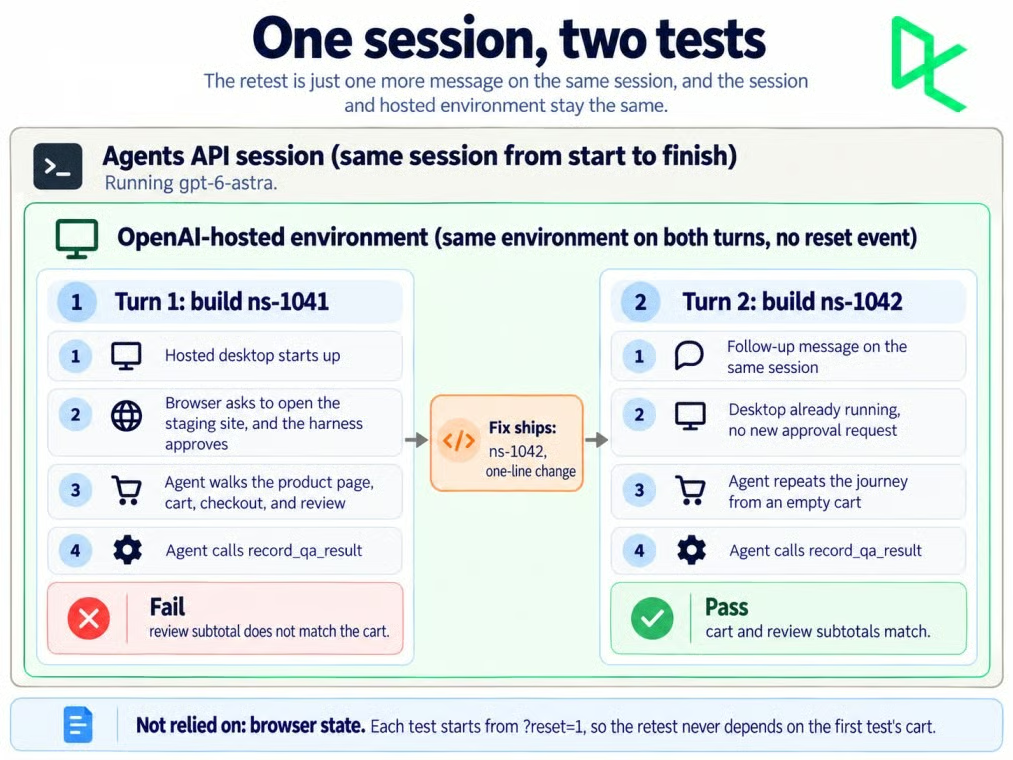
Одна сессия выполняла оба QA-теста. Изображение автора.
Хостируемая «песочница» может быть удалена, если активность и keep-alive прекращаются на 1 час. Следите за agent.session.environment.reset и начинайте каждый ретест из известного состояния.
Да. Повторный тест сообщил количество в корзине 2 и $48.00, затем на обзоре — количество 2 и $48.00, и judge() вернул pass без проваленных проверок.
Он занял 38.9 секунды с 5 элементами активности браузера против 96.5 секунды и 7 элементов в первом тесте, где было 47 секунд ожидания перед началом активности.
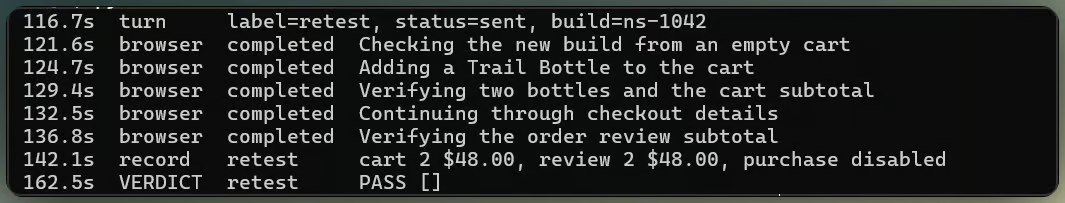
Повторный тест прошёл без нового одобрения. Изображение автора.
Не обязательно. Даже при включённом include_screenshots первый тест вернул 2 скриншота из 7 элементов активности браузера, а повторный — 2 из 5.
Некоторые элементы возвращают output: null, поэтому отчёты не могут предполагать картинку на каждую активность.
Поток событий — это не непрерывный видеопоток хостируемого браузера; он возвращает элементы активности браузера и скриншоты по мере доступности.
Northstar использует rrweb для записи изменений и взаимодействий DOM, отправляет их на тот же хост и воспроизводит оба прохождения ниже.
Браузер агента на обеих стендовых сборках. Видео автора.
Повтор показывает количество 2 и $24.00 на ns-1041, затем $48.00 на ns-1042; неактивная кнопка покупки остаётся нетронутой.
В репозитории также есть небольшой просмотрщик на Streamlit для сохранённого вердикта, доказательств из браузера, сведений о сессии, стоимости и лога событий.
Ориентировочные счётчики использования дали стандартную оценку стоимости токенов $0.9469 за оба теста.
| Метрика | Тест 1 (ns-1041) |
Повторный тест (ns-1042) |
|---|---|---|
| Входные токены | 255,550 | 223,533 |
| Кэшированные входные токены | 217,041 (84.9%) | 219,449 (98.2%) |
| Выходные токены | 982 | 708 |
| Оценочная стоимость токенов | $0.6512 | $0.2957 |
| Время хода | 96.5 секунды | 38.9 секунды |
| Элементы активности браузера | 7 | 5 |
Повторный тест использовал меньше входных токенов, и 98.2% из них пришлись на кэш подсказок. Вместе 2 теста стоили $0.9469.
Руководство по наблюдаемости говорит, что usage может быть null, если он неизвестен, и что записанные значения могут меняться, поэтому проверьте их снова перед удалением сессии.
Когда проводились тесты, это были стандартные тарифы GPT-6 Astra на странице цен OpenAI:
| Тип токенов | Ставка за 1 млн токенов |
|---|---|
| Вход | $10.00 |
| Кэшированный вход | $1.00 |
| Запись в кэш | $12.50 |
| Выход | $50.00 |
Порог длинного контекста 272K применяется к каждому запросу. Суммарный вход обоих ходов оставался ниже этого уровня, поэтому ни один запрос не мог вызвать более высокие ставки для длинного контекста.
Оценка всё равно не воспроизводит финальный счёт, поскольку использование Agents API ориентировочное и не раскрывает отдельные значения записей в кэш.
Хостируемая «песочница» тарифицируется отдельно по стандартным ставкам за контейнер. На странице цен указан контейнер medium с 4 ГБ по $0.12 за 20-минутную сессию; подходящие сессии контейнеров тарифицируются поминутно с минимумом 5 минут.
Безопасность зависит от того, к чему может получить доступ браузер и что позволяет сделать страница.
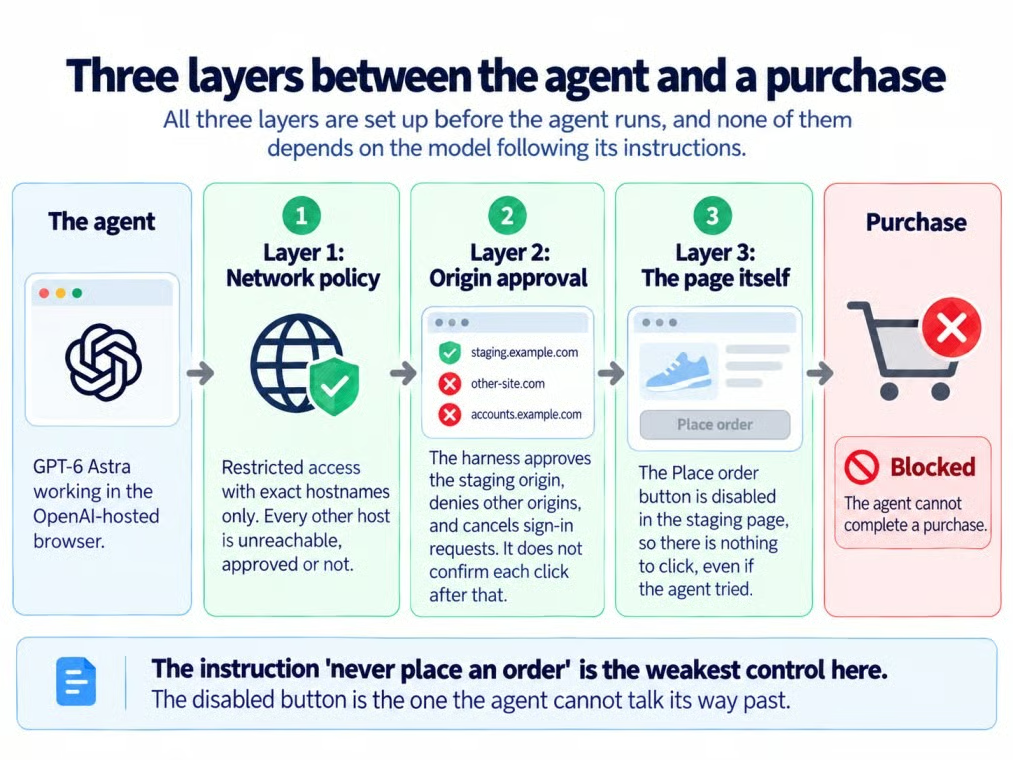
Три слоя между агентом и оформлением заказа. Изображение автора
Сетевая политика контролирует, к каким хостам может обращаться браузер, а одобрение источника решает, можно ли открывать каждый новый origin. Ни то, ни другое не подтверждает отдельные действия в браузере.
Таким образом, одобрение northstar-checkout-staging.vercel.app не одобряет каждое нажатие по отдельности.
Правило «без покупки» — это ограничение по безопасности, а purchase_control сохраняется как свидетельство, а не оценивается как критерий приёмки. Отключённая кнопка «Place order» в Northstar — это контроль, который его обеспечивает.
При restricted браузер может обращаться только к перечисленным именам хостов.
Руководство по «песочнице» OpenAI допускает от 1 до 100 точных имён хостов — без подстановок, протоколов, путей и портов. Сети доставки контента (CDN), поддомены и цели редиректов требуют отдельных записей.
Скриншоты и записи rrweb содержат всё, что показывает страница, поэтому Northstar использует вымышленные данные, не имеет логина и сообщает о записи в подвале.
Рекордер маскирует ввод, но на продакшене всё равно нужна политика обработки данных и маскировка, соответствующая странице.
Agents API поддерживает хранение данных только в США и не подходит для Zero Data Retention (ZDR), даже с самохостируемой «песочницей».
Сохраняйте нужные результаты и скриншоты, затем удаляйте сессию, вместо того чтобы оставлять стендовый чекаут в сохранённом состоянии сессии.
Удаление сессии Agents API не удаляет записи rrweb, сохранённые сайтом. Удаляйте их отдельно в соответствии с политикой записи.
Northstar провалился, когда промежуточные итоги корзины и обзора разошлись, а затем прошёл после исправления в той же сессии. Решение по обоим случаям принимал harness, а не сводка модели.
Скриптовые регрессионные тесты я бы оставил для известных инвариантов, а целеполагающих браузерных агентов — для исследовательских сценариев, которые сложнее выразить в виде assert. Агент исследует; решение принимает код приложения.
Для основ API рекомендуем наш курс Working with the OpenAI API.
Лучшие курсы DataCamp
Курс
Трек
Курс