Kurs
Praca z API OpenAI
3 godz.
179.5K
Wyobraź sobie checkout, który w koszyku pokazuje 48 $ , a na stronie podsumowania 24 $. Klient widzi dwie różne kwoty w tym samym procesie zakupu.
Zespoły zwykle uruchamiają testy jakości (QA) dla tego przepływu za pomocą skryptu przeglądarkowego: kliknij ten przycisk, otwórz tamtą stronę, sprawdź tę wartość. Taki test sprawdza tylko te stany, które autor rozpisał.
Agent AI to model, który potrafi podejmować działania w kierunku celu. Agents API od OpenAI zarządza pętlą agenta i utrzymuje jego pracę w sesji. W tym samouczku Computer Use dostarcza także hostowaną przeglądarkę.
Northstar Checkout to fikcyjny sklep testowy z ukrytym błędem w podsumaowaniu.
Agent zna poprawny wynik checkoutu, ale nie zna lokalizacji błędu ani listy przycisków do kliknięcia. Mały program w Pythonie, zwany „harness”, porównuje wartości raportowane przez agenta, a następnie prosi tę samą sesję o przetestowanie naprawionej wersji sklepu.
W tym samouczku pokażę, jak:
Kod i pomiary używają wersji 3.22.1 pakietu Pythona openai.
Jeśli masz tylko minutę, oto najważniejsze wnioski.
computer_use_call.To jeden testowy sklep z jednym „zasadzonym” błędem, a nie benchmark niezawodności.
Computer Use to narzędzie w OpenAI Agents API, które pozwala agentowi obsługiwać przeglądarkę uruchomioną na serwerach OpenAI. Twój kod śledzi zdarzenia sesji i odpowiada na jej prośby. OpenAI wymienia testowanie stron jako jedno z zastosowań.
OpenAI zarządza pętlą agenta, sesją i odzyskiwaniem po błędach. Nasz samouczek OpenAI Agents API omawia te podstawy.
Starsze konfiguracje computer use, jak ta w naszym samouczku computer use dla GPT-5.4, zamiast tego każą pętli zrzutów i akcji działać w kodzie dewelopera.
W QA przeglądarkowym to sama strona jest przedmiotem testu.
Bezpośrednie wywołanie API checkoutu pominęłoby stronę, na której ukryty jest błąd Northstara, więc agent podąża tą samą ścieżką co klient: od strony produktu przez koszyk, checkout i podsumowanie.
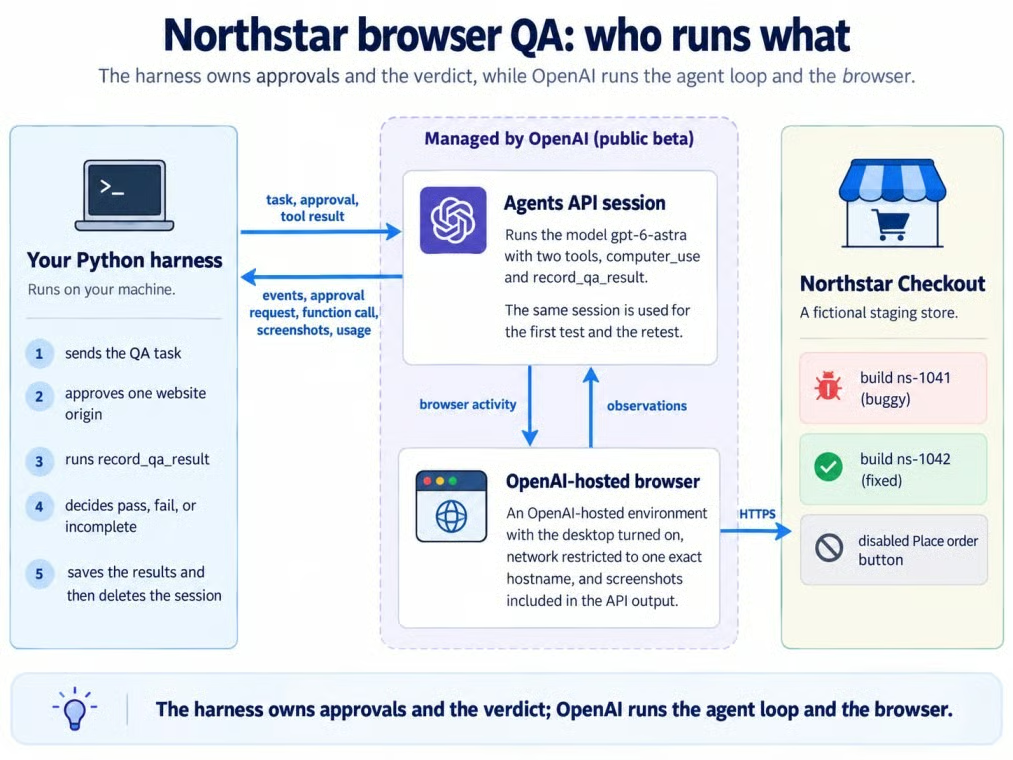
Harness, sesja, hostowana przeglądarka, środowisko testowe. Ilustracja autora.
OpenAI zarządza sesją i przeglądarką wewnątrz szarej strefy; harness i Northstar pozostają poza nią.
Projekt to fikcyjny sklep stagingowy, harness w Pythonie i jedna sesja Agents API.
Kompletny kod znajdziesz w tym repozytorium na GitHubie.
Northstar sprzedaje jedną butelkę Trail Bottle za 24 $. Test przechodzi od produktu do koszyka, checkoutu i podsumowania; nie ma wysyłki, podatków, logowania ani działającego przycisku zakupu.
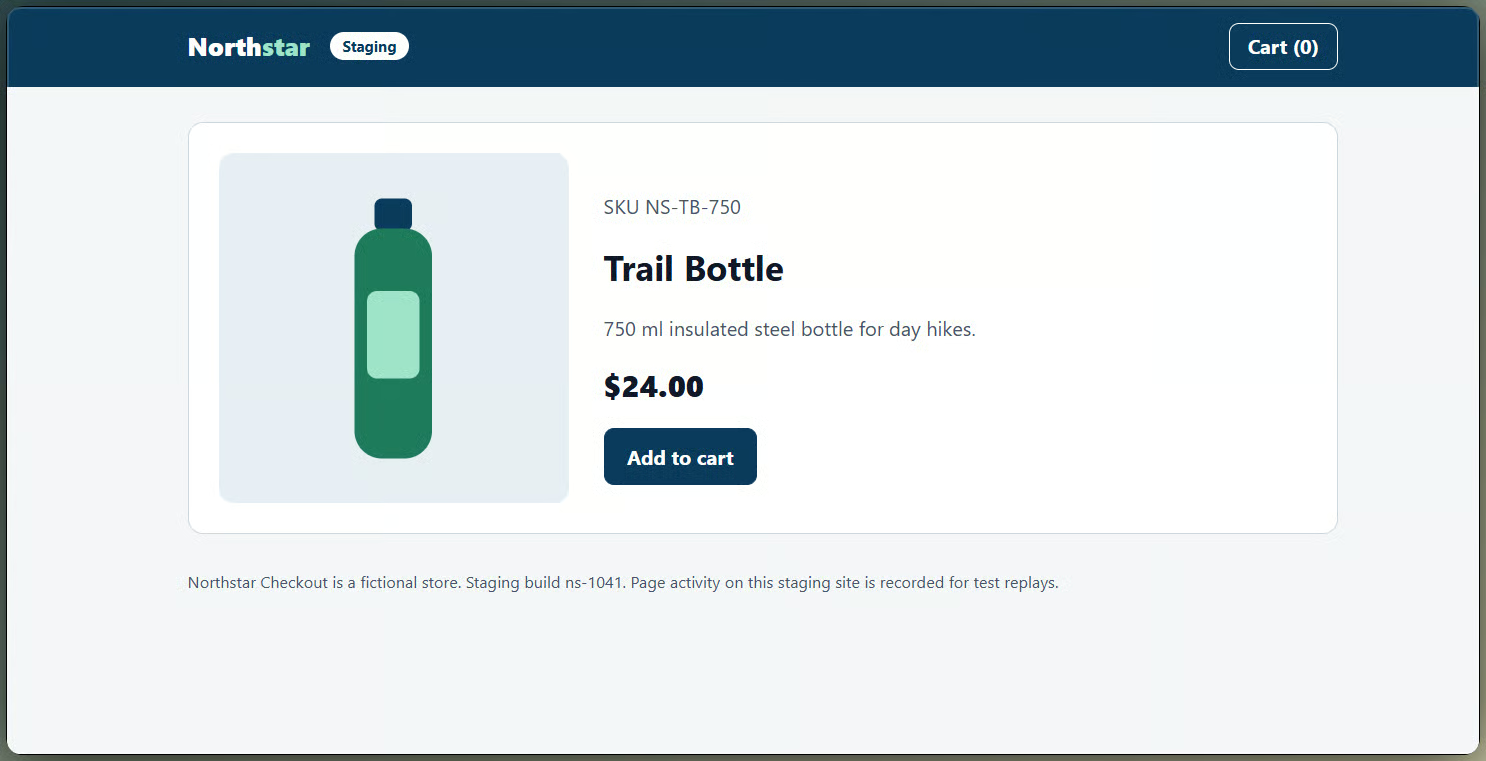
Strona produktu Northstar przed testem. Ilustracja autora.
Build ns-1041 zawiera błąd, a ns-1042 — poprawkę. Dodanie ?reset=1 do startowego URL-a buildu opróżnia koszyk przed każdym testem.
Prośba QA jest napisana jako cel. Kryteria akceptacji proszą agenta, aby:
Oddzielne ograniczenie bezpieczeństwa mówi, by nigdy nie składać, nie wysyłać ani nie opłacać zamówienia. Prośba definiuje wynik, nie kliknięcia.
Błędny build sumuje ceny jednostkowe na stronie podsumowania i zapomina o ilości. Obie strony pokazują ilość 2, ale podsuma w koszyku to 48,00 $, a na podsumowaniu 24,00 $.
Klucz odpowiedzi jest w kodzie aplikacji. Ani instrukcje, ani wiadomość z zadaniem nie wspominają o błędzie.
Agent raportuje ID buildu i 4 zaobserwowane wartości przez jedno narzędzie funkcji, record_qa_result.
Harness najpierw sprawdza, czy raportowany build to ten testowany — oba buildy mają ten sam hostname — a potem porównuje wartości z kluczem odpowiedzi.
Narzędzie funkcji uruchamia się tylko, jeśli agent je wywoła. Brak rekordu, brak wartości lub zły build powoduje wynik incomplete, który nigdy nie liczy się jako zaliczony.
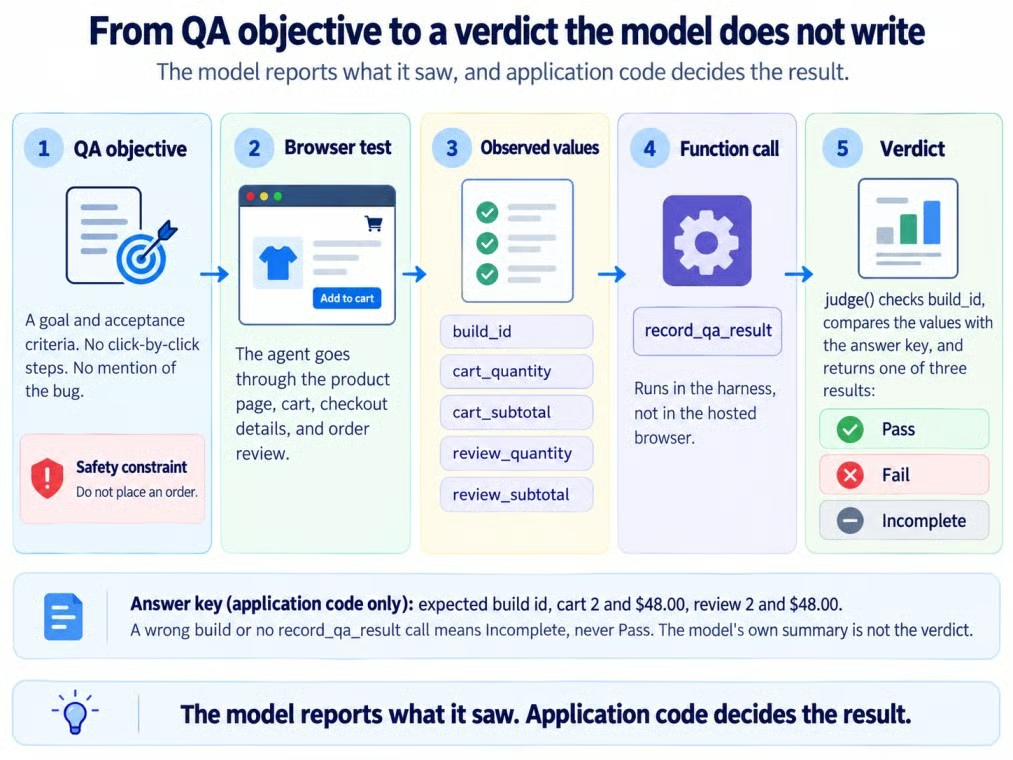
Od celu QA do werdyktu aplikacji. Ilustracja autora.
Potrzebujesz Pythona, klucza API z odpowiednimi zakresami, dostępu do GPT-6 Astra i jednej sesji z Computer Use.
openai==3.22.1 (SDK samo wysyła nagłówek OpenAI-Beta: agents=v1)api.agents.read, api.agents.write i api.responses.write w projekcie, który może używać gpt-6-astraAgents API jest w publicznej becie, więc nazwy pól i zachowanie mogą zmieniać się między wydaniami SDK. Repozytorium przypina wersję 3.22.1 w requirements.txt.
Hostowana przeglądarka potrzebuje dostępnego URL-a, więc kod używa wdrożenia Northstar na Vercel.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
Więcej o izolacji zależności znajdziesz w naszym przewodniku po wirtualnych środowiskach. Na macOS lub Linuksie aktywuj poleceniem source .venv/bin/activate, a plik skopiuj przez cp. Trzymaj klucz w .env, nigdy w kodzie.
Eksperyment używa GPT-6 Astra, modelu z przykładów Computer Use od OpenAI. Nasz przegląd GPT-6 Astra omawia sam model.
Kod używa Agents API (client.beta.agents), a nie Agents SDK ani narzędzia computer z Responses API użytego w naszym samouczku GPT-6 Astra API.
Utwórz jedną sesję z narzędziem computer_use i hostowanym przez OpenAI pulpitem, a następnie użyj jej ponownie dla obu testów:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True udostępnia ewentualne zrzuty ekranu zwracane przez API, a ograniczony dostęp do sieci ogranicza przeglądarkę do Northstara.
Środowisko używa domyślnego rozmiaru medium (2 vCPU, 4 GB RAM).
Funkcja zapisuje to, co agent zaobserwował. Jeśli agent nie potrafi odczytać jednej z 4 sprawdzanych wartości ilości lub podsumaowania, musi zgłosić to pole jako null.
Wymienienie każdej właściwości w required każe modelowi odpowiedzieć na wszystkie, używając null dla tego, czego nie widział. Harness i tak traktuje brakujące pole jako incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
Harness konwertuje każdą wyświetloną cenę na centy, weryfikuje ID buildu i porównuje wartości z kluczem odpowiedzi:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Nieczytelna lub brakująca wartość daje werdykt incomplete, nigdy zaliczony.
Raport z niewłaściwego buildu zwraca incomplete zanim jego wartości mogłyby wpłynąć na wynik.
Te same instrukcje obowiązują w obu testach:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Między testami zmienia się tylko wersja strony.
Otwórz strumień zdarzeń, wyślij cel QA raz, po czym obsługuj zgody i wywołania funkcji aż do zakończenia tury.
Najpierw otwórz strumień zdarzeń, potem wyślij zadanie dokładnie raz:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Strumienie nie odtwarzają pominiętych zdarzeń. Jeśli strumień padnie, otwórz nowy, a następnie pobierz sesję i jej zapisane elementy, dopóki połączenie się utrzymuje.
Wiadomość z zadaniem podaje build, kryteria akceptacji i ograniczenie bezpieczeństwa, ale nie wspomina o błędzie:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Zachowaj ID sesji do ponownego testu.
Hostowana przeglądarka prosi o zgodę przed otwarciem każdej nowej domeny pochodzenia.
Strumień emituje agent.session.requires_action; pobierz sesję i odczytaj required_actions, aby poznać żądanie.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Praca przeglądarki pojawia się jako elementy computer_use_call, każdy z krótkim tytułem i statusem. Strumień zdarzeń dla pierwszego testu pokazał:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Minęło około 47 sekund, zanim zaczęła się pierwsza aktywność przeglądarki.
Wszystkie 7 elementów computer_use_call zakończyło się powodzeniem, ale status elementu to nie werdykt QA; o wyniku decyduje rezultat funkcji.
Tak. Co ważniejsze, wywołanie funkcji odizolowało porażkę do jednego pola: podsumaowania na podsumowaniu.
Wywołanie record_qa_result zawierało:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Każda wartość zgadza się ze stroną z błędem. Ilość na stronie podsumowania pozostała 2, co wyklucza widoczną rozbieżność w ilości.
judge() potwierdził build ns-1041, porównał 4 wartości z oczekiwanymi i uznał, że tylko podsuma na podsumowaniu jest zła.
To jedyny werdykt użyty w eksperymencie:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Po wdrożeniu poprawki wyślij jeszcze jedną wiadomość do tej samej sesji.
Ten mały test regresji używa tych samych instrukcji i funkcji werdyktu.
Poprawka w buildzie ns-1042 to jedna linijka JavaScriptu Northstara:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);Link startowy zawiera ?reset=1, więc retest zaczyna od pustego koszyka. Następnie kontynuacja trafia do tej sameej sesji:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
Retest zachował hostowane środowisko i nie wymagał nowej zgody na pochodzenie. Nie polegaj na stanie przeglądarki, bo cookies mogą wygasnąć, a recykling środowiska je czyści.
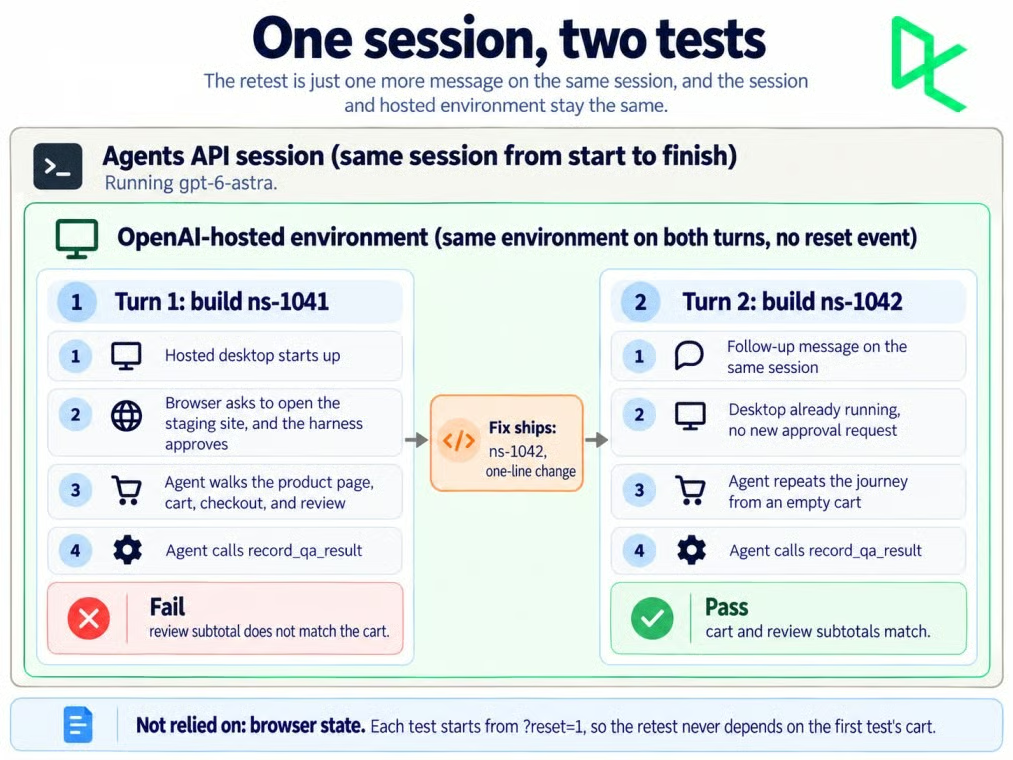
Jedna sesja obsłużyła oba testy QA. Ilustracja autora.
Hostowana piaskownica może zostać usunięta, jeśli aktywność i keep-alive’y ustaną na 1 godzinę. Obserwuj agent.session.environment.reset i zaczynaj każdy retest z znanego stanu.
Tak. Retest zgłosił w koszyku ilość 2 i 48,00 $, a na podsumowaniu ilość 2 i 48,00 $, a judge() zwrócił pass bez niezdanych kontroli.
Zajął 38,9 s z 5 elementami aktywności przeglądarki, wobec 96,5 s i 7 elementów w pierwszym teście, który obejmował 47-sekundowe oczekiwanie przed startem aktywności.
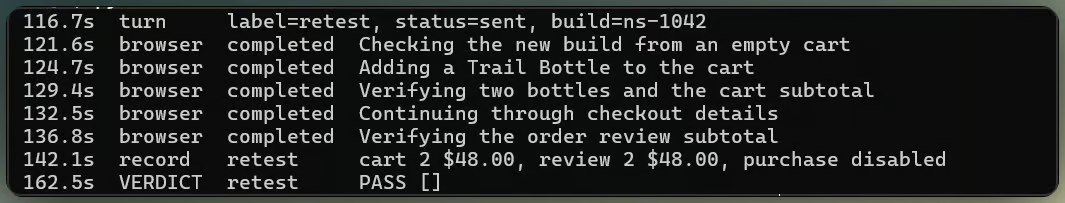
Retest przeszedł bez nowej zgody. Ilustracja autora.
Niekoniecznie. Nawet przy włączonym include_screenshots pierwszy test zwrócił 2 zrzuty z 7 elementów aktywności, a retest 2 z 5.
Niektóre elementy zwracają output: null, więc raporty nie mogą zakładać obrazka dla każdej aktywności.
Strumień zdarzeń to nie ciągły podgląd wideo hostowanej przeglądarki; zwraca elementy aktywności przeglądarki i zrzuty, gdy są dostępne.
Northstar używa rrweb, by rejestrować zmiany w DOM i interakcje, wysyłać je na ten sam host i odtwarzać obie ścieżki poniżej.
Przeglądarka agenta na obu buildach stagingowych. Wideo autora.
Odtworzenie pokazuje ilość 2 i 24,00 $ na ns-1041, a potem 48,00 $ na ns-1042; wyłączony przycisk zakupu pozostaje nietknięty.
Repozytorium zawiera też mały podgląd w Streamlit dla zapisanego werdyktu, materiału dowodowego z przeglądarki, szczegółów sesji, kosztu i dziennika zdarzeń.
Liczniki użycia „best effort” oszacowały koszt tokenów w standardowej stawce na 0,9469 $ dla obu testów.
| Metryka | Test 1 (ns-1041) |
Retest (ns-1042) |
|---|---|---|
| Tokeny wejściowe | 255 550 | 223 533 |
| Buforowane tokeny wejściowe | 217 041 (84,9%) | 219 449 (98,2%) |
| Tokeny wyjściowe | 982 | 708 |
| Szacowany koszt tokenów | 0,6512 $ | 0,2957 $ |
| Czas tury | 96,5 sekundy | 38,9 sekundy |
| Elementy aktywności przeglądarki | 7 | 5 |
Retest zużył mniej tokenów wejściowych, a 98,2% z nich pochodziło z podręcznego cache promptów. Razem 2 testy kosztowały 0,9469 $.
Przewodnik po obserwowalności mówi, że wykorzystanie może być null, gdy jest nieznane, a zapisane liczniki mogą się zmieniać, więc sprawdź je ponownie przed usunięciem sesji.
Gdy uruchamiałem testy, na stronie cennika OpenAI widniały takie standardowe stawki dla GPT-6 Astra:
| Typ tokenu | Stawka za 1 mln tokenów |
|---|---|
| Wejściowe | 10,00 $ |
| Buforowane wejściowe | 1,00 $ |
| Zapis do cache | 12,50 $ |
| Wyjściowe | 50,00 $ |
Próg długiego kontekstu 272 tys. dotyczy pojedynczego żądania. Łączne wejście obu tur było poniżej tego progu, więc żadne pojedyncze żądanie nie mogło uruchomić wyższych stawek dla długiego kontekstu.
Szacunek nadal nie odtworzy końcowej faktury, bo użycie Agents API jest „best effort” i nie ujawnia oddzielnych liczników zapisów do cache.
Hostowana piaskownica jest rozliczana osobno według standardowych stawek za kontenery. Strona cennika podaje kontener medium 4 GB po 0,12 $ za 20-minutową sesję, z kwalifikującymi się sesjami liczonymi za minutę i minimum 5 minut.
Bezpieczeństwo zależy od tego, do czego przeglądarka ma dostęp i co pozwala zrobić strona.
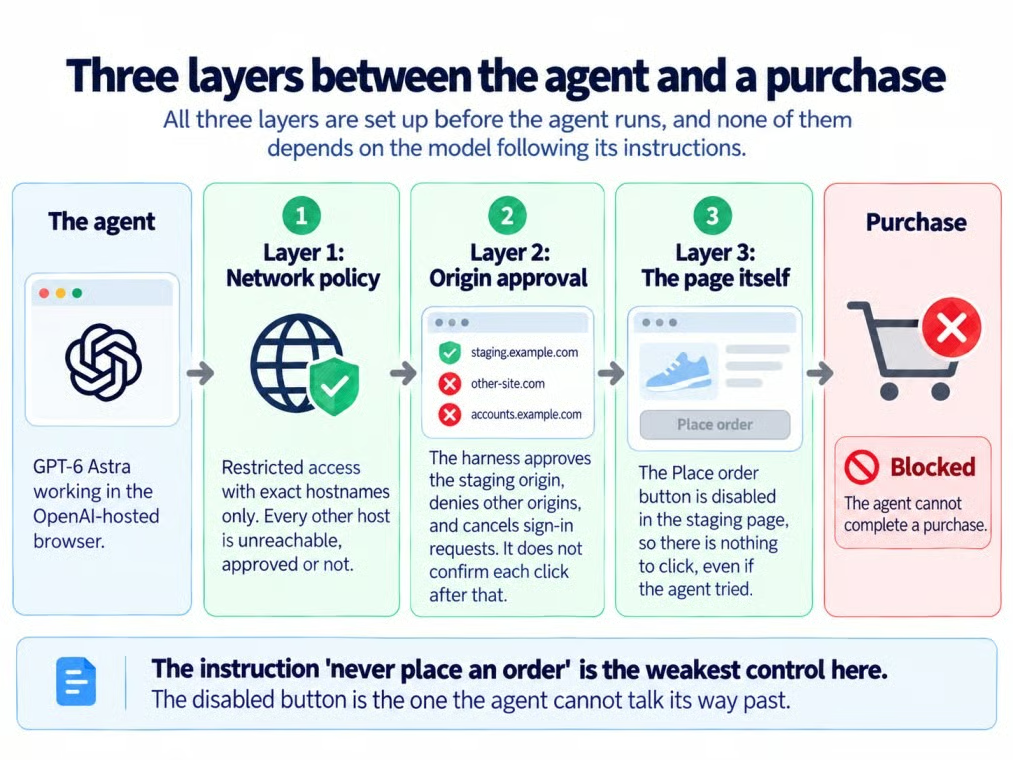
Trzy warstwy między agentem a checkoutem. Ilustracja autora
Polityka sieciowa kontroluje, jakie hosty przeglądarka może osiągnąć, a zatwierdzanie pochodzenia decyduje, czy może otworzyć każdą nową domenę pochodzenia. Żadna nie potwierdza pojedynczych akcji w przeglądarce.
Zatwierdzenie northstar-checkout-staging.vercel.app nie oznacza więc osobnej zgody na każde kliknięcie.
Zasada „bez zakupu” jest ograniczeniem bezpieczeństwa, a purchase_control jest zapisywana jako dowód, a nie oceniana jako kryterium akceptacji. Wyłączony przycisk „Place order” w Northstar to kontrola, która ją egzekwuje.
Przy restricted przeglądarka może dotrzeć tylko do hostów, które podasz.
Przewodnik po piaskownicy OpenAI akceptuje od 1 do 100 dokładnych nazw hostów, bez wildcardów, protokołów, ścieżek i portów. CDN-y, subdomeny i cele przekierowań wymagają osobnych wpisów.
Zrzuty ekranu i nagrania rrweb zawierają to, co pokazuje strona, więc Northstar używa fikcyjnych danych, nie ma logowania i informuje o nagrywaniu w stopce.
Rejestrator maskuje pola wejściowe, ale wdrożenie produkcyjne i tak wymagałoby polityki danych i maskowania dopasowanych do strony.
Agents API wspiera rezydencję danych tylko w Stanach Zjednoczonych i nie kwalifikuje się do Zero Data Retention (ZDR), nawet z samodzielnie hostowaną piaskownicą.
Zapisz potrzebne wyniki i zrzuty, a potem usuń sesję, zamiast zostawiać stagingowy checkout w zachowanym stanie sesji.
Usunięcie sesji Agents API nie usuwa nagrań rrweb przechowywanych przez stronę. Usuń je osobno zgodnie z polityką nagrywania.
Northstar oblał, gdy podsuma koszyka i podsumowania się rozjechały, a następnie zdał po poprawce w tej samej sesji. O obu werdyktach zadecydował harness, a nie podsumowanie modelu.
Zachowałbym skryptowe testy regresyjne dla znanych niezmienników, a agentów przeglądarkowych z celami używał do eksploracyjnych ścieżek, które trudniej wyrazić jako asercję. Agent eksploruje; decyzję podejmuje kod aplikacji.
Po podstawy API polecam nasz kurs Working with the OpenAI API.
Najlepsze kursy DataCamp
Kurs
Ścieżka
Kurs