
Kurs
Arbeiten mit der OpenAI-API
3 Std.
179.5K
Stell dir einen Checkout vor, der im Warenkorb $48 anzeigt und auf der Bestellübersichtsseite $24. Der Kunde sieht zwei Gesamtsummen im selben Checkout.
Teams führen dafür üblicherweise Quality-Assurance-(QA)-Tests mit einem Browserskript durch: Klicke diesen Button, öffne jene Seite, prüfe diesen Wert. Ein skriptgesteuerter Test prüft nur die Zustände, die seine Autorin oder sein Autor festgehalten hat.
Ein KI-Agent ist ein Modell, das eigenständig Schritte auf ein Ziel hin ausführen kann. OpenAIs Agents API steuert die Agentenschleife und hält die Arbeit in einer Session zusammen. In diesem Tutorial stellt Computer Use zusätzlich den gehosteten Browser bereit.
Northstar Checkout ist ein fiktiver Testshop mit einem versteckten Zwischensummen-Bug.
Der Agent erhält das korrekte Checkout-Ergebnis, aber weder den Ort des Bugs noch eine Klickliste. Ein kleines Python-Programm, das Harness, vergleicht die vom Agenten gemeldeten Werte und bittet anschließend dieselbe Session, den gefixten Shop zu testen.
In diesem Tutorial zeige ich dir, wie du:
Code und Messwerte nutzen Version 3.22.1 des Python-Pakets openai.
Wenn du nur eine Minute hast, hier die wichtigsten Punkte.
computer_use_call-Items.Das ist ein einzelner Testshop mit einem platzierten Bug, kein Zuverlässigkeits-Benchmark.
Computer Use ist ein Tool in der OpenAI Agents API, mit dem ein Agent einen auf OpenAIs Servern laufenden Browser bedienen kann. Dein Code folgt den Ereignissen der Session und beantwortet deren Anfragen. OpenAI nennt Website-Tests als einen Anwendungsfall.
OpenAI verwaltet die Agentenschleife, die Session und die Wiederherstellung. Unser OpenAI-Agents-API-Tutorial deckt diese Grundlagen ab.
Ältere Computer-Use-Setups, wie in unserem GPT-5.4-Computer-Use-Tutorial, lassen dagegen Entwicklercode den Screenshot-und-Aktions-Loop steuern.
Bei Browser-QA ist die Seite selbst das Testobjekt.
Ein direkter Aufruf einer Checkout-API würde die Seite überspringen, auf der Northstars Bug liegt. Deshalb folgt der Agent dem gleichen Weg wie ein Kunde: von der Produktseite in den Warenkorb, zum Checkout und zur Bestellübersicht.
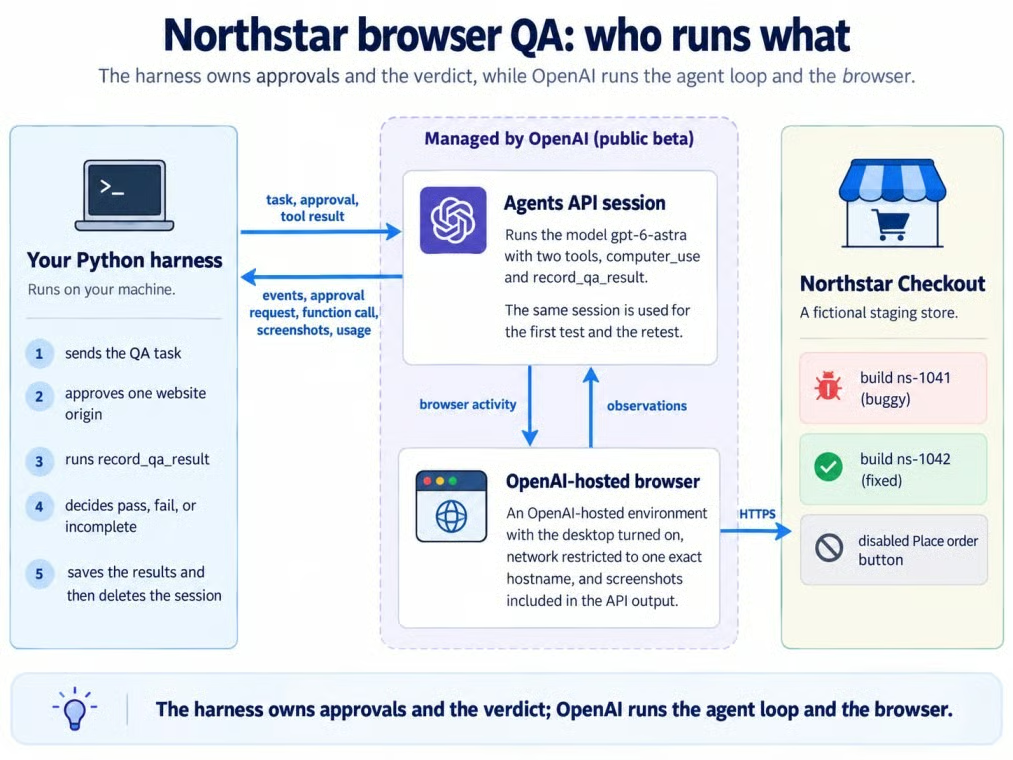
Harness, Session, gehosteter Browser, Staging-Site. Grafik: Autor.
OpenAI verwaltet Session und Browser in der grauen Zone; Harness und Northstar bleiben außerhalb.
Das Projekt umfasst einen fiktiven Staging-Shop, ein Python-Harness und eine Agents-API-Session.
Den vollständigen Code findest du in diesem GitHub-Repository.
Northstar verkauft eine $24 Trail Bottle. Der Test läuft von der Produktseite über Warenkorb und Checkout bis zur Bestellübersicht; es gibt keinen Versand, keine Steuern, kein Login und keinen funktionierenden Kaufen-Button.
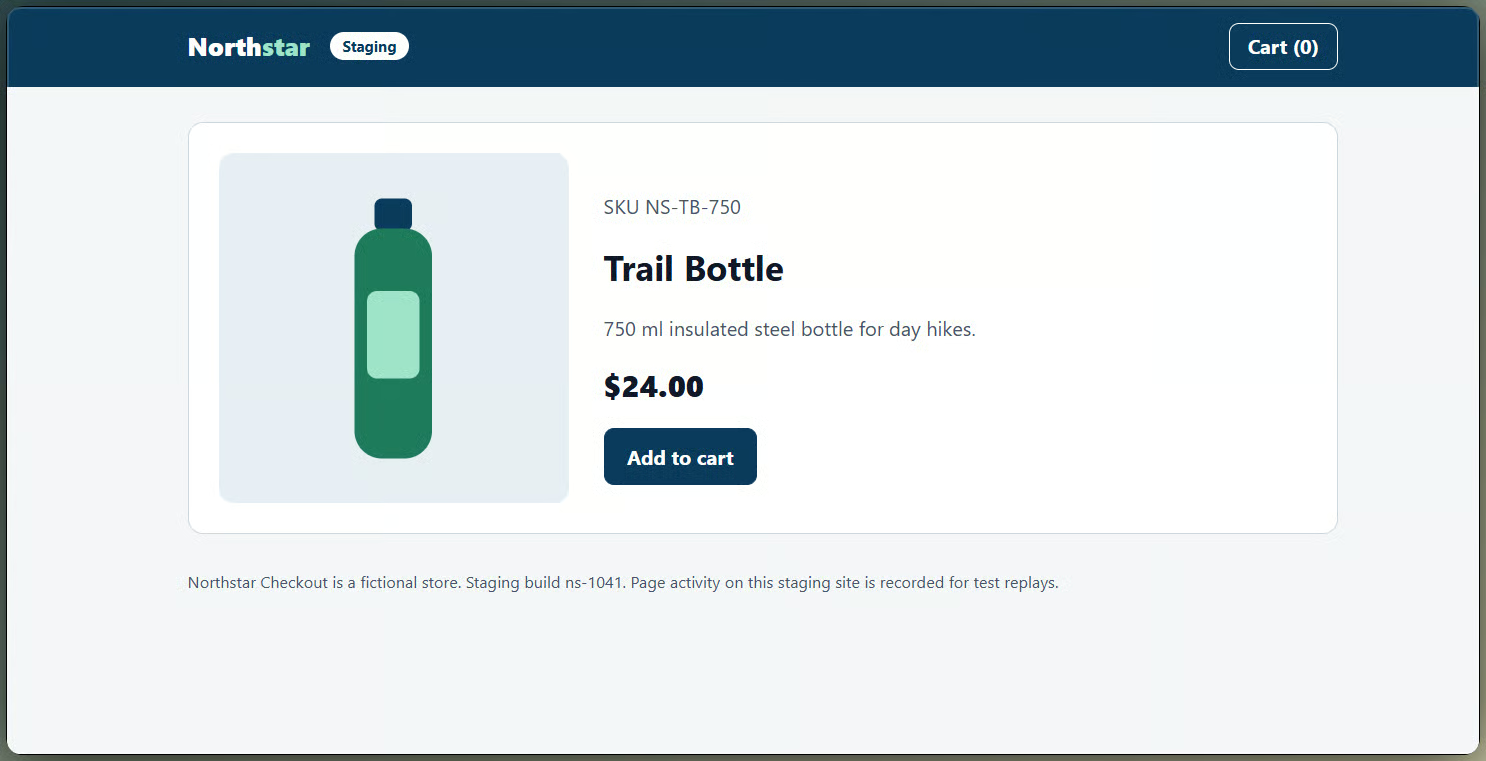
Northstar-Produktseite vor dem Test. Bild: Autor.
Build ns-1041 enthält den Bug, ns-1042 den Fix. Mit ?reset=1 am Startlink eines Builds wird der Warenkorb vor jedem Test geleert.
Die QA-Anfrage ist als Ziel formuliert. Ihre Abnahmekriterien fordern den Agenten auf:
Eine separate Safety-Vorgabe besagt, niemals eine Bestellung aufzugeben, abzusenden oder zu bezahlen. Die Anfrage definiert das Ergebnis, nicht die Klicks.
Die fehlerhafte Version addiert auf der Bestellübersichtsseite die Einzelpreise und ignoriert die Menge. Beide Seiten zeigen Menge 2, aber die Warenkorb-Zwischensumme ist $48.00 und die Review-Zwischensumme $24.00.
Der Lösungsschlüssel steckt im Anwendungscode. Weder die Anweisungen noch die Tasknachricht erwähnen den Bug.
Der Agent meldet die Build-ID und 4 beobachtete Werte über ein Function-Tool, record_qa_result.
Das Harness prüft zuerst, ob der gemeldete Build der getestete ist, da beide Builds denselben Hostnamen teilen, und vergleicht dann die Werte mit dem Lösungsschlüssel.
Ein Function-Tool läuft nur, wenn der Agent es aufruft. Ein fehlender Datensatz, ein fehlender Wert oder der falsche Build ergibt incomplete und zählt nie als bestanden.
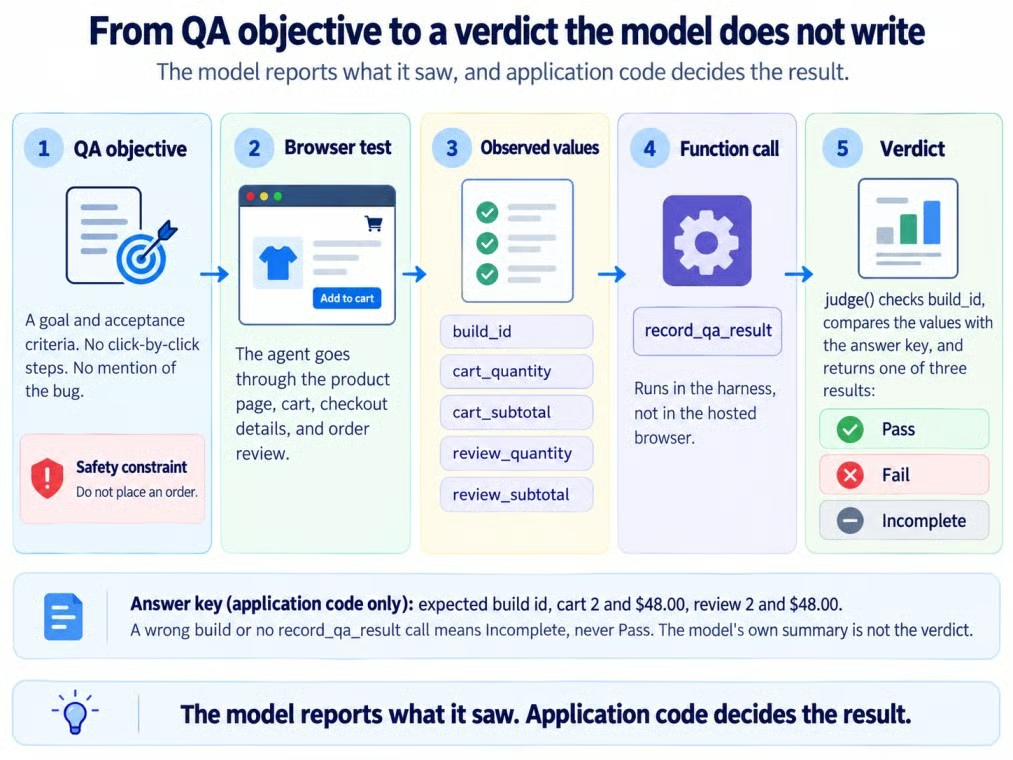
Vom QA-Ziel zum Urteil durch die Anwendung. Bild: Autor.
Du brauchst Python, einen API-Schlüssel mit passenden Scopes, Zugriff auf GPT-6 Astra und eine Session mit Computer Use.
openai==3.22.1 (das SDK sendet den Header OpenAI-Beta: agents=v1 automatisch)api.agents.read, api.agents.write und api.responses.write in einem Projekt, das gpt-6-astra nutzen kannDie Agents API ist in der Public Beta, daher können sich Feldnamen und Verhalten zwischen SDK-Releases ändern. Das Repository pinnt Version 3.22.1 in requirements.txt.
Der gehostete Browser braucht eine erreichbare URL, daher nutzt der Code ein Vercel-Deployment von Northstar.
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # dann deinen OPENAI_API_KEY eintragen
python run_qa.py
Mehr zu isolierten Abhängigkeiten findest du in unserem Guide zur virtuellen Umgebung. Unter macOS oder Linux aktivierst du mit source .venv/bin/activate und kopierst die Datei mit cp. Bewahre den Schlüssel in .env auf, niemals im Code.
Im Experiment kommt GPT-6 Astra zum Einsatz, das Modell aus OpenAIs Computer-Use-Beispielen. Unsere Übersicht zu GPT-6 Astra stellt das Modell vor.
Der Code nutzt die Agents API (client.beta.agents), nicht das Agents SDK oder das GPT-6 Astra API Tutorial mit dem computer-Tool der Responses API.
Erstelle eine Session mit dem Tool computer_use und einem OpenAI-gehosteten Desktop und nutze sie für beide Tests wieder:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", ausdrücklich gesetzt
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True stellt bereit, was auch immer die API an Screenshots zurückliefert, während eingeschränkter Netzwerkzugriff den Browser auf Northstar begrenzt.
Die Umgebung nutzt die Standardgröße medium (2 vCPU, 4 GB RAM).
Die Funktion zeichnet auf, was der Agent beobachtet hat. Kann der Agent einen der 4 geprüften Werte für Menge oder Zwischensumme nicht lesen, muss er dieses Feld als null melden.
Alle Properties unter required aufzulisten, weist das Modell an, alle zu beantworten und für nicht Gesehenes null zu verwenden. Das Harness wertet ein fehlendes Feld trotzdem als incomplete:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
Das Harness wandelt jeden angezeigten Preis in Cents um, verifiziert die Build-ID und vergleicht die Werte mit dem Lösungsschlüssel:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
Ein unlesbarer oder fehlender Wert führt zu incomplete, niemals zu „bestanden“.
Ein Bericht aus dem falschen Build ergibt incomplete, bevor seine Werte das Urteil beeinflussen können.
Die gleichen Anweisungen gelten für beide Tests:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
Nur der Website-Build ändert sich zwischen den Tests.
Öffne den Event-Stream, sende das QA-Ziel einmalig und bearbeite Genehmigungen und Funktionsaufrufe, bis der Turn abgeschlossen ist.
Öffne zuerst den Event-Stream und sende dann die Aufgabe genau einmal:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # erst den Stream öffnen, dann die Aufgabe genau einmal senden
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # wiederverbunden: auf noch offene Aktionen reagieren, Aufgabe nie erneut senden
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
Streams spielen verpasste Events nicht erneut ab. Wenn der Stream abreißt, öffne einen neuen, rufe dann die Session und ihre gespeicherten Items ab, solange die Verbindung steht.
Die Task-Nachricht nennt den Build, die Abnahmekriterien und die Safety-Vorgabe, aber nichts zum Bug:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
Bewahre die Session-ID für den Retest auf.
Der gehostete Browser fragt vor dem Öffnen jeder neuen Website-Origin nach Genehmigung.
Der Stream sendet agent.session.requires_action; hole die Session und lies required_actions für die Anfrage.
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar hat kein Login, daher Anmeldung ablehnen
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])Browserarbeit erscheint als computer_use_call-Items, jeweils mit kurzem Titel und Status. Der Event-Stream für den ersten Test zeigte:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
Etwa 47 Sekunden vergingen bis zur ersten Browseraktivität.
Alle 7 computer_use_call-Items wurden abgeschlossen, aber der Item-Status ist nicht das QA-Urteil; maßgeblich ist das Function-Ergebnis.
Ja. Wichtiger noch: Der Funktionsaufruf isolierte den Fehler auf ein Feld: die Review-Zwischensumme.
Der Aufruf record_qa_result enthielt:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
Jeder Wert entspricht der fehlerhaften Seite. Die Menge blieb auf der Review-Seite 2, damit ist eine sichtbare Mengenabweichung ausgeschlossen.
judge() bestätigte Build ns-1041, verglich die 4 Werte mit den erwarteten Werten und fand nur die Review-Zwischensumme falsch.
Dies ist das einzige Urteil, das das Experiment verwendet:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}Nachdem der Fix live ist, sende eine weitere Nachricht an dieselbe Session.
Dieser kleine Regressionstest nutzt die gleichen Instruktionen und dieselbe Urteilsfunktion.
Der Fix in Build ns-1042 ist eine einzige Zeile in Northstars JavaScript:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);Der Startlink enthält ?reset=1, daher beginnt der Retest mit leerem Warenkorb. Dann geht die Folgemeldung in dieselbe Session:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
Der Retest behielt die gehostete Umgebung und brauchte keine neue Origin-Genehmigung. Verlasse dich nicht auf Browserzustand, da Cookies ablaufen können und das Recyclen der Umgebung ihn löscht.
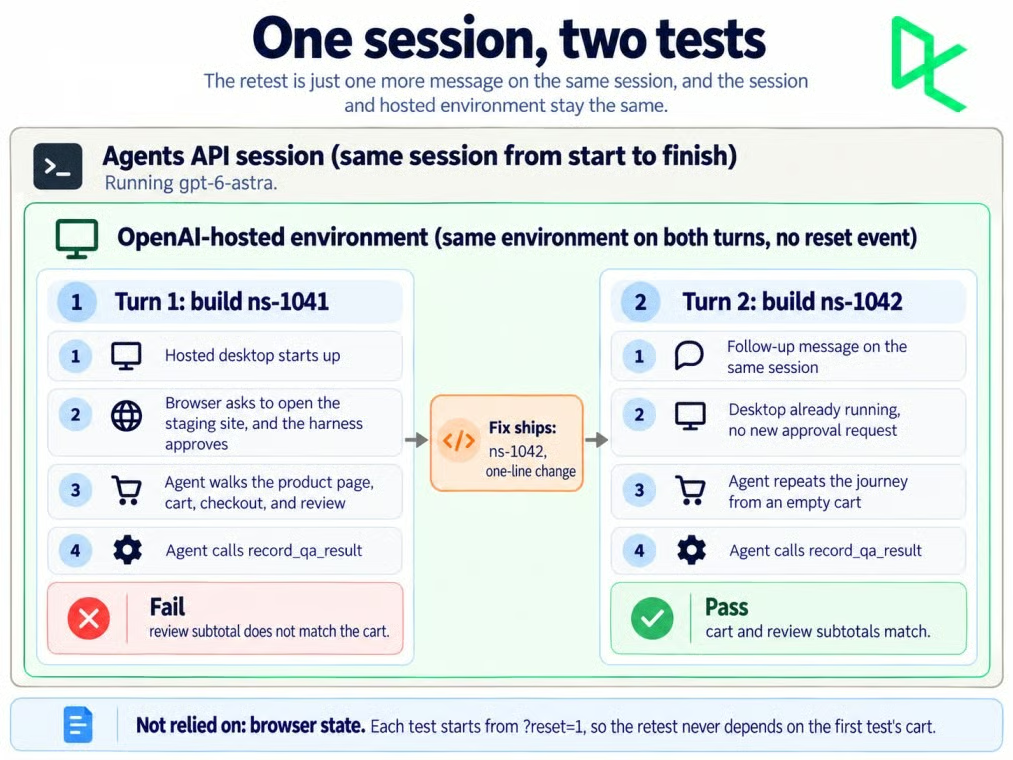
Eine Session trug beide QA-Tests. Bild: Autor.
Eine gehostete Sandbox kann gelöscht werden, wenn Aktivität und Keep-Alives 1 Stunde lang ausbleiben. Achte auf agent.session.environment.reset und starte jeden Retest aus einem bekannten Zustand.
Ja. Der Retest meldete Warenkorb Menge 2 und $48.00, dann Review Menge 2 und $48.00, und judge() gab „pass“ ohne fehlgeschlagene Checks zurück.
Er dauerte 38,9 Sekunden mit 5 Browseraktivitäts-Items gegenüber 96,5 Sekunden und 7 Items im ersten Test, der eine 47-sekündige Wartezeit vor der ersten Browseraktivität beinhaltete.
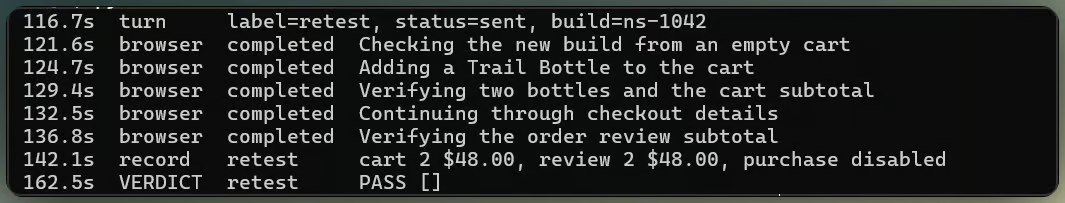
Retest bestand ohne neue Genehmigung. Bild: Autor.
Nicht unbedingt. Selbst mit gesetztem include_screenshots lieferte der erste Test 2 Screenshots aus 7 Browseraktivitäts-Items, der Retest 2 aus 5.
Einige Items geben output: null zurück, daher kann ein Bericht nicht für jede Aktivität ein Bild voraussetzen.
Der Event-Stream ist kein kontinuierlicher Videofeed des gehosteten Browsers; er liefert Browseraktivitäts-Items und bei Verfügbarkeit Screenshots.
Northstar nutzt rrweb, um DOM-Änderungen und Interaktionen aufzuzeichnen, an denselben Host zu senden und beide Journeys unten wiederzugeben.
Der Browser des Agenten auf beiden Staging-Builds. Video: Autor.
Das Replay zeigt Menge 2 und $24.00 auf ns-1041, danach $48.00 auf ns-1042; der deaktivierte Kaufen-Button bleibt unberührt.
Das Repository enthält außerdem einen kleinen Streamlit-Viewer für das gespeicherte Urteil, Browserbelege, Sessiondetails, Kosten und das Event-Log.
Die Best-Effort-Nutzungszähler ergaben eine Standardraten-Token-Schätzung von $0.9469 für beide Tests zusammen.
| Metrik | Test 1 (ns-1041) |
Retest (ns-1042) |
|---|---|---|
| Input-Tokens | 255.550 | 223.533 |
| Gecachte Input-Tokens | 217.041 (84,9%) | 219.449 (98,2%) |
| Output-Tokens | 982 | 708 |
| Geschätzte Tokenkosten | $0.6512 | $0.2957 |
| Dauer pro Turn | 96,5 Sekunden | 38,9 Sekunden |
| Browseraktivitäts-Items | 7 | 5 |
Der Retest nutzte weniger Input-Tokens, und 98,2% davon kamen aus dem Prompt-Cache. Zusammen kosteten die 2 Tests $0.9469.
Der Observability-Guide sagt, dass Nutzungswerte null sein können, wenn unbekannt, und dass aufgezeichnete Zählungen sich ändern können. Prüfe sie daher erneut, bevor du die Session löschst.
Als ich die Tests ausführt habe, galten auf OpenAIs Preisseite diese Standardraten für GPT-6 Astra:
| Tokentyp | Preis pro 1 Mio. Tokens |
|---|---|
| Input | $10.00 |
| Gecachter Input | $1.00 |
| Cache Writes | $12.50 |
| Output | $50.00 |
Die Long-Context-Schwelle von 272 Tsd. gilt pro Anfrage. Die kombinierten Inputs beider Turns blieben darunter, sodass keine einzelne Anfrage die höheren Long-Context-Raten ausgelöst haben kann.
Die Schätzung kann die finale Rechnung trotzdem nicht reproduzieren, da die Agents-API-Nutzung eine Näherung ist und keine separaten Cache-Write-Zählungen ausweist.
Die gehostete Sandbox wird separat zu Standard-Containerraten abgerechnet. Die Preisseite listet den 4-GB-medium-Container mit $0.12 pro 20-Minuten-Session; berechtigte Container-Sessions werden minutenweise mit mindestens 5 Minuten abgerechnet.
Sicherheit hängt davon ab, was der Browser erreichen kann und was die Seite zulässt.
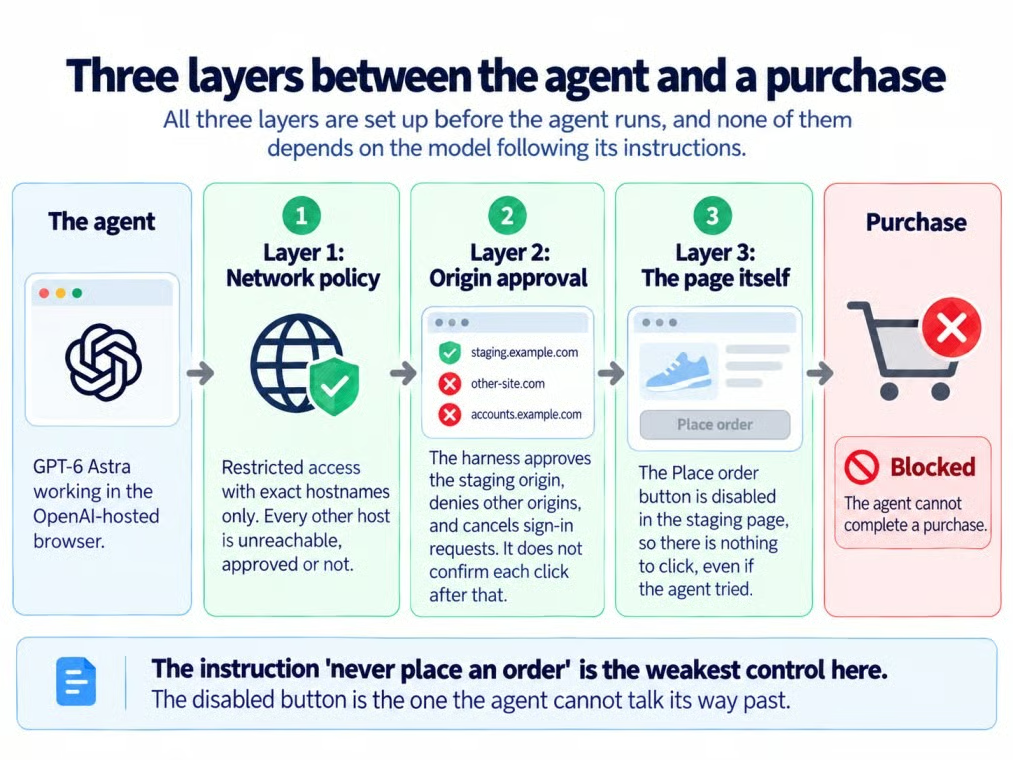
Drei Ebenen zwischen Agent und Checkout. Bild: Autor
Die Netzwerkpolicy steuert, welche Hosts der Browser erreichen darf, und die Origin-Genehmigung entscheidet, ob er jede neue Origin öffnen darf. Keine von beiden bestätigt einzelne Browseraktionen.
Die Genehmigung von northstar-checkout-staging.vercel.app genehmigt daher nicht jeden Klick einzeln.
Die No-Purchase-Regel ist eine Safety-Vorgabe, und purchase_control wird als Beleg gespeichert, statt als Abnahmekriterium gewertet. Northstars deaktivierter „Place order“-Button ist die technische Kontrolle, die sie durchsetzt.
Unter restricted kann der Browser nur die Hostnamen erreichen, die du aufführst.
OpenAIs Sandbox-Guide akzeptiert 1 bis 100 exakte Hostnamen, ohne Wildcards, Protokolle, Pfade oder Ports. Content-Delivery-Netzwerke (CDNs), Subdomains und Redirect-Ziele benötigen eigene Einträge.
Screenshots und rrweb-Aufzeichnungen enthalten, was auch immer die Seite zeigt. Daher nutzt Northstar fiktive Daten, hat kein Login und weist im Footer auf die Aufzeichnung hin.
Der Recorder maskiert Eingaben, aber ein Produktivbetrieb bräuchte dennoch eine passende Datenpolicy und Maskierung für die Seite.
Die Agents API unterstützt Datenresidenz nur in den USA und ist nicht für Zero Data Retention (ZDR) zugelassen, auch nicht mit selbstgehosteter Sandbox.
Speichere die benötigten Ergebnisse und Screenshots und lösche dann die Session, statt einen Staging-Checkout mit gehaltenem Sessionzustand liegen zu lassen.
Das Löschen der Agents-API-Session löscht keine rrweb-Aufzeichnungen, die von der Site gespeichert wurden. Entferne diese separat gemäß der Recording-Policy.
Northstar fiel durch, als Warenkorb- und Review-Zwischensummen auseinanderliefen, und bestand nach dem Fix in derselben Session. Das Harness, nicht die Modellzusammenfassung, entschied beide Urteile.
Ich würde skriptgesteuerte Regressionstests für bekannte Invarianten beibehalten und zielbasierte Browseragenten für explorative Journeys nutzen, die sich schwer als Assertion ausdrücken lassen. Der Agent erkundet, der Anwendungscode entscheidet.
Für API-Grundlagen empfehle ich unseren Kurs Working with the OpenAI API.
Top-DataCamp-Kurse
Kurs
Lernpfad
Kurs