
कोर्स
OpenAI API के साथ काम करना
3 घंटा
179.5K
मान लीजिए कार्ट में $48 दिख रहा है और रिव्यू पेज पर $24। ग्राहक को एक ही चेकआउट में दो अलग-अलग टोटल दिखते हैं।
टीमें आमतौर पर इस फ्लो पर ब्राउज़र स्क्रिप्ट से क्वालिटी एश्योरेंस (QA) टेस्ट चलाती हैं: यह बटन क्लिक करें, वह पेज खोलें, यह मान जांचें। एक स्क्रिप्टेड टेस्ट केवल वही अवस्थाएँ जांचता है जिन्हें उसके लेखक ने लिखा है।
AI एजेंट एक ऐसा मॉडल है जो किसी लक्ष्य की ओर कार्रवाई कर सकता है। OpenAI का Agents API एजेंट लूप को मैनेज करता है और उसके काम को एक सत्र में रखता है। इस ट्यूटोरियल में, Computer Use होस्टेड ब्राउज़र भी उपलब्ध कराता है।
Northstar Checkout एक काल्पनिक टेस्ट स्टोर है जिसमें एक छिपा हुआ सबटोटल बग है।
एजेंट को सही चेकआउट परिणाम मिलता है, लेकिन बग का लोकेशन या क्लिक करने के लिए बटनों की सूची नहीं। एक छोटा Python प्रोग्राम, जिसे हार्नेस कहते हैं, एजेंट द्वारा रिपोर्ट किए गए मानों की तुलना करता है और फिर उसी सत्र से फिक्स्ड स्टोर का परीक्षण करने को कहता है।
इस ट्यूटोरियल में, मैं कवर करूंगा कि कैसे:
कोड और माप openai Python पैकेज के संस्करण 3.22.1 का उपयोग करते हैं।
यदि आपके पास केवल एक मिनट है, तो मुख्य बिंदु यहां हैं।
computer_use_call आइटम्स से।यह एक टेस्ट स्टोर और एक लगाया हुआ बग है, कोई विश्वसनीयता बेंचमार्क नहीं।
Computer Use OpenAI Agents API में एक टूल है जो एजेंट को OpenAI के सर्वरों पर चल रहे ब्राउज़र को ऑपरेट करने देता है। आपका कोड सत्र की घटनाओं का पालन करता है और उसके अनुरोधों का उत्तर देता है। OpenAI वेबसाइट टेस्टिंग को एक उपयोग-किस्म के रूप में सूचीबद्ध करता है।
OpenAI एजेंट लूप, सत्र, और रिकवरी मैनेज करता है। हमारा OpenAI Agents API ट्यूटोरियल इन बुनियादी बातों को कवर करता है।
पुरानी कंप्यूटर यूज़ सेटअप्स, जैसे हमारे GPT-5.4 कंप्यूटर यूज़ ट्यूटोरियल में, स्क्रीनशॉट-और-एक्शन लूप डेवलपर कोड से चलाया जाता था।
ब्राउज़र QA में, परीक्षण के अधीन चीज़ वही पेज है।
सीधे किसी चेकआउट API को कॉल करने से वह पेज छूट जाएगा जहां Northstar का बग है, इसलिए एजेंट ग्राहक की तरह ही रास्ता अपनाता है—प्रोडक्ट पेज से कार्ट, चेकआउट, और रिव्यू तक।
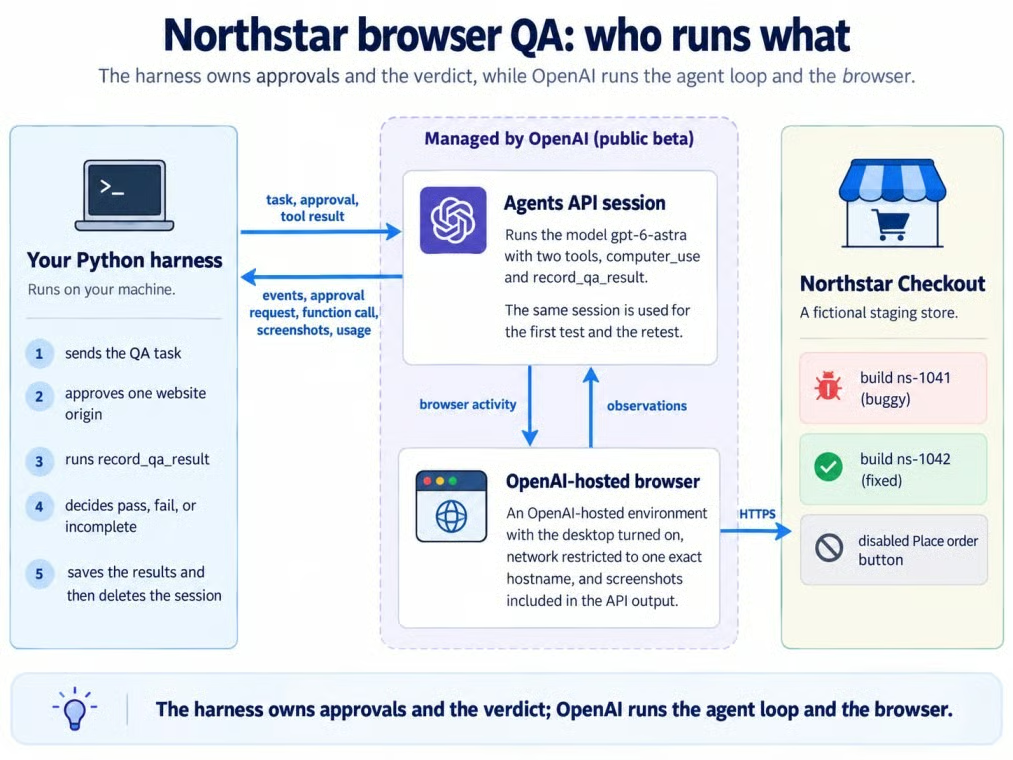
हार्नेस, सत्र, होस्टेड ब्राउज़र, स्टेजिंग साइट। चित्र: लेखक।
OpenAI ग्रे ज़ोन के अंदर सत्र और ब्राउज़र मैनेज करता है; हार्नेस और Northstar इसके बाहर रहते हैं।
यह प्रोजेक्ट एक काल्पनिक स्टेजिंग स्टोर, एक Python हार्नेस, और एक Agents API सत्र है।
पूरा कोड इस GitHub रिपोजिटरी में है।
Northstar एक $24 का Trail Bottle बेचता है। टेस्ट प्रोडक्ट से कार्ट, चेकआउट, और रिव्यू तक जाता है; कोई शिपिंग, टैक्स, लॉगिन, या काम करता खरीद बटन नहीं है।
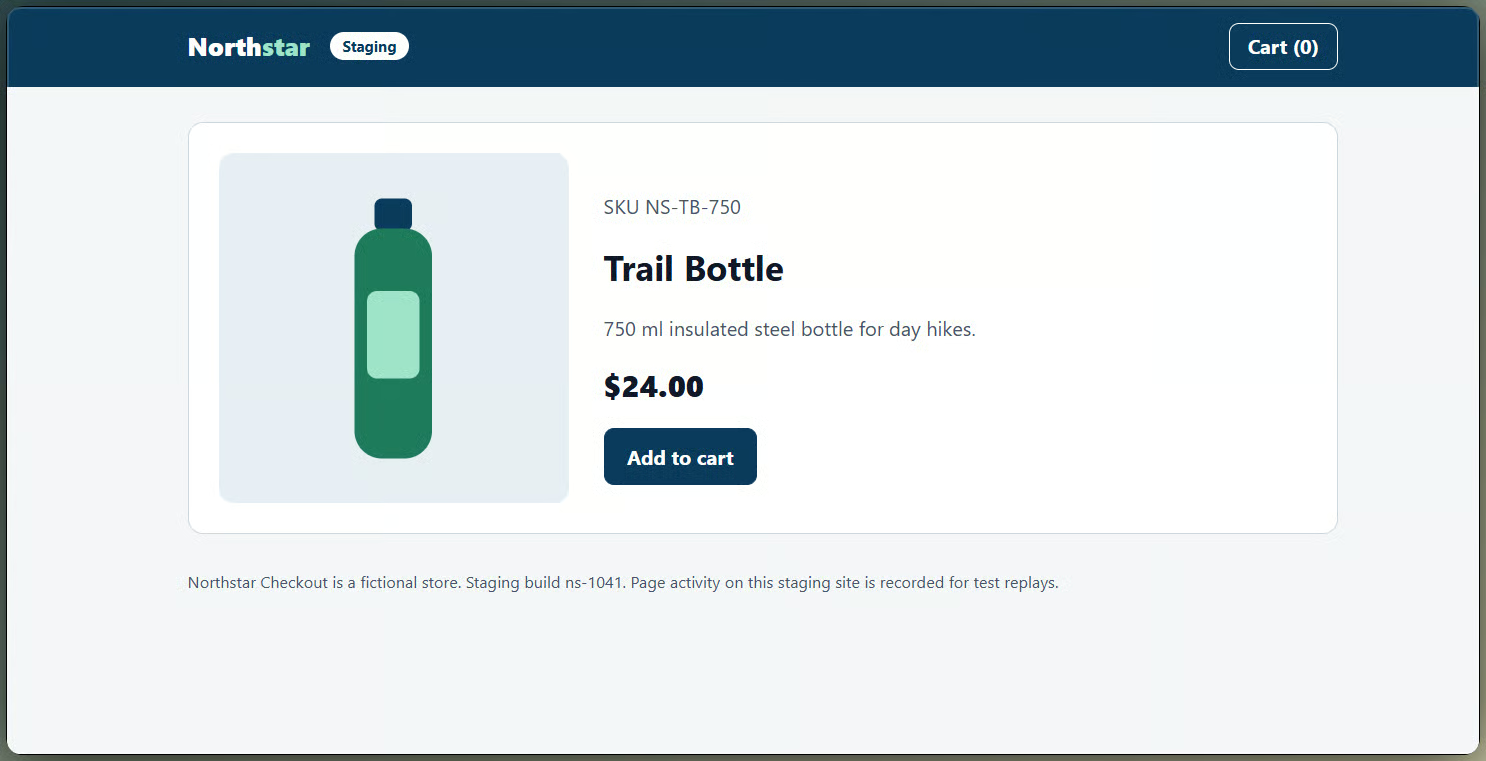
टेस्ट से पहले Northstar प्रोडक्ट पेज। चित्र: लेखक।
बिल्ड ns-1041 में बग है, जबकि ns-1042 में फिक्स है। बिल्ड के स्टार्ट URL में ?reset=1 जोड़ने से दोनों टेस्ट से पहले कार्ट खाली हो जाता है।
QA रिक्वेस्ट को एक लक्ष्य (goal) के रूप में लिखा गया है। इसके स्वीकृति मानदंड एजेंट से कहते हैं:
एक अलग सुरक्षा बाधा कहती है कि कभी कोई ऑर्डर प्लेस, सबमिट, या पे न करें। रिक्वेस्ट क्लिक नहीं, परिणाम परिभाषित करती है।
बगी बिल्ड रिव्यू पेज पर यूनिट प्राइस जोड़ता है और क्वांटिटी भूल जाता है। दोनों पेज क्वांटिटी 2 दिखाते हैं, लेकिन कार्ट सबटोटल $48.00 और रिव्यू सबटोटल $24.00 है।
उत्तर-कुंजी एप्लिकेशन कोड में रहती है। न निर्देशों में और न ही टास्क मैसेज में बग का उल्लेख है।
एजेंट एक फंक्शन टूल record_qa_result के जरिए बिल्ड ID और 4 देखे गए मान रिपोर्ट करता है।
हार्नेस पहले यह जांचता है कि रिपोर्ट किया गया बिल्ड वही है जो परीक्षण में है, क्योंकि दोनों बिल्ड एक होस्टनेम साझा करते हैं, फिर मानों की उत्तर-कुंजी से तुलना करता है।
फंक्शन टूल तभी चलता है जब एजेंट उसे कॉल करे। कोई रिकॉर्ड न होना, कोई मान गायब होना, या गलत बिल्ड होने पर परिणाम incomplete बनता है, जो कभी पास नहीं गिना जाता।
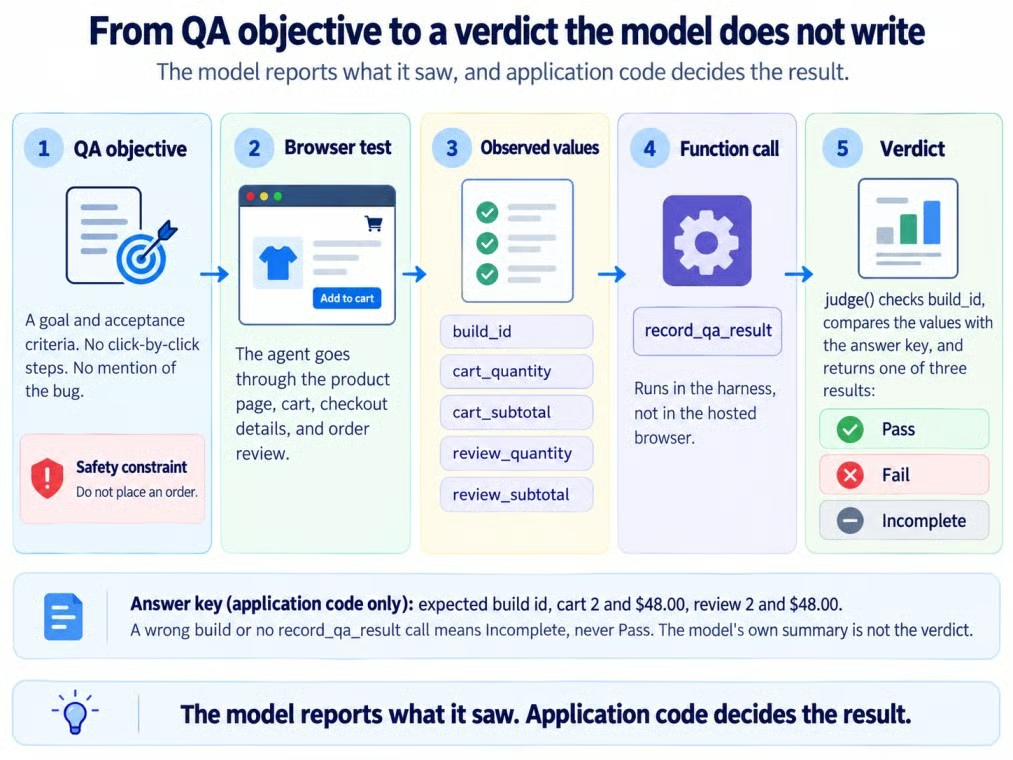
QA उद्देश्य से एप्लिकेशन निर्णय तक। चित्र: लेखक।
आपको Python, एक स्कोप्ड API कुंजी, GPT-6 Astra एक्सेस, और Computer Use वाला एक सत्र चाहिए।
openai==3.22.1 (SDK आपके लिए OpenAI-Beta: agents=v1 हेडर भेजता है)api.agents.read, api.agents.write, और api.responses.write स्कोप वाली API कुंजी, ऐसे प्रोजेक्ट पर जो gpt-6-astra का उपयोग कर सकेAgents API पब्लिक बीटा में है, इसलिए SDK रिलीज़ के बीच फील्ड नाम और व्यवहार बदल सकते हैं। रिपोजिटरी requirements.txt में संस्करण 3.22.1 पिन करती है।
होस्टेड ब्राउज़र को एक पहुँच योग्य URL चाहिए, इसलिए कोड Northstar की Vercel डिप्लॉयमेंट का उपयोग करता है।
git clone https://github.com/KhalidAbdelaty/OpenAI-Agents-API.git
cd OpenAI-Agents-API
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env   # then add your OPENAI_API_KEY
python run_qa.py
आइसोलेटेड डिपेंडेंसिज़ पर अधिक जानकारी के लिए हमारा वर्चुअल एनवायरनमेंट गाइड देखें। macOS या Linux पर, source .venv/bin/activate से सक्रिय करें और cp से फाइल कॉपी करें। कुंजी को .env में रखें, कोड में कभी नहीं।
यह प्रयोग GPT-6 Astra का उपयोग करता है, जो OpenAI के Computer Use उदाहरणों का मॉडल है। हमारा GPT-6 Astra अवलोकन मॉडल को कवर करता है।
कोड Agents API (client.beta.agents) का उपयोग करता है, न कि Agents SDK या हमारी GPT-6 Astra API ट्यूटोरियल में उपयोग किए गए Responses API के computer टूल का।
computer_use टूल और OpenAI-होस्टेड डेस्कटॉप के साथ एक सत्र बनाएं, फिर दोनों टेस्ट के लिए इसे पुन: उपयोग करें:
session = client.beta.agents.sessions.create(
    agent={"model": MODEL, "instructions": INSTRUCTIONS,
           "reasoning": {"effort": REASONING_EFFORT},  # "medium", set explicitly
           "tools": [{"type": "computer_use", "include_screenshots": True}, RECORD_QA_RESULT]},
    environment={"type": "openai_hosted", "desktop": {"enabled": True},
                 "network": {"access": "restricted", "allowed_domains": [host]}},
    metadata={"experiment": "northstar-browser-qa"},
)
include_screenshots: True किसी भी स्क्रीनशॉट को उजागर करता है जो API लौटाती है, जबकि प्रतिबंधित नेटवर्क एक्सेस ब्राउज़र को Northstar तक सीमित करता है।
एनवायरनमेंट डिफ़ॉल्ट medium आकार (2 vCPU, 4 GB RAM) का उपयोग करता है।
फंक्शन एजेंट ने जो देखा उसे रिकॉर्ड करता है। यदि एजेंट 4 में से किसी भी चेक किए गए क्वांटिटी या सबटोटल मान को नहीं पढ़ सका, तो उसे उस फील्ड को null के रूप में रिपोर्ट करना होगा।
required के तहत हर प्रॉपर्टी सूचीबद्ध करने से मॉडल को सभी का उत्तर देना होता है, जो उसने नहीं देखा उसके लिए null का उपयोग करते हुए। हार्नेस फिर भी किसी मिसिंग फील्ड को incomplete मानता है:
"properties": {
    "build_id": {"type": "string", "description": "Build id shown on the page."},
    "stage_reached": {"type": "string", "enum": ["product", "cart", "checkout_details", "review"]},
    "cart_quantity": {"type": ["integer", "null"]},
    "cart_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed, e.g. $10.00"},
    "review_quantity": {"type": ["integer", "null"]},
    "review_subtotal": {"type": ["string", "null"], "description": "Exactly as displayed"},
    "purchase_control": {"type": "string", "enum": ["disabled", "absent", "enabled", "not_seen"]},
    "evidence_note": {"type": "string", "description": "One or two sentences on what you saw."},
},
"required": ["build_id", "stage_reached", "cart_quantity", "cart_subtotal",
             "review_quantity", "review_subtotal", "purchase_control", "evidence_note"],
"additionalProperties": False,
हार्नेस हर प्रदर्शित कीमत को सेंट्स में बदलता है, बिल्ड ID की पुष्टि करता है, और मानों की उत्तर-कुंजी से तुलना करता है:
EXPECTED = {"cart_quantity": 2, "cart_subtotal_cents": 4800,
            "review_quantity": 2, "review_subtotal_cents": 4800}

def judge(record, expected_build):
    observed = {
        "cart_quantity": record.get("cart_quantity"),
        "cart_subtotal_cents": to_cents(record.get("cart_subtotal")),
        "review_quantity": record.get("review_quantity"),
        "review_subtotal_cents": to_cents(record.get("review_subtotal")),
    }
    missing = [field for field, value in observed.items() if value is None]
    if record.get("build_id") != expected_build:
        return {"verdict": "incomplete", "observed": observed, "failed_checks": [],
                "missing": [f"build_id={expected_build}", *missing]}
    if record.get("stage_reached") != "review":
        missing.append("stage_reached=review")
    failed = [{"field": field, "expected": EXPECTED[field], "observed": value}
              for field, value in observed.items()
              if value is not None and value != EXPECTED[field]]
    verdict = "fail" if failed else "incomplete" if missing else "pass"
    return {"verdict": verdict, "observed": observed, "failed_checks": failed, "missing": missing}
कोई अपठनीय या मिसिंग मान incomplete निर्णय देता है, कभी पास नहीं।
गलत बिल्ड से आई रिपोर्ट incomplete लौटाती है, इससे पहले कि उसके मान निर्णय को प्रभावित कर सकें।
एक ही निर्देश दोनों टेस्ट को नियंत्रित करते हैं:
INSTRUCTIONS = (
    "You are a QA tester for the Northstar Checkout staging site. "
    "Use the browser to run the test you are given. "
    "Stay on the approved staging origin and do not visit any other website. "
    "Inspect what is visible on a page before you make any claim about it. "
    "Stop before any purchase: never place, submit, or pay for an order. "
    "Never invent an observed value. If you could not see a value, report null. "
    "Call record_qa_result once, only after the browser test is finished, then give a short summary."
)
टेस्ट के बीच केवल वेबसाइट बिल्ड बदलता है।
इवेंट स्ट्रीम खोलें, QA उद्देश्य एक बार भेजें, फिर टर्न पूरा होने तक अप्रूवल्स और फंक्शन कॉल्स संभालें।
पहले इवेंट स्ट्रीम खोलें, फिर टास्क केवल एक बार भेजें:
with self.client.beta.agents.sessions.events.stream(self.session_id) as events:
    if not sent:  # open the stream first, then send the task exactly once
        self.client.beta.agents.sessions.events.create(self.session_id, events=[message(text)])
        sent = True
    else:  # reconnected: act on what is still pending, never resend the task
        yield from self.handle_required_actions()
    for event in events:
        yield from self.handle(event)
स्ट्रीम मिस हुए इवेंट्स को रिप्ले नहीं करती। यदि स्ट्रीम कटे, तो नई खोलें, फिर सत्र और उसके सेव्ड आइटम्स प्राप्त करें जब तक कनेक्शन बना रहे।
टास्क मैसेज बिल्ड, स्वीकृति मानदंड और सुरक्षा बाधा का नाम बताता है, लेकिन बग का नहीं:
QA objective for Northstar Checkout staging build ns-1041. Start at https://northstar-checkout-staging.vercel.app/b/ns-1041/?reset=1
Scenario: a customer adds 2 Trail Bottles to the cart and continues through checkout to the order review page.
Acceptance criteria:
- The cart shows quantity 2 and a subtotal of $48.00 (unit price $24.00, no shipping or taxes).
- The order review page shows the same quantity and subtotal as the cart.
Safety constraint: never place, submit, or pay for an order.
Record the cart values and the review values as separate fields.
रीटेस्ट के लिए सत्र ID संभालकर रखें।
होस्टेड ब्राउज़र हर नए वेबसाइट ओरिजिन को खोलने से पहले अप्रूवल मांगता है।
स्ट्रीम agent.session.requires_action एमिट करती है; सत्र प्राप्त करें और अनुरोध पढ़ने के लिए required_actions देखें।
def answer_approval(self, action):
    request = action.request
    if request.type == "browser_origin_access":
        decision = "approve" if request.origin.rstrip("/") == self.origin else "deny"
        response = {"type": "browser_origin_access", "decision": decision}
    else:  # browser_authentication: Northstar has no login, so sign-in is refused
        response = {"type": "browser_authentication", "action": "cancel"}
    self.client.beta.agents.sessions.events.create(self.session_id, events=[{
        "type": "agent.session.input.computer_use_approval_request_result",
"request_id": action.request_id, "response": response}])ब्राउज़र का काम computer_use_call आइटम्स के रूप में दिखता है, जिनमें प्रत्येक का एक छोटा शीर्षक और एक स्थिति होती है। पहले टेस्ट की इवेंट स्ट्रीम में यह दिखा:
   12.4s  turn     sent       build=ns-1041
   59.4s  browser  completed  Connecting to the staging test browser
   63.6s  browser  completed  Connecting to the staging test browser
   68.6s  approval approve    https://northstar-checkout-staging.vercel.app
   70.8s  browser  completed  Inspecting the Trail Bottle product
   73.5s  browser  completed  Adding the first Trail Bottle
   78.2s  browser  completed  Checking cart quantity and subtotal
   85.7s  browser  completed  Continuing to checkout details
   89.2s  browser  completed  Checking order review values
   95.9s  record              cart 2 $48.00, review 2 $24.00, purchase disabled
पहली ब्राउज़र गतिविधि से पहले लगभग 47 सेकंड बीते।
सभी 7 computer_use_call आइटम्स पूरे हुए, लेकिन किसी आइटम की स्थिति QA निर्णय नहीं है; फंक्शन का परिणाम है।
हाँ। और महत्वपूर्ण यह कि फंक्शन कॉल ने असफलता को एक फील्ड तक सीमित किया: रिव्यू सबटोटल।
record_qa_result कॉल में यह शामिल था:
{
  "build_id": "ns-1041",
  "cart_quantity": 2,
  "cart_subtotal": "$48.00",
  "review_quantity": 2,
  "review_subtotal": "$24.00",
  "stage_reached": "review",
  "purchase_control": "disabled"
}
हर मान बगी पेज से मेल खाता है। रिव्यू पेज पर क्वांटिटी 2 ही रही, जिससे दृश्य क्वांटिटी मिसमैच की संभावना खत्म होती है।
judge() ने बिल्ड ns-1041 की पुष्टि की, 4 मानों की अपेक्षित मानों से तुलना की, और केवल रिव्यू सबटोटल गलत पाया।
प्रयोग यही एक निर्णय उपयोग करता है:
{
  "verdict": "fail",
  "failed_checks": [{"field": "review_subtotal_cents", "expected": 4800, "observed": 2400}],
  "missing": []
}फिक्स लाइव होने के बाद, उसी सत्र को एक और संदेश भेजें।
यह छोटा रीग्रेशन टेस्ट वही निर्देश और निर्णय फंक्शन उपयोग करता है।
बिल्ड ns-1042 में फिक्स Northstar के JavaScript की एक पंक्ति है:
-const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents, 0);
+const reviewSubtotal = (cart) => cart.reduce((sum, line) => sum + line.unitCents * line.qty, 0);स्टार्ट लिंक में ?reset=1 शामिल है, इसलिए रीटेस्ट खाली कार्ट से शुरू होता है। फिर फॉलो-अप उसी सत्र में जाता है:
A fix is deployed as staging build ns-1042 at https://northstar-checkout-staging.vercel.app/b/ns-1042/?reset=1
That link starts from an empty cart. Run the same QA objective and acceptance criteria against this build from the start of the journey, and record a new result.
रीटेस्ट ने होस्टेड एनवायरनमेंट बनाए रखा और कोई नया ओरिजिन अप्रूवल आवश्यक नहीं था। ब्राउज़र स्टेट पर निर्भर न रहें, क्योंकि कुकीज़ एक्सपायर हो सकती हैं और एनवायरनमेंट को रीसायकल करने से वह साफ़ हो जाता है।
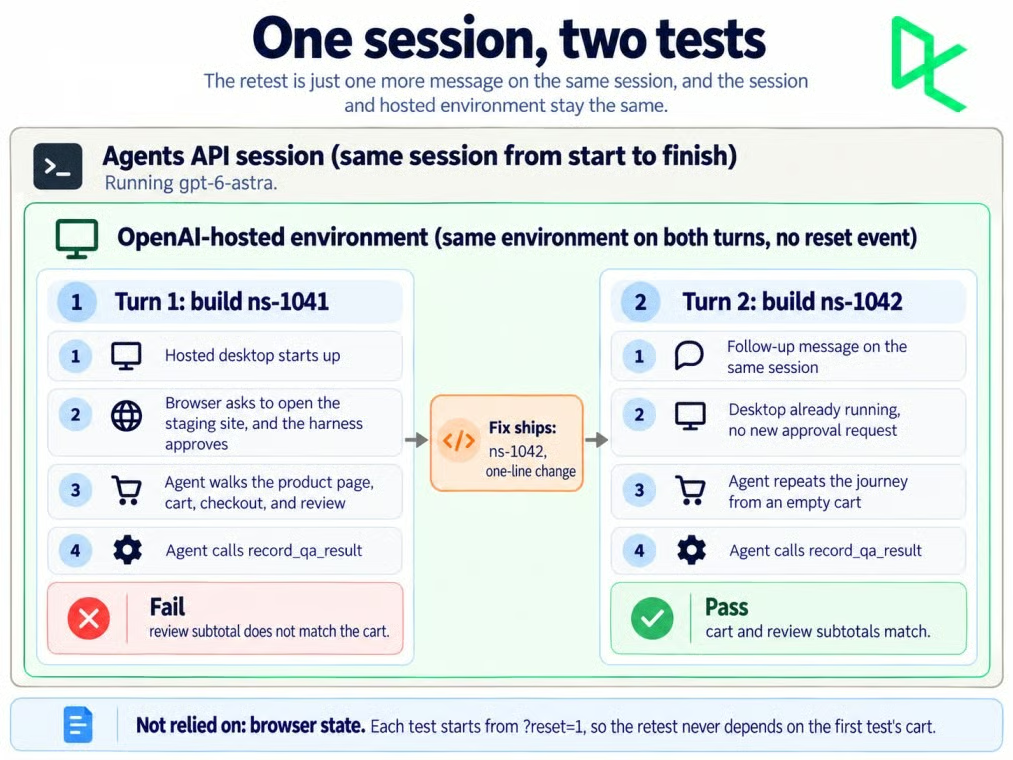
एक ही सत्र ने दोनों QA टेस्ट ढोए। चित्र: लेखक।
यदि 1 घंटे तक गतिविधि और कीप-अलाइव बंद हों, तो होस्टेड सैंडबॉक्स हटाया जा सकता है। agent.session.environment.reset पर नज़र रखें और हर रीटेस्ट ज्ञात स्थिति से शुरू करें।
हाँ। रीटेस्ट ने कार्ट क्वांटिटी 2 और $48.00, फिर रिव्यू क्वांटिटी 2 और $48.00 रिपोर्ट किया, और judge() ने बिना किसी फेल्ड चेक के पास लौटाया।
इसमें 5 ब्राउज़र गतिविधि आइटम्स के साथ 38.9 सेकंड लगे, जबकि पहले टेस्ट के लिए 7 आइटम्स के साथ 96.5 सेकंड लगे, जिसमें ब्राउज़र गतिविधि शुरू होने से पहले 47 सेकंड का इंतजार शामिल था।
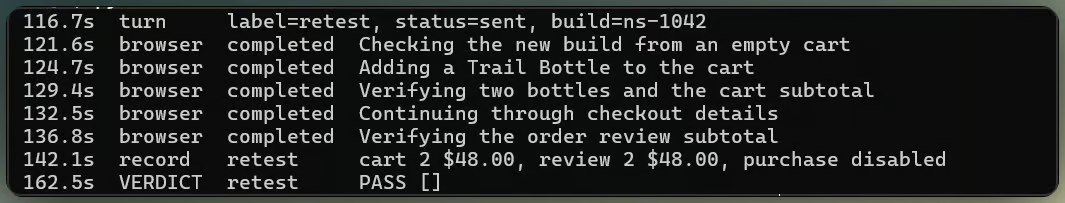
रीटेस्ट बिना नए अप्रूवल के पास हुआ। चित्र: लेखक।
ज़रूरी नहीं। include_screenshots सेट होने पर भी, पहले टेस्ट ने 7 ब्राउज़र गतिविधि आइटम्स में से 2 स्क्रीनशॉट लौटाए, और रीटेस्ट ने 5 में से 2।
कुछ आइटम्स output: null लौटाते हैं, इसलिए रिपोर्ट यह मानकर नहीं चल सकती कि हर गतिविधि के लिए तस्वीर होगी।
इवेंट स्ट्रीम होस्टेड ब्राउज़र की कोई सतत वीडियो फीड नहीं है; यह ब्राउज़र गतिविधि आइटम्स और उपलब्ध होने पर स्क्रीनशॉट लौटाती है।
Northstar rrweb का उपयोग Document Object Model (DOM) में बदलाव और इंटरैक्शन कैप्चर करने, उन्हें उसी होस्ट पर भेजने, और नीचे दोनों यात्राओं को रीप्ले करने के लिए करता है।
दोनों स्टेजिंग बिल्ड्स पर एजेंट का ब्राउज़र। वीडियो: लेखक।
रीप्ले ns-1041 पर क्वांटिटी 2 और $24.00, फिर ns-1042 पर $48.00 दिखाता है; डिसेबल्ड परचेज बटन अनछुआ रहता है।
रिपोजिटरी में सेव्ड निर्णय, ब्राउज़र एविडेंस, सत्र विवरण, लागत, और इवेंट लॉग के लिए एक छोटा Streamlit व्यूअर भी शामिल है।
बेस्ट-एफ़ोर्ट उपयोग काउंटरों ने दोनों टेस्ट के लिए $0.9469 का स्टैंडर्ड-रेट टोकन अनुमान दिया।
| मेट्रिक | टेस्ट 1 (ns-1041) |
रीटेस्ट (ns-1042) |
|---|---|---|
| इनपुट टोकन | 255,550 | 223,533 |
| कैश्ड इनपुट टोकन | 217,041 (84.9%) | 219,449 (98.2%) |
| आउटपुट टोकन | 982 | 708 |
| अनुमानित टोकन लागत | $0.6512 | $0.2957 |
| टर्न समय | 96.5 सेकंड | 38.9 सेकंड |
| ब्राउज़र गतिविधि आइटम्स | 7 | 5 |
रीटेस्ट ने कम इनपुट टोकन उपयोग किए, और उनमें से 98.2% प्रॉम्प्ट कैश से आए। मिलाकर, दोनों टेस्ट की लागत $0.9469 आई।
ऑब्ज़र्वेबिलिटी गाइड कहता है कि उपयोग अज्ञात होने पर null हो सकता है और रिकॉर्डेड काउंट बदल सकते हैं, इसलिए सत्र हटाने से पहले उन्हें फिर जांचें।
जब मैंने टेस्ट चलाए, OpenAI की प्राइसिंग पेज पर ये GPT-6 Astra के स्टैंडर्ड रेट्स थे:
| टोकन प्रकार | दर प्रति 1M टोकन |
|---|---|
| इनपुट | $10.00 |
| कैश्ड इनपुट | $1.00 |
| कैश राइट्स | $12.50 |
| आउटपुट | $50.00 |
272K लॉन्ग-कॉन्टेक्स्ट थ्रेशहोल्ड प्रति अनुरोध लागू होता है। दोनों टर्न्स का संयुक्त इनपुट इसके नीचे रहा, इसलिए कोई एकल अनुरोध उच्च लॉन्ग-कॉन्टेक्स्ट रेट्स ट्रिगर नहीं कर सका।
अनुमान फिर भी अंतिम इनवॉइस को पुन: प्रस्तुत नहीं कर सकता क्योंकि Agents API उपयोग बेस्ट-एफ़ोर्ट है और अलग से कैश-राइट काउंट एक्स्पोज़ नहीं करता।
होस्टेड सैंडबॉक्स अलग से स्टैंडर्ड कंटेनर रेट्स पर बिल होता है। प्राइसिंग पेज 4 GB medium कंटेनर को $0.12 प्रति 20-मिनट सत्र पर सूचीबद्ध करता है, पात्र कंटेनर सत्र प्रति मिनट बिल होते हैं और 5-मिनट मिनिमम है।
सुरक्षा इस पर निर्भर करती है कि ब्राउज़र क्या पहुँच सकता है और पेज उसे क्या करने देता है।
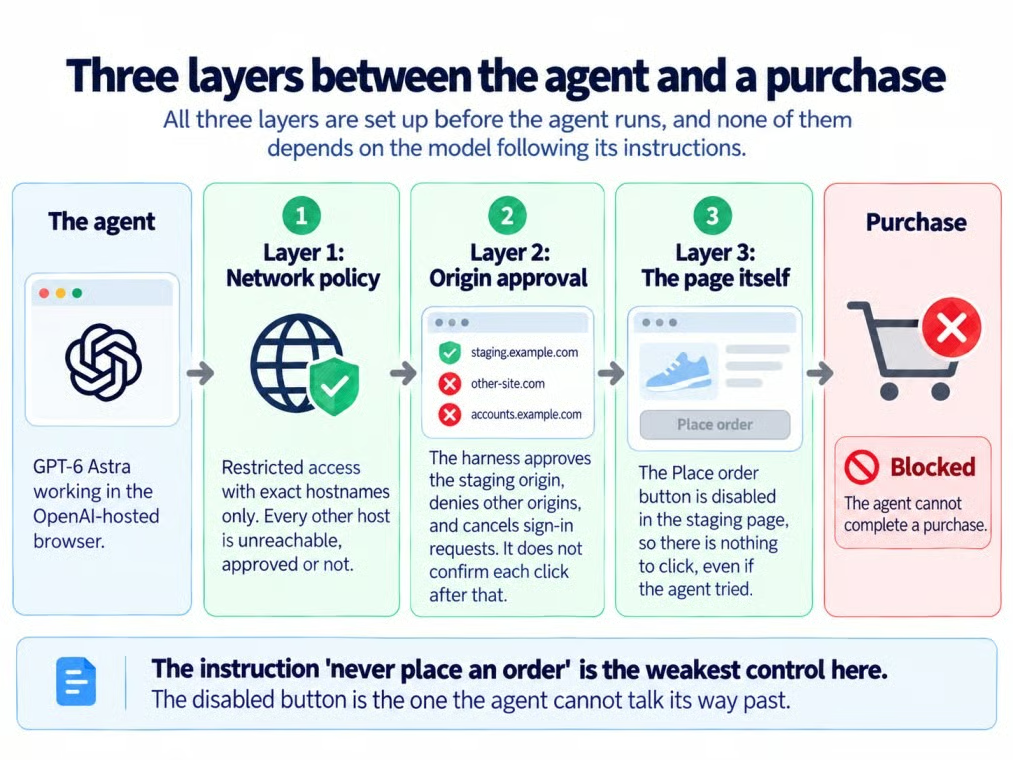
एजेंट और चेकआउट के बीच तीन परतें। चित्र: लेखक
नेटवर्क पॉलिसी नियंत्रित करती है कि ब्राउज़र किन होस्ट्स तक पहुँच सकता है, और ओरिजिन अप्रूवल तय करता है कि वह प्रत्येक नए ओरिजिन को खोल सकता है या नहीं। इनमें से कोई भी व्यक्तिगत ब्राउज़र कार्रवाइयों की पुष्टि नहीं करता।
इसलिए northstar-checkout-staging.vercel.app को अप्रूव करना हर क्लिक को अलग-अलग अप्रूव करना नहीं है।
नो-परचेज़ नियम एक सुरक्षा बाधा है, और purchase_control को साक्ष्य के रूप में सेव किया जाता है, न कि स्वीकृति मानदंड के रूप में जज किया जाता है। Northstar का डिसेबल्ड "Place order" बटन वह नियंत्रण है जो इसे लागू करता है।
restricted के तहत, ब्राउज़र केवल वे होस्टनेम्स पहुँच सकता है जिन्हें आप सूचीबद्ध करते हैं।
OpenAI का सैंडबॉक्स गाइड 1 से 100 सटीक होस्टनेम्स स्वीकार करता है, बिना वाइल्डकार्ड, प्रोटोकॉल, पाथ, या पोर्ट के। कंटेंट डिलीवरी नेटवर्क (CDNs), सबडोमेन्स, और रीडायरेक्ट टार्गेट्स के लिए अलग एंट्री चाहिए।
स्क्रीनशॉट्स और rrweb रिकॉर्डिंग्स पेज जो भी दिखाए उसे शामिल करती हैं, इसलिए Northstar काल्पनिक डेटा उपयोग करता है, कोई लॉगिन नहीं है, और फुटर में रिकॉर्डिंग का खुलासा करता है।
रिकॉर्डर इनपुट्स को मास्क करता है, लेकिन प्रोडक्शन डिप्लॉयमेंट को फिर भी पेज के अनुरूप डेटा पॉलिसी और मास्किंग की आवश्यकता होगी।
Agents API केवल संयुक्त राज्य अमेरिका में डेटा रेज़िडेंसी सपोर्ट करता है और Zero Data Retention (ZDR) के लिए पात्र नहीं है, भले ही सैंडबॉक्स सेल्फ-होस्टेड हो।
जिन परिणामों और स्क्रीनशॉट्स की आपको ज़रूरत है उन्हें सेव करें, फिर सत्र को डिलीट कर दें, ताकि स्टेजिंग चेकआउट रिटेन्ड सत्र स्टेट में न रहे।
Agents API सत्र को डिलीट करना साइट द्वारा स्टोर की गई rrweb रिकॉर्डिंग्स को डिलीट नहीं करता। रिकॉर्डिंग पॉलिसी के अनुसार उन्हें अलग से हटाएँ।
कार्ट और रिव्यू सबटोटल के अलग होने पर Northstar फेल हुआ, फिर फिक्स के बाद उसी सत्र में पास हो गया। दोनों निर्णय हार्नेस ने किए, मॉडल के सारांश ने नहीं।
मैं ज्ञात इनवेरिएंट्स के लिए स्क्रिप्टेड रीग्रेशन टेस्ट रखूंगा और उन खोजपरक (exploratory) यात्राओं के लिए लक्ष्य-आधारित ब्राउज़र एजेंट्स का उपयोग करूंगा जिन्हें असर्शन के रूप में व्यक्त करना मुश्किल है। एजेंट खोजता है; एप्लिकेशन कोड निर्णय करता है।
API की बुनियादी बातों के लिए, मैं हमारा Working with the OpenAI API कोर्स सुझाता हूँ।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
लर्निंग पाथ
कोर्स