강의
LangChain과 Neo4j로 배우는 Graph RAG
3시간
2.3K
챗봇을 위한 RAG(검색 증강 생성) 파이프라인이 노트북의 스모크 테스트를 모두 통과합니다. 그런데 틀리거나 이상한 답변에 대한 지원 티켓이 올라오기 시작하고, 스모크 테스트 로그에는 경고 신호가 전혀 보이지 않습니다.
이 실패는 지표 없이는 보이지 않기 때문에 잡기 어렵습니다. RAG 파이프라인은 두 곳에서 문제가 날 수 있습니다. 리트리버가 잘못된 청크를 가져오거나, 제너레이터가 좋은 청크를 무시하고 사실을 꾸며낼 수 있습니다. 단일 엔드 투 엔드 정확도 수치만으로는 어느 쪽이 문제인지 알 수 없고, 따라서 무엇을 고쳐야 하는지도 알 수 없습니다.
이 튜토리얼에서는 Ragas 0.4.3를 사용해 Python으로 완전한 RAG 평가 파이프라인을 구축합니다. 수작업으로 만든 평가 데이터셋, 4가지 핵심 지표(정합성, 답변 관련성, 컨텍스트 정밀도, 컨텍스트 재현율), 점수가 낮아지면 빌드를 실패시키는 CI(지속적 통합) 품질 게이트, 합성 테스트 세트 생성기, 그리고 JSON Lines 형식의 점수 추적기를 다룹니다.
먼저 배경이 필요하다면 RAG가 무엇인지에 대한 가이드, RAG 파이프라인을 평가하기 위해 LLM을 심판으로 사용하는 튜토리얼, 그리고 고급 RAG 기법 개요를 참고하세요.
Python 3.9 이상(여기서는 3.12 사용), uv 또는 pip, OpenAI 호환 심판 모델의 API 키, 그리고 RAG 파이프라인 작동 방식에 대한 대략적인 이해가 필요합니다. 먼저 기초를 다지고 싶다면, 점수를 매기게 될 유형의 파이프라인을 구축하는 Retrieval-Augmented Generation with LangChain 과정을 권합니다.
BLEU나 ROUGE 같은 텍스트 겹침 지표는 RAG에 맞는 자가 아닙니다. Ragas는 대신 심판 LLM이 4가지 축으로 각 답변을 채점합니다. 정합성과 답변 관련성은 제너레이터를 진단하고, 컨텍스트 정밀도와 컨텍스트 재현율은 리트리버를 진단합니다.
이 4개의 수치를 CI 임계값 뒤에 두고 커밋별로 로그를 남기면 일회성 감사가 아니라 회귀 알람을 갖게 됩니다.
시작하기 전에 한 가지 경고가 있습니다. Ragas API는 2년 사이 두 번 바뀌었습니다. v0.2에서 사전 기반 데이터셋을 SingleTurnSample과 EvaluationDataset으로 대체했고, v0.4에서는(0.3.9에서 도입된) 컬렉션 메트릭을 기본값으로 바꾸고 기존 evaluate() 함수를 더 이상 권장하지 않습니다.
온라인 튜토리얼 대부분은 아직 v0.1 또는 v0.2 코드를 보여줍니다. 아래의 모든 코드는 0.4.3에서 실행되며, 2026년 10월 현재 최신 릴리스입니다.
RAG에는 전용 지표가 필요합니다. 고전적인 텍스트 지표는 답변이 기준 답변과 몇 단어를 공유하는지만 세는데, RAG 시스템에서 문제가 나는 지점은 그런 공유 어휘가 아닙니다.
BLEU(Papineni et al., 2002)와 ROUGE(Lin, 2004)는 기계 번역과 요약을 위해 만들어졌습니다. 좋은 출력은 기준과 거의 같은 단어를 써야 합니다. RAG 답변이 “you have 2 weeks”라고 말하고 기준이 “14 days”라고 하면 두 지표 모두 낮게 나옵니다. 반면 환불 정책을 지어낸 유창한 답변이 기준의 단어를 우연히 재사용하면 높은 점수를 받을 수 있습니다.
더 큰 문제는 RAG 파이프라인이 두 지점에서 별개로 실패할 수 있다는 점입니다. 리트리버가 잘못된 정보를 고르거나, 제너레이터가 좋은 정보를 무시하고 사실을 꾸며낼 수 있습니다. 답이 틀렸을 때, 다음 중 무엇이 일어났는지 알아야 합니다.
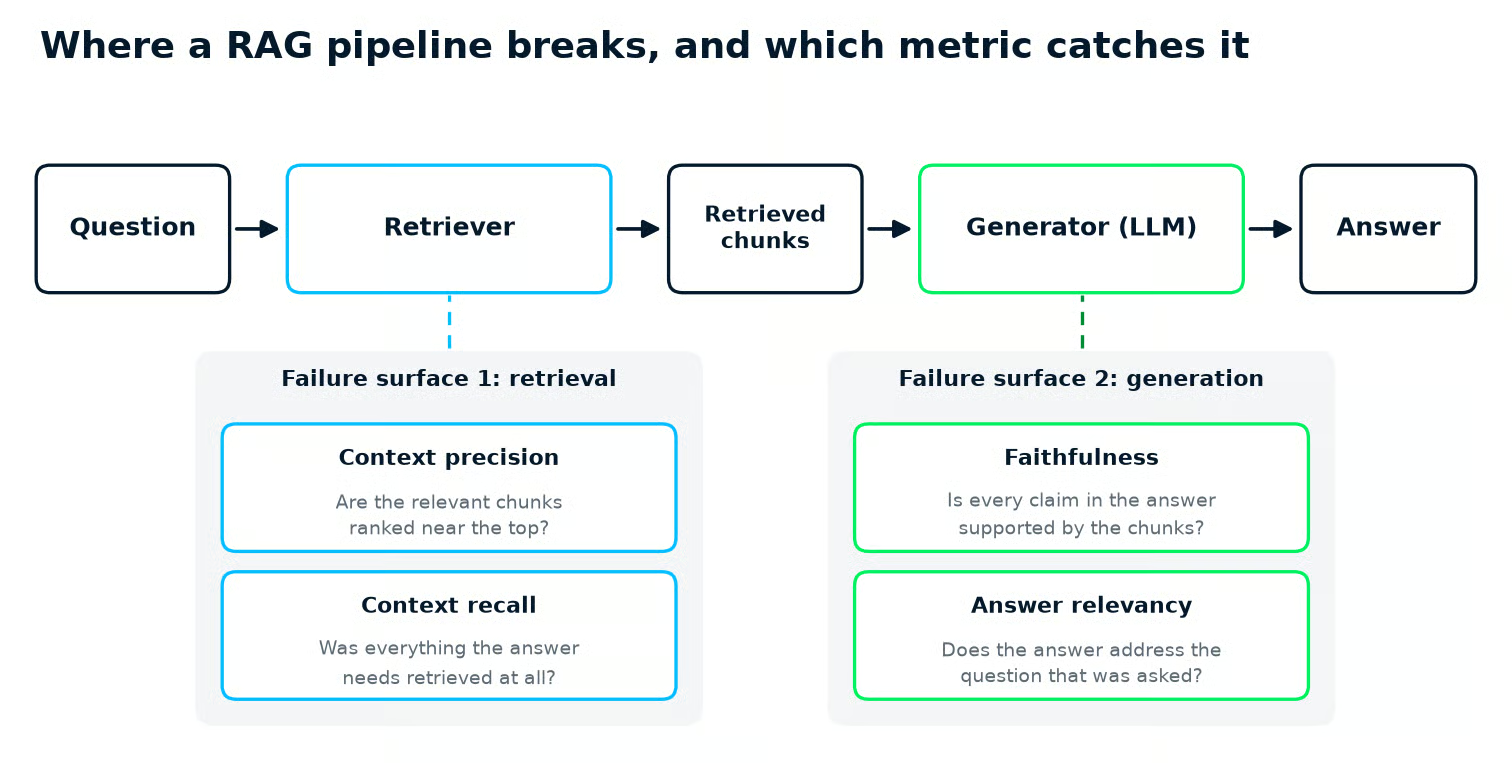
RAG 파이프라인의 두 가지 실패 양상: 컨텍스트 정밀도와 재현율은 리트리버를, 정합성과 답변 관련성은 제너레이터를 진단합니다. 이미지: 필자 제작.
What Is Retrieval Augmented Generation (RAG)? A Complete Guide에서는 이러한 실패가 시작되는 파이프라인 단계를 살펴봅니다.
Ragas는 파이프라인의 각 부분에 대한 수치를 제공하는 오픈 소스 Python 프레임워크입니다. 이것만이 유일한 선택지는 아닙니다. 두 가지 주요 대안은 pytest 스타일 테스트 케이스로 평가를 감싸는 DeepEval과, 데이터셋에 LLM 점검 결과를 열로 추가해 모니터링 리포트에 반영하는 Evidently입니다.
| Framework | Best for | RAG-specific metrics built in | Test data from your documents | Config style |
|---|---|---|---|---|
| Ragas | RAG 파이프라인 진단 | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (오픈 소스) |
메트릭 객체 + llm_factory()로 만든 심판 |
| DeepEval | CI에서 단위 테스트 스타일 LLM 테스트 | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (오픈 소스) |
LLMTestCase 객체, assert_test()를 deepeval test run으로 실행 |
| Evidently | 모니터링 대시보드와 시간 경과에 따른 드리프트 | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Evidently Cloud에서 RAG 데이터셋 생성 | Dataset의 디스크립터, Report로 요약 |
이 튜토리얼에서는 Ragas를 선택했습니다. 4가지 핵심 지표가 리트리버용과 제너레이터용으로 깔끔히 나뉘고, 테스트 세트 생성기가 같은 오픈 소스 패키지에 포함되어 있기 때문입니다.
팀이 이미 pytest 중심이라면 DeepEval의 assert_test()가 더 자연스러울 수 있습니다. 라이브 트래픽 품질 대시보드가 목적이라면 Evidently의 리포트가 더 빠릅니다.
Ragas 설정은 패키지 설치, 하나의 의존성 고정, 그리고 모든 지표가 공유할 심판 LLM 선택으로 이뤄집니다. uv를 사용하면 정확한 버전을 잠가주므로 편리하지만, 동일 버전으로 pip install을 해도 됩니다.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
여기서는 Python 3.12를 사용했습니다. Ragas 0.4.3은 Python 3.9 이상을 지원합니다.
rapidfuzz 패키지는 뒤에서 합성 테스트 세트 생성기에 필요합니다. Ragas의 의존성으로 선언되어 있지 않아 미리 설치합니다.
현재 시점에서 langchain-community<0.4 고정은 필수입니다. Ragas 0.4.3은 langchain-community 0.4에서 제거된 모듈 경로에서 ChatVertexAI를 임포트하므로, 핀 없이 새로 설치하면 ragas 임포트 시 실패합니다.
다음은 심판입니다. Ragas의 모든 LLM 기반 지표는 심판 모델에 1회 이상 호출을 하므로, 한 번 만들고 모든 곳에 전달합니다. 저는 이를 judge.py 모듈로 분리하고, 키는 환경 변수에서 읽어 git에 자격 증명이 남지 않게 합니다.
아래 파일은 OpenAI를 직접 호출하는 방법과, Google의 OpenAI 호환 엔드포인트를 통해 Gemini를 호출하는 방법을 보여줍니다.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
이 파일에서 처음 실행을 방해할 수 있는 두 가지 포인트가 있습니다.
llm_factory()에는 클라이언트 객체를 전달해야 하며, 모델 이름만 넘기면 오류가 납니다.llm_factory()에 전달하는 추가 설정은 그대로 모델 호출에 전달됩니다. 여기서는 기본 1,024보다 max_tokens를 높이는 데 사용했습니다.직접 검수한 샘플에서 점수가 안정적으로 나오는 가장 저렴한 모델을 쓰고, 반드시 고정하세요. 대규모 평가 모음에서는 호출량이 빠르게 누적됩니다. 정합성은 샘플당 심판 2회 호출, 답변 관련성은 3회 + 임베딩 2회, 컨텍스트 정밀도는 검색된 청크당 1회, 컨텍스트 재현율은 1회를 호출합니다.
4개 지표에 6개 샘플을 돌리니 한 번 실행에 62회 요청(심판 50회 + 임베딩 12회)이었습니다. 다음은 2026년 10월 19일 기준 각 벤더 목록가에서 3가지 소형 심판 모델 비용입니다.
| Judge model | Input per 1M tokens | Output per 1M tokens | Source |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API pricing |
| claude-haiku-5-5 | $0.10 (prompts up to 100K tokens) | $0.50 (prompts up to 100K tokens) | Claude API pricing |
judge.py의 기본값은 여전히 gpt-4o-mini입니다. 이는 OpenAI 가격 페이지의 주요 가격표에는 나오지 않는 구형 OpenAI 모델입니다. JUDGE_MODEL 변수를 설정해 전환하세요.
심판으로 Claude를 쓰고 싶다면 하나 걸림돌이 있습니다. 답변 관련성에는 임베딩 모델도 필요한데 Anthropic은 임베딩을 제공하지 않습니다. 문서에서는 Voyage AI를 안내하므로, Claude는 다른 제공자의 임베딩과 짝지어야 합니다.
선택 자체보다 고정이 더 중요합니다. 심판 모델을 바꾸면 파이프라인이 바뀌지 않았어도 점수가 이동해, 곧 만들 추적 트렌드 라인을 망가뜨립니다.
모델 이름을 버전 관리되는 judge.py에 넣고, 심판 업그레이드를 다른 호환성 깨짐과 동일하게 취급하세요. 새로운 심판 점수에 맞춰 모든 임계값을 재설정합니다.
데이터셋의 각 테스트 케이스를 샘플이라고 부릅니다. 샘플은 단순한 답변 이상으로, 파이프라인의 한 번 왕복을 4개의 필드에 기록합니다.
| Field | What it holds |
|---|---|
user_input |
고객이 한 질문 |
retrieved_contexts |
그 질문에 대해 리트리버가 반환한 청크 |
response |
RAG 파이프라인이 낸 답변 |
reference |
사람이 쓴 정답 |
Ragas는 각 샘플을 SingleTurnSample로, 전체를 EvaluationDataset으로 저장합니다. reference는 선택 사항이지만, 검색 지표는 이를 기준으로 비교하므로, 참조 없는 지표가 무시하더라도 큐레이션된 세트에는 항상 포함합니다.
허구의 커피 로스터 Northwind Coffee를 위해 6개의 샘플을 만들었습니다. 아래 각 지표 섹션에서 그 지표가 잡아야 하는 샘플을 추가합니다.
build_dataset.py를 깨끗한 답변, 의도적 환각, 여러 사실을 동시에 담은 두 번째 깨끗한 답변, 이렇게 처음 3개 샘플로 시작하세요.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
각 검색 컨텍스트는 Northwind 도움말 센터 페이지의 청크로, 리트리버가 제너레이터에 넘기는 그대로 스크립트에 적어둔 것입니다. uv run python build_dataset.py를 실행해 eval_dataset.jsonl과 eval_questions.jsonl을 생성하고, 이후 섹션에서 샘플을 추가할 때마다 다시 실행하세요.
JSON Lines로 저장하는 건 중요합니다. 이후 모든 스크립트(메트릭 실행, CI 게이트)가 EvaluationDataset.from_jsonl()로 동일한 eval_dataset.jsonl을 로드하기 때문입니다.
실제 프로젝트에서는 retrieved_contexts와 response가 실제 파이프라인을 질문에 대해 실행한 결과에서 오며, user_input과 reference만 수작업으로 작성합니다. CI 섹션에서 이 단계를 자동화하는 방법을 보여줍니다.
이 글에서 최종적으로 만들 6개 샘플은 지표를 배우기에는 충분하지만, 임계값을 신뢰하기에는 부족합니다. 임계값에 의존하기 전에는 약 100개 샘플을 목표로 하세요. 추적 섹션에서 이유를 보여줍니다. 필요 샘플 수는 용도 엄격도에 따라 달라지므로 특정 숫자보다는 균형에 초점을 둡니다.
4가지 핵심 지표는 제너레이터를 위한 정합성과 답변 관련성, 리트리버를 위한 컨텍스트 정밀도와 컨텍스트 재현율입니다. 모두 0과 1 사이의 점수를 반환합니다. 유용한 점은 각 수치가 어떤 수정을 지시하는지 알려준다는 것입니다.
정합성은 답변의 어느 부분이 검색된 청크로 뒷받침되는지를 측정합니다. 심판은 답변을 개별 주장으로 나눈 다음, 각 주장을 청크와 대조합니다. 1.0은 모든 주장이 뒷받침됨을, 0.0은 아무것도 뒷받침되지 않음을 뜻합니다.
정합성은 기준 답변이 필요 없으므로 테스트 세트뿐 아니라 운영 트래픽에도 적용할 수 있습니다. 프롬프트, 모델, 모델이 보는 컨텍스트 양을 바꿀 때마다 다시 실행하세요. 환각은 주로 이런 변경에서 생깁니다.
가장 빠른 체험 방법은 단일 답변에 적용하는 것입니다. 데이터셋이 필요 없습니다.
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
uv run python quick_check.py로 실행하면 faithfulness = 0.00이 출력됩니다. 응답의 두 주장(6개월, 무료 한 봉지) 모두 컨텍스트로 뒷받침되지 않기 때문입니다. 0.4에서는 각 메트릭의 ascore() 메서드로 채점하며, 반환값의 .value가 점수입니다.
지금까지의 데이터셋 전체에 대해 채점하면, 샘플 2의 의도적 환각은 0.0으로, 두 개의 깨끗한 샘플은 1.0으로 나옵니다. 전체 결과는 아래 멀티 메트릭 섹션에 있습니다.
답변 관련성은 답변이 실제로 질문을 다루는지를 측정합니다. 심판은 답변을 읽고 그 답변이 좋은 답이 될 3개의 질문을 작성합니다. 그러고 나서 Ragas가 임베딩 모델로 그 질문들과 원래 질문의 의미 유사도를 확인합니다. 답변이 질문을 회피하면 심판은 우회적이라고 표시하고 0점이 됩니다.
Ragas의 클래스 이름은 AnswerRelevancy(과거 예시는 ResponseRelevancy라고 부르며, 문서 페이지 제목도 Response Relevancy)이며, 심판 LLM과 임베딩 모델이 모두 필요합니다.
정합성은 높은데 관련성이 낮다면 대개 제너레이터나 프롬프트 문제를 시사합니다. 올바른 컨텍스트를 갖고 근거를 지켰지만, 질문과 다른 답을 한 경우입니다. 다만 먼저 컨텍스트 정밀도와 재현율을 확인하세요. 엉뚱한 청크를 반환하는 리트리버도 같은 패턴을 만들 수 있습니다.
다음 샘플은 제너레이터 사례를 보여줍니다. 리트리버는 올바른 배송 청크를 반환하고, 답변도 근거를 지키지만 배송비 대신 로스팅 날짜를 말합니다. build_dataset.py 상단 청크 목록에 다음을 추가하세요.
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
그런 다음 samples 리스트 끝에 새 샘플을 추가합니다.
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
각 샘플은 하나의 관련성 점수를 받습니다. 심판이 답변으로부터 작성한 질문들이 샘플이 실제로 묻는 질문과 얼마나 잘 맞는지이며, 1.0이 완벽한 일치입니다.
컨텍스트 정밀도는 유용한 청크가 리트리버 반환 목록의 상위에 잘 랭크되어 있는지를 확인하고, 컨텍스트 재현율은 올바른 정답을 작성하는 데 필요한 모든 정보를 리트리버가 찾아냈는지를 확인합니다.
정밀도는 유용한 청크가 더 높은 순위일수록 더 많은 가중치를 줍니다. 즉, 1위의 유용한 청크는 3위의 동일 청크보다 더 큰 기여를 합니다. 재현율은 기준 답변의 사실 중 검색된 청크가 최소 하나라도 뒷받침하는 비율입니다.
둘 다 reference 필드가 필요합니다. 컬렉션 API에서 클래스 이름은 ContextPrecisionWithReference와 ContextRecall이며, 둘 다 심판 LLM만 받습니다. Ragas 문서에서는 참조 기반 버전을 ContextPrecision으로 줄여 부르기도 합니다.
지금까지 샘플은 모두 올바른 청크를 상위로 검색했으므로 해당 지표가 잡을 것이 없습니다. 다른 방식으로 검색을 망가뜨리는 두 샘플을 추가해 봅시다. 하나는 올바른 청크가 검색되었지만 최하위로 랭크된 경우, 다른 하나는 관련된 것이 전혀 검색되지 않아 모델이 정답을 거부하는 경우입니다. 먼저 파일 상단에 다음 청크를 추가합니다.
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
그런 다음 리스트 끝에 샘플을 추가합니다.
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
랭킹은 중요합니다. 대부분의 파이프라인은 상위 몇 개 청크만 모델에 전달하므로, 상위 5개만 넘기는 리트리버에서 6위의 유용한 청크는 없는 것과 같습니다.
샘플 5는 하나뿐인 유용한 청크를 3개 중 최하위로 배치했고, 정밀도는 0.333으로 나옵니다. 유용한 정보가 마지막에 있기 때문입니다. 샘플 6, 검색 실패는 정밀도와 재현율 모두 0.0입니다.
샘플 6은 정합성에 대해서도 시사점이 있습니다. 모델은 올바르게 거부했지만, 그 거부는 어떤 실행에서는 정합성 1.0, 다른 실행에서는 0.0으로 나왔습니다. 사이에 변한 것은 없었습니다. “보유 문서에 보증 정보가 없다” 같은 문구는 컨텍스트로 뒷받침되지도, 반박되지도 않으며, 심판이 동전 던지듯 판단합니다.
파이프라인이 거부하도록 설계되어 있다면, 정합성과 분리해 거부를 별도로 채점하세요. 그래야 정합성 점수를 흔들지 않습니다. Ragas 0.4는 컬렉션 API에서 AspectCritic을 제거했으므로, 대체 방법은 @discrete_metric 데코레이터로 만드는 커스텀 점검입니다( v0.3 → v0.4 마이그레이션 가이드 참고).
두 검색 지표를 함께 읽으면 앞으로 어디에 시간을 써야 할지 보입니다.
| Context precision | Context recall | Diagnosis | What to change |
|---|---|---|---|
| 높음 | 높음 | 검색 상태 양호 | 제너레이터에 집중: 프롬프트, 모델, 정합성 |
| 낮음 | 높음 | 올바른 청크가 검색되었지만 랭킹이 나쁨 | 재랭커 추가/튜닝 |
| 높음 | 낮음 | 상위 청크는 관련 있으나 불완전 | 모델에 더 많은 청크 전달, 더 큰 청크 사용, 청크 분할 위치 점검 |
| 낮음 | 낮음 | 리트리버가 전반적으로 실패 | 임베딩, 인덱싱, 쿼리 리라이트 재점검 |
“정밀도 낮음, 재현율 높음” 행이 실무에서 가장 흔하고, 가장 저렴하게 고칠 수 있습니다.
RankGPT를 RAG 재랭킹 에이전트로 튜토리얼은 기존 리트리버 위에 LLM 재랭커를 추가하는 방법을, Boost LLM Accuracy with RAG and Reranking 튜토리얼은 또 다른 재랭킹 구성을 보여줍니다. RAG 성능 향상 5가지 핵심 기법 가이드는 나머지 행을 위한 청킹과 쿼리 리라이트를 다룹니다.
변경 후 두 검색 지표를 다시 실행해 표가 말해주는 효과를 확인하세요.
전체 멀티 메트릭 평가는 모든 샘플에 대해 4가지 지표를 병렬로 실행하고 점수를 수집합니다. 실패 원인을 파고드는 행 단위 값과 대시보드를 위한 열 평균을 함께 얻습니다.
Ragas 0.2와 0.3에서는 evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8))로 했습니다. 0.4.3에도 함수는 남아 있지만 더 이상 권장되지 않으며, 새 메트릭은 아예 받지 않습니다. 예전 Metric 클래스를 상속하지 않기 때문입니다.
대신 @experiment 데코레이터가 있습니다. 파이프라인과 메트릭을 함께 Dataset에 대해 실행하고 결과를 CSV로 씁니다. 파이프라인 호출이 준비되었을 때 적합한 도구입니다.
정적인 데이터셋을 채점할 때는 작은 헬퍼가 더 명확했습니다. 4개 지표를 해당 스크립트마다 한 번만 만들고, 병렬 호출과 에러 처리를 읽기 쉬운 코드에 둡니다.
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
하나 비직관적인 줄은 inspect.signature() 호출입니다. 4개 지표는 서로 다른 입력을 원합니다(정합성은 응답, 재현율은 기준 등). 그래서 헬퍼는 각 지표의 ascore()가 받는 인자를 읽어 샘플에서 해당 필드만 전달합니다. 이로써 하나의 루프가 모든 지표에 공통으로 쓰입니다.
세마포어는 동시에 실행되는 심판 호출 수를 제한합니다. 그래도 실패하는 지표는 전체 실행을 중단하지 않고 빈(NaN) 셀로 기록됩니다. 주피터 노트북 안에서 실행하면 이미 루프가 돌아가므로 asyncio.run이 실패합니다. 먼저 nest_asyncio.apply()를 호출하거나 코루틴을 직접 await 하세요(Ragas는 이미 이를 의존성으로 포함합니다).
헬퍼가 준비되면 전체 실행은 짧습니다.
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
첫 실행에서의 점수는 정합성으로 정렬하고 소수점 셋째 자리까지 반올림했으며, 마지막 행에 평균을 넣었습니다.
| Question | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
같은 데이터셋의 이후 실행에서는 정합성이 더 낮게 나왔습니다. 추적 섹션에서 다룰 거부 샘플의 뒤집힘 때문입니다.
정합성으로 정렬하면 환각 가능성이 가장 큰 항목을 집어낼 수 있고, 의도적으로 심은 환각이 최상단에 옵니다. 마지막 행의 평균은 대시보드 수치입니다.
행을 가로로 읽으면 각 의도적 실패가 다른 위치에 나타납니다. 환각은 정합성만 떨어뜨립니다. 검색 실패는 관련성, 정밀도, 재현율을 한꺼번에 0으로 만듭니다. 랭킹 문제는 정밀도를 0.333으로 깎고, 드리프트는 답변된 질문 중 가장 낮은 관련성으로 나타납니다.
한 가지 특이점: 캐나다 답변은 해당 청크에 완전히 근거하지만 정합성이 0.667로 나왔습니다. 이는 심판 노이즈로, 추적 섹션에서 다시 다룹니다.
답변 관련성은 임베딩으로 의미를 비교하므로, 좋은 답변도 1.0에 가까이 나오기 드뭅니다. 환불 답변은 0.746, 엉뚱한 배송 답변은 0.572였습니다. 관련성은 절대값이 아니라 샘플 간 격차와 시간 경과 트렌드로 판단하세요.
RAG 품질 게이트는 평가를 실행하고, 각 평균 점수를 임계값과 비교하며, 어떤 지표라도 기준 미달이면 오류 코드로 종료하는 테스트 스크립트입니다. 그러면 CI 시스템이 병합을 차단합니다.
먼저 한 가지. 앞서 만든 수작업 데이터셋은 응답과 검색 청크가 하드코딩되어 있어, 이를 채점해도 프롬프트나 리트리버 변경이 반영되지 않습니다. CI에서는 저장해둔 질문에 대해 실제 파이프라인을 다시 실행하고 생성된 결과를 채점해야 합니다. 두 개의 작은 스크립트가 이를 수행합니다.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py는 유일하게 직접 작성하는 파일입니다. answer() 본문을 리트리버와 제너레이터 호출로 바꾸세요. refresh_dataset.py는 build_dataset.py가 저장한 질문과 기준 답변을 읽고, 각 질문에 대해 파이프라인을 실행한 후 eval_dataset.jsonl을 다시 작성합니다.
게이트 자체는 임계값 딕셔너리와 루프입니다. 아래 임계값은 수작업 예제 데이터셋을 기준으로 보정한 것이므로, 실제 파이프라인 출력에 맞춰 재보정한 뒤 사용하세요.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
제 기준선에서는 4개 평균 모두 임계값을 통과했고, 스크립트는 코드 0으로 종료되어 병합이 허용됩니다.
| Metric | Mean | Threshold | Result |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer relevancy | 0.668 | 0.60 | Pass |
| Context precision | 0.722 | 0.65 | Pass |
| Context recall | 0.833 | 0.75 | Pass |
정합성 임계값을 0.70이 아니라 0.60으로 둔 이유는 추적 섹션에서 다룰 심판 노이즈 때문입니다. 샘플이 6개뿐이면 심판의 한 번의 흔들림이 평균을 0.17만큼 움직입니다. 변하지 않은 파이프라인의 이후 실행에서 0.61이 나온 적도 있습니다. 게이트는 또한 심판을 3회 실행해 평균(GATE_RUNS)을 내어 단일 판정 뒤집힘을 3배 비용으로 완화합니다.
not (actual >= threshold)로 실패를 판단하는 것도 의도입니다. NaN(숫자가 아님)과의 비교는 항상 False입니다. actual < threshold로 썼다면 심판이 실패할 때마다 빌드가 통과해버립니다.
평균에서의 skipna=False는 부분 실패를 다룹니다. pandas는 기본적으로 NaN을 건너뛰므로, 몇 번의 심판 실패가 조용히 샘플 크기를 줄여 게이트를 통과시킬 수 있습니다. 이제 일시적 심판 오류는 빌드를 실패시키며, 디버깅 전에 잡을 재실행을 유도합니다.
임계값 튜닝은 까다롭습니다. 반복 실행에서 본 최저 평균보다 약간 낮게 설정하세요. 0.9 같은 희망 수치로 설정하면 모든 PR이 막혀 팀이 CI를 신뢰하지 않게 됩니다. 심판 모델을 바꾸거나 샘플을 한 번에 여러 개 추가할 때마다 다시 설정하세요.
GitHub Actions에 연결하는 워크플로우는 짧습니다. 워크플로우 문법 레퍼런스에서 on.pull_request 경로 필터와 여기서 쓰는 schedule 크론을 확인하세요.
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
이 워크플로우에서 중요한 디테일 몇 가지입니다.
JUDGE_MODEL과 일치하는 API 키로 고정합니다. 임계값을 보정한 것과 같은 심판을 써야, CI 점수가 추적 히스토리와 비교 가능합니다.GATE_SAMPLE로 30개 고정 무작위 서브셋만 채점해 리뷰가 심판 호출 때문에 10분씩 대기하지 않게 합니다. 야간 크론에서는 전체를 채점합니다.scores.csv와 ragas_history.jsonl을 아티팩트로 업로드합니다. 러너 디스크는 작업 종료 시 사라지기 때문입니다.풀 스위트는 야간 크론에서 실행하세요. 아무도 기다리지 않을 때입니다. 실패한 야간 실행은 실패한 워크플로우로 표시되고, GitHub 알림 설정이나 Slack 단계로 담당자에게 아침에 알릴 수 있습니다. GitLab CI도 rules: changes:와 파이프라인 스케줄로 같은 형태를 갖습니다.
Ragas는 문서를 읽고 주요 주제와 사실을 추출한 뒤, 관련된 청크를 연결하고, 그 연결로부터 다양한 유형의 질문을 작성해 합성 테스트 질문을 생성합니다.
테스트 데이터 생성 문서는 쿼리를 단일 홉(하나의 청크로 답 가능)과 멀티 홉(여러 청크 필요)으로 나누고, 각각을 구체적/추상적으로 분류합니다. 기본 믹스는 이 4가지 중 3가지를 동일 비율로 사용합니다.
Ragas는 문서가 지원할 수 있는 생성기만 사용하므로, 문서가 적으면 다른 믹스가 나올 수 있습니다.
생성기는 실제 문서가 필요합니다. 마크다운 파일로 된 자체 문서를 지정하세요. 이 글에서는 Northwind를 위해 5개의 짧은 도움말 페이지(총 약 600단어)를 작성했으며, 각 문서는 다음과 같습니다.
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
여러분의 문서는 아래와 다른 질문을 만들어낼 것입니다. 그게 목적입니다. 생성기는 실제 지식 베이스의 내용을 바탕으로 질문을 씁니다.
TestsetGenerator는 앞에서 만든 심판 LLM과 임베딩 모델을 그대로 사용합니다. 문서 로딩은 LangChain의 DirectoryLoader로 하며, 마크다운 파일이 무거운 unstructured 의존성을 끌어오지 않도록 TextLoader를 명시합니다.
문서 맵핑은 동시에 많은 심판 호출을 발생시키므로, RunConfig로 병렬 실행 수를 제한합니다.
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
스크립트는 5개 문서를 로드하고 아래 8개 질문을 작성합니다. 질문은 문서를 반영하며, 일부는 의도적으로 오타를 포함합니다.
| # | Generated question | Question type |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
표에는 단순화한 라벨을 보였고, 출력의 synthesizer_name 열에는 전체 생성기 이름이 들어 있습니다. 5개 문서에서 8개의 질문을 생성하는 데 약 4분 30초가 걸렸습니다.
질문 2의 키워드 스타일 쿼리와 오타는 의도적입니다. 생성기는 각 쿼리의 스타일과 길이를 다양화해, 시험 문제보다는 검색창 트래픽처럼 보이게 합니다.
질문이 적절한지 사용 가능성은 검토하고 싶을 것입니다. 저는 출력을 초안으로 사용하겠습니다. 제가 검토한 모든 합성 세트에서 일부 질문은 잘못 구성되어 있었습니다(“문서”를 참조하거나 제목에 대해 묻는 등). 일부 기준 답변은 원본과 어긋나고, 문구는 실제 사용자보다 더 형식적이었습니다.
문서에 섹션을 추가할 때 생성기를 다시 실행하면 새로운 내용에 대한 후보 질문을 얻을 수 있습니다. 심판 호출이 한 번 더 들긴 합니다.
각 행에는 user_input, 생성된 reference 답변, 그리고 질문이 만들어진 청크인 reference_contexts가 있습니다. reference를 해당 청크와 대조해 보세요. 그곳에서 드리프트가 나타납니다.
검토한 행을 SingleTurnSample로 바꾸려면, user_input에 대해 파이프라인을 실행해 retrieved_contexts와 response를 얻으세요. 검토된 user_input과 reference 쌍을 eval_questions.jsonl에 추가하면 refresh_dataset.py가 이를 처리합니다.
지식 베이스가 문서 묶음이 아닌 그래프라면, 리트리버만 달라질 뿐 원리는 같습니다. 지식 그래프로 RAG 애플리케이션 구현 튜토리얼과 Graph RAG with LangChain and Neo4j 과정은 정확히 위의 4가지 지표로 평가할 수 있는 파이프라인을 만듭니다. 지표는 검색된 텍스트만 보고, 어떻게 검색되었는지는 보지 않습니다.
Ragas 점수를 시간에 따라 추적한다는 것은, 각 평가 실행 후 평균 점수, git 커밋 해시, 심판 모델, 타임스탬프를 로그 파일에 추가하는 것입니다. 이렇게 하면 운영에서의 놀라움 대신 선 그래프의 하락으로 회귀를 포착할 수 있습니다.
여러 사람이 공유하는 실험 추적기가 필요해지기 전까지는 JSON Lines 파일이 가장 무난합니다. track_scores.py는 quality_gate.py와 run_all.py가 모두 쓰는 scores.csv를 읽어들여, 심판 호출을 한 번 더 유발하지 않습니다.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
uv run python track_scores.py를 실행하면 로그에 한 줄이 추가되고 동시에 출력됩니다.
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
CI에서는 각 작업이 빈 디스크에서 시작하므로 ragas_history.jsonl에는 해당 실행의 레코드만 저장됩니다. 추세를 유지하려면 업로드된 아티팩트를 내려받아 하나의 파일로 이어붙이거나, 메트릭 전용 브랜치나 오브젝트 스토리지에 커밋하세요.
히스토리 플로팅은 꽤 간단합니다. 다음 스크립트를 시도해 보세요.
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
아래와 비슷한 차트를 얻게 됩니다.
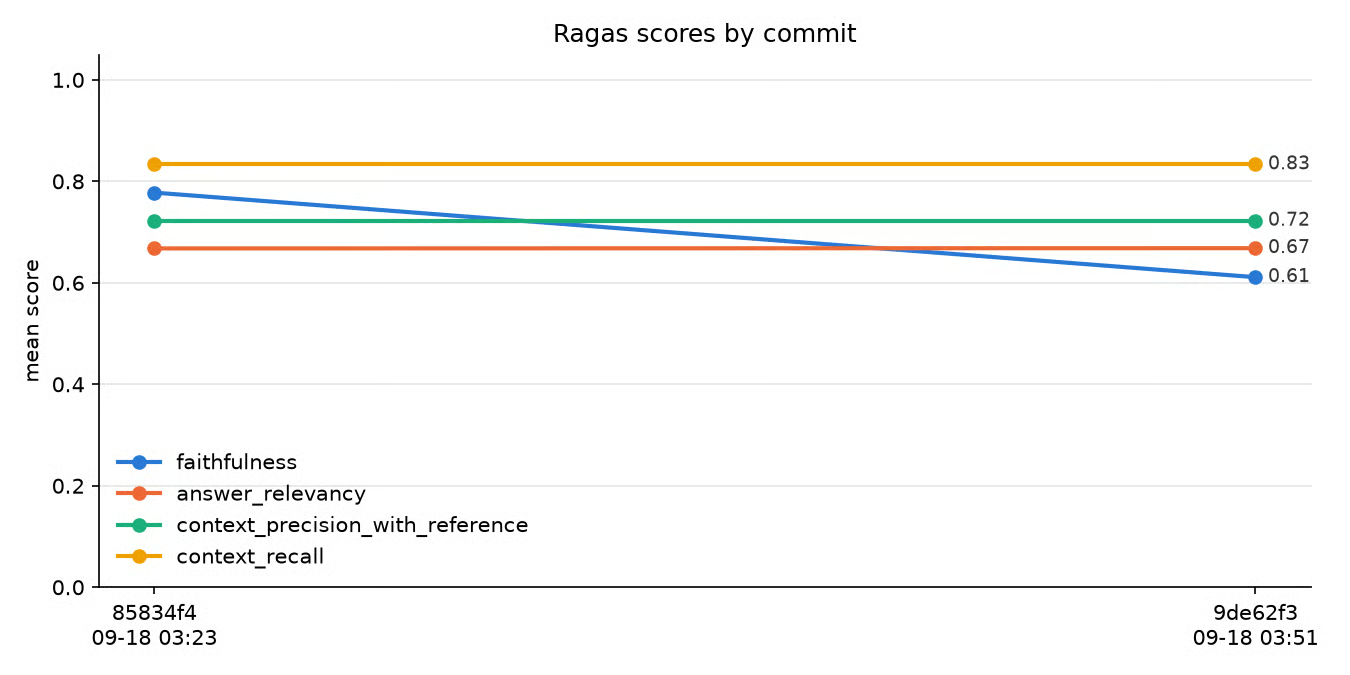
track_scores.py가 커밋별로 로깅한 평균 Ragas 점수. 이미지: 필자 제작.
두 커밋 사이에 파이프라인 자체는 바뀌지 않았습니다(두 번째는 심판 클라이언트 연결 설정만 바꿈). 그런데 샘플 6의 거부가 1.0에서 0.0으로 뒤집혀 정합성이 0.78에서 0.61로 떨어졌습니다.
따라서 충분한 샘플 수를 확보하기 전까지는 심판 노이즈를 경계해야 합니다. 샘플이 6개면 판정 한 번의 뒤집힘이 평균을 0.17 움직입니다. 100개 샘플이면 같은 뒤집힘이 0.01만 움직여, 큰 변화는 실제 회귀일 가능성이 훨씬 높아집니다.
이제 각 PR이나 커밋마다 게이트를 돌리고, 점수를 로깅하고, 차트를 볼 수 있습니다.
더 큰 구조적 변경을 저울질 중이라면, RAG vs. 파인튜닝 튜토리얼이 판단에 도움을 줍니다. 어느 경로든 같은 4가지 지표로 전후 비교를 할 수 있습니다.
LLM 심판 점수는 추정치입니다. 알려진 편향이 있고 실행마다 달라질 수 있지만, 사람 검수가 감당할 수 없는 평가 볼륨에 스케일합니다.
Ragas는 심판에게 두 답변을 비교하라고 요청하지 않습니다. 따라서 순서 편향(먼저 나온 답을 선호)이 대부분 적용되지 않습니다. 장황함 편향(긴 답을 선호)과 자기 선호 편향(자기 모델의 답을 선호)은 여전히 영향을 줄 수 있습니다. Zheng et al. (2023)이 세 가지 편향을 설명합니다. 자기 선호 때문에 저는 제너레이터와 심판에 같은 모델을 쓰지 않습니다.
실행 간 변동은 임계값 설정 방식을 바꾸기 때문에 직접 눈으로 보길 바랍니다. 동일한 6개 샘플과 고정된 심판으로 반복 실행하더라도, 샘플 6의 거부 답변은 어떤 실행에서는 정합성 0.0, 다른 실행에서는 1.0이었고, 완전히 근거 있는 샘플 5도 위 실행에서 0.667이 나왔습니다.
저렴한 심판의 샘플별 점수는 노이즈가 큽니다. 100개 샘플의 평균은 훨씬 덜 흔들립니다. CI 게이트는 항상 평균을 테스트해야 합니다.
노이즈를 제어하는 세 가지 실천:
judge.py와 track_scores.py처럼 하면 심판 변경을 파이프라인 변경으로 오인하지 않습니다.RAG를 넘어서는 폭넓은 평가 접근법과, 심판이 대체하고 있는 사람 평가 방법론은 LLM 평가 가이드에서 다룹니다. LLM as a judge 튜토리얼은 RAG 파이프라인을 위한 심판 구성에 대해 더 깊이 다룹니다.
이 파이프라인의 목적은 “리트리버는 괜찮고 프롬프트가 회귀했다”, “재랭커가 정밀도는 고쳤지만 재현율은 여전히 0.6이다” 같은 말을 수치로 뒷받침하며 할 수 있게 하는 것입니다.
정합성과 답변 관련성은 제너레이터를 감시합니다. 정합성은 꾸며낸 사실을, 답변 관련성은 질문에서 벗어난 답을 잡아냅니다. 컨텍스트 정밀도와 재현율은 리트리버를 감시해 올바른 정보를 끌어오는지 알려줍니다. 4개 중 2개는 기준 답변이 필요 없으므로, 기준이 없는 운영 트래픽에도 적용할 수 있습니다.
표준 텍스트 지표는 단어 겹침을 측정합니다. 이는 꾸며낸 환불 정책에 대해 아무 말도 하지 못하고, 단일 엔드 투 엔드 수치는 파이프라인의 어느 절반이 고장 났는지 숨깁니다. 두 실패 지점을 별도로 점검하는 프레임워크만이 이를 볼 수 있고, 일회성 감사를 CI 게이트와 히스토리 파일로 바꾸는 것이 팀이 수치를 행동으로 옮기게 하는 열쇠입니다.
아직 파이프라인을 만들지 않았다면 Retrieval-Augmented Generation with LangChain 과정부터 시작하고, 이 글의 pipeline.py를 그 결과물에 연결하세요.
일반 텍스트 검색을 넘어서는 파이프라인이라면, End-to-End RAG with Weaviate 과정, 멀티모달 RAG 가이드, 에이전틱 RAG 튜토리얼에서 동일한 방식으로 점수를 매길 수 있는 시스템을 구축합니다. 단, 한 가지 주의점이 있습니다. 4가지 핵심 지표는 텍스트만 읽습니다. 이미지를 검색하는 파이프라인은 Ragas의 별도 멀티모달 지표가 필요하고, 에이전틱 파이프라인은 각 검색 단계를 개별 질문·청크·답변으로 분리해 채점해야 합니다.
Top DataCamp Courses
강의
강의
강의