Cours
Graph RAG avec LangChain et Neo4j
3 h
2.3K
Un pipeline de génération augmentée par la récupération (RAG) pour un chatbot passe tous les tests rapides dans le notebook. Puis les tickets de support affluent pour signaler des réponses fausses ou étranges, et rien dans les journaux de smoke tests ne lève de drapeau rouge.
Cette défaillance est difficile à détecter sans métriques. Un pipeline RAG peut échouer à deux endroits : le récupérateur peut ramener les mauvais segments, ou le générateur peut ignorer de bons segments et inventer des faits. Un seul score d’exactitude de bout en bout ne vous dit pas lequel a dérapé, et donc ne vous dit pas quoi corriger.
Dans ce tutoriel, je construis un pipeline complet d’évaluation RAG en Python avec Ragas 0.4.3 : un jeu de données d’évaluation construit à la main, les 4 métriques clés (fiabilité, pertinence de la réponse, précision du contexte et rappel du contexte), une barrière qualité en intégration continue (CI) qui échoue la build quand les scores baissent, un générateur de jeu de tests synthétiques, et un suivi des scores en JSON Lines.
Si vous souhaitez plus de contexte, consultez notre guide sur ce qu’est RAG, notre tutoriel sur l’utilisation d’un grand modèle de langage (LLM) comme juge pour évaluer des pipelines RAG, et notre panorama des techniques RAG avancées.
Il vous faut Python 3.9 ou plus récent (j’utilise 3.12), uv ou pip, une clé API pour un modèle juge compatible OpenAI, et une idée générale du fonctionnement d’un pipeline RAG. Si vous préférez commencer par les bases, je vous recommande notre cours Retrieval-Augmented Generation with LangChain, qui construit le type de pipeline que nous allons évaluer.
Les métriques de recouvrement de texte comme BLEU (Bilingual Evaluation Understudy) et ROUGE (Recall-Oriented Understudy for Gisting Evaluation) ne sont pas la bonne jauge pour RAG. Ragas utilise plutôt un LLM juge pour noter chaque réponse selon 4 axes : la fiabilité (faithfulness) et la pertinence de la réponse (answer relevancy) diagnostiquent le générateur, tandis que la précision du contexte et le rappel du contexte diagnostiquent le récupérateur.
Placez ces 4 chiffres derrière un seuil en CI et consignez-les à chaque commit : vous obtenez une alerte de régression plutôt qu’un audit ponctuel.
Un avertissement avant de commencer. L’API de Ragas a changé deux fois en 2 ans : la v0.2 a remplacé les jeux de données dictionnaires par SingleTurnSample et EvaluationDataset, et la v0.4 a rendu les métriques « collections » (introduites en v0.3.9) par défaut et a marqué l’ancienne fonction evaluate() comme obsolète.
La plupart des tutoriels en ligne montrent encore du code v0.1 ou v0.2. Tout ce qui suit fonctionne avec la 0.4.3, qui est la version actuelle en octobre 2026.
RAG a besoin de ses propres métriques car les métriques textuelles classiques ne comptent que le nombre de mots partagés avec une réponse de référence, alors que le problème d’un système RAG ne vient pas du vocabulaire partagé.
BLEU (Papineni et al., 2002) et ROUGE (Lin, 2004) ont été conçues pour la traduction automatique et le résumé, où une bonne sortie doit employer sensiblement les mêmes mots que la référence. Une réponse RAG qui dit « vous avez 2 semaines » au lieu de « 14 jours » est pénalisée par les deux, tandis qu’une réponse fluide qui invente une politique de remboursement peut obtenir un bon score si elle réutilise les mots de la référence.
Le problème de fond est qu’un pipeline RAG peut échouer en deux endroits distincts : le récupérateur peut choisir la mauvaise information, ou le générateur peut ignorer une bonne information et inventer des faits. Quand une réponse est fausse, vous devez savoir ce qui s’est produit :
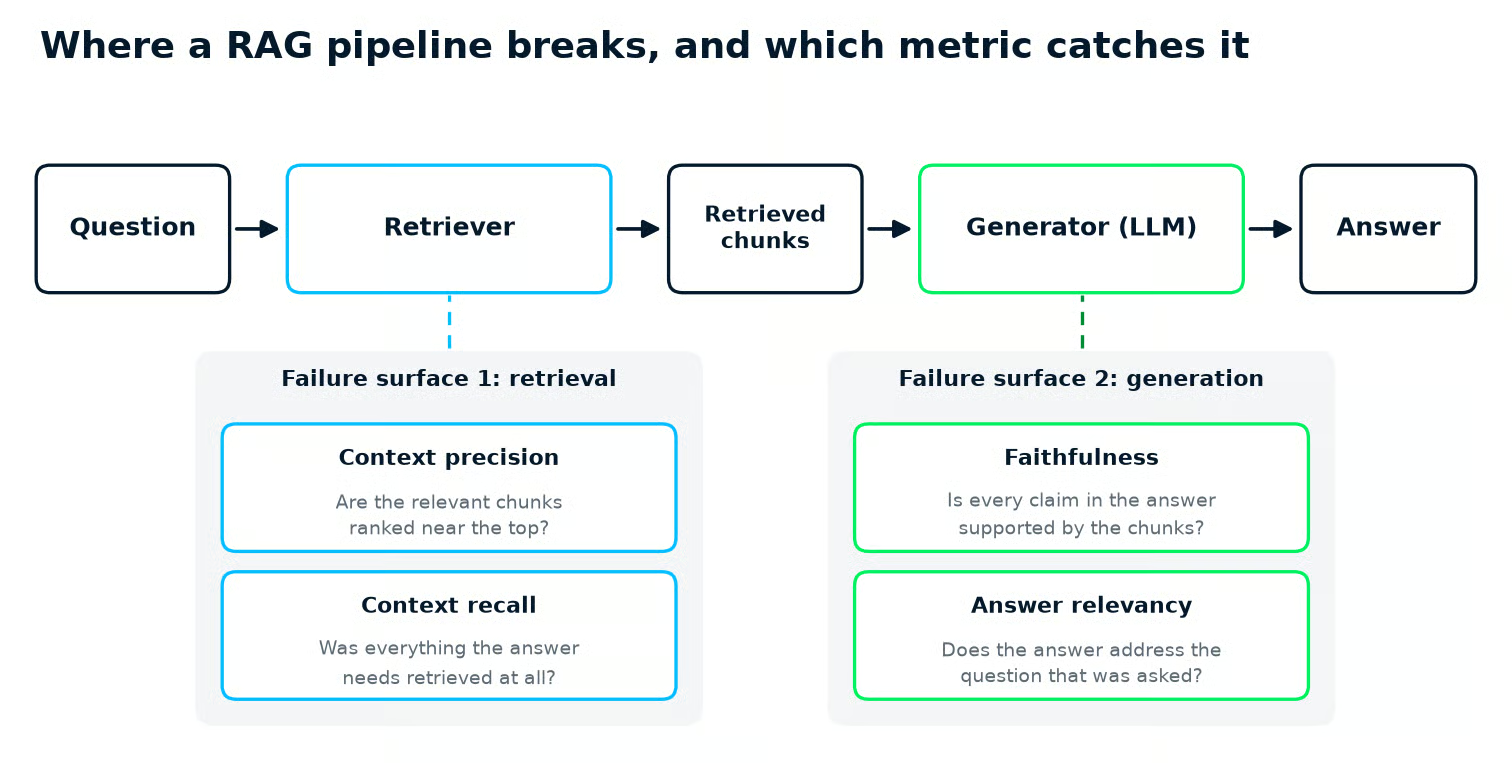
Les 2 modes de défaillance d’un pipeline RAG : la précision et le rappel du contexte diagnostiquent le récupérateur, la fiabilité et la pertinence de la réponse diagnostiquent le générateur. Image de l’auteur.
Notre article What Is Retrieval Augmented Generation (RAG)? A Complete Guide passe en revue les étapes du pipeline où ces défaillances apparaissent.
Ragas est un framework Python open source qui vous donne un nombre pour chaque partie du pipeline. Ce n’est pas l’unique option. Les deux principales alternatives sont DeepEval, qui encapsule l’évaluation dans des tests de style pytest, et Evidently, qui ajoute des contrôles LLM comme colonnes supplémentaires à un dataset et les alimente dans des rapports de monitoring.
| Framework | Idéal pour | Métriques RAG intégrées | Données de test depuis vos documents | Style de config |
|---|---|---|---|---|
| Ragas | Diagnostiquer des pipelines RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Objets Metric + un juge via llm_factory() |
| DeepEval | Tests LLM en CI façon unit tests | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Objets LLMTestCase, assert_test() lancés via deepeval test run |
| Evidently | Tableaux de bord et dérive dans le temps | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Génération de dataset RAG dans Evidently Cloud | Descripteurs sur un Dataset, synthétisés par un Report |
J’ai choisi Ragas pour ce tutoriel car ses 4 métriques clés séparent nettement les scores du récupérateur et du générateur, et parce que son générateur de jeu de tests est livré dans le même package open source.
Si votre équipe vit déjà dans pytest, le assert_test() de DeepEval sera plus naturel. Si vous voulez un tableau de bord sur le trafic live, les rapports d’Evidently iront plus vite.
Configurer Ragas consiste à installer le package, pinner une dépendance, et choisir un LLM juge partagé par toutes les métriques. J’utilise uv car il verrouille les versions exactes, mais pip install avec les mêmes versions fonctionne aussi.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
J’utilise Python 3.12 ici. Ragas 0.4.3 déclare un support pour Python 3.9 et plus.
Le package rapidfuzz est nécessaire pour le générateur de jeu de tests synthétiques plus loin dans l’article. Ragas ne le déclare pas en dépendance, donc je l’installe d’emblée.
Le pin langchain-community<0.4 n’est pas optionnel à la date d’écriture. Ragas 0.4.3 importe ChatVertexAI depuis un chemin que langchain-community 0.4 a supprimé, donc une installation sans pin échoue à l’import de ragas.
Ensuite, le juge. Chaque métrique basée LLM dans Ragas effectue une ou plusieurs requêtes vers un modèle juge, donc on le construit une fois et on le passe partout. Je le garde dans son propre module, judge.py, et je lis la clé dans l’environnement pour éviter de commiter des secrets.
Ce fichier montre comment appeler OpenAI directement, ou Gemini via le point de terminaison compatible OpenAI de Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Deux détails de ce fichier peuvent piéger votre première exécution :
llm_factory() en 0.4 a besoin d’un client passé en argument ; fournir uniquement un nom de modèle lève une erreur.llm_factory() sont transmis tels quels à l’appel du modèle, ce qui me permet d’augmenter max_tokens au-dessus de la valeur par défaut (1 024).Utilisez le modèle le moins cher qui produit des scores stables sur un échantillon que vous avez vérifié à la main, puis figez-le. Pour une grande suite d’évaluation, le volume coûte vite cher : la fiabilité fait 2 appels juge par échantillon, la pertinence de la réponse en fait 3 plus 2 appels d’embed, la précision du contexte en fait 1 par segment récupéré, et le rappel 1.
Six échantillons sur 4 métriques ont donné 62 requêtes en un seul run : 50 appels juge plus 12 appels d’embed. Voici le coût de 3 modèles juges « petits » chez chaque fournisseur, d’après leurs prix catalogue au 19 octobre 2026 :
| Modèle juge | Entrée pour 1 M de tokens | Sortie pour 1 M de tokens | Source |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | Tarifs OpenAI |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Tarifs API Gemini |
| claude-haiku-5-5 | $0.10 (prompts jusqu’à 100 K tokens) | $0.50 (prompts jusqu’à 100 K tokens) | Tarifs Claude API |
La valeur par défaut dans judge.py reste gpt-4o-mini, un ancien modèle OpenAI non listé dans le tableau principal des tarifs OpenAI. Définissez la variable JUDGE_MODEL pour changer.
Un piège si vous souhaitez Claude comme juge : la pertinence de la réponse a aussi besoin d’un modèle d’embed, et Anthropic n’en propose pas. Sa documentation pointe vers Voyage AI, donc vous associeriez Claude avec des embeddings d’un autre fournisseur.
Le gel de version compte plus que le choix. Changer de modèle juge décale les scores même si votre pipeline n’a pas changé, ce qui détruit la tendance que vous allez tracer dans la section suivi.
Mettez le nom du modèle dans judge.py sous contrôle de version et traitez une montée de version du juge comme tout changement majeur : réinitialisez chaque seuil d’après les nouveaux scores du juge.
Chaque cas de test du jeu de données est un échantillon. Un échantillon est plus qu’une réponse : il enregistre un passage complet dans le pipeline, en 4 champs :
| Champ | Contenu |
|---|---|
user_input |
La question du client |
retrieved_contexts |
Les segments retournés par le récupérateur pour cette question |
response |
La réponse donnée par le pipeline RAG |
reference |
La bonne réponse, rédigée par une personne |
Ragas stocke chaque échantillon en SingleTurnSample et l’ensemble en EvaluationDataset. Le champ reference est optionnel, mais les métriques de récupération s’y comparent, donc je l’inclus toujours dans le set curé même si les métriques sans référence l’ignorent.
J’ai construit 6 échantillons pour un torréfacteur fictif, Northwind Coffee. Chaque section de métrique ci-dessous ajoute l’échantillon que cette métrique doit détecter.
Commencez build_dataset.py avec les 3 premiers échantillons : une réponse correcte, une hallucination délibérée, et une seconde réponse correcte qui avance plusieurs affirmations à la fois.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Chaque contexte récupéré est un segment des pages du centre d’aide de Northwind, écrit dans le script exactement comme un récupérateur le transmettrait au générateur. Exécutez uv run python build_dataset.py pour écrire eval_dataset.jsonl et eval_questions.jsonl, et relancez-le chaque fois qu’une section ultérieure ajoute un échantillon.
Enregistrer en JSON Lines est important car tous les scripts suivants (l’exécution des métriques, la barrière CI) chargent le même eval_dataset.jsonl via EvaluationDataset.from_jsonl().
Dans un projet réel, les champs retrieved_contexts et response proviennent de l’exécution de votre pipeline réel sur les questions, et seuls user_input et reference sont rédigés à la main. La section CI montre comment automatiser cette étape.
Les 6 échantillons de cet article suffisent pour apprendre les métriques, mais pas pour faire confiance à un seuil. Visez environ 100 échantillons avant de vous appuyer dessus ; la section suivi explique pourquoi. Le volume nécessaire dépend de la rigueur de votre cas d’usage, donc je privilégie un bon mix plutôt qu’un nombre précis :
Les 4 métriques clés de Ragas sont : fiabilité et pertinence de la réponse pour le générateur, précision du contexte et rappel du contexte pour le récupérateur. Elles renvoient toutes un score entre 0 et 1. L’intérêt est ce que chaque score vous dit de corriger.
Faithfulness mesure dans quelle mesure une réponse est étayée par les segments récupérés. Le juge découpe la réponse en affirmations, puis vérifie chacune contre les segments : 1,0 signifie que toutes sont soutenues, 0,0 qu’aucune ne l’est.
La fiabilité n’a pas besoin d’une réponse de référence ; vous pouvez donc la lancer sur du trafic de production, pas seulement sur votre jeu de test. Relancez-la quand vous changez l’invite, le modèle, ou la quantité de contexte, car ces changements introduisent le plus souvent des hallucinations.
Le moyen le plus rapide de la voir en action est sur une seule réponse, sans dataset :
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Lancez uv run python quick_check.py : il affiche faithfulness = 0.00, car aucune des deux affirmations (6 mois, sac offert) n’est soutenue par le contexte. En 0.4, on note via la méthode ascore() de chaque métrique ; .value contient le score.
Sur le dataset à ce stade, l’hallucination placée dans l’échantillon 2 obtient 0,0 comme attendu, et les deux réponses propres obtiennent 1,0. Les résultats complets pour chaque métrique figurent dans la section multi-métriques plus bas.
Answer relevancy mesure si la réponse traite bien la question posée. Le juge lit la réponse et écrit 3 questions auxquelles elle conviendrait, puis Ragas mesure la proximité sémantique de ces questions avec la question initiale à l’aide d’un modèle d’embed. Si la réponse esquive, le juge la marque non committale et elle vaut 0.
La classe s’appelle AnswerRelevancy (des exemples plus anciens parlent de ResponseRelevancy, et la page de doc s’intitule Response Relevancy), et elle nécessite le LLM juge et le modèle d’embed.
Un score de pertinence bas avec un score de fiabilité élevé pointe généralement le générateur ou l’invite : le modèle avait le bon contexte et y est resté, mais a répondu à côté. Vérifiez d’abord la précision et le rappel du contexte, car un récupérateur qui renvoie des segments hors sujet peut produire le même motif.
Cet échantillon illustre le cas générateur. Le récupérateur renvoie le bon segment d’expédition, la réponse reste ancrée, et parle des dates de torréfaction au lieu du coût de livraison. Ajoutez le nouveau segment en tête de build_dataset.py :
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Puis ajoutez le nouvel échantillon à la fin de la liste samples :
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Chaque échantillon obtient un score de pertinence : dans quelle mesure les questions générées à partir de la réponse correspondent à la question réellement posée, 1,0 étant une correspondance parfaite.
La précision du contexte vérifie si les segments utiles sont bien classés en tête de ce que le récupérateur renvoie, et le rappel du contexte vérifie si le récupérateur a trouvé tout ce qui est nécessaire pour écrire la bonne réponse.
La précision donne plus de crédit à un segment utile bien classé ; un segment utile en première position compte plus que le même segment en troisième. Le rappel est la part de faits de la réponse de référence qu’au moins un segment récupéré soutient.
Les deux ont besoin du champ reference. Dans l’API « collections », les classes sont ContextPrecisionWithReference et ContextRecall, et ne prennent que le LLM juge. La doc Ragas utilise aussi le nom plus court ContextPrecision pour la version basée sur la référence, vous verrez donc les deux.
Jusqu’ici, chaque échantillon récupère les bons segments en tête, donc ces métriques n’ont encore rien à détecter. Ajoutons 2 échantillons qui cassent la récupération de manières différentes : l’un où le bon segment est récupéré mais classé dernier, et l’autre où rien de pertinent n’est récupéré, donc le modèle refuse correctement. Comme avant, ajoutez les segments en haut du fichier :
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Puis ajoutez les échantillons à la fin de la liste :
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Le classement compte car la plupart des pipelines ne transmettent au modèle que les premiers segments ; un segment utile en 6e position d’un récupérateur top‑5 revient à ne pas exister.
L’échantillon 5 place son seul segment utile en dernier sur 3 ; la précision vaut 0,333 car l’unique information utile est classée dernière. L’échantillon 6, le raté de récupération, obtient 0,0 en précision comme en rappel.
L’échantillon 6 apprend aussi quelque chose sur la fiabilité. Le modèle refuse correctement, mais ce refus a scoré 1,0 à certains runs et 0,0 à d’autres, sans changement. Une phrase comme « Je n’ai pas d’information sur la garantie » n’est ni étayée ni contredite par le contexte, et le juge tranche au hasard.
Si votre pipeline doit refuser, scorez les refus séparément plutôt que de laisser la fiabilité fluctuer. Ragas 0.4 a retiré AspectCritic de l’API collections ; le remplacement est un contrôle personnalisé avec le décorateur @discrete_metric (voir le guide de migration v0.3→v0.4).
Lisez les 2 scores de récupération ensemble : ils vous disent où investir votre semaine suivante :
| Précision du contexte | Rappel du contexte | Diagnostic | À changer |
|---|---|---|---|
| Élevée | Élevé | Récupération saine | Focus sur le générateur : prompt, modèle, fiabilité |
| Basse | Élevé | Bons segments récupérés mais mal classés | Ajouter/ajuster un reranker |
| Élevée | Bas | Top segments pertinents mais incomplets | Passer plus de segments au modèle, agrandir ou revoir le découpage |
| Basse | Bas | Récupérateur en échec global | Revoir embeddings, indexation et réécriture des requêtes |
La ligne « faible précision, fort rappel » est la plus fréquente en pratique, et la moins chère à corriger.
Nos tutoriels RankGPT comme agent de reranking pour RAG et Booster la précision des LLM avec RAG et le reranking montrent deux configurations de reranking. Notre guide 5 techniques clés pour améliorer les performances RAG couvre le chunking et la réécriture pour les autres cas.
Relancez les deux métriques de récupération après chaque changement ; le tableau vous dira si cela a fonctionné.
Une évaluation multi‑métriques complète lance les 4 métriques sur chaque échantillon en parallèle et collecte les scores, avec des valeurs par ligne pour investiguer les échecs et des moyennes de colonne pour votre tableau de bord.
En Ragas 0.2/0.3, on faisait evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). En 0.4.3, cette fonction existe encore, mais elle est dépréciée et refuse les nouvelles métriques, qui n’héritent plus de l’ancienne classe Metric.
Le remplaçant est le @experiment, qui exécute pipeline et métriques ensemble sur un Dataset et écrit des résultats en CSV. C’est l’outil adapté dès que vous avez un pipeline à appeler.
Pour scorer un dataset statique, j’aime un petit helper : il instancie les 4 métriques pour chaque script, et garde l’asynchrone et la gestion d’erreur dans un code lisible :
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
La ligne non évidente est l’appel à inspect.signature(). Les 4 métriques veulent des inputs différents (la fiabilité a besoin de la réponse, le rappel de la référence, etc.). Le helper lit les arguments que ascore() accepte et transmet exactement ces champs de l’échantillon, ce qui permet une boucle unique.
Le sémaphore plafonne le nombre d’appels juge simultanés, et une métrique qui échoue reste une cellule vide (NaN) au lieu d’aborter tout le run. Dans Jupyter, asyncio.run échoue car une boucle tourne déjà ; appelez nest_asyncio.apply() (Ragas en dépend) ou attendez la coroutine directement.
Avec le helper, l’exécution complète est concise :
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Voici les scores de mon premier run, triés par fiabilité et arrondis à 3 décimales, avec les moyennes en dernière ligne :
| Question | Fiabilité | Pertinence de la réponse | Précision du contexte | Rappel du contexte |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Des runs ultérieurs du même dataset ont noté la fiabilité plus bas à cause du retournement du refus de l’échantillon 6, que je couvre en section suivi.
Le tri par fiabilité aide à repérer les hallucinations probables, et celle que nous avons plantée est bien en tête. Les moyennes de la dernière ligne sont vos chiffres de tableau de bord.
Lisez ligne par ligne, chaque défaillance plantée apparaît à un endroit différent. L’hallucination n’abaisse que la fiabilité. Le raté de récupération met à 0 la pertinence, la précision et le rappel ensemble. Le problème de ranking baisse la précision à 0,333, et la dérive apparaît comme la pertinence la plus faible parmi les réponses données.
Une bizarrerie : la réponse Canada est pleinement étayée, pourtant elle a obtenu 0,667 en fiabilité. C’est du bruit du juge, que je reprends en section suivi.
La pertinence compare du sens via embeddings, donc même une bonne réponse atteint rarement 1,0 : la réponse remboursement a 0,746, la réponse hors sujet sur l’expédition 0,572. Jugez la pertinence par l’écart entre échantillons et la tendance, pas par la valeur absolue.
Une barrière qualité RAG est un script de test qui lance l’évaluation, compare chaque moyenne à un seuil, et sort avec un code d’erreur si une métrique est en dessous, ce qui bloque le merge en CI.
Un écueil d’abord. Le dataset construit à la main renseigne à la main les réponses et segments récupérés, donc son scoring ne reflète jamais un changement d’invite ou de récupérateur. En CI, vous devez relancer le pipeline réel sur vos questions sauvegardées puis scorer la production. Deux petits scripts s’en chargent.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py est le seul fichier que vous écrivez : remplacez le corps de answer() par un appel à votre récupérateur et générateur. refresh_dataset.py lit les questions et réponses de référence sauvegardées par build_dataset.py, exécute le pipeline pour chaque question et réécrit eval_dataset.jsonl.
La barrière elle‑même est un dictionnaire de seuils et une boucle. Les seuils ci‑dessous sont calibrés sur le dataset d’exemple ; recalibrez‑les sur la sortie de votre pipeline avant d’en dépendre.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Sur ma base, les 4 moyennes dépassent leurs seuils, et le script sort avec le code 0, laissant passer le merge :
| Métrique | Moyenne | Seuil | Résultat |
|---|---|---|---|
| Fiabilité | 0.778 | 0.60 | Succès |
| Pertinence de la réponse | 0.668 | 0.60 | Succès |
| Précision du contexte | 0.722 | 0.65 | Succès |
| Rappel du contexte | 0.833 | 0.75 | Succès |
J’ai fixé la fiabilité à 0,60 plutôt que 0,70 à cause du bruit du juge décrit en section suivi. Avec 6 échantillons, un verdict instable déplace la moyenne de 0,17, et un run ultérieur d’un pipeline inchangé a scoré 0,61. La barrière lance aussi le juge 3 fois et moyenne (GATE_RUNS), ce qui lisse les retournements ponctuels au coût de 3× plus d’appels juge.
Un choix de conception : échouer sur not (actual >= threshold) plutôt que actual < threshold. Une comparaison avec NaN est toujours False, donc un test actual < threshold laisserait passer la build quand le juge échoue.
Le skipna=False dans la moyenne couvre le cas partiel. Par défaut, pandas ignore les NaN ; quelques appels juge échoués réduiraient silencieusement l’échantillon au lieu d’échouer la barrière. Une erreur transitoire du juge fait désormais échouer la build ; relancez le job avant de débugger.
Les seuils sont délicats à régler. Fixez‑les légèrement en dessous de la plus basse moyenne observée sur des runs répétés, pas à un 0,9 ambitieux, sinon la barrière bloque chaque PR et l’équipe cesse d’y croire. Réajustez‑les à chaque changement de modèle juge ou après avoir ajouté plus que quelques échantillons.
L’intégration à GitHub Actions tient en peu de lignes. La référence de syntaxe couvre les filtres de chemins on.pull_request et le cron schedule utilisé ici :
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Quelques détails importants :
JUDGE_MODEL et la clé API correspondante. Utilisez le même juge que celui qui a servi à calibrer les seuils, sinon les scores CI ne seront pas comparables à votre historique.GATE_SAMPLE score un sous‑ensemble fixe de 30 lignes, pour éviter d’attendre 10 minutes d’appels juge. Le cron nocturne score tout.scores.csv et ragas_history.jsonl comme artefacts, car le disque du runner disparaît après le job.Lancez la suite complète la nuit, quand personne n’attend. Un échec nocturne apparaît comme un workflow en échec, et une notification GitHub ou une étape Slack peut prévenir le propriétaire le matin. GitLab CI suit la même logique avec rules: changes: et un pipeline schedule.
Ragas génère des questions de test synthétiques en lisant vos documents, en extrayant leurs sujets et faits principaux, en reliant les segments associés, puis en écrivant des questions de différents types à partir de ces liens.
La documentation de génération distingue les requêtes single‑hop (un segment suffit) et multi‑hop (plusieurs segments nécessaires), chacune pouvant être spécifique ou abstraite. Le mix par défaut utilise 3 combinaisons sur 4 à parts égales :
Ragas n’utilise que les synthétiseurs que vos documents peuvent supporter ; un petit corpus peut produire un mix différent.
Le générateur a besoin de vrais documents. Pointez‑le vers votre doc sous forme de fichiers markdown. Pour cet article, j’ai rédigé 5 courtes pages d’aide pour Northwind (environ 600 mots au total), et chacune ressemble à ceci :
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Vos propres docs produiront des questions différentes, c’est le but : le générateur écrit des questions sur ce que votre base de connaissance dit réellement.
Le TestsetGenerator prend le même LLM juge et le même modèle d’embed que nous avons déjà construits. Je charge les docs avec DirectoryLoader de LangChain, en forçant TextLoader pour que les fichiers markdown n’entraînent pas la lourde dépendance unstructured.
La cartographie de vos documents déclenche de nombreux appels juge en parallèle ; je limite aussi la parallélisation avec RunConfig :
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Le script charge les 5 documents et écrit ces 8 questions. Les questions collent aux documents, avec quelques fautes volontaires :
| # | Question générée | Type |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Le tableau affiche des libellés simplifiés ; la colonne synthesizer_name du CSV contient le nom complet du synthétiseur. Huit questions issues de 5 documents ont pris environ 4,5 minutes.
Les fautes de frappe et la requête style mots‑clés (question 2) sont volontaires : le générateur varie le style et la longueur pour ressembler à des recherches réelles plutôt qu’à des questions d’examen.
Vous voudrez sans doute relire les questions pour vérifier leur qualité et leur pertinence. J’utiliserais la sortie comme première ébauche. Dans chaque set synthétique que j’ai revu, certaines questions sont mal formées (elles mentionnent « le document » ou un intitulé), certaines réponses de référence dérivent de la source, et la phraséologie est plus formelle que celle d’un vrai utilisateur.
Relancez le générateur quand vous ajoutez une section à la doc ; vous obtiendrez des questions candidates pour le nouveau contenu, au prix d’un nouveau lot d’appels juge.
Chaque ligne contient un user_input, une reference générée, et des reference_contexts, les segments ayant servi à construire la question. Vérifiez la reference par rapport à ces segments ; c’est là que la dérive se voit.
Pour transformer une ligne relue en SingleTurnSample, lancez votre pipeline sur le user_input pour obtenir retrieved_contexts et response. Ajoutez les paires user_input/reference validées à eval_questions.jsonl et refresh_dataset.py fera le reste.
Si votre base de connaissances est un graphe plutôt qu’un tas de documents, le principe reste le même avec un récupérateur différent. Nos tutoriels Using a Knowledge Graph to Implement a RAG Application et notre cours Graph RAG with LangChain and Neo4j bâtissent des pipelines évaluables avec ces 4 métriques, car elles ne voient que le texte récupéré, pas la méthode de récupération.
Suivre les scores Ragas dans le temps consiste à ajouter après chaque run les moyennes, le hash du commit git, le modèle juge et un horodatage à un fichier log, pour que les régressions apparaissent comme une baisse sur un graphique plutôt qu’une surprise en production.
Un fichier JSON Lines est probablement le meilleur choix tant que vous n’avez pas besoin d’un traqueur d’expériences partagé. track_scores.py lit scores.csv, que quality_gate.py et run_all.py écrivent tous deux, donc il ne déclenche jamais une seconde série d’appels juge.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Exécuter uv run python track_scores.py ajoute une ligne au log et l’affiche :
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
En CI, chaque job démarre sur un disque vide ; ragas_history.jsonl ne contient donc que l’enregistrement du run. Pour garder une tendance, téléchargez les artefacts uploadés et concaténez‑les, ou commitez le fichier sur une branche « metrics » ou dans un stockage objet.
Tracer l’historique est simple. Essayez le script suivant :
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Vous obtiendrez un graphique ressemblant à ceci :
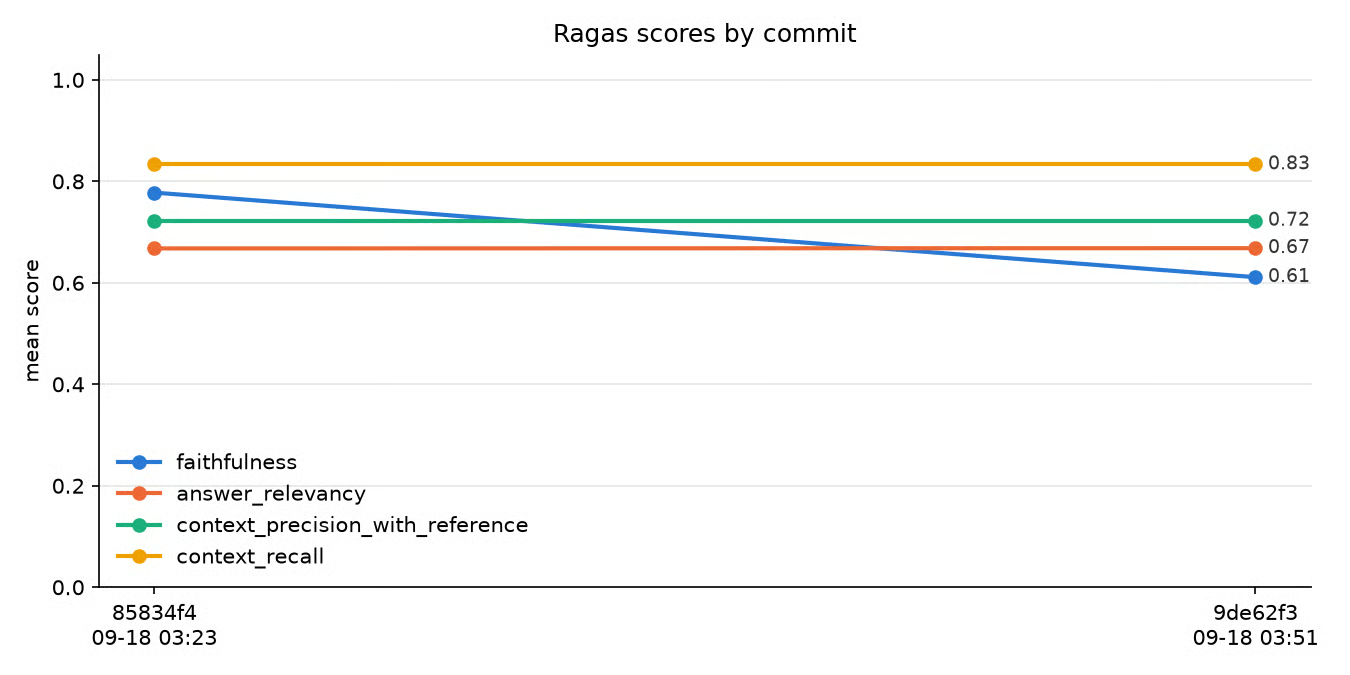
Moyennes Ragas consignées par commit via track_scores.py. Image de l’auteur.
Rien n’a changé dans le pipeline entre ces commits (le second ne modifie que les paramètres de connexion du client juge), pourtant la fiabilité est passée de 0,78 à 0,61 car le refus de l’échantillon 6 a basculé de 1,0 à 0,0.
Il y a donc un bruit réel du juge à surveiller tant que vous n’avez pas beaucoup d’échantillons. Avec 6 échantillons, 1 verdict instable déplace la moyenne de 0,17. Avec 100 échantillons, le même basculement la déplace de 0,01 ; un gros écart est bien plus probablement une vraie régression.
À présent, à chaque PR ou commit, vous pouvez lancer la barrière, journaliser les scores, et regarder le graphique.
Si vous envisagez un changement d’architecture plus large, notre tutoriel RAG vs fine‑tuning cadre le choix, et les mêmes 4 métriques servent de mesure « avant/après » dans les deux cas.
Les scores « LLM‑as‑a‑judge » sont des estimations : ils ont des biais connus et varient d’un run à l’autre, mais ils passent à l’échelle à des volumes qu’une revue humaine ne peut pas absorber.
Ragas ne demande jamais au juge de comparer deux réponses, donc le biais de position (favoriser la première) s’applique peu. Le biais de verbosité (favoriser les réponses longues) et d’auto‑préférence (un juge qui favorise son propre modèle) peuvent compter. Zheng et al. (2023) décrivent ces trois biais ; l’auto‑préférence est la raison pour laquelle je n’utiliserais pas le même modèle comme générateur et juge.
La variation d’un run à l’autre est la partie que je veux que vous constatiez vous‑même, car elle change la façon de régler les seuils. À jugé figé et sur les mêmes 6 échantillons, le refus de l’échantillon 6 a valu 0,0 à un run et 1,0 à un autre en fiabilité, et l’échantillon 5 parfaitement étayé a valu 0,667 dans le run montré ci‑dessus.
Les scores par échantillon d’un juge « petit » sont bruyants. Des moyennes sur 100 échantillons le sont beaucoup moins, et la barrière CI doit toujours tester la moyenne.
Trois pratiques pour contenir le bruit :
judge.py et track_scores.py, pour qu’un changement de juge ne soit jamais pris pour un changement de pipeline.Pour un tour plus large des approches d’évaluation au‑delà de RAG, y compris les méthodes humaines que le juge remplace ici, notre guide d’évaluation LLM couvre métriques et méthodologies. Notre tutoriel LLM juge va plus loin sur la construction d’un juge pour des pipelines RAG.
Le but de ce pipeline est de pouvoir dire « le récupérateur va bien, le prompt a régressé » ou « le reranker a corrigé la précision mais le rappel reste à 0,6 », avec des chiffres à l’appui.
La fiabilité et la pertinence de la réponse surveillent le générateur : la fiabilité attrape les faits inventés, la pertinence les réponses qui dérivent de la question. La précision et le rappel du contexte surveillent le récupérateur et vous disent s’il ramène la bonne information. Comme 2 des 4 métriques n’ont pas besoin de réponse de référence, vous pouvez les lancer sur du trafic de production où il n’y a pas de référence.
Les métriques textuelles standard mesurent le recouvrement de mots, ce qui ne dit rien d’une politique de remboursement inventée, et un score unique de bout en bout masque la moitié du pipeline qui a cassé. Un framework qui contrôle séparément les deux points de défaillance le voit, et en faire une barrière CI avec un historique incite l’équipe à agir sur les chiffres.
Si vous n’avez pas encore construit le pipeline, commencez par notre cours Retrieval-Augmented Generation with LangChain, puis pointez le pipeline.py de cet article sur ce que vous aurez bâti.
Pour des pipelines au‑delà de la simple récupération de texte, nos cours End‑to‑End RAG with Weaviate, notre guide RAG multimodal, et notre tutoriel RAG agentique construisent des systèmes évaluables de la même manière, avec une réserve : les 4 métriques clés ne lisent que du texte. Un pipeline qui récupère des images a besoin des métriques multimodales séparées de Ragas, et un pipeline agentique doit scorer chaque étape de récupération comme sa propre question, ses segments et sa réponse.
Les meilleurs cours DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
Zoumana Keita
15 min
Tutoriel
Josef Waples
8 min
Tutoriel
Dr Ana Rojo-Echeburúa
12 min
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Kurtis Pykes
15 min