
Curso
Graph RAG com LangChain e Neo4j
3 h
2.3K
Um pipeline de retrieval-augmented generation (RAG) para chatbot passa por todos os smoke tests no notebook. Aí começam a chegar chamados de suporte com respostas erradas ou estranhas — e nada nos logs do smoke test acusa o problema.
Esse tipo de falha é difícil de enxergar porque fica invisível sem métricas. Um pipeline de RAG pode dar errado em 2 pontos: o recuperador pode buscar os chunks errados, ou o gerador pode ignorar bons chunks e inventar fatos. Um único número de acurácia de ponta a ponta não diz qual dos dois aconteceu — então não diz o que você precisa corrigir.
Neste tutorial, vou construir um pipeline completo de avaliação de RAG em Python usando o Ragas 0.4.3: um conjunto de avaliação montado à mão, as 4 métricas centrais (faithfulness, answer relevancy, context precision e context recall), um quality gate de integração contínua (CI) que falha o build quando as pontuações caem, um gerador de conjunto de testes sintéticos e um rastreador de pontuações em JSON Lines.
Se você quiser mais contexto antes, veja nosso guia sobre o que é RAG, nosso tutorial sobre usar um LLM (large language model) como juiz para avaliar pipelines de RAG e nosso panorama de técnicas avançadas de RAG.
Você vai precisar de Python 3.9 ou mais novo (uso 3.12), uv ou pip, uma chave de API para um modelo juiz compatível com OpenAI e uma noção de como um pipeline de RAG funciona. Se quiser essa base antes, recomendo nosso curso Retrieval-Augmented Generation with LangChain, que constrói o tipo de pipeline que vamos pontuar.
Métricas de sobreposição de texto como BLEU (Bilingual Evaluation Understudy) e ROUGE (Recall-Oriented Understudy for Gisting Evaluation) são a régua errada para RAG. O Ragas usa um LLM juiz para pontuar cada resposta em 4 eixos: faithfulness e answer relevancy diagnosticam o gerador, enquanto context precision e context recall diagnosticam o recuperador.
Coloque esses 4 números atrás de um limite na sua CI e registre por commit — você passa a ter um alarme de regressão em vez de uma auditoria pontual.
Um aviso antes de começar. A API do Ragas mudou duas vezes em 2 anos: a v0.2 trocou datasets em dicionários por SingleTurnSample e EvaluationDataset, e a v0.4 tornou as metrics de collections (introduzidas na v0.3.9) o padrão e marcou a antiga função evaluate() como deprecada.
A maioria dos tutoriais ainda mostra código da v0.1 ou v0.2. Tudo abaixo roda em 0.4.3, a versão atual em outubro de 2026.
RAG precisa de métricas próprias porque as métricas clássicas contam quantas palavras a resposta compartilha com a referência — e a escolha de palavras não é o que quebra em um sistema de RAG.
BLEU (Papineni et al., 2002) e ROUGE (Lin, 2004) foram criadas para tradução e sumarização, em que uma boa saída tende a usar as mesmas palavras da referência. Uma resposta de RAG que diga “você tem 2 semanas” em vez de “14 dias” pontua mal nas duas, enquanto uma resposta fluente que inventa uma política de reembolso pode pontuar bem se reaproveitar as palavras da referência.
O problema mais fundo é que um pipeline de RAG pode falhar em 2 lugares diferentes: o recuperador pode trazer a informação errada, ou o gerador pode ignorar uma informação correta e inventar fatos. Quando uma resposta sai errada, você precisa saber o que aconteceu:
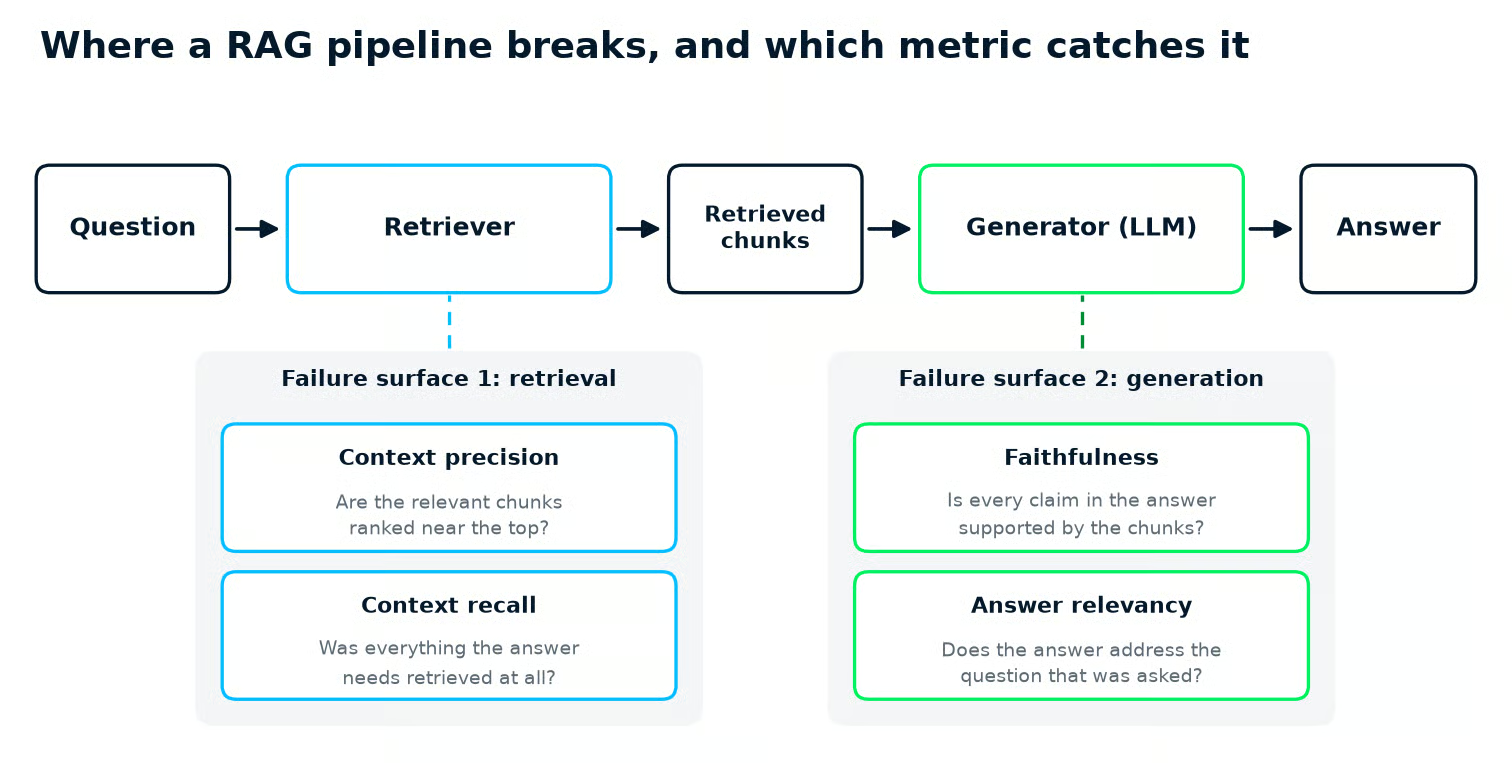
Os 2 modos de falha de um pipeline de RAG: context precision e recall diagnosticam o recuperador, enquanto faithfulness e answer relevancy diagnosticam o gerador. Imagem do autor.
Nosso guia What Is Retrieval Augmented Generation (RAG)? A Complete Guide percorre as etapas do pipeline onde essas falhas se originam.
Ragas é um framework open source em Python que te dá um número para cada parte do pipeline. Não é a única opção. As 2 principais alternativas são o DeepEval, que envolve a avaliação em casos de teste ao estilo pytest, e o Evidently, que adiciona checagens de LLM como colunas extras em um dataset e as leva a relatórios de monitoramento.
| Framework | Melhor para | Métricas específicas de RAG nativas | Dados de teste a partir dos seus documentos | Estilo de configuração |
|---|---|---|---|---|
| Ragas | Diagnosticar pipelines de RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Objetos de métricas + um juiz via llm_factory() |
| DeepEval | Testes de LLM em CI no estilo unit test | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Objetos LLMTestCase, assert_test() rodando via deepeval test run |
| Evidently | Dashboards de monitoramento e drift ao longo do tempo | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Geração de dataset de RAG no Evidently Cloud | Descritores em um Dataset, resumidos por um Report |
Escolhi o Ragas para este tutorial porque suas 4 métricas centrais separam bem as pontuações do recuperador e do gerador, e porque o gerador de conjunto de testes vem no mesmo pacote open source.
Se seu time já vive no pytest, o assert_test() do DeepEval vai soar mais natural. Se você quer um dashboard com qualidade do tráfego ao vivo, os relatórios do Evidently te levam mais rápido até lá.
Configurar o Ragas é instalar o pacote, fixar uma dependência e escolher um LLM juiz que todas as métricas vão compartilhar. Vou usar uv porque ele trava versões exatas para você, mas pip install com as mesmas versões também funciona.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Estou usando Python 3.12 aqui. O Ragas 0.4.3 declara suporte para Python 3.9 ou mais novo.
O pacote rapidfuzz é necessário para o gerador de conjunto de testes sintéticos mais adiante. O Ragas não o declara como dependência, então instalo de antemão.
O pin langchain-community<0.4 não é opcional no momento em que escrevo. O Ragas 0.4.3 importa ChatVertexAI de um caminho de módulo que o langchain-community 0.4 removeu, então uma instalação nova sem o pin falha ao importar ragas.
Agora, o juiz. Toda métrica baseada em LLM no Ragas faz 1 ou mais chamadas a um modelo juiz, então você o constrói uma vez e passa adiante. Eu deixo isso em um módulo próprio, judge.py, e leio a chave do ambiente para nenhuma credencial cair no git.
Este arquivo mostra como chamar a OpenAI diretamente, ou o Gemini pelo endpoint compatível com OpenAI do Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Dois detalhes nesse arquivo podem atrapalhar a primeira execução:
llm_factory() na 0.4 precisa receber um objeto client; passar só o nome do modelo gera erro.llm_factory() vai direto para a chamada do modelo — é assim que aumento max_tokens acima do padrão de 1.024.Use o modelo mais barato que produza pontuações estáveis em uma amostra que você conferiu manualmente — e então fixe-o. Em uma suíte grande, o volume cresce rápido: faithfulness faz 2 chamadas ao juiz por amostra, answer relevancy faz 3 mais 2 chamadas de embeddings, context precision faz 1 por chunk recuperado e context recall faz 1.
Seis amostras em 4 métricas somaram 62 requisições em uma única execução: 50 chamadas ao juiz e 12 de embeddings. Aqui está quanto 3 modelos juízes pequenos custam, pelos preços de tabela dos provedores em 19 de outubro de 2026:
| Modelo juiz | Entrada por 1M tokens | Saída por 1M tokens | Fonte |
|---|---|---|---|
| gpt-6-luna | $0,10 | $0,50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0,30 | $2,50 | Gemini API pricing |
| claude-haiku-5-5 | $0,10 (prompts até 100K tokens) | $0,50 (prompts até 100K tokens) | Claude API pricing |
O padrão em judge.py ainda é gpt-4o-mini, um modelo OpenAI mais antigo que não aparece na tabela principal de preços na página da OpenAI. Defina a variável JUDGE_MODEL para trocar.
Um detalhe se você quiser o Claude como juiz: answer relevancy também precisa de um modelo de embeddings, e a Anthropic não oferece um. A documentação aponta para a Voyage AI, então você combinaria Claude com embeddings de outro provedor.
Fixar o modelo importa mais do que a escolha em si. Trocar o juiz muda as pontuações mesmo sem alterar seu pipeline, destruindo a linha de tendência que você vai construir na seção de rastreamento.
Coloque o nome do modelo no judge.py sob controle de versão e trate uma atualização do juiz como qualquer mudança quebradora: recalcule todos os limites com as pontuações do novo juiz.
Cada caso de teste no dataset é uma amostra (sample). Uma amostra é mais que uma resposta: ela registra uma passagem completa pelo pipeline em 4 campos:
| Campo | O que guarda |
|---|---|
user_input |
A pergunta que o cliente fez |
retrieved_contexts |
Os chunks que o recuperador retornou para essa pergunta |
response |
A resposta que o pipeline de RAG deu |
reference |
A resposta correta, escrita por uma pessoa |
O Ragas guarda cada amostra como SingleTurnSample e o conjunto como EvaluationDataset. O reference é opcional, mas as métricas de recuperação o usam como comparação, então eu sempre incluo no conjunto curado mesmo que as métricas sem referência o ignorem.
Montei 6 amostras para uma torrefadora fictícia, Northwind Coffee. Cada seção de métrica abaixo adiciona a amostra que aquela métrica deveria pegar.
Comece o build_dataset.py com as 3 primeiras amostras: uma resposta limpa, uma alucinação deliberada e uma segunda resposta limpa que faz várias afirmações de uma vez.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Cada contexto recuperado é um trecho das páginas de ajuda da Northwind, escrito no script exatamente como um recuperador passaria para o gerador. Rode uv run python build_dataset.py para escrever eval_dataset.jsonl e eval_questions.jsonl, e rode de novo sempre que uma seção posterior adicionar uma amostra.
Salvar em JSON Lines importa porque todos os scripts seguintes (as execuções das métricas, o gate de CI) carregam o mesmo eval_dataset.jsonl com EvaluationDataset.from_jsonl().
Num projeto real, os campos retrieved_contexts e response vêm da execução do seu pipeline real sobre as perguntas, e só user_input e reference são escritos à mão. A seção de CI mostra como automatizar esse passo.
As 6 amostras deste artigo bastam para aprender as métricas, mas não para confiar em um limite. Mire em ~100 amostras antes de depender disso; a seção de rastreamento mostra o porquê. Quantas você precisa depende do rigor do seu caso de uso, então foque numa boa mistura em vez de um número fixo:
As 4 métricas centrais do Ragas são faithfulness e answer relevancy para o gerador, e context precision e context recall para o recuperador. Todas retornam uma pontuação entre 0 e 1. O valor está no que cada número te diz para corrigir.
Faithfulness mede quanto da resposta é sustentado pelos chunks recuperados. O juiz divide a resposta em afirmações e checa cada uma contra os chunks: 1.0 quer dizer que todas são suportadas, e 0.0 que nenhuma é.
Faithfulness não precisa de resposta de referência, então você pode rodá-la no tráfego de produção, não só no conjunto de testes. Rode de novo sempre que mudar o prompt, o modelo ou a quantidade de contexto que o modelo vê — são essas mudanças que mais introduzem alucinações.
A forma mais rápida de ver em ação é em uma única resposta, sem dataset:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Rode com uv run python quick_check.py e ele imprime faithfulness = 0.00, porque nenhuma das afirmações da resposta (6 meses, uma sacola grátis) é suportada pelo contexto. Na 0.4 você pontua com o método ascore() de cada métrica, que retorna um resultado cujo .value é a pontuação.
No dataset até aqui, a alucinação plantada na amostra 2 fica com 0.0, como deveria, e as duas amostras limpas com 1.0. Os resultados completos para cada métrica estão na seção de multi-métricas abaixo.
Answer relevancy mede se a resposta de fato aborda a pergunta. O juiz lê a resposta e escreve 3 perguntas para as quais ela seria uma boa resposta; depois, o Ragas mede quão próximas em significado essas perguntas ficam da pergunta original, usando um modelo de embeddings. Se a resposta escapa da pergunta, o juiz marca como evasiva e ela pontua 0.
A classe se chama AnswerRelevancy (exemplos antigos usam ResponseRelevancy, e a página da doc se chama Response Relevancy) e precisa do LLM juiz e do modelo de embeddings.
Relevância baixa com faithfulness alto geralmente aponta para o gerador ou o prompt: o modelo tinha o contexto certo e ficou ancorado nele, mas respondeu outra pergunta. Antes, cheque context precision e recall, porque um recuperador que retorna chunks fora de tópico pode produzir o mesmo padrão.
Esta amostra mostra o caso do gerador. O recuperador retorna o chunk certo de frete, a resposta se mantém ancorada — e fala de data de torra em vez de custo do frete. Adicione o novo chunk aos chunks no topo do build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Depois, adicione a nova amostra ao final da lista samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Cada amostra recebe uma pontuação de relevância: o quão perto em significado as perguntas que o juiz gerou a partir da resposta ficam da pergunta que a amostra realmente fez, onde 1.0 é uma correspondência perfeita.
Context precision verifica se os chunks úteis estão ranqueados no topo do que o recuperador retornou, e o context recall verifica se o recuperador encontrou tudo que é necessário para escrever a resposta correta.
Precision dá mais crédito a um chunk útil quanto mais alto ele aparece no ranking, então um chunk útil em primeiro lugar conta mais do que o mesmo chunk em terceiro. Recall é a fração dos fatos na resposta de referência que ao menos um chunk recuperado suporta.
Ambos precisam do campo reference. Na API de collections, as classes são ContextPrecisionWithReference e ContextRecall, e ambas recebem só o LLM juiz. A doc do Ragas também usa o nome abreviado ContextPrecision para a versão com referência, então você pode ver ambos.
Até aqui toda amostra recupera os chunks certos primeiro, então nenhuma métrica tem o que pegar. Vamos adicionar 2 amostras que quebram a recuperação de jeitos diferentes: uma em que o chunk certo é recuperado, mas fica por último no ranking, e outra em que nada relevante é recuperado, então o modelo recusa corretamente. Como antes, adicione os chunks ao topo do arquivo:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Depois, adicione as amostras ao final da lista:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Ranking importa porque a maioria dos pipelines passa só os primeiros chunks para o modelo — então um chunk útil em 6º lugar de um recuperador top-5 é como se não existisse.
A amostra 5 coloca seu único chunk útil em 3º de 3, e a precision volta 0,333 porque a única informação útil está por último. A amostra 6, o erro de recuperação, ficou com 0,0 em precision e em recall.
A amostra 6 também ensina algo sobre faithfulness. O modelo recusou corretamente, mas essa recusa pontuou 1.0 em algumas execuções e 0.0 em outras — sem nada mudar entre elas. Uma frase como “não tenho informações sobre a garantia” não é nem suportada nem contradita pelo contexto, e o juiz oscila.
Se seu pipeline deve recusar, pontue recusas separadamente em vez de deixar que baguncem a faithfulness. O Ragas 0.4 removeu AspectCritic da API de collections, então a substituição é uma checagem customizada com o decorator @discrete_metric (veja o guia de migração da v0.3 para v0.4).
Ler os 2 números de recuperação juntos diz onde investir sua próxima semana:
| Context precision | Context recall | Diagnóstico | O que mudar |
|---|---|---|---|
| Alta | Alta | Recuperação saudável | Foque no gerador: prompt, modelo, faithfulness |
| Baixa | Alta | Chunks certos recuperados, mas ranqueados mal | Adicionar ou calibrar um reranker |
| Alta | Baixa | Top chunks relevantes porém incompletos | Passar mais chunks ao modelo, usar chunks maiores ou ajustar o split |
| Baixa | Baixa | Recuperador falhando de forma ampla | Rever embeddings, indexação e reescrita de consultas |
A linha “baixa precision, alta recall” é a mais comum que vejo na prática — e a mais barata de corrigir.
Nosso tutorial RankGPT como agente de reranking para RAG adiciona um reranker de LLM sobre um recuperador existente, e nosso tutorial Aumente a precisão de LLM com RAG e reranking mostra outra configuração. Nosso guia de 5 técnicas essenciais para melhorar desempenho em RAG cobre chunking e reescrita de consultas para as outras linhas.
Rode as 2 métricas de recuperação após cada mudança e a tabela mostra se funcionou.
Uma avaliação completa roda as 4 métricas em todas as amostras em paralelo e coleta as pontuações, com valores por linha para investigar falhas e médias por coluna para seu dashboard.
No Ragas 0.2 e 0.3 você fazia isso com evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). Na 0.4.3 essa função ainda existe, mas avisa que está deprecada e recusa as novas métricas, porque elas não herdam mais da classe antiga Metric que ela espera.
A substituta é o @experiment decorator, que roda seu pipeline e suas métricas juntos sobre um Dataset e escreve resultados em CSV. É a ferramenta certa quando você já tem um pipeline para chamar.
Para pontuar um dataset estático, acho um helper pequeno mais claro: ele constrói as 4 métricas uma vez para cada script que precisa delas e mantém as chamadas paralelas e o tratamento de erros em código legível:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
A linha menos óbvia é a inspect.signature(). As 4 métricas querem entradas diferentes (faithfulness precisa da resposta; recall, da referência), então o helper lê quais argumentos o ascore() de cada métrica aceita e passa exatamente esses campos da amostra — permitindo um único loop para todas.
O semáforo limita quantas chamadas ao juiz rodam de uma vez, e uma métrica que ainda falhar vira uma célula vazia (NaN) em vez de derrubar a execução inteira. Se você rodar dentro de um Jupyter, asyncio.run falha porque já existe um loop; chame nest_asyncio.apply() antes (o Ragas já depende dele) ou faça await direto.
Com o helper pronto, a execução completa fica curta:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Aqui estão as pontuações da minha primeira execução, ordenadas por faithfulness e arredondadas para 3 casas, com as médias na última linha:
| Pergunta | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0,000 | 0,883 | 1,000 | 1,000 |
| Does Northwind ship to Canada, and how long does it take? | 0,667 | 0,954 | 0,333 | 1,000 |
| How long do I have to ask for a refund on a bag of coffee? | 1,000 | 0,746 | 1,000 | 1,000 |
| How long is the warranty on the Baratza Encore grinder? | 1,000 | 0,000 | 0,000 | 0,000 |
| How much does standard shipping cost in the US? | 1,000 | 0,572 | 1,000 | 1,000 |
| What do subscribers get that regular customers do not? | 1,000 | 0,852 | 1,000 | 1,000 |
| Média | 0,778 | 0,668 | 0,722 | 0,833 |
Execuções posteriores do mesmo dataset pontuaram faithfulness mais baixo por causa do vaivém na amostra de recusa que comento na seção de rastreamento.
Ordenar por faithfulness ajuda a identificar as prováveis alucinações, e a plantada aparece no topo. As médias da última linha são os números do seu dashboard.
Lendo por linha, cada falha plantada aparece em um ponto diferente. A alucinação derruba só a faithfulness. A falha de recuperação zera relevância, precision e recall juntas. O problema de ranking derruba a precision para 0,333, e o desvio de tema aparece como a menor relevância entre as perguntas respondidas.
Uma estranheza: a resposta do Canadá é totalmente sustentada pelo chunk, mas marcou 0,667 em faithfulness. Esse é o ruído do juiz, que volto a tratar na seção de rastreamento.
Answer relevancy compara significado via embeddings, então mesmo uma boa resposta raramente chega perto de 1,0: a resposta de reembolso marcou 0,746, enquanto a resposta fora de tópico sobre frete marcou 0,572. Julgue relevância pela diferença entre amostras e pela tendência ao longo do tempo, não pelo número absoluto.
Um quality gate de RAG é um script de teste que roda a avaliação, compara cada média com um limite e sai com código de erro quando alguma métrica fica abaixo — o que informa à CI para bloquear o merge.
Um detalhe primeiro. O dataset montado à mão acima guarda respostas e chunks recuperados no próprio arquivo, então pontuá-lo nunca vai refletir uma mudança no seu prompt ou recuperador. Na CI você precisa reexecutar o pipeline real sobre as perguntas salvas e então pontuar o que ele produziu. Dois scripts simples fazem isso.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py é o único arquivo que você escreve: substitua o corpo de answer() por uma chamada ao seu recuperador e gerador. O refresh_dataset.py lê as perguntas e respostas de referência salvas pelo build_dataset.py, roda o pipeline em cada pergunta e reescreve o eval_dataset.jsonl.
O gate em si é um dicionário de limites e um loop. Os limites abaixo foram calibrados no dataset de exemplo montado à mão; recalcibre-os na saída do seu próprio pipeline antes de depender deles.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
No meu baseline, as 4 médias ficaram acima dos limites e o script saiu com código 0 — liberando o merge:
| Métrica | Média | Limite | Resultado |
|---|---|---|---|
| Faithfulness | 0,778 | 0,60 | Aprovado |
| Answer relevancy | 0,668 | 0,60 | Aprovado |
| Context precision | 0,722 | 0,65 | Aprovado |
| Context recall | 0,833 | 0,75 | Aprovado |
Coloquei o limite de faithfulness em 0,60 (e não 0,70) por causa do ruído do juiz que explico na seção de rastreamento. Com 6 amostras, um único veredito instável move a média em 0,17, e uma execução posterior do pipeline inalterado marcou 0,61. O gate também roda o juiz 3 vezes e faz a média (GATE_RUNS), o que suaviza oscilações pontuais — a 3 vezes o custo do juiz.
Uma decisão de design é falhar em not (actual >= threshold) em vez de actual < threshold. Comparar com NaN (“not a number”) sempre dá False, então uma checagem como actual < threshold aprovaria o build quando o juiz cai.
O skipna=False na média cobre o caso parcial. O pandas ignora NaN por padrão, então algumas falhas no juiz encolheriam silenciosamente a amostra em vez de falhar o gate. Agora, um erro transitório do juiz falha o build — rode o job de novo antes de depurar.
Limites são difíceis de ajustar. Defina-os um pouco abaixo da menor média que você viu em execuções repetidas — não num aspiracional 0,9 — ou o gate vai bloquear todo PR e o time para de confiar na CI. Reajuste sempre que trocar o modelo juiz ou adicionar mais do que um punhado de amostras.
Para ligar no GitHub Actions, o workflow é curto. A referência de sintaxe cobre os filtros de caminho em on.pull_request e o cron em schedule usado aqui:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Alguns detalhes desse workflow importam:
JUDGE_MODEL e a chave de API correspondente. Use o mesmo juiz com que você calibrado os limites, ou as pontuações de CI não vão ser comparáveis ao seu histórico.GATE_SAMPLE pontua um subconjunto aleatório fixo de 30 linhas — assim a revisão não fica esperando 10 minutos de chamadas ao juiz. O cron noturno pontua tudo.scores.csv e ragas_history.jsonl como artefatos, porque o disco do runner some ao fim do job.Rode a suíte completa no cron noturno, quando ninguém está esperando. Uma falha aparece como workflow com erro, e as notificações do GitHub ou um passo no Slack podem avisar o responsável de manhã. O GitLab CI segue o mesmo padrão com rules: changes: e um pipeline schedule.
O Ragas gera perguntas de teste sintéticas lendo seus documentos, puxando tópicos e fatos principais, ligando chunks relacionados e então escrevendo perguntas de tipos diferentes a partir dessas ligações.
A doc de geração de dados de teste divide as consultas em single-hop (um chunk responde) e multi-hop (a resposta precisa de vários chunks), e cada uma pode ser específica ou abstrata. A mistura padrão usa 3 dessas 4 combinações em partes iguais:
O Ragas só usa os sintetizadores que seus documentos suportam, então um conjunto pequeno pode produzir outra mistura.
O gerador precisa de documentos reais. Aponte para sua própria documentação em arquivos markdown. Para este artigo, escrevi 5 páginas curtas do help center da Northwind (cerca de 600 palavras no total), e cada uma é assim:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Os seus próprios docs vão produzir perguntas diferentes das abaixo — e isso é o objetivo: o gerador escreve perguntas sobre o que sua base realmente diz.
O TestsetGenerator usa o mesmo LLM juiz e o mesmo modelo de embeddings que já construímos. Carrego os docs com o DirectoryLoader do LangChain, usando TextLoader explicitamente para os arquivos markdown não puxarem a dependência pesada do unstructured.
Mapear seus documentos dispara muitas chamadas ao juiz de uma vez, então também limito o paralelismo com RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
O script carrega os 5 documentos e escreve estas 8 perguntas. As perguntas refletem os documentos e algumas contêm erros de digitação deliberados:
| # | Pergunta gerada | Tipo de pergunta |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
A tabela mostra rótulos simplificados; a coluna synthesizer_name na saída traz o nome completo do sintetizador. Oito perguntas a partir de 5 documentos levaram ~4,5 minutos.
Os typos e a consulta no estilo “palavra-chave” na pergunta 2 são de propósito: o gerador varia o estilo e o tamanho de cada consulta para o conjunto parecer tráfego de busca, não prova escolar.
Provavelmente você vai querer revisar as perguntas para garantir que são usáveis e relevantes. Eu usaria a saída como rascunho. Em todo conjunto sintético que revisei, algumas perguntas vêm malformadas (referem-se a “o documento” ou a um heading), algumas respostas de referência se afastam do que a fonte realmente diz e a redação é mais formal do que a de um usuário real.
Rode o gerador sempre que adicionar uma seção à doc e você ganha perguntas candidatas para o novo material — ao custo de outra rodada de chamadas ao juiz.
Cada linha tem um user_input, uma reference gerada e reference_contexts, os chunks de onde a pergunta veio. Confira a reference contra esses chunks — é aí que aparece o drift.
Para transformar uma linha revisada em SingleTurnSample, rode seu pipeline sobre o user_input para obter retrieved_contexts e response. Acrescente os pares revisados de user_input e reference ao eval_questions.jsonl e o refresh_dataset.py faz o resto.
Se sua base de conhecimento é um grafo e não um monte de documentos, o princípio é o mesmo com outro recuperador. Nosso tutorial Using a Knowledge Graph to Implement a RAG Application e nosso curso Graph RAG with LangChain and Neo4j produzem pipelines que você avalia com as mesmas 4 métricas — porque as métricas só leem o texto recuperado, não como ele foi recuperado.
Acompanhar as pontuações do Ragas ao longo do tempo é adicionar, após cada execução de avaliação, as médias, o hash do commit, o modelo juiz e um timestamp a um arquivo de log — assim uma regressão aparece como uma queda em um gráfico de linha, não como surpresa em produção.
Um arquivo JSON Lines provavelmente é a melhor aposta até você precisar de um tracker de experimentos compartilhado. O track_scores.py lê o scores.csv, que quality_gate.py e run_all.py já escrevem — então ele nunca dispara uma segunda rodada de chamadas ao juiz.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Rodar uv run python track_scores.py adiciona uma linha ao log e a imprime:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
Na CI, cada job começa com um disco vazio, então o ragas_history.jsonl sempre terá só o registro daquela execução. Para manter uma tendência, baixe os artefatos enviados e agregue num arquivo, ou faça commit em um branch de métricas ou em um storage de objetos.
Plotar o histórico é simples. Experimente o script:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Você vai obter um gráfico parecido com este:
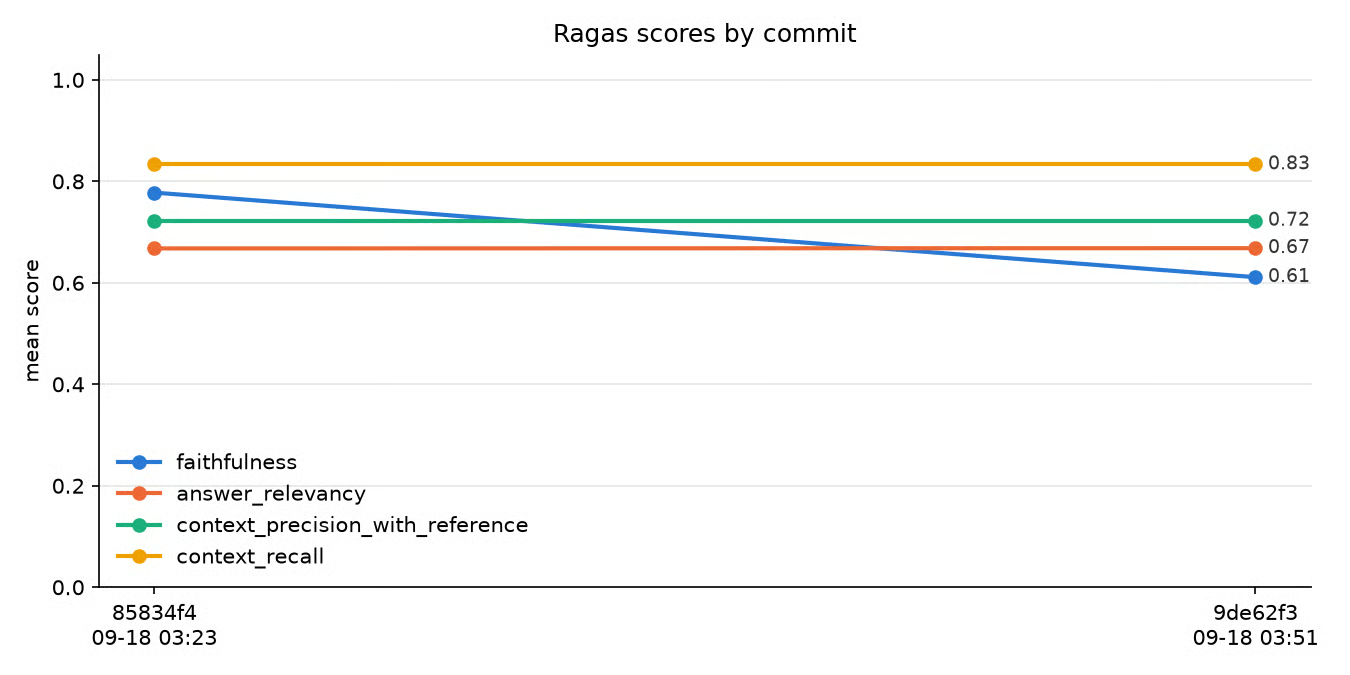
Médias do Ragas registradas por commit pelo track_scores.py. Imagem do autor.
Nada no pipeline mudou entre aqueles commits (o segundo só alterou as configurações de conexão do cliente do juiz), e ainda assim a faithfulness caiu de 0,78 para 0,61 porque a recusa na amostra 6 virou de 1,0 para 0,0.
Ou seja: há ruído real do juiz até você ter um número grande de amostras. Com 6 amostras, 1 veredito instável move a média em 0,17. Com 100 amostras, o mesmo flip move 0,01 — então uma grande mudança é bem mais provável ser uma regressão real.
Agora, a cada pull request ou commit, você pode rodar o gate, registrar as pontuações e olhar o gráfico.
Se estiver avaliando uma mudança arquitetural maior, nosso tutorial RAG vs. fine-tuning enquadra o trade-off, e as mesmas 4 métricas funcionam como medição antes e depois em ambos os caminhos.
As pontuações de LLM-como-juiz são estimativas: têm vieses conhecidos e podem variar entre execuções — mas escalam para volumes que revisão humana não alcança.
O Ragas nunca pede para o juiz comparar 2 respostas, então o viés de posição (favorecer a resposta que vem primeiro) praticamente não se aplica. Viés de verbosidade (favorecer respostas mais longas) e viés de auto-preferência (juízes favorecendo respostas do próprio modelo) ainda importam. Zheng et al. (2023) descrevem os 3, e o de auto-preferência é por que eu não usaria o mesmo modelo como gerador e juiz.
A variação entre execuções é o ponto que quero que você veja com seus próprios olhos, porque muda como você define limites. Em execuções da mesma 6 amostras com o mesmo juiz fixado, a resposta de recusa da amostra 6 marcou 0,0 em uma execução e 1,0 em outra em faithfulness, e a amostra 5 — totalmente ancorada — marcou 0,667 na execução mostrada acima.
Pontuações por amostra de um juiz barato são ruidosas. Médias sobre 100 amostras são muito menos ruidosas — e o gate de CI deve sempre testar a média.
Três práticas para conter o ruído:
judge.py e track_scores.py fazem acima, para uma troca de juiz nunca ser confundida com uma mudança no pipeline.Para um panorama mais amplo de avaliação além de RAG, incluindo métodos de avaliação humana que o juiz está substituindo, nosso guia de avaliação de LLMs cobre métricas e metodologias. Nosso tutorial de LLM como juiz aprofunda a construção de um juiz para pipelines de RAG.
O objetivo desse pipeline é permitir dizer coisas como “o recuperador está ok, o prompt regrediu” ou “o reranker consertou a precision, mas o recall ainda está em 0,6”, com números por trás.
Faithfulness e answer relevancy observam o gerador: faithfulness pega fatos inventados e answer relevancy pega respostas que fogem da pergunta. Context precision e recall observam o recuperador e dizem se ele traz a informação certa. Como 2 das 4 não precisam de referência, você pode rodá-las no tráfego de produção, onde a referência não existe.
Métricas textuais padrão medem sobreposição de palavras — o que não diz nada sobre uma política de reembolso inventada —, e um número único de ponta a ponta esconde qual metade do pipeline quebrou. Um framework que checa os 2 pontos de falha separadamente enxerga isso — e transformar a avaliação de auditoria pontual em um gate de CI com histórico é o que faz o time agir sobre os números.
Se você ainda não construiu o pipeline, comece com nosso curso Retrieval-Augmented Generation with LangChain e depois aponte o pipeline.py deste artigo para o que você construir.
Para pipelines que vão além de recuperação de texto puro, nosso curso End-to-End RAG with Weaviate, nosso guia de RAG multimodal e nosso tutorial de agentic RAG constroem sistemas que você pode pontuar do mesmo jeito — com uma ressalva: as 4 métricas centrais leem só texto. Um pipeline que recupera imagens precisa das métricas multimodais do Ragas; um pipeline agentic precisa de cada etapa de recuperação pontuada como sua própria pergunta, chunks e resposta.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Natassha Selvaraj
10 min
blog
Stanislav Karzhev
9 min
Tutorial
Ryan Ong
8 min
Tutorial
Ryan Ong
12 min
Tutorial
DataCamp Team
10 min
Tutorial
Abid Ali Awan
12 min


