
कोर्स
LangChain और Neo4j के साथ Graph RAG
3 घंटा
2.3K
किसी चैटबॉट के लिए retrieval-augmented generation (RAG) पाइपलाइन नोटबुक में हर स्मोक टेस्ट पास कर लेती है। फिर गलत या अजीब जवाबों पर सपोर्ट टिकट आने लगते हैं—और स्मोक टेस्ट लॉग में कोई चेतावनी नज़र नहीं आती।
यह विफलता पकड़ना कठिन है क्योंकि मेट्रिक्स के बिना यह अदृश्य रहती है। RAG पाइपलाइन 2 जगहों पर गलत हो सकती है: रिट्रीवर गलत चंक्स ला सकता है, या जनरेटर अच्छे चंक्स को नज़रअंदाज़ करके तथ्य गढ़ सकता है। एक अकेला एंड-टू-एंड एक्युरेसी नंबर यह नहीं बता सकता कि किस हिस्से में समस्या आई, इसलिए यह यह भी नहीं बताता कि ठीक क्या करना है।
इस ट्यूटोरियल में मैं Python में Ragas 0.4.3 का उपयोग करके एक पूरी RAG मूल्यांकन पाइपलाइन बनाऊंगा: हाथ से तैयार किया गया मूल्यांकन डेटासेट, 4 मुख्य मेट्रिक्स (faithfulness, answer relevancy, context precision, और context recall), एक continuous integration (CI) क्वालिटी गेट जो स्कोर गिरने पर बिल्ड फेल कर देता है, एक सिंथेटिक टेस्ट सेट जनरेटर, और एक JSON Lines स्कोर ट्रैकर।
यदि आप पहले अधिक पृष्ठभूमि चाहते हैं, तो हमारा RAG क्या है गाइड, RAG पाइपलाइनों का मूल्यांकन करने के लिए एक बड़े भाषा मॉडल (LLM) को जज की तरह उपयोग करने वाला हमारा ट्यूटोरियल, और एडवांस्ड RAG तकनीकों का ओवरव्यू देखें।
आपको Python 3.9 या नया (मैं 3.12 उपयोग करता हूँ), uv या pip, एक OpenAI-कंपैटिबल जज मॉडल के लिए API कुंजी, और RAG पाइपलाइन कैसे काम करती है इसकी मोटी समझ चाहिए। यदि आप पहले वह आधार चाहते हैं, तो हमारा Retrieval-Augmented Generation with LangChain कोर्स देखें, जिसमें हम उसी तरह की पाइपलाइन बनाते हैं जिसका हम यहां स्कोर करेंगे।
BLEU (Bilingual Evaluation Understudy) और ROUGE (Recall-Oriented Understudy for Gisting Evaluation) जैसे टेक्स्ट-ओवरलैप मेट्रिक्स RAG के लिए सही पैमाना नहीं हैं। Ragas की जगह एक जज LLM हर उत्तर को 4 अक्षों पर स्कोर करता है: faithfulness और answer relevancy जनरेटर का निदान करते हैं, जबकि context precision और context recall रिट्रीवर का।
इन 4 संख्याओं को CI में एक थ्रेशहोल्ड के पीछे रखें और प्रति कमिट लॉग करें, तो आपके पास एक बार के ऑडिट की जगह रिग्रेशन अलार्म होगा।
शुरू करने से पहले एक चेतावनी। 2 वर्षों में Ragas API दो बार बदली: v0.2 ने dictionary डेटासेट्स की जगह SingleTurnSample और EvaluationDataset दिए, और v0.4 ने (v0.3.9 में आए) कलेक्शंस मेट्रिक्स को डिफॉल्ट बनाया और पुराने evaluate() फ़ंक्शन को डिप्रिकेट कर दिया।
ज्यादातर ऑनलाइन ट्यूटोरियल अब भी v0.1 या v0.2 का कोड दिखाते हैं। नीचे दिया सब कुछ 0.4.3 पर चलता है, जो अक्टूबर 2026 तक का वर्तमान रिलीज़ है।
RAG को अपने मेट्रिक्स इसलिए चाहिए क्योंकि क्लासिक टेक्स्ट मेट्रिक्स केवल यह गिनते हैं कि किसी उत्तर में रेफरेंस उत्तर के साथ कितने शब्द साझा हैं, जबकि RAG सिस्टम में जो टूटता है वह साझा शब्दावली नहीं होती।
BLEU (Papineni et al., 2002) और ROUGE (Lin, 2004) मशीन अनुवाद और संक्षेपण के लिए बने थे, जहाँ अच्छा आउटपुट रेफरेंस जैसे ही शब्दों का उपयोग करता है। RAG का कोई उत्तर जो “14 दिनों” की जगह “2 सप्ताह” कहे, दोनों पर खराब स्कोर करेगा, जबकि रिफंड पॉलिसी गढ़ देने वाला एक सधी हुई भाषा वाला उत्तर अच्छा स्कोर कर सकता है अगर वह संयोग से रेफरेंस के शब्दों का पुन: उपयोग कर दे।
गहरी समस्या यह है कि RAG पाइपलाइन 2 अलग जगहों पर फेल हो सकती है: रिट्रीवर गलत जानकारी चुन सकता है, या जनरेटर अच्छी जानकारी को नज़रअंदाज़ करके तथ्य गढ़ सकता है। जब कोई उत्तर गलत होता है, तो आपको जानना होता है कि इनमें से क्या हुआ:
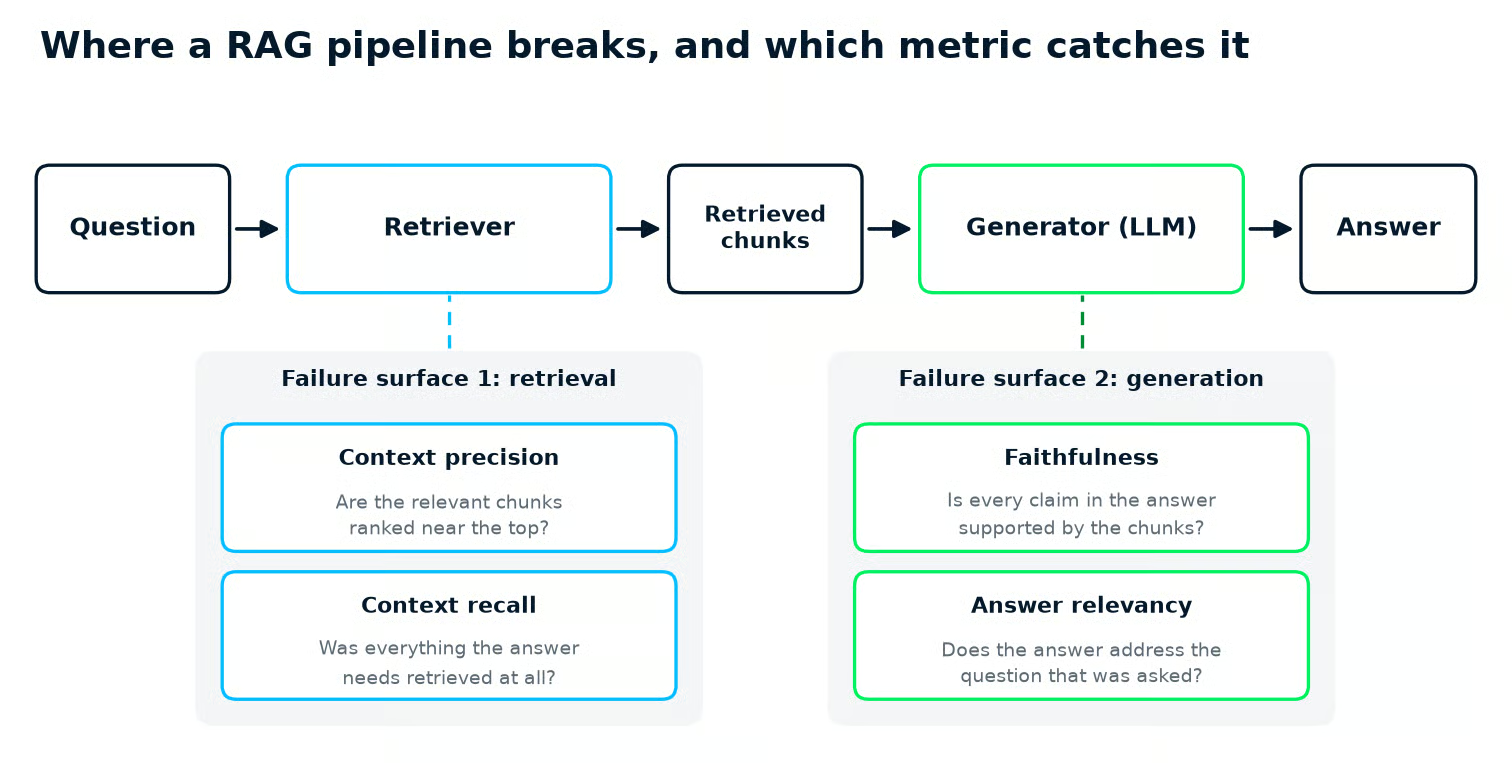
RAG पाइपलाइन के 2 फेल्योर मोड: context precision और recall रिट्रीवर का निदान करते हैं, जबकि faithfulness और answer relevancy जनरेटर का। चित्र: लेखक द्वारा।
हमारा What Is Retrieval Augmented Generation (RAG)? A Complete Guide उन पाइपलाइन चरणों से होकर गुजरता है जहाँ ये विफलताएँ जन्म लेती हैं।
Ragas एक ओपन-सोर्स Python फ्रेमवर्क है जो पाइपलाइन के हर हिस्से के लिए आपको एक नंबर देता है। यह अकेला विकल्प नहीं है। 2 मुख्य विकल्प हैं DeepEval, जो pytest-स्टाइल टेस्ट केसों में मूल्यांकन को लपेटता है, और Evidently, जो LLM जाँचों को डेटासेट की अतिरिक्त कॉलम के रूप में जोड़ता है और उन्हें मॉनिटरिंग रिपोर्ट्स में फीड करता है।
| Framework | Best for | RAG-specific metrics built in | Test data from your documents | Config style |
|---|---|---|---|---|
| Ragas | RAG पाइपलाइनों का निदान | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (ओपन सोर्स) |
मेट्रिक ऑब्जेक्ट्स और llm_factory() से जज |
| DeepEval | CI में यूनिट-टेस्ट-स्टाइल LLM टेस्टिंग | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (ओपन सोर्स) |
LLMTestCase ऑब्जेक्ट्स, assert_test() को deepeval test run से चलाना |
| Evidently | मॉनिटरिंग डैशबोर्ड और समय के साथ ड्रिफ्ट | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Evidently Cloud में RAG डेटासेट जनरेशन | Dataset पर डेस्क्रिप्टर्स, जिन्हें एक Report समरी करता है |
मैंने इस ट्यूटोरियल के लिए Ragas चुना क्योंकि इसके 4 मुख्य मेट्रिक्स साफ-साफ रिट्रीवर स्कोर और जनरेटर स्कोर में बंटते हैं, और इसका टेस्ट सेट जनरेटर उसी ओपन-सोर्स पैकेज में आता है।
यदि आपकी टीम पहले से pytest में रहती है, तो DeepEval का assert_test() ज़्यादा स्वाभाविक लगेगा। यदि आप लाइव ट्रैफिक क्वालिटी का डैशबोर्ड चाहते हैं, तो Evidently की रिपोर्ट आपको वहाँ तेज़ी से पहुँचा देती हैं।
Ragas सेट करने का मतलब है पैकेज इंस्टॉल करना, एक डिपेंडेंसी पिन करना, और एक जज LLM चुनना जिसे हर मेट्रिक शेयर करे। मैं uv का उपयोग करूंगा क्योंकि यह आपके लिए पैकेज वर्ज़न लॉक कर देता है, लेकिन वही वर्ज़न के साथ pip install भी काम करता है।
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
मैं यहाँ Python 3.12 उपयोग कर रहा हूँ। Ragas 0.4.3 Python 3.9 और नए वर्ज़न को सपोर्ट बताता है।
rapidfuzz पैकेज आगे लेख में आने वाले सिंथेटिक टेस्ट सेट जनरेटर के लिए चाहिए। Ragas इसे डिपेंडेंसी के रूप में डिक्लेयर नहीं करता, इसलिए मैं इसे पहले से इंस्टॉल कर देता हूँ।
langchain-community<0.4 पिन फिलहाल वैकल्पिक नहीं है। Ragas 0.4.3 ChatVertexAI को ऐसे मॉड्यूल पथ से इम्पोर्ट करता है जिसे langchain-community 0.4 ने हटा दिया, इसलिए बिना पिन के नई इंस्टॉलेशन में ragas इम्पोर्ट करते समय फेल हो जाता है।
अब जज। Ragas में हर LLM-आधारित मेट्रिक जज मॉडल को 1 या अधिक कॉल करता है, इसलिए आप उसे एक बार बनाते हैं और हर जगह पास करते हैं। मैं इसे अलग मॉड्यूल judge.py में रखता हूँ और कुंजी एनवायरनमेंट से पढ़ता हूँ ताकि कोई क्रेडेंशियल git में न जाए।
यह फ़ाइल दिखाती है कि OpenAI को सीधे कैसे कॉल करें, या Google के OpenAI-कंपैटिबल एंडपॉइंट के ज़रिये Gemini को कैसे।
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
उस फ़ाइल में 2 बातें आपकी पहली रन में अटका सकती हैं:
llm_factory() को एक client ऑब्जेक्ट चाहिए; केवल मॉडल नाम पास करने पर एरर आता है।llm_factory() को दिए गए कोई भी अतिरिक्त सेटिंग्स सीधे मॉडल कॉल तक जाती हैं—यहीं मैं max_tokens को 1,024 डिफॉल्ट से ऊपर बढ़ाता हूँ।सबसे सस्ता मॉडल लें जो आपके हाथ से चेक किए हुए सैंपल पर स्थिर स्कोर दे, और फिर उसे पिन कर दें। बड़े मूल्यांकन सूट पर वॉल्यूम तेज़ी से बढ़ता है: faithfulness हर सैंपल पर 2 जज कॉल करता है, answer relevancy 3 जज कॉल और 2 एम्बेडिंग कॉल, context precision रिट्रीव हुए हर chunk पर 1, और context recall 1 कॉल।
4 मेट्रिक्स में 6 सैंपल्स पर एक रन में 62 रिक्वेस्ट हुईं: 50 जज कॉल और 12 एम्बेडिंग कॉल। 19 अक्टूबर 2026 को प्रत्येक वेंडर के लिस्ट प्राइस पर 3 मौजूदा छोटे जज मॉडलों की लागत का मोटा अंदाज़ा यह है:
| Judge model | Input per 1M tokens | Output per 1M tokens | Source |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API pricing |
| claude-haiku-5-5 | $0.10 (prompts up to 100K tokens) | $0.50 (prompts up to 100K tokens) | Claude API pricing |
judge.py में डिफॉल्ट अब भी gpt-4o-mini है—OpenAI का पुराना मॉडल जो उनकी प्राइसिंग पेज की मुख्य तालिका में सूचीबद्ध नहीं है। बदलने के लिए JUDGE_MODEL वैरिएबल सेट करें।
यदि आप Claude को जज बनाना चाहते हैं तो एक अड़चन: answer relevancy को एम्बेडिंग मॉडल भी चाहिए, और Anthropic एम्बेडिंग मॉडल नहीं देता। इसके डॉक्यूमेंट्स Voyage AI की ओर इशारा करते हैं, इसलिए आप Claude को किसी दूसरे प्रोवाइडर की एम्बेडिंग्स के साथ पेयर करेंगे।
चॉइस से ज़्यादा मायने पिनिंग का है। जज मॉडल बदलने से स्कोर शिफ्ट हो जाते हैं भले आपकी पाइपलाइन न बदले—यह उस ट्रेंड लाइन को बिगाड़ देता है जिसे आप ट्रैकिंग सेक्शन में बनाने वाले हैं।
मॉडल का नाम judge.py में वर्ज़न कंट्रोल के तहत रखें और जज अपग्रेड को किसी ब्रेकिंग चेंज जैसा समझें: हर थ्रेशहोल्ड को नए जज के स्कोर के हिसाब से रीसेट करें।
डेटासेट में हर टेस्ट केस को sample कहा जाता है। एक sample केवल उत्तर नहीं होता: यह चार फ़ील्ड में पाइपलाइन की एक पूरी यात्रा दर्ज करता है:
| Field | यह क्या रखता है |
|---|---|
user_input |
ग्राहक ने जो सवाल पूछा |
retrieved_contexts |
उस सवाल के लिए रिट्रीवर ने जो चंक्स लौटाए |
response |
RAG पाइपलाइन ने जो उत्तर दिया |
reference |
सही उत्तर, किसी इंसान द्वारा लिखा हुआ |
Ragas हर sample को SingleTurnSample और पूरी सेट को EvaluationDataset के रूप में स्टोर करता है। reference वैकल्पिक है, लेकिन retrieval मेट्रिक्स इसका उपयोग करते हैं, इसलिए मैं क्यूरेटेड सेट में इसे हमेशा शामिल करता हूँ, भले रेफरेंस-फ्री मेट्रिक्स इसे इग्नोर करें।
मैंने एक काल्पनिक कॉफी रोस्टर, Northwind Coffee, के लिए 6 सैंपल बनाए। नीचे हर मेट्रिक सेक्शन उस सैंपल को जोड़ता है जिसे वह मेट्रिक पकड़ना चाहिए।
build_dataset.py को पहले 3 सैंपल्स से शुरू करें: एक साफ उत्तर, एक जानबूझकर की गई hallucination, और एक दूसरा साफ उत्तर जो एक साथ कई दावे करता है।
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
हर रिट्रीव्ड कॉन्टेक्स्ट Northwind के हेल्प-सेंटर पेजों का एक chunk है, ठीक उसी तरह लिखा जैसा कोई रिट्रीवर जनरेटर को देगा। uv run python build_dataset.py चलाएँ ताकि eval_dataset.jsonl और eval_questions.jsonl लिखे जाएँ, और जब भी आगे के सेक्शन में कोई sample जुड़ता है, इसे फिर चलाएँ।
JSON Lines में सेव करना इसलिए अहम है क्योंकि आगे के हर स्क्रिप्ट (मेट्रिक रन, CI गेट) वही eval_dataset.jsonl EvaluationDataset.from_jsonl() से लोड करते हैं।
किसी वास्तविक प्रोजेक्ट में retrieved_contexts और response फ़ील्ड आपके असली पाइपलाइन को सवालों पर चलाने से आते हैं, और केवल user_input व reference हाथ से लिखे जाते हैं। CI सेक्शन दिखाता है कि वह कदम कैसे ऑटोमेट करें।
इस लेख के 6 सैंपल्स मेट्रिक्स सीखने के लिए काफी हैं, भरोसेमंद थ्रेशहोल्ड के लिए नहीं। उस पर भरोसा करने से पहले लगभग 100 सैंपल्स का लक्ष्य रखें; ट्रैकिंग सेक्शन बताएगा क्यों। कितने चाहिए यह आपके उपयोग-केस की सख्ती पर निर्भर करता है, इसलिए मैं किसी खास संख्या के बजाय अच्छे मिश्रण पर ज़ोर देता हूँ:
4 मुख्य Ragas मेट्रिक्स हैं: जनरेटर के लिए faithfulness और answer relevancy, और रिट्रीवर के लिए context precision और context recall। सभी 0 से 1 के बीच स्कोर लौटाते हैं। काम की बात यह है कि हर संख्या आपको क्या सुधारना है, यह बताती है।
Faithfulness मापता है कि उत्तर का कितना हिस्सा रिट्रीव किए गए चंक्स से समर्थित है। जज उत्तर को व्यक्तिगत दावों में विभाजित करता है, फिर हर दावे को चंक्स के साथ मिलाता है: 1.0 का मतलब हर दावा समर्थित है, 0.0 का मतलब कोई नहीं।
Faithfulness को रेफरेंस उत्तर की ज़रूरत नहीं होती, इसलिए आप इसे लाइव प्रोडक्शन ट्रैफिक पर भी चला सकते हैं, न कि केवल अपने टेस्ट सेट पर। जब भी आप प्रॉम्प्ट, मॉडल, या मॉडल को दिखने वाले कॉन्टेक्स्ट की मात्रा बदलें, इसे फिर चलाएँ—क्योंकि यहीं से hallucinations सबसे ज़्यादा आती हैं।
इसे कार्रवाई में सबसे तेज़ देखने का तरीका है एक अकेले उत्तर पर स्कोर करना, किसी डेटासेट की ज़रूरत नहीं:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
uv run python quick_check.py से चलाएँ और यह faithfulness = 0.00 प्रिंट करता है, क्योंकि उत्तर के दोनों दावे (6 महीने, फ्री बैग) कॉन्टेक्स्ट से समर्थित नहीं हैं। 0.4 में आप हर मेट्रिक के ascore() मेथड से स्कोर करते हैं, जो एक रिजल्ट लौटाता है जिसका .value स्कोर होता है।
अब तक के डेटासेट पर स्कोर करने पर, सैंपल 2 में रखी गई hallucination 0.0 पाती है, जैसा कि होना चाहिए, और दोनों साफ सैंपल 1.0 पाते हैं। हर मेट्रिक के पूरे नतीजे नीचे मल्टी-मेट्रिक सेक्शन में हैं।
Answer relevancy देखती है कि उत्तर वास्तव में पूछे गए सवाल को संबोधित करता है या नहीं। जज उत्तर पढ़ता है और 3 सवाल लिखता है जिनका वह उत्तर अच्छा होगा, फिर Ragas एम्बेडिंग मॉडल से देखता है कि उनका अर्थ मूल सवाल के कितना करीब है। यदि उत्तर सवाल को टालता है, तो जज उसे noncommittal मार्क करता है और स्कोर 0 होता है।
Ragas इस क्लास को AnswerRelevancy कहता है (पुराने उदाहरण इसे ResponseRelevancy कहते हैं, और डॉक्यूमेंटेशन पेज का शीर्षक भी Response Relevancy है), और इसे जज LLM और एम्बेडिंग मॉडल दोनों चाहिए।
उच्च faithfulness और कम relevancy आमतौर पर जनरेटर या प्रॉम्प्ट की ओर इशारा करता है: मॉडल के पास सही कॉन्टेक्स्ट था और वह उसमें grounded रहा, लेकिन उसने पूछे गए सवाल से अलग सवाल का उत्तर दे दिया। पहले context precision और recall जाँचें, क्योंकि ऑफ-टॉपिक चंक्स लौटाने वाला रिट्रीवर भी यही पैटर्न बना सकता है।
यह सैंपल जनरेटर वाले केस को दिखाता है। रिट्रीवर सही shipping chunk लौटाता है, उत्तर grounded रहता है, और वह शिपिंग लागत की बजाय रोस्ट डेट्स पर बात करता है। नए chunk को build_dataset.py के शीर्ष पर चंक्स में जोड़ें:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
फिर नए सैंपल को samples सूची के अंत में जोड़ें:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
हर सैंपल को एक relevancy स्कोर मिलता है: जज द्वारा उत्तर से लिखे गए सवाल मूल सवाल के अर्थ से कितने मेल खाते हैं, जहाँ 1.0 एकदम सटीक मेल है।
Context precision जाँचती है कि उपयोगी चंक्स रिट्रीवर द्वारा लौटाई सूची में ऊपर की पोज़ीशन में हैं या नहीं, और context recall जाँचती है कि सही उत्तर लिखने के लिए जो कुछ चाहिए था वह सब रिट्रीवर ने ढूँढ़ा या नहीं।
Precision उच्च रैंक वाले उपयोगी chunk को ज़्यादा क्रेडिट देती है, इसलिए पहला स्थान तीसरे से अधिक गिना जाता है। Recall वह अंश है जितने तथ्यों को रेफरेंस उत्तर में कहा गया है जिन्हें कम-से-कम एक रिट्रीव्ड chunk सपोर्ट करता है।
दोनों को reference फ़ील्ड चाहिए। कलेक्शंस API में क्लासेस ContextPrecisionWithReference और ContextRecall हैं, और दोनों केवल जज LLM लेते हैं। Ragas डॉक्यूमेंटेशन रेफरेंस-आधारित वर्शन के लिए छोटा नाम ContextPrecision भी उपयोग करता है, इसलिए आप दोनों देखें।
अब तक हर सैंपल सही चंक्स पहले ला रहा है, इसलिए किसी के पास पकड़ने के लिए कुछ नहीं। चलिए 2 सैंपल जोड़ते हैं जो रिट्रीवल को अलग-अलग तरीकों से तोड़ते हैं: एक जिसमें सही chunk तो रिट्रीव होता है पर आख़िर में रैंक होता है, और एक जिसमें कुछ भी प्रासंगिक रिट्रीव नहीं होता, इसलिए मॉडल सही तरह से मना कर देता है। पहले की तरह, चंक्स फ़ाइल के ऊपर जोड़ें:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
फिर सैंपल्स को सूची के अंत में जोड़ें:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
रैंकिंग इसलिए मायने रखती है क्योंकि ज़्यादातर पाइपलाइनें केवल टॉप कुछ चंक्स मॉडल तक पास करती हैं, इसलिए टॉप-5 रिट्रीवर में 6वें स्थान का उपयोगी chunk तो मानो अस्तित्व में ही नहीं।
सैंपल 5 में एकमात्र उपयोगी chunk 3 में आख़िर में है, और precision 0.333 आती है क्योंकि अकेली उपयोगी जानकारी सबसे नीचे रैंक है। सैंपल 6, रिट्रीवल मिस, ने precision और recall दोनों में 0.0 स्कोर किया।
सैंपल 6 faithfulness के बारे में भी सिखाता है। मॉडल ने सही तरह से मना किया, फिर भी कुछ रन में वह मना करना 1.0 और कुछ में 0.0 स्कोर हुआ—बिना कुछ बदले। “मेरे पास वारंटी की सूचना नहीं है” जैसा कथन न तो कॉन्टेक्स्ट द्वारा समर्थित होता है, न खंडित—और जज उस पर सिक्का उछाल देता है।
यदि आपकी पाइपलाइन को मना करना चाहिए, तो मना करने वाले जवाबों को अलग स्कोर करें ताकि वे faithfulness को इधर-उधर न करें। Ragas 0.4 ने कलेक्शंस API से AspectCritic हटा दिया, इसलिए विकल्प है @discrete_metric डेकोरेटर से बना कस्टम चेक (देखें v0.3 से v0.4 माइग्रेशन गाइड)।
दोनों रिट्रीवल नंबरों को एक साथ पढ़ें और वे आपको बताते हैं कि अगला हफ्ता कहाँ लगाना है:
| Context precision | Context recall | निदान | क्या बदलें |
|---|---|---|---|
| उच्च | उच्च | रिट्रीवल स्वस्थ है | जनरेटर पर ध्यान दें: प्रॉम्प्ट, मॉडल, faithfulness |
| निम्न | उच्च | सही चंक्स रिट्रीव हुए पर खराब रैंक | कोई री-रैंकर जोड़ें या ट्यून करें |
| उच्च | निम्न | टॉप चंक्स प्रासंगिक हैं पर अधूरे | मॉडल तक अधिक चंक्स पास करें, बड़े चंक्स लें, या चंक-स्प्लिटिंग जाँचें |
| निम्न | निम्न | रिट्रीवर व्यापक रूप से फेल | एम्बेडिंग्स, इंडेक्सिंग, और क्वेरी री-राइटिंग दोबारा देखें |
“कम precision, उच्च recall” वाली पंक्ति मुझे व्यवहार में सबसे आम दिखती है—और इसे ठीक करना सबसे सस्ता है।
हमारा RankGPT as a Re-Ranking Agent for RAG ट्यूटोरियल मौजूदा रिट्रीवर पर एक LLM री-रैंकर जोड़ता है, और Boost LLM Accuracy with RAG and Reranking ट्यूटोरियल एक और री-रैंकिंग सेटअप दिखाता है। RAG प्रदर्शन सुधारने की 5 प्रमुख तकनीकें गाइड अन्य पंक्तियों के लिए चंकिंग और क्वेरी री-राइटिंग कवर करता है।
हर बदलाव के बाद 2 रिट्रीवल मेट्रिक्स फिर चलाएँ और तालिका बताएगी कि यह काम किया या नहीं।
पूरा मल्टी-मेट्रिक मूल्यांकन सभी 4 मेट्रिक्स को हर सैंपल पर समानांतर में चलाता है और स्कोर इकट्ठा करता है—विफलताओं में ड्रिल-डाउन के लिए प्रति-रो मान और आपके डैशबोर्ड के लिए कॉलम के औसत।
Ragas 0.2 और 0.3 में आप यह evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)) से करते थे। 0.4.3 में वह फ़ंक्शन अब भी मौजूद है, पर यह चेतावनी देता है कि यह डिप्रिकेटेड है और नए मेट्रिक्स को ठुकरा देता है, क्योंकि अब वे पुराने Metric क्लास से इनहेरिट नहीं करते जिसकी उसे उम्मीद है।
विकल्प है @experiment डेकोरेटर, जो आपके पाइपलाइन और मेट्रिक्स को साथ में किसी Dataset पर चलाता है और CSV में नतीजे लिखता है। एक बार जब आपके पास कॉल करने को पाइपलाइन हो, तब यह सही टूल है।
स्टैटिक डेटासेट को स्कोर करने के लिए, मुझे एक छोटा हेल्पर साफ लगता है: यह हर स्क्रिप्ट के लिए 4 मेट्रिक्स एक बार बनाता है, और समानांतर कॉल और एरर हैंडलिंग को पठनीय कोड में रखता है:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
एक गैर-आसान लाइन है inspect.signature() कॉल। 4 मेट्रिक्स को अलग-अलग इनपुट चाहिए (faithfulness को response, recall को reference), इसलिए हेल्पर पढ़ता है कि हर मेट्रिक के ascore() को कौन-से आर्ग्युमेंट्स चाहिए और सैंपल से वही फ़ील्ड पास करता है—जिससे एक ही लूप हर मेट्रिक की सेवा कर सकता है।
सेमाफोर एक साथ चलने वाले जज कॉल की संख्या कैप करता है, और जो मेट्रिक फिर भी फेल होता है, वह पूरे रन को रोके बिना खाली (NaN) सेल बन जाता है। यदि आप इसे Jupyter नोटबुक में चलाते हैं, तो asyncio.run फेल होगा क्योंकि लूप पहले से चल रहा है। पहले nest_asyncio.apply() कॉल करें (Ragas उस पर निर्भर करता है) या coroutine को सीधे await करें।
हेल्पर के साथ, पूरा रन छोटा हो जाता है:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
यहाँ मेरे पहले रन के स्कोर हैं, faithfulness के आधार पर सॉर्टेड और 3 डेसिमल तक गोल, अंतिम पंक्ति में औसत के साथ:
| Question | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
उसी डेटासेट के बाद के रन faithfulness को और कम स्कोर कर गए, क्योंकि मना करने वाले सैंपल की flip मैंने ट्रैकिंग सेक्शन में कवर की है।
faithfulness के आधार पर सॉर्ट करना सबसे संभावित hallucinations निकालने में मदद करता है—और planted वाली सबसे ऊपर है। अंतिम पंक्ति में औसत आपके डैशबोर्ड नंबर हैं।
पंक्तियों को पार पढ़ें और हर planted फेल्योर अलग जगह दिखता है। hallucination केवल faithfulness गिराती है। रिट्रीवल मिस relevancy, precision और recall तीनों को एक साथ शून्य करती है। रैंकिंग समस्या precision को 0.333 पर काट देती है, और ड्रिफ्ट उत्तर दिए गए सवालों में से सबसे कम relevancy के रूप में दिखती है।
एक विचित्रता: Canada उत्तर पूरी तरह अपने chunk द्वारा समर्थित है, फिर भी इसे faithfulness पर 0.667 मिला। यह जज का शोर है, जिस पर मैं ट्रैकिंग सेक्शन में लौटता हूँ।
Answer relevancy अर्थ को एम्बेडिंग्स से कंपेयर करता है, इसलिए अच्छा उत्तर भी शायद ही 1.0 के पास स्कोर करे: रिफंड उत्तर 0.746 स्कोर करता है, जबकि ऑफ-टॉपिक shipping उत्तर 0.572। relevancy को सैंपल्स के बीच गैप और समय के साथ ट्रेंड से आँकें, एब्सोल्यूट नंबर से नहीं।
RAG क्वालिटी गेट एक टेस्ट स्क्रिप्ट है जो मूल्यांकन चलाती है, हर औसत स्कोर को एक थ्रेशहोल्ड से मिलाती है, और किसी भी मेट्रिक के कम पड़ने पर एरर कोड के साथ एग्ज़िट करती है—यही CI को मर्ज ब्लॉक करने को कहता है।
पहले एक कैच। पहले बनाया गया हाथ-से-तैयार डेटासेट अपने responses और retrieved chunks हाथ से लिखता है, इसलिए उसका स्कोर कभी भी आपके प्रॉम्प्ट या रिट्रीवर में बदलाव को नहीं दिखा सकता। CI में आपको सेव किए गए सवालों पर अपनी असली पाइपलाइन फिर चलानी होगी और फिर जो निकले उसे स्कोर करना होगा। इसके लिए 2 छोटे स्क्रिप्ट हैं।
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py एकमात्र फ़ाइल है जो आप स्वयं लिखेंगे: answer() के शरीर को अपने रिट्रीवर और जनरेटर की कॉल से बदलें। refresh_dataset.py build_dataset.py द्वारा सेव किए गए सवाल और रेफरेंस उत्तर पढ़ता है, हर सवाल पर पाइपलाइन चलाता है, और eval_dataset.jsonl फिर लिखता है।
स्वयं गेट एक थ्रेशहोल्ड डिक्शनरी और एक लूप है। नीचे दिए थ्रेशहोल्ड हाथ-से-तैयार उदाहरण डेटासेट पर कॅलिब्रेट किए गए थे, इसलिए अपने पाइपलाइन के आउटपुट पर इन्हें फिर कॅलिब्रेट करें।
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
मेरे बेसलाइन पर, 4ों औसत अपने-अपने थ्रेशहोल्ड पार करते हैं, और स्क्रिप्ट कोड 0 के साथ बाहर निकलती है—यानी मर्ज हो सकता है:
| मेट्रिक | औसत | थ्रेशहोल्ड | नतीजा |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer relevancy | 0.668 | 0.60 | Pass |
| Context precision | 0.722 | 0.65 | Pass |
| Context recall | 0.833 | 0.75 | Pass |
मैंने faithfulness थ्रेशहोल्ड 0.70 की बजाय 0.60 रखा क्योंकि जज शोर के कारण—जिसे मैं ट्रैकिंग सेक्शन में कवर करता हूँ। 6 सैंपल्स के साथ, एक फ्लेकी verdict औसत को 0.17 बदल देता है, और बदले बिना बाद के रन में 0.61 स्कोर आया। गेट जज को 3 बार चलाता है और औसत लेता है (GATE_RUNS), जो एकल फ्लिप को 3 गुना जज लागत पर स्मूद कर देता है।
एक डिज़ाइन चॉइस है not (actual >= threshold) पर फेल करना बजाय actual < threshold के। NaN से तुलना हमेशा False होती है, तो actual < threshold लिखी जाँच जज फेल होने पर बिल्ड पास कर देगी।
औसत में skipna=False आंशिक केस को कवर करता है। pandas डिफॉल्ट से NaN स्किप करता है, तो कुछ जज कॉल फेल होने पर सैंपल चुपचाप सिकुड़ जाएगा—गेट फेल नहीं होगा। अब कोई क्षणिक जज एरर बिल्ड फेल कर देता है, इसलिए डिबग से पहले जॉब फिर चलाएँ।
थ्रेशहोल्ड ट्यून करना पेचीदा होता है। उन्हें दुहराए गए रनों में देखे गए सबसे कम औसत से थोड़ा नीचे सेट करें, न कि किसी आकांक्षी 0.9 पर—वरना गेट हर पुल रिक्वेस्ट को ब्लॉक करेगा और टीम CI पर भरोसा करना छोड़ देगी। जब भी आप जज मॉडल बदलें या एक साथ कई सैंपल जोड़ें, उन्हें रीसेट करें।
GitHub Actions में इसे जोड़ना छोटा वर्कफ़्लो है। वर्कफ़्लो सिंटैक्स रेफरेंस on.pull_request पथ फ़िल्टर्स और यहाँ उपयोग किए schedule क्रोन को कवर करता है:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
उस वर्कफ़्लो में कुछ बातें अहम हैं:
JUDGE_MODEL और उसकी मिलती API कुंजी से पिन किया गया है। वही जज उपयोग करें जिससे आपने थ्रेशहोल्ड कॅलिब्रेट किए, वरना CI स्कोर आपकी हिस्ट्री से तुलनीय नहीं होंगे।GATE_SAMPLE 30 पंक्तियों के फिक्स्ड रैंडम सबसेट को स्कोर करता है, ताकि समीक्षा 10 मिनट के जज कॉल का इंतज़ार न करे। नाइटली क्रोन सब कुछ स्कोर करता है।scores.csv और ragas_history.jsonl को आर्टिफैक्ट के रूप में अपलोड करता है, क्योंकि जॉब खत्म होने पर रनर की डिस्क गायब हो जाती है।पूरा सूट नाइटली क्रोन पर चलाएँ, जहाँ कोई इंतज़ार नहीं कर रहा। फेल हुआ नाइटली रन एक फेल्ड वर्कफ़्लो की तरह दिखेगा, और GitHub की नोटिफिकेशन सेटिंग्स या कोई Slack स्टेप सुबह ओनर को बता सकता है। GitLab CI में भी rules: changes: और एक पाइपलाइन शेड्यूल के साथ यही ढांचा है।
Ragas आपके दस्तावेज़ पढ़कर, उनके मुख्य विषयों और तथ्यों को निकालकर, आपस में संबंधित चंक्स को जोड़कर, और फिर उन लिंक से अलग-अलग प्रकार के सवाल लिखकर सिंथेटिक टेस्ट सवाल जनरेट करता है।
टेस्ट डेटा जनरेशन डॉक्यूमेंट्स क्वेरियों को single-hop (एक chunk उत्तर दे सकता है) और multi-hop (सही उत्तर के लिए कई chunk चाहिए) में बाँटते हैं, और हर एक specific या abstract हो सकता है। डिफॉल्ट मिक्स इन 4 में से 3 को बराबर हिस्सों में उपयोग करता है:
Ragas केवल वे synthesizers उपयोग करता है जिन्हें आपके दस्तावेज़ सपोर्ट कर सकें, इसलिए छोटे दस्तावेज़ सेट से अलग मिक्स आ सकता है।
जनरेटर को वास्तविक दस्तावेज़ चाहिए। उसे अपने markdown डॉक्यूमेंटेशन की ओर पॉइंट करें। इस लेख के लिए, मैंने Northwind के 5 छोटे हेल्प-सेंटर पेज लिखे (कुल ~600 शब्द), और हर एक ऐसा दिखता है:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
आपके अपने दस्तावेज़ नीचे दिए सवालों से अलग सवाल बनाएँगे—और यही बात है: जनरेटर उसी पर सवाल लिखता है जो आपकी knowledge base में वास्तव में है।
TestsetGenerator वही जज LLM और एम्बेडिंग मॉडल लेता है जिन्हें हमने बनाया है। मैं LangChain के DirectoryLoader से डॉक्यूमेंट्स लोड करता हूँ, TextLoader को स्पष्ट रूप से उपयोग करके ताकि markdown फाइलें भारी unstructured डिपेंडेंसी न खींचें।
आपके डॉक्यूमेंट्स को मैप करना एक साथ कई जज कॉल चलाता है, इसलिए मैं RunConfig से समानांतर कॉल्स सीमित भी करता हूँ:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
स्क्रिप्ट सभी 5 डॉक्यूमेंट्स लोड करता है और ये 8 सवाल लिखता है। सवाल डॉक्यूमेंट्स का अनुसरण करते हैं, और कुछ में जानबूझकर टायपो हैं:
| # | जनरेट किया गया सवाल | सवाल का प्रकार |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
तालिका सरल लेबल दिखाती है; आउटपुट में synthesizer_name कॉलम पूरा synthesizer नाम रखता है। 5 डॉक्यूमेंट्स से 8 सवाल बनाने में लगभग 4.5 मिनट लगे।
टायपो और सवाल 2 में कीवर्ड-स्टाइल क्वेरी जानबूझकर हैं: जनरेटर हर क्वेरी की शैली और लंबाई बदलता है ताकि सेट एग्ज़ाम क्वेश्चन की बजाय सर्च-बॉक्स ट्रैफिक जैसा लगे।
आप शायद सवालों को देखकर तय करना चाहेंगे कि वे usable और प्रासंगिक हैं। मैं आउटपुट को फ़र्स्ट ड्राफ्ट की तरह लूंगा। हर सिंथेटिक सेट जिसकी मैंने समीक्षा की, उसमें कुछ सवाल खराब बने होते हैं (वो “the document” का संदर्भ देते हैं या किसी हेडिंग के बारे में पूछते हैं), कुछ रेफरेंस उत्तर स्रोत से drift कर जाते हैं, और भाषा किसी वास्तविक उपयोगकर्ता से ज़्यादा औपचारिक होती है।
जब आप डॉक्यूमेंट्स में कोई सेक्शन जोड़ते हैं, जनरेटर फिर चलाएँ और आपको नई सामग्री के लिए उम्मीदवार सवाल मिलते हैं—एक और राउंड जज कॉल्स की कीमत पर।
हर पंक्ति में एक user_input, जनरेट किया गया reference उत्तर, और reference_contexts होते हैं—वे चंक्स जिनसे सवाल बना है। reference को उन्हीं चंक्स के साथ मिलाएँ—यहीं drift दिखती है।
किसी reviewed पंक्ति को SingleTurnSample में बदलने के लिए, अपने पाइपलाइन को user_input पर चलाएँ ताकि retrieved_contexts और response मिलें। reviewed user_input और reference जोड़े eval_questions.jsonl में जोड़ें—refresh_dataset.py आपके लिए वही करता है।
यदि आपकी knowledge base ग्राफ है, दस्तावेज़ों का ढेर नहीं, तो सिद्धांत वही है—रिट्रीवर अलग। हमारा Using a Knowledge Graph to Implement a RAG Application ट्यूटोरियल और Graph RAG with LangChain and Neo4j कोर्स ऐसी पाइपलाइनें बनाते हैं जिन्हें आप ठीक इन्हीं 4 मेट्रिक्स से स्कोर कर सकते हैं—क्योंकि मेट्रिक्स केवल रिट्रीव किया गया टेक्स्ट पढ़ते हैं, यह नहीं कि उसे कैसे रिट्रीव किया गया।
Ragas स्कोर ट्रैक करने का मतलब है हर मूल्यांकन रन के बाद औसत स्कोर, git कमिट हैश, जज मॉडल, और टाइमस्टैम्प को एक लॉग फ़ाइल में जोड़ना—ताकि रिग्रेशन किसी लाइन चार्ट पर dip की तरह दिखे, प्रोडक्शन में सरप्राइज़ की तरह नहीं।
जब तक कई लोगों के लिए कोई साझा एक्सपेरिमेंट ट्रैकर न चाहिए, JSON Lines फ़ाइल शायद सबसे अच्छा दांव है। track_scores.py scores.csv पढ़ता है, जिसे quality_gate.py और run_all.py दोनों लिखते हैं—तो यह कभी दूसरी बार जज कॉल्स ट्रिगर नहीं करता।
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
uv run python track_scores.py चलाने पर लॉग में एक पंक्ति जुड़ती है और प्रिंट होती है:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
CI में हर जॉब खाली डिस्क से शुरू होता है, इसलिए ragas_history.jsonl केवल उसी रन का रिकॉर्ड रखता है। ट्रेंड रखने के लिए, अपलोड किए गए आर्टिफैक्ट्स डाउनलोड करें और उन्हें एक फ़ाइल में जोड़ते रहें, या फ़ाइल को किसी मेट्रिक्स ब्रांच या ऑब्जेक्ट स्टोरेज में कमिट करें।
हिस्ट्री को प्लॉट करना काफ़ी आसान है। यह स्क्रिप्ट आज़माएँ:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
आपको कुछ ऐसा चार्ट मिलेगा:
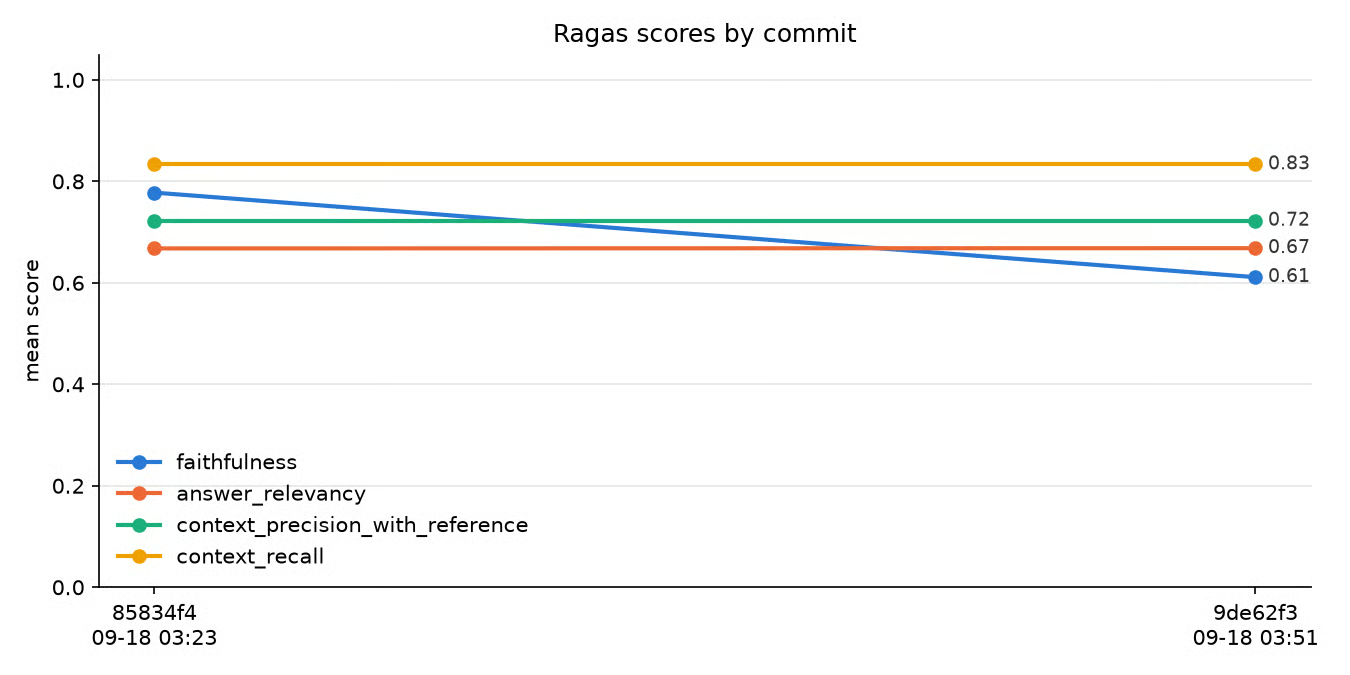
track_scores.py द्वारा प्रति कमिट लॉग किए गए औसत Ragas स्कोर। चित्र: लेखक द्वारा।
उन कमिट्स के बीच पाइपलाइन में कुछ नहीं बदला (दूसरे ने केवल जज क्लाइंट की कनेक्शन सेटिंग्स बदली), फिर भी faithfulness 0.78 से 0.61 पर गिर गया क्योंकि सैंपल 6 में मना करने वाला उत्तर 1.0 से 0.0 पर flip हो गया।
तो बड़े सैंपल काउंट तक वास्तविक जज शोर देखने को मिलता है। 6 सैंपल्स पर, 1 फ्लेकी verdict औसत को 0.17 हिलाता है। 100 सैंपल्स पर वही flip 0.01 हिलाता है—इसलिए बड़ा बदलाव वास्तविक रिग्रेशन होने की ज़्यादा संभावना है।
अब, हर पुल रिक्वेस्ट या कमिट के साथ, आप गेट चला सकते हैं, स्कोर लॉग कर सकते हैं, और चार्ट देख सकते हैं।
यदि आप बड़ा आर्किटेक्चरल बदलाव तौल रहे हैं, हमारा RAG बनाम फाइन-ट्यूनिंग ट्यूटोरियल फ़्रेम देता है—और दोनों रास्तों के पहले और बाद के माप के लिए यही 4 मेट्रिक्स काम करते हैं।
LLM-as-a-judge स्कोर अनुमान हैं: इनमें ज्ञात बायस होते हैं और रन-टू-रन बदल भी सकते हैं, लेकिन ये उस मूल्यांकन वॉल्यूम तक स्केल होते हैं जिसे मानव समीक्षा नहीं कर सकती।
Ragas कभी जज से 2 उत्तरों की तुलना नहीं कराता, इसलिए position bias (जो पहले आता है उसे तरजीह) अधिकांशतः लागू नहीं होता। verbosity bias (लंबे जवाबों को तरजीह) और self-preference bias (जज अपने ही मॉडल के जवाबों को तरजीह देते हैं) अब भी मायने रख सकते हैं। Zheng et al. (2023) तीनों बायस का वर्णन करते हैं, और self-preference यही वजह है कि मैं जनरेटर और जज के लिए एक ही मॉडल उपयोग नहीं करूँगा।
रन-टू-रन वेरिएशन वह हिस्सा है जिसे मैं चाहता हूँ आप अपनी आँखों से देखें—क्योंकि यह तय करता है कि थ्रेशहोल्ड कैसे सेट करें। एक ही 6 सैंपल्स पर, एक ही पिन किए जज के साथ, सैंपल 6 के मना करने वाले उत्तर को faithfulness पर एक रन में 0.0 और दूसरे में 1.0 मिला, और पूरी तरह grounded सैंपल 5 ने ऊपर दिखाए रन में 0.667 स्कोर किया।
सस्ते जज से प्रति-सैंपल स्कोर शोरयुक्त होते हैं। 100 सैंपल्स पर औसत कहीं कम शोरयुक्त होते हैं—और CI गेट को हमेशा औसत ही जाँचना चाहिए।
तीन अभ्यास शोर को सीमित करते हैं:
judge.py और track_scores.py करते हैं—ताकि जज का बदलाव कभी पाइपलाइन बदलाव समझ में न आए।RAG से आगे के मूल्यांकन तरीकों के लिए, जिनमें वही मानव मूल्यांकन पद्धतियाँ शामिल हैं जिनकी जगह जज ले रहा है, हमारा LLM मूल्यांकन गाइड मेट्रिक्स और मेथडोलॉजी कवर करता है। हमारा LLM as a judge ट्यूटोरियल RAG पाइपलाइनों के लिए जज बनाने पर और गहराई से जाता है।
इस पाइपलाइन का मक़सद यह है कि हम “रिट्रीवर ठीक है, प्रॉम्प्ट रिग्रेस हो गया” या “री-रैंकर ने precision सुधारी पर recall अब भी 0.6 है” जैसी बातें कह सकें—दावों के पीछे संख्याओं के साथ।
Faithfulness और answer relevancy जनरेटर पर नज़र रखते हैं: faithfulness गढ़े हुए तथ्यों को पकड़ता है, और answer relevancy उन जवाबों को पकड़ता है जो सवाल से भटक जाते हैं। Context precision और recall रिट्रीवर पर नज़र रखते हैं और बताते हैं कि वह सही जानकारी खींचता है या नहीं। क्योंकि 4 में से 2 को रेफरेंस उत्तर नहीं चाहिए, आप उन्हें प्रोडक्शन ट्रैफिक पर भी चला सकते हैं जहाँ कोई रेफरेंस होता ही नहीं।
मानक टेक्स्ट मेट्रिक्स शब्द-ओवरलैप मापते हैं—जो किसी गढ़ी हुई रिफंड पॉलिसी के बारे में कुछ नहीं कहते—और एक अकेला एंड-टू-एंड नंबर यह छुपा देता है कि पाइपलाइन का कौन-सा आधा टूटा। कोई ऐसा फ्रेमवर्क जो 2 फेल्योर प्वाइंट्स को अलग-अलग जाँचता है, वह इसे देख सकता है—और इसे एक बार के ऑडिट से CI गेट और हिस्ट्री फ़ाइल में बदल देना वही है जो आपकी टीम को संख्याओं पर कार्रवाई करने तक ले जाता है।
यदि आपने अभी पाइपलाइन नहीं बनाई, तो हमारे Retrieval-Augmented Generation with LangChain कोर्स से शुरू करें और फिर इस लेख के pipeline.py को आपने जो बनाया है उसकी ओर पॉइंट करें।
टेक्स्ट रिट्रीवल से आगे जाने वाली पाइपलाइनों के लिए, हमारा End-to-End RAG with Weaviate कोर्स, हमारा मल्टीमॉडल RAG गाइड, और हमारा एजेंटिक RAG ट्यूटोरियल ऐसे सिस्टम बनाते हैं जिन्हें आप इसी तरह स्कोर कर सकते हैं—एक caveat के साथ: 4 मुख्य मेट्रिक्स केवल टेक्स्ट पढ़ते हैं। इमेजेस रिट्रीव करने वाली पाइपलाइन को Ragas के अलग मल्टीमॉडल मेट्रिक्स चाहिए, और एजेंटिक पाइपलाइन में हर रिट्रीवल स्टेप को अपने अलग सवाल, chunks, और उत्तर की तरह स्कोर करना होगा।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स