
Cursus
Graph RAG met LangChain en Neo4j
3 uur
2.3K
Een retrieval-augmented generation (RAG)‑pijplijn voor een chatbot slaagt voor elke rooktest in het notebook. Dan komen de supporttickets binnen over foute of vreemde antwoorden, en niets in de rooktestlogs steekt als een rode vlag uit.
Die fout is lastig te vangen omdat hij onzichtbaar is zonder metriek. Een RAG‑pijplijn kan op 2 plekken misgaan: de retriever kan de verkeerde chunks ophalen, of de generator kan goede chunks negeren en feiten verzinnen. Eén end‑to‑end nauwkeurigheidsgetal kan je niet vertellen welke van de twee het was, en dus ook niet wat je moet fixen.
In deze tutorial bouw ik in Python een complete RAG‑evaluatiepijplijn met Ragas 0.4.3: een handgemaakt evaluatiedataset, de 4 kernmetriek (faithfulness, answer relevancy, context precision en context recall), een continuous‑integration‑kwaliteitshek (CI) dat de build laat falen wanneer scores dalen, een generator voor synthetische testsets, en een JSON Lines‑scoretracker.
Wil je eerst meer achtergrond? Zie dan onze gids over wat RAG is, onze tutorial over het gebruiken van een large language model (LLM) als scheidsrechter om RAG‑pijplijnen te evalueren, en ons overzicht van geavanceerde RAG‑technieken.
Je hebt Python 3.9 of nieuwer nodig (ik gebruik 3.12), uv of pip, een API‑sleutel voor een OpenAI‑compatibel judge‑model, en globaal begrip van hoe een RAG‑pijplijn werkt. Wil je eerst die basis, dan raad ik onze cursus Retrieval-Augmented Generation met LangChain aan, die het type pijplijn opzet dat we gaan scoren.
Tekstoverlapmetriek zoals BLEU (Bilingual Evaluation Understudy) en ROUGE (Recall-Oriented Understudy for Gisting Evaluation) zijn de verkeerde meetlat voor RAG. Ragas gebruikt in plaats daarvan een judge‑LLM om elk antwoord op 4 assen te scoren: faithfulness en answer relevancy diagnosticeren de generator, terwijl context precision en context recall de retriever diagnosticeren.
Zet die 4 cijfers achter een drempel in CI en log ze per commit, en je hebt een regressiealarm in plaats van een eenmalige audit.
Eén waarschuwing vooraf. De Ragas‑API is 2 keer veranderd in 2 jaar: v0.2 verving dictionary‑datasets door SingleTurnSample en EvaluationDataset, en v0.4 maakte de collections‑metriek (ingevoerd in v0.3.9) de standaard en markeerde de oude evaluate()‑functie als verouderd.
De meeste tutorials online laten nog v0.1‑ of v0.2‑code zien. Alles hieronder draait op 0.4.3, de huidige release in oktober 2026.
RAG heeft eigen metriek nodig omdat klassieke tekstmetriek alleen tellen hoeveel woorden een antwoord deelt met een referentieantwoord, en gedeelde bewoording is niet wat breekt in een RAG‑systeem.
BLEU (Papineni et al., 2002) en ROUGE (Lin, 2004) zijn gebouwd voor vertalen en samenvatten, waar een goede output grotendeels dezelfde woorden gebruikt als de referentie. Een RAG‑antwoord dat “je hebt 2 weken” zegt in plaats van “14 dagen” scoort slecht op beide, terwijl een vloeiend antwoord dat een restitutiebeleid verzint toch goed kan scoren als het toevallig woorden van de referentie hergebruikt.
Het diepere probleem is dat een RAG‑pijplijn op 2 afzonderlijke plekken kan falen: de retriever kan de verkeerde informatie kiezen, of de generator kan goede informatie negeren en feiten verzinnen. Als een antwoord fout is, moet je weten welk van deze gebeurde:
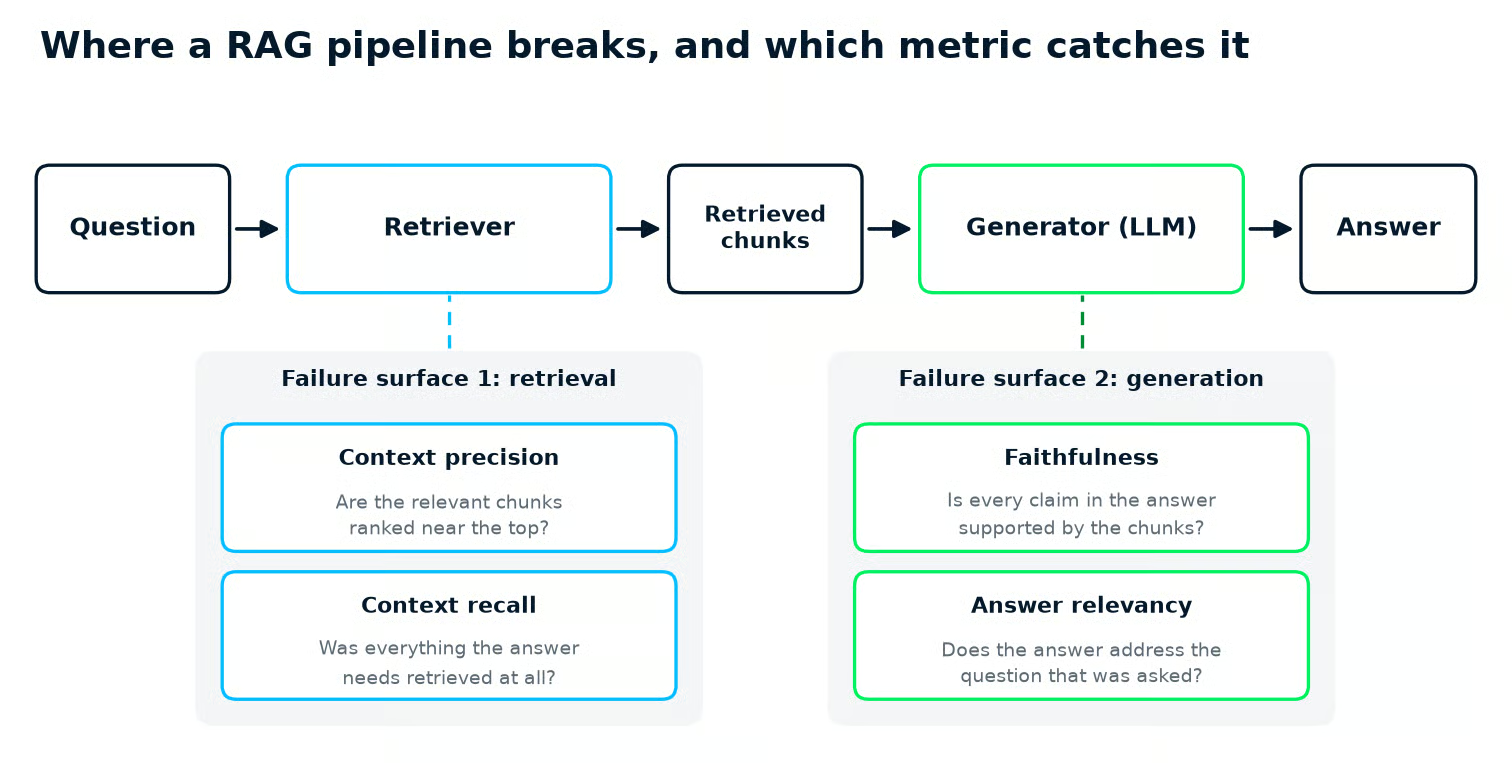
De 2 faalmodi van een RAG‑pijplijn: context precision en recall diagnosticeren de retriever, terwijl faithfulness en answer relevancy de generator diagnosticeren. Afbeelding door de auteur.
Onze What Is Retrieval Augmented Generation (RAG)? A Complete Guide loopt door de pijplijnstappen waar die fouten ontstaan.
Ragas is een open‑source Pythonframework dat je een getal geeft voor elk deel van de pijplijn. Het is niet de enige optie. De 2 belangrijkste alternatieven zijn DeepEval, dat evaluatie in pytest‑achtige testcases verpakt, en Evidently, dat LLM‑checks als extra kolommen op een dataset zet en in monitorrapporten voedt.
| Framework | Beste voor | RAG‑specifieke metriek ingebouwd | Testdata uit je documenten | Configstijl |
|---|---|---|---|---|
| Ragas | Diagnostiek van RAG‑pijplijnen | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Metriekobjecten plus een judge uit llm_factory() |
| DeepEval | Unit‑test‑achtige LLM‑tests in CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
LLMTestCase‑objecten, assert_test() gedraaid via deepeval test run |
| Evidently | Monitoringdashboards en drift door de tijd | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | RAG‑datasetgeneratie in Evidently Cloud | Descriptors op een Dataset, samengevat door een Report |
Ik koos Ragas voor deze tutorial omdat de 4 kernmetriek netjes splitsen in retriever‑scores en generator‑scores, en omdat de testsetgenerator in hetzelfde open‑sourcepakket zit.
Als je team al in pytest leeft, voelt DeepEval’s assert_test() natuurlijker. Wil je vooral een dashboard van live verkeerskwaliteit, dan brengen Evidently’s rapporten je daar sneller.
Ragas opzetten betekent het pakket installeren, één dependency pinnen en een judge‑LLM kiezen die elke metriek deelt. Ik gebruik uv omdat het exacte pakketversies voor je lockt, maar pip install met dezelfde versies werkt ook.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Ik gebruik hier Python 3.12. Ragas 0.4.3 ondersteunt officieel Python 3.9 en nieuwer.
Het pakket rapidfuzz is nodig voor de synthetische testsetgenerator later in het artikel. Ragas declareert het niet als dependency, dus ik installeer het vooraf.
De pin langchain-community<0.4 is niet optioneel op het moment van schrijven. Ragas 0.4.3 importeert ChatVertexAI uit een modulepad dat in langchain-community 0.4 is verwijderd, dus een schone installatie zonder pin faalt zodra je ragas importeert.
Dan de judge. Elke LLM‑gebaseerde metriek in Ragas doet 1 of meer aanroepen naar een judge‑model, dus je bouwt die één keer en geeft hem overal door. Ik bewaar dat in een eigen module, judge.py, en lees de sleutel uit de omgeving zodat er geen credential in git belandt.
Dit bestand laat zien hoe je OpenAI direct aanroept of Gemini via Google’s OpenAI‑compatibele endpoint.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Twee details in dat bestand kunnen je eerste run laten struikelen:
llm_factory() in 0.4 heeft een clientobject nodig; alleen een modelnaam doorgeven geeft een fout.llm_factory() meegeeft gaan rechtstreeks de modelcall in; zo verhoog ik max_tokens boven de standaard 1.024.Gebruik het goedkoopste model dat stabiele scores geeft op een sample dat je handmatig hebt gecheckt, en pin het dan. Voor een grote evaluatiesuite tikt het volume snel aan: faithfulness doet 2 judge‑calls per sample, answer relevancy 3 plus 2 embedding‑calls, context precision 1 per opgehaalde chunk, en context recall 1.
Zes samples over 4 metriek kwamen uit op 62 requests in één run: 50 judge‑calls plus 12 embedding‑calls. Dit kostten 3 huidige kleine judge‑modellen bij elke aanbieder op 19 oktober 2026:
| Judge‑model | Input per 1M tokens | Output per 1M tokens | Bron |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI‑prijzen |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API‑prijzen |
| claude-haiku-5-5 | $0.10 (prompts tot 100K tokens) | $0.50 (prompts tot 100K tokens) | Claude API‑prijzen |
De default in judge.py is nog steeds gpt-4o-mini, een ouder OpenAI‑model dat niet in de hoofdprijstabel op OpenAI’s prijspagina staat. Zet de variabele JUDGE_MODEL om te wisselen.
Eén addertje als je Claude als judge wilt: answer relevancy heeft ook een embedding‑model nodig en Anthropic biedt er geen. De docs verwijzen naar Voyage AI, dus je zou Claude combineren met embeddings van een andere provider.
Pinnen is belangrijker dan de keuze. Het wisselen van judge‑model verschuift scores zelfs als je pijplijn niet veranderde, wat de trendlijn die je zo gaat bouwen in de war stuurt.
Zet de modelnaam in judge.py onder versiebeheer en behandel een judge‑upgrade als elke andere breaking change: reset elke drempel tegen de scores van de nieuwe judge.
Elke testcase in de dataset heet een sample. Een sample is meer dan een antwoord: het legt één volledige rit door de pijplijn vast, in 4 velden:
| Veld | Wat het bevat |
|---|---|
user_input |
De vraag die de klant stelde |
retrieved_contexts |
De chunks die de retriever voor die vraag teruggaf |
response |
Het antwoord dat de RAG‑pijplijn gaf |
reference |
Het juiste antwoord, geschreven door een persoon |
Ragas slaat elk sample op als een SingleTurnSample en de hele set als een EvaluationDataset. De reference is optioneel, maar de retrievalmetriek vergelijken ermee, dus ik neem hem altijd op in de gecureerde set ook al negeren de referentieloze metriek hem.
Ik heb 6 samples gebouwd voor een fictieve brander, Northwind Coffee. Elke metrieksectie hieronder voegt het sample toe dat die metriek moet vangen.
Begin build_dataset.py met de eerste 3 samples: een schoon antwoord, een opzettelijke hallucinatie, en een tweede schoon antwoord dat meerdere claims tegelijk doet.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Elke opgehaalde context is een chunk van Northwinds helpcenterpagina’s, precies zoals een retriever die aan de generator zou geven. Draai uv run python build_dataset.py om eval_dataset.jsonl en eval_questions.jsonl te schrijven, en draai hem opnieuw telkens als een latere sectie een sample toevoegt.
Opslaan als JSON Lines is belangrijk omdat elk later script (de metriekruns, het CI‑hek) dezelfde eval_dataset.jsonl laadt met EvaluationDataset.from_jsonl().
In een echt project komen de velden retrieved_contexts en response uit het draaien van je daadwerkelijke pijplijn over de vragen, en schrijf je alleen user_input en reference met de hand. De CI‑sectie laat zien hoe je dat automatiseert.
De 6 samples waar dit artikel op uitkomt zijn genoeg om de metriek te leren kennen, maar niet om een drempel te vertrouwen. Mik op zo’n 100 samples voordat je op één drempel leunt; de trackingsectie laat zien waarom. Hoeveel je nodig hebt hangt af van hoe strikt je use‑case is, dus ik focus op een goede mix in plaats van een specifiek aantal:
De 4 kernmetriek van Ragas zijn faithfulness en answer relevancy voor de generator, en context precision en context recall voor de retriever. Alle 4 geven een score tussen 0 en 1. Het nuttige is wat elk getal je vertelt dat je moet veranderen.
Faithfulness meet hoeveel van een antwoord wordt onderbouwd door de opgehaalde chunks. De judge splitst het antwoord in afzonderlijke claims en checkt elke claim tegen de chunks: 1,0 betekent dat elke claim ondersteund is, en 0,0 betekent geen enkele.
Faithfulness heeft geen referentieantwoord nodig, dus je kunt het draaien op live productie‑traffic, niet alleen je testset. Draai het opnieuw wanneer je de prompt, het model of de hoeveelheid context voor het model wijzigt, want dat zijn de veranderingen die het vaakst hallucinaties introduceren.
De snelste manier om het in actie te zien is op één antwoord, geen dataset nodig:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Draai met uv run python quick_check.py en het print faithfulness = 0.00, omdat geen van de 2 claims in de response (6 maanden, een gratis zak) door de context wordt ondersteund. In 0.4 score je met de ascore()‑methode van elke metriek, die een resultaat teruggeeft waarvan .value de score is.
Gescoord over de dataset tot nu toe krijgt de geplante hallucinatie in sample 2 een 0,0, zoals het hoort, en beide schone samples krijgen 1,0. De volledige resultaten per metriek staan in de multimetrieksectie hieronder.
Answer relevancy meet of het antwoord de vraag daadwerkelijk adresseert. De judge leest het antwoord en schrijft 3 vragen waar het een goed antwoord op zou zijn; vervolgens checkt Ragas hoe dicht in betekenis die vragen bij de oorspronkelijke liggen, met een embedding‑model. Als het antwoord de vraag ontwijkt, markeert de judge het als niet to the point en scoort het 0.
Ragas noemt de klasse AnswerRelevancy (oudere voorbeelden noemen het ResponseRelevancy, en de docspagina heet Response Relevancy), en hij heeft zowel de judge‑LLM als het embedding‑model nodig.
Een lage relevancy‑score met een hoge faithfulness‑score wijst meestal op de generator of de prompt: het model had de juiste context en bleef eraan gegrond, maar beantwoordde een andere vraag dan werd gesteld. Check eerst context precision en recall, want een retriever die off‑topic chunks teruggeeft kan hetzelfde patroon produceren.
Dit sample laat de generatorvariant zien. De retriever geeft de juiste shipping‑chunk terug, het antwoord blijft gegrond, en het gaat over roastdata in plaats van verzendkosten. Voeg de nieuwe chunk toe aan de chunks bovenaan build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Voeg dan het nieuwe sample toe aan het eind van de samples‑lijst:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Elk sample krijgt één relevancy‑score: hoe dicht de vragen die de judge uit het antwoord schreef bij de vraag van het sample liggen, waarbij 1,0 een perfecte match is.
Context precision checkt of de nuttige chunks hoog gerankt staan in wat de retriever teruggaf, en context recall checkt of de retriever alles vond wat nodig is om het juiste antwoord te schrijven.
Precision geeft een nuttige chunk meer krediet naarmate die hoger is gerankt; een nuttige chunk op 1 telt dus zwaarder dan dezelfde chunk op 3. Recall is het aandeel feiten in het referentieantwoord dat door minstens één opgehaalde chunk wordt ondersteund.
Beide hebben het veld reference nodig. In de collections‑API heten de klassen ContextPrecisionWithReference en ContextRecall, en beide nemen alleen de judge‑LLM. De Ragas‑docs gebruiken ook de kortere naam ContextPrecision voor de referentie‑variant, dus je kunt beide namen tegenkomen.
Tot nu toe haalt elk sample de juiste chunks eerst op, dus beide metriek hebben niets te vangen. Laten we 2 samples toevoegen die retrieval op verschillende manieren breken: één waar de juiste chunk is opgehaald maar als laatste is gerankt, en één waar helemaal niets relevants is opgehaald, zodat het model terecht weigert. Voeg zoals eerder de chunks bovenaan het bestand toe:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Voeg daarna de samples toe aan het eind van de lijst:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Ranking is belangrijk omdat de meeste pijplijnen alleen de top‑paar chunks aan het model doorgeven, dus een nuttige chunk op plek 6 bij een top‑5‑retriever bestaat praktisch niet.
Sample 5 zet zijn ene nuttige chunk op plek 3 van 3, en precision komt terug op 0,333 omdat de enige nuttige informatie als laatste staat. Sample 6, de retrieval‑misser, scoorde 0,0 op zowel precision als recall.
Sample 6 leert ook iets over faithfulness. Het model weigerde terecht, maar die weigering scoorde 1,0 op faithfulness in sommige runs en 0,0 in andere, zonder dat er iets tussendoor veranderde. Een uitspraak als “Ik heb geen informatie over de garantie” wordt noch ondersteund noch tegengesproken door de context, en de judge gooit er een muntje over op.
Als je pijplijn hoort te weigeren, score weigeringen dan apart in plaats van faithfulness te laten schommelen. Ragas 0.4 verwijderde AspectCritic uit de collections‑API, dus de vervanging is een custom check met de decorator @discrete_metric (zie de migratiegids van v0.3 naar v0.4).
Lees de 2 retrievalcijfers samen en ze vertellen je waar je je volgende week aan moet besteden:
| Context precision | Context recall | Diagnose | Wat te veranderen |
|---|---|---|---|
| Hoog | Hoog | Retrieval is gezond | Focus op de generator: prompt, model, faithfulness |
| Laag | Hoog | Juiste chunks opgehaald maar slecht gerankt | Voeg een reranker toe of tune hem |
| Hoog | Laag | Topchunks relevant maar incompleet | Geef meer chunks aan het model, gebruik grotere chunks, of check waar chunks gesplitst worden |
| Laag | Laag | Retriever faalt breed | Herzie embeddings, indexeren en query rewriting |
De rij “lage precision, hoge recall” is in de praktijk de meest voorkomende, en het goedkoopst te fixen.
Onze tutorial RankGPT als re‑ranking‑agent voor RAG voegt een LLM‑reranker bovenop een bestaande retriever, en onze tutorial Boost LLM‑nauwkeurigheid met RAG en reranking laat een andere reranking‑setup zien. Onze gids 5 sleuteltechnieken om RAG‑performance te verbeteren behandelt chunking en query rewriting voor de andere rijen.
Draai de 2 retrievalmetriek na elke wijziging en de tabel vertelt je of het gewerkt heeft.
Een volledige multimetriekevaluatie draait alle 4 metriek parallel over elk sample en verzamelt de scores, met per‑rijwaarden om in fouten te boren en kolommiddelen voor je dashboard.
In Ragas 0.2 en 0.3 deed je dit met evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). In 0.4.3 bestaat die functie nog, maar hij waarschuwt dat hij verouderd is en weigert de nieuwe metriek, omdat die niet langer overerven van de oude Metric‑klasse die hij verwacht.
De vervanger is de @experiment‑decorator, die je pijplijn en je metriek samen over een Dataset draait en resultaten naar CSV schrijft. Dat is het juiste gereedschap zodra je een pijplijn hebt om aan te roepen.
Voor het scoren van een statische dataset vind ik een kleine helper duidelijker: die bouwt de 4 metriek één keer voor elk script dat ze nodig heeft, en houdt de parallelle calls en error‑afhandeling in leesbare code:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
De ene niet‑voor‑de‑hand‑liggende regel is de call naar inspect.signature(). De 4 metriek willen verschillende inputs (faithfulness wil de response, recall juist de reference), dus de helper leest welke argumenten ascore() van elke metriek accepteert en geeft precies die velden van het sample door, waardoor één loop elke metriek kan bedienen.
De semafoor begrenst hoeveel judge‑calls tegelijk draaien, en een metriek die alsnog faalt wordt een lege (NaN) cel in plaats van dat de hele run afbreekt. Als je dit binnen een Jupyternotebook draait, faalt asyncio.run omdat er al een loop draait. Roep eerst nest_asyncio.apply() aan (Ragas hangt er al van af) of await de coroutine direct.
Met de helper op zijn plek is de volledige run kort:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Dit zijn de scores uit mijn eerste run, gesorteerd op faithfulness en afgerond op 3 decimals, met de gemiddelden in de laatste rij:
| Vraag | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Latere runs van dezelfde dataset scoorden faithfulness lager door de weigering‑sampleflip die ik in de trackingsectie behandel.
Sorteren op faithfulness helpt je de waarschijnlijkste hallucinaties eruit te pikken, en de geplante staat bovenaan. De middelen in de laatste rij zijn je dashboardcijfers.
Lees over de rijen en elke geplande fout duikt op een andere plek op. De hallucinatie drukt alleen faithfulness. De retrieval‑misser zet relevancy, precision en recall tegelijk op nul. Het rankingprobleem snijdt precision tot 0,333, en de drift verschijnt als de laagste relevancy onder de beantwoorde vragen.
Eén eigenaardigheid: het Canada‑antwoord wordt volledig ondersteund door zijn chunk, maar scoorde toch 0,667 op faithfulness. Dat is judgeruis, waar ik in de trackingsectie op terugkom.
Answer relevancy vergelijkt betekenis met embeddings, dus zelfs een goed antwoord scoort zelden dichtbij 1,0: het restitutieantwoord scoorde 0,746, terwijl het off‑topic shippingantwoord 0,572 scoorde. Beoordeel relevancy op het gat tussen samples en de trend door de tijd, niet op het absolute getal.
Een RAG‑kwaliteitshek is een testscript dat de evaluatie draait, elk gemiddelde tegen een drempel vergelijkt, en met een errorcode afsluit wanneer een metriek tekortschiet, wat het CI‑systeem vertelt om de merge te blokkeren.
Eerst een addertje. De handgemaakte dataset van eerder heeft zijn responses en opgehaalde chunks met de hand ingevuld, dus het scoren ervan kan nooit een verandering in je prompt of retriever weerspiegelen. In CI moet je je echte pijplijn opnieuw over je opgeslagen vragen draaien en dan scoren wat die produceerde. Twee kleine scripts doen dat.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py is het enige bestand dat je zelf schrijft: vervang de body van answer() door een call naar je retriever en generator. refresh_dataset.py leest de vragen en referentieantwoorden die build_dataset.py opsloeg, draait de pijplijn over elke vraag en herschrijft eval_dataset.jsonl.
Het hek zelf is een dictionary met drempels en een loop. De drempels hieronder zijn gekalibreerd op de handgemaakte voorbeeldset, dus kalibreer ze op de output van je eigen pijplijn voordat je erop vertrouwt.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Tegen mijn baseline halen alle 4 middelen hun drempels, en het script sluit af met code 0, wat de merge toelaat:
| Metriek | Gemiddelde | Drempel | Resultaat |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Geslaagd |
| Answer relevancy | 0.668 | 0.60 | Geslaagd |
| Context precision | 0.722 | 0.65 | Geslaagd |
| Context recall | 0.833 | 0.75 | Geslaagd |
Ik zette de faithfulness‑drempel op 0,60 in plaats van 0,70 door de judgeruis die ik in de trackingsectie behandel. Met 6 samples verschuift één wispelturige uitspraak een mean met 0,17, en een latere run van de ongewijzigde pijplijn scoorde 0,61. Het hek draait de judge ook 3 keer en neemt het gemiddelde (GATE_RUNS), wat enkelvoudige flips afvlakt tegen 3× de judge‑kosten.
Een ontwerpkeuze is falen op not (actual >= threshold) in plaats van actual < threshold. Een vergelijking met NaN (“not a number”) is altijd False, dus een check als actual < threshold zou de build passeren wanneer de judge faalt.
De skipna=False in de mean dekt het gedeeltelijke geval. pandas slaat NaN standaard over, dus een paar mislukte judge‑calls zouden de sample stilletjes verkleinen in plaats van het hek te laten falen. Een tijdelijke judge‑fout laat de build nu falen, dus draai de job opnieuw voordat je debugt.
Drempels zijn lastig af te stemmen. Zet ze iets onder het laagste gemiddelde dat je over herhaalde runs hebt gezien, niet op een ambitieuze 0,9, anders blokkeert het hek elke pull request en verliest het team vertrouwen in CI. Reset ze telkens als je het judge‑model wijzigt of meer dan een handvol samples toevoegt.
In GitHub Actions is de bedrading een korte workflow. De workflow‑syntaxisreferentie behandelt de on.pull_request‑padfilters en de schedule‑cron hier gebruikt:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Een paar details in die workflow zijn belangrijk:
JUDGE_MODEL en de bijbehorende API‑sleutel. Gebruik dezelfde judge waarmee je de drempels kalibreerde, anders zijn CI‑scores niet vergelijkbaar met je geschiedenis.GATE_SAMPLE een vaste willekeurige subset van 30 rijen, zodat een review niet 10 minuten wacht op judge‑calls. De nightly cron scoort alles.scores.csv en ragas_history.jsonl als artifact, omdat de schijf van de runner verdwijnt na afloop.Draai de volledige suite op de nightly cron, wanneer niemand wacht. Een falende nightly‑run verschijnt als mislukte workflow, en GitHub’s notificatie‑instellingen of een Slack‑stap kunnen de eigenaar ’s ochtends informeren. GitLab CI heeft dezelfde vorm met rules: changes: en een pipeline‑schema.
Ragas genereert synthetische testvragen door je documenten te lezen, hun hoofdonderwerpen en feiten te extraheren, gerelateerde chunks te koppelen en dan vragen van verschillende typen uit die links te schrijven.
De docs over testdatageneratie splitsen queries in single‑hop (één chunk kan antwoorden) en multi‑hop (het antwoord heeft meerdere chunks nodig), en elk daarvan kan specifiek of abstract zijn. De standaardmix gebruikt 3 van die 4 combinaties in gelijke delen:
Ragas gebruikt alleen de synthesizers die je documenten kunnen ondersteunen, dus een kleine documentenset kan een andere mix opleveren.
De generator heeft echte documenten nodig om te lezen. Richt hem op je eigen documentatie als markdownbestanden. Voor dit artikel schreef ik 5 korte helpcenterpagina’s voor Northwind (in totaal ongeveer 600 woorden), en elk ziet er zo uit:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Je eigen docs leveren andere vragen op dan hieronder, en dat is precies de bedoeling: de generator schrijft vragen over wat je kennisbank daadwerkelijk zegt.
De TestsetGenerator neemt dezelfde judge‑LLM en embedding‑model die we al bouwden. Ik laad de docs met LangChains DirectoryLoader, met TextLoader expliciet zodat de markdownbestanden niet de zware dependency unstructured binnenhalen.
Je documenten in kaart brengen schiet veel judge‑calls tegelijk af, dus ik beperk ook hoeveel er parallel draaien met RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Het script laadt alle 5 documenten en schrijft deze 8 vragen. De vragen volgen de documenten, en sommige bevatten opzettelijke typfouten:
| # | Gegenereerde vraag | Vragentype |
|---|---|---|
| 1 | how do i brew with a french pres | Single‑hop |
| 2 | Northwind equipment warranty | Single‑hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single‑hop |
| 4 | how do I cancel Nortwind subscription? | Single‑hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi‑hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi‑hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi‑hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi‑hop |
De tabel toont vereenvoudigde labels; de kolom synthesizer_name in de output bevat de volledige synthesizernaam. Acht vragen uit 5 documenten kostten ongeveer 4,5 minuten.
De typfouten en de keyword‑achtige query in vraag 2 zijn opzettelijk: de generator varieert de stijl en lengte van elke query zodat de set op zoekbox‑verkeer lijkt in plaats van tentamenvragen.
Je wilt de vragen waarschijnlijk even nalopen om te checken dat ze bruikbaar en relevant zijn. Ik zou de output als eerste versie gebruiken. In elke synthetische set die ik reviewde, zijn sommige vragen misvormd (ze verwijzen naar “het document” of vragen naar een kop), drijven sommige referentieantwoorden af van wat de bron daadwerkelijk zegt, en is de formulering formeler dan die van echte gebruikers.
Draai de generator opnieuw wanneer je een sectie aan de docs toevoegt en je krijgt kandidaatvragen voor het nieuwe materiaal, tegen de prijs van nog een ronde judge‑calls.
Elke rij heeft een user_input, een gegenereerd reference‑antwoord, en reference_contexts, de chunks waarop de vraag is gebouwd. Check de reference tegen die chunks, want daar ontstaat drift.
Om een gereviewde rij om te zetten in een SingleTurnSample, draai je je pijplijn over de user_input om de retrieved_contexts en response te krijgen. Voeg de gereviewde paren user_input en reference toe aan eval_questions.jsonl en refresh_dataset.py doet de rest voor je.
Als je kennisbasis een graaf is in plaats van een stapel documenten, geldt hetzelfde principe met een andere retriever. Onze tutorial Using a Knowledge Graph to Implement a RAG Application en onze cursus Graph RAG met LangChain en Neo4j leveren beide pijplijnen die je exact met dezelfde 4 metriek kunt evalueren, omdat de metriek alleen de opgehaalde tekst zien, niet hoe die is opgehaald.
Ragas‑scores door de tijd tracken betekent na elke evaluatie de gemiddelde scores, de git‑commit‑hash, het judge‑model en een timestamp aan een logbestand toevoegen, zodat een regressie als een dip op een lijngrafiek verschijnt in plaats van als een verrassing in productie.
Een JSON Lines‑bestand is waarschijnlijk de beste keuze tot je een gedeelde experimententracker nodig hebt voor meerdere mensen. track_scores.py leest scores.csv, dat zowel quality_gate.py als run_all.py schrijven, dus het triggert nooit een tweede ronde judge‑calls.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
uv run python track_scores.py draaien voegt één regel toe aan de log en print die:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
In CI begint elke job met een lege schijf, dus ragas_history.jsonl bevat alleen het record van die run. Wil je een trend bewaren, download dan de geüploade artifacts en append ze aan één bestand, of commit het bestand naar een metrics‑branch of objectopslag.
Het plotten van de geschiedenis is vrij eenvoudig. Probeer dit script:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Je krijgt een grafiek die hierop lijkt:
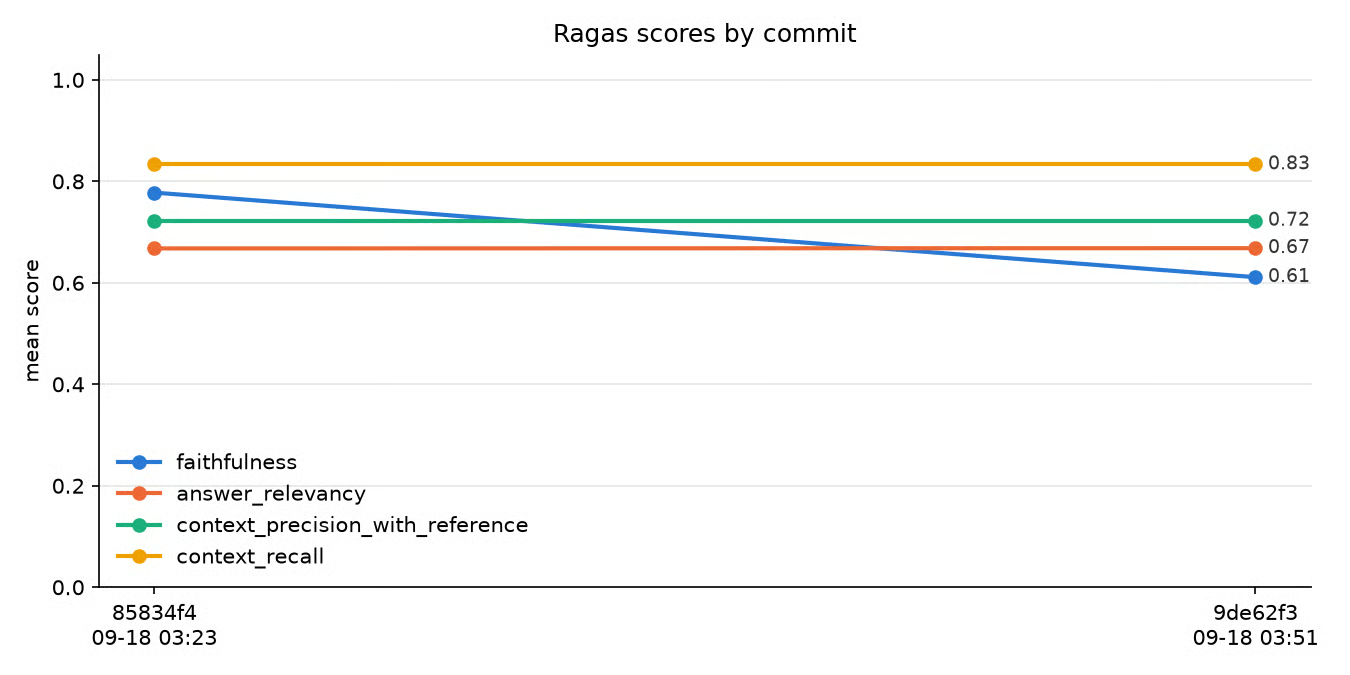
Gemiddelde Ragas‑scores per commit gelogd door track_scores.py. Afbeelding door de auteur.
Tussen die commits veranderde niets in de pijplijn (de tweede wijzigde alleen de connectie‑instellingen van de judge‑client), maar toch viel faithfulness van 0,78 naar 0,61 omdat de weigering in sample 6 flipte van 1,0 naar 0,0.
Er is dus echte judgeruis om op te letten totdat je een groot aantal samples hebt. Met 6 samples verschuift één wispelturige uitspraak het gemiddelde met 0,17. Met 100 samples verschuift dezelfde flip met 0,01, dus een grote verandering is dan veel waarschijnlijker een echte regressie.
Nu kun je bij elke pull request of commit het hek draaien, de scores loggen en naar de grafiek kijken.
Als je een grotere architectuurwijziging afweegt, kadert onze tutorial RAG versus fine‑tunen de trade‑off, en dezelfde 4 metriek werken als voor‑ en nameting voor beide paden.
LLM‑als‑judge‑scores zijn schattingen: ze hebben bekende biases en kunnen van run tot run veranderen, maar ze schalen naar evaluatievolumes waar menselijke review niet tegenop kan.
Ragas vraagt de judge nooit om 2 antwoorden te vergelijken, dus position bias (voorkeur voor het eerste antwoord) geldt grotendeels niet. Verbosity bias (voorkeur voor langere antwoorden) en self‑preference bias (judges die antwoorden van hun eigen model prefereren) kunnen nog steeds meespelen. Zheng et al. (2023) beschrijven alle 3 biases, en self‑preference is waarom ik niet hetzelfde model als generator en judge zou gebruiken.
De variatie tussen runs is het deel dat ik je zelf wil laten zien, omdat het verandert hoe je drempels zet. Over runs van dezelfde 6 samples met dezelfde gepinde judge scoorde het weigering‑antwoord in sample 6 0,0 in de ene run en 1,0 in een andere op faithfulness, en het volledig gegronde sample 5 scoorde 0,667 in de getoonde run.
Per‑sample scores van een goedkoop judge‑model zijn ruisachtig. Middelden over 100 samples zijn veel minder ruisachtig, en het CI‑hek zou altijd het gemiddelde moeten testen.
Drie praktijken beteugelen de ruis:
judge.py en track_scores.py hierboven doen, zodat een judge‑wijziging nooit wordt aangezien voor een pijplijnwijziging.Voor een bredere tour van evaluatiebenaderingen buiten RAG, inclusief de menselijke evaluatiemethoden waar de judge voor invalt, behandelt onze LLM‑evaluatiegids de metriek en methodologieën. Onze LLM als judge‑tutorial gaat dieper in op het bouwen van een judge voor RAG‑pijplijnen.
Het punt van deze pijplijn is dat we dingen kunnen zeggen als “de retriever is in orde, de prompt is achteruitgegaan” of “de reranker fixte precision maar recall is nog 0,6”, met cijfers achter de claim.
Faithfulness en answer relevancy bewaken de generator: faithfulness vangt verzonnen feiten, en answer relevancy vangt antwoorden die van de vraag afdwalen. Context precision en recall bewaken de retriever en vertellen je of die de juiste informatie ophaalt. Omdat 2 van de 4 geen referentieantwoord nodig hebben, kun je ze draaien op productie‑traffic waar geen referentie bestaat.
Standaard tekstmetriek meten woordoverlap, wat niets zegt over een verzonnen restitutiebeleid, en één end‑to‑end‑getal verbergt welke helft van de pijplijn brak. Een framework dat de 2 faalpunten apart checkt kan dat zien, en het omzetten van een eenmalige audit in een CI‑hek met een historie‑bestand zorgt ervoor dat je team op de cijfers gaat handelen.
Heb je de pijplijn nog niet gebouwd, begin dan met onze cursus Retrieval-Augmented Generation met LangChain en wijs daarna het pipeline.py uit dit artikel naar wat je bouwt.
Voor pijplijnen die verder gaan dan plain‑text retrieval bouwen onze cursus End‑to‑End RAG met Weaviate, onze multimodale RAG‑gids, en onze agentic RAG‑tutorial systemen die je op dezelfde manier kunt scoren, met één kanttekening: de 4 kernmetriek lezen alleen tekst. Een pijplijn die afbeeldingen ophaalt heeft de aparte multimodale metriek van Ragas nodig, en een agentische pijplijn moet elke retrievalstap als eigen vraag, chunks en antwoord gescoord krijgen.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

