Kurs
Graph RAG med LangChain och Neo4j
3 tim
2.3K
En retrieval-augmented generation- (RAG) pipeline för en chatbot klarar alla röktester i anteckningsboken. Sedan börjar supportärenden trilla in om felaktiga eller märkliga svar, och inget i loggarna från röktesterna visar någon varningsflagga.
Det här felet är svårt att fånga eftersom det är osynligt utan mätvärden. En RAG-pipeline kan gå fel på två ställen: hämtaren kan plocka fel textbitar, eller generatorn kan ignorera bra bitar och hitta på fakta. Ett enda end-to-end-noggrannhetstal kan inte tala om vilket som hände, och kan därför inte tala om vad du ska åtgärda.
I den här tutorialen bygger jag en komplett RAG-utvärderingspipeline i Python med Ragas 0.4.3: ett handbyggt utvärderingsdataset, de fyra kärnmetrikerna (faithfulness, answer relevancy, context precision och context recall), en kvalitetsgrind i continuous integration (CI) som fallerar bygget när poängen sjunker, en generator för syntetiskt testset och en JSON Lines-baserad resultatlogg.
Vill du ha mer bakgrund först, se vår guide till vad RAG är, vår tutorial om att använda en stor språkmodell (LLM) som domare för utvärdering av RAG-pipelines, och vår översikt över avancerade RAG-tekniker.
Du behöver Python 3.9 eller nyare (jag använder 3.12), uv eller pip, en API-nyckel till en OpenAI-kompatibel domarmodell och en hyfsad uppfattning om hur en RAG-pipeline fungerar. Om du vill ha den grunden först rekommenderar jag vår kurs Retrieval-Augmented Generation with LangChain, som bygger den typ av pipeline vi ska poängsätta.
Textöverlappningsmått som BLEU (Bilingual Evaluation Understudy) och ROUGE (Recall-Oriented Understudy for Gisting Evaluation) är fel måttstock för RAG. Ragas använder i stället en domar-LLM för att poängsätta varje svar längs fyra axlar: faithfulness och answer relevancy diagnostiserar generatorn, medan context precision och context recall diagnostiserar hämtaren.
Lägg dessa fyra tal bakom en tröskel i CI och logga dem per commit, så har du ett regressionslarm i stället för en engångsrevision.
En varning innan vi börjar. Ragas API har ändrats två gånger på två år: v0.2 ersatte ordboksdataset med SingleTurnSample och EvaluationDataset, och v0.4 gjorde samlingsmetrikerna (införda i v0.3.9) till standard och markerade den gamla funktionen evaluate() som utfasad.
De flesta tutorials online visar fortfarande kod för v0.1 eller v0.2. Allt nedan körs på 0.4.3, som är aktuell version i oktober 2026.
RAG behöver egna mått eftersom klassiska textmått bara räknar hur många ord ett svar delar med ett referenssvar, och delad ordalydelse är inte det som går sönder i ett RAG-system.
BLEU (Papineni m.fl., 2002) och ROUGE (Lin, 2004) byggdes för maskinöversättning och sammanfattning, där ett bra resultat bör använda i stort sett samma ord som referensen. Ett RAG-svar som säger ”du har 2 veckor” i stället för ”14 dagar” får dålig poäng på båda, medan ett flytande svar som hittar på en återbetalningspolicy kan få bra poäng om det råkar återanvända ord från referensen.
Det djupare problemet är att en RAG-pipeline kan fallera på två separata ställen: hämtaren kan välja fel information, eller generatorn kan ignorera bra information och hitta på fakta. När ett svar är fel behöver du veta vilket av detta som hände:
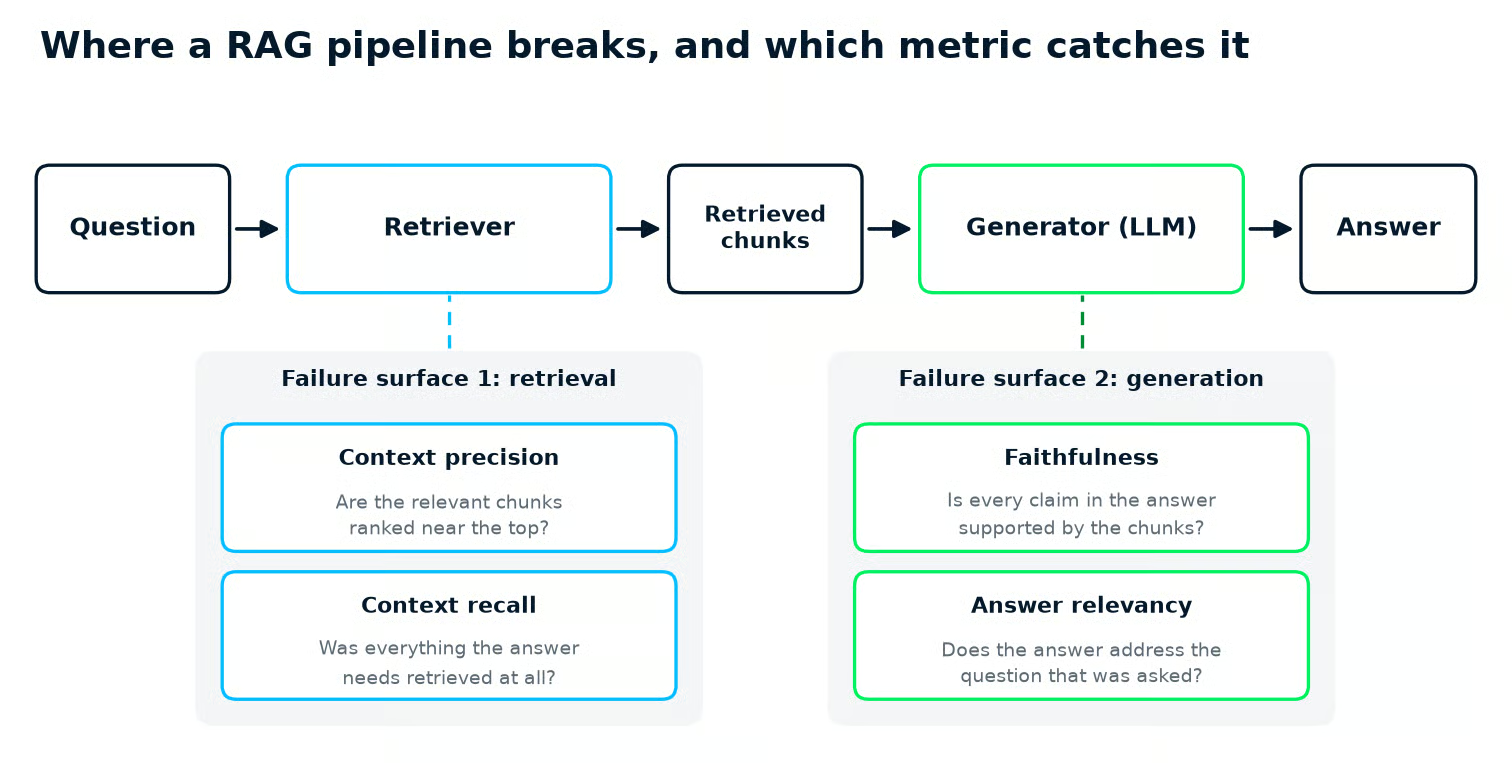
De två felmoderna i en RAG-pipeline: context precision och recall diagnostiserar hämtaren, medan faithfulness och answer relevancy diagnostiserar generatorn. Bild av författaren.
Vår What Is Retrieval Augmented Generation (RAG)? A Complete Guide går igenom pipeline-stegen där dessa fel uppstår.
Ragas är ett öppet Python-ramverk som ger dig ett tal för varje del av pipelinen. Det är inte det enda alternativet. De två huvudsakliga alternativen är DeepEval, som kapslar in utvärdering i pytest-liknande testfall, och Evidently, som lägger till LLM-kontroller som extra kolumner i ett dataset och matar dem till övervakningsrapporter.
| Ramverk | Bäst för | RAG-specifika inbyggda metriker | Testdata från dina dokument | Konfigstil |
|---|---|---|---|---|
| Ragas | Diagnostisera RAG-pipelines | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (öppen källkod) |
Metrobjekt plus en domare från llm_factory() |
| DeepEval | Enhetstestliknande LLM-testning i CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (öppen källkod) |
LLMTestCase-objekt, assert_test() körs via deepeval test run |
| Evidently | Övervakningsdashboards och drift över tid | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | RAG-datasetgenerering i Evidently Cloud | Beskrivare på ett Dataset, sammanfattade av en Report |
Jag valde Ragas för den här tutorialen eftersom dess fyra kärnmetriker delar upp sig rent i hämtarpoäng och generatorpoäng, och eftersom dess testsetgenerator följer med i samma open source-paket.
Om ditt team redan lever i pytest kommer DeepEvals assert_test() kännas mer naturligt. Om du vill ha en dashboard över kvaliteten i live-trafik kommer Evidentlys rapporter snabbare dit.
Att sätta upp Ragas innebär att installera paketet, låsa en beroendeversion och välja en domar-LLM som alla metriker delar. Jag använder uv eftersom det låser exakta paketversioner åt dig, men pip install med samma versioner fungerar också.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Jag använder Python 3.12 här. Ragas 0.4.3 deklarerar stöd för Python 3.9 och nyare.
Paketet rapidfuzz behövs av generatorn för det syntetiska testsetet senare i artikeln. Ragas deklarerar det inte som beroende, så jag installerar det direkt.
Spiken langchain-community<0.4 är inte valfri i skrivande stund. Ragas 0.4.3 importerar ChatVertexAI från en modulsökväg som langchain-community 0.4 tog bort, så en ren installation utan spiken fallerar när du importerar ragas.
Nästa steg: domaren. Varje LLM-baserad metrik i Ragas gör ett eller flera anrop till en domarmodell, så du bygger den en gång och skickar in den överallt. Jag lägger den i en egen modul, judge.py, och läser nyckeln från miljön så att inga uppgifter hamnar i git.
Den här filen visar hur du anropar OpenAI direkt, eller Gemini via Googles OpenAI-kompatibla slutpunkt.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Två detaljer i den filen kan snubbla din första körning:
llm_factory() i 0.4 behöver ett klientobjekt inpassat, och att bara skicka ett modellnamn ger ett fel.llm_factory() går rakt in i modellanropet, vilket är hur jag höjer max_tokens över standardvärdet 1 024.Använd den billigaste modellen som ger stabila poäng på ett stickprov du har handkontrollerat, och lås den sedan. För en stor utvärderingssvit blir volymen snabbt stor: faithfulness gör 2 domaranrop per prov, answer relevancy gör 3 plus 2 embedding-anrop, context precision gör 1 per hämtad textbit och context recall gör 1.
Sex prov över fyra metriker blev 62 anrop i en enda körning: 50 domaranrop plus 12 embedding-anrop. Här är vad 3 aktuella små domarmodeller kostar enligt respektive leverantörs listpris den 19 oktober 2026:
| Domarmodell | Inmatning per 1 M token | Utmatning per 1 M token | Källa |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI-priser |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API-priser |
| claude-haiku-5-5 | $0.10 (prompter upp till 100K token) | $0.50 (prompter upp till 100K token) | Claude API-priser |
Standardvalet i judge.py är fortfarande gpt-4o-mini, en äldre OpenAI-modell som inte listas i huvudtabellen på OpenAIs prissida. Sätt variabeln JUDGE_MODEL för att byta.
En hake om du vill ha Claude som domare: answer relevancy behöver också en embedding-modell, och Anthropic erbjuder ingen. Deras dokumentation pekar på Voyage AI, så du skulle para Claude med embeddings från en annan leverantör.
Att låsa modellen är viktigare än valet. Att byta domarmodell flyttar poäng även när din pipeline inte ändrats, vilket förstör trendlinjen du snart ska bygga i spårningsavsnittet.
Lägg modellnamnet i judge.py under versionskontroll och behandla en domaruppgradering som vilket annat brytande ändring som helst: nollställ varje tröskel mot den nya domarens poäng.
Varje testfall i datasetet kallas ett sample. Ett sample är mer än ett svar: det registrerar en hel resa genom pipelinen i fyra fält:
| Fält | Vad det innehåller |
|---|---|
user_input |
Frågan som kunden ställde |
retrieved_contexts |
Textbitarna som hämtaren returnerade för den frågan |
response |
Svaret som RAG-pipelinen gav |
reference |
Det korrekta svaret, skrivet av en människa |
Ragas sparar varje sample som en SingleTurnSample och hela uppsättningen som ett EvaluationDataset. reference är valfritt, men hämtarmetrikerna jämför mot det, så jag tar alltid med det i det kuraterade setet även om de referensfria metrikerna ignorerar det.
Jag byggde sex sample för ett fiktivt rosteri, Northwind Coffee. Varje metrikavsnitt nedan lägger till det sample som just den metriken ska fånga.
Börja build_dataset.py med de tre första samplena: ett rent svar, en avsiktlig hallucination och ett andra rent svar som gör flera påståenden samtidigt.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Varje hämtad kontext är en bit från Northwinds hjälpsidor, skriven in i skriptet exakt som en hämtare skulle lämna den till generatorn. Kör uv run python build_dataset.py för att skriva eval_dataset.jsonl och eval_questions.jsonl, och kör om det varje gång ett senare avsnitt lägger till ett sample.
Att spara till JSON Lines spelar roll eftersom varje senare skript (metriskörningarna, CI-grinden) laddar samma eval_dataset.jsonl med EvaluationDataset.from_jsonl().
I ett riktigt projekt kommer fälten retrieved_contexts och response från att köra din faktiska pipeline över frågorna, och bara user_input och reference är handskrivna. CI-avsnittet visar hur du automatiserar det steget.
De sex sample som artikeln landar i räcker för att lära metrikerna, men inte för att lita på en tröskel. Sikta på runt 100 sample innan du förlitar dig på en; spårningsavsnittet visar varför. Hur många du behöver beror på hur strikt ditt användningsfall är, så jag fokuserar på en bra mix snarare än ett specifikt tal:
De fyra kärnmetrikerna i Ragas är faithfulness och answer relevancy för generatorn, samt context precision och context recall för hämtaren. Alla fyra returnerar en poäng mellan 0 och 1. Det användbara är vad varje siffra säger åt dig att fixa.
Faithfulness mäter hur mycket av ett svar som stöds av de hämtade textbitarna. Domaren delar upp svaret i individuella påståenden och kontrollerar sedan varje påstående mot bitarna: 1,0 betyder att varje påstående är stött, och 0,0 att inget är det.
Faithfulness behöver inget referenssvar, så du kan köra det på live-produktionstrafik, inte bara ditt testset. Kör det igen när du ändrar prompten, modellen eller hur mycket kontext modellen ser, för det är de ändringarna som oftast introducerar hallucinationer.
Snabbaste sättet att se det i praktiken är på ett enskilt svar, inget dataset krävs:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Kör det med uv run python quick_check.py och det skriver ut faithfulness = 0.00, eftersom inget av påståendena i svaret (6 månader, en gratis påse) stöds av kontexten. I 0.4 poängsätter du med varje metriks ascore()-metod, som returnerar ett resultat vars .value är poängen.
Poängsatt över datasetet hittills får den planterade hallucinationen i sample 2 poängen 0,0, som den ska, och båda rena samplena får 1,0. Fullständiga resultat för varje metrik finns i multi-metrikavsnittet nedan.
Answer relevancy mäter om svaret faktiskt adresserar frågan. Domaren läser svaret och skriver tre frågor som det skulle vara ett bra svar på, sedan kontrollerar Ragas hur lika i betydelse dessa frågor är den ursprungliga, med hjälp av en embedding-modell. Om svaret undviker frågan markerar domaren det som undvikande och det får 0.
Ragas kallar klassen AnswerRelevancy (äldre exempel kallar den ResponseRelevancy, och dokumentsidan heter Response Relevancy), och den behöver både domar-LLM och embedding-modellen.
En låg relevanspoäng med en hög faithfulness-poäng pekar oftast på generatorn eller prompten: modellen hade rätt kontext och höll sig till den, men svarade på en annan fråga än den som ställdes. Kolla context precision och recall först, eftersom en hämtare som returnerar offtopic-bitar kan ge samma mönster.
Detta sample visar generatorfallet. Hämtaren returnerar rätt fraktbit, svaret är förankrat och det pratar om rostningsdatum i stället för fraktkostnad. Lägg till den nya textbiten överst i build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Lägg sedan till det nya samplet sist i listan samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Varje sample får en relevanspoäng: hur väl frågorna domaren skrev utifrån svaret matchar frågan samplet faktiskt ställde, där 1,0 är en perfekt matchning.
Context precision kontrollerar om de användbara bitarna är rankade nära toppen av vad hämtaren returnerade, och context recall kontrollerar om hämtaren hittade allt som behövs för att skriva det korrekta svaret.
Precision ger en användbar bit mer kredit ju högre den är rankad, så en användbar bit på första plats räknas mer än samma bit på tredje. Recall är andelen fakta i referenssvaret som åtminstone en hämtad bit stöder.
Båda behöver fältet reference. I Collections-API:et heter klasserna ContextPrecisionWithReference och ContextRecall, och båda tar bara domar-LLM:en. Ragas-dokumenten använder också det kortare namnet ContextPrecision för den referensbaserade versionen, så du kan se båda.
Hittills hämtar varje sample rätt bitar först, så ingen metrik har något att fånga. Låt oss lägga till två sample som bryter retrieval på olika sätt: ett där rätt bit hämtas men rankas sist, och ett där inget relevant hämtas alls, så modellen korrekt avböjer. Som tidigare, lägg till bitarna överst i filen:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Lägg sedan till samplena sist i listan:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Rankning spelar roll eftersom de flesta pipelines bara skickar de översta få bitarna till modellen, så en användbar bit på sjätte plats i en top-5-hämtare kunde lika gärna inte finnas.
Sample 5 lägger sin enda användbara bit sist av tre, och precisionen blir 0,333 eftersom den enda användbara informationen är rankad sist. Sample 6, retrieval-missen, fick 0,0 på både precision och recall.
Sample 6 lär oss också något om faithfulness. Modellen avböjde korrekt, men den avböjningen fick 1,0 på faithfulness i vissa körningar och 0,0 i andra, utan att något ändrades däremellan. Ett påstående som ”Jag har inte information om garantin” varken stöds eller motsägs av kontexten, och domaren slumpar utfallet.
Om din pipeline ska avböja, poängsätt avböjningar separat i stället för att låta dem dra runt faithfulness. Ragas 0.4 tog bort AspectCritic från Collections-API:et, så ersättningen är en egen kontroll byggd med dekoratorn @discrete_metric (se migreringsguiden v0.3 till v0.4).
Läs de två hämtarsiffrorna tillsammans så talar de om var du ska lägga nästa vecka:
| Context precision | Context recall | Diagnos | Vad du ändrar |
|---|---|---|---|
| Hög | Hög | Retrieval mår bra | Fokusera på generatorn: prompt, modell, faithfulness |
| Låg | Hög | Rätta bitar hämtas men rankas dåligt | Lägg till eller trimma en reranker |
| Hög | Låg | Toppbitar relevanta men ofullständiga | Skicka fler bitar till modellen, använd större bitar eller se över hur bitar delas |
| Låg | Låg | Hämtaren fallerar brett | Se över embeddings, indexering och omskrivning av frågor |
Raden ”låg precision, hög recall” är den vanligaste jag ser i praktiken, och den är billigast att fixa.
Vår tutorial RankGPT som omrankningsagent för RAG lägger en LLM-reranker ovanpå en befintlig hämtare, och vår tutorial Boost LLM Accuracy with RAG and Reranking visar en annan omrankningslösning. Vår guide 5 nyckeltekniker för att förbättra RAG-prestanda täcker chunking och omskrivning av frågor för de andra raderna.
Kör om de två hämtarmetrikerna efter varje ändring och låt tabellen tala om ifall det fungerade.
En fullständig multi-metrikutvärdering kör alla fyra metriker över varje sample parallellt och samlar poängen, med radvisa värden för felsökning och kolumnmedel för din dashboard.
I Ragas 0.2 och 0.3 gjorde du detta med evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). I 0.4.3 finns funktionen kvar, men varnar att den är utfasad och vägrar de nya metrikerna rakt av, eftersom de inte längre ärv från den gamla Metric-klassen den förväntar sig.
Ersättningen är @experiment-dekorationen, som kör din pipeline och dina metriker tillsammans över ett Dataset och skriver resultat till CSV. Det är rätt verktyg när du väl har en pipeline att anropa.
För att poängsätta ett statiskt dataset tycker jag att en liten hjälpare är tydligare: den bygger de fyra metrikerna en gång för varje skript som behöver dem, och den håller parallellanrop och felhantering i kod jag kan läsa:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Den enda icke-uppenbara raden är anropet inspect.signature(). De fyra metrikerna vill ha olika indata (faithfulness behöver svaret, recall behöver referensen i stället), så hjälparen läser vilka argument varje metriks ascore() accepterar och skickar exakt de fälten från samplet, vilket låter en enda loop tjäna varje metrik.
Semaforen sätter tak för hur många domaranrop som körs samtidigt, och en metrik som ändå fallerar blir en tom (NaN) cell i stället för att avbryta hela körningen. Om du kör detta i en Jupyter-notebook fallerar asyncio.run eftersom en loop redan kör. Anropa nest_asyncio.apply() först (Ragas beror redan på det) eller avvakta koroutinen direkt.
Med hjälparen på plats är fullkörningen kort:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Här är poängen från min första körning, sorterade efter faithfulness och avrundade till tre decimaler, med medelvärden i sista raden:
| Fråga | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Medel | 0.778 | 0.668 | 0.722 | 0.833 |
Senare körningar av samma dataset poängsatte faithfulness lägre på grund av avböjnings-samplets flip som jag tar upp i spårningsavsnittet.
Sortering efter faithfulness hjälper dig plocka ut troliga hallucinationer, och den planterade ligger överst. Medlen i sista raden är dina dashboard-siffror.
Läs tvärs över raderna och varje planterat fel syns på olika ställen. Hallucinationen sänker bara faithfulness. Retrieval-missen nollar relevans, precision och recall tillsammans. Rankningsproblemet sänker precisionen till 0,333, och driften syns som lägst relevans bland de besvarade frågorna.
En konstighet: Kanada-svaret stöds helt av sin bit, ändå fick det 0,667 på faithfulness. Det är domarbrus, som jag återkommer till i spårningsavsnittet.
Answer relevancy jämför betydelse med embeddings, så även ett bra svar når sällan nära 1,0: återbetalningssvaret fick 0,746, medan det offtopic fraktsvaret fick 0,572. Bedöm relevans efter gapet mellan sample och efter trenden över tid, inte efter absoluta tal.
En RAG-kvalitetsgrind är ett testskript som kör utvärderingen, jämför varje medelpoäng mot en tröskel och avslutar med en felkod när någon metrik hamnar under, vilket talar om för CI-systemet att blockera mergingen.
En hake först. Det handbyggda datasetet från tidigare har sina svar och hämtade bitar inskrivna för hand, så att poängsätta det kan aldrig spegla en ändring i din prompt eller hämtare. I CI behöver du köra den riktiga pipelinen över dina sparade frågor och sedan poängsätta vad den producerade. Två små skript gör det.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py är den enda fil du skriver själv: ersätt kroppen i answer() med ett anrop till din hämtare och generator. refresh_dataset.py läser de frågor och referenssvar som build_dataset.py sparade, kör pipelinen över varje fråga och skriver om eval_dataset.jsonl.
Själva grinden är en ordbok med trösklar och en loop. Trösklarna nedan kalibrerades på det handbyggda exempel-datasetet, så kalibrera om dem på din egen pipelines utdata innan du litar på dem.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Mot min baslinje klarar alla fyra medel sina trösklar, och skriptet avslutar med kod 0, vilket låter mergingen gå igenom:
| Metrik | Medel | Tröskel | Resultat |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Godkänd |
| Answer relevancy | 0.668 | 0.60 | Godkänd |
| Context precision | 0.722 | 0.65 | Godkänd |
| Context recall | 0.833 | 0.75 | Godkänd |
Jag satte faithfulness-tröskeln till 0,60 i stället för 0,70 på grund av domarbruset jag tar upp i spårningsavsnittet. Med sex sample flyttar ett fladdrigt utslag ett medel med 0,17, och en senare körning av den oförändrade pipelinen gav 0,61. Grinden kör också domaren tre gånger och medelvärdesbildar poängen (GATE_RUNS), vilket jämnar ut enskilda flippar till trefaldig domarkostnad.
Ett designval är att falla på not (actual >= threshold) i stället för actual < threshold. En jämförelse mot NaN (”not a number”) är alltid False, så en kontroll skriven som actual < threshold skulle godkänna bygget när domaren fallerar.
skipna=False i medelvärdet täcker delvisa fall. pandas hoppar över NaN som standard, så några misslyckade domaranrop skulle tyst krympa samplet i stället för att fälla grinden. En tillfällig domarincident fäller nu bygget, så kör om jobbet innan du felsöker.
Trösklar är svåra att trimma. Sätt dem strax under det lägsta medel du sett över upprepade körningar, inte på något önsketänkande 0,9, annars blockerar grinden varje pull request och teamet slutar lita på CI. Nollställ dem när du byter domarmodell eller lägger till mer än en handfull sample.
Att koppla in det i GitHub Actions är ett kort workflow. Referensen för workflow-syntax täcker on.pull_request-sökvägsfilter och cron-schemat schedule som används här:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Några detaljer i det workflowet spelar roll:
JUDGE_MODEL och motsvarande API-nyckel. Använd samma domare som du kalibrerade trösklarna med, annars blir CI-poängen inte jämförbara med din spårade historik.GATE_SAMPLE en fast slumpmässig delmängd på 30 rader, så en granskning inte väntar tio minuter på domaranrop. Nattlig cron kör allt.scores.csv och ragas_history.jsonl som en artefakt, eftersom runnerns disk försvinner när jobbet slutar.Kör hela sviten på nattlig cron, där ingen väntar. En fallerande nattlig körning syns som ett fallerat workflow, och GitHubs notifieringsinställningar eller ett Slack-steg kan meddela ägaren på morgonen. GitLab CI har samma upplägg med rules: changes: och ett pipelineschema.
Ragas genererar syntetiska testfrågor genom att läsa dina dokument, plocka ut huvudämnen och fakta, länka relaterade bitar och sedan skriva frågor av olika slag från dessa länkar.
Dokumentationen för testdatagenerering delar upp frågor i single-hop (en bit kan svara) och multi-hop (svaret kräver flera bitar), och var och en av dessa kan vara specifik eller abstrakt. Standardmixen använder tre av dessa fyra kombinationer i lika delar:
Ragas använder bara de syntetiserare som dina dokument kan stödja, så en liten dokumentsamling kan ge en annan mix.
Generatorn behöver riktiga dokument att läsa. Peka den mot din egen dokumentation som markdownfiler. För den här artikeln skrev jag fem korta hjälpsidor för Northwind (cirka 600 ord totalt), och varje ser ut så här:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Dina egna dokument kommer ge andra frågor än de nedan, vilket är poängen: generatorn skriver frågor om vad din kunskapsbas faktiskt säger.
TestsetGenerator tar samma domar-LLM och embedding-modell som vi redan byggt. Jag laddar dokumenten med LangChains DirectoryLoader, och använder TextLoader uttryckligen så att markdown-filerna inte drar in det tunga beroendet unstructured.
Att kartlägga dina dokument avfyrar många domaranrop samtidigt, så jag begränsar också hur många som kör parallellt med RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Skriptet laddar alla fem dokument och skriver dessa åtta frågor. Frågorna följer dokumenten, och vissa innehåller avsiktliga stavfel:
| # | Genererad fråga | Frågetyp |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Tabellen visar förenklade etiketter; kolumnen synthesizer_name i utdata innehåller det fulla syntetiserarnamnet. Åtta frågor från fem dokument tog cirka 4,5 minuter.
Stavfelen och sökordsstilen i fråga 2 är avsiktliga: generatorn varierar stil och längd på varje fråga så att uppsättningen liknar sökrutetrafik snarare än provfrågor.
Du kommer troligen vilja gå igenom frågorna för att se att de går att använda och är relevanta. Jag skulle använda utdata som ett första utkast. I varje syntetisk uppsättning jag granskat är vissa frågor felaktigt formade (de refererar till ”dokumentet” eller frågar om en rubrik), vissa referenssvar glider från vad källan faktiskt säger, och fraseringen är mer formell än någon verklig användares.
Kör generatorn igen när du lägger till en sektion i dokumentationen så får du kandidatfrågor för det nya materialet, till priset av en ny omgång domaranrop.
Varje rad har ett user_input, ett genererat reference-svar och reference_contexts, de bitar som frågan byggdes från. Kontrollera reference mot dessa bitar, för det är där drift dyker upp.
För att göra en granskad rad till en SingleTurnSample, kör din pipeline över user_input för att få retrieved_contexts och response. Lägg till de granskade user_input- och reference-paren i eval_questions.jsonl så fixar refresh_dataset.py resten åt dig.
Om din kunskapsbas är en graf snarare än en dokumenthög gäller samma princip med en annan hämtare. Våra tutorials Using a Knowledge Graph to Implement a RAG Application och kursen Graph RAG with LangChain and Neo4j producerar pipelines du kan utvärdera exakt med de fyra metrikerna ovan, eftersom metrikerna bara ser den hämtade texten, inte hur den hämtades.
Att spåra Ragas-poäng över tid innebär att lägga till medelpoängen, git-commit-hashen, domarmodellen och en tidsstämpel i en loggfil efter varje körning, så att en regression syns som en dipp på en linjegraf i stället för en överraskning i produktion.
En JSON Lines-fil är troligen bäst tills du behöver en delad experimentspårare för flera personer. track_scores.py läser scores.csv, som både quality_gate.py och run_all.py skriver, så den triggar aldrig en andra omgång domaranrop.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Att köra uv run python track_scores.py lägger till en rad i loggen och skriver ut den:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
I CI börjar varje jobb med en tom disk, så ragas_history.jsonl innehåller bara den körningens post. För att hålla en trend, ladda ned de uppladdade artefakterna och lägg till dem i en fil, eller committa filen till en metrics-branch eller objektlagring.
Att plotta historiken är ganska enkelt. Prova följande skript:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Du får en graf som ser ut ungefär så här:
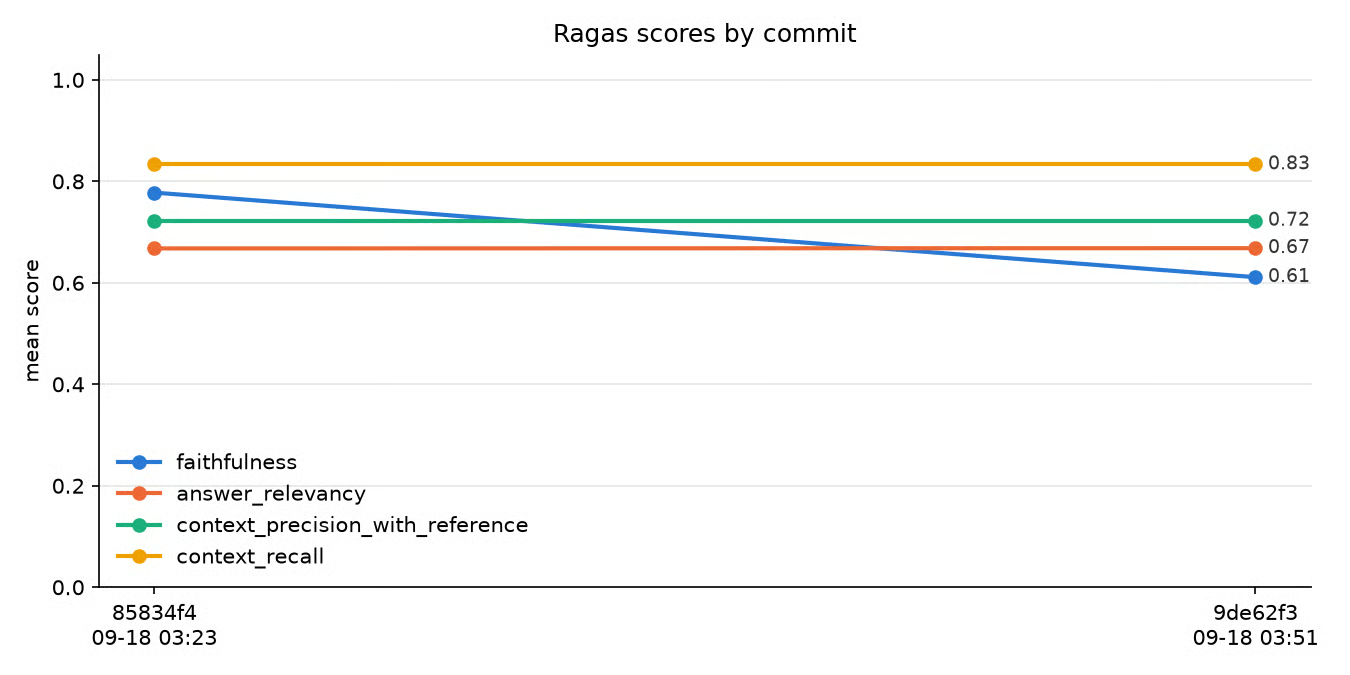
Medel-Ragas-poäng loggade per commit av track_scores.py. Bild av författaren.
Inget i pipelinen ändrades mellan de commiten (den andra ändrade bara domarklientens anslutningsinställningar), ändå föll faithfulness från 0,78 till 0,61 eftersom avböjningen i sample 6 flippade från 1,0 till 0,0.
Det finns alltså verkligt domarbrus att se upp för tills du har ett stort antal sample. Med sex sample flyttar en fladdrig dom medlet med 0,17. Med 100 sample flyttar samma flip det med 0,01, så en stor förändring är mycket mer sannolikt en verklig regression.
Nu kan du, med varje pull request eller commit, köra grinden, logga poängen och titta på grafen.
Om du överväger en större arkitektonisk förändring, ramar vår tutorial RAG vs. finjustering in avvägningen, och samma fyra metriker fungerar som före- och eftermätning för båda vägarna.
LLM-as-a-judge-poäng är uppskattningar: de har kända biaser och kan ändras mellan körningar, men de skalar till utvärderingsvolymer som mänsklig granskning inte kan.
Ragas ber aldrig domaren jämföra två svar, så positionsbias (gynna det svar som kommer först) gäller mest inte. Verbositetsbias (gynna längre svar) och självpreferensbias (domare som föredrar svar från sin egen modell) kan fortfarande spela roll. Zheng m.fl. (2023) beskriver alla tre biaser, och självpreferens är varför jag inte skulle använda samma modell som generator och domare.
Variation mellan körningar är delen jag vill att du ser med egna ögon, för den ändrar hur du sätter trösklar. Över körningar av samma sex sample med samma låsta domare fick avböjningssvaret i sample 6 0,0 i en körning och 1,0 i en annan på faithfulness, och det helt förankrade sample 5 fick 0,667 i körningen ovan.
Per-sample-poäng från en billig domare är brusiga. Medel över 100 sample är mycket mindre brusiga, och CI-grinden bör alltid testa medelvärdet.
Tre arbetssätt håller bruset i schack:
judge.py och track_scores.py gör ovan, så att en domarändring aldrig misstas för en pipelineändring.För en bredare rundtur i utvärderingsmetoder bortom RAG, inklusive de mänskliga metoder som domaren ersätter, täcker vår LLM-utvärderingsguide metriker och metodik. Vår LLM som domare-tutorial går djupare på att bygga en domare för RAG-pipelines.
Poängen med den här pipelinen är att den låter oss säga saker som ”hämtaren är okej, prompten försämrades” eller ”rerankern fixade precisionen men recall är fortfarande 0,6”, med siffror bakom påståendet.
Faithfulness och answer relevancy bevakar generatorn: faithfulness fångar påhittade fakta, och answer relevancy fångar svar som driver bort från frågan. Context precision och recall bevakar hämtaren och talar om huruvida den plockar rätt information. Eftersom två av fyra inte behöver referenssvar kan du köra dem på produktionstrafik där referens saknas.
Standardtextmått mäter ordöverlapp, vilket inte säger något om en påhittad återbetalningspolicy, och ett enda end-to-end-tal döljer vilken halva av pipelinen som gick sönder. Ett ramverk som kontrollerar de två felpunkterna separat kan se det, och att göra det till en CI-grind med en historikfil är det som får ditt team att agera på siffrorna.
Om du inte har byggt pipelinen ännu, börja med vår kurs Retrieval-Augmented Generation with LangChain och peka sedan den här artikelns pipeline.py mot det du bygger.
För pipelines som går bortom ren texthämtning bygger vår kurs End-to-End RAG with Weaviate, vår guide till multimodal RAG och vår agentic RAG-tutorial system som du kan poängsätta på samma sätt, med en brasklapp: de fyra kärnmetrikerna läser bara text. En pipeline som hämtar bilder behöver Ragas separata multimodala metriker, och en agentisk pipeline behöver varje hämtarsteg poängsatt som sin egen fråga, bitar och svar.
Top DataCamp Courses
Kurs
Kurs
Kurs