
Kurs
LangChain ve Neo4j ile Graph RAG
3 sa
2.3K
Bir sohbet botu için alma-artırmalı üretim (RAG) hattı, defterdeki tüm duman testlerinden geçer. Ardından yanlış veya tuhaf yanıtlarla ilgili destek bildirimleri gelmeye başlar ve duman testi günlüklerinde hiçbir uyarı görünmez.
Bu arızayı yakalamak zordur çünkü metrikler olmadan görünmezdir. Bir RAG hattının yanlış gidebileceği 2 yer vardır: toplayıcı yanlış parçaları getirebilir veya üreteç iyi parçaları görmezden gelip uydurma yapabilir. Uçtan uca tek bir doğruluk sayısı hangisinin olduğunu söyleyemez, dolayısıyla neyi düzeltmeniz gerektiğini de söyleyemez.
Bu eğitimde, Python ile Ragas 0.4.3 kullanarak eksiksiz bir RAG değerlendirme hattı kuracağım: elle oluşturulmuş bir değerlendirme veri kümesi, 4 çekirdek metrik (sadakat, yanıt ilgililiği, bağlam kesinliği ve bağlam duyarlılığı), puanlar düştüğünde derlemeyi başarısız kılan sürekli tümleştirme (CI) kalite kapısı, sentetik test kümesi üretici ve bir JSON Lines puan takipçisi.
Daha önce arka plan isterseniz, RAG nedir kılavuzumuza, RAG hatlarını değerlendirmek için bir büyük dil modelini (LLM) hakem olarak kullanma eğitimimize ve ileri RAG tekniklerine genel bakışımıza göz atın.
Python 3.9 veya daha yenisine (ben 3.12 kullanıyorum), uv veya pip", OpenAI uyumlu bir hakem model için bir API anahtarına ve bir RAG hattının nasıl çalıştığına dair kabaca bir fikre ihtiyacınız var. Önce bu temele ihtiyaç duyarsanız, bu yazıda puanlayacağımız türde bir hattı inşa eden LangChain ile Retrieval-Augmented Generation kursumuzu öneririm.
BLEU (Bilingual Evaluation Understudy) ve ROUGE (Recall-Oriented Understudy for Gisting Evaluation) gibi metin-örtüşme metrikleri, RAG için yanlış ölçüdür. Ragas bunun yerine her yanıtı 4 eksende puanlamak için bir hakem LLM kullanır: sadakat ve yanıt ilgililiği üreteci teşhis ederken, bağlam kesinliği ve bağlam duyarlılığı toplayıcıyı teşhis eder.
Bu 4 sayıyı CI’da bir eşik arkasına koyup commit başına kaydederseniz, tek seferlik denetim yerine bir regresyon alarmınız olur.
Başlamadan önce bir uyarı. Ragas API’si 2 yılda iki kez değişti: v0.2 sözlük veri kümelerini SingleTurnSample ve EvaluationDataset ile değiştirdi ve v0.4 koleksiyon metriklerini (v0.3.9’da tanıtılmıştı) varsayılan yaptı ve eski evaluate() işlevini kullanımdan kaldırıldı olarak işaretledi.
Çevrimiçi eğitimlerin çoğu hâlâ v0.1 veya v0.2 kodu gösteriyor. Aşağıdakilerin tümü, Ekim 2026 itibarıyla güncel sürüm olan 0.4.3’te çalışır.
RAG’in kendi metriklerine ihtiyacı vardır çünkü klasik metin metrikleri bir yanıtın referans yanıtla kaç kelime paylaştığını sayar, oysa RAG sisteminde bozulan şey paylaşılan ifadeler değildir.
BLEU (Papineni ve ark., 2002) ve ROUGE (Lin, 2004) makine çevirisi ve özetleme için geliştirilmiştir; iyi bir çıktı referansla büyük ölçüde aynı kelimeleri kullanmalıdır. RAG yanıtı “14 gün” yerine “2 hafta” derse her ikisinde de düşük puan alır; buna karşılık iade politikasını uyduran akıcı bir yanıt, referanstaki kelimeleri yeniden kullanırsa iyi puan alabilir.
Daha derin sorun, bir RAG hattının 2 ayrı noktada başarısız olabilmesidir: toplayıcı yanlış bilgiyi seçebilir veya üreteç iyi bilgiyi görmezden gelip uydurabilir. Bir yanıt yanlış olduğunda, aşağıdakilerden hangisinin yaşandığını bilmeniz gerekir:
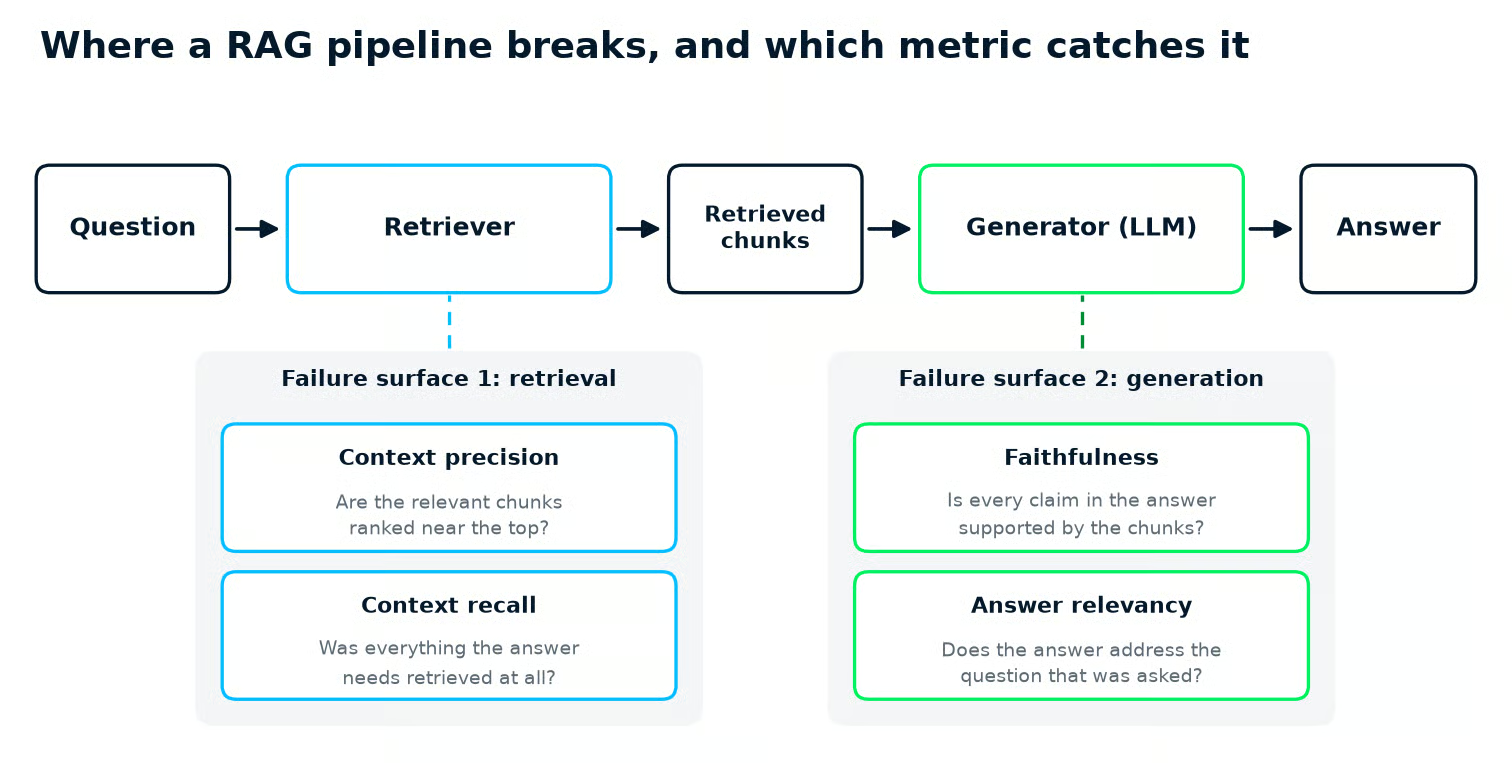
Bir RAG hattının 2 arıza modu: bağlam kesinliği ve duyarlılık toplayıcıyı, sadakat ve yanıt ilgililiği üreteci teşhis eder. Görsel: yazar.
Retrieval Augmented Generation (RAG) Nedir? Kapsamlı Kılavuz yazımız bu arızaların ortaya çıktığı hat aşamalarını adım adım anlatır.
Ragas, hattın her parçası için size bir sayı veren açık kaynak bir Python çatısıdır. Tek seçenek değildir. 2 ana alternatif, değerlendirmeyi pytest tarzı test vakalarına saran DeepEval ve LLM kontrollerini veri kümesine ek sütunlar olarak ekleyip bunları izleme raporlarına besleyen Evidently’dir.
| Çatı | En uygun alan | Yerleşik RAG’e özgü metrikler | Belgelerinizden test verisi | Yapılandırma stili |
|---|---|---|---|---|
| Ragas | RAG hatlarını teşhis etme | Sadakat, yanıt ilgililiği, bağlam kesinliği, bağlam duyarlılığı, bağlam varlıkları duyarlılığı, gürültü duyarlılığı | TestsetGenerator (açık kaynak) |
llm_factory()’den bir hakemle metrik nesneleri |
| DeepEval | CI’da birim test tarzı LLM testleri | Yanıt ilgililiği, sadakat, bağlamsal ilgililik, bağlamsal duyarlılık, bağlamsal kesinlik | Synthesizer (açık kaynak) |
LLMTestCase nesneleri, assert_test() ile deepeval test run üzerinden yürütme |
| Evidently | İzleme panoları ve zamana bağlı kayma | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Evidently Cloud’da RAG veri kümesi üretimi | Dataset üzerinde tanımlayıcılar, bir Report ile özetlenir |
Bu eğitim için Ragas’ı seçtim; çünkü 4 çekirdek metriği toplayıcı ve üreteç puanlarına temizce ayrılır ve test kümesi üreticisi aynı açık kaynak pakette gelir.
Ekibiniz zaten pytest içinde yaşıyorsa, DeepEval’in assert_test() yöntemi daha doğal gelecektir. İstediğiniz şey canlı trafik kalitesinin bir panosuysa, Evidently’nin raporları sizi daha hızlı oraya götürür.
Ragas’ı kurmak, paketi yüklemek, bir bağımlılığı sabitlemek ve her metriğin paylaşacağı bir hakem LLM seçmek anlamına gelir. Ben, tam paket sürümlerini sizin için kilitlediği için uv kullanacağım, ancak aynı sürümlerle pip install da çalışır.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Burada Python 3.12 kullanıyorum. Ragas 0.4.3, Python 3.9 ve yenilerini desteklediğini belirtir.
rapidfuzz paketi, yazının ilerleyen kısmındaki sentetik test kümesi üreticisi tarafından gereklidir. Ragas bunu bir bağımlılık olarak bildirmediğinden, baştan kuruyorum.
langchain-community<0.4 sabitlemesi bu yazı yazılırken isteğe bağlı değildir. Ragas 0.4.3, ChatVertexAI’yi langchain-community 0.4’ün kaldırdığı bir modül yolundan içe aktarır, bu nedenle sabitleme olmadan taze bir kurulumda ragas’ı içe aktardığınızda hata alırsınız.
Sırada hakem var. Ragas’taki LLM tabanlı her metrik, bir hakem modele 1 veya daha fazla çağrı yapar; bu yüzden onu bir kez oluşturur ve her yerde geçirirsiniz. Ben bunu judge.py adında ayrı bir modülde tutuyorum ve anahtarı git’e hiçbir kimlik bilgisinin düşmemesi için ortamdan okuyorum.
Bu dosya, OpenAI’ı doğrudan veya Google’ın OpenAI uyumlu uç noktası üzerinden Gemini’yı nasıl çağıracağınızı gösterir.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
İlk çalıştırmanızı sekteye uğratabilecek iki ayrıntı:
llm_factory() bir istemci nesnesi ister; yalnızca model adı geçmek hata verir.llm_factory()’ye ilettiğiniz ek ayarlar doğrudan model çağrısına gider; böylece max_tokens değerini varsayılan 1.024’ün üzerine bu şekilde çıkarıyorum.Elde elle kontrol ettiğiniz bir örnek üzerinde istikrarlı puanlar üreten en ucuz modeli kullanın ve sonra onu sabitleyin. Geniş bir değerlendirme setinde hacim hızla artar: sadakat örnek başına 2 hakem çağrısı yapar, yanıt ilgililiği 3 çağrı artı 2 gömme çağrısı yapar, bağlam kesinliği getirilen her parça başına 1, bağlam duyarlılığı ise 1 çağrı yapar.
4 metrikte 6 örnek tek bir çalıştırmada 62 isteğe geldi: 50 hakem çağrısı artı 12 gömme çağrısı. İşte 19 Ekim 2026 itibarıyla 3 güncel küçük hakem modelinin, her sağlayıcının liste fiyatına göre maliyeti:
| Hakem modeli | 1M token başına giriş | 1M token başına çıkış | Kaynak |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI fiyatlandırma |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API fiyatlandırma |
| claude-haiku-5-5 | $0.10 (100K token’a kadar istemler) | $0.50 (100K token’a kadar istemler) | Claude API fiyatlandırma |
judge.py içindeki varsayılan hâlâ OpenAI’ın fiyatlandırma sayfasındaki ana tabloya listelenmeyen eski bir OpenAI modeli olan gpt-4o-mini’dir. Değiştirmek için JUDGE_MODEL değişkenini ayarlayın.
Hakem olarak Claude’u istiyorsanız bir pürüz var: yanıt ilgililiği ayrıca bir gömme modeline ihtiyaç duyar ve Anthropic bir gömme modeli sunmaz. Belgeleri Voyage AI’a işaret eder; dolayısıyla Claude’u başka bir sağlayıcıdan gömmelerle eşlersiniz.
Seçimden çok sabitleme önemlidir. Hakem modelini değiştirmek, hattınız değişmemiş olsa bile puanları kaydırır; bu da az sonra takip bölümünde kuracağınız trend çizgisini bozar.
Model adını sürüm kontrolünde judge.py içine koyun ve bir hakem yükseltmesini, diğer kırıcı değişiklikler gibi ele alın: her eşiği yeni hakemin puanlarına göre sıfırlayın.
Veri kümesindeki her test vakası bir örnektir (sample). Bir örnek, yalnızca bir yanıttan fazlasıdır: hattın bir tam turunu 4 alanla kaydeder:
| Alan | Ne tutar |
|---|---|
user_input |
Müşterinin sorduğu soru |
retrieved_contexts |
Toplayıcının o soru için döndürdüğü parçalar |
response |
RAG hattının verdiği yanıt |
reference |
Doğru yanıt, bir kişi tarafından yazılmış |
Ragas her örneği bir SingleTurnSample olarak ve tüm seti bir EvaluationDataset olarak saklar. reference isteğe bağlıdır, ancak getirme metrikleri ona göre karşılaştırma yaptığından, küratörlü sette her zaman dahil ederim; referansa ihtiyaç duymayan metrikler onu görmezden gelse de.
Kurgusal bir kahve kavurucusu olan Northwind Coffee için 6 örnek oluşturdum. Aşağıdaki her metrik bölümü, o metriğin yakalaması gereken örneği ekler.
build_dataset.py’ye ilk 3 örnekle başlayın: temiz bir yanıt, kasıtlı bir halüsinasyon ve birden çok iddiayı aynı anda içeren ikinci bir temiz yanıt.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Getirilen her bağlam, Northwind’in yardım merkezi sayfalarının bir parçasıdır ve bir toplayıcının bunları üreteceğe teslim edeceği şekilde tam olarak betiğe yazılmıştır. uv run python build_dataset.py komutunu çalıştırarak eval_dataset.jsonl ve eval_questions.jsonl dosyalarını yazın ve sonraki bölümler bir örnek eklediğinde yeniden çalıştırın.
JSON Lines’a kaydetmek önemlidir; çünkü sonraki her betik (metrik çalıştırmaları, CI kapısı) aynı eval_dataset.jsonl dosyasını EvaluationDataset.from_jsonl() ile yükler.
Gerçek bir projede, retrieved_contexts ve response alanları, gerçek hattınızı sorular üzerinde çalıştırmaktan gelir ve yalnızca user_input ile reference elle yazılır. CI bölümü bu adımı nasıl otomatikleştireceğinizi gösterir.
Bu yazının sonunda oluşan 6 örnek, metrikleri öğrenmek için yeterlidir ama bir eşiğe güvenmek için yeterli değildir. Gerçekten güvenmeden önce yaklaşık 100 örneği hedefleyin; takip bölümü nedenini gösterir. Kaça ihtiyacınız olduğu kullanım alanınızın katılığına bağlıdır; bu yüzden belirli bir sayıdan çok iyi bir karışıma odaklanıyorum:
4 çekirdek Ragas metriği üreteç için sadakat ve yanıt ilgililiği; toplayıcı için bağlam kesinliği ve bağlam duyarlılığıdır. Hepsi 0 ile 1 arasında bir puan döndürür. Faydalı olan, her sayının size neyi düzeltmeniz gerektiğini söylemesidir.
Sadakat, bir yanıtın ne kadarının getirilen parçalarla desteklendiğini ölçer. Hakem yanıtı bireysel iddialara böler, ardından her iddiayı parçalara göre kontrol eder: 1,0 puan her iddianın desteklendiği, 0,0 puan hiçbirinin desteklenmediği anlamına gelir.
Sadakat, bir referans yanıta ihtiyaç duymaz; bu nedenle yalnızca test setinizde değil, canlı üretim trafiğinde de çalıştırabilirsiniz. Halüsinasyonları en sık oluşturan değişiklikler bunlar olduğundan, anımsatıcıyı, modeli veya modelin gördüğü bağlam miktarını değiştirdiğinizde yeniden çalıştırın.
Bir yanıt üzerinde, veri kümesi gerektirmeden hızlıca görmek için en kestirme yol şudur:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
uv run python quick_check.py ile çalıştırın; faithfulness = 0.00 yazdırır; çünkü yanıttaki iddiaların (6 ay, ücretsiz paket) hiçbiri bağlam tarafından desteklenmez. 0.4’te puanlama, her metriğin ascore() yöntemiyle yapılır ve bu yöntem, puanı .value alanında tutan bir sonuç döndürür.
Şimdiye kadarki veri kümesi genelinde puanlandığında, örnek 2’deki yerleştirilmiş halüsinasyon olması gerektiği gibi 0,0 alır ve her iki temiz örnek 1,0 alır. Her metrik için tam sonuçlar aşağıdaki çoklu metrik bölümündedir.
Yanıt ilgililiği, yanıtın gerçekten soruyu ele alıp almadığını ölçer. Hakem yanıtı okur ve bu yanıta iyi karşılık gelecek 3 soru yazar; ardından Ragas, bu soruların anlamca özgün soruya ne kadar yakın olduğunu bir gömme modeli kullanarak kontrol eder. Yanıt sorudan kaçarsa, hakem onu kaçamak olarak işaretler ve puanı 0 olur.
Ragas sınıfı AnswerRelevancy olarak adlandırır (eski örneklerde ResponseRelevancy denir ve doküman sayfasının başlığı Response Relevancy’dir) ve hem hakem LLM’ye hem de gömme modeline ihtiyaç duyar.
Düşük ilgililik puanı ile yüksek sadakat puanı genellikle üreteci veya anımsatıcıyı işaret eder: modelin doğru bağlamı vardı ve ona bağlı kaldı ama sorulandan farklı bir soruya yanıt verdi. Yine de önce bağlam kesinliği ve duyarlılığı kontrol edin; çünkü ilgisiz parçalar döndüren bir toplayıcı da aynı deseni üretebilir.
Bu örnek üreteç durumunu gösterir. Toplayıcı doğru kargo parçasını döndürür, yanıt temellidir ve gönderim ücretinden ziyade kavurma tarihinden bahseder. Yeni parçayı build_dataset.py’nin başındaki parçalara ekleyin:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Ardından yeni örneği samples listesinin sonuna ekleyin:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Her örnek bir ilgililik puanı alır: hakemin yanıttan yazdığı soruların, örneğin sorduğu soruyla ne kadar eşleştiği; 1,0 mükemmel eşleşmedir.
Bağlam kesinliği, yararlı parçaların toplayıcının döndürdüğü listede üst sıralarda yer alıp almadığını kontrol eder; bağlam duyarlılığı ise doğru yanıtı yazmak için gereken her şeyin bulunup bulunmadığını kontrol eder.
Kesinlik, yararlı bir parça sıralamada ne kadar yukarıdaysa daha fazla kredi verir; bu nedenle ilk sıradaki yararlı bir parça, üçüncü sıradaki aynı parçadan daha çok sayılır. Duyarlılık, referans yanıttaki olguların, getirilen parçalardan en az biri tarafından desteklenen payıdır.
Her ikisi de reference alanını ister. Koleksiyonlar API’sinde sınıflar ContextPrecisionWithReference ve ContextRecall’dur ve her ikisi de yalnızca hakem LLM’yi alır. Ragas belgeleri, referans tabanlı sürüm için kısaca ContextPrecision adını da kullanır; bu yüzden ikisini de görebilirsiniz.
Şimdiye dek her örnek doğru parçaları önce getiriyor; bu yüzden hiçbir metrik yakalanacak bir şey bulamıyor. Getirmeyi farklı şekillerde bozan 2 örnek ekleyelim: doğru parçanın getirildiği ama en sona sıralandığı bir örnek ve hiç alakalı bir şeyin getirilmediği, bu yüzden modelin doğru şekilde geri çevirdiği bir örnek. Önce, parçaları dosyanın başına ekleyin:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Sonra örnekleri listenin sonuna ekleyin:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Sıralama önemlidir; çünkü çoğu hat yalnızca ilk birkaç parçayı modele geçirir; bu nedenle ilk 5’lik bir toplayıcıda 6. sıradaki yararlı bir parça, yok hükmündedir.
Örnek 5, tek yararlı parçasını 3’te son sıraya koyar ve kesinlik 0,333 olarak döner; çünkü tek yararlı bilgi en sonda sıralanmıştır. Örnek 6, getirme kaçırması, hem kesinlikte hem duyarlılıkta 0,0 alır.
Örnek 6 sadakat hakkında da bir şey öğretir. Model doğru şekilde reddetti; yine de bu red, arada hiçbir şey değişmemesine rağmen bazı çalıştırmalarda sadakatte 1,0, bazılarında 0,0 aldı. “Garanti hakkında bilgim yok” gibi bir ifade bağlam tarafından ne desteklenir ne de çürütülür ve hakem bu konuda yazı tura atar.
Hattınızın reddetmesi gerekiyorsa, bunları sadakattan ayrı puanlayın; böylece sadakatin etrafta savrulmasına izin vermemiş olursunuz. Ragas 0.4, koleksiyon API’sinden AspectCritic’i kaldırdı; bu yüzden yerini @discrete_metric dekoratörüyle oluşturulan özel bir kontrol alır (bkz. v0.3’ten v0.4’e geçiş rehberi).
2 getirme sayısını birlikte okuyun; size gelecek haftayı nerede geçirmeniz gerektiğini söyler:
| Bağlam kesinliği | Bağlam duyarlılığı | Teşhis | Ne değiştirilmeli |
|---|---|---|---|
| Yüksek | Yüksek | Getirme sağlıklı | Üretece odaklanın: anımsatıcı, model, sadakat |
| Düşük | Yüksek | Doğru parçalar getirildi ama kötü sıralandı | Bir yeniden sıralayıcı ekleyin veya ayarlayın |
| Yüksek | Düşük | Üst parçalar alakalı ama eksik | Modele daha fazla parça geçin, daha büyük parçalar kullanın ya da parçaların nerede bölündüğünü inceleyin |
| Düşük | Düşük | Toplayıcı geniş ölçüde başarısız | Gömme, indeksleme ve sorgu yeniden yazmayı gözden geçirin |
“Düşük kesinlik, yüksek duyarlılık” satırı pratikte en sık gördüğüm ve en ucuza düzeltilebilen durumdur.
RAG için Yeniden Sıralama Aracısı olarak RankGPT eğitimimiz, mevcut bir toplayıcının üzerine bir LLM yeniden sıralayıcı ekler; RAG ve Yeniden Sıralama ile LLM Doğruluğunu Artırın eğitimimiz başka bir yeniden sıralama kurulumunu gösterir. RAG performansını iyileştirmenin 5 temel tekniği kılavuzumuz, diğer satırlar için parçalama ve sorgu yeniden yazmayı kapsar.
Her değişiklikten sonra 2 getirme metriğini yeniden çalıştırın; tablo işe yarayıp yaramadığını söyler.
Tam bir çoklu metrik değerlendirme, tüm 4 metriği her örnek üzerinde paralel olarak çalıştırır ve puanları toplar; başarısızlıklara inmek için satır bazında değerler ve pano için sütun ortalamalarıyla.
Ragas 0.2 ve 0.3’te bunu evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)) ile yapardınız. 0.4.3’te bu işlev hâlâ vardır; ancak kullanımdan kalktı uyarısı verir ve yeni metrikleri doğrudan reddeder; çünkü artık beklediği eski Metric sınıfından türemezler.
Yerine @experiment dekoratörü geçmiştir; bu, hattınızı ve metriklerinizi birlikte bir Dataset üzerinde çalıştırır ve sonuçları CSV’ye yazar. Çağrılacak bir hattınız olduğunda doğru araç budur.
Statik bir veri kümesini puanlamak için, küçük bir yardımcıyı daha berrak buluyorum: her betiğin ihtiyaç duyduğu 4 metriği bir kez kurar ve paralel çağrıları ile hata işlemeyi okuyabildiğim bir kodda tutar:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Tek belirsiz satır inspect.signature() çağrısıdır. 4 metrik farklı girdiler ister (sadakat yanıtı ister, duyarlılık bunun yerine referansı ister); bu yüzden yardımcı, her metriğin ascore() yönteminin kabul ettiği argümanları okur ve örnekten tam bu alanları geçirir; böylece tek bir döngü tüm metriklere hizmet eder.
Semafor, aynı anda çalışan hakem çağrılarının sayısını sınırlar ve yine de başarısız olan bir metrik, tüm çalışmayı yarıda kesmek yerine boş (NaN) bir hücreye dönüşür. Bunu bir Jupyter defteri içinde çalıştırırsanız, zaten bir döngü çalıştığı için asyncio.run başarısız olur. Önce nest_asyncio.apply() çağırın (Ragas zaten buna bağımlıdır) veya coroutine’i doğrudan await edin.
Yardımcı hazır olduğunda, tam çalıştırma kısadır:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
İşte ilk çalıştırmamdan, sadakate göre sıralanmış ve 3 ondalığa yuvarlanmış puanlar, en altta ortalamalarla:
| Soru | Sadakat | Yanıt ilgililiği | Bağlam kesinliği | Bağlam duyarlılığı |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Ortalama | 0.778 | 0.668 | 0.722 | 0.833 |
Aynı veri kümesinin sonraki çalıştırmaları, izleme bölümünde ele aldığım red örneği yazı tura etkisi nedeniyle sadakati daha düşük puanladı.
Sadakate göre sıralamak, en olası halüsinasyonları seçmenize yardımcı olur ve yerleştirilen örnek en üsttedir. Son satırdaki ortalamalar pano rakamlarınızdır.
Satırlar boyunca okuyun; yerleştirilen her arıza farklı bir yerde görünür. Halüsinasyon yalnızca sadakati düşürür. Getirme kaçırması ilgililiği, kesinliği ve duyarlılığı birlikte sıfırlar. Sıralama problemi kesinliği 0,333’e indirir ve kayma, yanıtlanan sorular arasında en düşük ilgililik olarak ortaya çıkar.
Bir gariplik: Kanada yanıtı, parçası tarafından tamamen desteklenmektedir; yine de sadakatte 0,667 aldı. Bu, izleme bölümüne geri döneceğim hakem gürültüsüdür.
Yanıt ilgililiği anlamı gömmelerle karşılaştırır; bu yüzden iyi bir yanıt bile nadiren 1,0’a yakın puan alır: iade yanıtı 0,746 alırken, konu dışına kayan gönderim yanıtı 0,572 aldı. İlgililiği mutlak sayıya göre değil, örnekler arasındaki farka ve zaman içindeki trende göre değerlendirin.
Bir RAG kalite kapısı, değerlendirmeyi çalıştıran, her ortalama puanı bir eşiğe karşı karşılaştıran ve herhangi bir metrik eşiğin altına düştüğünde bir hata koduyla çıkan bir test betiğidir; bu da CI sistemine birleştirmeyi engellemesini söyler.
Önce bir pürüz. Daha önceki elle oluşturulmuş veri kümesi, yanıtlarını ve getirilen parçaları elle yazılmış içerir; bu yüzden onu puanlamak, anımsatıcıya veya toplayıcıya yapılan bir değişikliği asla yansıtamaz. CI’da, kaydedilmiş sorularınız üzerinde gerçek hattınızı yeniden çalıştırmanız ve sonra ürettiklerini puanlamanız gerekir. Bunu iki küçük betik yapar.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py yazdığınız tek dosyadır: answer() gövdesini, toplayıcınıza ve üretecinize yapılan bir çağrı ile değiştirin. refresh_dataset.py, build_dataset.py’nin kaydettiği soruları ve referans yanıtları okur, her soru üzerinde hattı çalıştırır ve eval_dataset.jsonl dosyasını yeniden yazar.
Kapının kendisi, eşiklerden oluşan bir sözlük ve bir döngüdür. Aşağıdaki eşikler, elle oluşturulmuş örnek veri kümesi üzerinde kalibre edilmiştir; bu yüzden güvenmeden önce kendi hattınızın çıktısı üzerinde yeniden kalibre edin.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Benim temel setimde, tüm 4 ortalama, eşiklerini geçer ve betik 0 koduyla çıkar; bu da birleştirmeye izin verir:
| Metrik | Ortalama | Eşik | Sonuç |
|---|---|---|---|
| Sadakat | 0.778 | 0.60 | Geçti |
| Yanıt ilgililiği | 0.668 | 0.60 | Geçti |
| Bağlam kesinliği | 0.722 | 0.65 | Geçti |
| Bağlam duyarlılığı | 0.833 | 0.75 | Geçti |
Hakem gürültüsü nedeniyle sadakat eşiğini 0,70 yerine 0,60 olarak ayarladım; bunu izleme bölümünde ele alıyorum. 6 örnekle, tek bir oynak hüküm ortalamayı 0,17 kaydırır ve değişmeyen hattın daha sonraki bir çalıştırması 0,61 puan aldı. Kapı ayrıca hakemi 3 kez çalıştırır ve puanları ortalar (GATE_RUNS); bu, tek hüküm oynamalarını hakem maliyetinin 3 katı pahasına yumuşatır.
Bir tasarım seçimi, actual >= threshold durumunun sağlanmaması hâlinde başarısız olmaktır; actual < threshold değil. NaN’a (sayı değil) karşı yapılan bir karşılaştırma her zaman Yanlıştır; bu yüzden actual < threshold olarak yazılmış bir kontrol, hakem her başarısız olduğunda derlemeyi geçirirdi.
Ortalamadaki skipna=False kısmi durumu kapsar. pandas varsayılan olarak NaN’ı atlar; dolayısıyla birkaç başarısız hakem çağrısı, kapıyı başarısız kılmak yerine örneği sessizce küçültürdü. Artık geçici bir hakem hatası derlemeyi başarısız kılar; bu yüzden hata ayıklamadan önce işi yeniden çalıştırın.
Eşikleri ayarlamak zordur. Onları, tekrarlı çalıştırmalar boyunca gördüğünüz en düşük ortalamanın biraz altına koyun; ulaşılması zor 0,9 gibi bir değere değil; yoksa kapı her isteği engeller ve ekip CI’a güvenmeyi bırakır. Hakem modelini değiştirdiğinizde veya bir avuçtan fazla örnek eklediğinizde onları yeniden ayarlayın.
GitHub Actions’a bağlamak kısa bir iş akışıdır. İş akışı söz dizimi başvurusu, burada kullanılan on.pull_request yol filtrelerini ve schedule cron’unu kapsar:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Bu iş akışındaki birkaç ayrıntı önemlidir:
JUDGE_MODEL ve eşleşen API anahtarıyla sabitlenir. Eşikleri kalibre ettiğiniz hakemi kullanın; yoksa CI’daki puanlar, izlenen geçmişinizle karşılaştırılabilir olmaz.GATE_SAMPLE sabit bir 30 satırlık alt küme puanlar; böylece bir inceleme, hakem çağrılarında 10 dakika beklemez. Gecelik cron her şeyi puanlar.scores.csv ve ragas_history.jsonl dosyalarını bir yapıt olarak yükler.Kimsenin beklemediği gecelik cron’da tam seti çalıştırın. Başarısız bir gecelik çalışma, başarısız bir iş akışı olarak görünür ve GitHub’ın bildirim ayarları veya bir Slack adımı, sahibi sabah bilgilendirebilir. GitLab CI’da da rules: changes: ve bir pipeline schedule ile aynı şekildedir.
Ragas, belgelerinizi okuyarak, ana konularını ve olgularını çıkararak, ilişkili parçaları bağlayarak ve bu bağlantılardan farklı türlerde sorular yazarak sentetik test soruları üretir.
Test verisi üretimi dokümanları sorguları tek atlamalı (tek parça yanıtlayabilir) ve çok atlamalı (yanıtın birkaç parçaya ihtiyaç duyduğu) olarak ayırır; bunların her biri de spesifik veya soyut olabilir. Varsayılan karışım, bu 4 kombinasyonun 3’ünü eşit paylarla kullanır:
Ragas yalnızca belgelerinizin destekleyebileceği sentezleyicileri kullanır; bu nedenle küçük bir belge seti farklı bir karışım üretebilir.
Üretici, okunacak gerçek belgelere ihtiyaç duyar. Onu, markdown dosyaları olarak kendi dokümantasyonunuza yönlendirin. Bu yazı için Northwind adına 5 kısa yardım merkezi sayfası yazdım (toplamda ~600 kelime) ve her biri şöyle görünür:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Kendi belgeleriniz, aşağıdakilerden farklı sorular üretecektir ki amaç da budur: üretici, bilgi tabanınızın gerçekten söylediği şeyler hakkında sorular yazar.
TestsetGenerator, zaten kurduğumuz aynı hakem LLM’yi ve gömme modelini alır. Dokümanları, markdown dosyalarının ağır unstructured bağımlılığını çekmemesi için açıkça TextLoader kullanarak LangChain’in DirectoryLoader’ı ile yüklüyorum.
Belgelerinizi haritalamak, aynı anda çok sayıda hakem çağrısı tetikler; bu yüzden RunConfig ile paralelde çalışacak sayıyı da sınırlıyorum:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Betik tüm 5 belgeyi yükler ve şu 8 soruyu yazar. Sorular belgelere paraleldir ve bazıları kasıtlı yazım hataları içerir:
| # | Üretilen soru | Soru türü |
|---|---|---|
| 1 | how do i brew with a french pres | Tek atlamalı |
| 2 | Northwind equipment warranty | Tek atlamalı |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Tek atlamalı |
| 4 | how do I cancel Nortwind subscription? | Tek atlamalı |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Çok atlamalı |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Çok atlamalı |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Çok atlamalı |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Çok atlamalı |
Tablo sadeleştirilmiş etiketleri gösterir; çıktıda synthesizer_name sütunu tam sentezleyici adını tutar. 5 belgeden 8 soru ~4,5 dakika sürdü.
Sorulardaki yazım hataları ve 2. sorudaki anahtar sözcük tarzı sorgu kasıtlıdır: üretici, setin sınav soruları değil de arama kutusu trafiğine benzemesi için her sorgunun stilini ve uzunluğunu çeşitlendirir.
Soruları kullanılabilir ve alakalı olduklarından emin olmak için muhtemelen gözden geçirmek isteyeceksiniz. Çıktıyı bir ilk taslak olarak kullanırdım. Gözden geçirdiğim her sentetik sette, bazı sorular kusurludur (“belge”yi referans alır veya bir başlık hakkında sorar), bazı referans yanıtlar kaynaktan gerçekten söylenenlerden sapar ve ifade biçimi gerçek bir kullanıcıdan daha resmidir.
Dokümanlara bir bölüm eklediğinizde üreticiyi yeniden çalıştırın; yeni malzeme için aday sorular elde edersiniz; bunun bedeli bir başka hakem çağrısı turudur.
Her satırda bir user_input, üretilmiş bir reference yanıt ve sorunun oluşturulduğu parçalar olan reference_contexts bulunur. Sapmalar burada ortaya çıktığı için reference’ı bu parçalara göre kontrol edin.
Gözden geçirilmiş bir satırı bir SingleTurnSample’a dönüştürmek için, user_input üzerinde hattınızı çalıştırarak retrieved_contexts ve response alın. Gözden geçirilmiş user_input ve reference çiftlerini eval_questions.jsonl dosyasına ekleyin; refresh_dataset.py bunu sizin için yapar.
Bilgi tabanınız bir belge yığını yerine bir grafikse, aynı ilke farklı bir toplayıcıyla geçerlidir. Bir Bilgi Grafiği Kullanarak RAG Uygulaması eğitimimiz ve LangChain ve Neo4j ile Graph RAG kursumuz, yukarıdaki 4 metrikle tam olarak değerlendirebileceğiniz hatlar üretir; çünkü metrikler sadece getirilen metni görür, nasıl getirildiğini değil.
Ragas puanlarını zaman içinde takip etmek, her değerlendirme çalıştırmasından sonra ortalama puanları, git commit karmasını, hakem modelini ve bir zaman damgasını bir günlük dosyasına eklemek demektir; böylece bir gerileme üretimde sürpriz olmak yerine bir çizgi grafikte düşüş olarak görünür.
JSON Lines dosyası, birkaç kişi için paylaşılan bir deney takipçisine ihtiyaç duyana kadar muhtemelen en iyi seçenektir. track_scores.py, quality_gate.py ve run_all.py’nin her ikisinin de yazdığı scores.csv’yi okur; böylece ikinci bir hakem çağrısı turunu asla tetiklemez.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
uv run python track_scores.py çalıştırmak, günlüğe bir satır ekler ve yazdırır:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
CI’da her iş boş bir diskle başlar; bu yüzden ragas_history.jsonl yalnızca o çalıştırmanın kaydını tutar. Bir trendi korumak için yüklenen yapıtları indirip tek bir dosyaya ekleyin veya dosyayı bir metrik dalına ya da nesne depolamaya işleyin.
Tarihi çizmek oldukça kolaydır. Aşağıdaki betiği deneyin:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Şuna benzer bir grafik elde edeceksiniz:
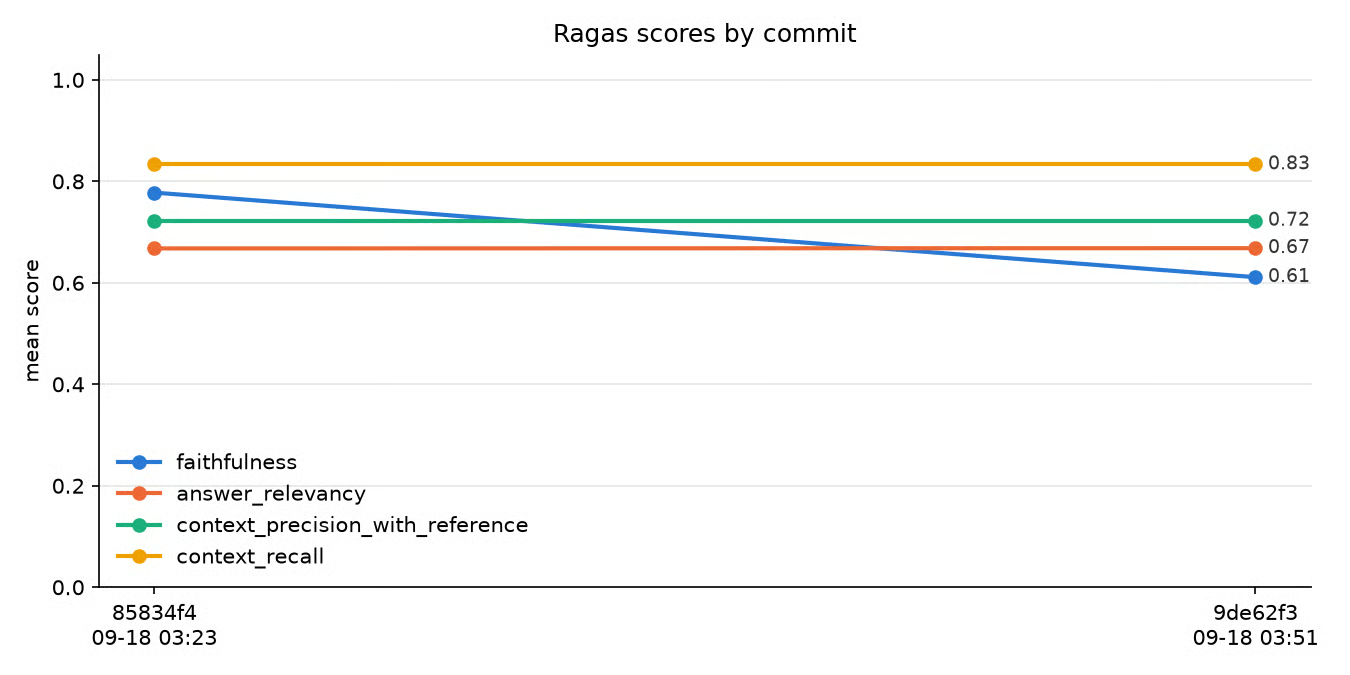
track_scores.py tarafından commit başına kaydedilen ortalama Ragas puanları. Görsel: yazar.
Bu commit’ler arasında hattan hiçbir şey değişmedi (ikincisi yalnızca hakem istemcisinin bağlantı ayarlarını değiştirdi); yine de örnek 6’daki red 1,0’dan 0,0’a döndüğü için sadakat 0,78’den 0,61’e düştü.
Dolayısıyla yeterli sayıda örneğiniz olana kadar dikkat etmeniz gereken gerçek bir hakem gürültüsü var. 6 örnekle, 1 oynak hüküm ortalamayı 0,17 kaydırır. 100 örnekle aynı oynama 0,01 kaydırır; bu yüzden büyük bir değişim çok daha olası şekilde gerçek bir gerilemedir.
Artık her çekme isteği veya commit ile kapıyı çalıştırabilir, puanları kaydedebilir ve grafiğe bakabilirsiniz.
Daha büyük bir mimari değişimi tartıyorsanız, RAG vs. ince ayar eğitimimiz dengeyi çerçeveler ve her iki yol için de öncesi-sonrası ölçümü olarak aynı 4 metrik çalışır.
Hakem olarak LLM puanları birer tahmindir: bilinen önyargıları vardır ve çalıştırmadan çalıştırmaya değişebilir; ancak insan incelemesinin yetişemeyeceği değerlendirme hacimlerine ölçeklenir.
Ragas, hakeme asla 2 yanıtı karşılaştırmasını istemez; bu nedenle konum önyargısı (ilk geleni tercih etme) çoğunlukla uygulanmaz. Çok sözlülük önyargısı (daha uzun yanıtlara kayırma) ve öz-tercih önyargısı (hakemlerin kendi modellerinden gelen yanıtları kayırması) yine de önemli olabilir. Zheng ve ark. (2023) her 3 önyargıyı açıklar ve öz-tercih, aynı modeli üreteç ve hakem olarak kullanmamamın nedenidir.
Çalıştırmadan çalıştırmaya değişim, eşikleri nasıl ayarladığınızı değiştirdiği için kendi gözlerinizle görmenizi istediğim kısımdır. Aynı 6 örneğin, aynı sabitlenmiş hakemle çalıştırmaları arasında, örnek 6’daki red yanıtı sadakatte bir çalıştırmada 0,0, diğerinde 1,0 aldı ve tamamen temelli örnek 5, yukarıda gösterilen çalıştırmada 0,667 aldı.
Ucuz bir hakemden örnek başına puanlar gürültülüdür. 100 örnek üzerindeki ortalamalar çok daha az gürültülüdür ve CI kapısı her zaman ortalamayı test etmelidir.
Gürültüyü sınırlayan üç uygulama:
judge.py ve track_scores.py’de olduğu gibi; böylece bir hakem değişikliği asla bir hat değişikliği ile karıştırılmaz.RAG’in ötesindeki değerlendirme yaklaşımlarına, hakemin yerine geçtiği insan değerlendirme yöntemleri de dahil olmak üzere daha geniş bir tur için, LLM değerlendirme kılavuzumuz metrikleri ve metodolojileri kapsar. Hakem olarak LLM eğitimimiz, RAG hatları için bir hakem oluşturmayı daha derinlemesine ele alır.
Bu hattın amacı, “toplayıcı iyi, anımsatıcı geriledi” ya da “yeniden sıralayıcı kesinliği düzeltti ama duyarlılık hâlâ 0,6” gibi şeyleri, iddianın arkasında sayılarla söylememize imkân vermesidir.
Sadakat ve yanıt ilgililiği üreteci izler: sadakat uydurulan olguları yakalar; yanıt ilgililiği, sorudan sapan yanıtları yakalar. Bağlam kesinliği ve duyarlılığı toplayıcıyı izler ve doğru bilgiyi çekip çekmediğini söyler. 4’ten 2’sinin referans yanıta ihtiyacı olmadığından, referansın olmadığı üretim trafiğinde de çalıştırabilirsiniz.
Standart metin metrikleri kelime örtüşmesini ölçer; bu, uydurulmuş bir iade politikası hakkında hiçbir şey söylemez ve tek bir uçtan uca sayı, hattın hangi yarısının bozulduğunu gizler. Arıza noktalarını ayrı kontrol eden bir çatı bunu görebilir ve bunu bir kerelik bir denetimden, geçmişi olan bir CI kapısına dönüştürmek, ekibinizin bu sayıların gereğini yapmasını sağlar.
Hattı henüz kurmadıysanız, LangChain ile Retrieval-Augmented Generation kursumuzla başlayın ve sonra bu yazının pipeline.py dosyasını inşa ettiğiniz yapıya yönlendirin.
Düz metin getirmeyi aşan hatlar için, Weaviate ile Uçtan Uca RAG kursumuz, çok modlu RAG rehberimiz ve ajan temelli RAG eğitimimiz, aynı şekilde puanlayabileceğiniz sistemler kurar; bir çekinceyle: 4 çekirdek metrik yalnızca metni okur. Görselleri getiren bir hat, Ragas’ın ayrı çok modlu metriklerine ihtiyaç duyar ve ajan temelli bir hat, her getirme adımının kendi soru, parça ve yanıtı olarak puanlanmasını gerektirir.
Öne Çıkan DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




