Kurs
Graph RAG z LangChain i Neo4j
3 godz.
2.3K
Pipeline RAG (retrieval-augmented generation) dla chatbota przechodzi wszystkie testy dymne w notatniku. Potem zaczynają spływać zgłoszenia do supportu o błędnych lub dziwnych odpowiedziach, a w logach z testów dymnych nie ma żadnych czerwonych flag.
Ten błąd trudno wychwycić, bo bez metryk jest niewidoczny. Pipeline RAG ma 2 miejsca, w których może pójść nie tak: retriever może pobrać nie te fragmenty, albo generator może zignorować dobre fragmenty i zmyślać fakty. Pojedyncza liczba trafności end-to-end nie powie ci, która z tych rzeczy się wydarzyła, więc nie powie też, co naprawić.
W tym tutorialu zbuduję pełny pipeline ewaluacji RAG w Pythonie, używając Ragas 0.4.3: ręcznie przygotowany zestaw danych do oceny, 4 kluczowe metryki (faithfulness, answer relevancy, context precision i context recall), bramkę jakości w CI, która przerwie build przy spadku wyników, generator syntetycznego zestawu testowego oraz tracker wyników w formacie JSON Lines.
Jeśli najpierw chcesz więcej kontekstu, zobacz nasz przewodnik po tym, czym jest RAG, nasz tutorial o użyciu dużego modelu językowego (LLM) jako sędziego do ewaluacji pipeline’ów RAG oraz przegląd zaawansowanych technik RAG.
Potrzebujesz Pythona 3.9 lub nowszego (ja używam 3.12), uv albo pip, klucza API do modelu sędziego kompatybilnego z OpenAI oraz ogólnego pojęcia o tym, jak działa pipeline RAG. Jeśli chcesz najpierw podstaw, polecam nasz kurs Retrieval-Augmented Generation with LangChain, w którym budujemy rodzaj pipeline’u, jaki będziemy tu oceniać.
Metryki pokrycia tekstu, takie jak BLEU (Bilingual Evaluation Understudy) i ROUGE (Recall-Oriented Understudy for Gisting Evaluation), to zła miara dla RAG. Ragas zamiast tego używa sędziego LLM do oceny każdej odpowiedzi w 4 osiach: faithfulness i answer relevancy diagnozują generator, a context precision i context recall diagnozują retriever.
Wstaw te 4 liczby za progiem w CI i loguj je per commit, a dostaniesz alarm regresji zamiast jednorazowego audytu.
Jedno ostrzeżenie na start. API Ragas zmieniło się dwukrotnie w 2 lata: w v0.2 słowniki danych zastąpiono przez SingleTurnSample i EvaluationDataset, a w v0.4 metryki „collections” (wprowadzone w v0.3.9) stały się domyślne, a stara funkcja evaluate() została oznaczona jako przestarzała.
Większość tutoriali w sieci nadal pokazuje kod z v0.1 lub v0.2. Wszystko poniżej działa na 0.4.3, czyli bieżącej wersji na październik 2026.
RAG potrzebuje własnych metryk, bo klasyczne metryki tekstowe liczą tylko, ile słów odpowiedź dzieli z odpowiedzią referencyjną, a wspólne sformułowania to nie to, co psuje się w systemie RAG.
BLEU (Papineni i in., 2002) i ROUGE (Lin, 2004) powstały dla tłumaczeń maszynowych i streszczeń, gdzie dobre wyjście powinno używać podobnych słów co referencja. Odpowiedź RAG, która mówi „masz 2 tygodnie” zamiast „14 dni”, dostaje słaby wynik w obu, a płynna odpowiedź, która zmyśla politykę zwrotów, może wypaść dobrze, jeśli przypadkiem użyje słów z referencji.
Głębszy problem polega na tym, że pipeline RAG może się zepsuć w 2 osobnych miejscach: retriever może wybrać złą informację, albo generator może zignorować dobrą informację i wymyślać fakty. Gdy odpowiedź jest błędna, musisz wiedzieć, co się stało:
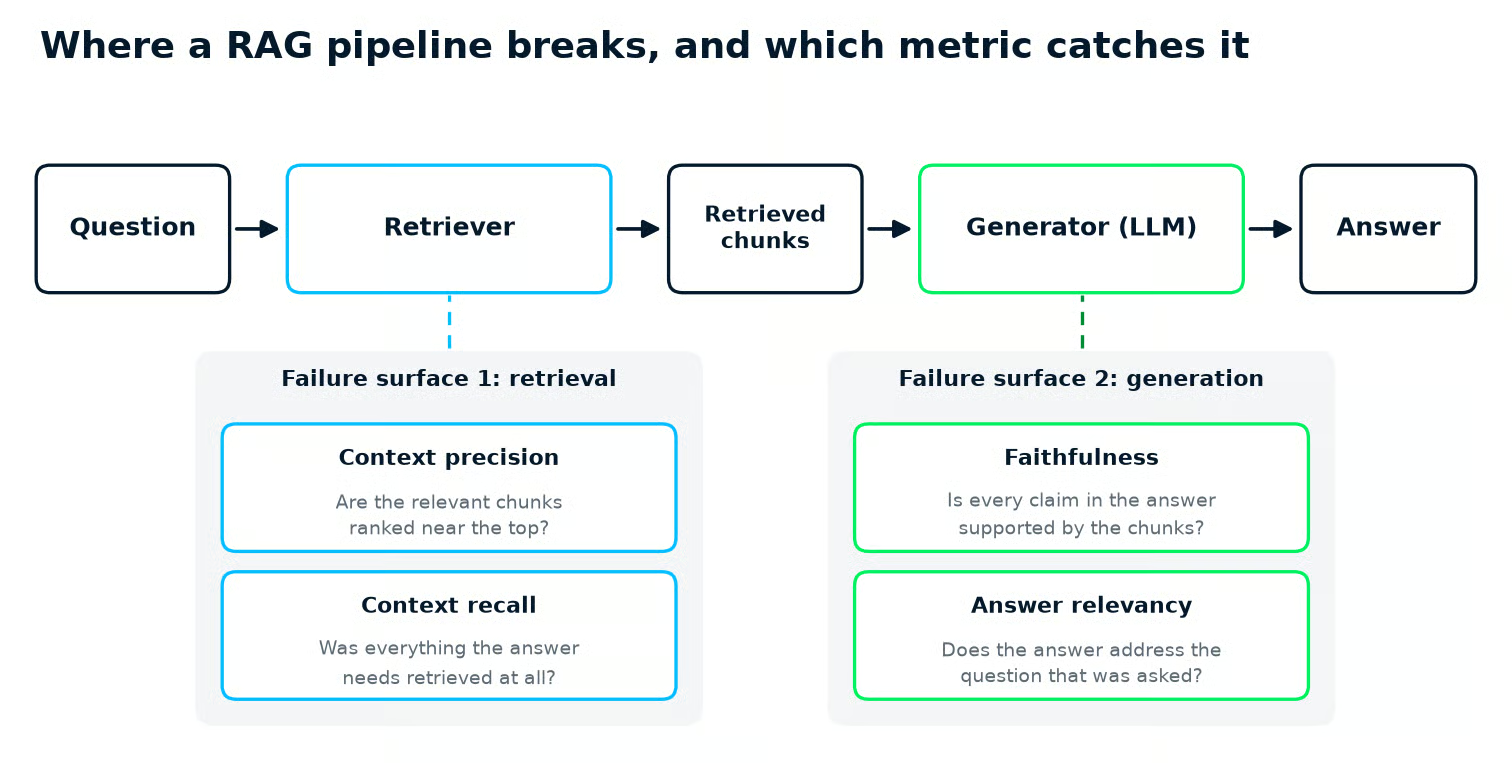
Dwa tryby awarii pipeline’u RAG: context precision i recall diagnozują retriever, a faithfulness i answer relevancy diagnozują generator. Ilustracja: autor.
Nasz artykuł What Is Retrieval Augmented Generation (RAG)? A Complete Guide omawia etapy pipeline’u, w których te błędy powstają.
Ragas to open-source’owy framework w Pythonie, który daje ci liczby dla każdej części pipeline’u. Nie jest to jedyna opcja. Dwie główne alternatywy to DeepEval, które opakowuje ewaluację w testy w stylu pytest, oraz Evidently, które dodaje sprawdzenia LLM jako dodatkowe kolumny w zbiorze danych i karmi nimi raporty monitorujące.
| Framework | Najlepsze do | Wbudowane metryki specyficzne dla RAG | Dane testowe z twoich dokumentów | Styl konfiguracji |
|---|---|---|---|---|
| Ragas | Diagnozowania pipeline’ów RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Obiekty metryk plus sędzia z llm_factory() |
| DeepEval | Testowanie LLM w CI w stylu testów jednostkowych | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Obiekty LLMTestCase, assert_test() uruchamiane przez deepeval test run |
| Evidently | Dashboardy monitorujące i drift w czasie | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Generowanie datasetu RAG w Evidently Cloud | Deskryptory na Dataset, podsumowane przez Report |
Wybrałem Ragas do tego tutorialu, bo jego 4 kluczowe metryki czysto dzielą się na wyniki retrievera i generatora, a generator zestawu testowego jest w tym samym, otwartym pakiecie.
Jeśli wasz zespół żyje w pytest, assert_test() w DeepEval będzie bardziej naturalne. Jeśli chcesz dashboard jakości ruchu na żywo, raporty Evidently doprowadzą cię tam szybciej.
Konfiguracja Ragas to instalacja pakietu, przypięcie jednej zależności i wybór modelu sędziego LLM, wspólnego dla wszystkich metryk. Użyję uv, bo sam blokuje wersje pakietów, ale pip install z tymi samymi wersjami też działa.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Używam tu Pythona 3.12. Ragas 0.4.3 deklaruje wsparcie dla Pythona 3.9 i nowszych.
Pakiet rapidfuzz będzie potrzebny do generatora syntetycznego zestawu testowego dalej w artykule. Ragas nie deklaruje go jako zależności, więc instaluję go od razu.
Pin langchain-community<0.4 nie jest opcjonalny na moment pisania. Ragas 0.4.3 importuje ChatVertexAI ze ścieżki modułu, którą langchain-community 0.4 usunął, więc świeża instalacja bez pinu zawiedzie przy imporcie ragas.
Teraz sędzia. Każda metryka oparta na LLM w Ragas wykonuje 1 lub więcej wywołań do modelu sędziego, więc budujesz go raz i przekazujesz wszędzie. Trzymam go w osobnym module, judge.py, i czytam klucz ze środowiska, żeby żadna dana uwierzytelniająca nie trafiła do gita.
Ten plik pokazuje, jak wywołać OpenAI bezpośrednio albo Gemini przez endpoint kompatybilny z OpenAI od Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Dwa szczegóły w tym pliku mogą wyłożyć pierwsze uruchomienie:
llm_factory() wymaga przekazania obiektu klienta, a podanie samej nazwy modelu kończy się błędem.llm_factory() trafia prosto do wywołania modelu, dzięki czemu mogę podnieść max_tokens ponad domyślne 1 024.Użyj najtańszego modelu, który daje stabilne wyniki na próbce ręcznie sprawdzonej, a potem go przypnij. Przy dużym pakiecie ewaluacji wolumen szybko rośnie: faithfulness wykonuje 2 wywołania sędziego na próbkę, answer relevancy robi 3 plus 2 wywołania embeddingów, context precision robi 1 na każdy pobrany fragment, a context recall robi 1.
Sześć próbek na 4 metrykach dało łącznie 62 żądania w jednym przebiegu: 50 wywołań sędziego plus 12 embeddingów. Oto ile kosztują 3 obecne małe modele sędziów w cenach katalogowych u dostawców na 19 października 2026:
| Model sędziego | Wejście za 1M tokenów | Wyjście za 1M tokenów | Źródło |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | Cennik OpenAI |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Cennik Gemini API |
| claude-haiku-5-5 | $0.10 (prompty do 100K tokenów) | $0.50 (prompty do 100K tokenów) | Cennik Claude API |
Domyślnie w judge.py jest nadal gpt-4o-mini, starszy model OpenAI, który nie jest wymieniony w głównej tabeli cen na stronie OpenAI. Ustaw zmienną JUDGE_MODEL, żeby go zmienić.
Jeden haczyk, jeśli chcesz użyć Claude jako sędziego: answer relevancy potrzebuje też modelu embeddingów, a Anthropic go nie oferuje. Ich dokumentacja wskazuje Voyage AI, więc sparujesz Claude z embeddingami od innego dostawcy.
Przypięcie jest ważniejsze niż wybór. Podmiana modelu sędziego przesuwa wyniki nawet wtedy, gdy pipeline się nie zmienił, co psuje trend, który zaraz zbudujesz w sekcji śledzenia.
Trzymaj nazwę modelu w judge.py pod kontrolą wersji i traktuj aktualizację sędziego jak każdą inną zmianę łamiącą: zresetuj każdy próg względem wyników nowego sędziego.
Każdy przypadek testowy w zestawie to próbka (sample). Próbka to więcej niż odpowiedź: zapisuje pełną ścieżkę przez pipeline w 4 polach:
| Pole | Co zawiera |
|---|---|
user_input |
Pytanie zadane przez klienta |
retrieved_contexts |
Fragmenty, które retriever zwrócił dla tego pytania |
response |
Odpowiedź udzielona przez pipeline RAG |
reference |
Poprawna odpowiedź, napisana przez człowieka |
Ragas przechowuje każdą próbkę jako SingleTurnSample, a cały zestaw jako EvaluationDataset. Pole reference jest opcjonalne, ale metryki retrievalu porównują względem niego, więc zawsze je dodaję do kuratorowanego zestawu, nawet jeśli metryki bez referencji je ignorują.
Przygotowałem 6 próbek dla fikcyjnej palarni Northwind Coffee. Każda sekcja metryki poniżej dodaje próbkę, którą ta metryka powinna wychwycić.
Zacznij build_dataset.py od pierwszych 3 próbek: czystej odpowiedzi, celowej halucynacji i drugiej czystej odpowiedzi, która zawiera kilka twierdzeń naraz.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Każdy pobrany kontekst to fragment stron centrum pomocy Northwind, wpisany do skryptu dokładnie tak, jak retriever przekazałby go generatorowi. Uruchom uv run python build_dataset.py, aby zapisać eval_dataset.jsonl i eval_questions.jsonl, i uruchamiaj ponownie za każdym razem, gdy późniejsza sekcja doda próbkę.
Zapis do JSON Lines ma znaczenie, bo każdy kolejny skrypt (uruchamianie metryk, bramka CI) ładuje to samo eval_dataset.jsonl przez EvaluationDataset.from_jsonl().
W realnym projekcie pola retrieved_contexts i response pochodzą z uruchomienia twojego faktycznego pipeline’u na pytaniach, a tylko user_input i reference są pisane ręcznie. Sekcja CI pokazuje, jak to zautomatyzować.
6 próbek, na których kończy się ten artykuł, wystarczy do nauki metryk, ale nie do zaufania progom. Celuj w około 100 próbek, zanim oprzesz się na progu; sekcja śledzenia pokazuje dlaczego. Ile potrzebujesz, zależy od rygoru twojego use case’u, więc skupiam się na dobrym miksie zamiast konkretnej liczbie:
4 kluczowe metryki Ragas to faithfulness i answer relevancy dla generatora oraz context precision i context recall dla retrievera. Wszystkie zwracają wynik między 0 a 1. Najbardziej użyteczne jest to, co każda liczba mówi, co naprawić.
Faithfulness mierzy, jaka część odpowiedzi jest poparta pobranymi fragmentami. Sędzia dzieli odpowiedź na pojedyncze twierdzenia, a potem sprawdza każde z nich względem fragmentów: 1.0 oznacza, że każde jest wspierane, a 0.0, że żadne nie jest.
Faithfulness nie potrzebuje odpowiedzi referencyjnej, więc możesz ją uruchamiać na ruchu produkcyjnym, nie tylko na zestawie testowym. Uruchamiaj ponownie za każdym razem, gdy zmieniasz prompt, model lub zakres kontekstu widzianego przez model, bo to właśnie te zmiany najczęściej wprowadzają halucynacje.
Najszybszy sposób, by to zobaczyć w akcji, to pojedyncza odpowiedź, bez datasetu:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Uruchom to komendą uv run python quick_check.py, a wypisze faithfulness = 0.00, ponieważ żadne z twierdzeń w odpowiedzi (6 miesięcy, darmowa paczka) nie jest wspierane przez kontekst. W 0.4 oceniasz metodą ascore() każdej metryki, która zwraca wynik, a jego .value to punktacja.
Ocenione na dotychczasowym zbiorze danych, podstawiona halucynacja w próbce 2 dostaje 0.0, jak należy, a obie czyste próbki mają 1.0. Pełne wyniki dla każdej metryki są w sekcji multi-metryk niżej.
Answer relevancy mierzy, czy odpowiedź faktycznie odnosi się do pytania. Sędzia czyta odpowiedź i pisze 3 pytania, na które byłaby dobrą odpowiedzią, po czym Ragas sprawdza, jak blisko znaczeniowo są te pytania względem oryginalnego, używając modelu embeddingów. Jeśli odpowiedź unika kwestii, sędzia oznacza ją jako wymijającą i dostaje 0.
Ragas nazywa tę klasę AnswerRelevancy (starsze przykłady mówią ResponseRelevancy, a strona dokumentacji ma tytuł Response Relevancy) i potrzebuje ona zarówno sędziego LLM, jak i modelu embeddingów.
Niski wynik relewancji przy wysokim faithfulness zwykle wskazuje na generator albo prompt: model miał właściwy kontekst i pozostał na nim ugruntowany, ale odpowiedział na inne pytanie niż zadane. Najpierw sprawdź context precision i recall, bo retriever zwracający off-topic fragmenty może dać ten sam wzorzec.
Ta próbka pokazuje przypadek generatora. Retriever zwraca właściwy fragment o wysyłce, odpowiedź pozostaje ugruntowana, a mówi o datach palenia zamiast o kosztach wysyłki. Dodaj nowy fragment do fragmentów na górze build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Następnie dodaj nową próbkę na koniec listy samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Każda próbka dostaje jeden wynik relewancji: jak blisko pytania napisane przez sędziego z odpowiedzi są względem pytania faktycznie zadanego w próbce, gdzie 1.0 to idealne dopasowanie.
Context precision sprawdza, czy użyteczne fragmenty są wysoko w rankingu zwróconych przez retriever, a context recall sprawdza, czy retriever znalazł wszystko potrzebne do napisania poprawnej odpowiedzi.
Precision daje użytecznemu fragmentowi więcej punktów im wyżej jest w rankingu, więc użyteczny fragment na pierwszym miejscu liczy się bardziej niż ten sam na trzecim. Recall to odsetek faktów w odpowiedzi referencyjnej, które są wspierane przez co najmniej jeden pobrany fragment.
Obie potrzebują pola reference. W API „collections” klasy to ContextPrecisionWithReference i ContextRecall, i obie biorą tylko sędziego LLM. Dokumentacja Ragas używa też krótszej nazwy ContextPrecision dla wersji opartej na referencji, więc możesz spotkać obie.
Do tej pory każda próbka pobierała właściwe fragmenty na górze, więc żadna metryka nie miała czego złapać. Dodajmy 2 próbki, które psują retrieval na różne sposoby: jedną, gdzie właściwy fragment jest pobrany, ale na ostatnim miejscu, i jedną, gdzie nic istotnego nie zostało pobrane, więc model poprawnie odmawia. Jak wcześniej, dodaj fragmenty na górze pliku:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Następnie dodaj próbki na koniec listy:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Ranking ma znaczenie, bo większość pipeline’ów przekazuje do modelu tylko kilka najwyższych fragmentów, więc użyteczny fragment na 6. miejscu przy retrieverze top-5 praktycznie nie istnieje.
Próbka 5 umieszcza jedyny użyteczny fragment na ostatnim z 3 miejsc, a precision wychodzi 0.333, bo jedyna użyteczna informacja jest na końcu rankingu. Próbka 6, miss retrievalu, dostała 0.0 zarówno w precision, jak i recall.
Próbka 6 uczy też czegoś o faithfulness. Model poprawnie odmówił, a mimo to ta odmowa raz dostała 1.0, a innym razem 0.0, bez żadnych zmian pomiędzy. Stwierdzenie w stylu „Nie mam informacji o gwarancji” nie jest ani wspierane, ani obalane przez kontekst i sędzia czasem losuje.
Jeśli twój pipeline ma odmawiać, oceniaj odmowy osobno, zamiast pozwalać im rozhuśtać faithfulness. Ragas 0.4 usunął AspectCritic z API „collections”, więc zamiennikiem jest własny check z dekoratorem @discrete_metric (zob. przewodnik migracji v0.3 → v0.4).
Czytane razem 2 liczby retrievalu mówią, na co poświęcić kolejny tydzień:
| Context precision | Context recall | Diagnoza | Co zmienić |
|---|---|---|---|
| Wysoki | Wysoki | Retrieval zdrowy | Skup się na generatorze: prompt, model, faithfulness |
| Niski | Wysoki | Właściwe fragmenty pobrane, ale słabo zrankowane | Dodaj lub dostrój reranker |
| Wysoki | Niski | Top fragmenty trafne, ale niepełne | Przekaż więcej fragmentów do modelu, używaj większych fragmentów albo sprawdź podział fragmentów |
| Niski | Niski | Retriever szeroko zawodzi | Przejrzyj embeddingi, indeksowanie i przepisywanie zapytań |
Wiersz „niska precyzja, wysoki recall” jest najczęstszy w praktyce i najtańszy do naprawy.
Nasz tutorial RankGPT jako agent rerankingu dla RAG dodaje LLM-owy reranker na istniejącego retrievera, a nasz tutorial Boost LLM Accuracy with RAG and Reranking pokazuje inny setup rerankingu. Nasz przewodnik 5 kluczowych technik poprawy wydajności RAG obejmuje chunking i przepisywanie zapytań dla innych wierszy.
Uruchamiaj ponownie 2 metryki retrievalu po każdej zmianie, a tabela powie ci, czy zadziałało.
Pełna ewaluacja multi-metrykowa uruchamia wszystkie 4 metryki na każdej próbce równolegle i zbiera wyniki, z wartościami per wiersz do wglądu w błędy oraz średnimi kolumnowymi na dashboard.
W Ragas 0.2 i 0.3 robiło się to przez evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). W 0.4.3 ta funkcja wciąż istnieje, ale ostrzega, że jest przestarzała i odrzuca nowe metryki, bo te nie dziedziczą już po starej klasie Metric, której oczekuje.
Następcą jest @experiment, który uruchamia twój pipeline i metryki razem na Dataset i zapisuje wyniki do CSV. To właściwe narzędzie, gdy masz pipeline do wywołania.
Do oceniania statycznego datasetu wolę mały helper: buduje 4 metryki raz dla każdego skryptu, który ich potrzebuje, i trzyma równoległe wywołania oraz obsługę błędów w kodzie, który mogę przeczytać:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Jedyna nieoczywista linia to inspect.signature(). 4 metryki chcą różnych wejść (faithfulness potrzebuje odpowiedzi, recall potrzebuje referencji itd.), więc helper czyta, jakie argumenty akceptuje ascore() każdej metryki, i przekazuje dokładnie te pola z próbki, co pozwala jedną pętlą obsłużyć wszystkie metryki.
Semafor ogranicza, ile wywołań sędziego działa równocześnie, a metryka, która i tak się wyłoży, staje się pustą komórką (NaN) zamiast przerywać cały przebieg. Jeśli uruchamiasz to w Jupyterze, asyncio.run się wywróci, bo pętla już działa. Najpierw wywołaj nest_asyncio.apply() (Ragas już od niego zależy) albo awaituj korutynę bezpośrednio.
Z helperem pełny przebieg jest krótki:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Oto wyniki z mojego pierwszego przebiegu, posortowane po faithfulness i zaokrąglone do 3 miejsc, ze średnimi w ostatnim wierszu:
| Pytanie | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Późniejsze przebiegi tego samego datasetu oceniły faithfulness niżej przez flip odmowy z próbki 6, o czym piszę w sekcji śledzenia.
Sortowanie po faithfulness pomaga wychwycić najbardziej prawdopodobne halucynacje i ta podstawiona jest na górze. Średnie w ostatnim wierszu to twoje liczby do dashboardu.
Czytaj wierszami i każda podstawiona awaria pojawia się w innym miejscu. Halucynacja obniża tylko faithfulness. Miss retrievalu zeruje łącznie relewancję, precision i recall. Problem rankingu tnie precision do 0.333, a dryf wychodzi jako najniższa relewancja spośród udzielonych odpowiedzi.
Jedna osobliwość: odpowiedź o Kanadzie jest w pełni wsparta fragmentem, a mimo to dostała 0.667 w faithfulness. To szum sędziego, do którego wrócę w sekcji śledzenia.
Answer relevancy porównuje znaczenie embeddingami, więc nawet dobra odpowiedź rzadko dochodzi do 1.0: odpowiedź o zwrocie uzyskała 0.746, a off-topic o wysyłce 0.572. Oceniaj relewancję po różnicy między próbkami i po trendzie w czasie, nie po absolutnej liczbie.
Bramka jakości RAG to skrypt testowy, który uruchamia ewaluację, porównuje każdą średnią ze swoim progiem i kończy się kodem błędu, gdy któraś metryka spadnie poniżej — co każe CI zablokować merge.
Najpierw jedno ale. Ręcznie zbudowany dataset z wcześniej ma odpowiedzi i pobrane fragmenty wpisane ręcznie, więc jego ocenianie nigdy nie odzwierciedli zmiany promptu albo retrievera. W CI musisz ponownie uruchomić prawdziwy pipeline na zapisanych pytaniach, a potem ocenić to, co zwrócił. Zrobią to dwa małe skrypty.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py to jedyny plik, który piszesz sam: zastąp ciało answer() wywołaniem twojego retrievera i generatora. refresh_dataset.py czyta pytania i odpowiedzi referencyjne zapisane przez build_dataset.py, uruchamia pipeline na każdym pytaniu i przepisuje eval_dataset.jsonl.
Sama bramka to słownik progów i pętla. Progi niżej były kalibrowane na ręcznie zbudowanym przykładzie datasetu, więc skalibruj je na wyjściu twojego własnego pipeline’u, zanim na nich polegniesz.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Na mojej bazie wszystkie 4 średnie przekraczają progi i skrypt kończy się kodem 0, co pozwala na merge:
| Metryka | Średnia | Próg | Wynik |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer relevancy | 0.668 | 0.60 | Pass |
| Context precision | 0.722 | 0.65 | Pass |
| Context recall | 0.833 | 0.75 | Pass |
Ustawiłem próg faithfulness na 0.60 zamiast 0.70 przez szum sędziego, o którym piszę w sekcji śledzenia. Przy 6 próbkach jedna „flaky” ocena przesuwa średnią o 0.17, a późniejszy przebieg niezmienionego pipeline’u dał 0.61. Bramka też uruchamia sędziego 3 razy i uśrednia wyniki (GATE_RUNS), co wygładza pojedyncze flipy werdyktu kosztem 3× wyższego kosztu sędziego.
Jeden wybór projektowy to fail na not (actual >= threshold) zamiast actual < threshold. Porównanie z NaN („not a number”) zawsze zwraca False, więc check jako actual < threshold przepuściłby build przy awarii sędziego.
skipna=False przy średniej pokrywa przypadek częściowy. pandas domyślnie pomija NaN, więc kilka nieudanych wywołań sędziego po cichu zmniejszyłoby próbkę zamiast oblać bramkę. Teraz chwilowy błąd sędziego oblewa build, więc uruchom job ponownie, zanim zaczniesz debugować.
Progi są trudne do strojenia. Ustawiaj je nieco poniżej najniższej średniej widzianej w powtórzonych przebiegach, nie na aspiracyjne 0.9, bo bramka zablokuje każdy PR i zespół przestanie ufać CI. Resetuj je za każdym razem, gdy zmieniasz model sędziego lub dodasz więcej niż kilka próbek.
Podpięcie do GitHub Actions to krótki workflow. Dokumentacja składni workflow obejmuje filtry ścieżek w on.pull_request i cron w schedule użyty tutaj:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Kilka szczegółów w tym workflow ma znaczenie:
JUDGE_MODEL i pasujący do niego klucz API. Użyj tego samego sędziego, z którym kalibrowałeś progi, inaczej wyniki CI nie będą porównywalne z twoją historią.GATE_SAMPLE ocenia stały, losowy podzbiór 30 wierszy, żeby recenzja nie czekała 10 minut na wywołania sędziego. Nocny cron ocenia wszystko.scores.csv i ragas_history.jsonl jako artefakty, bo dysk runnera znika po zakończeniu joba.Uruchamiaj pełny pakiet w nocnym cronie, gdy nikt nie czeka. Nieudany nocny przebieg pojawi się jako failed workflow, a ustawienia powiadomień GitHuba lub krok Slacka poinformują właściciela rano. GitLab CI ma ten sam kształt z rules: changes: i harmonogramem pipeline’u.
Ragas generuje syntetyczne pytania testowe, czytając twoje dokumenty, wyciągając główne tematy i fakty, łącząc powiązane fragmenty, a potem pisząc z tych powiązań pytania różnych typów.
Dokumentacja generatora dzieli zapytania na single-hop (jeden fragment wystarczy) i multi-hop (odpowiedź wymaga kilku fragmentów), a każdy z nich może być konkretny lub abstrakcyjny. Domyślna mieszanka używa 3 z 4 kombinacji w równych proporcjach:
Ragas używa tylko tych syntezatorów, które wspierają twoje dokumenty, więc mały zbiór może dać inną mieszankę.
Generator potrzebuje prawdziwych dokumentów. Wskaż mu własną dokumentację jako pliki markdown. Do tego artykułu napisałem 5 krótkich stron centrum pomocy Northwind (około 600 słów łącznie) i każda wygląda tak:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Twoje własne dokumenty wygenerują inne pytania niż poniższe — i o to chodzi: generator pisze pytania o tym, co faktycznie mówi twoja baza wiedzy.
TestsetGenerator używa tego samego sędziego LLM i modelu embeddingów, które już zbudowaliśmy. Ładuję dokumenty loaderem DirectoryLoader z LangChain, jawnie używając TextLoader, żeby pliki markdown nie wciągnęły ciężkiej zależności unstructured.
Mapowanie dokumentów uruchamia naraz wiele wywołań sędziego, więc ograniczam też równoległość przez RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Skrypt ładuje wszystkie 5 dokumentów i zapisuje te 8 pytań. Pytania trzymają się dokumentów, a niektóre zawierają celowe literówki:
| # | Wygenerowane pytanie | Typ pytania |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Tabela pokazuje uproszczone etykiety; kolumna synthesizer_name w output zawiera pełną nazwę syntezatora. Osiem pytań z 5 dokumentów zajęło około 4,5 minuty.
Literówki i zapytanie w stylu słów kluczowych w pytaniu 2 są celowe: generator zmienia styl i długość każdego zapytania, żeby zestaw wyglądał jak ruch z wyszukiwarki, a nie jak egzamin.
Zapewne zechcesz przejrzeć pytania, by upewnić się, że są użyteczne i trafne. Traktowałbym output jako pierwszy szkic. W każdym syntetycznym zestawie, który przeglądałem, część pytań jest wadliwa (odnoszą się do „dokumentu” lub pytają o nagłówek), część odpowiedzi referencyjnych dryfuje od tego, co faktycznie mówi źródło, a frazowanie jest bardziej formalne niż jakiegokolwiek realnego użytkownika.
Uruchom generator ponownie, gdy dodasz sekcję do dokumentów, a dostaniesz kandydujące pytania do nowego materiału — kosztem kolejnej rundy wywołań sędziego.
Każdy wiersz ma user_input, wygenerowaną odpowiedź reference i reference_contexts, czyli fragmenty, z których pytanie powstało. Sprawdź reference względem tych fragmentów — tam pojawia się dryf.
Aby zamienić przejrzany wiersz w SingleTurnSample, uruchom pipeline na user_input, by dostać retrieved_contexts i response. Dopisz pary user_input i reference do eval_questions.jsonl, a refresh_dataset.py zajmie się resztą.
Jeśli twoja baza wiedzy to graf, a nie stos dokumentów, zasada jest ta sama przy innym retrieverze. Nasz tutorial Using a Knowledge Graph to Implement a RAG Application i nasz kurs Graph RAG with LangChain and Neo4j tworzą pipeline’y, które ocenisz dokładnie tymi 4 metrykami, bo metryki czytają tylko pobrany tekst, nie to, jak został pobrany.
Śledzenie wyników Ragas w czasie polega na dopisywaniu średnich wyników, hasha commitu, modelu sędziego i znacznika czasu do logu po każdym przebiegu ewaluacji, tak by regresja pojawiła się jako spadek na wykresie, a nie niespodzianka na produkcji.
Plik JSON Lines to chyba najlepszy wybór, dopóki nie potrzebujesz współdzielonego trackera eksperymentów dla kilku osób. track_scores.py czyta scores.csv, które zapisują zarówno quality_gate.py, jak i run_all.py, więc nigdy nie wywołuje sędziego drugi raz.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Uruchomienie uv run python track_scores.py dopisze jedną linię do logu i ją wydrukuje:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
W CI każdy job startuje z pustym dyskiem, więc ragas_history.jsonl trzyma tylko rekord z danego przebiegu. Żeby mieć trend, pobierz artefakty i dopisuj je do jednego pliku albo commituj plik do gałęzi z metrykami lub do storage’u obiektowego.
Wykreślenie historii jest dość łatwe. Spróbuj tego skryptu:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Dostaniesz wykres mniej więcej taki:
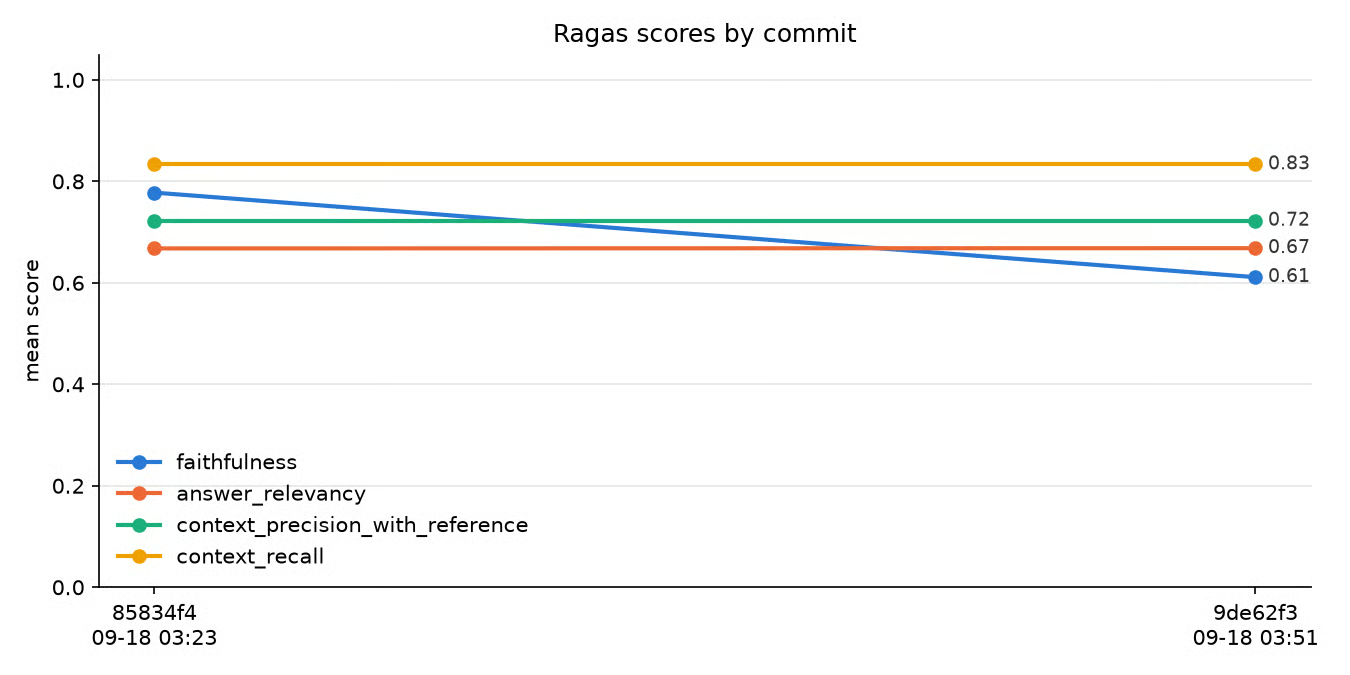
Średnie wyniki Ragas logowane per commit przez track_scores.py. Ilustracja: autor.
Między tymi commitami nic w pipeline się nie zmieniło (drugi zmienił tylko ustawienia połączenia klienta sędziego), a jednak faithfulness spadł z 0.78 do 0.61, bo odmowa w próbce 6 przeskoczyła z 1.0 na 0.0.
Więc póki nie masz dużej liczby próbek, realny szum sędziego trzeba mieć na oku. Przy 6 próbkach 1 „flaky” werdykt przesuwa średnią o 0.17. Przy 100 próbkach ten sam flip przesuwa o 0.01, więc duża zmiana jest znacznie bardziej prawdopodobną realną regresją.
Teraz, przy każdym pull requeście lub commicie, możesz uruchomić bramkę, zalogować wyniki i spojrzeć na wykres.
Jeśli rozważasz większą zmianę architektury, nasz tutorial RAG vs. fine-tuning pokazuje kompromisy, a te same 4 metryki działają jako pomiar przed i po dla obu dróg.
Oceny LLM-as-a-judge są estymatami: mają znane biasy i mogą się zmieniać między przebiegami, ale skalują się do wolumenów ewaluacji, których ręczna weryfikacja nie udźwignie.
Ragas nigdy nie prosi sędziego o porównanie 2 odpowiedzi, więc bias pozycji (faworyzowanie odpowiedzi pierwszej) zasadniczo nie ma zastosowania. Bias „gadulstwa” (faworyzowanie dłuższych odpowiedzi) i bias własnego modelu (sędzia faworyzuje odpowiedzi ze swojego modelu) nadal mogą mieć znaczenie. Zheng i in. (2023) opisują wszystkie 3 biasy i to dlatego nie używałbym tego samego modelu jako generatora i sędziego.
Zmiana między przebiegami to część, którą chcę, żebyś zobaczył na własne oczy, bo zmienia sposób ustawiania progów. W przebiegach tych samych 6 próbek z tym samym przypiętym sędzią odmowa w próbce 6 dostała 0.0 w jednym przebiegu i 1.0 w innym na faithfulness, a w pełni ugruntowana próbka 5 dostała 0.667 w przebiegu pokazanym powyżej.
Wyniki per próbka z tanim sędzią są hałaśliwe. Średnie po 100 próbkach są dużo mniej hałaśliwe i bramka CI powinna zawsze testować średnią.
Trzy praktyki okiełznają szum:
judge.py i track_scores.py, żeby zmiana sędziego nigdy nie została pomylona ze zmianą pipeline’u.Szerszy przegląd podejść do ewaluacji poza RAG, w tym metod oceny przez ludzi, które sędzia zastępuje, znajdziesz w naszym przewodniku po ewaluacji LLM. Nasz tutorial o LLM jako sędzim wchodzi głębiej w budowanie sędziego dla pipeline’ów RAG.
Cel tego pipeline’u jest taki, by móc powiedzieć „retriever jest OK, prompt się pogorszył” albo „reranker naprawił precision, ale recall to wciąż 0.6” — i mieć na to liczby.
Faithfulness i answer relevancy patrzą na generator: faithfulness łapie wymyślone fakty, a answer relevancy łapie odpowiedzi, które zbaczają z pytania. Context precision i recall patrzą na retriever i mówią, czy wyciąga właściwe informacje. Ponieważ 2 z 4 nie potrzebują odpowiedzi referencyjnej, możesz je uruchamiać na ruchu produkcyjnym, gdzie referencji nie ma.
Standardowe metryki tekstowe mierzą nakładanie się słów, co nic nie mówi o zmyślonej polityce zwrotów, a pojedyncza liczba end-to-end ukrywa, która połowa pipeline’u się zepsuła. Framework, który sprawdza osobno 2 punkty awarii, potrafi to zobaczyć, a zamiana jednorazowego audytu w bramkę CI z plikiem historii sprawia, że zespół zaczyna działać na podstawie liczb.
Jeśli nie zbudowałeś jeszcze pipeline’u, zacznij od naszego kursu Retrieval-Augmented Generation with LangChain, a potem skieruj pipeline.py z tego artykułu do tego, co zbudujesz.
Dla pipeline’ów wykraczających poza zwykły retrieval tekstu, nasz kurs End-to-End RAG with Weaviate, nasz przewodnik po multimodalnym RAG i nasz tutorial o agentic RAG budują systemy, które ocenisz tak samo, z jednym zastrzeżeniem: 4 kluczowe metryki czytają tylko tekst. Pipeline pobierający obrazy potrzebuje osobnych metryk multimodalnych Ragas, a pipeline agentowy potrzebuje oceny każdego kroku retrievalu jako własnego pytania, fragmentów i odpowiedzi.
Najlepsze kursy DataCamp
Kurs
Kurs
Kurs