Curs
Graph RAG cu LangChain și Neo4j
3 ore
2.3K
O linie de generare augmentată prin regăsire (RAG) pentru un chatbot trece toate testele de tip smoke din notebook. Apoi încep să apară tichete la suport cu răspunsuri greșite sau ciudate, iar în jurnalele testelor smoke nu apare niciun semn de avertizare.
Eșecul acesta e greu de prins pentru că este invizibil fără metrici. O linie RAG poate greși în 2 locuri: retrieverul poate aduce fragmente greșite sau generatorul poate ignora fragmente bune și poate inventa fapte. Un singur număr de acuratețe end-to-end nu îți poate spune care dintre acestea s-a întâmplat, așa că nu îți poate spune ce să repari.
În acest tutorial, voi construi o linie completă de evaluare RAG în Python folosind Ragas 0.4.3: un set de date de evaluare construit manual, cele 4 metrici de bază (faithfulness, answer relevancy, context precision și context recall), un prag de calitate în continuous integration (CI) care pică build-ul când scad scorurile, un generator de seturi de test sintetice și un tracker de scoruri în JSON Lines.
Dacă vrei mai întâi context, vezi ghidul nostru despre ce este RAG, tutorialul despre folosirea unui model mare de limbaj (LLM) ca arbitru pentru evaluarea liniilor RAG și prezentarea noastră a tehnicilor RAG avansate.
Ai nevoie de Python 3.9 sau mai nou (eu folosesc 3.12), uv sau pip, o cheie API pentru un model-arbitru compatibil cu OpenAI și o idee generală despre cum funcționează o linie RAG. Dacă vrei mai întâi baza, îți recomandăm cursul nostru Retrieval-Augmented Generation with LangChain, care construiește tipul de linie pe care o vom puncta.
Metricile de suprapunere a textului precum BLEU (Bilingual Evaluation Understudy) și ROUGE (Recall-Oriented Understudy for Gisting Evaluation) sunt rigla greșită pentru RAG. Ragas folosește în schimb un LLM-arbitru pentru a puncta fiecare răspuns pe 4 axe: faithfulness și answer relevancy diagnostichează generatorul, iar context precision și context recall diagnostichează retrieverul.
Pune aceste 4 numere cu un prag în CI și înregistrează-le per commit, și obții o alarmă de regresie în locul unui audit punctual.
Un avertisment înainte să începem. API-ul Ragas s-a schimbat de două ori în 2 ani: v0.2 a înlocuit seturile de date dicționar cu SingleTurnSample și EvaluationDataset, iar v0.4 a făcut metricile „collections” (introduse în v0.3.9) implicite și a marcat vechea funcție evaluate() ca învechită.
Majoritatea tutorialelor online încă arată cod de v0.1 sau v0.2. Tot ce urmează rulează pe 0.4.3, care este versiunea curentă în octombrie 2026.
RAG are nevoie de propriile metrici pentru că metricile clasice de text numără doar câte cuvinte împarte un răspuns cu un răspuns de referință, iar formularea comună nu este ceea ce se strică într-un sistem RAG.
BLEU (Papineni et al., 2002) și ROUGE (Lin, 2004) au fost construite pentru traducere automată și sumarizare, unde un output bun ar trebui să folosească în mare aceleași cuvinte ca referința. Un răspuns RAG care spune „ai 2 săptămâni” în loc de „14 zile” punctează slab la ambele, în timp ce un răspuns fluent care inventează o politică de rambursare poate puncta bine dacă reutilizează, întâmplător, cuvintele din referință.
Problema mai adâncă este că o linie RAG poate eșua în 2 locuri separate: retrieverul poate alege informațiile greșite sau generatorul poate ignora informații bune și poate inventa fapte. Când un răspuns e greșit, trebuie să știi care dintre acestea s-a întâmplat:
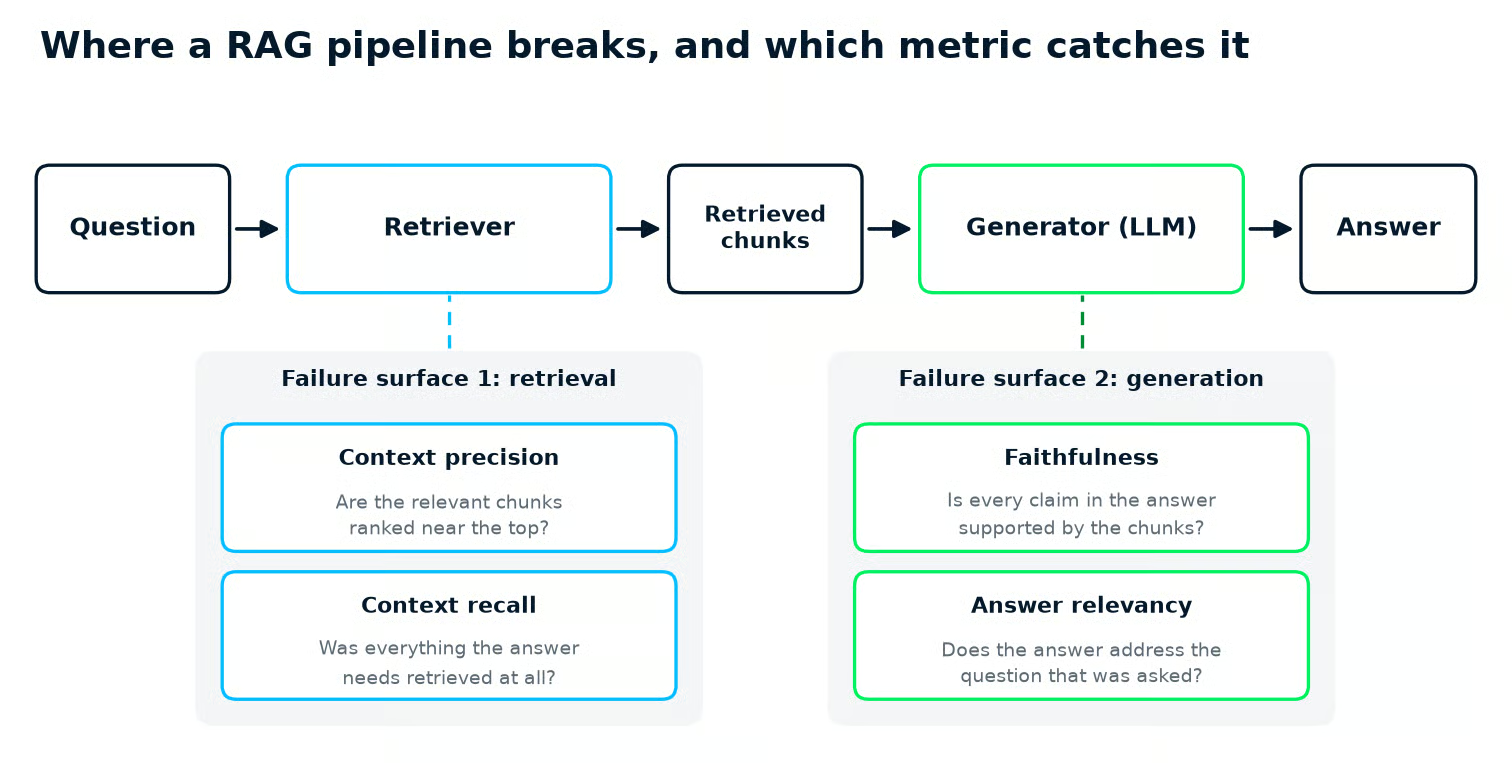
Cele 2 moduri de eșec ale unei linii RAG: context precision și recall diagnostichează retrieverul, iar faithfulness și answer relevancy diagnostichează generatorul. Imagine de autor.
Ghidul nostru What Is Retrieval Augmented Generation (RAG)? A Complete Guide trece prin etapele liniei unde apar aceste eșecuri.
Ragas este un framework Python open-source care îți dă un număr pentru fiecare parte a liniei. Nu este singura opțiune. Cele 2 alternative principale sunt DeepEval, care înfășoară evaluarea în cazuri de testare în stil pytest, și Evidently, care adaugă verificări LLM ca coloane suplimentare pe un set de date și le alimentează în rapoarte de monitorizare.
| Framework | Cel mai potrivit pentru | Metrici specifice RAG incluse | Date de test din documentele tale | Stil de configurare |
|---|---|---|---|---|
| Ragas | Diagnosticarea liniilor RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Obiecte metrică plus un arbitru din llm_factory() |
| DeepEval | Testare LLM în stil unit-test în CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Obiecte LLMTestCase, assert_test() rulate prin deepeval test run |
| Evidently | Dashboarduri de monitorizare și drift în timp | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Generare dataset RAG în Evidently Cloud | Descriptori pe un Dataset, sumarizați de un Report |
Am ales Ragas pentru acest tutorial pentru că cele 4 metrici de bază se împart clar în scoruri de retriever și de generator și pentru că generatorul de seturi de test vine în același pachet open-source.
Dacă echipa ta trăiește deja în pytest, assert_test() din DeepEval va părea mai natural. Dacă vrei un dashboard al calității traficului live, rapoartele Evidently te duc mai repede acolo.
Configurarea Ragas înseamnă instalarea pachetului, fixarea unei dependențe și alegerea unui LLM-arbitru pe care îl vor împărți toate metricile. Voi folosi uv pentru că îți blochează versiunile exacte ale pachetelor, dar și pip install cu aceleași versiuni funcționează.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Folosesc Python 3.12 aici. Ragas 0.4.3 declară suport pentru Python 3.9 și mai noi.
Pachetul rapidfuzz este necesar pentru generatorul de seturi de test sintetice mai târziu în articol. Ragas nu îl declară ca dependență, așa că îl instalez din start.
Fixarea langchain-community<0.4 nu este opțională la momentul scrierii. Ragas 0.4.3 importă ChatVertexAI dintr-o cale de modul pe care langchain-community 0.4 a eliminat-o, deci o instalare proaspătă fără pin eșuează când imporți ragas.
Urmează arbitrul. Fiecare metrică bazată pe LLM din Ragas face 1 sau mai multe apeluri la un model-arbitru, deci îl construiești o dată și îl transmiți peste tot. Îl țin într-un modul separat, judge.py, și citesc cheia din mediu ca să nu ajungă credențiale în git.
Acest fișier arată cum să apelezi direct OpenAI sau Gemini prin endpointul compatibil OpenAI de la Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Două detalii din acel fișier îți pot încurca prima rulare:
llm_factory() în 0.4 are nevoie de un obiect client transmis, iar dacă transmiți doar numele modelului, aruncă eroare.llm_factory() merg direct în apelul modelului, de aici cum cresc max_tokens peste valoarea implicită 1.024.Folosește cel mai ieftin model care produce scoruri stabile pe un eșantion verificat manual de tine, apoi fixează-l. Pentru o suită mare de evaluare, volumul se adună rapid: faithfulness face 2 apeluri la arbitru per eșantion, answer relevancy face 3 plus 2 apeluri de embedding, context precision face 1 per fragment regăsit, iar context recall face 1.
Șase eșantioane pe 4 metrici au ajuns la 62 de cereri într-o singură rulare: 50 apeluri la arbitru plus 12 apeluri de embedding. Iată cât costă 3 modele-arbitru mici actuale la prețul de listă al fiecărui furnizor pe 19 octombrie 2026:
| Model-arbitru | Input per 1M tokeni | Output per 1M tokeni | Sursă |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API pricing |
| claude-haiku-5-5 | $0.10 (prompts până la 100K tokeni) | $0.50 (prompts până la 100K tokeni) | Claude API pricing |
Implicita în judge.py rămâne gpt-4o-mini, un model OpenAI mai vechi care nu este listat în tabelul principal de prețuri de pe pagina OpenAI. Setează variabila JUDGE_MODEL pentru a comuta.
O capcană dacă vrei Claude ca arbitru: answer relevancy are nevoie și de un model de embedding, iar Anthropic nu oferă unul. Documentația lor indică Voyage AI, deci ai combina Claude cu embeddings de la un alt furnizor.
Fixarea contează mai mult decât alegerea. Schimbarea modelului-arbitru deplasează scorurile chiar și când linia ta nu s-a schimbat, ceea ce distruge linia de trend pe care urmează să o construiești în secțiunea de tracking.
Pune numele modelului în judge.py sub control versiune și tratează un upgrade de arbitru ca pe orice altă schimbare cu impact: resetează fiecare prag în funcție de scorurile noului arbitru.
Fiecare caz de test din setul de date se numește sample. Un sample e mai mult decât un răspuns: înregistrează o trecere completă prin linie, în 4 câmpuri:
| Câmp | Ce conține |
|---|---|
user_input |
Întrebarea pe care a pus-o clientul |
retrieved_contexts |
Fragmentele returnate de retriever pentru acea întrebare |
response |
Răspunsul pe care l-a dat linia RAG |
reference |
Răspunsul corect, scris de un om |
Ragas stochează fiecare sample ca SingleTurnSample și întreg setul ca EvaluationDataset. reference este opțional, dar metricile de regăsire compară cu el, așa că îl includ mereu în setul curat, chiar dacă metricile fără referință îl ignoră.
Am construit 6 sample-uri pentru un prăjitor de cafea fictiv, Northwind Coffee. Fiecare secțiune de metrici de mai jos adaugă sample-ul pe care acea metrică ar trebui să-l prindă.
Pornește build_dataset.py cu primele 3 sample-uri: un răspuns curat, o halucinație deliberată și un al doilea răspuns curat care face mai multe afirmații deodată.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Fiecare context regăsit este un fragment din paginile centrului de ajutor Northwind, scris în script exact așa cum l-ar da un retriever către generator. Rulează uv run python build_dataset.py pentru a scrie eval_dataset.jsonl și eval_questions.jsonl, și rulează din nou de fiecare dată când o secțiune ulterioară adaugă un sample.
Salvarea în JSON Lines contează pentru că fiecare script ulterior (rulările metricilor, poarta CI) încarcă același eval_dataset.jsonl cu EvaluationDataset.from_jsonl().
Într-un proiect real, câmpurile retrieved_contexts și response vin din rularea liniei tale reale peste întrebări, iar doar user_input și reference sunt scrise manual. Secțiunea CI arată cum automatizezi acest pas.
Cele 6 sample-uri cu care se termină acest articol sunt suficiente pentru a învăța metricile, dar nu pentru a avea încredere într-un prag. Țintește spre ~100 de sample-uri înainte să te bazezi pe unul; secțiunea de tracking arată de ce. De câte ai nevoie depinde de cât de strict e cazul tău de utilizare, așa că mă concentrez pe un mix bun mai degrabă decât pe un număr exact:
Cele 4 metrici de bază Ragas sunt faithfulness și answer relevancy pentru generator, și context precision și context recall pentru retriever. Toate 4 întorc un scor între 0 și 1. Partea utilă este ce îți spune fiecare număr să repari.
Faithfulness măsoară cât dintr-un răspuns este susținut de fragmentele regăsite. Arbitrul împarte răspunsul în afirmații individuale, apoi verifică fiecare afirmație față de fragmente: un scor de 1.0 înseamnă că fiecare afirmație este susținută, iar 0.0 că niciuna nu este.
Faithfulness nu are nevoie de un răspuns de referință, așa că îl poți rula pe trafic de producție live, nu doar pe setul tău de test. Rulează din nou ori de câte ori schimbi promptul, modelul sau cât context vede modelul, pentru că acestea sunt schimbările care introduc cel mai des halucinații.
Cel mai rapid mod să îl vezi în acțiune este pe un singur răspuns, fără set de date:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Rulează cu uv run python quick_check.py și va imprima faithfulness = 0.00, pentru că nicio afirmație din răspuns (6 luni, o pungă gratuită) nu este susținută de context. În 0.4 punctezi cu metoda ascore() a fiecărei metrici, care întoarce un rezultat al cărui .value este scorul.
Punctat pe întreg setul de până acum, halucinația plantată din sample-ul 2 ia 0.0, cum e corect, iar ambele sample-uri curate iau 1.0. Rezultatele complete pentru fiecare metrică sunt în secțiunea multi-metric de mai jos.
Answer relevancy măsoară dacă răspunsul chiar abordează întrebarea. Arbitrul citește răspunsul și scrie 3 întrebări la care ar fi un răspuns bun, apoi Ragas verifică cât de apropiate ca sens sunt acele întrebări de întrebarea originală, folosind un model de embedding. Dacă răspunsul evită întrebarea, arbitrul îl marchează ca neangajant și punctează 0.
Ragas numește clasa AnswerRelevancy (exemplele mai vechi o numesc ResponseRelevancy, iar pagina de documentație este intitulată Response Relevancy), și are nevoie atât de LLM-ul arbitru, cât și de modelul de embedding.
Un scor mic de relevanță cu un scor mare de faithfulness indică de obicei generatorul sau promptul: modelul a avut contextul corect și a rămas ancorat în el, dar a răspuns la o altă întrebare decât cea pusă. Verifică totuși mai întâi context precision și recall, pentru că un retriever care întoarce fragmente off-topic poate produce același tipar.
Acest sample arată cazul generatorului. Retrieverul întoarce fragmentul corect despre shipping, răspunsul rămâne ancorat, și vorbește despre datele de prăjire în loc de costul livrării. Adaugă fragmentul nou la fragmentele de sus din build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Apoi adaugă sample-ul nou la finalul listei samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Fiecare sample primește un singur scor de relevanță: cât de bine se potrivesc ca sens întrebările scrise de arbitru din răspuns cu întrebarea pusă în sample, unde 1.0 este o potrivire perfectă.
Context precision verifică dacă fragmentele utile sunt clasate aproape de vârful listei întoarse de retriever, iar context recall verifică dacă retrieverul a găsit tot ce e nevoie pentru a scrie răspunsul corect.
Precision acordă mai mult credit unui fragment util cu cât e mai sus clasat, deci un fragment util pe primul loc contează mai mult decât același fragment pe al treilea. Recall este ponderea afirmațiilor din răspunsul de referință pe care le susține cel puțin un fragment regăsit.
Ambele au nevoie de câmpul reference. În API-ul „collections”, clasele sunt ContextPrecisionWithReference și ContextRecall, și ambele iau doar LLM-ul arbitru. Documentația Ragas mai folosește și numele mai scurt ContextPrecision pentru versiunea bazată pe referință, deci le poți vedea pe ambele.
Până acum fiecare sample regăsește fragmentele corecte pe primele locuri, deci niciuna dintre metrici nu are ce prinde. Hai să adăugăm 2 sample-uri care strică regăsirea în moduri diferite: unul în care fragmentul corect e regăsit dar clasat ultimul și unul în care nu e regăsit nimic relevant, deci modelul refuză corect. Ca înainte, adaugă fragmentele sus în fișier:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Apoi adaugă sample-urile la finalul listei:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Clasarea contează pentru că majoritatea liniilor trimit doar primele câteva fragmente către model, deci un fragment util pe locul 6 într-un retriever top-5 e ca și cum n-ar exista.
Sample-ul 5 pune singurul fragment util pe ultimul loc din 3, iar precision iese 0.333 deoarece singura informație utilă e clasată ultima. Sample-ul 6, ratarea regăsirii, a punctat 0.0 atât la precision, cât și la recall.
Sample-ul 6 mai învață ceva despre faithfulness. Modelul a refuzat corect, dar acel refuz a punctat 1.0 pe faithfulness în unele rulari și 0.0 în altele, fără să se schimbe nimic între timp. O afirmație ca „Nu am informații despre garanție” nu este nici susținută, nici contrazisă de context, iar arbitrul aruncă banul.
Dacă linia ta trebuie să refuze, punctează refuzurile separat în loc să lași să-ți plimbe faithfulness. Ragas 0.4 a scos AspectCritic din API-ul „collections”, așa că înlocuitorul este un check personalizat construit cu decoratorul @discrete_metric (vezi ghidul de migrare v0.3 la v0.4).
Citește cele 2 numere de regăsire împreună și îți spun unde să-ți petreci săptămâna următoare:
| Context precision | Context recall | Diagnostic | Ce să schimbi |
|---|---|---|---|
| Mare | Mare | Regăsirea e sănătoasă | Concentrează-te pe generator: prompt, model, faithfulness |
| Mic | Mare | Fragmentele corecte regăsite dar clasate prost | Adaugă sau reglează un reranker |
| Mare | Mic | Top fragmente relevante dar incomplete | Trimite mai multe fragmente modelului, folosește fragmente mai mari sau verifică unde se taie fragmentele |
| Mic | Mic | Retrieverul eșuează pe scară largă | Revizuiește embeddings, indexarea și rescrierea interogărilor |
Rândul „precision mic, recall mare” este cel mai des întâlnit în practică și e cel mai ieftin de reparat.
Tutorialul nostru RankGPT ca agent de re-clasare pentru RAG adaugă un reranker LLM peste un retriever existent, iar tutorialul Boost LLM Accuracy with RAG and Reranking arată o altă configurație de reranking. Ghidul 5 tehnici-cheie pentru îmbunătățirea performanței RAG acoperă fragmentarea și rescrierea interogărilor pentru celelalte rânduri.
Rulează din nou cele 2 metrici de regăsire după fiecare schimbare, iar tabelul îți spune dacă a funcționat.
O evaluare multi-metric completă rulează toate cele 4 metrici peste fiecare sample în paralel și colectează scorurile, cu valori pe rând pentru a investiga eșecurile și medii pe coloane pentru dashboardul tău.
În Ragas 0.2 și 0.3 făceai asta cu evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). În 0.4.3 funcția încă există, dar avertizează că este învechită și refuză metricile noi, pentru că nu mai moștenesc din vechea clasă Metric pe care o așteaptă.
Înlocuitorul este @experiment, care rulează linia ta și metricile împreună peste un Dataset și scrie rezultatele în CSV. Acesta e instrumentul corect odată ce ai o linie de apelat.
Pentru punctarea unui set de date static, eu prefer un mic helper: construiește cele 4 metrici o dată pentru fiecare script care are nevoie de ele și păstrează apelurile paralele și tratarea erorilor în cod pe care îl pot citi:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Singura linie mai puțin evidentă e apelul inspect.signature(). Cele 4 metrici vor inputuri diferite (faithfulness are nevoie de response, recall are nevoie în schimb de reference), așa că helperul citește ce argumente acceptă ascore() pentru fiecare metrică și transmite exact acele câmpuri din sample, permițând unui singur loop să deservească fiecare metrică.
Semaforul limitează câte apeluri la arbitru rulează simultan, iar o metrică ce totuși eșuează devine o celulă goală (NaN) în loc să oprească toată rularea. Dacă rulezi asta într-un notebook Jupyter, asyncio.run eșuează pentru că un loop rulează deja. Apelează nest_asyncio.apply() înainte (Ragas depinde deja de el) sau așteaptă direct coroutine-ul.
Cu helperul la locul lui, rularea completă e scurtă:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Iată scorurile din prima mea rulare, sortate după faithfulness și rotunjite la 3 zecimale, cu mediile în ultimul rând:
| Întrebare | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Medie | 0.778 | 0.668 | 0.722 | 0.833 |
Rulări ulterioare ale aceluiași set de date au punctat faithfulness mai jos din cauza flip-ului pe sample-ul de refuz, pe care îl acopăr în secțiunea de tracking.
Sortarea după faithfulness te ajută să identifici cele mai probabile halucinații, iar cea plantată e în vârf. Mediile din ultimul rând sunt numerele pentru dashboard.
Citește pe rânduri și fiecare eșec plantat apare în alt loc. Halucinația scade doar faithfulness. Ratarea regăsirii pune la zero relevanța, precision și recall împreună. Problema de clasare taie precision la 0.333, iar driftul apare ca cea mai mică relevanță dintre întrebările la care s-a răspuns.
O ciudățenie: răspunsul despre Canada e pe deplin susținut de fragmentul său, totuși a punctat 0.667 la faithfulness. Asta e zgomotul arbitrului, la care revin în secțiunea de tracking.
Answer relevancy compară sensul cu embeddings, deci chiar și un răspuns bun rar punctează aproape de 1.0: răspunsul despre rambursare a punctat 0.746, în timp ce răspunsul off-topic despre shipping a punctat 0.572. Evaluează relevanța după diferența dintre sample-uri și după trend în timp, nu după numărul absolut.
O poartă de calitate RAG este un script de test care rulează evaluarea, compară fiecare scor mediu cu un prag și iese cu un cod de eroare când vreo metrică e sub prag, ceea ce îi spune sistemului CI să blocheze merge-ul.
O atenționare întâi. Setul construit manual de mai devreme are răspunsurile și fragmentele regăsite scrise de mână, deci punctarea lui nu poate reflecta o schimbare a promptului sau a retrieverului. În CI trebuie să rulezi din nou linia reală peste întrebările salvate și apoi să punctezi ce a produs. Două scripturi mici fac asta.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py este singurul fișier pe care îl scrii tu: înlocuiește corpul lui answer() cu un apel către retrieverul și generatorul tău. refresh_dataset.py citește întrebările și răspunsurile de referință pe care le-a salvat build_dataset.py, rulează linia peste fiecare întrebare și rescrie eval_dataset.jsonl.
Poarta în sine este un dicționar de praguri și un loop. Pragurile de mai jos au fost calibrate pe setul de date de exemplu construit manual, așa că recalibrează-le pe outputul liniei tale înainte să te bazezi pe ele.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Față de baza mea, toate cele 4 medii trec pragurile, iar scriptul iese cu codul 0, ceea ce lasă merge-ul să treacă:
| Metrică | Medie | Prag | Rezultat |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer relevancy | 0.668 | 0.60 | Pass |
| Context precision | 0.722 | 0.65 | Pass |
| Context recall | 0.833 | 0.75 | Pass |
Am setat pragul de faithfulness la 0.60 în loc de 0.70 din cauza zgomotului arbitrilor pe care îl acopăr în secțiunea de tracking. Cu 6 sample-uri, un verdict instabil mută media cu 0.17, iar o rulare ulterioară a aceleiași linii a punctat 0.61. Poarta mai rulează și arbitrul de 3 ori și mediază scorurile (GATE_RUNS), ceea ce netezește flip-urile de verdict cu costul a 3 ori mai multe apeluri la arbitru.
O alegere de design este să pice pe not (actual >= threshold) mai degrabă decât pe actual < threshold. O comparație cu NaN („not a number”) e mereu False, deci un check scris ca actual < threshold ar trece build-ul ori de câte ori arbitrul eșuează.
skipna=False în medie acoperă cazul parțial. Implicit, pandas sare peste NaN, deci câteva apeluri eșuate la arbitru ar micșora pe ascuns eșantionul în loc să pice poarta. O eroare tranzitorie a arbitrilor pică acum build-ul, deci rulează jobul din nou înainte să faci debug.
Pragurile sunt greu de reglat. Pune-le puțin sub cea mai mică medie pe care ai văzut-o de-a lungul rularilor repetate, nu la un 0.9 aspirațional, altfel poarta blochează fiecare pull request și echipa nu mai are încredere în CI. Resetează-le ori de câte ori schimbi modelul-arbitru sau adaugi mai mult decât câteva sample-uri.
Legarea în GitHub Actions e un workflow scurt. Referința de sintaxă pentru workflow acoperă filtrele de cale pentru on.pull_request și cronul schedule folosit aici:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Câteva detalii importante în acel workflow:
JUDGE_MODEL și cheia sa API corespunzătoare. Folosește același arbitru cu care ai calibrat pragurile, altfel scorurile din CI nu vor fi comparabile cu istoricul urmărit.GATE_SAMPLE punctează un subset aleatoriu fix de 30 de rânduri, ca să nu aștepți 10 minute după apelurile la arbitru. Cronul nightly punctează tot.scores.csv și ragas_history.jsonl ca artifact, pentru că discul runnerului dispare când jobul se termină.Rulează suita completă pe cronul nightly, când nimeni nu așteaptă. O rulare nightly eșuată apare ca un workflow eșuat, iar setările de notificare GitHub sau un pas Slack pot anunța proprietarul dimineața. GitLab CI are aceeași formă, cu rules: changes: și un program de pipeline.
Ragas generează întrebări de test sintetice citindu-ți documentele, extrăgând principalele lor subiecte și fapte, legând fragmente înrudite și apoi scriind întrebări de diferite feluri pornind de la acele legături.
Documentația despre generarea datelor de test împarte interogările în single-hop (un fragment poate răspunde) și multi-hop (răspunsul are nevoie de mai multe fragmente), iar fiecare dintre acestea poate fi specific sau abstract. Mixul implicit folosește 3 din cele 4 combinații în părți egale:
Ragas folosește doar sintetizatoarele pe care le pot susține documentele tale, deci un set mic de documente poate produce un mix diferit.
Generatorul are nevoie de documente reale de citit. Indică documentația ta în fișiere markdown. Pentru acest articol, am scris 5 pagini scurte de help-center pentru Northwind (aprox. 600 de cuvinte în total), și fiecare arată așa:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Documentele tale proprii vor produce întrebări diferite față de cele de mai jos, ceea ce este și ideea: generatorul scrie întrebări despre ceea ce spune de fapt baza ta de cunoștințe.
TestsetGenerator folosește același LLM arbitru și model de embedding pe care le-am construit deja. Încarc documentele cu DirectoryLoader din LangChain, folosind explicit TextLoader ca fișierele markdown să nu tragă dependența grea unstructured.
Cartografierea documentelor tale declanșează multe apeluri la arbitru deodată, așa că limitez și câte rulează în paralel cu RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Scriptul încarcă toate cele 5 documente și scrie aceste 8 întrebări. Întrebările urmăresc documentele, iar unele conțin typo-uri deliberate:
| # | Întrebare generată | Tip întrebare |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Tabelul arată etichete simplificate; coloana synthesizer_name din output conține numele complet al sintetizatorului. Opt întrebări din 5 documente au durat aproximativ 4,5 minute.
Typos-urile și interogarea în stil cuvânt-cheie din întrebarea 2 sunt deliberate: generatorul variază stilul și lungimea fiecărei interogări ca setul să arate ca traficul dintr-o căsuță de căutare, nu ca întrebări de examen.
Probabil vei vrea să te uiți peste întrebări ca să te asiguri că sunt utilizabile și relevante. Eu aș folosi outputul ca un prim draft. În fiecare set sintetic pe care l-am revizuit, unele întrebări sunt defecte (se referă la „document” sau întreabă despre un heading), unele răspunsuri de referință se abat de la ce spune sursa, iar formularea e mai formală decât a oricărui utilizator real.
Rulează din nou generatorul când adaugi o secțiune la documente și primești întrebări candidate pentru materialul nou, cu costul unei alte runde de apeluri la arbitru.
Fiecare rând are un user_input, un răspuns reference generat și reference_contexts, fragmentele din care a fost construită întrebarea. Verifică reference față de acele fragmente, pentru că acolo apare driftul.
Ca să transformi un rând revizuit într-un SingleTurnSample, rulează linia ta peste user_input pentru a obține retrieved_contexts și response. Adaugă perechile revizuite user_input și reference la eval_questions.jsonl, iar refresh_dataset.py face restul pentru tine.
Dacă baza ta de cunoștințe e un graf mai degrabă decât un morman de documente, același principiu se aplică cu un retriever diferit. Tutorialul nostru Using a Knowledge Graph to Implement a RAG Application și cursul Graph RAG with LangChain and Neo4j produc linii pe care le poți evalua exact cu cele 4 metrici de mai sus, pentru că metricile văd doar textul regăsit, nu cum a fost regăsit.
Urmărirea scorurilor Ragas în timp înseamnă să adaugi la un fișier jurnal, după fiecare rulare de evaluare, mediile scorurilor, hash-ul commit-ului git, modelul-arbitru și un timestamp, astfel încât o regresie să apară ca o scădere pe un grafic de linii, nu ca o surpriză în producție.
Un fișier JSON Lines probabil e cea mai bună opțiune până când ai nevoie de un tracker de experimente partajat pentru mai multe persoane. track_scores.py citește scores.csv, pe care îl scriu atât quality_gate.py cât și run_all.py, deci nu declanșează un al doilea rând de apeluri la arbitru.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Rularea uv run python track_scores.py adaugă o linie la jurnal și o afișează:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
În CI, fiecare job pornește cu un disc gol, deci ragas_history.jsonl conține doar înregistrarea acelei rulari. Ca să păstrezi trendul, descarcă artifactele încărcate și anexează-le într-un singur fișier sau comite fișierul într-un branch de metrici sau într-un storage de obiecte.
Plotarea istoricului este destul de simplă. Încearcă următorul script:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Vei obține un grafic de acest fel:
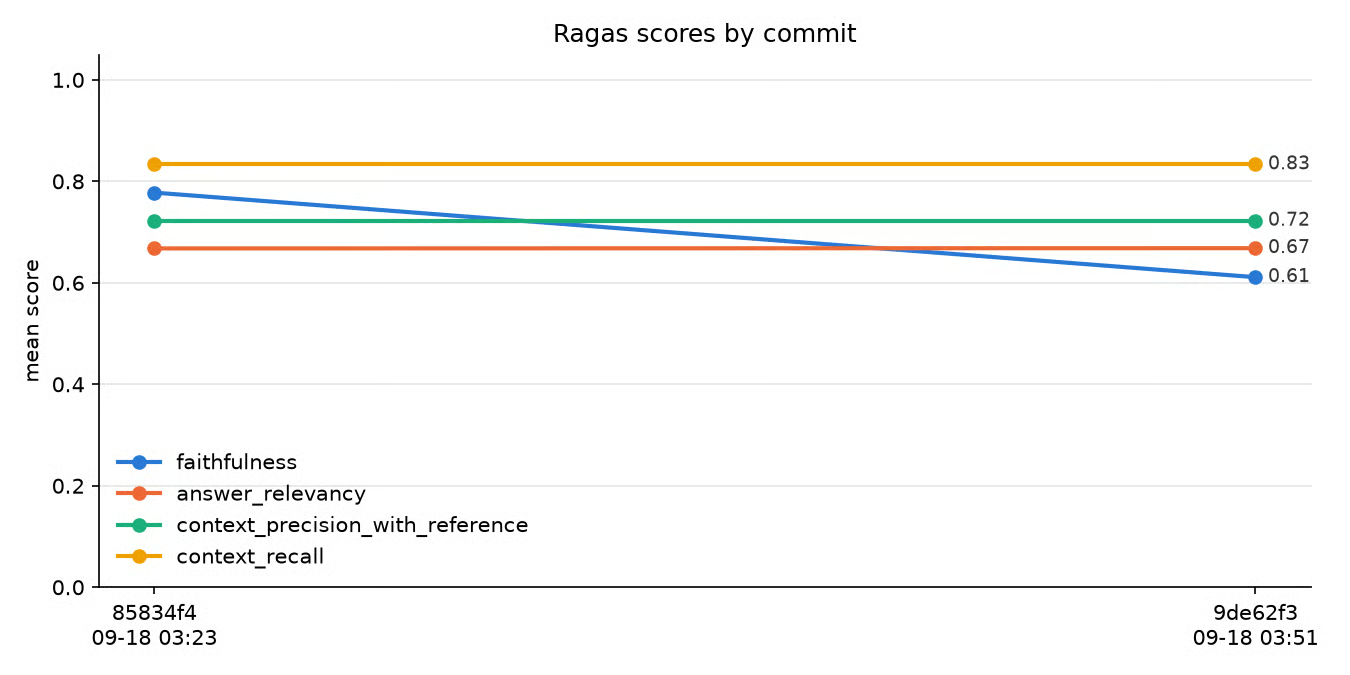
Scoruri medii Ragas înregistrate per commit de track_scores.py. Imagine de autor.
Nimic din linie nu s-a schimbat între acele commit-uri (al doilea a schimbat doar setările de conexiune ale clientului arbitrului), totuși faithfulness a scăzut de la 0.78 la 0.61 pentru că refuzul din sample-ul 6 a trecut de la 1.0 la 0.0.
Deci există zgomot real al arbitrului de urmărit până când ai un număr mare de sample-uri. Cu 6 sample-uri, 1 verdict instabil mută media cu 0.17. Cu 100 de sample-uri, același flip o mută cu 0.01, deci o schimbare mare e mult mai probabil o regresie reală.
Acum, la fiecare pull request sau commit, poți rula poarta, înregistra scorurile și privi graficul.
Dacă iei în calcul o schimbare arhitecturală mai mare, tutorialul nostru RAG vs. fine-tuning încadrează balanța, iar aceleași 4 metrici funcționează ca măsurătoare de dinainte și de după pentru oricare cale.
Scorurile „LLM ca arbitru” sunt estimări: au bias-uri cunoscute și pot varia de la o rulare la alta, dar se scalează la volume de evaluare pe care revizuirea umană nu le poate susține.
Ragas nu cere niciodată arbitrului să compare 2 răspunsuri, deci bias-ul de poziție (favorizarea răspunsului care vine primul) în mare nu se aplică. Bias-ul de verbositate (favorizarea răspunsurilor mai lungi) și bias-ul de auto-preferință (arbitrii preferă răspunsuri de la propriul lor model) pot conta în continuare. Zheng et al. (2023) descriu toate cele 3 bias-uri, iar auto-preferința e motivul pentru care nu aș folosi același model ca generator și arbitru.
Variația între rulari e partea pe care vreau să o vezi cu ochii tăi, pentru că îți schimbă modul în care setezi pragurile. De-a lungul rularilor acelor 6 sample-uri cu același arbitru fixat, răspunsul de refuz din sample-ul 6 a punctat 0.0 într-o rulare și 1.0 în alta la faithfulness, iar sample-ul 5, pe deplin ancorat, a punctat 0.667 în rularea arătată mai sus.
Scorurile per-sample de la un arbitru ieftin au mult zgomot. Mediile peste 100 de sample-uri au mult mai puțin zgomot, iar poarta CI ar trebui să testeze mereu media.
Trei practici țin zgomotul sub control:
judge.py și track_scores.py mai sus, ca o schimbare de arbitru să nu fie confundată cu o schimbare a liniei.Pentru un tur mai larg al abordărilor de evaluare dincolo de RAG, inclusiv metodele de evaluare umană pe care arbitrul le înlocuiește, ghidul nostru LLM evaluation acoperă metricile și metodologiile. Tutorialul nostru LLM ca arbitru merge mai adânc în construirea unui arbitru pentru linii RAG.
Scopul acestei linii este să ne permită să spunem lucruri precum „retrieverul e OK, promptul a regresat” sau „rerankerul a reparat precision, dar recall încă e 0.6”, cu numere în spatele afirmației.
Faithfulness și answer relevancy urmăresc generatorul: faithfulness prinde faptele inventate, iar answer relevancy prinde răspunsurile care deviază de la întrebare. Context precision și recall urmăresc retrieverul și îți spun dacă aduce informația corectă. Pentru că 2 din 4 nu au nevoie de răspuns de referință, le poți rula pe trafic de producție unde nu există referință.
Metricile standard de text măsoară suprapunerea de cuvinte, ceea ce nu spune nimic despre o politică de rambursare inventată, iar un singur număr end-to-end ascunde care jumătate a liniei s-a stricat. Un framework care verifică separat cele 2 puncte de eșec poate vedea asta, iar transformarea lui dintr-un audit punctual într-o poartă CI cu un fișier de istoric este ceea ce face echipa ta să acționeze pe baza numerelor.
Dacă nu ai construit încă linia, începe cu cursul nostru Retrieval-Augmented Generation with LangChain și apoi leagă pipeline.py din acest articol de ceea ce construiești.
Pentru linii care merg dincolo de regăsirea de text simplă, cursul nostru End-to-End RAG with Weaviate, ghidul nostru RAG multimodal și tutorialul nostru agentic RAG construiesc sisteme pe care le poți puncta la fel, cu o singură rezervă: cele 4 metrici de bază citesc doar text. O linie care regăsește imagini are nevoie de metricile multimodale separate ale Ragas, iar o linie agentică are nevoie ca fiecare pas de regăsire să fie punctat ca propria sa întrebare, fragmente și răspuns.
Cursuri DataCamp de top
Curs
Curs
Curs