
Curso
Graph RAG con LangChain y Neo4j
3 h
2.3K
Un pipeline de generación aumentada por recuperación (RAG) para un chatbot supera todas las pruebas rápidas en el notebook. Luego empiezan a llegar tickets de soporte por respuestas erróneas o extrañas, y en los registros de las pruebas rápidas no aparece ninguna alerta.
Este fallo es difícil de detectar porque es invisible sin métricas. Un pipeline RAG puede fallar en 2 puntos: el recuperador puede traer los fragmentos equivocados, o el generador puede ignorar buenos fragmentos e inventarse hechos. Un único número de exactitud extremo a extremo no te dice cuál de los dos ha pasado, así que tampoco te dice qué arreglar.
En este tutorial, voy a construir un pipeline completo de evaluación RAG en Python usando Ragas 0.4.3: un conjunto de evaluación hecho a mano, las 4 métricas clave (faithfulness, answer relevancy, context precision y context recall), una puerta de calidad en integración continua (CI) que falla la build cuando bajan las puntuaciones, un generador de conjunto de pruebas sintético y un registro de puntuaciones en JSON Lines.
Si antes quieres más contexto, consulta nuestra guía sobre qué es RAG, nuestro tutorial sobre usar un modelo de lenguaje grande (LLM) como juez para evaluar pipelines RAG y nuestro resumen de técnicas avanzadas de RAG.
Necesitas Python 3.9 o superior (yo uso 3.12), uv o pip, una clave de API para un modelo juez compatible con OpenAI y una idea general de cómo funciona un pipeline RAG. Si primero quieres afianzar eso, te recomiendo nuestro curso Retrieval-Augmented Generation with LangChain, que construye el tipo de pipeline que vamos a evaluar.
Las métricas de solapamiento de texto como BLEU (Bilingual Evaluation Understudy) y ROUGE (Recall-Oriented Understudy for Gisting Evaluation) no son la vara adecuada para RAG. Ragas usa en su lugar un LLM juez para puntuar cada respuesta en 4 ejes: faithfulness y answer relevancy diagnostican al generador, mientras que context precision y context recall diagnostican al recuperador.
Pon esos 4 números detrás de un umbral en CI y regístralos por commit, y tendrás una alarma de regresión en lugar de una auditoría puntual.
Un aviso antes de empezar. La API de Ragas ha cambiado dos veces en 2 años: la v0.2 sustituyó los datasets de diccionarios por SingleTurnSample y EvaluationDataset, y la v0.4 hizo que las métricas de collections (introducidas en la v0.3.9) fueran la opción por defecto y marcó la antigua función evaluate() como obsoleta.
La mayoría de tutoriales en línea aún muestran código de la v0.1 o v0.2. Todo lo de abajo funciona con 0.4.3, la versión actual en octubre de 2026.
RAG necesita sus propias métricas porque las clásicas solo cuentan cuántas palabras comparte una respuesta con una respuesta de referencia, y el problema en un sistema RAG no es compartir redacción.
BLEU (Papineni et al., 2002) y ROUGE (Lin, 2004) se construyeron para traducción automática y resumen, donde una buena salida debería usar casi las mismas palabras que la referencia. Una respuesta RAG que dice “tienes 2 semanas” en vez de “14 días” puntúa mal en ambas, mientras que una respuesta fluida que se inventa una política de reembolsos puede puntuar bien si reutiliza palabras de la referencia.
El problema de fondo es que un pipeline RAG puede fallar en 2 lugares distintos: el recuperador puede elegir la información equivocada, o el generador puede ignorar buena información e inventarse hechos. Cuando una respuesta es incorrecta, necesitas saber cuál de estas cosas ha pasado:
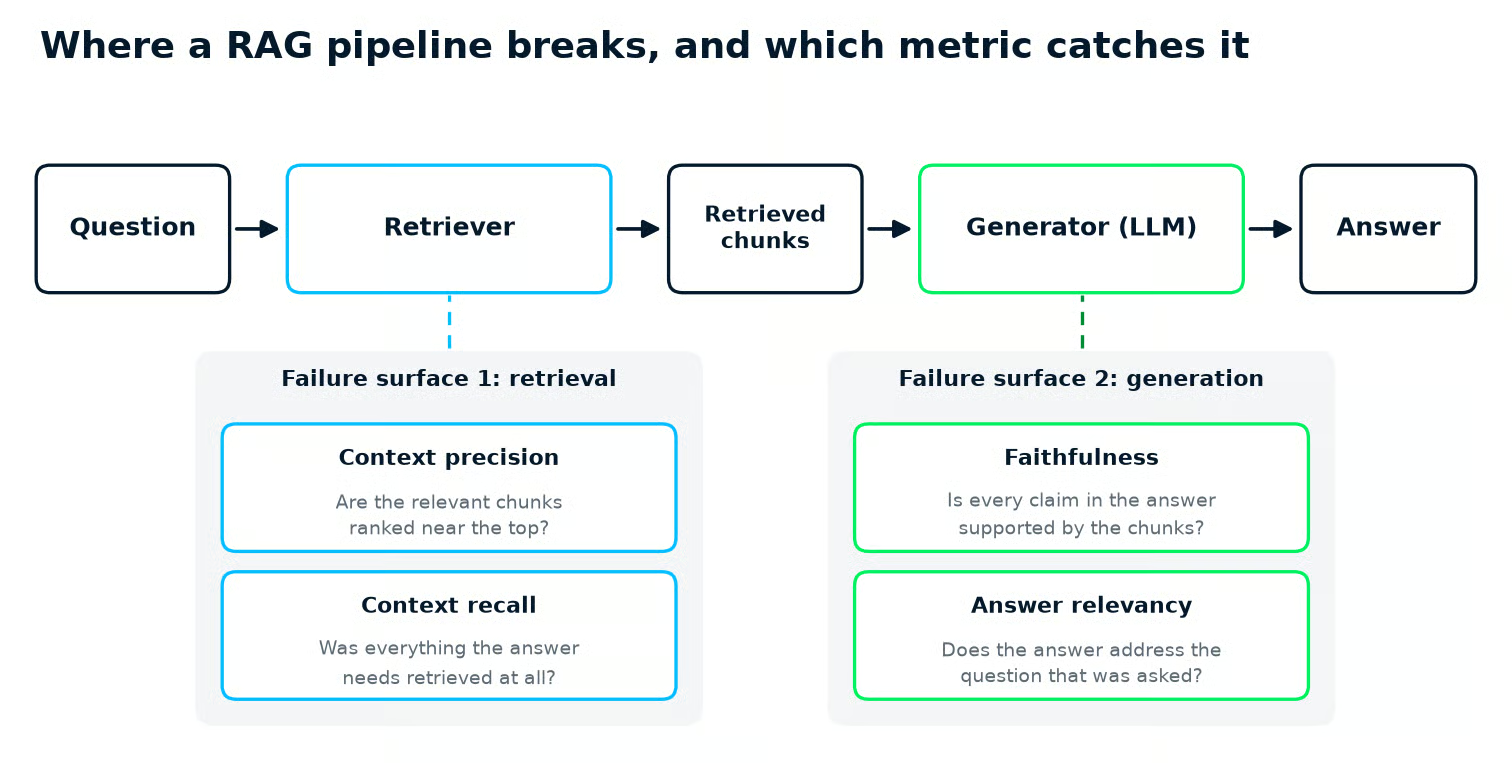
Los 2 modos de fallo de un pipeline RAG: context precision y recall diagnostican el recuperador, mientras que faithfulness y answer relevancy diagnostican el generador. Imagen del autor.
Nuestra guía What Is Retrieval Augmented Generation (RAG)? A Complete Guide recorre las fases del pipeline donde se originan esos fallos.
Ragas es un framework open source en Python que te da un número para cada parte del pipeline. No es la única opción. Las 2 alternativas principales son DeepEval, que envuelve la evaluación en casos de prueba al estilo pytest, y Evidently, que añade comprobaciones con LLM como columnas extra en un dataset y las alimenta en informes de monitorización.
| Framework | Mejor para | Métricas específicas de RAG integradas | Datos de prueba desde tus documentos | Estilo de configuración |
|---|---|---|---|---|
| Ragas | Diagnosticar pipelines RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Objetos de métricas más un juez desde llm_factory() |
| DeepEval | Pruebas de LLM en CI al estilo de tests unitarios | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Objetos LLMTestCase, assert_test() ejecutados con deepeval test run |
| Evidently | Cuadros de mando y deriva en el tiempo | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Generación de dataset RAG en Evidently Cloud | Descriptores sobre un Dataset, resumidos por un Report |
He elegido Ragas para este tutorial porque sus 4 métricas principales separan claramente las puntuaciones del recuperador y del generador, y porque su generador de conjuntos de prueba viene en el mismo paquete open source.
Si tu equipo ya vive en pytest, el assert_test() de DeepEval te resultará más natural. Si lo que buscas es un panel con calidad de tráfico en vivo, los informes de Evidently te llevan más rápido.
Configurar Ragas significa instalar el paquete, fijar una dependencia y elegir un LLM juez que compartirán todas las métricas. Usaré uv porque bloquea por ti las versiones exactas de los paquetes, pero pip install con las mismas versiones también sirve.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Aquí uso Python 3.12. Ragas 0.4.3 declara compatibilidad con Python 3.9 o superior.
El paquete rapidfuzz lo necesita el generador de conjuntos de prueba sintéticos más adelante. Ragas no lo declara como dependencia, así que lo instalo desde el principio.
El pin langchain-community<0.4 no es opcional en el momento de escribir esto. Ragas 0.4.3 importa ChatVertexAI desde una ruta de módulo que langchain-community 0.4 eliminó, así que una instalación limpia sin el pin falla al importar ragas.
Ahora, el juez. Cada métrica basada en LLM en Ragas hace 1 o más llamadas a un modelo juez, así que lo construyes una vez y lo pasas a todas. Yo lo guardo en su propio módulo, judge.py, y leo la clave del entorno para que ninguna credencial acabe en git.
Este archivo muestra cómo llamar a OpenAI directamente o a Gemini a través del endpoint compatible con OpenAI de Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Dos detalles en ese archivo pueden fastidiar tu primera ejecución:
llm_factory() en 0.4 necesita que le pases un objeto cliente, y pasar solo el nombre del modelo provoca un error.llm_factory() va directo a la llamada al modelo, que es cómo aumento max_tokens por encima del valor por defecto de 1.024.Usa el modelo más barato que produzca puntuaciones estables en una muestra que hayas verificado a mano, y luego fíjalo. En una batería grande de evaluación el volumen suma rápido: faithfulness hace 2 llamadas al juez por muestra, answer relevancy hace 3 más 2 llamadas de embeddings, context precision hace 1 por fragmento recuperado y context recall hace 1.
Seis muestras a través de 4 métricas sumaron 62 solicitudes en una sola ejecución: 50 llamadas al juez más 12 de embeddings. Estos son los costes de 3 modelos juez pequeños actuales según el precio de lista de cada proveedor a 19 de octubre de 2026:
| Modelo juez | Entrada por 1M tokens | Salida por 1M tokens | Fuente |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API pricing |
| claude-haiku-5-5 | $0.10 (prompts hasta 100K tokens) | $0.50 (prompts hasta 100K tokens) | Claude API pricing |
El valor por defecto en judge.py sigue siendo gpt-4o-mini, un modelo antiguo de OpenAI que no aparece en la tabla principal de precios de su página. Define la variable JUDGE_MODEL para cambiarlo.
Un detalle si quieres usar Claude como juez: answer relevancy también necesita un modelo de embeddings y Anthropic no ofrece uno. En su documentación remiten a Voyage AI, así que emparejarías Claude con embeddings de otro proveedor.
Fijar el modelo importa más que la elección. Cambiar el juez desplaza las puntuaciones aunque tu pipeline no haya cambiado, lo que estropea la serie temporal que estás a punto de construir en la sección de seguimiento.
Pon el nombre del modelo en judge.py bajo control de versiones y trata una actualización del juez como cualquier cambio rompedor: recalibra todos los umbrales con las nuevas puntuaciones del juez.
Cada caso de prueba en el dataset se llama sample. Una sample es más que una respuesta: registra un viaje completo por el pipeline, en 4 campos:
| Campo | Qué contiene |
|---|---|
user_input |
La pregunta que hizo la persona usuaria |
retrieved_contexts |
Los fragmentos que devolvió el recuperador para esa pregunta |
response |
La respuesta que dio el pipeline RAG |
reference |
La respuesta correcta, escrita por una persona |
Ragas guarda cada sample como SingleTurnSample y el conjunto completo como EvaluationDataset. El reference es opcional, pero las métricas de recuperación comparan contra él, así que yo siempre lo incluyo en el set curado aunque las métricas sin referencia lo ignoren.
Construí 6 samples para una tostadora de café ficticia, Northwind Coffee. Cada sección de métricas añade el sample que esa métrica debería detectar.
Empieza build_dataset.py con los 3 primeros samples: una respuesta limpia, una alucinación deliberada y una segunda respuesta limpia que hace varias afirmaciones a la vez.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Cada contexto recuperado es un fragmento de las páginas del centro de ayuda de Northwind, escrito en el script exactamente como un recuperador se lo pasaría al generador. Ejecuta uv run python build_dataset.py para escribir eval_dataset.jsonl y eval_questions.jsonl, y vuelve a ejecutarlo cada vez que una sección posterior añada un sample.
Guardar en JSON Lines es importante porque todos los scripts posteriores (las ejecuciones de métricas, la puerta de CI) cargan el mismo eval_dataset.jsonl con EvaluationDataset.from_jsonl().
En un proyecto real, los campos retrieved_contexts y response salen de ejecutar tu pipeline real sobre las preguntas, y solo user_input y reference están escritos a mano. La sección de CI muestra cómo automatizar ese paso.
Las 6 samples con las que termina este artículo bastan para aprender las métricas, pero no para confiar en un umbral. Apunta a unas 100 antes de fiarte; la sección de seguimiento explica por qué. Cuántas necesitas depende de lo exigente que sea tu caso, así que me centro en una buena mezcla más que en un número concreto:
Las 4 métricas básicas son faithfulness y answer relevancy para el generador, y context precision y context recall para el recuperador. Las 4 devuelven una puntuación entre 0 y 1. Lo útil es que cada número te dice qué parte debes arreglar.
Faithfulness mide cuánto de una respuesta está respaldado por los fragmentos recuperados. El juez divide la respuesta en afirmaciones y comprueba cada una contra los fragmentos: 1.0 significa que todas están soportadas y 0.0 que ninguna lo está.
Faithfulness no necesita una respuesta de referencia, así que puedes ejecutarla sobre tráfico de producción, no solo sobre tu set de pruebas. Vuelve a ejecutarla siempre que cambies el prompt, el modelo o cuánta información de contexto ve el modelo, porque esos cambios son los que más a menudo introducen alucinaciones.
La forma más rápida de verlo en acción es sobre una única respuesta, sin dataset:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Ejecuta con uv run python quick_check.py y verás faithfulness = 0.00, porque ninguna de las dos afirmaciones de la respuesta (6 meses, una bolsa gratis) está respaldada por el contexto. En 0.4 se puntúa con el método ascore() de cada métrica, que devuelve un resultado cuyo .value es la puntuación.
Puntuado en todo el dataset hasta ahora, la alucinación intencionada del sample 2 obtiene 0.0, como debe ser, y las dos respuestas limpias obtienen 1.0. Los resultados completos de cada métrica están en la sección de evaluación multimétrica más abajo.
Answer relevancy mide si la respuesta realmente aborda la pregunta. El juez lee la respuesta y escribe 3 preguntas a las que esa respuesta sería buena, y Ragas comprueba cuán cercanas en significado son esas preguntas a la original usando un modelo de embeddings. Si la respuesta esquiva la pregunta, el juez la marca como evasiva y puntúa 0.
Ragas llama a la clase AnswerRelevancy (ejemplos antiguos la llaman ResponseRelevancy, y la página de docs se titula Response Relevancy), y necesita tanto el LLM juez como el modelo de embeddings.
Una relevancia baja con una faithfulness alta suele señalar al generador o al prompt: el modelo tenía el contexto correcto y se mantuvo anclado a él, pero contestó a otra cosa. Antes comprueba context precision y recall, porque un recuperador que devuelve fragmentos fuera de tema puede producir el mismo patrón.
Este sample muestra el caso del generador. El recuperador devuelve el fragmento de envío correcto, la respuesta se mantiene anclada y habla sobre fechas de tueste en lugar de costes de envío. Añade el nuevo fragmento a los de la parte superior de build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Luego añade el nuevo sample al final de la lista samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Cada sample recibe una puntuación de relevancia: qué tan de cerca las preguntas que el juez escribió a partir de la respuesta coinciden con la pregunta que realmente se hizo, donde 1.0 es coincidencia perfecta.
Context precision comprueba si los fragmentos útiles están bien clasificados en lo alto de lo que devolvió el recuperador, y context recall comprueba si el recuperador encontró todo lo necesario para redactar la respuesta correcta.
Precision da más crédito a un fragmento útil cuanto más arriba esté clasificado, así que un fragmento útil en primer lugar cuenta más que el mismo en tercero. Recall es la proporción de hechos en la respuesta de referencia que al menos un fragmento recuperado respalda.
Ambas necesitan el campo reference. En la API de collections las clases son ContextPrecisionWithReference y ContextRecall, y ambas solo reciben el LLM juez. La documentación de Ragas también usa el nombre más corto ContextPrecision para la versión con referencia, así que puedes ver cualquiera de los dos.
Hasta ahora cada sample recupera los fragmentos correctos primero, así que ninguna métrica tiene nada que detectar. Añadamos 2 samples que rompen la recuperación de formas distintas: uno donde el fragmento correcto se recupera pero va el último, y otro donde no se recupera nada relevante, por lo que el modelo declina correctamente. Como antes, añade los fragmentos al inicio del archivo:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Luego añade las samples al final de la lista:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
El ranking importa porque la mayoría de pipelines pasan solo los primeros fragmentos al modelo, así que un fragmento útil en 6ª posición de un recuperador top-5 es como si no existiera.
La sample 5 coloca su único fragmento útil en último lugar de 3, y precision sale 0,333 porque la información útil está la última. La sample 6, el fallo de recuperación, puntúa 0,0 en precision y en recall.
La sample 6 también enseña algo sobre faithfulness. El modelo se negó correctamente, pero esa negativa puntuó 1,0 en algunas ejecuciones y 0,0 en otras, sin cambios entre medias. Una frase como “no tengo información sobre la garantía” no está ni respaldada ni contradicha por el contexto, y el juez lanza una moneda.
Si tu pipeline debe rehusar responder, puntúa las negativas por separado en lugar de dejar que arrastren faithfulness. Ragas 0.4 eliminó AspectCritic de la API de collections, así que el reemplazo es una comprobación personalizada con el decorador @discrete_metric (mira la guía de migración de v0.3 a v0.4).
Lee los 2 números de recuperación juntos y te dirán dónde invertir la próxima semana:
| Context precision | Context recall | Diagnóstico | Qué cambiar |
|---|---|---|---|
| Alta | Alta | Recuperación sana | Enfócate en el generador: prompt, modelo, faithfulness |
| Baja | Alta | Fragmentos correctos recuperados pero mal clasificados | Añade o ajusta un reranker |
| Alta | Baja | Top de fragmentos relevantes pero incompletos | Pasa más fragmentos al modelo, usa fragmentos más grandes o revisa el troceado |
| Baja | Baja | El recuperador falla de forma general | Revisa embeddings, indexación y reescritura de consultas |
La fila de “baja precision, alta recall” es la más común que veo en la práctica y es la más barata de arreglar.
Nuestro tutorial RankGPT as a Re-Ranking Agent for RAG añade un reranker con LLM encima de un recuperador existente, y nuestro tutorial Boost LLM Accuracy with RAG and Reranking muestra otra configuración de reranking. Nuestra guía de 5 técnicas clave para mejorar el rendimiento de RAG cubre el troceado y la reescritura de consultas para las otras filas.
Vuelve a ejecutar las 2 métricas de recuperación tras cada cambio y la tabla te dirá si ha funcionado.
Una evaluación multimétrica completa ejecuta las 4 métricas sobre cada sample en paralelo y recopila las puntuaciones, con valores por fila para profundizar en los fallos y medias por columna para tu panel.
En Ragas 0.2 y 0.3 hacías esto con evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). En 0.4.3 esa función sigue existiendo, pero avisa de que está obsoleta y rechaza las métricas nuevas, porque ya no heredan de la antigua clase Metric que espera.
El reemplazo es el @experiment decorator, que ejecuta tu pipeline y tus métricas juntos sobre un Dataset y escribe resultados a CSV. Es la herramienta adecuada cuando ya tienes un pipeline que llamar.
Para puntuar un dataset estático, prefiero un pequeño helper: construye las 4 métricas una vez para cada script que las necesite y mantiene las llamadas paralelas y el manejo de errores en código legible:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
La única línea no obvia es la llamada a inspect.signature(). Las 4 métricas quieren entradas distintas (faithfulness necesita la respuesta, recall necesita la referencia), así que el helper lee qué argumentos acepta el ascore() de cada métrica y pasa exactamente esos campos de la sample, lo que permite que un único bucle sirva para todas.
El semáforo limita cuántas llamadas al juez se ejecutan a la vez, y una métrica que aún falle se convierte en una celda vacía (NaN) en lugar de abortar toda la ejecución. Si lo ejecutas dentro de un notebook Jupyter, asyncio.run falla porque ya hay un bucle corriendo. Llama antes a nest_asyncio.apply() (Ragas ya depende de él) o espera la corrutina directamente.
Con el helper listo, la ejecución completa es corta:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Estas son las puntuaciones de mi primera ejecución, ordenadas por faithfulness y redondeadas a 3 decimales, con las medias en la última fila:
| Pregunta | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
En ejecuciones posteriores del mismo dataset, faithfulness salió más baja por el cambio de veredicto en la sample de negativa que cubro en la sección de seguimiento.
Ordenar por faithfulness te ayuda a localizar las alucinaciones más probables, y la sembrada está arriba. Las medias de la última fila son tus números de panel.
Lee las filas de izquierda a derecha y cada fallo provocado aparece en un sitio distinto. La alucinación solo baja faithfulness. El fallo de recuperación pone a cero relevancia, precision y recall a la vez. El problema de ranking baja precision a 0,333, y la deriva aparece como la relevancia más baja entre las preguntas respondidas.
Una rareza: la respuesta sobre Canadá está totalmente respaldada por su fragmento y aun así obtuvo 0,667 en faithfulness. Es ruido del juez, al que vuelvo en la sección de seguimiento.
Answer relevancy compara significados con embeddings, así que incluso una buena respuesta rara vez se acerca a 1,0: la respuesta de reembolso puntuó 0,746, mientras que la respuesta fuera de tema sobre envío puntuó 0,572. Juzga la relevancia por la diferencia entre samples y por la tendencia, no por el número absoluto.
Una puerta de calidad RAG es un script de prueba que ejecuta la evaluación, compara cada media con un umbral y sale con código de error cuando alguna métrica no llega, lo que indica al sistema de CI que bloquee el merge.
Un detalle primero. El dataset hecho a mano de antes tiene sus respuestas y fragmentos recuperados escritos a mano, así que puntuarlo nunca reflejará un cambio en tu prompt o recuperador. En CI necesitas volver a ejecutar el pipeline real sobre tus preguntas guardadas y luego puntuar lo que produjo. Dos scripts pequeños lo hacen.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py es el único archivo que escribes tú: sustituye el cuerpo de answer() por una llamada a tu recuperador y generador. refresh_dataset.py lee las preguntas y respuestas de referencia que guardó build_dataset.py, ejecuta el pipeline sobre cada pregunta y reescribe eval_dataset.jsonl.
La puerta en sí es un diccionario de umbrales y un bucle. Los umbrales de abajo se calibraron con el dataset de ejemplo hecho a mano, así que recalíbralos con la salida de tu propio pipeline antes de fiarte.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Contra mi línea base, las 4 medias superan sus umbrales y el script sale con código 0, lo que permite el merge:
| Métrica | Media | Umbral | Resultado |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer relevancy | 0.668 | 0.60 | Pass |
| Context precision | 0.722 | 0.65 | Pass |
| Context recall | 0.833 | 0.75 | Pass |
Puse el umbral de faithfulness en 0,60 en lugar de 0,70 por el ruido del juez que cubro en la sección de seguimiento. Con 6 samples, un veredicto inestable mueve la media 0,17, y una ejecución posterior del pipeline sin cambios arrojó 0,61. La puerta también ejecuta el juez 3 veces y promedia las puntuaciones (GATE_RUNS), lo que suaviza cambios puntuales a 3 veces el coste del juez.
Una decisión de diseño es fallar con not (actual >= threshold) en lugar de actual < threshold. Una comparación con NaN (“not a number”) siempre es False, así que una comprobación escrita como actual < threshold aprobaría la build cuando fallara el juez.
El skipna=False en la media cubre el caso parcial. pandas se salta los NaN por defecto, así que unas cuantas llamadas fallidas al juez encogerían la muestra en silencio en lugar de hacer fallar la puerta. Un error transitorio del juez ahora falla la build, así que reejecuta el job antes de ponerte a depurar.
Los umbrales son delicados de ajustar. Ponlos ligeramente por debajo de la media más baja que hayas visto en ejecuciones repetidas, no en un 0,9 aspiracional, o la puerta bloqueará cada pull request y el equipo dejará de confiar en CI. Reinícialos siempre que cambies el modelo juez o añadas más de unas pocas samples.
Integrarlo en GitHub Actions es un workflow corto. La referencia de sintaxis cubre los filtros de rutas en on.pull_request y el cron de schedule usado aquí:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Algunos detalles de ese workflow importan:
JUDGE_MODEL y su clave de API correspondiente. Usa el mismo juez con el que calibraste los umbrales, o CI no será comparable con tu histórico.GATE_SAMPLE puntúa un subconjunto aleatorio fijo de 30 filas, para que una revisión no espere 10 minutos por llamadas al juez. El cron nocturno lo puntúa todo.scores.csv y ragas_history.jsonl como artefacto, porque el disco del runner desaparece al terminar el job.Ejecuta la suite completa en el cron nocturno, cuando nadie está esperando. Una ejecución nocturna fallida aparece como un workflow fallido, y la configuración de notificaciones de GitHub o un paso de Slack pueden avisar a la persona responsable por la mañana. GitLab CI tiene la misma forma con rules: changes: y un pipeline schedule.
Ragas genera preguntas de prueba sintéticas leyendo tus documentos, extrayendo sus temas y hechos principales, enlazando fragmentos relacionados y escribiendo preguntas de distintos tipos a partir de esos enlaces.
La documentación de generación de datos de prueba divide las consultas en single-hop (un fragmento basta para responder) y multi-hop (la respuesta necesita varios fragmentos), y cada una de esas puede ser específica o abstracta. La mezcla por defecto usa 3 de esas 4 combinaciones a partes iguales:
Ragas solo usa los sintetizadores que tus documentos pueden soportar, así que un conjunto pequeño de documentos puede producir una mezcla distinta.
El generador necesita documentos reales que leer. Apúntalo a tu propia documentación como archivos markdown. Para este artículo, escribí 5 páginas cortas del centro de ayuda de Northwind (unos 600 palabras en total) y cada una tiene este aspecto:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Tus propios documentos producirán preguntas diferentes a las de abajo, que es lo ideal: el generador escribe preguntas sobre lo que realmente dice tu base de conocimiento.
El TestsetGenerator usa el mismo LLM juez y el mismo modelo de embeddings que ya construimos. Cargo los documentos con DirectoryLoader de LangChain, usando TextLoader explícitamente para que los markdown no arrastren la pesada dependencia unstructured.
Mapear tus documentos dispara muchas llamadas al juez a la vez, así que también limito cuántas se ejecutan en paralelo con RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
El script carga los 5 documentos y escribe estas 8 preguntas. Las preguntas siguen los documentos y algunas incluyen faltas intencionadas:
| # | Pregunta generada | Tipo de pregunta |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
La tabla muestra etiquetas simplificadas; la columna synthesizer_name en la salida contiene el nombre completo del sintetizador. Ocho preguntas desde 5 documentos tardaron unos 4,5 minutos.
Las faltas y la consulta estilo “keywords” en la pregunta 2 son deliberadas: el generador varía el estilo y la longitud de cada consulta para que el conjunto parezca tráfico de buscador y no preguntas de examen.
Probablemente querrás revisar las preguntas para asegurar que son utilizables y relevantes. Yo usaría la salida como primer borrador. En cada set sintético que he revisado, algunas preguntas están mal formadas (hacen referencia a “el documento” o a un encabezado), algunas respuestas de referencia se desvían de lo que dice la fuente y la redacción es más formal que la de cualquier usuario real.
Vuelve a ejecutar el generador cuando añadas una sección a la documentación y obtendrás preguntas candidatas para el material nuevo, al coste de otra ronda de llamadas al juez.
Cada fila tiene un user_input, una reference generada y reference_contexts, los fragmentos a partir de los cuales se construyó la pregunta. Comprueba la reference contra esos fragmentos, porque ahí es donde aparece la deriva.
Para convertir una fila revisada en SingleTurnSample, ejecuta tu pipeline sobre el user_input para obtener retrieved_contexts y response. Añade los pares revisados de user_input y reference a eval_questions.jsonl y refresh_dataset.py lo hará por ti.
Si tu base de conocimiento es un grafo en vez de un conjunto de documentos, el mismo principio se aplica con otro recuperador. Nuestro tutorial Using a Knowledge Graph to Implement a RAG Application y nuestro curso Graph RAG with LangChain and Neo4j producen pipelines que puedes evaluar exactamente con las 4 métricas de arriba, porque las métricas solo ven el texto recuperado, no cómo se recuperó.
Hacer seguimiento de las puntuaciones de Ragas en el tiempo significa añadir tras cada ejecución las medias, el hash del commit de git, el modelo juez y una marca temporal a un archivo de log, para que una regresión aparezca como una bajada en una línea en lugar de una sorpresa en producción.
Un archivo JSON Lines probablemente es la mejor opción hasta que necesites un tracker de experimentos compartido. track_scores.py lee scores.csv, que escriben tanto quality_gate.py como run_all.py, así que nunca dispara una segunda ronda de llamadas al juez.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Ejecutar uv run python track_scores.py añade una línea al registro y la imprime:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
En CI cada job empieza con un disco vacío, así que ragas_history.jsonl solo contiene el registro de esa ejecución. Para mantener una serie, descarga los artefactos subidos y añádelos a un archivo, o comítelo en una rama de métricas o en almacenamiento de objetos.
Graficar el histórico es bastante sencillo. Prueba este script:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Obtendrás un gráfico parecido a este:
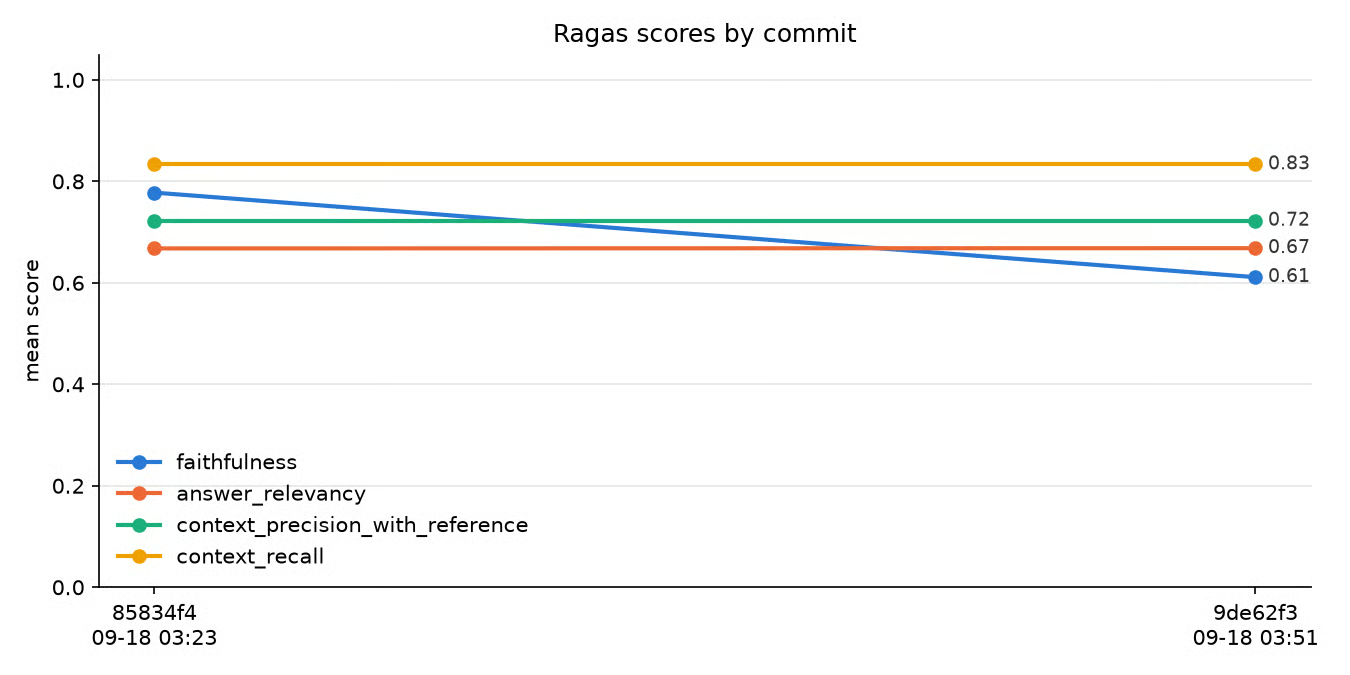
Puntuaciones medias de Ragas registradas por commit por track_scores.py. Imagen del autor.
No cambió nada en el pipeline entre esos commits (el segundo solo cambió los ajustes de conexión del cliente del juez), y aun así faithfulness cayó de 0,78 a 0,61 porque la negativa en la sample 6 pasó de 1,0 a 0,0.
Así que hay ruido real del juez a vigilar hasta que tengas un número amplio de samples. Con 6, un veredicto inestable mueve la media 0,17. Con 100, el mismo cambio la mueve 0,01, así que un bajón grande es mucho más probable que sea una regresión real.
Ahora, con cada pull request o commit, puedes ejecutar la puerta, registrar las puntuaciones y mirar el gráfico.
Si estás valorando un cambio arquitectónico más grande, nuestro tutorial RAG vs. fine-tuning enmarca el trade-off, y las mismas 4 métricas sirven como medición antes y después en cualquiera de los dos caminos.
Las puntuaciones con LLM como juez son estimaciones: tienen sesgos conocidos y pueden variar de una ejecución a otra, pero escalan a volúmenes de evaluación inasumibles para revisión humana.
Ragas nunca pide al juez comparar 2 respuestas, así que el sesgo de posición (favorecer la que va primero) apenas aplica. El sesgo de verbosidad (favorecer respuestas largas) y el de autocomplacencia (jueces que favorecen respuestas de su propio modelo) sí pueden importar. Zheng et al. (2023) describen los 3 sesgos, y el de autocomplacencia es por lo que no usaría el mismo modelo como generador y como juez.
La variación entre ejecuciones es lo que quiero que veas con tus propios ojos, porque cambia cómo fijas umbrales. En ejecuciones del mismo set de 6 samples con el mismo juez fijado, la negativa del sample 6 puntuó 0,0 en una ejecución y 1,0 en otra en faithfulness, y la sample 5, totalmente anclada, puntuó 0,667 en la ejecución mostrada arriba.
Las puntuaciones por sample de un juez barato son ruidosas. Las medias sobre 100 samples son mucho menos ruidosas, y la puerta de CI siempre debería comprobar la media.
Tres prácticas contienen el ruido:
judge.py y track_scores.py, para que un cambio de juez no se confunda con un cambio del pipeline.Para una panorámica más amplia de enfoques de evaluación más allá de RAG, incluidos los métodos de evaluación humana que el juez viene a sustituir, nuestra guía de evaluación de LLM cubre métricas y metodologías. Nuestro tutorial de LLM como juez profundiza en construir un juez para pipelines RAG.
La gracia de este pipeline es que nos permite decir cosas como “el recuperador está bien, el prompt ha empeorado” o “el reranker arregló la precision pero el recall sigue en 0,6”, con números que sostienen la afirmación.
Faithfulness y answer relevancy vigilan al generador: faithfulness detecta hechos inventados, y answer relevancy detecta respuestas que se desvían de la pregunta. Context precision y recall vigilan al recuperador y te dicen si trae la información correcta. Como 2 de las 4 no necesitan respuesta de referencia, puedes ejecutarlas sobre tráfico de producción donde no existe referencia.
Las métricas de texto estándar miden solapamiento de palabras, que no dice nada sobre una política de reembolsos inventada, y un único número de extremo a extremo oculta qué mitad del pipeline se rompió. Un framework que comprueba por separado los 2 puntos de fallo puede verlo, y convertirlo de una auditoría puntual en una puerta de CI con un histórico es lo que consigue que tu equipo actúe sobre los números.
Si aún no has construido el pipeline, empieza con nuestro curso Retrieval-Augmented Generation with LangChain y luego apunta el pipeline.py de este artículo a lo que construyas.
Para pipelines que van más allá de la recuperación de texto plano, nuestro curso End-to-End RAG with Weaviate, nuestra guía de RAG multimodal y nuestro tutorial de agentic RAG construyen sistemas que puedes puntuar igual, con una salvedad: las 4 métricas clave solo leen texto. Un pipeline que recupere imágenes necesita las métricas multimodales de Ragas, y uno agentic necesita puntuar cada paso de recuperación como su propia pregunta, fragmentos y respuesta.
Top DataCamp Courses
Curso
Curso
Curso
blog
Stanislav Karzhev
9 min
Tutorial
Ryan Ong
12 min
Tutorial
Ryan Ong
8 min
Tutorial
DataCamp Team
10 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min


