
Khóa học
Graph RAG với LangChain và Neo4j
3 giờ
2.3K
Một pipeline RAG (retrieval-augmented generation) cho chatbot vượt qua mọi bài kiểm tra smoke trong notebook. Rồi các phiếu hỗ trợ bắt đầu đổ về với những câu trả lời sai hoặc kỳ lạ, và không có gì trong log smoke test cho thấy dấu hiệu bất thường.
Dạng lỗi này khó bắt vì bạn sẽ không thấy nếu thiếu số liệu. Một pipeline RAG có 2 điểm có thể hỏng: bộ truy xuất có thể lấy sai đoạn văn bản, hoặc bộ sinh có thể phớt lờ những đoạn đúng và bịa ra thông tin. Một con số độ chính xác end-to-end duy nhất không thể cho bạn biết lỗi nằm ở đâu, nên cũng không thể cho bạn biết phải sửa gì.
Trong hướng dẫn này, tôi sẽ xây dựng một pipeline đánh giá RAG hoàn chỉnh bằng Python với Ragas 0.4.3: một tập dữ liệu đánh giá tự xây, 4 chỉ số cốt lõi (tính trung thực, mức liên quan của câu trả lời, độ chính xác ngữ cảnh và độ truy hồi ngữ cảnh), một cổng chất lượng CI (continuous integration) chặn build khi điểm giảm, một bộ tạo tập kiểm thử tổng hợp, và một bộ theo dõi điểm bằng JSON Lines.
Nếu bạn muốn tìm hiểu nền tảng trước, hãy xem hướng dẫn của chúng tôi về RAG là gì, bài hướng dẫn dùng mô hình ngôn ngữ lớn (LLM) làm giám khảo để đánh giá pipeline RAG, và tổng quan về các kỹ thuật RAG nâng cao.
Bạn cần Python 3.9 trở lên (tôi dùng 3.12), uv hoặc pip, một khóa API cho một mô hình giám khảo tương thích OpenAI, và hiểu sơ qua cách một pipeline RAG hoạt động. Nếu bạn muốn nắm vững trước, tôi khuyên bạn học khóa Retrieval-Augmented Generation with LangChain, khóa này xây dựng kiểu pipeline mà chúng ta sẽ chấm điểm.
Các chỉ số chồng lặp văn bản như BLEU (Bilingual Evaluation Understudy) và ROUGE (Recall-Oriented Understudy for Gisting Evaluation) không phù hợp cho RAG. Thay vào đó, Ragas dùng một LLM giám khảo để chấm mỗi câu trả lời theo 4 trục: tính trung thực và mức liên quan của câu trả lời để chẩn đoán bộ sinh, còn độ chính xác ngữ cảnh và độ truy hồi ngữ cảnh để chẩn đoán bộ truy xuất.
Đặt 4 con số đó sau một ngưỡng trong CI và ghi log theo mỗi commit, bạn sẽ có chuông báo hồi quy thay vì một lần kiểm toán đơn lẻ.
Một lưu ý trước khi bắt đầu. API của Ragas đã thay đổi 2 lần trong 2 năm: v0.2 thay bộ dữ liệu kiểu dictionary bằng SingleTurnSample và EvaluationDataset, và v0.4 đưa các chỉ số dạng collections (giới thiệu ở v0.3.9) thành mặc định và đánh dấu hàm evaluate() cũ là không khuyến nghị dùng nữa.
Phần lớn bài hướng dẫn trên mạng vẫn dùng code v0.1 hoặc v0.2. Mọi thứ dưới đây chạy trên 0.4.3, bản phát hành hiện tại vào tháng 10 năm 2026.
RAG cần các chỉ số riêng vì các chỉ số văn bản cổ điển chỉ đếm xem câu trả lời chia sẻ bao nhiêu từ với câu trả lời tham chiếu, trong khi điều khiến một hệ thống RAG hỏng lại không nằm ở chỗ trùng từ.
BLEU (Papineni và cộng sự, 2002) và ROUGE (Lin, 2004) được xây cho dịch máy và tóm tắt, nơi đầu ra tốt nên dùng gần như cùng từ với tham chiếu. Một câu trả lời RAG nói “bạn có 2 tuần” thay vì “14 ngày” sẽ bị chấm thấp ở cả hai, trong khi một câu trả lời lưu loát bịa ra chính sách hoàn tiền vẫn có thể được điểm cao nếu vô tình dùng lại từ của tham chiếu.
Vấn đề sâu hơn là pipeline RAG có thể hỏng ở 2 chỗ riêng biệt: bộ truy xuất có thể chọn sai thông tin, hoặc bộ sinh có thể phớt lờ thông tin đúng và bịa ra dữ kiện. Khi một câu trả lời sai, bạn cần biết điều nào trong số sau đã xảy ra:
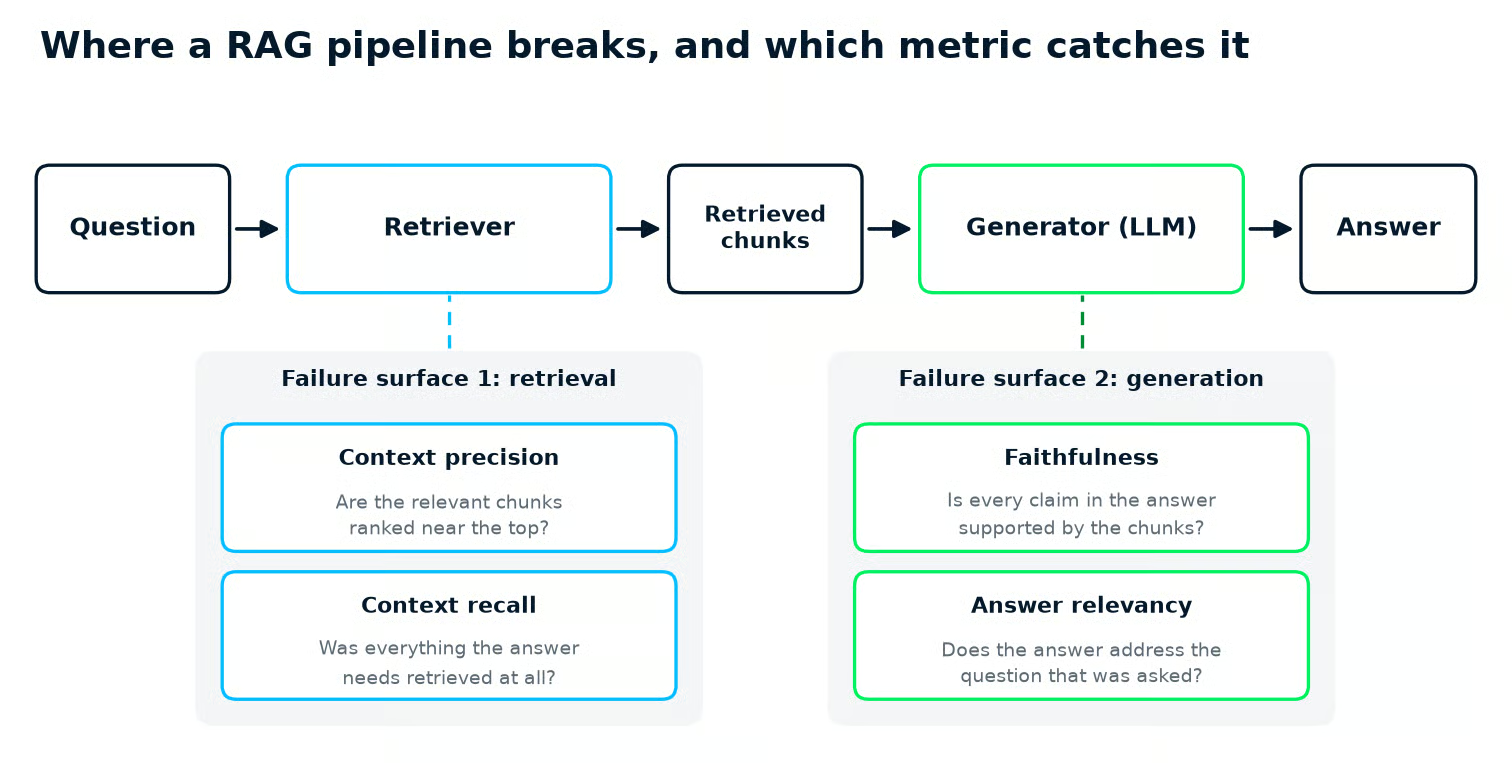
Hai chế độ lỗi của pipeline RAG: độ chính xác và độ truy hồi ngữ cảnh chẩn đoán bộ truy xuất, còn tính trung thực và mức liên quan của câu trả lời chẩn đoán bộ sinh. Ảnh: tác giả.
Bài What Is Retrieval Augmented Generation (RAG)? A Complete Guide của chúng tôi đi qua các giai đoạn pipeline nơi các lỗi này bắt nguồn.
Ragas là một framework Python mã nguồn mở cho bạn một con số cho mỗi phần của pipeline. Đây không phải lựa chọn duy nhất. Hai lựa chọn chính khác là DeepEval, gói đánh giá theo kiểu test case của pytest, và Evidently, thêm các kiểm tra LLM như các cột phụ trên tập dữ liệu và đưa vào báo cáo giám sát.
| Nền tảng | Phù hợp nhất cho | Chỉ số chuyên RAG tích hợp | Dữ liệu kiểm thử từ tài liệu của bạn | Phong cách cấu hình |
|---|---|---|---|---|
| Ragas | Chẩn đoán pipeline RAG | Tính trung thực, mức liên quan của câu trả lời, độ chính xác ngữ cảnh, độ truy hồi ngữ cảnh, độ truy hồi thực thể trong ngữ cảnh, độ nhạy với nhiễu | TestsetGenerator (mã nguồn mở) |
Đối tượng chỉ số cộng với một giám khảo từ llm_factory() |
| DeepEval | Kiểm thử LLM kiểu unit test trong CI | Mức liên quan của câu trả lời, tính trung thực, mức liên quan theo ngữ cảnh, độ truy hồi theo ngữ cảnh, độ chính xác theo ngữ cảnh | Synthesizer (mã nguồn mở) |
Đối tượng LLMTestCase, assert_test() chạy qua deepeval test run |
| Evidently | Bảng điều khiển giám sát và drift theo thời gian | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Tạo tập dữ liệu RAG trong Evidently Cloud | Mô tả trên một Dataset, tổng hợp bởi một Report |
Tôi chọn Ragas cho bài này vì 4 chỉ số cốt lõi tách bạch sạch sẽ giữa điểm của bộ truy xuất và điểm của bộ sinh, và vì bộ tạo tập kiểm thử của nó đi kèm trong cùng gói mã nguồn mở.
Nếu nhóm bạn đã quen với pytest, assert_test() của DeepEval sẽ tự nhiên hơn. Nếu bạn muốn một dashboard chất lượng lưu lượng trực tiếp, các báo cáo của Evidently sẽ đưa bạn tới đó nhanh hơn.
Thiết lập Ragas nghĩa là cài gói, ghim một phụ thuộc, và chọn một LLM giám khảo mà mọi chỉ số sẽ dùng chung. Tôi sẽ dùng uv vì nó khóa chính xác phiên bản gói cho bạn, nhưng pip install với cùng phiên bản cũng được.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Tôi dùng Python 3.12 ở đây. Ragas 0.4.3 tuyên bố hỗ trợ Python 3.9 trở lên.
Gói rapidfuzz cần cho bộ tạo tập kiểm thử tổng hợp ở phần sau. Ragas không khai báo nó là phụ thuộc, nên tôi cài sẵn.
Pin langchain-community<0.4 hiện chưa thể bỏ. Ragas 0.4.3 import ChatVertexAI từ đường dẫn module mà langchain-community 0.4 đã xóa, nên cài mới không pin sẽ lỗi khi bạn import ragas.
Tiếp đến là giám khảo. Mỗi chỉ số dựa trên LLM trong Ragas sẽ gọi 1 hoặc nhiều lần tới mô hình giám khảo, nên bạn xây nó một lần và truyền đi mọi nơi. Tôi để nó trong module riêng, judge.py, và đọc key từ biến môi trường để không đẩy thông tin xác thực vào git.
Tệp này cho thấy cách gọi trực tiếp OpenAI, hoặc Gemini qua điểm cuối tương thích OpenAI của Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Hai chi tiết trong tệp đó có thể khiến lần chạy đầu trục trặc:
llm_factory() ở 0.4 cần truyền một đối tượng client, và chỉ truyền tên model sẽ gây lỗi.llm_factory() sẽ đi thẳng vào lệnh gọi model, đó là cách tôi nâng max_tokens lên trên mức mặc định 1.024.Dùng mô hình rẻ nhất cho điểm số ổn định trên một mẫu bạn đã tự kiểm tra, rồi ghim nó lại. Với một bộ đánh giá lớn, số lượng cuộc gọi tăng rất nhanh: tính trung thực gọi giám khảo 2 lần mỗi mẫu, mức liên quan của câu trả lời gọi 3 lần cộng 2 lần embedding, độ chính xác ngữ cảnh gọi 1 lần cho mỗi đoạn truy xuất, và độ truy hồi ngữ cảnh gọi 1 lần.
Sáu mẫu qua 4 chỉ số thành 62 yêu cầu trong một lượt: 50 cuộc gọi giám khảo cộng 12 cuộc gọi embedding. Dưới đây là chi phí của 3 mô hình giám khảo nhỏ hiện nay theo bảng giá niêm yết của mỗi nhà cung cấp vào ngày 19/10/2026:
| Mô hình giám khảo | Đầu vào mỗi 1M token | Đầu ra mỗi 1M token | Nguồn |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API pricing |
| claude-haiku-5-5 | $0.10 (prompt đến 100K token) | $0.50 (prompt đến 100K token) | Claude API pricing |
Mặc định trong judge.py vẫn là gpt-4o-mini, một mô hình OpenAI cũ không được liệt kê trong bảng giá chính trên trang giá của OpenAI. Đặt biến JUDGE_MODEL để chuyển đổi.
Một điểm cần lưu ý nếu bạn muốn dùng Claude làm giám khảo: chỉ số mức liên quan của câu trả lời cũng cần mô hình embedding, và Anthropic không cung cấp. Tài liệu của họ trỏ sang Voyage AI, vì vậy bạn sẽ ghép Claude với embedding từ nhà cung cấp khác.
Việc ghim quan trọng hơn lựa chọn cụ thể. Đổi mô hình giám khảo sẽ làm dịch chuyển điểm số ngay cả khi pipeline của bạn không đổi, phá hủy đường xu hướng mà bạn sắp xây trong phần theo dõi.
Đưa tên mô hình vào judge.py dưới kiểm soát phiên bản và coi việc nâng cấp giám khảo như mọi thay đổi gây vỡ khác: đặt lại mọi ngưỡng theo điểm của giám khảo mới.
Mỗi test case trong tập dữ liệu được gọi là một sample. Một sample không chỉ là một câu trả lời: nó ghi lại cả một lượt đi qua pipeline, trong 4 trường:
| Trường | Nội dung |
|---|---|
user_input |
Câu hỏi khách hàng hỏi |
retrieved_contexts |
Các đoạn văn bản bộ truy xuất trả về cho câu hỏi đó |
response |
Câu trả lời mà pipeline RAG đưa ra |
reference |
Câu trả lời đúng, do con người viết |
Ragas lưu mỗi sample là một SingleTurnSample và cả tập là một EvaluationDataset. Trường reference là tùy chọn, nhưng các chỉ số truy xuất so sánh với nó, nên tôi luôn đưa vào trong tập đã tuyển chọn mặc dù các chỉ số không cần tham chiếu sẽ bỏ qua.
Tôi xây 6 sample cho một hãng rang cà phê hư cấu, Northwind Coffee. Mỗi phần chỉ số bên dưới sẽ thêm sample mà chỉ số đó nên bắt được.
Bắt đầu build_dataset.py với 3 sample đầu: một câu trả lời sạch, một lỗi bịa đặt có chủ ý, và một câu trả lời sạch thứ hai đưa ra nhiều khẳng định cùng lúc.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Mỗi ngữ cảnh truy xuất là một đoạn từ trang trung tâm trợ giúp của Northwind, được viết đúng như cách một bộ truy xuất sẽ đưa cho bộ sinh. Chạy uv run python build_dataset.py để ghi eval_dataset.jsonl và eval_questions.jsonl, và chạy lại mỗi khi phần sau thêm sample.
Lưu ở định dạng JSON Lines quan trọng vì mọi script sau (chạy chỉ số, cổng CI) đều tải cùng eval_dataset.jsonl bằng EvaluationDataset.from_jsonl().
Trong dự án thực tế, các trường retrieved_contexts và response đến từ việc chạy pipeline thật của bạn trên các câu hỏi, và chỉ user_input và reference là viết tay. Phần CI sẽ chỉ cách tự động hóa bước này.
6 sample trong bài này đủ để học các chỉ số, nhưng chưa đủ để tin vào ngưỡng. Hãy nhắm khoảng 100 sample trước khi dựa vào ngưỡng; phần theo dõi sẽ cho thấy vì sao. Bạn cần bao nhiêu phụ thuộc vào mức nghiêm ngặt của bài toán, nên tôi tập trung vào cơ cấu mẫu tốt hơn là con số cụ thể:
4 chỉ số cốt lõi của Ragas là tính trung thực và mức liên quan của câu trả lời cho bộ sinh, và độ chính xác ngữ cảnh và độ truy hồi ngữ cảnh cho bộ truy xuất. Cả 4 trả về điểm từ 0 đến 1. Phần hữu ích là mỗi con số chỉ cho bạn biết cần sửa gì.
Faithfulness đo xem câu trả lời được hậu thuẫn bao nhiêu bởi các đoạn truy xuất. Giám khảo tách câu trả lời thành từng mệnh đề, rồi kiểm tra từng mệnh đề với các đoạn: điểm 1.0 nghĩa là mọi mệnh đề đều được hỗ trợ, và 0.0 nghĩa là không mệnh đề nào được hỗ trợ.
Tính trung thực không cần câu trả lời tham chiếu, nên bạn có thể chạy trên lưu lượng sản xuất trực tiếp, không chỉ tập kiểm thử. Chạy lại khi bạn thay prompt, mô hình, hoặc lượng ngữ cảnh mô hình nhìn thấy, vì đó là những thay đổi thường dễ đưa vào bịa đặt nhất.
Cách nhanh nhất để thấy nó hoạt động là trên một câu trả lời đơn, không cần tập dữ liệu:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Chạy bằng uv run python quick_check.py sẽ in faithfulness = 0.00, vì cả hai khẳng định trong phản hồi (6 tháng, một túi miễn phí) đều không được ngữ cảnh hỗ trợ. Ở 0.4 bạn chấm điểm bằng phương thức ascore() của mỗi chỉ số, trả về một kết quả có .value là điểm.
Chấm trên tập dữ liệu hiện tại, lỗi bịa đặt cài cắm ở sample 2 được 0.0, như mong đợi, và cả hai sample sạch được 1.0. Kết quả đầy đủ cho mọi chỉ số có ở phần chạy đa chỉ số bên dưới.
Answer relevancy đo xem câu trả lời có thực sự nhắm vào câu hỏi hay không. Giám khảo đọc câu trả lời và viết 3 câu hỏi mà câu trả lời đó sẽ phù hợp, rồi Ragas kiểm tra độ gần nghĩa giữa những câu hỏi đó với câu hỏi gốc bằng mô hình embedding. Nếu câu trả lời né tránh câu hỏi, giám khảo đánh dấu là không cam kết và điểm sẽ là 0.
Ragas đặt tên lớp là AnswerRelevancy (ví dụ cũ gọi là ResponseRelevancy, và trang tài liệu cũng có tiêu đề Response Relevancy), và nó cần cả LLM giám khảo và mô hình embedding.
Điểm mức liên quan thấp cùng điểm tính trung thực cao thường chỉ về bộ sinh hoặc prompt: mô hình đã có đúng ngữ cảnh và giữ vững theo đó, nhưng lại trả lời một câu hỏi khác với câu được hỏi. Hãy kiểm tra độ chính xác và độ truy hồi ngữ cảnh trước, vì một bộ truy xuất trả về các đoạn lạc đề cũng có thể tạo ra cùng mẫu hình.
Sample này cho thấy trường hợp thuộc về bộ sinh. Bộ truy xuất trả về đúng đoạn về vận chuyển, câu trả lời vẫn bám ngữ cảnh, và nó nói về ngày rang thay vì chi phí vận chuyển. Thêm đoạn mới vào phần đoạn ở đầu build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Rồi thêm sample mới vào cuối danh sách samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Mỗi sample nhận một điểm mức liên quan: mức độ phù hợp giữa các câu hỏi mà giám khảo viết từ câu trả lời với câu hỏi mà sample thực sự hỏi, trong đó 1.0 là khớp hoàn hảo.
Context precision kiểm tra xem các đoạn hữu ích có được xếp hạng gần đầu trong số các đoạn mà bộ truy xuất trả về hay không, và context recall kiểm tra xem bộ truy xuất có tìm thấy mọi thứ cần để viết câu trả lời đúng không.
Precision cho đoạn hữu ích nhiều điểm hơn khi xếp hạng cao hơn, nên một đoạn hữu ích ở vị trí đầu tiên được tính nhiều hơn cùng đoạn ở vị trí thứ ba. Recall là tỷ lệ các dữ kiện trong câu trả lời tham chiếu được ít nhất một đoạn truy xuất hỗ trợ.
Cả hai cần trường reference. Trong API collections, các lớp là ContextPrecisionWithReference và ContextRecall, và cả hai chỉ nhận LLM giám khảo. Tài liệu Ragas cũng dùng tên ngắn hơn ContextPrecision cho phiên bản có tham chiếu, nên bạn có thể thấy cả hai cách gọi.
Cho đến giờ mọi sample đều truy xuất đúng đoạn đầu tiên, nên chưa có chỉ số nào bắt được lỗi. Hãy thêm 2 sample phá truy xuất theo 2 cách khác nhau: một mẫu mà đoạn đúng được truy xuất nhưng xếp hạng cuối, và một mẫu không truy xuất được gì liên quan, nên mô hình từ chối đúng cách. Như trước, thêm các đoạn vào đầu tệp:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Rồi thêm các sample vào cuối danh sách:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Xếp hạng quan trọng vì hầu hết pipeline chỉ chuyển vài đoạn đầu cho mô hình, nên một đoạn hữu ích ở vị trí thứ 6 của một bộ truy xuất top-5 coi như không tồn tại.
Sample 5 đặt đoạn hữu ích duy nhất ở vị trí cuối trong 3 đoạn, và precision về 0.333 vì thông tin hữu ích duy nhất xếp hạng cuối. Sample 6, lỗi truy xuất, được 0.0 cả precision lẫn recall.
Sample 6 cũng dạy bạn điều gì đó về tính trung thực. Mô hình từ chối đúng cách, nhưng câu từ chối đó có lần được 1.0 lần khác 0.0, dù không có gì thay đổi. Một phát biểu như “Tôi không có thông tin về bảo hành” không được ngữ cảnh hỗ trợ cũng không bị ngữ cảnh bác bỏ, và giám khảo đôi khi “tung đồng xu”.
Nếu pipeline của bạn được kỳ vọng từ chối, hãy chấm điểm các câu từ chối riêng thay vì để chúng kéo tụt điểm tính trung thực. Ragas 0.4 đã bỏ AspectCritic khỏi API collections, nên thay thế là một kiểm tra tùy biến với decorator @discrete_metric (xem hướng dẫn di trú v0.3 lên v0.4).
Đọc hai con số truy xuất cùng nhau và chúng cho bạn biết tuần tới nên làm gì:
| Độ chính xác ngữ cảnh | Độ truy hồi ngữ cảnh | Chẩn đoán | Cần thay đổi gì |
|---|---|---|---|
| Cao | Cao | Truy xuất khỏe mạnh | Tập trung vào bộ sinh: prompt, mô hình, tính trung thực |
| Thấp | Cao | Đoạn đúng được truy xuất nhưng xếp hạng kém | Thêm hoặc tinh chỉnh bộ reranker |
| Cao | Thấp | Các đoạn top liên quan nhưng thiếu thông tin | Chuyển nhiều đoạn hơn cho mô hình, dùng đoạn dài hơn, hoặc kiểm tra cách chia đoạn |
| Thấp | Thấp | Bộ truy xuất đang hỏng diện rộng | Xem lại embedding, lập chỉ mục, và viết lại truy vấn |
Dòng “precision thấp, recall cao” là thường gặp nhất tôi thấy trên thực tế, và là dòng rẻ nhất để sửa.
Bài hướng dẫn RankGPT làm tác tử reranking cho RAG của chúng tôi thêm một LLM reranker lên trên một bộ truy xuất có sẵn, và bài Tăng độ chính xác của LLM với RAG và Reranking cho bạn một cấu hình reranking khác. Bài 5 kỹ thuật chính để cải thiện hiệu năng RAG đề cập chunking và viết lại truy vấn cho các dòng còn lại.
Chạy lại 2 chỉ số truy xuất sau mỗi thay đổi và dùng bảng để xem liệu thay đổi có hiệu quả không.
Một lượt đánh giá đa chỉ số đầy đủ chạy cả 4 chỉ số trên mọi sample song song và thu thập điểm, với giá trị theo từng dòng để đi sâu vào lỗi và giá trị trung bình theo cột cho dashboard của bạn.
Trong Ragas 0.2 và 0.3 bạn làm việc này bằng evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). Ở 0.4.3 hàm đó vẫn tồn tại, nhưng cảnh báo đã lỗi thời và từ chối các chỉ số mới, vì chúng không còn kế thừa từ lớp Metric cũ mà hàm mong đợi.
Thay thế là @experiment decorator, chạy pipeline của bạn và các chỉ số cùng nhau trên một Dataset và ghi kết quả ra CSV. Đó là công cụ phù hợp khi bạn đã có pipeline để gọi.
Để chấm một tập dữ liệu tĩnh, tôi thấy một helper nhỏ dễ hiểu hơn: nó xây 4 chỉ số một lần cho mọi script cần dùng, và giữ các lệnh gọi song song cùng xử lý lỗi trong code dễ đọc:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Dòng không hiển nhiên là lời gọi inspect.signature(). 4 chỉ số cần các đầu vào khác nhau (tính trung thực cần phản hồi, recall cần tham chiếu), nên helper đọc đối số mà ascore() của mỗi chỉ số chấp nhận và truyền đúng những trường đó từ sample, cho phép một vòng lặp phục vụ mọi chỉ số.
Semaphore giới hạn số cuộc gọi giám khảo chạy cùng lúc, và một chỉ số vẫn lỗi sẽ trở thành ô trống (NaN) thay vì hủy cả lượt chạy. Nếu chạy trong Jupyter, asyncio.run lỗi vì đã có vòng lặp chạy. Gọi nest_asyncio.apply() trước (Ragas đã phụ thuộc nó) hoặc await coroutine trực tiếp.
Có helper rồi, lượt chạy đầy đủ khá ngắn:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Đây là điểm từ lượt chạy đầu của tôi, sắp xếp theo tính trung thực và làm tròn 3 chữ số thập phân, với giá trị trung bình ở hàng cuối:
| Câu hỏi | Tính trung thực | Mức liên quan của câu trả lời | Độ chính xác ngữ cảnh | Độ truy hồi ngữ cảnh |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Các lượt sau trên cùng tập dữ liệu chấm tính trung thực thấp hơn vì sự lật điểm của sample từ chối mà tôi đề cập ở phần theo dõi.
Sắp xếp theo tính trung thực giúp bạn chọn ra các khả năng bịa đặt lớn nhất, và mẫu cài cắm nằm ở đầu. Các giá trị trung bình ở hàng cuối là số liệu dashboard của bạn.
Đọc theo hàng và mỗi lỗi cài cắm hiện ra ở chỗ khác nhau. Lỗi bịa đặt làm rơi chỉ tính trung thực. Lỗi truy xuất làm 0 cả mức liên quan, precision và recall. Vấn đề xếp hạng cắt precision xuống 0.333, và trôi đề hiện thành điểm mức liên quan thấp nhất trong số các câu có trả lời.
Một điểm lạ: câu trả lời Canada được hỗ trợ hoàn toàn bởi đoạn của nó, vậy mà điểm tính trung thực là 0.667. Đó là nhiễu của giám khảo, tôi sẽ quay lại ở phần theo dõi.
Mức liên quan của câu trả lời so sánh nghĩa bằng embedding, nên ngay cả câu trả lời tốt hiếm khi gần 1.0: câu trả lời hoàn tiền được 0.746, còn câu trả lời lạc đề vận chuyển được 0.572. Hãy đánh giá mức liên quan dựa trên khoảng cách giữa các sample và xu hướng theo thời gian, không dựa trên con số tuyệt đối.
Một cổng chất lượng RAG là script test chạy đánh giá, so sánh mỗi điểm trung bình với một ngưỡng, và thoát với mã lỗi khi bất kỳ chỉ số nào rơi xuống dưới, báo cho hệ thống CI chặn việc merge.
Một lưu ý trước. Tập dữ liệu viết tay trước đó có phản hồi và các đoạn truy xuất cũng được viết tay, nên chấm nó sẽ không phản ánh thay đổi ở prompt hoặc bộ truy xuất. Trong CI bạn cần chạy lại pipeline thật trên các câu hỏi đã lưu rồi mới chấm những gì nó tạo ra. Hai script nhỏ làm điều đó.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py là tệp duy nhất bạn tự viết: thay thân hàm answer() bằng lời gọi tới bộ truy xuất và bộ sinh của bạn. refresh_dataset.py đọc các câu hỏi và câu trả lời tham chiếu mà build_dataset.py đã lưu, chạy pipeline trên mỗi câu hỏi, và viết lại eval_dataset.jsonl.
Chính cổng là một dictionary ngưỡng và một vòng lặp. Các ngưỡng bên dưới được hiệu chỉnh trên tập dữ liệu ví dụ viết tay, nên hãy hiệu chỉnh lại trên đầu ra pipeline của bạn trước khi tin dùng.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
So với đường cơ sở của tôi, cả 4 giá trị trung bình vượt ngưỡng, và script thoát với mã 0, cho phép merge:
| Chỉ số | Giá trị trung bình | Ngưỡng | Kết quả |
|---|---|---|---|
| Tính trung thực | 0.778 | 0.60 | Pass |
| Mức liên quan của câu trả lời | 0.668 | 0.60 | Pass |
| Độ chính xác ngữ cảnh | 0.722 | 0.65 | Pass |
| Độ truy hồi ngữ cảnh | 0.833 | 0.75 | Pass |
Tôi đặt ngưỡng tính trung thực ở 0.60 thay vì 0.70 vì nhiễu của giám khảo mà tôi đề cập ở phần theo dõi. Với 6 sample, một phán quyết “phập phù” sẽ đẩy trung bình lên xuống 0.17, và một lượt chạy sau của pipeline không đổi ghi 0.61. Cổng cũng chạy giám khảo 3 lần và lấy trung bình điểm (GATE_RUNS), làm mượt sự lật điểm đơn lẻ với chi phí giám khảo gấp 3.
Một lựa chọn thiết kế là fail trên điều kiện not (actual >= threshold) thay vì actual < threshold. So sánh với NaN (“không phải số”) luôn là False, nên viết actual < threshold sẽ khiến build pass bất cứ khi nào giám khảo lỗi.
skipna=False khi lấy trung bình xử lý trường hợp một phần. pandas mặc định bỏ qua NaN, nên vài lần gọi giám khảo thất bại sẽ âm thầm làm nhỏ mẫu thay vì làm cổng fail. Lỗi giám khảo tạm thời giờ sẽ làm build fail, nên hãy chạy lại job trước khi debug.
Ngưỡng khó tinh chỉnh. Đặt chúng hơi thấp hơn giá trị trung bình thấp nhất bạn thấy qua nhiều lượt chạy, không phải ở mức kỳ vọng 0.9, nếu không cổng sẽ chặn mọi pull request và nhóm sẽ không còn tin CI. Đặt lại mỗi khi bạn thay mô hình giám khảo hoặc thêm hơn một vài sample.
Đấu nối vào GitHub Actions là một workflow ngắn. Tài liệu cú pháp workflow bao quát bộ lọc đường dẫn on.pull_request và cron schedule dùng ở đây:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Một vài chi tiết trong workflow quan trọng:
JUDGE_MODEL và khóa API khớp. Dùng cùng giám khảo mà bạn đã hiệu chỉnh ngưỡng, nếu không điểm CI sẽ không so sánh được với lịch sử theo dõi của bạn.GATE_SAMPLE chấm một tập con ngẫu nhiên cố định 30 dòng, để review không phải chờ 10 phút các cuộc gọi giám khảo. Cron ban đêm sẽ chấm tất cả.scores.csv và ragas_history.jsonl như artifact, vì ổ đĩa runner biến mất khi job kết thúc.Chạy toàn bộ suite vào cron ban đêm, khi không ai phải chờ. Một lượt chạy ban đêm fail sẽ hiện thành workflow fail, và thiết lập thông báo của GitHub hoặc một bước Slack có thể báo cho người phụ trách vào buổi sáng. GitLab CI có hình dạng tương tự với rules: changes: và lịch pipeline.
Ragas tạo câu hỏi kiểm thử tổng hợp bằng cách đọc tài liệu của bạn, rút ra các chủ đề và dữ kiện chính, liên kết các đoạn có liên quan, rồi viết các loại câu hỏi khác nhau từ những liên kết đó.
Tài liệu tạo dữ liệu kiểm thử chia truy vấn thành single-hop (một đoạn có thể trả lời) và multi-hop (cần nhiều đoạn), và mỗi loại có thể cụ thể hoặc trừu tượng. Tổ hợp mặc định dùng 3 trong 4 kết hợp theo tỷ lệ ngang nhau:
Ragas chỉ dùng các bộ sinh (synthesizer) mà tài liệu của bạn hỗ trợ, nên một tập tài liệu nhỏ có thể tạo ra tổ hợp khác.
Bộ tạo cần tài liệu thật để đọc. Trỏ nó đến tài liệu của bạn dạng markdown. Cho bài này, tôi viết 5 trang trung tâm trợ giúp ngắn cho Northwind (khoảng 600 từ tổng), và mỗi trang trông như sau:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Tài liệu của bạn sẽ tạo ra các câu hỏi khác với bên dưới, đó là chủ ý: bộ tạo viết câu hỏi xoay quanh những gì kho tri thức của bạn thực sự nói.
TestsetGenerator dùng cùng LLM giám khảo và mô hình embedding chúng ta đã xây. Tôi tải tài liệu bằng DirectoryLoader của LangChain, dùng rõ TextLoader để tệp markdown không kéo phụ thuộc nặng unstructured.
Việc lập bản đồ tài liệu sẽ bắn rất nhiều cuộc gọi giám khảo cùng lúc, nên tôi cũng giới hạn số lượng chạy song song bằng RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Script tải cả 5 tài liệu và ghi ra 8 câu hỏi sau. Các câu hỏi bám sát tài liệu, và một số có lỗi chính tả cố ý:
| # | Câu hỏi được tạo | Loại câu hỏi |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Bảng hiển thị nhãn đơn giản; cột synthesizer_name trong đầu ra chứa tên đầy đủ của bộ sinh. Tám câu hỏi từ 5 tài liệu mất khoảng 4,5 phút.
Các lỗi chính tả và truy vấn kiểu từ khóa ở câu hỏi 2 là cố ý: bộ tạo thay đổi phong cách và độ dài của từng truy vấn để bộ câu trông giống lưu lượng hộp tìm kiếm hơn là câu hỏi thi.
Bạn có thể sẽ muốn xem qua các câu hỏi để đảm bảo chúng dùng được và phù hợp. Tôi sẽ dùng đầu ra như bản nháp đầu tiên. Trong mọi tập tổng hợp tôi đã duyệt, có câu hỏi bị lỗi (tham chiếu “tài liệu” hoặc hỏi về một tiêu đề), có câu trả lời tham chiếu lệch khỏi điều nguồn nói thực sự, và cách hành văn trang trọng hơn bất kỳ người dùng thực nào.
Chạy lại bộ tạo khi bạn thêm một mục vào tài liệu và bạn sẽ có các câu hỏi gợi ý cho phần mới, với chi phí một vòng cuộc gọi giám khảo nữa.
Mỗi dòng có user_input, một câu trả lời reference được tạo, và reference_contexts, các đoạn mà câu hỏi được xây từ đó. Hãy kiểm tra reference so với các đoạn đó, vì đó là nơi lệch trôi xuất hiện.
Để biến một dòng đã duyệt thành SingleTurnSample, chạy pipeline của bạn trên user_input để lấy retrieved_contexts và response. Nối các cặp user_input và reference đã duyệt vào eval_questions.jsonl và refresh_dataset.py sẽ lo cho bạn.
Nếu kho tri thức của bạn là một đồ thị hơn là một đống tài liệu, nguyên tắc tương tự áp dụng với bộ truy xuất khác. Bài Dùng Knowledge Graph để triển khai ứng dụng RAG và khóa Graph RAG with LangChain and Neo4j của chúng tôi đều tạo ra các pipeline bạn có thể đánh giá bằng đúng 4 chỉ số ở trên, vì các chỉ số chỉ nhìn văn bản đã truy xuất, không quan tâm nó được truy xuất thế nào.
Theo dõi điểm Ragas theo thời gian nghĩa là thêm điểm trung bình, hash commit git, mô hình giám khảo, và timestamp vào một tệp log sau mỗi lượt đánh giá, để hồi quy hiện lên thành một chỗ trũng trên biểu đồ đường thay vì một cú sốc trong sản xuất.
Một tệp JSON Lines có lẽ là lựa chọn tốt nhất cho đến khi bạn cần một bộ theo dõi thí nghiệm dùng chung cho nhiều người. track_scores.py đọc scores.csv, vốn được cả quality_gate.py và run_all.py ghi, nên nó không bao giờ kích hoạt một đợt gọi giám khảo thứ hai.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Chạy uv run python track_scores.py sẽ thêm một dòng vào log và in ra:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
Trong CI mỗi job bắt đầu với ổ đĩa trống, nên ragas_history.jsonl chỉ chứa bản ghi của lượt chạy đó. Để giữ xu hướng, tải artifact đã upload xuống và nối chúng vào một tệp, hoặc commit tệp vào một nhánh metrics hoặc lưu trữ đối tượng.
Vẽ biểu đồ lịch sử khá đơn giản. Thử script sau:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Bạn sẽ được một biểu đồ tương tự như sau:
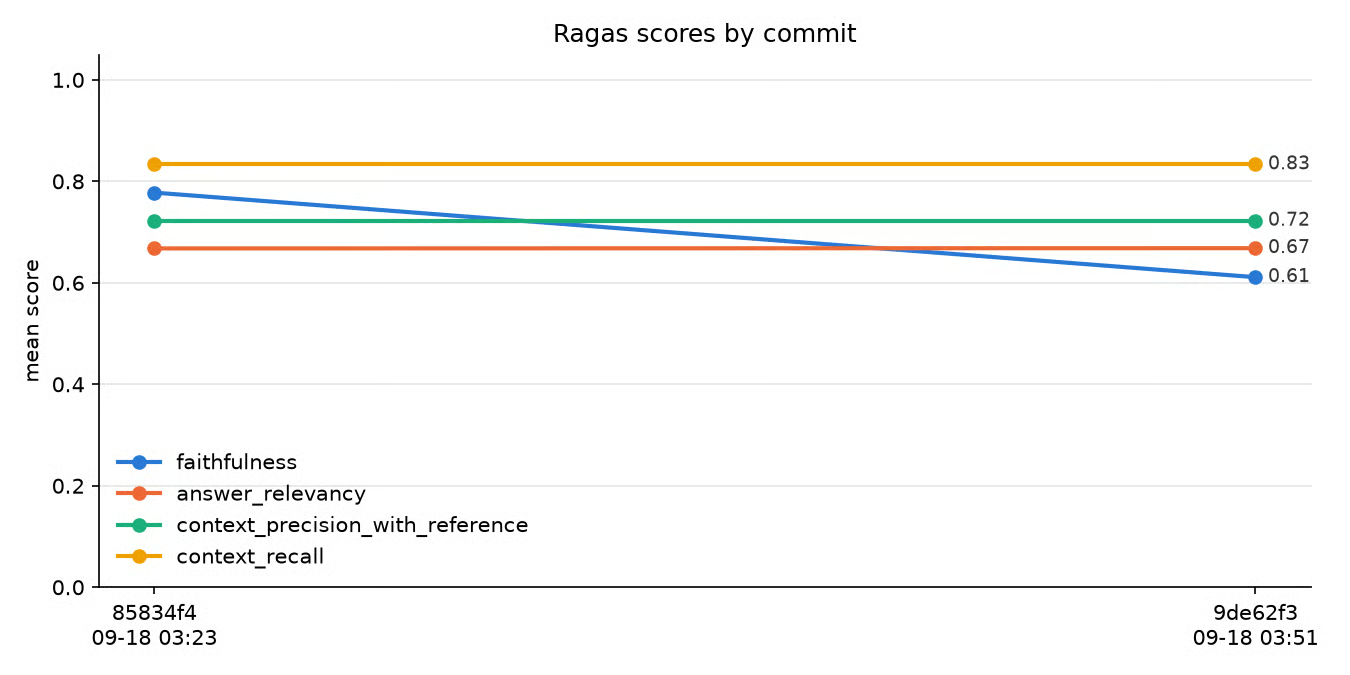
Điểm Ragas trung bình ghi theo commit bởi track_scores.py. Ảnh: tác giả.
Không có gì trong pipeline thay đổi giữa các commit đó (commit thứ hai chỉ đổi thiết lập kết nối client của giám khảo), vậy mà tính trung thực giảm từ 0.78 xuống 0.61 vì câu từ chối ở sample 6 lật từ 1.0 xuống 0.0.
Vậy là có nhiễu giám khảo thực tế cần theo dõi cho đến khi bạn có số lượng sample lớn. Với 6 sample, một phán quyết “phập phù” sẽ đẩy trung bình 0.17. Với 100 sample, cùng một cú lật chỉ đẩy 0.01, nên thay đổi lớn nhiều khả năng là hồi quy thực sự.
Giờ thì với mỗi pull request hoặc commit, bạn có thể chạy cổng, ghi log điểm, và xem biểu đồ.
Nếu bạn đang cân nhắc thay đổi kiến trúc lớn hơn, bài hướng dẫn RAG vs. fine-tuning khung hóa đánh đổi, và cùng 4 chỉ số có thể dùng làm phép đo trước-sau cho cả hai hướng.
Điểm LLM làm giám khảo là ước lượng: có thiên lệch đã biết và có thể thay đổi giữa các lượt chạy, nhưng chúng mở rộng đến khối lượng đánh giá mà con người không kham nổi.
Ragas không bao giờ yêu cầu giám khảo so sánh 2 câu trả lời, nên thiên lệch vị trí (ưu ái câu trả lời đứng trước) phần lớn không áp dụng. Thiên lệch dài dòng (ưu tiên câu trả lời dài) và thiên lệch tự thiên vị (giám khảo ưu ái câu trả lời từ chính mô hình của mình) vẫn có thể ảnh hưởng. Zheng và cộng sự (2023) mô tả cả 3 thiên lệch, và tự thiên vị là lý do tôi sẽ không dùng cùng một mô hình cho cả bộ sinh và giám khảo.
Sự thay đổi giữa các lượt chạy là phần tôi muốn bạn tự thấy, vì nó ảnh hưởng cách bạn đặt ngưỡng. Qua các lượt chạy cùng 6 sample với cùng giám khảo được ghim, câu trả lời từ chối ở sample 6 được 0.0 trong một lượt và 1.0 trong lượt khác về tính trung thực, và sample 5 hoàn toàn bám ngữ cảnh lại có lần được 0.667 như ở trên.
Điểm theo sample từ một giám khảo rẻ là nhiễu. Trung bình trên 100 sample ít nhiễu hơn rất nhiều, và cổng CI luôn nên kiểm tra giá trị trung bình.
Ba thực hành để kiềm chế nhiễu:
judge.py và track_scores.py ở trên, để một thay đổi giám khảo không bị nhầm là thay đổi ở pipeline.Để có cái nhìn rộng hơn về các cách đánh giá vượt ra ngoài RAG, gồm cả phương pháp đánh giá thủ công mà giám khảo đang thay thế, hướng dẫn đánh giá LLM của chúng tôi bao quát chỉ số và phương pháp luận. Bài LLM làm giám khảo đi sâu hơn vào cách xây một giám khảo cho pipeline RAG.
Mục tiêu của pipeline này là cho phép chúng ta nói những câu như “bộ truy xuất ổn, prompt bị hồi quy” hoặc “reranker đã sửa được precision nhưng recall vẫn 0.6”, với số liệu hậu thuẫn.
Tính trung thực và mức liên quan của câu trả lời theo dõi bộ sinh: tính trung thực bắt lỗi bịa đặt, và mức liên quan bắt các câu trả lời trôi khỏi câu hỏi. Độ chính xác và độ truy hồi ngữ cảnh theo dõi bộ truy xuất và cho bạn biết nó có lấy đúng thông tin không. Vì 2 trong 4 không cần câu trả lời tham chiếu, bạn có thể chạy chúng trên lưu lượng sản xuất nơi không có tham chiếu.
Các chỉ số văn bản chuẩn đo lường chồng lặp từ, điều này chẳng nói gì về một chính sách hoàn tiền bịa đặt, và một con số end-to-end duy nhất che giấu nửa nào của pipeline bị hỏng. Một framework kiểm tra riêng 2 điểm lỗi có thể nhìn thấy điều đó, và biến nó từ một lần kiểm toán thành cổng CI với tệp lịch sử mới là thứ khiến nhóm của bạn hành động dựa trên số liệu.
Nếu bạn chưa xây pipeline, hãy bắt đầu với khóa Retrieval-Augmented Generation with LangChain rồi trỏ pipeline.py trong bài này vào thứ bạn xây.
Với các pipeline vượt ra ngoài truy xuất văn bản thuần, khóa End-to-End RAG with Weaviate, hướng dẫn RAG đa phương thức, và bài hướng dẫn agentic RAG của chúng tôi xây các hệ thống bạn có thể chấm tương tự, với một lưu ý: 4 chỉ số cốt lõi chỉ đọc văn bản. Một pipeline truy xuất hình ảnh cần các chỉ số đa phương thức riêng của Ragas, và một pipeline agentic cần mỗi bước truy xuất được chấm như một câu hỏi, các đoạn, và một câu trả lời riêng.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
