Kurs
Graph RAG mit LangChain und Neo4j
3 Std.
2.3K
Eine Retrieval-Augmented-Generation-(RAG)-Pipeline für einen Chatbot besteht im Notebook jeden Smoke-Test. Dann trudeln Support-Tickets zu falschen oder merkwürdigen Antworten ein – und in den Smoke-Test-Logs ist kein Warnsignal zu sehen.
Dieser Fehler ist schwer zu greifen, weil er ohne Metriken unsichtbar bleibt. Eine RAG-Pipeline kann an zwei Stellen scheitern: Der Retriever zieht die falschen Chunks, oder der Generator ignoriert gute Chunks und erfindet Fakten. Eine einzige End-to-End-Genauigkeitszahl verrät dir nicht, welche der beiden Ursachen vorliegt – und damit auch nicht, was du beheben musst.
In diesem Tutorial baue ich eine vollständige RAG-Evaluierungspipeline in Python mit Ragas 0.4.3: ein manuell kuratiertes Evaluierungsdatenset, die vier Kernmetriken (Faithfulness, Answer Relevancy, Context Precision und Context Recall), ein Continuous-Integration-(CI)-Qualitätsgate, das den Build bei fallenden Scores stoppt, einen Generator für synthetische Testsätze und ein JSON-Lines-Score-Tracking.
Wenn du zuerst mehr Hintergrund brauchst: Lies unseren Guide zu Was RAG ist, unser Tutorial zum Einsatz eines Large Language Models (LLM) als Richter für die Evaluierung von RAG-Pipelines und unsere Übersicht zu fortgeschrittenen RAG-Techniken.
Du brauchst Python 3.9 oder neuer (ich nutze 3.12), uv oder pip, einen API-Schlüssel für ein OpenAI-kompatibles Judge-Modell und ein Grundverständnis, wie eine RAG-Pipeline funktioniert. Wenn dir das noch fehlt, empfehle ich unseren Kurs Retrieval-Augmented Generation with LangChain, der genau die Art Pipeline baut, die wir gleich bewerten.
Text-Overlap-Metriken wie BLEU (Bilingual Evaluation Understudy) und ROUGE (Recall-Oriented Understudy for Gisting Evaluation) sind das falsche Maß für RAG. Ragas nutzt stattdessen ein Judge-LLM, das jede Antwort auf vier Achsen bewertet: Faithfulness und Answer Relevancy diagnostizieren den Generator, Context Precision und Context Recall den Retriever.
Packs diese vier Zahlen in der CI hinter Schwellwerte und logge sie pro Commit – und du hast einen Regressionsalarm statt einer einmaligen Prüfung.
Ein Hinweis vorab. Die Ragas-API hat sich in zwei Jahren zweimal geändert: v0.2 ersetzte Dictionary-Datasets durch SingleTurnSample und EvaluationDataset, und v0.4 machte die Collections-Metriken (eingeführt in v0.3.9) zum Standard und markierte die alte Funktion evaluate() als veraltet.
Die meisten Tutorials online zeigen noch Code für v0.1 oder v0.2. Alles unten läuft auf 0.4.3, der aktuellen Version im Oktober 2026.
RAG braucht eigene Metriken, weil klassische Textmetriken nur zählen, wie viele Wörter eine Antwort mit einer Referenz teilt – und geteilte Formulierungen sind nicht das, was in einem RAG-System bricht.
BLEU (Papineni et al., 2002) und ROUGE (Lin, 2004) wurden für maschinelle Übersetzung und Zusammenfassung entwickelt, wo eine gute Ausgabe weitgehend dieselben Wörter wie die Referenz nutzt. Eine RAG-Antwort, die „du hast 2 Wochen“ statt „14 Tage“ sagt, schneidet bei beiden schlecht ab, während eine flüssige, aber erfundene Rückerstattungsregel gut punkten kann, wenn sie zufällig Wörter der Referenz wiederverwendet.
Das Grundproblem: Eine RAG-Pipeline kann an zwei separaten Stellen versagen – der Retriever wählt falsche Informationen aus, oder der Generator ignoriert gute Informationen und erfindet Fakten. Wenn eine Antwort falsch ist, musst du wissen, was davon passiert ist:
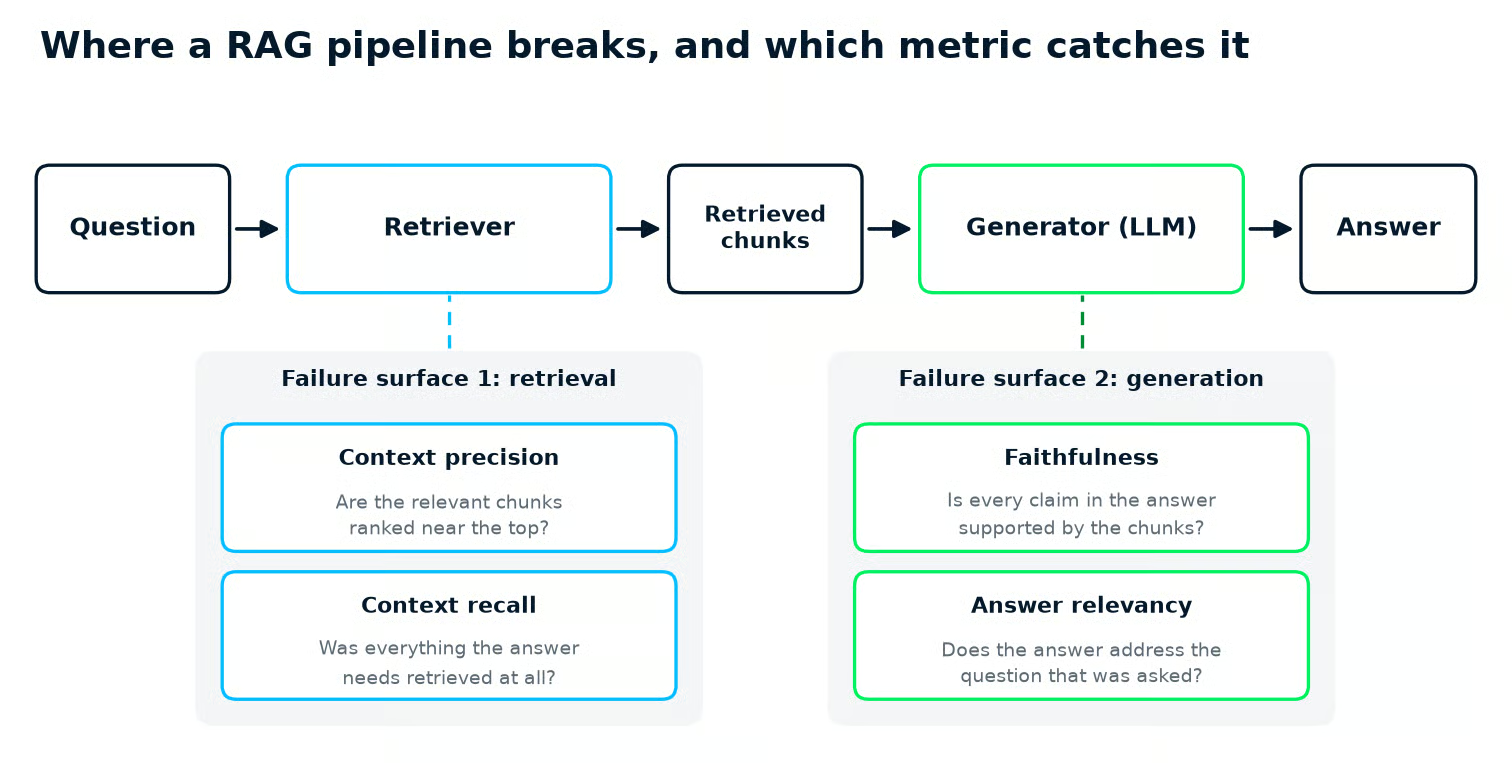
Die zwei Fehlermodi einer RAG-Pipeline: Context Precision und Recall diagnostizieren den Retriever, Faithfulness und Answer Relevancy den Generator. Abbildung: Autor.
Unser Guide zu RAG führt durch die Pipeline-Stufen, in denen diese Fehler entstehen.
Ragas ist ein Open-Source-Python-Framework, das dir eine Zahl für jeden Teil der Pipeline gibt. Es ist nicht die einzige Option. Die zwei wichtigsten Alternativen sind DeepEval, das Evaluierung in pytest-artige Testfälle packt, und Evidently, das LLM-Checks als Zusatzspalten in ein Dataset schreibt und in Monitoring-Reports visualisiert.
| Framework | Am besten geeignet für | RAG-spezifische Metriken integriert | Testdaten aus deinen Dokumenten | Konfigurationsstil |
|---|---|---|---|---|
| Ragas | Diagnose von RAG-Pipelines | Faithfulness, Answer Relevancy, Context Precision, Context Recall, Context Entities Recall, Noise Sensitivity | TestsetGenerator (Open Source) |
Metric-Objekte plus ein Judge aus llm_factory() |
| DeepEval | Unit-Test-ähnliches LLM-Testing in CI | Answer Relevancy, Faithfulness, Contextual Relevancy, Contextual Recall, Contextual Precision | Synthesizer (Open Source) |
LLMTestCase-Objekte, assert_test() via deepeval test run |
| Evidently | Monitoring-Dashboards und Drift über die Zeit | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | RAG-Dataset-Generierung in Evidently Cloud | Descriptors auf einem Dataset, zusammengefasst in einem Report |
Ich habe Ragas gewählt, weil seine vier Kernmetriken sauber in Retriever- und Generator-Scores trennen – und weil der Testsatz-Generator im selben Open-Source-Paket mitgeliefert wird.
Lebt dein Team ohnehin in pytest, fühlt sich DeepEvals assert_test() natürlicher an. Wenn du ein Dashboard mit Live-Traffic-Qualität willst, kommst du mit Evidently schneller ans Ziel.
Ragas einrichten heißt: Paket installieren, eine Abhängigkeit pinnen und ein Judge-LLM wählen, das alle Metriken gemeinsam nutzen. Ich nehme uv, weil es exakte Paketversionen sperrt, aber pip install mit denselben Versionen funktioniert genauso.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Ich nutze hier Python 3.12. Ragas 0.4.3 unterstützt offiziell Python 3.9 und neuer.
Das Paket rapidfuzz wird später für den Generator synthetischer Testsätze benötigt. Ragas deklariert es nicht als Abhängigkeit, daher installiere ich es direkt mit.
Das Pin langchain-community<0.4 ist aktuell nicht optional. Ragas 0.4.3 importiert ChatVertexAI aus einem Modulpfad, den langchain-community 0.4 entfernt hat. Eine frische Installation ohne Pin schlägt daher bereits beim Import von ragas fehl.
Als Nächstes der Judge. Jede LLM-basierte Metrik in Ragas macht eine oder mehrere Aufrufe an ein Judge-Modell. Du baust es einmal und reichst es überall durch. Ich lege das in ein eigenes Modul judge.py und lese den Schlüssel aus der Umgebung, damit keine Credentials in Git landen.
Diese Datei zeigt, wie du OpenAI direkt aufrufst oder Gemini über Googles OpenAI-kompatiblen Endpunkt.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Zwei Details in dieser Datei können den ersten Lauf stolpern lassen:
llm_factory() in 0.4 benötigt ein Client-Objekt. Nur einen Modellnamen zu übergeben, wirft einen Fehler.llm_factory() übergibst, landen direkt im Model-Call – so erhöhe ich max_tokens über das Standardlimit von 1.024.Nimm das günstigste Modell, das auf einem manuell geprüften Sample stabile Scores liefert – und pinne es dann. Bei großen Suites summiert sich das Volumen schnell: Faithfulness macht 2 Judge-Calls pro Sample, Answer Relevancy 3 plus 2 Embedding-Calls, Context Precision 1 pro abgerufenem Chunk und Context Recall 1.
Sechs Samples über vier Metriken ergaben in einem Run 62 Requests: 50 Judge-Calls plus 12 Embedding-Calls. Hier ist, was drei aktuelle kleine Judge-Modelle am 19. Oktober 2026 laut Listenpreis kosten:
| Judge-Modell | Input pro 1 Mio. Tokens | Output pro 1 Mio. Tokens | Quelle |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | OpenAI Pricing |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Gemini API Pricing |
| claude-haiku-5-5 | $0.10 (Prompts bis 100K Tokens) | $0.50 (Prompts bis 100K Tokens) | Claude API Pricing |
Der Default in judge.py ist weiterhin gpt-4o-mini, ein älteres OpenAI-Modell, das nicht in der Haupttabelle auf der OpenAI-Preisseite gelistet ist. Setze die Variable JUDGE_MODEL, um zu wechseln.
Ein Haken, wenn du Claude als Judge willst: Answer Relevancy braucht auch ein Embedding-Modell, und Anthropic bietet keines. Die Doku verweist auf Voyage AI, daher würdest du Claude mit Embeddings eines anderen Providers kombinieren.
Wichtiger als die Wahl ist das Pinnen. Ein Judge-Wechsel verschiebt Scores, selbst wenn deine Pipeline unverändert ist – das zerstört die Trendlinie, die du im Tracking-Abschnitt gleich aufbaust.
Schreibe den Modellnamen in judge.py unter Versionskontrolle und behandle ein Judge-Upgrade wie jeden anderen Breaking Change: Setze alle Schwellwerte anhand der neuen Judge-Scores neu.
Jeder Testfall im Datenset heißt Sample. Ein Sample ist mehr als eine Antwort: Es erfasst einen vollständigen Durchlauf durch die Pipeline in vier Feldern:
| Feld | Inhalt |
|---|---|
user_input |
Die Frage der Kundin bzw. des Kunden |
retrieved_contexts |
Die Chunks, die der Retriever zu dieser Frage zurückgegeben hat |
response |
Die Antwort der RAG-Pipeline |
reference |
Die korrekte, menschlich verfasste Antwort |
Ragas speichert jedes Sample als SingleTurnSample und das gesamte Set als EvaluationDataset. Das Feld reference ist optional, aber die Retrieval-Metriken vergleichen damit – daher nehme ich es im kuratierten Set immer auf, auch wenn die referenzfreien Metriken es ignorieren.
Ich habe sechs Samples für eine fiktive Kaffeerösterei, Northwind Coffee, gebaut. Jeder Metrik-Abschnitt unten ergänzt das Sample, das diese Metrik erkennen soll.
Starte build_dataset.py mit den ersten drei Samples: eine saubere Antwort, eine absichtliche Halluzination und eine zweite saubere Antwort mit mehreren Behauptungen.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Jeder abgerufene Kontext ist ein Chunk aus Northwinds Help-Center-Seiten, im Skript genau so hinterlegt, wie ein Retriever ihn an den Generator übergeben würde. Führe uv run python build_dataset.py aus, um eval_dataset.jsonl und eval_questions.jsonl zu schreiben, und führe es erneut aus, wenn ein späterer Abschnitt ein Sample hinzufügt.
Das Speichern als JSON Lines ist wichtig, weil alle späteren Skripte (Metrikläufe, CI-Gate) dasselbe eval_dataset.jsonl mit EvaluationDataset.from_jsonl() laden.
In echten Projekten stammen die Felder retrieved_contexts und response aus Läufen deiner tatsächlichen Pipeline über die Fragen, und nur user_input und reference sind manuell geschrieben. Der CI-Abschnitt zeigt, wie du diesen Schritt automatisierst.
Die sechs Samples in diesem Artikel reichen, um die Metriken zu lernen, aber nicht, um Schwellwerte zu vertrauen. Ziele auf etwa 100 Samples, bevor du dich auf Schwellwerte verlässt – der Tracking-Abschnitt zeigt warum. Wie viele du brauchst, hängt von der Strenge deines Use Cases ab, daher fokussiere ich auf einen guten Mix statt einer festen Zahl:
Die vier Kernmetriken sind: Faithfulness und Answer Relevancy für den Generator sowie Context Precision und Context Recall für den Retriever. Alle vier liefern Scores zwischen 0 und 1. Der Nutzen liegt darin, was dir jede Zahl zum Fixen sagt.
Faithfulness misst, wie viel der Antwort durch die abgerufenen Chunks gestützt ist. Der Judge teilt die Antwort in einzelne Claims auf und prüft jeden Claim gegen die Chunks: 1,0 heißt, jeder Claim ist belegt, 0,0 heißt, keiner ist belegt.
Faithfulness braucht keine Referenzantwort. Du kannst es daher auf Live-Produktionsverkehr laufen lassen, nicht nur auf deinem Testset. Führe es erneut aus, wann immer du Prompt, Modell oder die Kontextmenge änderst – das sind die häufigsten Quellen für Halluzinationen.
Am schnellsten siehst du die Wirkung an einer einzelnen Antwort, ganz ohne Dataset:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Starte es mit uv run python quick_check.py und es druckt faithfulness = 0.00, weil keiner der Claims (6 Monate, kostenlose Tüte) im Kontext gestützt ist. In 0.4 bewertest du über die ascore()-Methode der Metrik. Das Ergebnisobjekt liefert den Wert in .value.
Über das Dataset bisher erzielt die eingebaute Halluzination in Sample 2 einen Score von 0,0 – wie erwartet – und beide sauberen Samples 1,0. Die vollständigen Ergebnisse für alle Metriken findest du im Multi-Metrik-Abschnitt weiter unten.
Answer Relevancy misst, ob die Antwort die Frage tatsächlich adressiert. Der Judge liest die Antwort und schreibt drei Fragen, zu denen sie gut passen würde; dann prüft Ragas, wie ähnlich diese Fragen der ursprünglichen sind – per Embedding-Modell. Weicht die Antwort aus, markiert der Judge sie als unverbindlich und der Score ist 0.
Ragas nennt die Klasse AnswerRelevancy (ältere Beispiele nennen sie ResponseRelevancy, und die Doku-Seite heißt Response Relevancy). Sie braucht sowohl das Judge-LLM als auch das Embedding-Modell.
Ein niedriger Relevancy-Score bei hohem Faithfulness-Score deutet meist auf Generator oder Prompt: Das Modell hatte den richtigen Kontext und blieb darin, beantwortete aber eine andere Frage. Prüfe vorher Context Precision und Recall, denn auch ein Retriever, der Off-Topic-Chunks liefert, kann dieses Muster erzeugen.
Dieses Sample zeigt den Generator-Fall. Der Retriever liefert den richtigen Shipping-Chunk, die Antwort bleibt grounded – spricht aber über Röstdaten statt Versandkosten. Ergänze den neuen Chunk oben in build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Füge dann das neue Sample ans Ende der samples-Liste an:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Jedes Sample erhält einen Relevancy-Score: wie nah die vom Judge aus der Antwort abgeleiteten Fragen an der tatsächlich gestellten Frage liegen, wobei 1,0 eine perfekte Übereinstimmung ist.
Context Precision prüft, ob die nützlichen Chunks oben im Ranking der zurückgegebenen Treffer stehen, und Context Recall prüft, ob der Retriever alles gefunden hat, was für die korrekte Antwort nötig ist.
Precision gibt einem nützlichen Chunk mehr Gewicht, je höher er gerankt ist – ein nützlicher Chunk auf Platz 1 zählt also mehr als derselbe Chunk auf Platz 3. Recall ist der Anteil an Fakten in der Referenzantwort, die durch mindestens einen abgerufenen Chunk gestützt sind.
Beide brauchen das Feld reference. In der Collections-API heißen die Klassen ContextPrecisionWithReference und ContextRecall und nehmen nur das Judge-LLM. Die Ragas-Doku nutzt teils die Kurzform ContextPrecision für die referenzbasierte Variante – du kannst beide Bezeichnungen sehen.
Bisher holt jedes Sample die richtigen Chunks oben ab, daher gibt es noch nichts zu fangen. Fügen wir zwei Samples hinzu, die Retrieval auf unterschiedliche Weise brechen: eins, in dem der richtige Chunk zwar kommt, aber als Letzter gerankt ist, und eins, in dem gar nichts Relevantes kommt, sodass das Modell korrekt ablehnt. Wie zuvor kommen die Chunks oben in die Datei:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Dann kommen die Samples ans Listenende:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Ranking ist wichtig, weil die meisten Pipelines nur die Top-Chunks an das Modell übergeben – ein nützlicher Chunk auf Platz 6 einer Top-5-Retrieval-Pipeline existiert faktisch nicht.
Sample 5 setzt seinen einen nützlichen Chunk auf Platz 3 von 3 – Precision kommt mit 0,333 zurück, weil die einzige nützliche Information zuletzt kommt. Sample 6, der Retrieval-Miss, erzielt 0,0 bei Precision und Recall.
Sample 6 lehrt auch etwas zu Faithfulness. Das Modell lehnt korrekt ab, dennoch erhielt diese Ablehnung in manchen Läufen 1,0 und in anderen 0,0 bei Faithfulness – ohne Änderungen dazwischen. Eine Aussage wie „Ich habe keine Informationen zur Garantie“ wird vom Kontext weder gestützt noch widerlegt – der Judge entscheidet hier faktisch per Münzwurf.
Wenn deine Pipeline ablehnen soll, bewerte Ablehnungen separat, statt sie Faithfulness verwässern zu lassen. Ragas 0.4 hat AspectCritic aus der Collections-API entfernt, der Ersatz ist ein eigener Check mit dem Dekorator @discrete_metric (siehe Migrations-Guide von v0.3 auf v0.4).
Liest du die zwei Retrieval-Zahlen zusammen, sagen sie dir, wo du als Nächstes investieren solltest:
| Context Precision | Context Recall | Diagnose | Was ändern |
|---|---|---|---|
| Hoch | Hoch | Retrieval ist gesund | Am Generator arbeiten: Prompt, Modell, Faithfulness |
| Niedrig | Hoch | Richtige Chunks, aber schlecht gerankt | Reranker hinzufügen oder tunen |
| Hoch | Niedrig | Top-Chunks relevant, aber unvollständig | Mehr Chunks ans Modell geben, größere Chunks wählen oder Chunk-Splitting prüfen |
| Niedrig | Niedrig | Retriever versagt breit | Embeddings, Indexing und Query-Rewriting überarbeiten |
„Niedrige Precision, hoher Recall“ sehe ich in der Praxis am häufigsten – und es ist am günstigsten zu beheben.
Unser Tutorial RankGPT als Re-Ranking-Agent für RAG setzt einen LLM-Reranker auf einen bestehenden Retriever, und unser Tutorial Boost LLM Accuracy with RAG and Reranking zeigt ein weiteres Reranking-Setup. Unser Guide Fünf Schlüsseltechniken zur Verbesserung der RAG-Performance deckt Chunking und Query-Rewriting für die anderen Fälle ab.
Führe die beiden Retrieval-Metriken nach jeder Änderung erneut aus – die Tabelle zeigt dir, ob es gewirkt hat.
Eine vollständige Multi-Metrik-Evaluierung lässt alle vier Metriken parallel über jedes Sample laufen und sammelt die Scores – mit Zeilenwerten zum Debuggen und Spaltenmitteln für dein Dashboard.
In Ragas 0.2 und 0.3 ging das mit evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). In 0.4.3 existiert die Funktion noch, ist aber veraltet und akzeptiert die neuen Metriken nicht mehr, weil sie nicht mehr von der alten Metric-Klasse erben.
Der Ersatz ist der @experiment-Dekorator, der deine Pipeline und Metriken zusammen über ein Dataset laufen lässt und Ergebnisse als CSV schreibt. Das ist das richtige Werkzeug, sobald du die Pipeline aufrufen willst.
Für das Scoring eines statischen Datasets finde ich einen kleinen Helper klarer: Er baut die vier Metriken einmal pro Skript, das sie braucht, und hält Parallelität und Fehlerbehandlung in gut lesbarem Code:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Die einzig nicht offensichtliche Zeile ist der Aufruf inspect.signature(). Die vier Metriken wollen unterschiedliche Inputs (Faithfulness braucht die Antwort, Recall die Referenz). Der Helper liest, welche Argumente ascore() erwartet, und übergibt genau diese Felder aus dem Sample – so bedient eine Schleife alle Metriken.
Das Semaphore begrenzt die Zahl paralleler Judge-Calls und ein Metrikfehler wird zu einer leeren Zelle (NaN), statt den ganzen Lauf abzubrechen. In Jupyter schlägt asyncio.run fehl, weil bereits eine Loop läuft. Rufe vorher nest_asyncio.apply() auf (Ragas hängt bereits davon ab) oder awaite die Coroutine direkt.
Mit dem Helper ist der Voll-Lauf kurz:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Hier sind die Scores meines ersten Laufs, nach Faithfulness sortiert und auf drei Nachkommastellen gerundet, mit den Mitteln in der letzten Zeile:
| Frage | Faithfulness | Answer Relevancy | Context Precision | Context Recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mittelwert | 0.778 | 0.668 | 0.722 | 0.833 |
Spätere Läufe desselben Datasets bewerteten Faithfulness niedriger – wegen des Ablehnungs-Samples, das ich im Tracking-Abschnitt behandle.
Nach Faithfulness zu sortieren hilft, die wahrscheinlichsten Halluzinationen zu finden – die eingebaute steht oben. Die Mittelwerte in der letzten Zeile sind deine Dashboard-Zahlen.
Zeilenweise gelesen, zeigt sich jeder eingebaute Fehler an anderer Stelle. Die Halluzination drückt nur Faithfulness. Der Retrieval-Miss setzt Relevancy, Precision und Recall gleichzeitig auf 0. Das Ranking-Problem schneidet Precision auf 0,333. Der Drift-Fall zeigt die niedrigste Relevancy unter den beantworteten Fragen.
Eine Auffälligkeit: Die Kanada-Antwort ist vollständig gestützt, erzielte aber 0,667 bei Faithfulness. Das ist Judge-Rauschen – mehr dazu im Tracking-Abschnitt.
Answer Relevancy vergleicht Bedeutung über Embeddings, daher liegen auch gute Antworten selten nahe 1,0: Die Rückerstattungsantwort lag bei 0,746, während die Off-Topic-Shipping-Antwort 0,572 erhielt. Beurteile Relevancy über Lücken zwischen Samples und den Trend, nicht über absolute Zahlen.
Ein RAG-Qualitätsgate ist ein Testskript, das die Evaluierung ausführt, jeden Mittelwert mit einem Schwellwert vergleicht und mit Fehlercode beendet, sobald eine Metrik unterschreitet – die CI blockiert dann den Merge.
Ein Haken vorweg. Das oben manuell gebaute Dataset enthält handgeschriebene Antworten und Chunks – sein Scoring kann daher nie Änderungen an Prompt oder Retriever widerspiegeln. In CI musst du deine echte Pipeline über die gespeicherten Fragen laufen lassen und dann bewerten, was sie erzeugt hat. Zwei kleine Skripte erledigen das.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py ist die einzige Datei, die du selbst schreibst: Ersetze den Body von answer() durch einen Aufruf deines Retrievers und Generators. refresh_dataset.py liest die Fragen und Referenzen aus build_dataset.py, lässt die Pipeline darüber laufen und schreibt eval_dataset.jsonl neu.
Das Gate selbst ist ein Dictionary mit Schwellwerten und eine Schleife. Die Schwellwerte unten sind auf das Beispiel-Dataset kalibriert – kalibriere sie für deine Pipeline, bevor du dich darauf verlässt.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Gegen meine Basis reißen alle vier Mittel ihre Schwellwerte und das Skript beendet sich mit Code 0 – der Merge darf durch:
| Metrik | Mittel | Schwellwert | Ergebnis |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Pass |
| Answer Relevancy | 0.668 | 0.60 | Pass |
| Context Precision | 0.722 | 0.65 | Pass |
| Context Recall | 0.833 | 0.75 | Pass |
Ich setze den Faithfulness-Schwellwert auf 0,60 statt 0,70 wegen des Judge-Rauschens (siehe Tracking). Bei sechs Samples verschiebt ein einziger wackeliger Entscheid den Mittelwert um 0,17 – ein späterer Lauf derselben Pipeline lag bei 0,61. Das Gate lässt den Judge zudem dreimal laufen und mittelt (GATE_RUNS) – das glättet Flipps, kostet aber das Dreifache an Judge-Calls.
Eine Designentscheidung ist, auf not (actual >= threshold) zu failen statt actual < threshold. Ein Vergleich mit NaN („not a number“) ist immer False, daher würde actual < threshold Builds durchwinken, wenn der Judge ausfällt.
Das skipna=False im Mittel deckt den Teilfall ab. pandas überspringt NaN standardmäßig, wodurch ein paar fehlgeschlagene Judge-Calls das Sample still verkleinern würden. Ein temporärer Judge-Fehler lässt den Build jetzt fehlschlagen – starte den Job neu, bevor du debuggst.
Schwellwerte sind heikel. Setze sie ein wenig unter den niedrigsten Mittelwert, den du über wiederholte Läufe gesehen hast – nicht auf „aspirierende“ 0,9. Sonst blockt das Gate jeden Pull Request und niemand vertraut der CI. Setze sie neu, wenn du das Judge-Modell wechselst oder deutlich mehr Samples hinzufügst.
Die Einbindung in GitHub Actions ist ein kurzes Workflow-File. Die Referenz deckt die on.pull_request-Pfadfilter und den schedule-Cron ab:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Einige Details in diesem Workflow sind wichtig:
JUDGE_MODEL und passendem API-Key gepinnt. Nutze den gleichen Judge wie bei der Kalibrierung, sonst sind CI-Scores nicht mit deiner Historie vergleichbar.GATE_SAMPLE einen festen 30-Zeilen-Subset, damit Reviews nicht 10 Minuten auf Judge-Calls warten. Der nächtliche Cron bewertet alles.scores.csv und ragas_history.jsonl als Artefakte hoch, weil der Runner-Speicher nach dem Job verschwindet.Lass die volle Suite nachts laufen, wenn niemand wartet. Ein fehlschlagender nächtlicher Job erscheint als fehlgeschlagener Workflow; GitHubs Benachrichtigungen oder ein Slack-Step informieren morgens. GitLab CI hat denselben Aufbau mit rules: changes: und einem Pipeline-Schedule.
Ragas generiert synthetische Testfragen, indem es deine Dokumente liest, Hauptthemen und -fakten extrahiert, verwandte Chunks verknüpft und daraus verschiedene Fragetypen erstellt.
Die Doku zur Testdatengenerierung trennt Queries in Single-Hop (ein Chunk reicht) und Multi-Hop (mehrere Chunks nötig), jeweils spezifisch oder abstrakt. Der Default-Mix nutzt drei dieser vier Kombinationen zu gleichen Teilen:
Ragas nutzt nur Synthesizer, die deine Dokumente unterstützen – ein kleiner Dokumentensatz kann daher einen anderen Mix liefern.
Der Generator braucht echte Dokumente. Verweise auf deine eigene Doku als Markdown-Dateien. Für diesen Artikel habe ich fünf kurze Help-Center-Seiten für Northwind (insgesamt ca. 600 Wörter) geschrieben – jede sieht so aus:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Deine eigenen Docs erzeugen andere Fragen – genau darum geht es: Der Generator schreibt Fragen über das, was in deiner Wissensbasis wirklich steht.
Der TestsetGenerator nimmt dasselbe Judge-LLM und Embedding-Modell wie oben. Ich lade die Docs mit LangChains DirectoryLoader und nutze explizit TextLoader, damit Markdown-Dateien nicht die schwere unstructured-Abhängigkeit nachladen.
Die Dokumenten-Mapping-Phase feuert viele Judge-Calls auf einmal ab – ich begrenze die Parallelität via RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Das Skript lädt alle fünf Dokumente und schreibt diese acht Fragen. Die Fragen spiegeln die Dokumente – teils mit absichtlichen Tippfehlern:
| # | Generierte Frage | Fragetyp |
|---|---|---|
| 1 | how do i brew with a french pres | Single-Hop |
| 2 | Northwind equipment warranty | Single-Hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-Hop |
| 4 | how do I cancel Nortwind subscription? | Single-Hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-Hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-Hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-Hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-Hop |
Die Tabelle zeigt vereinfachte Labels; die Spalte synthesizer_name im Output enthält den vollen Namen. Acht Fragen aus fünf Dokumenten dauerten rund 4,5 Minuten.
Die Tippfehler und die Keyword-Query in Frage 2 sind Absicht: Der Generator variiert Stil und Länge jeder Query, sodass das Set eher wie Such-Traffic wirkt als wie Prüfungsfragen.
Du wirst die Fragen wahrscheinlich sichten wollen, um Nutzbarkeit und Relevanz zu sichern. Ich nutze den Output als ersten Entwurf. In jedem synthetischen Set, das ich geprüft habe, sind einige Fragen fehlerhaft (sie beziehen sich auf „das Dokument“ oder auf Überschriften), manche Referenzantworten driften vom tatsächlichen Inhalt ab, und die Formulierungen sind formaler als echte Nutzerfragen.
Starte den Generator erneut, wenn du einen Doku-Abschnitt ergänzt – du erhältst Vorschläge für neue Fragen, gegen die Kosten weiterer Judge-Calls.
Jede Zeile enthält ein user_input, eine generierte reference-Antwort und reference_contexts – die Chunks, aus denen die Frage gebaut wurde. Prüfe die reference gegen diese Chunks – dort treten Drifts auf.
Um eine geprüfte Zeile in ein SingleTurnSample zu überführen, lass deine Pipeline über das user_input laufen, um retrieved_contexts und response zu erhalten. Hänge geprüfte user_input-/reference-Paare an eval_questions.jsonl an – refresh_dataset.py erledigt den Rest.
Wenn deine Wissensbasis ein Graph statt eines Dokumenthaufens ist, gilt dasselbe Prinzip mit einem anderen Retriever. Unser Tutorial Using a Knowledge Graph to Implement a RAG Application und unser Kurs Graph RAG with LangChain and Neo4j liefern Pipelines, die du mit genau diesen vier Metriken evaluieren kannst – denn die Metriken sehen nur den Text, nicht den Retrievalweg.
Ragas-Scores über die Zeit zu tracken heißt: Nach jedem Evaluierungslauf die gemittelten Scores, den Git-Commit-Hash, das Judge-Modell und einen Zeitstempel in eine Logdatei (JSON Lines) anhängen, damit Regressionen als Delle in einer Linie statt als Produktionsüberraschung sichtbar werden.
Eine JSON-Lines-Datei ist wahrscheinlich die beste Wahl, bis du ein gemeinsames Experiment-Tracking brauchst. track_scores.py liest scores.csv, das sowohl quality_gate.py als auch run_all.py schreiben – es löst daher nie einen zweiten Judge-Lauf aus.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
uv run python track_scores.py hängt eine Zeile an die Logdatei an und druckt sie:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
In CI startet jeder Job mit einer leeren Disk, daher enthält ragas_history.jsonl pro Lauf nur diesen Eintrag. Um einen Trend zu behalten, lade die Artefakte herunter und hänge sie an eine gemeinsame Datei an – oder committe sie auf einen Metrics-Branch bzw. in Object Storage.
Das Plotten der Historie ist unkompliziert. Probier dieses Skript:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Du bekommst eine Grafik in dieser Art:
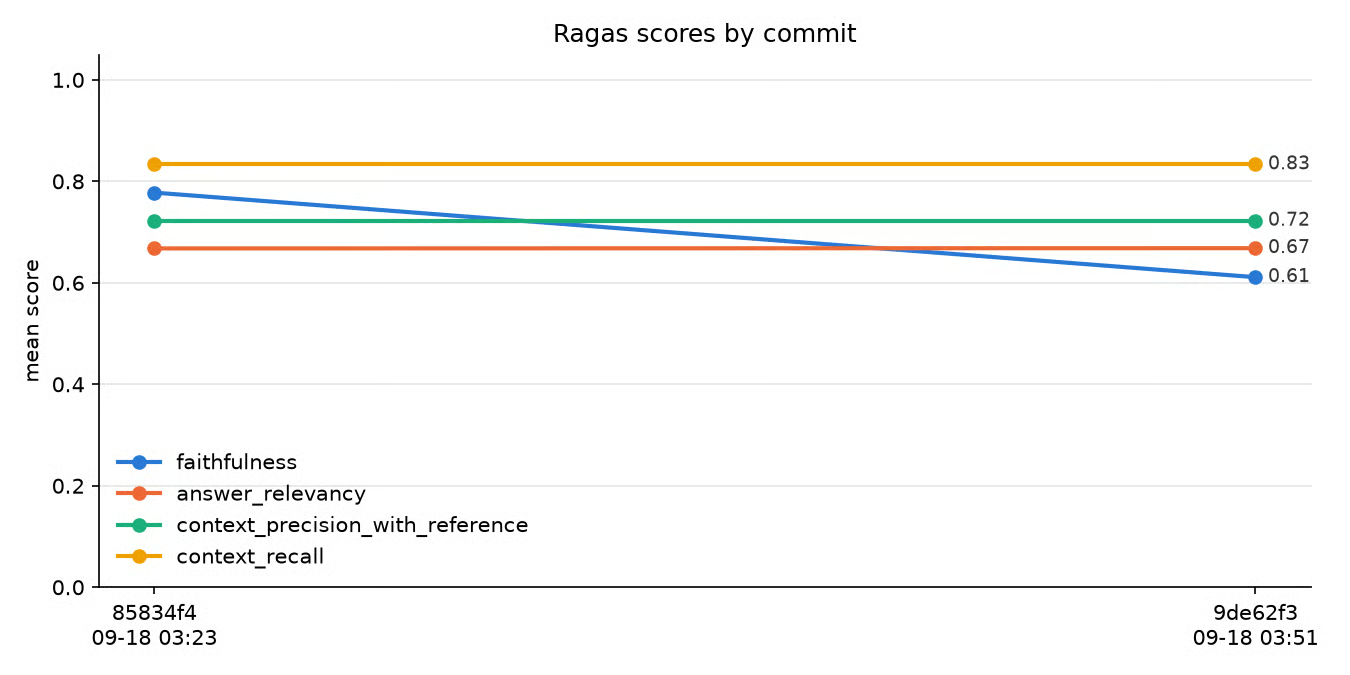
Mittlere Ragas-Scores pro Commit, geloggt von track_scores.py. Abbildung: Autor.
Zwischen diesen Commits hat sich an der Pipeline nichts geändert (der zweite Commit änderte nur die Verbindungs-Settings des Judge-Clients) – trotzdem fiel Faithfulness von 0,78 auf 0,61, weil die Ablehnung in Sample 6 von 1,0 auf 0,0 kippte.
Es gibt also reales Judge-Rauschen – besonders, bis du viele Samples hast. Mit sechs Samples verschiebt ein wackeliger Entscheid den Mittelwert um 0,17. Mit 100 Samples verschiebt derselbe Flip nur um 0,01 – eine starke Änderung ist dann sehr viel eher eine echte Regression.
Jetzt kannst du bei jedem Pull Request oder Commit das Gate laufen lassen, die Scores loggen und die Linie anschauen.
Wenn du über einen größeren Architekturwechsel nachdenkst, hilft unser Tutorial RAG vs. Fine-Tuning bei der Einordnung – und dieselben vier Metriken taugen für das Vorher-nachher in beiden Pfaden.
LLM-as-a-Judge-Scores sind Schätzwerte: Sie haben bekannte Biases und können von Lauf zu Lauf schwanken – skalieren aber auf Evaluierungsvolumina, die menschliches Review nicht leisten kann.
Ragas bittet den Judge nie, zwei Antworten zu vergleichen – daher greift Positionsbias (die erste Antwort zu bevorzugen) kaum. Verbosity-Bias (längere Antworten werden bevorzugt) und Self-Preference-Bias (Judges bevorzugen Antworten ihres eigenen Modells) können weiterhin eine Rolle spielen. Zheng et al. (2023) beschreiben alle drei, und Self-Preference ist der Grund, warum ich nicht dasselbe Modell für Generator und Judge nutzen würde.
Die Lauf-zu-Lauf-Varianz möchte ich, dass du sie selbst siehst – sie ändert, wie du Schwellwerte setzt. Über Läufe derselben sechs Samples mit demselben gepinnten Judge erhielt die Ablehnung in Sample 6 einmal 0,0 und ein andermal 1,0 bei Faithfulness – und das vollständig gestützte Sample 5 lag im gezeigten Lauf bei 0,667.
Per-Sample-Scores eines günstigen Judges sind verrauscht. Mittelwerte über 100 Samples sind deutlich stabiler – und das CI-Gate sollte immer den Mittelwert prüfen.
Drei Praktiken begrenzen das Rauschen:
judge.py und track_scores.py oben –, damit ein Judge-Wechsel nie als Pipeline-Änderung missverstanden wird.Für einen breiteren Überblick über Evaluierungsansätze jenseits von RAG – inklusive der menschlichen Methoden, die der Judge ersetzt –, deckt unser LLM-Evaluierungs-Guide Metriken und Methodik ab. Unser LLM-as-a-Judge-Tutorial geht tiefer in den Bau eines Judges für RAG-Pipelines.
Der Punkt dieser Pipeline: Sie erlaubt Aussagen wie „Der Retriever ist in Ordnung, der Prompt ist schlechter geworden“ oder „Der Reranker hat die Precision gefixt, aber Recall liegt noch bei 0,6“ – mit Zahlen dahinter.
Faithfulness und Answer Relevancy beobachten den Generator: Faithfulness fängt erfundene Fakten, Answer Relevancy Antworten, die an der Frage vorbeigehen. Context Precision und Recall beobachten den Retriever und sagen dir, ob er die richtigen Informationen zieht. Weil zwei der vier keine Referenz brauchen, kannst du sie auf Produktions-Traffic laufen lassen, wo keine Referenz existiert.
Standard-Textmetriken messen Wortüberlappung – das sagt nichts über eine erfundene Rückerstattungsregel aus – und eine einzelne End-to-End-Zahl verschleiert, welche Hälfte der Pipeline gebrochen ist. Ein Framework, das die zwei Fehlerpunkte getrennt prüft, kann das sehen – und der Schritt vom einmaligen Audit zum CI-Gate mit Historie sorgt dafür, dass dein Team nach den Zahlen handelt.
Wenn du die Pipeline noch nicht gebaut hast, starte mit unserem Kurs Retrieval-Augmented Generation with LangChain und verknüpfe dann dieses pipeline.py mit deiner Umsetzung.
Für Pipelines jenseits von reinem Text-Retrieval liefern unser Kurs End-to-End RAG with Weaviate, unser Multimodal-RAG-Guide und unser Agentic-RAG-Tutorial Systeme, die du genauso scoren kannst – mit einer Einschränkung: Die vier Kernmetriken lesen nur Text. Eine Pipeline, die Bilder retrievt, braucht Ragas’ separate Multimodal-Metriken, und eine agentische Pipeline muss jeden Retrieval-Schritt als eigene Frage/Chunks/Antwort bewerten.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Allan Ouko
11 Min.
Tutorial
Mark Pedigo
10 Min.