
Corso
Graph RAG con LangChain e Neo4j
3 ore
2.3K
Una pipeline di retrieval-augmented generation (RAG) per un chatbot supera ogni smoke test nel notebook. Poi iniziano ad arrivare ticket di supporto su risposte sbagliate o strane, e nei log degli smoke test non compare alcun campanello d’allarme.
Questo problema è difficile da intercettare perché è invisibile senza metriche. Una pipeline RAG può sbagliare in 2 punti: il retriever può recuperare i chunk sbagliati, oppure il generator può ignorare chunk corretti e inventare fatti. Un singolo numero di accuratezza end-to-end non può dirti quale dei due sia accaduto, quindi non può dirti cosa correggere.
In questo tutorial costruirò un’intera pipeline di valutazione RAG in Python usando Ragas 0.4.3: un dataset di valutazione costruito a mano, le 4 metriche core (faithfulness, answer relevancy, context precision e context recall), un quality gate di continuous integration (CI) che fa fallire la build quando i punteggi scendono, un generatore di test set sintetici e un tracker dei punteggi in JSON Lines.
Se vuoi prima un po’ di contesto, consulta la nostra guida su cos’è RAG, il nostro tutorial sull’uso di un large language model (LLM) come giudice per valutare pipeline RAG e la nostra panoramica sulle tecniche RAG avanzate.
Ti serve Python 3.9 o più recente (io uso la 3.12), uv o pip, una chiave API per un modello giudice compatibile con OpenAI e un’idea di massima di come funziona una pipeline RAG. Se vuoi prima creare le basi, ti consiglio il nostro corso Retrieval-Augmented Generation con LangChain, che costruisce il tipo di pipeline che andremo a valutare.
Metriche di sovrapposizione del testo come BLEU (Bilingual Evaluation Understudy) e ROUGE (Recall-Oriented Understudy for Gisting Evaluation) non sono lo strumento giusto per RAG. Ragas usa invece un LLM giudice per valutare ogni risposta su 4 assi: faithfulness e answer relevancy diagnosticano il generator, mentre context precision e context recall diagnosticano il retriever.
Metti queste 4 cifre dietro una soglia in CI e registrale per commit, e avrai un allarme di regressione invece di un audit estemporaneo.
Un avviso prima di iniziare. L’API di Ragas è cambiata due volte in 2 anni: la v0.2 ha sostituito i dataset a dizionari con SingleTurnSample ed EvaluationDataset, e la v0.4 ha reso predefinite le metriche “collections” (introdotte in v0.3.9) e ha deprecato la vecchia funzione evaluate().
La maggior parte dei tutorial online mostra ancora codice v0.1 o v0.2. Tutto ciò che segue gira su 0.4.3, l’attuale release a ottobre 2026.
RAG ha bisogno di metriche proprie perché le metriche classiche di testo contano solo quante parole una risposta condivide con una risposta di riferimento, e la condivisione di parole non è ciò che si rompe in un sistema RAG.
BLEU (Papineni et al., 2002) e ROUGE (Lin, 2004) sono state create per traduzione automatica e riassunto, dove un buon output dovrebbe usare parole molto simili al riferimento. Una risposta RAG che dice “hai 2 settimane” invece di “14 giorni” ottiene un punteggio basso su entrambe, mentre una risposta fluente che inventa una policy di rimborso può ottenere un buon punteggio se per caso riusa le parole del riferimento.
Il problema più profondo è che una pipeline RAG può fallire in 2 punti separati: il retriever può scegliere informazioni sbagliate oppure il generator può ignorare informazioni corrette e inventare fatti. Quando una risposta è sbagliata, devi sapere quale di questi è successo:
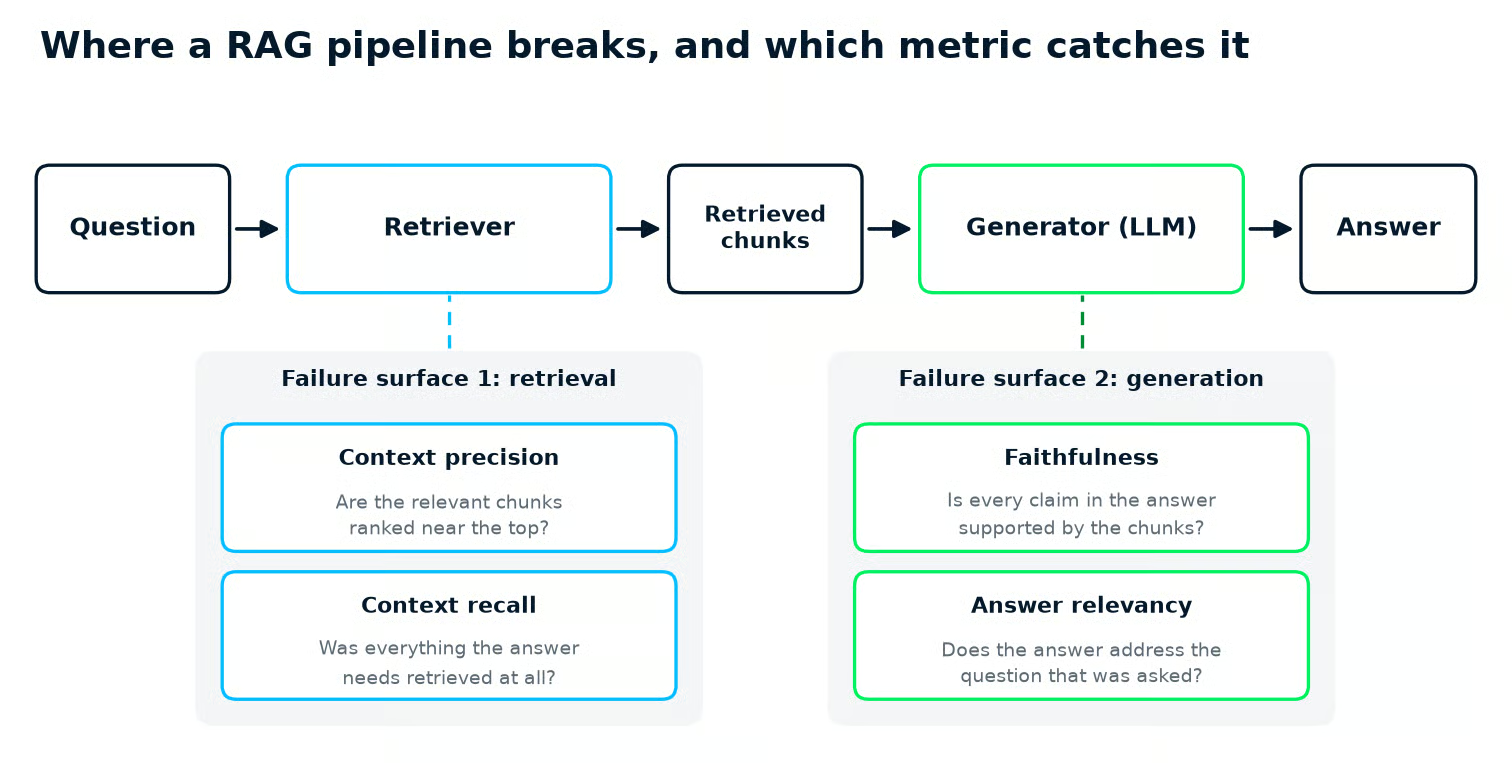
I 2 modi in cui può fallire una pipeline RAG: context precision e recall diagnosticano il retriever, mentre faithfulness e answer relevancy diagnosticano il generator. Immagine dell’autore.
La nostra guida What Is Retrieval Augmented Generation (RAG)? A Complete Guide illustra le fasi della pipeline in cui hanno origine questi fallimenti.
Ragas è un framework Python open source che ti dà un numero per ogni parte della pipeline. Non è l’unica opzione. Le 2 principali alternative sono DeepEval, che incapsula la valutazione in test case in stile pytest, e Evidently, che aggiunge controlli LLM come colonne extra su un dataset e li alimenta in report di monitoraggio.
| Framework | Ideale per | Metriche specifiche RAG integrate | Dati di test dai tuoi documenti | Stile di configurazione |
|---|---|---|---|---|
| Ragas | Diagnosticare pipeline RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Oggetti metrica più un giudice da llm_factory() |
| DeepEval | Test LLM in stile unit test in CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Oggetti LLMTestCase, assert_test() lanciati con deepeval test run |
| Evidently | Dashboard di monitoraggio e drift nel tempo | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Generazione dataset RAG in Evidently Cloud | Descriptor su un Dataset, riassunti da un Report |
Ho scelto Ragas per questo tutorial perché le sue 4 metriche core si dividono nettamente in punteggi del retriever e del generator, e perché il generatore di test set è fornito nello stesso pacchetto open source.
Se il tuo team già vive in pytest, l’assert_test() di DeepEval ti sembrerà più naturale. Se quello che vuoi è una dashboard della qualità del traffico live, i report di Evidently ti ci portano più in fretta.
Configurare Ragas significa installare il pacchetto, fissare una dipendenza e scegliere un LLM giudice condiviso da ogni metrica. Userò uv perché blocca per te le versioni esatte dei pacchetti, ma anche pip install con le stesse versioni va bene.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Qui uso Python 3.12. Ragas 0.4.3 dichiara supporto per Python 3.9 e successivi.
Il pacchetto rapidfuzz serve al generatore di test set sintetici più avanti nell’articolo. Ragas non lo dichiara come dipendenza, quindi lo installo subito.
Il pin langchain-community<0.4 non è opzionale al momento in cui scrivo. Ragas 0.4.3 importa ChatVertexAI da un percorso di modulo che la versione 0.4 di langchain-community ha rimosso, quindi un’installazione fresca senza il pin fallisce quando importi ragas.
Ora il giudice. Ogni metrica basata su LLM in Ragas effettua 1 o più chiamate a un modello giudice, quindi lo costruisci una volta e lo passi ovunque. Io lo tengo in un suo modulo, judge.py, e leggo la chiave dall’ambiente così nessuna credenziale finisce su git.
Questo file mostra come chiamare direttamente OpenAI, o Gemini tramite l’endpoint compatibile OpenAI di Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Due dettagli in quel file possono ostacolare la prima esecuzione:
llm_factory() nella 0.4 richiede il client passato, e passare solo un nome modello genera un errore.llm_factory() arriva direttamente alla chiamata del modello, ed è così che alzo max_tokens sopra il default di 1.024.Usa il modello più economico che produce punteggi stabili su un campione che hai verificato a mano, e poi fissalo. Per una suite di valutazione grande il volume pesa in fretta: faithfulness effettua 2 chiamate al giudice per campione, answer relevancy 3 più 2 chiamate di embedding, context precision 1 per chunk recuperato e context recall 1.
Sei campioni su 4 metriche hanno totalizzato 62 richieste in una singola esecuzione: 50 chiamate al giudice più 12 di embedding. Ecco quanto costano 3 modelli giudici piccoli attuali ai prezzi di listino di ciascun vendor al 19 ottobre 2026:
| Modello giudice | Input per 1M token | Output per 1M token | Fonte |
|---|---|---|---|
| gpt-6-luna | $0,10 | $0,50 | Prezzi OpenAI |
| gemini-3.5-flash-lite | $0,30 | $2,50 | Prezzi Gemini API |
| claude-haiku-5-5 | $0,10 (prompt fino a 100K token) | $0,50 (prompt fino a 100K token) | Prezzi Claude API |
Il default in judge.py resta gpt-4o-mini, un modello OpenAI più vecchio che non è elencato nella tabella prezzi principale sulla pagina dei prezzi di OpenAI. Imposta la variabile JUDGE_MODEL per cambiarlo.
Una nota se vuoi Claude come giudice: answer relevancy ha bisogno anche di un modello di embedding, e Anthropic non ne offre. I suoi doc puntano a Voyage AI, quindi accoppieresti Claude con embedding di un altro provider.
Fissare la versione conta più della scelta. Cambiare il modello giudice sposta i punteggi anche quando la tua pipeline non cambia, distruggendo la linea di tendenza che stai per costruire nella sezione di tracciamento.
Metti il nome del modello in judge.py sotto controllo di versione e tratta un upgrade del giudice come qualsiasi altra modifica breaking: reimposta ogni soglia in base ai punteggi del nuovo giudice.
Ogni test case nel dataset è chiamato sample. Un sample è più di una risposta: registra un giro completo attraverso la pipeline, in 4 campi:
| Campo | Cosa contiene |
|---|---|
user_input |
La domanda che ha fatto il cliente |
retrieved_contexts |
I chunk che il retriever ha restituito per quella domanda |
response |
La risposta fornita dalla pipeline RAG |
reference |
La risposta corretta, scritta da una persona |
Ragas salva ogni sample come SingleTurnSample e l’intero set come EvaluationDataset. Il campo reference è opzionale, ma le metriche di retrieval lo confrontano, quindi lo includo sempre nel set curato anche se le metriche senza riferimento lo ignorano.
Ho costruito 6 sample per una torrefazione fittizia, Northwind Coffee. Ogni sezione di metrica qui sotto aggiunge il sample che quella metrica dovrebbe intercettare.
Inizia build_dataset.py con i primi 3 sample: una risposta pulita, una allucinazione deliberata e una seconda risposta pulita che fa diverse affermazioni insieme.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Ogni contesto recuperato è un chunk delle pagine del centro assistenza di Northwind, scritto nello script esattamente come un retriever lo passerebbe al generator. Esegui uv run python build_dataset.py per scrivere eval_dataset.jsonl ed eval_questions.jsonl, e rieseguilo ogni volta che una sezione successiva aggiunge un sample.
Salvare in JSON Lines è importante perché ogni script successivo (le esecuzioni delle metriche, il gate CI) carica lo stesso eval_dataset.jsonl con EvaluationDataset.from_jsonl().
In un progetto reale, i campi retrieved_contexts e response provengono dall’esecuzione della tua pipeline reale sulle domande, e solo user_input e reference sono scritti a mano. La sezione CI mostra come automatizzare questo passaggio.
I 6 sample con cui si conclude questo articolo bastano per imparare le metriche, ma non per fidarsi di una soglia. Punta a circa 100 sample prima di farci affidamento; la sezione di tracciamento mostra perché. Quanti te ne servono dipende da quanto è rigoroso il tuo caso d’uso, quindi mi concentro su un buon mix più che su un numero specifico:
Le 4 metriche core di Ragas sono faithfulness e answer relevancy per il generator, e context precision e context recall per il retriever. Tutte e 4 restituiscono un punteggio tra 0 e 1. La parte utile è cosa ciascun numero ti dice di sistemare.
Faithfulness misura quanto di una risposta è supportato dai chunk recuperati. Il giudice spezza la risposta in singole affermazioni, poi verifica ogni affermazione contro i chunk: un punteggio di 1,0 significa che ogni affermazione è supportata, 0,0 che nessuna lo è.
Faithfulness non richiede una risposta di riferimento, quindi puoi eseguirla sul traffico di produzione live, non solo sul test set. Rieseguila ogni volta che cambi il prompt, il modello o quanta porzione di contesto vede il modello, perché sono questi i cambi che più spesso introducono allucinazioni.
Il modo più rapido per vederla in azione è su una singola risposta, senza dataset:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Eseguilo con uv run python quick_check.py e stamperà faithfulness = 0.00, perché nessuna delle affermazioni nella risposta (6 mesi, una busta gratuita) è supportata dal contesto. Nella 0.4 esegui il punteggio con il metodo ascore() di ogni metrica, che restituisce un risultato il cui .value è il punteggio.
Valutato sull’intero dataset finora, l’allucinazione inserita nel sample 2 ottiene 0,0, come dovrebbe, e entrambi i sample puliti ottengono 1,0. I risultati completi per ogni metrica sono nella sezione multi-metrica qui sotto.
Answer relevancy misura se la risposta affronta davvero la domanda. Il giudice legge la risposta e scrive 3 domande a cui quella risposta andrebbe bene, poi Ragas controlla quanto quelle domande siano vicine nel significato all’originale, usando un modello di embedding. Se la risposta elude la domanda, il giudice la marca come non impegnativa e ottiene 0.
Ragas chiama la classe AnswerRelevancy (esempi più vecchi la chiamano ResponseRelevancy, e la pagina dei doc è intitolata Response Relevancy), e richiede sia l’LLM giudice sia il modello di embedding.
Un punteggio di relevancy basso con un punteggio di faithfulness alto di solito punta al generator o al prompt: il modello aveva il contesto giusto e vi è rimasto ancorato, ma ha risposto a una domanda diversa da quella posta. Controlla prima context precision e recall, perché un retriever che restituisce chunk fuori tema può produrre lo stesso pattern.
Questo sample mostra il caso del generator. Il retriever restituisce il chunk di spedizione giusto, la risposta resta ancorata, e parla di date di tostatura invece che del costo di spedizione. Aggiungi il nuovo chunk in cima a build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Poi aggiungi il nuovo sample in coda alla lista samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Ogni sample ottiene un punteggio di relevancy: quanto vicino sono nel significato le domande scritte dal giudice a partire dalla risposta rispetto alla domanda effettiva del sample, dove 1,0 è una corrispondenza perfetta.
Context precision verifica se i chunk utili sono classificati ai primi posti tra quelli restituiti dal retriever, e context recall verifica se il retriever ha trovato tutto ciò che serve per scrivere la risposta corretta.
La precision dà più credito a un chunk utile quanto più in alto è classificato, quindi un chunk utile al primo posto conta più dello stesso chunk al terzo. Il recall è la quota di fatti nella risposta di riferimento che almeno un chunk recuperato supporta.
Entrambe richiedono il campo reference. Nella collections API le classi sono ContextPrecisionWithReference e ContextRecall, e entrambe prendono solo l’LLM giudice. I doc di Ragas usano anche il nome più corto ContextPrecision per la versione basata su reference, quindi potresti vedere entrambi.
Finora ogni sample recupera i chunk giusti per primi, quindi nessuna metrica ha nulla da intercettare. Aggiungiamo 2 sample che rompono il retrieval in modi diversi: uno in cui il chunk corretto è recuperato ma classificato per ultimo, e uno in cui non viene recuperato nulla di rilevante, quindi il modello rifiuta correttamente. Come prima, aggiungi i chunk in cima al file:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Poi aggiungi i sample in coda alla lista:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Il ranking conta perché la maggior parte delle pipeline passa al modello solo i primi pochi chunk, quindi un chunk utile al 6º posto di un retriever top-5 è come se non esistesse.
Il sample 5 mette il suo unico chunk utile ultimo su 3, e la precision torna a 0,333 dato che l’unica informazione utile è classificata ultima. Il sample 6, il retrieval miss, ha ottenuto 0,0 sia in precision sia in recall.
Il sample 6 insegna anche qualcosa su faithfulness. Il modello ha rifiutato correttamente, eppure quel rifiuto ha ottenuto 1,0 in alcune esecuzioni e 0,0 in altre, senza che nulla fosse cambiato. Un’affermazione come “Non ho informazioni sulla garanzia” non è né supportata né contraddetta dal contesto, e il giudice tira una moneta.
Se la tua pipeline deve rifiutare, valuta i rifiuti separatamente invece di lasciare che trascinino in basso la faithfulness. Ragas 0.4 ha rimosso AspectCritic dalla collections API, quindi il sostituto è un controllo personalizzato costruito con il decorator @discrete_metric (vedi la guida alla migrazione da v0.3 a v0.4).
Leggi insieme i 2 numeri del retrieval e ti diranno dove spendere la prossima settimana:
| Context precision | Context recall | Diagnosi | Cosa cambiare |
|---|---|---|---|
| Alta | Alta | Retrieval sano | Concentrati sul generator: prompt, modello, faithfulness |
| Bassa | Alta | Chunk corretti recuperati ma classificati male | Aggiungi o ottimizza un reranker |
| Alta | Bassa | Top chunk rilevanti ma incompleti | Passa più chunk al modello, usa chunk più grandi o rivedi dove avviene lo split |
| Bassa | Bassa | Retriever ampiamente in fallimento | Rivedi embedding, indicizzazione e riscrittura query |
La riga “bassa precision, alta recall” è la più comune che vedo in pratica, ed è la più economica da sistemare.
Il nostro tutorial RankGPT come agente di re-ranking per RAG aggiunge un LLM reranker sopra un retriever esistente, e il nostro tutorial Aumenta l’accuratezza degli LLM con RAG e reranking mostra un altro setup di reranking. La nostra guida su 5 tecniche chiave per migliorare le performance RAG copre chunking e riscrittura delle query per le altre righe.
Riesegui le 2 metriche di retrieval dopo ogni modifica e la tabella ti dirà se ha funzionato.
Una valutazione multi-metrica completa esegue tutte e 4 le metriche su ogni sample in parallelo e raccoglie i punteggi, con valori per riga per approfondire i fallimenti e medie di colonna per la tua dashboard.
In Ragas 0.2 e 0.3 lo facevi con evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). Nella 0.4.3 quella funzione esiste ancora, ma avvisa che è deprecata e rifiuta le nuove metriche in blocco, perché non ereditano più dalla vecchia classe Metric che si aspetta.
Il rimpiazzo è il @experiment decorator, che esegue pipeline e metriche insieme su un Dataset e scrive i risultati in CSV. È lo strumento giusto quando hai una pipeline da chiamare.
Per valutare un dataset statico, trovo più chiaro un piccolo helper: costruisce le 4 metriche una volta per ogni script che ne ha bisogno, e mantiene chiamate parallele e gestione errori in codice leggibile:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
L’unica riga non ovvia è la chiamata a inspect.signature(). Le 4 metriche richiedono input diversi (faithfulness ha bisogno della risposta, recall della reference), quindi l’helper legge quali argomenti accetta il ascore() di ciascuna e passa esattamente quei campi dal sample, permettendo a un singolo loop di servire ogni metrica.
Il semaforo limita quante chiamate al giudice girano in parallelo, e una metrica che fallisce comunque diventa una cella vuota (NaN) invece di interrompere l’intera esecuzione. Se esegui questo in un notebook Jupyter, asyncio.run fallisce perché un loop è già in esecuzione. Chiama prima nest_asyncio.apply() (Ragas lo include già come dipendenza) o attendi direttamente la coroutine.
Con l’helper in posto, l’esecuzione completa è breve:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Ecco i punteggi della mia prima esecuzione, ordinati per faithfulness e arrotondati a 3 decimali, con le medie nell’ultima riga:
| Domanda | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0,000 | 0,883 | 1,000 | 1,000 |
| Does Northwind ship to Canada, and how long does it take? | 0,667 | 0,954 | 0,333 | 1,000 |
| How long do I have to ask for a refund on a bag of coffee? | 1,000 | 0,746 | 1,000 | 1,000 |
| How long is the warranty on the Baratza Encore grinder? | 1,000 | 0,000 | 0,000 | 0,000 |
| How much does standard shipping cost in the US? | 1,000 | 0,572 | 1,000 | 1,000 |
| What do subscribers get that regular customers do not? | 1,000 | 0,852 | 1,000 | 1,000 |
| Media | 0,778 | 0,668 | 0,722 | 0,833 |
Esecuzioni successive dello stesso dataset hanno valutato la faithfulness più in basso a causa del flip del sample di rifiuto che tratto nella sezione tracking.
Ordinare per faithfulness aiuta a individuare le allucinazioni più probabili, e quella inserita è in cima. Le medie nell’ultima riga sono i numeri per la tua dashboard.
Leggi per riga e ogni fallimento “piantato” emerge in un punto diverso. L’allucinazione abbassa solo la faithfulness. Il retrieval miss azzera insieme relevancy, precision e recall. Il problema di ranking taglia la precision a 0,333, e il drift emerge come la relevancy più bassa tra le domande a cui è stata data risposta.
Una stranezza: la risposta sul Canada è pienamente supportata dal suo chunk, eppure ha ottenuto 0,667 su faithfulness. È rumore del giudice, a cui torno nella sezione tracking.
Answer relevancy confronta il significato con embedding, quindi anche una buona risposta raramente arriva vicino a 1,0: la risposta sul rimborso ha ottenuto 0,746, mentre la risposta fuori tema sulla spedizione 0,572. Valuta la relevancy per il divario tra sample e per la tendenza nel tempo, non per il numero assoluto.
Un quality gate RAG è uno script di test che esegue la valutazione, confronta ogni punteggio medio con una soglia ed esce con un codice di errore quando una metrica scende sotto, segnalando al sistema CI di bloccare il merge.
Un caveat prima. Il dataset costruito a mano sopra ha risposte e chunk recuperati scritti a mano, quindi valutarlo non può mai riflettere un cambiamento al prompt o al retriever. In CI devi rieseguire la pipeline reale sulle domande salvate e poi valutare ciò che ha prodotto. Servono due piccoli script.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py è l’unico file che scrivi tu: sostituisci il corpo di answer() con una chiamata al tuo retriever e generator. refresh_dataset.py legge le domande e le risposte di riferimento salvate da build_dataset.py, esegue la pipeline su ogni domanda e riscrive eval_dataset.jsonl.
Il gate in sé è un dizionario di soglie e un loop. Le soglie sotto sono calibrate sul dataset di esempio costruito a mano, quindi ricalibrale sull’output della tua pipeline prima di farci affidamento.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Rispetto alla mia baseline, tutte e 4 le medie superano le soglie e lo script esce con codice 0, consentendo il merge:
| Metrica | Media | Soglia | Risultato |
|---|---|---|---|
| Faithfulness | 0,778 | 0,60 | Pass |
| Answer relevancy | 0,668 | 0,60 | Pass |
| Context precision | 0,722 | 0,65 | Pass |
| Context recall | 0,833 | 0,75 | Pass |
Ho impostato la soglia di faithfulness a 0,60 invece che a 0,70 a causa del rumore del giudice che tratto nella sezione tracking. Con 6 sample, un singolo verdetto instabile sposta una media di 0,17, e un’esecuzione successiva della pipeline invariata ha ottenuto 0,61. Il gate esegue anche il giudice 3 volte e media i punteggi (GATE_RUNS), il che attenua i flip a parità di costo del giudice moltiplicato per 3.
Una scelta progettuale è fallire su not (actual >= threshold) piuttosto che su actual < threshold. Un confronto con NaN (“not a number”) è sempre False, quindi un controllo scritto come actual < threshold farebbe passare la build ogni volta che il giudice fallisce.
Lo skipna=False nella media copre il caso parziale. Per default pandas salta i NaN, quindi alcune chiamate al giudice fallite ridurrebbero silenziosamente il campione invece di far fallire il gate. Un errore transitorio del giudice ora fa fallire la build, quindi rilancia il job prima di fare debug.
Le soglie sono difficili da tarare. Impostale leggermente sotto la media più bassa che hai visto su esecuzioni ripetute, non a un auspicabile 0,9, altrimenti il gate blocca ogni pull request e il team smette di fidarsi della CI. Reimpostale ogni volta che cambi il modello giudice o aggiungi più di una manciata di sample.
Collegarlo a GitHub Actions richiede un workflow breve. La reference della sintassi workflow copre i filtri di percorso on.pull_request e il cron schedule usato qui:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Alcuni dettagli in quel workflow contano:
JUDGE_MODEL e la relativa chiave API. Usa lo stesso giudice con cui hai calibrato le soglie, altrimenti i punteggi in CI non saranno comparabili con la tua cronologia.GATE_SAMPLE valuta un sottoinsieme casuale fisso di 30 righe, così la review non attende 10 minuti di chiamate al giudice. Il cron notturno valuta tutto.scores.csv e ragas_history.jsonl come artifact, perché il disco del runner scompare alla fine del job.Esegui la suite completa sul cron notturno, quando nessuno sta aspettando. Un fallimento notturno appare come workflow fallito, e le impostazioni di notifica di GitHub o uno step Slack possono avvisare il responsabile al mattino. GitLab CI ha la stessa struttura con rules: changes: e una pipeline schedule.
Ragas genera domande di test sintetiche leggendo i tuoi documenti, estraendone i temi e i fatti principali, collegando chunk correlati e poi scrivendo domande di generi diversi a partire da quei collegamenti.
I doc sulla generazione dei dati di test dividono le query in single-hop (un chunk può rispondere) e multi-hop (la risposta richiede più chunk), e ognuna può essere specifica o astratta. Il mix predefinito usa 3 di queste 4 combinazioni in parti uguali:
Ragas usa solo i sintetizzatori che i tuoi documenti possono supportare, quindi un set di documenti piccolo può produrre un mix diverso.
Il generatore ha bisogno di documenti reali da leggere. Puntalo alla tua documentazione come file markdown. Per questo articolo ho scritto 5 brevi pagine del centro assistenza per Northwind (circa 600 parole in totale), e ognuna appare così:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
I tuoi doc produrranno domande diverse da quelle sotto, ed è il punto: il generatore scrive domande su ciò che il tuo knowledge base effettivamente dice.
Il TestsetGenerator usa lo stesso LLM giudice e modello di embedding che abbiamo già costruito. Carico i doc con il DirectoryLoader di LangChain, usando esplicitamente TextLoader così i file markdown non trascinano dentro la pesante dipendenza unstructured.
Mappare i tuoi documenti scatena molte chiamate al giudice in una volta, quindi limito anche quante girano in parallelo con RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Lo script carica tutti e 5 i documenti e scrive queste 8 domande. Le domande seguono i documenti, e alcune contengono errori di battitura deliberati:
| # | Domanda generata | Tipo di domanda |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
La tabella mostra etichette semplificate; la colonna synthesizer_name nell’output contiene il nome completo del sintetizzatore. Otto domande da 5 documenti hanno richiesto circa 4,5 minuti.
Gli errori di battitura e la query in stile keyword nella domanda 2 sono deliberati: il generatore varia lo stile e la lunghezza di ogni query così il set assomiglia al traffico di una search box più che a domande da esame.
Probabilmente vorrai rivedere le domande per assicurarti che siano utilizzabili e pertinenti. Userei l’output come prima bozza. In ogni set sintetico che ho revisionato, alcune domande sono malformate (fanno riferimento a “il documento” o chiedono di un heading), alcune risposte di riferimento deviano da quanto dice davvero la fonte e la formulazione è più formale di quella di un utente reale.
Riesegui il generatore quando aggiungi una sezione ai doc e otterrai domande candidate per il nuovo materiale, al costo di un altro giro di chiamate al giudice.
Ogni riga ha un user_input, una reference generata e i reference_contexts, i chunk da cui è stata costruita la domanda. Controlla la reference rispetto a quei chunk, perché è lì che emerge il drift.
Per trasformare una riga revisionata in un SingleTurnSample, esegui la tua pipeline sul user_input per ottenere retrieved_contexts e response. Aggiungi le coppie user_input e reference revisionate a eval_questions.jsonl e refresh_dataset.py farà il resto per te.
Se il tuo knowledge base è un grafo piuttosto che un insieme di documenti, lo stesso principio vale con un retriever diverso. Il nostro tutorial Usare un knowledge graph per implementare un’app RAG e il nostro corso Graph RAG con LangChain e Neo4j producono pipeline che puoi valutare esattamente con le 4 metriche sopra, perché le metriche vedono solo il testo recuperato, non come è stato recuperato.
Tracciare i punteggi di Ragas nel tempo significa aggiungere i punteggi medi, l’hash del commit git, il modello giudice e un timestamp a un file di log dopo ogni esecuzione di valutazione, così una regressione appare come un calo su un grafico a linee invece di una sorpresa in produzione.
Un file JSON Lines è probabilmente la scelta migliore finché non ti serve un experiment tracker condiviso. track_scores.py legge scores.csv, che sia quality_gate.py sia run_all.py scrivono, così non scatena mai un secondo giro di chiamate al giudice.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Eseguire uv run python track_scores.py aggiunge una riga al log e la stampa:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
In CI ogni job parte con un disco vuoto, quindi ragas_history.jsonl conterrà solo il record di quell’esecuzione. Per mantenere una tendenza, scarica gli artifact caricati e aggiungili a un unico file, oppure fai il commit del file su un branch di metriche o su object storage.
Tracciare la cronologia è piuttosto semplice. Prova questo script:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Otterrai un grafico simile a questo:
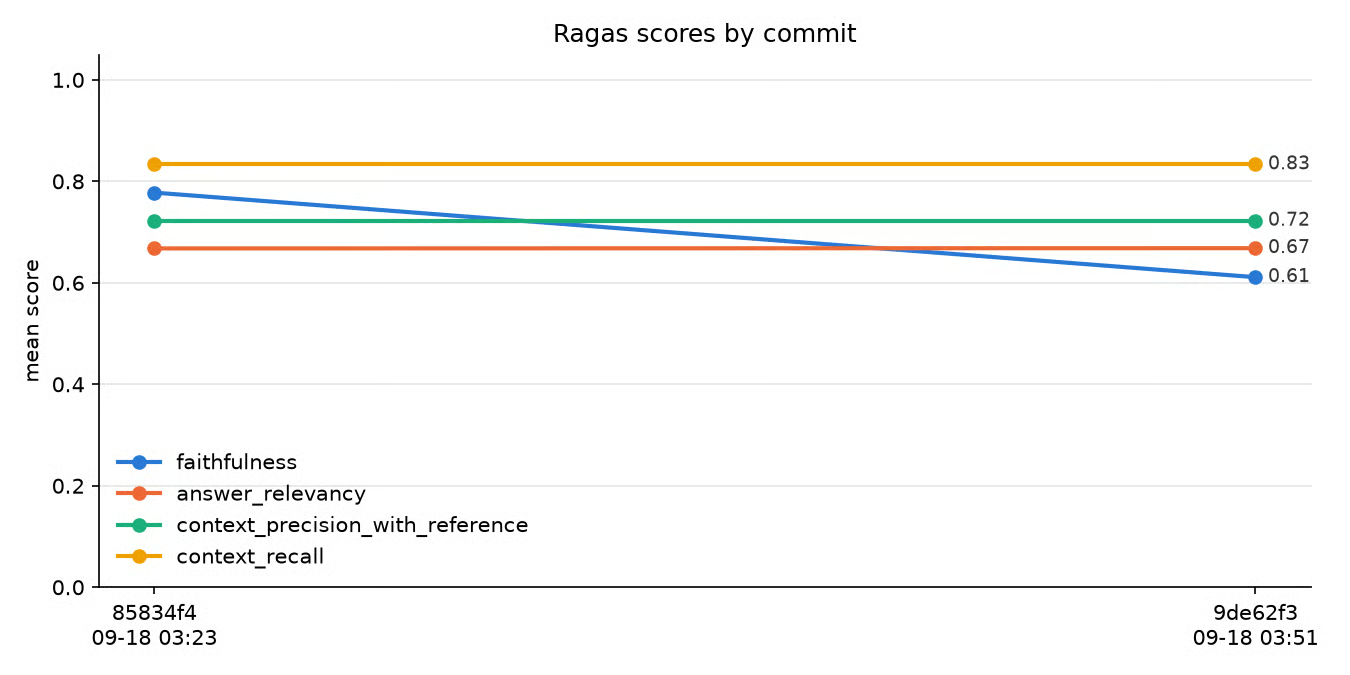
Punteggi medi Ragas registrati per commit da track_scores.py. Immagine dell’autore.
Nella pipeline non è cambiato nulla tra quei commit (il secondo ha cambiato solo le impostazioni di connessione del client del giudice), eppure la faithfulness è scesa da 0,78 a 0,61 perché il rifiuto nel sample 6 è passato da 1,0 a 0,0.
Quindi c’è un reale rumore del giudice da tenere d’occhio finché non hai un gran numero di sample. Con 6 sample, 1 verdetto instabile sposta la media di 0,17. Con 100 sample lo stesso flip la sposta di 0,01, quindi un grande cambiamento è molto più probabilmente una vera regressione.
Ora, con ogni pull request o commit, puoi eseguire il gate, registrare i punteggi e guardare il grafico.
Se stai valutando un cambiamento architetturale più grande, il nostro tutorial RAG vs fine-tuning inquadra il trade-off, e le stesse 4 metriche funzionano come misurazione prima e dopo in entrambi i percorsi.
I punteggi LLM-come-giudice sono stime: hanno bias noti e possono cambiare da un’esecuzione all’altra, ma scalano a volumi di valutazione che una revisione umana non può sostenere.
Ragas non chiede mai al giudice di confrontare 2 risposte, quindi il position bias (favorire la risposta che viene per prima) in gran parte non si applica. Il verbosity bias (favorire risposte più lunghe) e il self-preference bias (giudici che favoriscono risposte del proprio modello) possono comunque contare. Zheng et al. (2023) descrivono tutti e 3 i bias, e l’auto-preferenza è il motivo per cui non userei lo stesso modello come generator e giudice.
La variazione tra esecuzioni è la parte che voglio tu veda con i tuoi occhi, perché cambia come imposti le soglie. Su esecuzioni dello stesso 6 sample con lo stesso giudice fissato, la risposta di rifiuto nel sample 6 ha ottenuto 0,0 in un’esecuzione e 1,0 in un’altra su faithfulness, e il sample 5 pienamente ancorato ha ottenuto 0,667 nell’esecuzione sopra.
I punteggi per sample di un giudice economico sono rumorosi. Le medie su 100 sample sono molto meno rumorose, e il gate CI dovrebbe sempre testare la media.
Tre pratiche contengono il rumore:
judge.py e track_scores.py sopra, così un cambio di giudice non viene mai scambiato per un cambio di pipeline.Per un giro più ampio degli approcci di valutazione oltre RAG, inclusi i metodi di valutazione umana che il giudice sostituisce, la nostra guida alla valutazione degli LLM copre metriche e metodologie. Il nostro tutorial su LLM come giudice approfondisce la costruzione di un giudice per pipeline RAG.
Il punto di questa pipeline è poter dire cose come “il retriever va bene, il prompt è regredito” oppure “il reranker ha sistemato la precision ma la recall è ancora 0,6”, con numeri a supporto.
Faithfulness e answer relevancy guardano il generator: faithfulness intercetta fatti inventati, answer relevancy risposte che deragliano dalla domanda. Context precision e recall guardano il retriever e ti dicono se recupera le informazioni giuste. Poiché 2 delle 4 non richiedono una risposta di riferimento, puoi eseguirle sul traffico di produzione dove il riferimento non esiste.
Le metriche di testo standard misurano la sovrapposizione di parole, che non dice nulla su una policy di rimborso inventata, e un singolo numero end-to-end nasconde quale metà della pipeline si è rotta. Un framework che controlla separatamente i 2 punti di failure può vederlo, e trasformarlo da audit estemporaneo a gate in CI con un file di cronologia è ciò che porta il tuo team ad agire sui numeri.
Se non hai ancora costruito la pipeline, inizia con il nostro corso Retrieval-Augmented Generation con LangChain e poi punta il pipeline.py di questo articolo a ciò che costruisci.
Per pipeline che vanno oltre il retrieval di solo testo, il nostro corso End-to-End RAG con Weaviate, la nostra guida al RAG multimodale e il nostro tutorial su agentic RAG costruiscono sistemi che puoi valutare allo stesso modo, con una precisazione: le 4 metriche core leggono solo testo. Una pipeline che recupera immagini ha bisogno delle metriche multimodali separate di Ragas, e una pipeline agentica richiede che ogni step di retrieval sia valutato come sua domanda, chunk e risposta.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



