
Kursus
Graph RAG dengan LangChain dan Neo4j
3 jam
2.3K
Sebuah pipeline retrieval-augmented generation (RAG) untuk chatbot lolos semua smoke test di notebook. Lalu tiket dukungan mulai berdatangan tentang jawaban yang salah atau aneh, dan tidak ada satu pun yang tampak mencurigakan di log smoke test.
Kegagalan ini sulit ditangkap karena tidak terlihat tanpa metrik. Pipeline RAG punya 2 titik rawan: retriever dapat mengambil potongan yang salah, atau generator dapat mengabaikan potongan yang benar dan mengarang fakta. Satu angka akurasi end-to-end tidak bisa memberi tahu Anda mana yang terjadi, jadi tidak bisa memberi tahu apa yang perlu diperbaiki.
Dalam tutorial ini, saya akan membangun pipeline evaluasi RAG lengkap di Python menggunakan Ragas 0.4.3: dataset evaluasi buatan tangan, 4 metrik inti (faithfulness, answer relevancy, context precision, dan context recall), quality gate continuous integration (CI) yang menggagalkan build ketika skor turun, generator test set sintetis, dan pelacak skor JSON Lines.
Jika Anda ingin latar belakang dulu, lihat panduan kami tentang apa itu RAG, tutorial kami tentang menggunakan large language model (LLM) sebagai juri untuk mengevaluasi pipeline RAG, dan tinjauan kami tentang teknik RAG tingkat lanjut.
Anda memerlukan Python 3.9 atau lebih baru (saya memakai 3.12), uv atau pip, kunci API untuk model juri yang kompatibel dengan OpenAI, dan gambaran kasar cara kerja pipeline RAG. Jika Anda ingin fondasi itu dulu, saya rekomendasikan kursus Retrieval-Augmented Generation with LangChain kami, yang membangun jenis pipeline yang akan kita nilai.
Metrik tumpang tindih teks seperti BLEU (Bilingual Evaluation Understudy) dan ROUGE (Recall-Oriented Understudy for Gisting Evaluation) adalah penggaris yang keliru untuk RAG. Ragas memakai LLM juri untuk memberi skor tiap jawaban pada 4 sumbu: faithfulness dan answer relevancy mendiagnosis generator, sementara context precision dan context recall mendiagnosis retriever.
Taruh 4 angka itu di balik ambang batas di CI dan catat per commit, maka Anda punya alarm regresi alih-alih audit sekali jalan.
Satu peringatan sebelum mulai. API Ragas berubah dua kali dalam 2 tahun: v0.2 mengganti dataset dictionary dengan SingleTurnSample dan EvaluationDataset, dan v0.4 menjadikan metrik koleksi (diperkenalkan di v0.3.9) sebagai default dan menandai fungsi lama evaluate() sebagai deprecated.
Kebanyakan tutorial online masih menampilkan kode v0.1 atau v0.2. Semua di bawah ini berjalan di 0.4.3, yang merupakan rilis saat ini per Oktober 2026.
RAG butuh metrik tersendiri karena metrik teks klasik hanya menghitung berapa banyak kata yang dibagi sebuah jawaban dengan jawaban referensi, dan kesamaan kata bukan hal yang rusak di sistem RAG.
BLEU (Papineni dkk., 2002) dan ROUGE (Lin, 2004) dibuat untuk penerjemahan mesin dan peringkasan, di mana keluaran yang baik seharusnya menggunakan kata yang mirip dengan referensi. Jawaban RAG yang mengatakan “Anda punya 2 minggu” alih-alih “14 hari” akan mendapat skor buruk pada keduanya, sementara jawaban fasih yang mengarang kebijakan pengembalian dana bisa mendapat skor bagus jika kebetulan memakai ulang kata-kata referensi.
Masalah yang lebih dalam adalah pipeline RAG bisa gagal di 2 tempat terpisah: retriever bisa memilih informasi yang salah, atau generator bisa mengabaikan informasi yang benar dan mengarang fakta. Ketika sebuah jawaban salah, Anda perlu tahu mana dari ini yang terjadi:
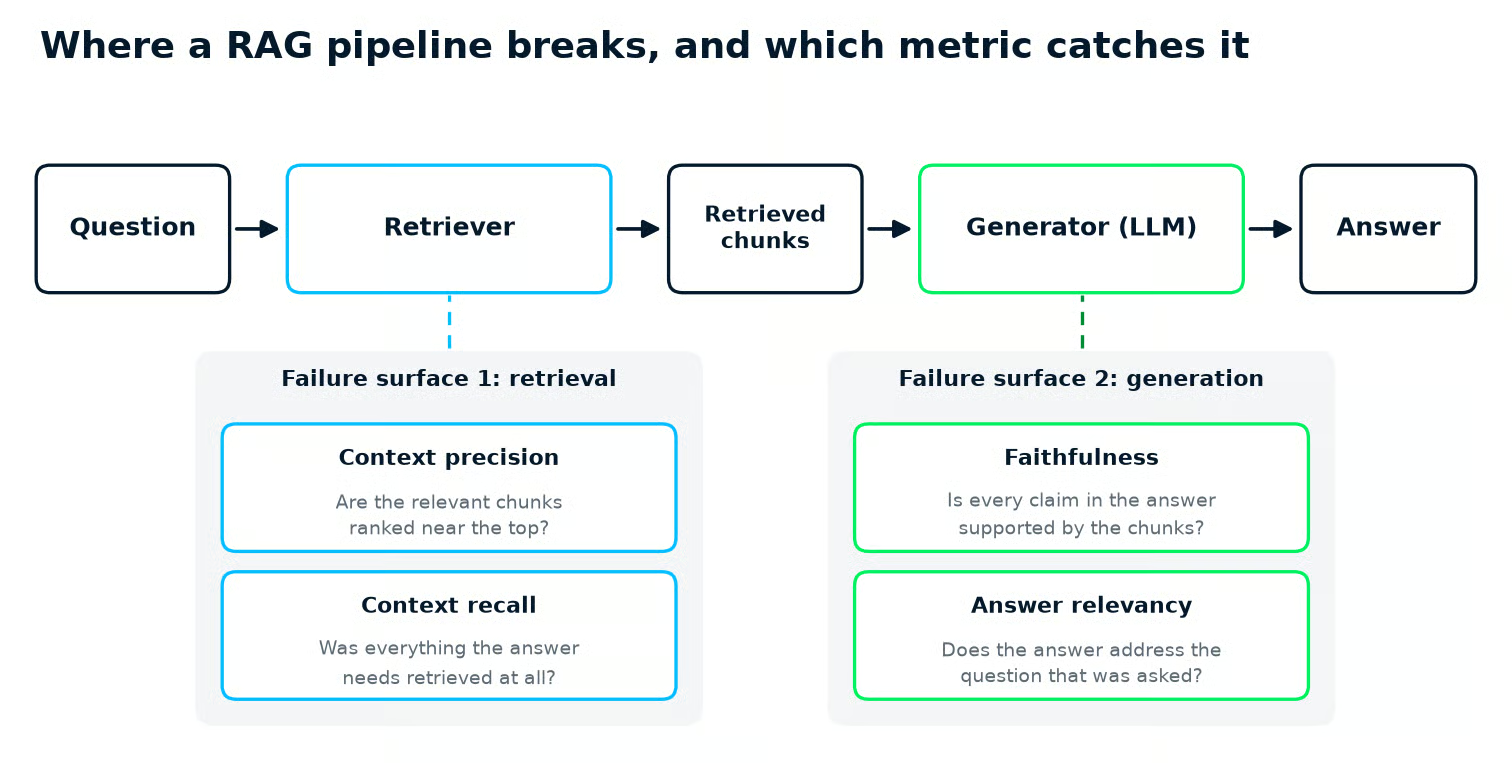
Dua mode kegagalan pipeline RAG: context precision dan recall mendiagnosis retriever, sementara faithfulness dan answer relevancy mendiagnosis generator. Gambar oleh penulis.
Panduan Lengkap Apa itu Retrieval Augmented Generation (RAG)? kami mengulas tahapan pipeline tempat kegagalan itu berasal.
Ragas adalah kerangka kerja Python open-source yang memberi Anda angka untuk tiap bagian pipeline. Ini bukan satu-satunya opsi. Dua alternatif utama adalah DeepEval, yang membungkus evaluasi dalam test case bergaya pytest, dan Evidently, yang menambah pemeriksaan LLM sebagai kolom ekstra pada dataset dan memasukkannya ke laporan pemantauan.
| Framework | Terbaik untuk | Metrik khusus RAG bawaan | Data uji dari dokumen Anda | Gaya konfigurasi |
|---|---|---|---|---|
| Ragas | Mendiagnosis pipeline RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Objek metrik plus juri dari llm_factory() |
| DeepEval | Pengujian LLM ala unit test di CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Objek LLMTestCase, assert_test() dijalankan lewat deepeval test run |
| Evidently | Dasbor pemantauan dan drift dari waktu ke waktu | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Generasi dataset RAG di Evidently Cloud | Descriptor pada Dataset, diringkas oleh Report |
Saya memilih Ragas untuk tutorial ini karena 4 metrik intinya terbagi jelas menjadi skor retriever dan skor generator, dan karena generator test set-nya tersedia dalam paket open-source yang sama.
Jika tim Anda sudah hidup di pytest, assert_test() milik DeepEval akan terasa lebih alami. Jika yang Anda inginkan adalah dasbor kualitas trafik live, laporan Evidently membawa Anda ke sana lebih cepat.
Menyiapkan Ragas berarti menginstal paketnya, mem-pin satu dependensi, dan memilih LLM juri yang akan dipakai bersama oleh setiap metrik. Saya akan gunakan uv karena ia mengunci versi paket secara presisi, tetapi pip install dengan versi yang sama juga berfungsi.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Saya menggunakan Python 3.12 di sini. Ragas 0.4.3 menyatakan dukungan untuk Python 3.9 ke atas.
Paket rapidfuzz diperlukan oleh generator test set sintetis nanti di artikel. Ragas tidak menyatakannya sebagai dependensi, jadi saya instal di awal.
Pin langchain-community<0.4 bukan opsional saat tulisan ini dibuat. Ragas 0.4.3 mengimpor ChatVertexAI dari jalur modul yang dihapus oleh langchain-community 0.4, sehingga instalasi baru tanpa pin akan gagal saat Anda mengimpor ragas.
Berikutnya, juri. Setiap metrik berbasis LLM di Ragas melakukan 1 atau lebih panggilan ke model juri, jadi Anda membangunnya sekali dan menggunakannya di mana-mana. Saya simpan itu di modul terpisah, judge.py, dan membaca kunci dari environment agar kredensial tidak masuk ke git.
Berkas ini menunjukkan cara memanggil OpenAI langsung, atau Gemini melalui endpoint kompatibel OpenAI milik Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Ada dua detail pada berkas itu yang bisa menjebak saat pertama kali dijalankan:
llm_factory() di 0.4 perlu objek klien diberikan, dan hanya memberi nama model akan melempar error.llm_factory() dikirim langsung ke pemanggilan model, yang mana saya gunakan untuk menaikkan max_tokens di atas default 1.024.Gunakan model termurah yang menghasilkan skor stabil pada sampel yang sudah Anda cek manual, lalu pin. Untuk suite evaluasi besar volumenya cepat bertambah: faithfulness membuat 2 panggilan juri per sampel, answer relevancy membuat 3 plus 2 panggilan embedding, context precision membuat 1 per potongan yang diambil, dan context recall membuat 1.
Enam sampel di 4 metrik menghasilkan 62 permintaan dalam satu kali jalan: 50 panggilan juri plus 12 panggilan embedding. Berikut biaya 3 model juri kecil saat ini di harga daftar masing-masing vendor pada 19 Oktober 2026:
| Model juri | Input per 1M token | Output per 1M token | Sumber |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | Harga OpenAI |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Harga API Gemini |
| claude-haiku-5-5 | $0.10 (prompt hingga 100K token) | $0.50 (prompt hingga 100K token) | Harga API Claude |
Default di judge.py masih gpt-4o-mini, model OpenAI yang lebih lama dan tidak tercantum di tabel harga utama di halaman harga OpenAI. Setel variabel JUDGE_MODEL untuk beralih.
Satu catatan jika Anda ingin Claude sebagai juri: answer relevancy juga butuh model embedding, dan Anthropic tidak menyediakannya. Dokumennya menunjuk ke Voyage AI, jadi Anda akan memasangkan Claude dengan embedding dari penyedia lain.
Mem-pin lebih penting daripada pilihannya. Menukar model juri menggeser skor bahkan ketika pipeline Anda tidak berubah, yang merusak garis tren yang akan Anda bangun di bagian pelacakan.
Taruh nama model di judge.py di bawah version control dan perlakukan upgrade juri seperti perubahan breaking lainnya: reset setiap ambang batas sesuai skor juri baru.
Setiap test case di dataset disebut sampel. Satu sampel lebih dari sekadar jawaban: ia merekam satu perjalanan penuh melalui pipeline, dalam 4 kolom:
| Kolom | Isi |
|---|---|
user_input |
Pertanyaan yang diajukan pelanggan |
retrieved_contexts |
Potongan yang dikembalikan retriever untuk pertanyaan tersebut |
response |
Jawaban yang diberikan pipeline RAG |
reference |
Jawaban yang benar, ditulis oleh manusia |
Ragas menyimpan tiap sampel sebagai SingleTurnSample dan keseluruhannya sebagai EvaluationDataset. Kolom reference bersifat opsional, tetapi metrik retrieval membandingkannya, jadi saya selalu menyertakannya di set kurasi meskipun metrik tanpa referensi mengabaikannya.
Saya membangun 6 sampel untuk sebuah roaster kopi fiksi, Northwind Coffee. Setiap bagian metrik di bawah menambahkan sampel yang seharusnya ditangkap oleh metrik tersebut.
Mulai build_dataset.py dengan 3 sampel pertama: satu jawaban bersih, satu halusinasi sengaja, dan satu jawaban bersih lain yang membuat beberapa klaim sekaligus.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Setiap retrieved context adalah potongan halaman pusat bantuan Northwind, ditulis ke skrip persis seperti retriever akan memberikannya ke generator. Jalankan uv run python build_dataset.py untuk menulis eval_dataset.jsonl dan eval_questions.jsonl, dan jalankan ulang setiap kali bagian selanjutnya menambah sampel.
Menyimpan ke JSON Lines penting karena setiap skrip berikutnya (jalan metrik, gate CI) memuat eval_dataset.jsonl yang sama dengan EvaluationDataset.from_jsonl().
Dalam proyek nyata, kolom retrieved_contexts dan response berasal dari menjalankan pipeline Anda sebenarnya atas pertanyaan-pertanyaan itu, dan hanya user_input dan reference yang ditulis manual. Bagian CI menunjukkan cara mengotomatisasi langkah tersebut.
Enam sampel yang akhirnya ada di artikel ini cukup untuk mempelajari metrik, tetapi belum cukup untuk mempercayai ambang batas. Bidik sekitar 100 sampel sebelum Anda mengandalkannya; bagian pelacakan menunjukkan alasannya. Berapa banyak yang Anda butuhkan bergantung pada seketat apa use case Anda, jadi saya fokus pada campuran yang baik alih-alih angka spesifik:
Empat metrik inti Ragas adalah faithfulness dan answer relevancy untuk generator, serta context precision dan context recall untuk retriever. Semua mengembalikan skor antara 0 dan 1. Bagian yang berguna adalah apa yang tiap angka beri tahu untuk diperbaiki.
Faithfulness mengukur seberapa banyak jawaban didukung oleh potongan yang diambil. Juri membagi jawaban menjadi klaim-klaim individu, lalu memeriksa tiap klaim terhadap potongan: skor 1,0 berarti setiap klaim didukung, dan 0,0 berarti tidak ada yang didukung.
Faithfulness tidak butuh jawaban referensi, jadi Anda bisa menjalankannya pada trafik produksi live, bukan hanya set uji. Jalankan kembali kapan pun Anda mengubah prompt, model, atau seberapa banyak konteks yang dilihat model, karena perubahan itulah yang paling sering memperkenalkan halusinasi.
Cara tercepat melihatnya bekerja adalah pada satu jawaban, tanpa dataset:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Jalankan dengan uv run python quick_check.py dan ia mencetak faithfulness = 0.00, karena tidak ada klaim di respons (6 bulan, satu kantong gratis) yang didukung konteks. Di 0.4 Anda memberi skor dengan metode ascore() milik tiap metrik, yang mengembalikan hasil dengan .value sebagai skornya.
Dinilai di seluruh dataset sejauh ini, halusinasi yang ditanam di sampel 2 mendapat 0,0, sebagaimana mestinya, dan kedua sampel bersih mendapat 1,0. Hasil lengkap untuk tiap metrik ada di bagian multi-metrik di bawah.
Answer relevancy mengukur apakah jawaban benar-benar menanggapi pertanyaan. Juri membaca jawaban dan menulis 3 pertanyaan yang akan cocok dijawab oleh jawaban itu, lalu Ragas memeriksa seberapa dekat maknanya dengan pertanyaan asli, menggunakan model embedding. Jika jawaban menghindar, juri menandainya tidak tegas dan skornya 0.
Ragas menamai kelasnya AnswerRelevancy (contoh lama menyebutnya ResponseRelevancy, dan halaman dokumentasinya berjudul Response Relevancy), dan ia membutuhkan LLM juri serta model embedding.
Skor relevansi yang rendah dengan skor faithfulness yang tinggi biasanya menunjuk ke generator atau prompt: model punya konteks yang benar dan tetap berpijak padanya, tetapi menjawab pertanyaan yang berbeda dari yang diajukan. Namun periksa context precision dan recall dulu, karena retriever yang mengembalikan potongan di luar topik bisa menghasilkan pola yang sama.
Sampel ini menunjukkan kasus generator. Retriever mengembalikan potongan pengiriman yang benar, jawabannya tetap berpijak, dan ia membicarakan tanggal sangrai alih-alih biaya pengiriman. Tambahkan potongan baru ke daftar potongan di bagian atas build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Lalu tambahkan sampel baru di akhir daftar samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Tiap sampel mendapat satu skor relevansi: seberapa dekat pertanyaan yang ditulis juri dari jawaban cocok dengan pertanyaan yang sebenarnya ditanyakan oleh sampel, di mana 1,0 adalah kecocokan sempurna.
Context precision memeriksa apakah potongan yang berguna diberi peringkat di dekat puncak dari apa yang dikembalikan retriever, dan context recall memeriksa apakah retriever menemukan semua yang dibutuhkan untuk menulis jawaban yang benar.
Precision memberi kredit lebih besar pada potongan berguna yang peringkatnya lebih tinggi, jadi potongan berguna di posisi pertama dihitung lebih besar daripada potongan yang sama di posisi ketiga. Recall adalah porsi fakta dalam jawaban referensi yang didukung oleh setidaknya satu potongan yang diambil.
Keduanya butuh kolom reference. Di API koleksi, kelasnya adalah ContextPrecisionWithReference dan ContextRecall, dan keduanya hanya menerima LLM juri. Dokumentasi Ragas juga menggunakan nama yang lebih pendek ContextPrecision untuk versi berbasis referensi, jadi Anda mungkin melihat salah satunya.
Sejauh ini setiap sampel mengambil potongan yang benar terlebih dahulu, jadi belum ada yang perlu ditangkap oleh metrik ini. Mari tambahkan 2 sampel yang merusak retrieval dengan cara berbeda: satu di mana potongan yang benar diambil tetapi diberi peringkat terakhir, dan satu di mana tidak ada yang relevan diambil sama sekali, sehingga model menolak dengan benar. Seperti sebelumnya, tambahkan potongan di bagian atas berkas:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Kemudian tambahkan sampel pada akhir daftar:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Peringkat itu penting karena kebanyakan pipeline hanya meneruskan beberapa potongan teratas ke model, jadi potongan berguna di posisi ke-6 dari retriever top-5 sama saja tidak ada.
Sampel 5 menaruh satu potongan bergunanya paling akhir dari 3, dan precision kembali 0,333 karena satu-satunya informasi berguna diperingkat terakhir. Sampel 6, miss retrieval, mendapat 0,0 pada precision dan recall.
Sampel 6 juga mengajarkan sesuatu tentang faithfulness. Model menolak dengan benar, namun penolakan itu mendapat 1,0 pada faithfulness di beberapa run dan 0,0 di run lain, tanpa ada yang berubah di antaranya. Pernyataan seperti “Saya tidak memiliki informasi tentang garansi” tidak didukung atau disangkal oleh konteks, dan juri melempar koin.
Jika pipeline Anda seharusnya menolak, nilai penolakan secara terpisah daripada membiarkannya menyeret faithfulness. Ragas 0.4 menghapus AspectCritic dari API koleksi, jadi penggantinya adalah pemeriksaan kustom dengan dekorator @discrete_metric (lihat panduan migrasi v0.3 ke v0.4).
Baca 2 angka retrieval bersama-sama dan keduanya memberi tahu di mana Anda menghabiskan minggu depan:
| Context precision | Context recall | Diagnosis | Apa yang diubah |
|---|---|---|---|
| Tinggi | Tinggi | Retrieval sehat | Fokus pada generator: prompt, model, faithfulness |
| Rendah | Tinggi | Potongan yang benar diambil tetapi peringkatnya buruk | Tambah atau sesuaikan reranker |
| Tinggi | Rendah | Potongan teratas relevan tetapi tidak lengkap | Teruskan lebih banyak potongan ke model, gunakan potongan lebih besar, atau periksa cara pemotongan |
| Rendah | Rendah | Retriever gagal secara umum | Tinjau embedding, pengindeksan, dan penulisan ulang kueri |
Baris “precision rendah, recall tinggi” adalah yang paling sering saya lihat di praktik, dan paling murah diperbaiki.
Tutorial RankGPT sebagai Agen Re-Ranking untuk RAG kami menambahkan LLM reranker di atas retriever yang ada, dan tutorial Tingkatkan Akurasi LLM dengan RAG dan Reranking menunjukkan pengaturan reranking lain. Panduan 5 teknik kunci untuk meningkatkan performa RAG membahas chunking dan penulisan ulang kueri untuk baris lainnya.
Jalankan ulang 2 metrik retrieval setelah tiap perubahan dan tabel akan memberi tahu apakah berhasil.
Evaluasi multi-metrik lengkap menjalankan keempat metrik pada setiap sampel secara paralel dan mengumpulkan skor, dengan nilai per baris untuk menelusuri kegagalan dan rata-rata kolom untuk dasbor Anda.
Di Ragas 0.2 dan 0.3 Anda melakukannya dengan evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). Di 0.4.3 fungsi itu masih ada, tetapi memperingatkan sudah deprecated dan menolak metrik baru secara langsung, karena mereka tidak lagi mewarisi kelas Metric lama yang diharapkan.
Penggantinya adalah @experiment decorator, yang menjalankan pipeline dan metrik Anda bersama-sama atas Dataset dan menulis hasil ke CSV. Itu alat yang tepat begitu Anda punya pipeline untuk dipanggil.
Untuk memberi skor dataset statis, saya merasa helper kecil lebih jelas: ia membangun 4 metrik sekali untuk setiap skrip yang memerlukannya, dan ia menyimpan pemanggilan paralel serta penanganan error dalam kode yang bisa saya baca:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Satu baris yang tidak langsung terlihat adalah pemanggilan inspect.signature(). Keempat metrik menginginkan input berbeda (faithfulness butuh response, recall butuh reference), jadi helper membaca argumen yang diterima ascore() tiap metrik dan meneruskan persis kolom itu dari sampel, yang memungkinkan satu loop melayani semua metrik.
Semaphore membatasi berapa banyak panggilan juri yang berjalan sekaligus, dan metrik yang tetap gagal menjadi sel kosong (NaN) alih-alih menggagalkan seluruh run. Jika Anda menjalankan ini di Jupyter, asyncio.run gagal karena loop sudah berjalan. Panggil nest_asyncio.apply() dulu (Ragas sudah bergantung padanya) atau await korutin secara langsung.
Dengan helper siap, seluruh run menjadi singkat:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Berikut skor dari run pertama saya, diurutkan menurut faithfulness dan dibulatkan ke 3 desimal, dengan mean di baris terakhir:
| Pertanyaan | Faithfulness | Answer relevancy | Context precision | Context recall |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Run berikutnya dari dataset yang sama memberi skor faithfulness lebih rendah karena flip sampel penolakan yang saya bahas di bagian pelacakan.
Mengurutkan menurut faithfulness membantu Anda menyorot halusinasi paling mungkin, dan yang ditanam ada di puncak. Mean di baris terakhir adalah angka dasbor Anda.
Baca melintang baris dan tiap kegagalan yang ditanam muncul di tempat berbeda. Halusinasi hanya menjatuhkan faithfulness. Miss retrieval men-nol-kan relevansi, precision, dan recall bersama-sama. Masalah peringkat memotong precision ke 0,333, dan drift muncul sebagai relevansi terendah di antara pertanyaan yang dijawab.
Satu keanehan: jawaban Kanada sepenuhnya didukung oleh potongannya, namun ia mendapat 0,667 pada faithfulness. Itu noise juri, yang saya bahas kembali di bagian pelacakan.
Answer relevancy membandingkan makna dengan embedding, jadi bahkan jawaban bagus jarang mendekati 1,0: jawaban refund mendapat 0,746, sementara jawaban pengiriman yang off-topic mendapat 0,572. Nilailah relevansi dari selisih antarsampel dan tren dari waktu ke waktu, bukan dari angka absolut.
Quality gate RAG adalah skrip uji yang menjalankan evaluasi, membandingkan setiap skor rata-rata dengan ambang batas, dan keluar dengan kode error ketika ada metrik yang kurang, yang memberi tahu sistem CI untuk memblokir merge.
Satu catatan dulu. Dataset buatan tangan sebelumnya menuliskan respons dan potongan yang diambil secara manual, jadi penilaiannya tidak pernah mencerminkan perubahan pada prompt atau retriever Anda. Di CI Anda perlu menjalankan ulang pipeline nyata atas pertanyaan yang disimpan dan kemudian menilai apa yang dihasilkannya. Dua skrip kecil melakukan itu.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py adalah satu-satunya berkas yang Anda tulis sendiri: ganti isi answer() dengan panggilan ke retriever dan generator Anda. refresh_dataset.py membaca pertanyaan dan jawaban referensi yang disimpan oleh build_dataset.py, menjalankan pipeline atas tiap pertanyaan, dan menulis ulang eval_dataset.jsonl.
Gate itu sendiri adalah kamus ambang batas dan sebuah loop. Ambang di bawah ini dikalibrasi pada dataset contoh buatan tangan, jadi kalibrasikan ulang pada keluaran pipeline Anda sendiri sebelum mengandalkannya.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
Terhadap baseline saya, semua 4 mean melampaui ambang, dan skrip keluar dengan kode 0, yang memungkinkan merge lolos:
| Metrik | Mean | Ambang | Hasil |
|---|---|---|---|
| Faithfulness | 0.778 | 0.60 | Lulus |
| Answer relevancy | 0.668 | 0.60 | Lulus |
| Context precision | 0.722 | 0.65 | Lulus |
| Context recall | 0.833 | 0.75 | Lulus |
Saya menetapkan ambang faithfulness 0,60 alih-alih 0,70 karena noise juri yang saya bahas di bagian pelacakan. Dengan 6 sampel, satu vonis fluktuatif menggeser mean sebesar 0,17, dan run berikutnya dari pipeline yang tak berubah memberi skor 0,61. Gate juga menjalankan juri 3 kali dan merata-ratakan skor (GATE_RUNS), yang menghaluskan flip vonis tunggal dengan biaya juri 3 kali.
Satu pilihan desain adalah gagal pada not (actual >= threshold) alih-alih actual < threshold. Perbandingan terhadap NaN (“not a number”) selalu False, jadi pemeriksaan yang ditulis sebagai actual < threshold akan meloloskan build kapan pun juri gagal.
skipna=False pada mean menutup kasus parsial. Secara default pandas melewati NaN, jadi beberapa panggilan juri yang gagal diam-diam akan mengecilkan sampel alih-alih menggagalkan gate. Error juri sementara sekarang menggagalkan build, jadi jalankan ulang job sebelum Anda debug.
Ambang sulit disetel. Tetapkan sedikit di bawah mean terendah yang Anda lihat di run berulang, bukan pada angka ambisius 0,9, atau gate akan memblokir setiap pull request dan tim berhenti mempercayai CI. Reset kapan pun Anda mengganti model juri atau menambah lebih dari segelintir sampel.
Menghubungkannya ke GitHub Actions adalah workflow singkat. Referensi sintaks workflow membahas filter path on.pull_request dan cron schedule yang digunakan di sini:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Ada beberapa detail penting di workflow itu:
JUDGE_MODEL dan kunci API yang cocok. Gunakan juri yang sama dengan yang Anda gunakan untuk mengalibrasi ambang, atau skor CI tidak akan sebanding dengan riwayat yang Anda lacak.GATE_SAMPLE memberi skor subset acak tetap 30 baris, jadi tinjauan tidak menunggu 10 menit pada panggilan juri. Cron malam menilai semuanya.scores.csv dan ragas_history.jsonl sebagai artefak, karena disk runner hilang ketika job berakhir.Jalankan suite penuh pada cron malam, saat tidak ada yang menunggu. Run malam yang gagal muncul sebagai workflow gagal, dan pengaturan notifikasi GitHub atau langkah Slack dapat memberi tahu pemiliknya pagi hari. GitLab CI punya bentuk yang sama dengan rules: changes: dan jadwal pipeline.
Ragas menghasilkan pertanyaan uji sintetis dengan membaca dokumen Anda, mengekstrak topik dan fakta utama, mengaitkan potongan yang terkait, lalu menulis pertanyaan berbagai jenis dari kaitan tersebut.
Dokumentasi generasi data uji membagi kueri menjadi single-hop (satu potongan bisa menjawab) dan multi-hop (jawaban butuh beberapa potongan), dan masing-masing bisa spesifik atau abstrak. Campuran default menggunakan 3 dari 4 kombinasi dalam porsi yang sama:
Ragas hanya memakai penyintesis yang bisa didukung dokumen Anda, jadi set dokumen kecil bisa menghasilkan campuran berbeda.
Generator butuh dokumen nyata untuk dibaca. Arahkan ke dokumentasi Anda sendiri sebagai berkas markdown. Untuk artikel ini, saya menulis 5 halaman pusat bantuan pendek untuk Northwind (sekitar 600 kata total), dan tiap halaman terlihat seperti ini:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Dokumen Anda sendiri akan menghasilkan pertanyaan berbeda dari yang di bawah ini, itulah tujuannya: generator menulis pertanyaan tentang apa pun yang benar-benar ada di basis pengetahuan Anda.
TestsetGenerator memakai LLM juri dan model embedding yang sama yang sudah kita bangun. Saya memuat dokumen dengan DirectoryLoader milik LangChain, memakai TextLoader secara eksplisit agar berkas markdown tidak menarik dependensi berat unstructured.
Memetakan dokumen Anda memicu banyak panggilan juri sekaligus, jadi saya juga membatasi berapa banyak yang berjalan paralel dengan RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Skrip memuat semua 5 dokumen dan menulis 8 pertanyaan ini. Pertanyaannya mengikuti dokumen, dan beberapa berisi salah ketik yang disengaja:
| # | Pertanyaan yang dihasilkan | Jenis pertanyaan |
|---|---|---|
| 1 | how do i brew with a french pres | Single-hop |
| 2 | Northwind equipment warranty | Single-hop |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Single-hop |
| 4 | how do I cancel Nortwind subscription? | Single-hop |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Multi-hop |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Multi-hop |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Multi-hop |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Multi-hop |
Tabel menampilkan label yang disederhanakan; kolom synthesizer_name di output memuat nama penyintesis lengkap. Delapan pertanyaan dari 5 dokumen memakan waktu sekitar 4,5 menit.
Typo dan kueri bergaya kata kunci pada pertanyaan 2 disengaja: generator memvariasikan gaya dan panjang tiap kueri agar set terlihat seperti trafik kotak pencarian, bukan soal ujian.
Anda mungkin ingin meninjau pertanyaan untuk memastikan bisa dipakai dan relevan. Saya akan gunakan output sebagai draf pertama. Di setiap set sintetis yang saya tinjau, beberapa pertanyaan cacat (merujuk “dokumen” atau menanyakan tentang heading), beberapa jawaban referensi melenceng dari apa yang sebenarnya dikatakan sumber, dan redaksinya lebih formal dari pengguna nyata mana pun.
Jalankan ulang generator saat Anda menambah bagian pada dokumen dan Anda mendapatkan kandidat pertanyaan untuk materi baru, dengan biaya satu putaran panggilan juri lagi.
Tiap baris memiliki user_input, jawaban reference yang dihasilkan, dan reference_contexts, potongan yang menjadi dasar pertanyaan dibuat. Periksa reference terhadap potongan tersebut, karena di situlah drift muncul.
Untuk mengubah baris yang telah ditinjau menjadi SingleTurnSample, jalankan pipeline Anda atas user_input untuk mendapatkan retrieved_contexts dan response. Tambahkan pasangan user_input dan reference yang telah ditinjau ke eval_questions.jsonl dan refresh_dataset.py akan melakukannya untuk Anda.
Jika basis pengetahuan Anda berupa grafik alih-alih tumpukan dokumen, prinsip yang sama berlaku dengan retriever berbeda. Tutorial Menggunakan Knowledge Graph untuk Mengimplementasikan Aplikasi RAG kami dan kursus Graph RAG with LangChain and Neo4j kami sama-sama menghasilkan pipeline yang dapat Anda nilai dengan 4 metrik di atas, karena metrik hanya melihat teks yang diambil, bukan bagaimana ia diambil.
Melacak skor Ragas dari waktu ke waktu berarti menambahkan skor rata-rata, hash commit git, model juri, dan stempel waktu ke berkas log setelah setiap run evaluasi, sehingga regresi muncul sebagai penurunan pada grafik garis alih-alih kejutan di produksi.
Berkas JSON Lines mungkin pilihan terbaik sampai Anda butuh pelacak eksperimen bersama untuk beberapa orang. track_scores.py membaca scores.csv, yang ditulis oleh quality_gate.py dan run_all.py, jadi tidak pernah memicu putaran panggilan juri kedua.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Menjalankan uv run python track_scores.py menambahkan satu baris ke log dan mencetaknya:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
Di CI setiap job dimulai dengan disk kosong, jadi ragas_history.jsonl hanya pernah memuat catatan run tersebut. Untuk menjaga tren, unduh artefak yang diunggah dan gabungkan ke satu berkas, atau commit berkas ke branch metrik atau object storage.
Memplot riwayat cukup mudah dilakukan. Coba skrip berikut:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Anda akan mendapatkan grafik yang terlihat seperti ini:
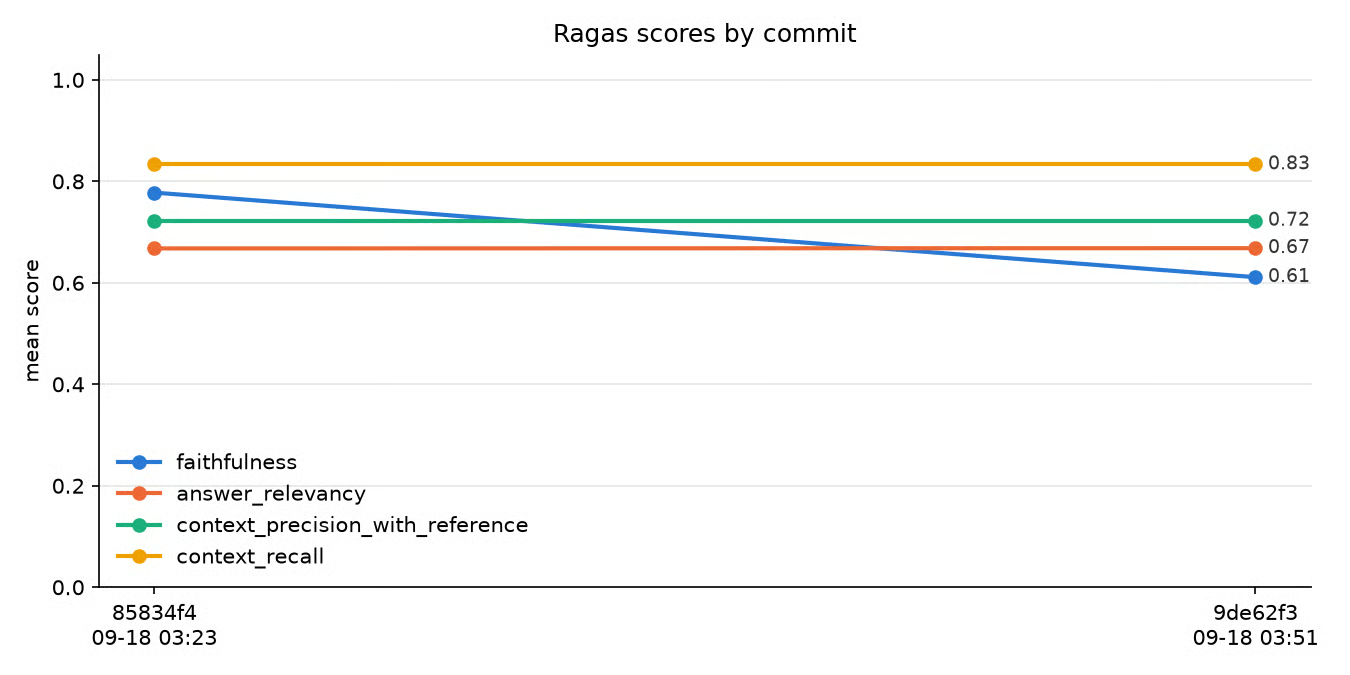
Skor rata-rata Ragas yang dicatat per commit oleh track_scores.py. Gambar oleh penulis.
Tidak ada yang berubah di pipeline antara commit tersebut (yang kedua hanya mengubah pengaturan koneksi klien juri), namun faithfulness turun dari 0,78 ke 0,61 karena penolakan di sampel 6 berubah dari 1,0 ke 0,0.
Jadi ada noise juri nyata yang perlu diawasi sampai Anda punya jumlah sampel yang besar. Dengan 6 sampel, 1 vonis fluktuatif menggeser mean sebesar 0,17. Dengan 100 sampel, flip yang sama menggeser 0,01, sehingga perubahan besar jauh lebih mungkin merupakan regresi nyata.
Sekarang, pada setiap pull request atau commit, Anda bisa menjalankan gate, mencatat skor, dan melihat grafiknya.
Jika Anda menimbang perubahan arsitektural yang lebih besar, tutorial RAG vs. fine-tuning kami membingkai pertukarannya, dan 4 metrik yang sama bekerja sebagai pengukuran sebelum-dan-sesudah untuk kedua jalur.
Skor LLM-sebagai-juri adalah estimasi: punya bias yang diketahui dan bisa berubah dari run ke run, tetapi dapat diskalakan ke volume evaluasi yang tidak mungkin dilakukan tinjauan manusia.
Ragas tidak pernah meminta juri membandingkan 2 jawaban, jadi bias posisi (memihak jawaban yang datang duluan) sebagian besar tidak berlaku. Bias verbositas (memihak jawaban lebih panjang) dan bias preferensi diri (juri memihak jawaban dari modelnya sendiri) masih bisa berpengaruh. Zheng dkk. (2023) menjelaskan ketiga bias tersebut, dan preferensi diri adalah alasan saya tidak akan memakai model yang sama sebagai generator dan juri.
Variasi antar-run adalah bagian yang ingin saya Anda lihat sendiri, karena itu mengubah cara Anda menetapkan ambang. Di berbagai run dari 6 sampel yang sama dengan juri yang dipin sama, jawaban penolakan di sampel 6 mendapat 0,0 di satu run dan 1,0 di run lain pada faithfulness, dan sampel 5 yang sepenuhnya berpijak mendapat 0,667 di run yang ditampilkan di atas.
Skor per sampel dari juri murah itu berisik. Rata-rata atas 100 sampel jauh lebih tidak berisik, dan gate CI seharusnya selalu menguji mean.
Tiga praktik membatasi noise:
judge.py dan track_scores.py di atas, sehingga perubahan juri tidak pernah disalahartikan sebagai perubahan pipeline.Untuk tur yang lebih luas tentang pendekatan evaluasi di luar RAG, termasuk metode evaluasi manusia yang digantikan juri, panduan evaluasi LLM kami membahas metrik dan metodologinya. Tutorial LLM sebagai juri kami membahas lebih dalam pembangunan juri untuk pipeline RAG.
Tujuan pipeline ini adalah agar kita bisa mengatakan hal seperti “retriever baik-baik saja, prompt yang menurun” atau “reranker memperbaiki precision tetapi recall masih 0,6”, dengan angka yang mendasari klaim.
Faithfulness dan answer relevancy mengawasi generator: faithfulness menangkap fakta yang dikarang, dan answer relevancy menangkap jawaban yang melenceng dari pertanyaan. Context precision dan recall mengawasi retriever dan memberi tahu apakah ia menarik informasi yang tepat. Karena 2 dari 4 tidak butuh jawaban referensi, Anda bisa menjalankannya pada trafik produksi di mana tidak ada referensi.
Metrik teks standar mengukur tumpang tindih kata, yang tidak mengatakan apa-apa tentang kebijakan pengembalian dana yang dikarang, dan satu angka end-to-end menyembunyikan bagian mana dari setengah pipeline yang rusak. Kerangka kerja yang memeriksa 2 titik kegagalan secara terpisah bisa melihatnya, dan mengubahnya dari audit sekali jalan menjadi gate CI dengan berkas riwayat itulah yang membuat tim Anda bertindak berdasarkan angka.
Jika Anda belum membangun pipeline, mulai dengan kursus Retrieval-Augmented Generation with LangChain kami lalu arahkan pipeline.py di artikel ini ke apa yang Anda bangun.
Untuk pipeline yang melampaui retrieval teks polos, kursus End-to-End RAG with Weaviate kami, panduan RAG multimodal, dan tutorial agentic RAG kami membangun sistem yang bisa Anda nilai dengan cara yang sama, dengan satu catatan: 4 metrik inti hanya membaca teks. Pipeline yang mengambil gambar membutuhkan metrik multimodal terpisah dari Ragas, dan pipeline agentic perlu tiap langkah retrieval dinilai sebagai pertanyaan, potongan, dan jawaban tersendiri.
Kursus Teratas DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



