Курс
Graph RAG с LangChain и Neo4j
3 ч
2.3K
Конвейер генерации с дополнением извлечением (RAG) для чат-бота проходит все смоук-тесты в ноутбуке. Затем начинают приходить тикеты в поддержку о неверных или странных ответах, а логи смоук-тестов не показывают ничего подозрительного.
Такой сбой сложно поймать, потому что без метрик он невидим. В конвейере RAG есть 2 места, где можно ошибиться: извлекатель может принести не те фрагменты, а генератор — проигнорировать хорошие фрагменты и выдумать факты. Один сквозной показатель точности не скажет, что именно произошло, а значит, не подскажет, что исправлять.
В этом туториале мы построим полноценный конвейер оценки RAG на Python с использованием Ragas 0.4.3: вручную собранный датасет для оценки, 4 ключевые метрики (достоверность, релевантность ответа, точность контекста и полнота контекста), качественный порог в CI, который ломает сборку при падении оценок, генератор синтетического тестового набора и трекер оценок в формате JSON Lines.
Если нужна теоретическая база, смотрите наш обзор что такое RAG, наш туториал об использовании крупной языковой модели (LLM) в роли судьи для оценки конвейеров RAG и наш обзор продвинутых техник RAG.
Вам понадобится Python 3.9 или новее (здесь используется 3.12), uv или pip, API-ключ для модели-судьи, совместимой с OpenAI, и общее понимание того, как работает конвейер RAG. Если сначала нужна база, рекомендуем наш курс Retrieval-Augmented Generation with LangChain, в котором строится конвейер того типа, который мы будем оценивать.
Метрики пересечения текста, такие как BLEU (Bilingual Evaluation Understudy) и ROUGE (Recall-Oriented Understudy for Gisting Evaluation), — неподходящая линейка для RAG. Ragas вместо этого использует LLM-судью, чтобы оценивать каждый ответ по 4 осям: достоверность и релевантность ответа диагностируют генератор, а точность контекста и полнота контекста — извлекатель.
Поместите эти 4 числа за порог в CI и логируйте их на каждый коммит — и у вас будет сигнал регрессии вместо разовой проверки.
Одно предупреждение перед началом. API Ragas менялся дважды за 2 года: v0.2 заменил датасеты-словари на SingleTurnSample и EvaluationDataset, а v0.4 сделал коллекционные метрики (введённые в v0.3.9) значением по умолчанию и пометил старую функцию evaluate() как устаревшую.
Большинство туториалов в сети всё ещё показывают код для v0.1 или v0.2. Всё ниже работает на 0.4.3, актуальной версии на октябрь 2026.
RAG нужны собственные метрики, потому что классические текстовые метрики считают, сколько слов ответа совпадает с эталонным ответом, а общая формулировка — не то, что ломается в системе RAG.
BLEU (Papineni и др., 2002) и ROUGE (Lin, 2004) создавались для машинного перевода и суммаризации, где хороший результат должен использовать примерно те же слова, что и эталон. Ответ RAG «у вас есть 2 недели» вместо «14 дней» на обеих метриках получит низкую оценку, тогда как беглый, но выдуманный ответ о политике возвратов может получить высокую, если случайно переиспользует слова из эталона.
Глубже проблема в том, что конвейер RAG может падать в двух местах: извлекатель выбирает не ту информацию, или генератор игнорирует правильную информацию и выдумывает факты. Когда ответ неверен, важно понять, что именно произошло:
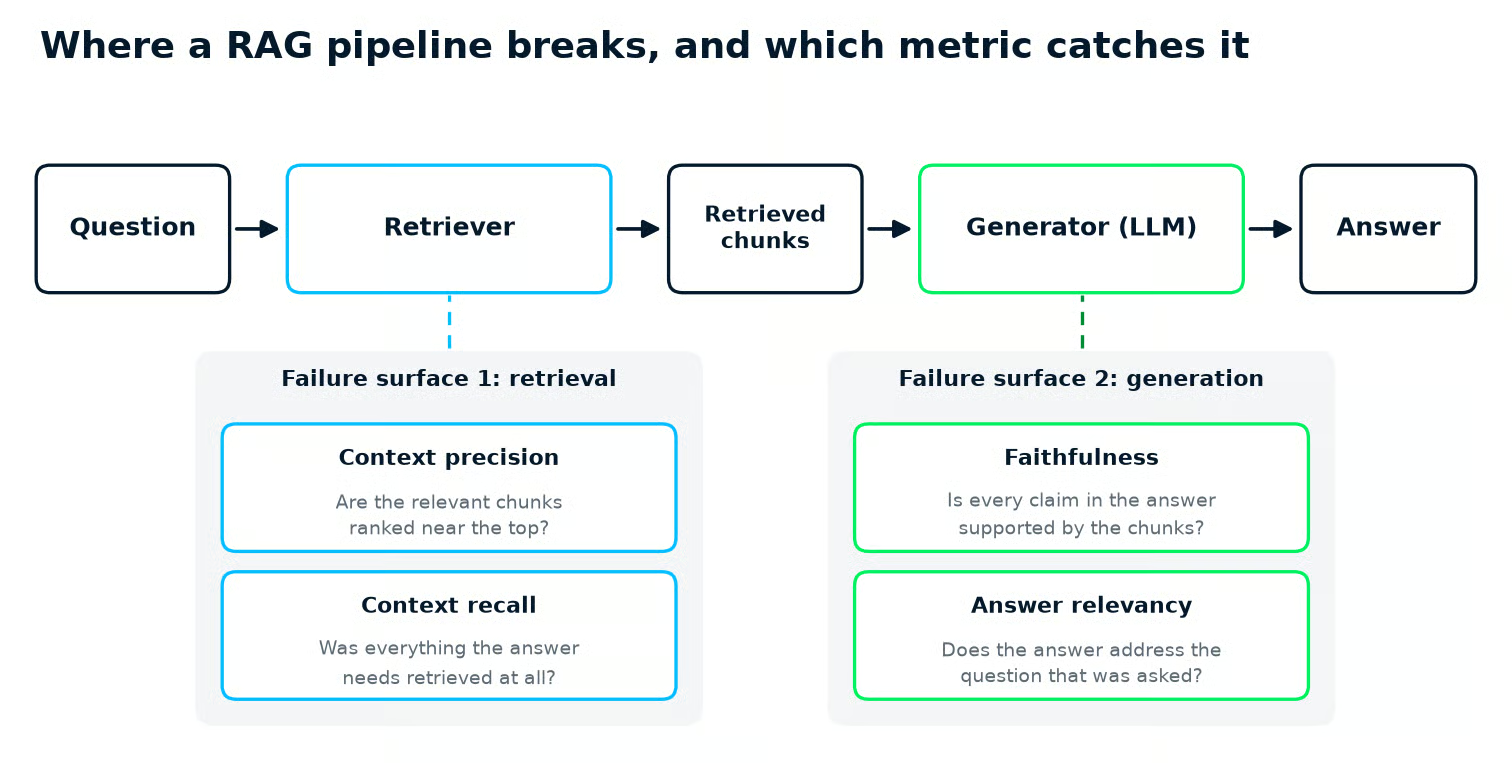
Два режима отказа конвейера RAG: точность и полнота контекста диагностируют извлекатель, а достоверность и релевантность ответа — генератор. Изображение автора.
В нашем руководстве What Is Retrieval Augmented Generation (RAG)? A Complete Guide показаны стадии конвейера, где берут начало эти сбои.
Ragas — это open-source фреймворк на Python, который даёт число для каждой части конвейера. Это не единственный вариант. Два основных альтернативных подхода — DeepEval, который оборачивает оценку в pytest-подобные тест-кейсы, и Evidently, который добавляет LLM-проверки как дополнительные колонки в датасет и подаёт их в мониторинговые отчёты.
| Фреймворк | Сильная сторона | Встроенные RAG-метрики | Тестовые данные из ваших документов | Стиль конфигурации |
|---|---|---|---|---|
| Ragas | Диагностика конвейеров RAG | Faithfulness, answer relevancy, context precision, context recall, context entities recall, noise sensitivity | TestsetGenerator (open source) |
Объекты метрик плюс судья из llm_factory() |
| DeepEval | LLM-тестирование в стиле юнит-тестов в CI | Answer relevancy, faithfulness, contextual relevancy, contextual recall, contextual precision | Synthesizer (open source) |
Объекты LLMTestCase, запуск assert_test() через deepeval test run |
| Evidently | Дашборды мониторинга и дрейф со временем | FaithfulnessLLMEval, ContextRelevance, ContextQualityLLMEval | Генерация RAG-датасета в Evidently Cloud | Дескрипторы на Dataset, суммируются в Report |
Для этого туториала выбран Ragas, потому что его 4 ключевые метрики чётко разделяются на оценки извлекателя и генератора, а генератор тестовых наборов поставляется в том же open-source пакете.
Если ваша команда живёт в pytest, assert_test() из DeepEval будет привычнее. Если вам нужен дашборд качества живого трафика, отчёты Evidently помогут быстрее.
Настройка Ragas — это установка пакета, пин одного зависимого пакета и выбор LLM-судьи, общий для всех метрик. Мы будем использовать uv, потому что он фиксирует точные версии пакетов, но pip install с теми же версиями тоже подойдёт.
uv init rag-eval --python 3.12 && cd rag-eval
uv add "ragas==0.4.3" "langchain-community<0.4" openai pandas matplotlib rapidfuzz
Здесь используется Python 3.12. Ragas 0.4.3 заявляет поддержку Python 3.9 и новее.
Пакет rapidfuzz нужен для генератора синтетического тестового набора дальше в статье. Ragas не объявляет его зависимостью, поэтому мы устанавливаем его заранее.
Пин langchain-community<0.4 пока обязателен. Ragas 0.4.3 импортирует ChatVertexAI из пути модуля, который был удалён в langchain-community 0.4, поэтому «свежая» установка без пина упадёт при импорте ragas.
Теперь — судья. Каждая LLM-метрика в Ragas делает один или несколько вызовов к модели-судье, поэтому судью создаём один раз и передаём везде. Я держу это в отдельном модуле judge.py и читаю ключ из окружения, чтобы учётные данные не попали в git.
Этот файл показывает, как вызывать OpenAI напрямую или Gemini через совместимую с OpenAI конечную точку от Google.
# judge.py
"""Build the judge LLM and embedding model that every metric shares.

Uses OpenAI by default (reads OPENAI_API_KEY). Set GEMINI_API_KEY instead to
judge with Gemini through Google's OpenAI-compatible endpoint.
"""

import os

from openai import AsyncOpenAI
from ragas.embeddings import embedding_factory
from ragas.llms import llm_factory

GEMINI_BASE_URL = "https://generativelanguage.googleapis.com/v1beta/openai/"


def judge_model_name() -> str:
    """The judge model to use (override it with the JUDGE_MODEL variable)."""
    default = "gemini-3.5-flash-lite" if os.environ.get("GEMINI_API_KEY") else "gpt-4o-mini"
    return os.environ.get("JUDGE_MODEL", default)


def build_judge():
    """Return (llm, embeddings), both using one OpenAI-compatible client."""
    if os.environ.get("GEMINI_API_KEY"):
        client = AsyncOpenAI(
            api_key=os.environ["GEMINI_API_KEY"],
            base_url=GEMINI_BASE_URL,
            max_retries=5,
        )
        embedding_model = "gemini-embedding-001"
        # Gemini 3.x models spend output tokens thinking before they answer
        settings = {"max_tokens": 4096, "reasoning_effort": "low"}
    else:
        client = AsyncOpenAI(max_retries=5)
        embedding_model = "text-embedding-3-small"
        settings = {"max_tokens": 4096}

    llm = llm_factory(judge_model_name(), client=client, **settings)
    embeddings = embedding_factory("openai", model=embedding_model, client=client)
    return llm, embeddings
Две детали в этом файле могут помешать первому запуску:
llm_factory() требует передать объект клиента; передача только имени модели вызовет ошибку.llm_factory(), уходят прямо в вызов модели — так мы поднимаем max_tokens выше значения по умолчанию 1 024.Выберите самую дешёвую модель, которая даёт стабильные оценки на примере, который вы проверили вручную, и зафиксируйте её. При большом наборе оценка быстро становится дорогой: достоверность делает 2 вызова судьи на сэмпл, релевантность ответа — 3 плюс 2 вызова эмбеддингов, точность контекста — по 1 на каждый извлечённый фрагмент, полнота контекста — 1.
Шесть сэмплов на 4 метриках дали 62 запроса за один прогон: 50 вызовов судьи плюс 12 вызовов эмбеддингов. Вот сколько стоят 3 актуальные небольшие модели-судьи по прайс‑листам на 19 октября 2026:
| Модель-судья | Вход на 1 млн токенов | Выход на 1 млн токенов | Источник |
|---|---|---|---|
| gpt-6-luna | $0.10 | $0.50 | Цены OpenAI |
| gemini-3.5-flash-lite | $0.30 | $2.50 | Цены Gemini API |
| claude-haiku-5-5 | $0.10 (промпты до 100K токенов) | $0.50 (промпты до 100K токенов) | Цены Claude API |
Значение по умолчанию в judge.py — gpt-4o-mini, более старая модель OpenAI, которая не перечислена в основной таблице цен на странице OpenAI. Установите переменную JUDGE_MODEL, чтобы переключить модель.
Одна оговорка, если вы хотите использовать Claude в роли судьи: релевантности ответа также нужен эмбеддинг‑модель, а Anthropic её не предоставляет. В их документации указывают Voyage AI, так что Claude придётся сочетать с эмбеддингами другого провайдера.
Важно не столько какая модель, сколько то, что она закреплена. Смена модели-судьи сдвигает оценки даже при неизменном конвейере, разрушая тренд, который вы собираетесь строить в разделе трекинга.
Зафиксируйте имя модели в judge.py под контролем версий и относитесь к обновлению судьи как к ломающему изменению: переснимайте все пороги относительно оценок новой модели.
Каждый тест-кейс в датасете называется сэмплом. Сэмпл — это больше, чем ответ: он фиксирует полный проход по конвейеру в 4 полях:
| Поле | Что хранит |
|---|---|
user_input |
Вопрос, который задал клиент |
retrieved_contexts |
Фрагменты, которые извлекатель вернул для этого вопроса |
response |
Ответ, который дал конвейер RAG |
reference |
Правильный ответ, написанный человеком |
Ragas хранит каждый сэмпл как SingleTurnSample, а весь набор — как EvaluationDataset. Поле reference опционально, но метрики извлечения сравниваются с ним, так что в кураторском наборе я всегда его включаю, даже если метрики без эталона его игнорируют.
Я собрал 6 сэмплов для вымышленной обжарки Northwind Coffee. Каждый раздел про метрики ниже добавляет сэмпл, который эта метрика должна поймать.
Начните build_dataset.py с первых 3 сэмплов: чистый ответ, преднамеренная галлюцинация и второй чистый ответ, который делает несколько утверждений сразу.
# build_dataset.py
"""Hand-build a small evaluation set and save it as JSON Lines."""

import json

from ragas import EvaluationDataset, SingleTurnSample

# Chunks of Northwind's help-center pages, exactly as a retriever would
# return them to the generator.
REFUNDS = (
    "If you are not happy with your coffee, contact support within 14 days of "
    "the delivery date for a full refund. You do not need to return the bag."
)
REFUND_TIMING = (
    "Refunds are issued to the original payment method and appear within 5 to "
    "7 business days. Gift orders are refunded as store credit."
)
SHIPPING_US = (
    "Standard shipping within the contiguous United States takes 3 to 5 "
    "business days and costs $6.00. Standard shipping is free on orders of "
    "$40.00 or more."
)
PAUSE = (
    "You can pause a subscription for up to 3 months from your account page. "
    "Paused subscriptions keep their pricing."
)
SUBSCRIPTION_PERKS = (
    "Subscribers save 10% on every bag and always get free standard shipping, "
    "regardless of order size."
)

samples = [
    # 1. Clean: grounded answer, relevant chunks ranked first.
    SingleTurnSample(
        user_input="How long do I have to ask for a refund on a bag of coffee?",
        retrieved_contexts=[REFUNDS, REFUND_TIMING, SHIPPING_US],
        response=(
            "You have 14 days from the delivery date to contact support for a "
            "full refund, and you do not need to send the bag back."
        ),
        reference=(
            "Contact support within 14 days of the delivery date for a full "
            "refund; the bag does not need to be returned."
        ),
    ),
    # 2. Deliberate hallucination: the pause limit is 3 months, not 6, and
    #    the free bag does not exist anywhere in the docs.
    SingleTurnSample(
        user_input="Can I pause my subscription?",
        retrieved_contexts=[PAUSE, SUBSCRIPTION_PERKS],
        response=(
            "Yes. You can pause your subscription for up to 6 months from your "
            "account page, and you get a free bag when you resume."
        ),
        reference=(
            "Yes, a subscription can be paused for up to 3 months from the "
            "account page, and paused subscriptions keep their pricing."
        ),
    ),
    # 3. Clean: multi-fact answer fully supported by the retrieved chunks.
    SingleTurnSample(
        user_input="What do subscribers get that regular customers do not?",
        retrieved_contexts=[SUBSCRIPTION_PERKS, PAUSE],
        response=(
            "Subscribers save 10% on every bag and get free standard shipping "
            "on every order, with no minimum order size."
        ),
        reference=(
            "Subscribers save 10% on every bag and always get free standard "
            "shipping regardless of order size."
        ),
    ),
]

dataset = EvaluationDataset(samples=samples)
dataset.to_jsonl("eval_dataset.jsonl")
print(dataset)

# Save the questions and reference answers separately. The CI section rebuilds
# retrieved_contexts and response from your real pipeline, so it only needs these.
with open("eval_questions.jsonl", "w", encoding="utf-8") as file:
    for sample in samples:
        row = {"user_input": sample.user_input, "reference": sample.reference}
        file.write(json.dumps(row) + "\n")
Каждый извлечённый контекст — это фрагмент страниц справочного центра Northwind, записанный в скрипт ровно так, как извлекатель передал бы его генератору. Запустите uv run python build_dataset.py, чтобы записать eval_dataset.jsonl и eval_questions.jsonl, и перезапускайте при каждом добавлении сэмпла в следующих разделах.
Сохранение в JSON Lines важно, потому что все последующие скрипты (прогоны метрик, CI‑ворота) загружают один и тот же eval_dataset.jsonl через EvaluationDataset.from_jsonl().
В реальном проекте поля retrieved_contexts и response берутся из запуска вашего конвейера на вопросах, и только user_input и reference пишутся вручную. В разделе CI показано, как автоматизировать этот шаг.
6 сэмплов в этой статье достаточно, чтобы освоить метрики, но недостаточно, чтобы доверять порогам. Стремитесь примерно к 100 сэмплам, прежде чем полагаться на пороги; раздел трекинга покажет почему. Сколько именно нужно — зависит от строгости кейса, поэтому фокус на хорошем миксе, а не на числе:
4 ключевые метрики Ragas — это достоверность и релевантность ответа для генератора, а также точность и полнота контекста для извлекателя. Все 4 возвращают оценку от 0 до 1. Самое полезное — что именно каждая цифра подсказывает, что чинить.
Достоверность измеряет, насколько ответ подкреплён извлечёнными фрагментами. Судья разбивает ответ на отдельные утверждения и проверяет каждое по фрагментам: 1.0 значит, что каждое утверждение поддержано, 0.0 — ни одно не поддержано.
Достоверность не требует эталонного ответа, так что её можно запускать на продовом трафике, а не только на тестовом наборе. Перезапускайте её при изменениях промпта, модели или объёма контекста, доступного модели — именно эти изменения чаще всего приводят к галлюцинациям.
Быстрее всего посмотреть её в деле на одном ответе — без датасета:
# quick_check.py
"""Score a single response for faithfulness"""

import asyncio

from ragas.metrics.collections import Faithfulness

from judge import build_judge

judge_llm, _ = build_judge()
faithfulness = Faithfulness(llm=judge_llm)

result = asyncio.run(
    faithfulness.ascore(
        user_input="Can I pause my subscription?",
        response=(
            "Yes. You can pause for up to 6 months, and you get a free bag "
            "when you resume."
        ),
        retrieved_contexts=[
            "You can pause a subscription for up to 3 months from your account "
            "page. Paused subscriptions keep their pricing."
        ],
    )
)
print(f"faithfulness = {result.value:.2f}")
Запустите uv run python quick_check.py — напечатается faithfulness = 0.00, потому что ни одно из двух утверждений в ответе (6 месяцев, бесплатная пачка) не поддержано контекстом. В 0.4 оценка вызывается методом ascore() каждой метрики, который возвращает результат с оценкой в .value.
В датасетном прогоне запланированная галлюцинация во втором сэмпле получает 0.0 — как и должно быть, а оба чистых сэмпла — по 1.0. Полные результаты для каждой метрики — в разделе про мульти-метрическую оценку ниже.
Релевантность ответа измеряет, отвечает ли ответ на заданный вопрос. Судья читает ответ и пишет 3 вопроса, для которых этот ответ подошёл бы, а затем Ragas проверяет близость по смыслу этих вопросов к исходному, используя модель эмбеддингов. Если ответ уходит от темы, судья маркирует его как уклончивый, и оценка равна 0.
Класс в Ragas называется AnswerRelevancy (в старых примерах — ResponseRelevancy, а страница документации называется Response Relevancy) и требует и LLM-судью, и модель эмбеддингов.
Низкая релевантность при высокой достоверности обычно указывает на генератор или промпт: у модели был правильный контекст, она опиралась на него, но ответила на другой вопрос. Сначала проверьте точность и полноту контекста, потому что извлекатель, возвращающий не по теме, даст тот же паттерн.
Этот сэмпл показывает случай генератора. Извлекатель возвращает нужный фрагмент про доставку, ответ остаётся приземлённым, но говорит о дате обжарки, а не о стоимости доставки. Добавьте новый фрагмент к фрагментам вверху build_dataset.py:
ROAST_DATE = (
    "Every bag is roasted to order and shipped within 48 hours of roasting. "
    "The roast date is printed on the bottom of the bag."
)
Затем добавьте новый сэмпл в конец списка samples:
    # 4. Drift: retrieval was fine and the answer is grounded, but it never
    #    addresses the question that was asked.
    SingleTurnSample(
        user_input="How much does standard shipping cost in the US?",
        retrieved_contexts=[SHIPPING_US, ROAST_DATE],
        response=(
            "Every bag is roasted to order and shipped within 48 hours of "
            "roasting, and the roast date is printed on the bottom of the bag."
        ),
        reference=(
            "Standard shipping in the contiguous United States costs $6.00 and "
            "is free on orders of $40.00 or more."
        ),
    ),
Каждый сэмпл получает одну оценку релевантности: насколько близко вопросы, написанные судьёй по ответу, совпадают по смыслу с вопросом, который реально задавался; 1.0 — идеальное совпадение.
Точность контекста проверяет, находятся ли полезные фрагменты ближе к началу списка, который вернул извлекатель, а полнота контекста проверяет, нашёл ли извлекатель всё, что нужно, чтобы написать правильный ответ.
Точность даёт больший вклад полезному фрагменту, если он ранжирован выше: полезный фрагмент на первом месте ценится выше того же фрагмента на третьем. Полнота — это доля фактов из эталонного ответа, которые поддержаны хотя бы одним извлечённым фрагментом.
Обе метрики требуют поле reference. В коллекционном API классы называются ContextPrecisionWithReference и ContextRecall, и обе используют только LLM-судью. В документации Ragas также используется краткое имя ContextPrecision для версии с эталоном, так что вы можете встретить оба варианта.
Пока что каждый сэмпл извлекает правильные фрагменты первыми, так что ловить нечего. Добавим 2 сэмпла, которые ломают извлечение по-разному: один, где нужный фрагмент извлечён, но ранжирован последним, и один, где вообще ничего релевантного не извлечено, поэтому модель корректно отказывает. Как и прежде, добавьте фрагменты в начало файла:
SHIPPING_CANADA = (
    "We ship to Canada. Canadian orders take 7 to 10 business days and cost "
    "$18.00. We do not currently ship outside the United States and Canada."
)
BREWING = (
    "For pour-over, we recommend a ratio of 1 gram of coffee to 16 grams of "
    "water, a medium-fine grind, and water at 200 degrees Fahrenheit."
)
Затем добавьте сэмплы в конец списка:
    # 5. Ranking problem: the right chunk is retrieved, but it is ranked last.
    SingleTurnSample(
        user_input="Does Northwind ship to Canada, and how long does it take?",
        retrieved_contexts=[BREWING, ROAST_DATE, SHIPPING_CANADA],
        response=(
            "Yes, Northwind ships to Canada. Canadian orders take 7 to 10 "
            "business days and cost $18.00."
        ),
        reference="Yes. Canadian orders take 7 to 10 business days and cost $18.00.",
    ),
    # 6. Retrieval miss: nothing about the warranty was retrieved, so the
    #    model correctly declines. Recall will be 0 here.
    SingleTurnSample(
        user_input="How long is the warranty on the Baratza Encore grinder?",
        retrieved_contexts=[BREWING, SHIPPING_US],
        response=(
            "I do not have information about the grinder warranty in the "
            "documents available to me."
        ),
        reference=(
            "All equipment, including the Baratza Encore grinder, ships with a "
            "2-year manufacturer warranty covering defects in materials and "
            "workmanship."
        ),
    ),
Ранжирование важно, потому что большинство конвейеров передаёт модели только первые несколько фрагментов, так что полезный фрагмент на 6 месте у извлекателя с топ‑5 всё равно не попадёт в модель.
В сэмпле 5 единственный полезный фрагмент стоит третьим из трёх, и точность получается 0.333, поскольку полезная информация ранжирована последней. Сэмпл 6, промах извлечения, получил 0.0 и по точности, и по полноте.
Сэмпл 6 также учит кое-чему про достоверность. Модель корректно отказалась, но этот отказ иногда получал 1.0, а иногда 0.0 — без каких‑либо изменений между прогонами. Утверждение вроде «У меня нет информации о гарантии» ни не подтверждается, ни не опровергается контекстом, и судья кидает монетку.
Если по вашему конвейеру модель должна отказывать, оценивайте отказы отдельно, чтобы они не дёргали достоверность. В Ragas 0.4 AspectCritic удалён из коллекционного API, так что замена — кастомная проверка с декоратором @discrete_metric (см. гайд миграции с v0.3 на v0.4).
Читайте 2 числа извлечения вместе — и поймёте, на что тратить следующую неделю:
| Точность контекста | Полнота контекста | Диагноз | Что менять |
|---|---|---|---|
| Высокая | Высокая | Извлечение здорово | Сфокусируйтесь на генераторе: промпт, модель, достоверность |
| Низкая | Высокая | Правильные фрагменты извлечены, но плохо ранжированы | Добавьте или настройте переранжировщик |
| Высокая | Низкая | Топ‑фрагменты релевантны, но неполны | Передавайте больше фрагментов модели, используйте более крупные фрагменты или проверьте разбиение |
| Низкая | Низкая | Извлекатель в целом не справляется | Пересмотрите эмбеддинги, индексирование и переформулирование запросов |
Строка «низкая точность, высокая полнота» — самая частая на практике и самая дешёвая в исправлении.
Наш туториал RankGPT как агент для переранжирования в RAG добавляет LLM‑переранжировщик поверх существующего извлекателя, а Boost LLM Accuracy with RAG and Reranking показывает другую схему переранжирования. В руководстве 5 ключевых техник улучшения RAG разбираются чанкинг и переформулирование для других случаев.
Перезапускайте 2 метрики извлечения после каждого изменения — и таблица покажет, сработало ли оно.
Полная многомерная оценка запускает все 4 метрики по каждому сэмплу параллельно и собирает оценки: по строкам — значения для разбора сбоёв, по столбцам — средние для дашборда.
В Ragas 0.2 и 0.3 это делалось через evaluate(dataset, metrics=[...], run_config=RunConfig(max_workers=8)). В 0.4.3 эта функция ещё есть, но она помечена как устаревшая и не принимает новые метрики, потому что они больше не наследуются от старого класса Metric, которого она ждёт.
Взамен есть @experiment, который совместно запускает ваш конвейер и метрики по Dataset и пишет результаты в CSV. Это правильный инструмент, когда у вас есть конвейер для вызова.
Для оценки статического датасета удобнее небольшой помощник: он один раз собирает 4 метрики для каждого скрипта, которому они нужны, и оставляет параллелизм и обработку ошибок в читаемом коде:
# score.py
"""Score an EvaluationDataset with the 4 core Ragas metrics."""

import asyncio
import inspect
import math

import pandas as pd
from ragas.metrics.collections import (
    AnswerRelevancy,
    ContextPrecisionWithReference,
    ContextRecall,
    Faithfulness,
)


def build_metrics(judge_llm, judge_embeddings) -> list:
    """The 4 core metrics, all using the same judge."""
    return [
        Faithfulness(llm=judge_llm),
        AnswerRelevancy(llm=judge_llm, embeddings=judge_embeddings),
        ContextPrecisionWithReference(llm=judge_llm),
        ContextRecall(llm=judge_llm),
    ]


async def score_sample(sample, metrics, limit):
    """Run every metric on one sample and return that sample's row of scores."""
    row = {"user_input": sample.user_input}
    for metric in metrics:
        # Each metric needs different fields (recall wants the reference,
        # faithfulness wants the response), so pass only the ones it asks for.
        wanted = inspect.signature(metric.ascore).parameters
        inputs = {field: getattr(sample, field) for field in wanted}
        async with limit:
            try:
                result = await metric.ascore(**inputs)
                row[metric.name] = result.value
            except Exception as error:
                # One failed judge call should not sink the whole run
                print(f"{metric.name} failed on {sample.user_input!r}: {error}")
                row[metric.name] = math.nan
    return row


def score_dataset(dataset, metrics, max_concurrency=8):
    """Score every sample: one row per sample, one column per metric."""

    async def score_all_samples():
        limit = asyncio.Semaphore(max_concurrency)  # cap parallel judge calls
        tasks = [score_sample(sample, metrics, limit) for sample in dataset.samples]
        return await asyncio.gather(*tasks)

    return pd.DataFrame(asyncio.run(score_all_samples()))
Единственная неочевидная строка — вызов inspect.signature(). Разным метрикам нужны разные входы (достоверности — ответ, полноте — эталон и т. д.), поэтому помощник читает, какие аргументы принимает ascore() каждой метрики, и передаёт ровно эти поля из сэмпла. Так один цикл обслуживает все метрики.
Семафор ограничивает число параллельных вызовов судьи, а метрика, которая всё же упала, превращается в пустую ячейку (NaN), а не в аварийный выход. Если вы запускаете это в Jupyter, asyncio.run упадёт, потому что цикл уже запущен. Вызовите nest_asyncio.apply() (Ragas уже зависит от него) или ожидайте корутину напрямую.
С помощником полный прогон — короткий:
# run_all.py
"""Run all four core metrics and save per-sample scores to scores.csv."""

import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

judge_llm, judge_embeddings = build_judge()
dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
metrics = build_metrics(judge_llm, judge_embeddings)

scores = score_dataset(dataset, metrics, max_concurrency=4)
scores.to_csv("scores.csv", index=False)

pd.set_option("display.max_colwidth", 45)
pd.set_option("display.width", 160)
print(scores.sort_values("faithfulness").round(3))
print("\nMeans:")
print(scores.drop(columns="user_input").mean().round(3))
Вот оценки из моего первого прогона, отсортированные по достоверности и округлённые до 3 знаков, со средними в последней строке:
| Вопрос | Достоверность | Релевантность ответа | Точность контекста | Полнота контекста |
|---|---|---|---|---|
| Can I pause my subscription? | 0.000 | 0.883 | 1.000 | 1.000 |
| Does Northwind ship to Canada, and how long does it take? | 0.667 | 0.954 | 0.333 | 1.000 |
| How long do I have to ask for a refund on a bag of coffee? | 1.000 | 0.746 | 1.000 | 1.000 |
| How long is the warranty on the Baratza Encore grinder? | 1.000 | 0.000 | 0.000 | 0.000 |
| How much does standard shipping cost in the US? | 1.000 | 0.572 | 1.000 | 1.000 |
| What do subscribers get that regular customers do not? | 1.000 | 0.852 | 1.000 | 1.000 |
| Mean | 0.778 | 0.668 | 0.722 | 0.833 |
Позднейшие прогоны того же датасета дали более низкую достоверность из‑за «перевёртыша» с отказом — об этом в разделе трекинга.
Сортировка по достоверности помогает быстро увидеть вероятные галлюцинации — запланированная стоит наверху. Средние в последней строке — ваши дашбордные цифры.
Читая строки по горизонтали, видно, как каждая запланированная ошибка проявляется по‑разному. Галлюцинация просаживает только достоверность. Промах извлечения обнуляет релевантность, точность и полноту вместе. Проблема ранжирования режет точность до 0.333, а дрейф проявляется как самая низкая релевантность среди отвеченных вопросов.
Один нюанс: ответ про Канаду полностью поддержан своим фрагментом, но достоверность 0.667. Это шум судьи; вернёмся к нему в разделе трекинга.
Релевантность ответа сравнивает смысл через эмбеддинги, поэтому даже хороший ответ редко будет близок к 1.0: ответ про возврат набрал 0.746, а не по теме — 0.572. Оценивайте релевантность по разрыву между сэмплами и по тренду со временем, а не по абсолютному числу.
Ворота качества RAG — это тестовый скрипт, который запускает оценку, сравнивает средние значения метрик с порогами и выходит с ошибкой, если какая‑либо метрика ниже порога, — CI блокирует merge.
Сначала важная оговорка. Ручной датасет выше содержит ответы и извлечённые фрагменты, вписанные вручную, так что его оценка не отразит изменения промпта или извлекателя. В CI нужно прогнать реальный конвейер на сохранённых вопросах и затем оценить его выход. Для этого — два небольших скрипта.
# pipeline.py
"""The bridge between the evaluation scripts and your own RAG pipeline."""


def answer(question: str) -> tuple[list[str], str]:
    """Return (retrieved_chunks, generated_answer) for one question.

    Replace the body with a call to your own retriever and generator. The
    chunks must be in the order your generator receives them, because context
    precision depends on ranking.
    """
    raise NotImplementedError("Connect this function to your RAG pipeline.")
# refresh_dataset.py
"""Run the real pipeline over the saved questions and rebuild eval_dataset.jsonl."""
import json
from ragas import EvaluationDataset, SingleTurnSample
from pipeline import answer
def main():
samples = []
with open("eval_questions.jsonl", encoding="utf-8") as file:
for line in file:
row = json.loads(line)
retrieved_contexts, response = answer(row["user_input"])
samples.append(
SingleTurnSample(
user_input=row["user_input"],
retrieved_contexts=retrieved_contexts,
response=response,
reference=row["reference"],
)
)
EvaluationDataset(samples=samples).to_jsonl("eval_dataset.jsonl")
print(f"Rebuilt eval_dataset.jsonl with {len(samples)} samples")
if __name__ == "__main__":
main()pipeline.py — единственный файл, который вы пишете сами: замените тело answer() вызовами вашего извлекателя и генератора. refresh_dataset.py читает вопросы и эталонные ответы, сохранённые build_dataset.py, прогоняет конвейер по каждому вопросу и перезаписывает eval_dataset.jsonl.
Сами ворота — это словарь порогов и цикл. Пороги ниже откалиброваны на примере ручного датасета, поэтому в реальном проекте калибруйте их на выходе вашего конвейера, прежде чем полагаться на них.
# quality_gate.py
"""Fail the build when any aggregate Ragas score drops below its threshold."""

import os
import random
import sys

import numpy as np
import pandas as pd
from ragas import EvaluationDataset

from judge import build_judge
from score import build_metrics, score_dataset

# Set each threshold just below the lowest mean you have seen across repeated
# runs, not below one lucky run. With a small dataset a single flaky verdict
# moves a mean by 1 / n_samples, so a thin margin makes the build flaky.
THRESHOLDS = {
    "faithfulness": 0.60,
    "answer_relevancy": 0.60,
    "context_precision_with_reference": 0.65,
    "context_recall": 0.75,
}

RUNS = int(os.environ.get("GATE_RUNS", "3"))      # judge runs to average
SAMPLE = int(os.environ.get("GATE_SAMPLE", "0"))  # rows to score, 0 means all


def load_dataset():
    dataset = EvaluationDataset.from_jsonl("eval_dataset.jsonl")
    if 0 < SAMPLE < len(dataset.samples):
        # A fixed seed means every pull request scores the same subset
        rows = random.Random(0).sample(dataset.samples, SAMPLE)
        dataset = EvaluationDataset(samples=rows)
    return dataset


def average_runs(frames):
    """Average each sample's scores across runs. A NaN in any run stays NaN."""
    numbers = [frame.drop(columns="user_input") for frame in frames]
    averaged = np.mean([frame.to_numpy() for frame in numbers], axis=0)
    result = pd.DataFrame(averaged, columns=numbers[0].columns)
    result.insert(0, "user_input", frames[0]["user_input"])
    return result


def main():
    judge_llm, judge_embeddings = build_judge()
    dataset = load_dataset()
    metrics = build_metrics(judge_llm, judge_embeddings)

    frames = [score_dataset(dataset, metrics, max_concurrency=4) for _ in range(RUNS)]
    scores = average_runs(frames)
    scores.to_csv("scores.csv", index=False)  # track_scores.py reads this file

    # skipna=False: a failed judge call must fail the gate, not shrink the sample
    means = scores.drop(columns="user_input").mean(skipna=False)

    failed = []
    for metric_name, threshold in THRESHOLDS.items():
        actual = means[metric_name]
        # Test the pass condition once and fail on everything else. NaN is
        # neither >= nor < a threshold, so a judge outage must fail the gate
        # rather than slip between the two comparisons.
        ok = actual >= threshold
        print(f"{'PASS' if ok else 'FAIL'}  {metric_name:<34} {actual:.3f} (min {threshold:.2f})")
        if not ok:
            failed.append(metric_name)

    if failed:
        print(f"\nQuality gate failed on: {', '.join(failed)}")
        sys.exit(1)
    print("\nQuality gate passed.")


if __name__ == "__main__":
    main()
На моём базовом наборе все 4 средних превышают пороги, и скрипт выходит с кодом 0 — merge разрешён:
| Метрика | Среднее | Порог | Результат |
|---|---|---|---|
| Достоверность | 0.778 | 0.60 | Pass |
| Релевантность ответа | 0.668 | 0.60 | Pass |
| Точность контекста | 0.722 | 0.65 | Pass |
| Полнота контекста | 0.833 | 0.75 | Pass |
Порог достоверности поставлен на 0.60, а не 0.70, из‑за шума судьи (см. раздел трекинга). При 6 сэмплах один «флип» вердикта двигает среднее на 0.17, и поздний прогон неизменного конвейера дал 0.61. Ворота также гоняют судью 3 раза и усредняют оценки (GATE_RUNS), сглаживая одиночные перевороты втрое дороже.
Ещё один момент — условие провала как not (actual >= threshold), а не actual < threshold. Любое сравнение с NaN («не число») ложно, так что проверка actual < threshold пропустила бы сборку при падении судьи.
skipna=False в среднем закрывает частный случай. По умолчанию pandas пропускает NaN, так что несколько неудачных вызовов судьи тихо «сжали» бы выборку вместо того, чтобы уронить ворота. Теперь временная ошибка судьи ломает сборку — перезапустите джоб, прежде чем разбираться.
Пороги сложно настраивать. Ставьте их чуть ниже самого низкого среднего, которое вы видели в повторных прогонах, а не на «хотелось бы 0.9», иначе ворота будут блокировать каждый pull request, и команда перестанет доверять CI. Переснимайте их при смене модели-судьи или при добавлении заметного числа сэмплов.
Включить это в GitHub Actions — короткий workflow. Справочник по синтаксису workflow описывает фильтры on.pull_request по путям и cron в schedule:
# .github/workflows/rag-eval.yml
name: RAG quality gate

on:
  pull_request:
    paths:
      - "prompts/**"
      - "retriever/**"
      - "judge.py"
      - "eval_questions.jsonl"
  schedule:
    - cron: "0 3 * * *"  # full suite nightly at 03:00 UTC

jobs:
  ragas:
    runs-on: ubuntu-latest
    env:
      # Use the same judge you calibrated the thresholds with
      GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
      JUDGE_MODEL: gemini-3.5-flash-lite
      # Score a fixed 30-row subset on pull requests, everything on the nightly run
      GATE_SAMPLE: ${{ github.event_name == 'pull_request' && '30' || '0' }}
    steps:
      - uses: actions/checkout@v7
      - uses: astral-sh/setup-uv@v10
      - run: uv sync
      - name: Rebuild the dataset with the current pipeline
        run: uv run python refresh_dataset.py
      - name: Run Ragas quality gate
        run: uv run python quality_gate.py
      - name: Log scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        run: uv run python track_scores.py
      - name: Keep the scores
        if: ${{ always() && hashFiles('scores.csv') != '' }}
        uses: actions/upload-artifact@v7
        with:
          name: ragas-scores
          path: |
            scores.csv
            ragas_history.jsonl
Пара важных деталей:
JUDGE_MODEL и соответствующий API‑ключ. Используйте того же судью, на котором калибровались пороги, иначе CI не сопоставим с вашей историей.GATE_SAMPLE оценивает фиксированную случайную подвыборку из 30 строк, чтобы ревью не ждало 10 минут вызовов судьи. Ночной cron гоняет всё.scores.csv и ragas_history.jsonl как артефакты, потому что диск раннера стирается после джоба.Гоняйте полный набор по ночному cron, когда никто не ждёт. Провал ночного прогона будет виден как упавший workflow, а настройки уведомлений GitHub или шаг в Slack сообщат ответственному утром. В GitLab CI всё выглядит так же с rules: changes: и расписанием pipeline.
Ragas генерирует синтетические тестовые вопросы, читая ваши документы, выделяя их основные темы и факты, связывая родственные фрагменты и затем формируя вопросы разных типов из этих связей.
Документация по генерации тестовых данных разбивает запросы на одношаговые (можно ответить одним фрагментом) и многошаговые (нужно несколько фрагментов), и каждый из этих типов может быть специфичным или абстрактным. Набор по умолчанию использует 3 из этих 4 комбинаций в равных долях:
Ragas использует только те синтезаторы, которым соответствуют ваши документы, так что небольшой набор документов может дать другой состав.
Генератору нужны реальные документы. Укажите на вашу документацию в виде файлов markdown. Для этой статьи я написал 5 коротких страниц справочного центра Northwind (около 600 слов), каждая выглядит так:
<!-- docs/subscription.md -->
# Subscriptions

A Northwind subscription delivers a fresh bag on a schedule you choose: every 1, 2, or 4 weeks. Subscribers save 10% on every bag and always get free standard shipping, regardless of order size.

You can pause a subscription for up to 3 months from your account page. Paused subscriptions keep their pricing. You can also skip a single delivery up to 48 hours before it is scheduled to ship.

Cancel at any time from the account page. Cancellations take effect immediately and no further bags are charged. There is no cancellation fee.

Subscribers can change their roast, grind, or bag size at any time. Changes made less than 48 hours before a scheduled shipment apply to the following delivery.
Ваши собственные документы дадут другие вопросы — и это правильно: генератор пишет вопросы о том, что реально есть в вашей базе знаний.
TestsetGenerator использует того же LLM‑судью и модель эмбеддингов, которые мы уже собрали. Я загружаю доки через DirectoryLoader из LangChain, явно задавая TextLoader, чтобы markdown‑файлы не тянули тяжёлую зависимость unstructured.
Построение карты ваших документов запускает множество параллельных вызовов судьи, поэтому я также ограничиваю их число через RunConfig:
# generate_testset.py
"""Generate synthetic question-answer pairs from the documents in ./docs."""

import pandas as pd
from langchain_community.document_loaders import DirectoryLoader, TextLoader
from ragas import RunConfig
from ragas.testset import TestsetGenerator

from judge import build_judge

judge_llm, judge_embeddings = build_judge()

loader = DirectoryLoader(
    "docs", glob="**/*.md", loader_cls=TextLoader, loader_kwargs={"encoding": "utf-8"}
)
docs = loader.load()
print(f"Loaded {len(docs)} documents")

generator = TestsetGenerator(llm=judge_llm, embedding_model=judge_embeddings)
testset = generator.generate_with_langchain_docs(
    docs,
    testset_size=8,
    run_config=RunConfig(max_workers=4),  # keep the knowledge-graph build polite
)

frame = testset.to_pandas()
frame.to_csv("synthetic_testset.csv", index=False)

pd.set_option("display.max_colwidth", 70)
print(frame[["user_input", "synthesizer_name"]])
Скрипт загружает все 5 документов и записывает 8 вопросов. Вопросы соответствуют документам, некоторые содержат намеренные опечатки:
| # | Сгенерированный вопрос | Тип вопроса |
|---|---|---|
| 1 | how do i brew with a french pres | Одношаговый |
| 2 | Northwind equipment warranty | Одношаговый |
| 3 | Where is Northwinds roastery located in Portlnd where orders are shipped from? | Одношаговый |
| 4 | how do I cancel Nortwind subscription? | Одношаговый |
| 5 | Can u tell me about the warranty coverge for equipmet like grinders and how long do i have if i need to ask for refunds? | Многошаговый |
| 6 | What specific equipment does Northwind sell for coffee brewing, and what are the terms of their manufacturer warranty regarding coverage and claims? | Многошаговый |
| 7 | What is the shipping policy for orders and what are the return guidelines if I am not happy with my coffee or espresso equipment? | Многошаговый |
| 8 | What is the shipping policy for orders from Northwind Coffee and what are the conditions for getting refunds? | Многошаговый |
В таблице упрощённые ярлыки; полный тип лежит в колонке synthesizer_name в выходных данных. Восемь вопросов из 5 документов заняли около 4.5 минут.
Опечатки и «поисковый» стиль запроса во втором вопросе добавлены намеренно: генератор варьирует стиль и длину запроса, чтобы набор выглядел как поисковый трафик, а не как экзаменационные билеты.
Скорее всего, вы захотите просмотреть вопросы, чтобы убедиться, что они пригодны и релевантны. Я бы использовал результат как черновик. В каждом синтетическом наборе, который я просматривал, часть вопросов сформулирована неудачно (ссылки на «этот документ» или вопросы о заголовке), часть эталонных ответов уезжает от источника, а стиль формальнее, чем у реальных пользователей.
Перезапускайте генератор при добавлении разделов в доки — получите кандидатов на вопросы о новом материале, ценой ещё одной серии вызовов судьи.
В каждой строке есть user_input, сгенерированный эталонный reference и reference_contexts — фрагменты, из которых строился вопрос. Проверьте reference по этим фрагментам — именно там чаще всего возникает дрейф.
Чтобы превратить проверенную строку в SingleTurnSample, прогоните ваш конвейер по user_input, чтобы получить retrieved_contexts и response. Добавьте проверенные пары user_input и reference в eval_questions.jsonl, а refresh_dataset.py сделает остальное.
Если ваша база знаний — это граф, а не набор документов, принцип тот же, только извлекатель другой. Наш туториал Using a Knowledge Graph to Implement a RAG Application и курс Graph RAG with LangChain and Neo4j дают конвейеры, которые можно оценивать ровно теми же 4 метриками, потому что метрики видят только извлечённый текст, а не способ его извлечения.
Отслеживание оценок Ragas во времени — это добавление средних оценок, хеша коммита, модели-судьи и таймстемпа в лог после каждого прогона, чтобы регрессия проявлялась как провал на линейном графике, а не как сюрприз на проде.
Файл JSON Lines — вероятно, лучший формат, пока вам не понадобится общий трекер экспериментов для нескольких человек. track_scores.py читает scores.csv, который пишут и quality_gate.py, и run_all.py, так что он не инициирует второй раунд вызовов судьи.
# track_scores.py
"""Append the latest aggregate scores, commit hash, and timestamp to a log."""

import json
import subprocess
from datetime import datetime, timezone

import pandas as pd

from judge import judge_model_name

HISTORY_FILE = "ragas_history.jsonl"


def current_commit():
    """Return the short git hash, or 'no-git' outside a repository."""
    try:
        return subprocess.check_output(
            ["git", "rev-parse", "--short", "HEAD"],
            text=True, stderr=subprocess.DEVNULL,
        ).strip()
    except (subprocess.CalledProcessError, FileNotFoundError):
        return "no-git"


def main():
    scores = pd.read_csv("scores.csv")
    means = scores.drop(columns="user_input").mean().round(4)

    record = {
        "timestamp": datetime.now(timezone.utc).isoformat(timespec="seconds"),
        "commit": current_commit(),
        "judge_model": judge_model_name(),
        "n_samples": len(scores),
        **means.to_dict(),
    }
    with open(HISTORY_FILE, "a", encoding="utf-8") as history:
        history.write(json.dumps(record) + "\n")
    print(json.dumps(record, indent=2))


if __name__ == "__main__":
    main()
Запуск uv run python track_scores.py добавляет строку в лог и печатает её:
{
  "timestamp": "2026-09-18T03:23:51+00:00",
  "commit": "85834f4",
  "judge_model": "gemini-3.5-flash-lite",
  "n_samples": 6,
  "faithfulness": 0.7778,
  "answer_relevancy": 0.6678,
  "context_precision_with_reference": 0.7222,
  "context_recall": 0.8333
}
В CI каждый джоб стартует с пустым диском, поэтому ragas_history.jsonl содержит только запись текущего прогона. Чтобы сохранять тренд, скачивайте артефакты и добавляйте их в один файл, или коммитьте файл в метрик‑ветку, или складывайте в объектное хранилище.
Построить график истории несложно. Попробуйте следующий скрипт:
# plot_history.py
"""Plot every logged Ragas run so regressions show up as a dip in a line."""

import matplotlib.pyplot as plt
import pandas as pd

history = pd.read_json("ragas_history.jsonl", lines=True)
history["timestamp"] = pd.to_datetime(history["timestamp"])
history["run"] = history["commit"] + "\n" + history["timestamp"].dt.strftime("%m-%d %H:%M")

METRICS = {
    "faithfulness": "#2a78d6",
    "answer_relevancy": "#eb6834",
    "context_precision_with_reference": "#1baf7a",
    "context_recall": "#eda100",
}

fig, ax = plt.subplots(figsize=(9, 4.5))
for metric, color in METRICS.items():
    ax.plot(history["run"], history[metric], color=color, linewidth=2,
            marker="o", markersize=6, label=metric)
    ax.annotate(f"{history[metric].iloc[-1]:.2f}",
                (history["run"].iloc[-1], history[metric].iloc[-1]),
                xytext=(6, 0), textcoords="offset points", va="center",
                fontsize=9, color="#333333")

ax.set_ylim(0, 1.05)
ax.set_ylabel("mean score")
ax.set_title("Ragas scores by commit")
ax.grid(axis="y", color="#e5e5e5")
ax.spines[["top", "right"]].set_visible(False)
ax.legend(loc="lower left", frameon=False)
fig.tight_layout()
fig.savefig("ragas_history.png", dpi=150)
print("Saved ragas_history.png")
Получится график примерно такого вида:
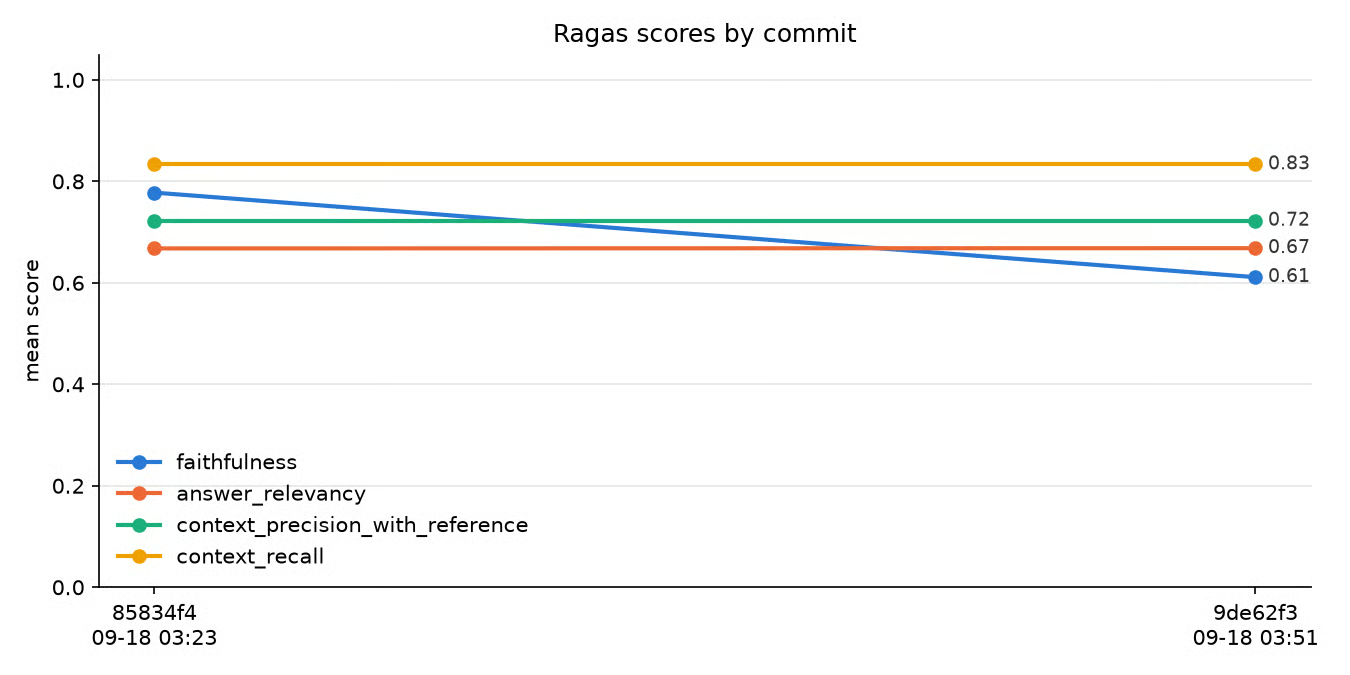
Средние оценки Ragas по коммитам из лога track_scores.py. Изображение автора.
Между этими коммитами в конвейере ничего не менялось (во втором менялись только настройки подключения клиента судьи), но достоверность упала с 0.78 до 0.61, потому что отказ в сэмпле 6 «перевернулся» с 1.0 на 0.0.
Так что есть реальный шум судьи, на который стоит смотреть, пока у вас немного сэмплов. При 6 сэмплах один «флип» двигает среднее на 0.17. При 100 сэмплах тот же флип двигает его на 0.01, и заметное изменение куда вероятнее окажется настоящей регрессией.
Теперь при каждом pull request или коммите вы можете запускать ворота, логировать оценки и смотреть на график.
Если вы взвешиваете более крупные архитектурные изменения, наш туториал RAG vs. тонкая настройка поможет с выбором, и те же 4 метрики подойдут как измерение «до и после» для любого пути.
Оценки «LLM как судья» — это приближения: у них есть известные смещения, и они могут меняться от прогона к прогону, но они масштабируются на объёмы, которые человеку не по силам.
Ragas никогда не просит судью сравнить 2 ответа, поэтому смещение позиции (предпочтение первого ответа) в основном не применимо. Смещение к многословию (предпочтение длинных ответов) и само‑предпочтение (судьи предпочитают ответы своей модели) всё ещё могут играть роль. Zheng et al. (2023) описывают все 3 смещения, и именно из‑за само‑предпочтения я не стал бы использовать одну и ту же модель как генератор и как судью.
Вариативность между прогонами — то, что полезно увидеть своими глазами, потому что это влияет на настройку порогов. Между прогонами одного и того же набора из 6 сэмплов с закреплённым судьёй отказной ответ в сэмпле 6 получал 0.0 в одном прогоне и 1.0 — в другом по достоверности, а полностью приземлённый сэмпл 5 — 0.667 в показанном выше прогоне.
Покомплектные оценки от дешёвого судьи шумные. Средние по 100 сэмплам намного стабильнее — и ворота в CI всегда должны проверять именно среднее.
Три практики сдерживают шум:
judge.py и track_scores.py, чтобы смену судьи никогда не спутать со сменой конвейера.Для более широкого обзора подходов к оценке за пределами RAG, включая человеческие методики, которые заменяет судья, смотрите наше руководство по оценке LLM. Наш туториал про LLM в роли судьи глубже разбирает построение судьи для конвейеров RAG.
Смысл этого конвейера в том, что он позволяет говорить: «извлечение в порядке, деградировал промпт» или «переранжировщик починил точность, но полнота всё ещё 0.6» — и подкреплять это числами.
Достоверность и релевантность ответа следят за генератором: достоверность ловит выдуманные факты, релевантность — ответы, уходящие от вопроса. Точность и полнота контекста следят за извлекателем и говорят, приносит ли он правильную информацию. Поскольку 2 из 4 метрик не требуют эталонного ответа, их можно запускать на продовом трафике, где эталона нет.
Стандартные текстовые метрики измеряют пересечение слов, что ничего не говорит о выдуманной политике возвратов, а одна сквозная цифра скрывает, какая половина конвейера сломалась. Фреймворк, который проверяет две точки отказа отдельно, это видит, а превращение разовой оценки в CI‑ворота с историей — то, что заставит команду действовать по числам.
Если вы ещё не построили конвейер, начните с нашего курса Retrieval-Augmented Generation with LangChain, а затем подключите pipeline.py из этой статьи к тому, что вы соберёте.
Для конвейеров, выходящих за рамки простого извлечения текста, наш курс End-to-End RAG with Weaviate, наше руководство по мультимодальному RAG и наш туториал по агентному RAG помогают строить системы, которые можно оценивать тем же способом — с одной оговоркой: 4 ключевые метрики читают только текст. Конвейеру, извлекающему изображения, нужны отдельные мультимодальные метрики Ragas, а агентному конвейеру — оценка каждого шага извлечения как отдельного вопроса, фрагментов и ответа.
Лучшие курсы DataCamp
Курс
Курс
Курс