tracks
개발자를 위한 AI 엔지니어 보조
26
Motif-3는 대규모 Mixture-of-Experts (MoE) 모델로, Motif Technologies가 총 3,140억 매개변수로 설계했으며 토큰당 132억 매개변수만 활성화합니다.
이 모델은 384개의 라우팅 전문가(Experts), 256K 컨텍스트 윈도우를 제공하며, 코드·수학·STEM·다국어 데이터 등 약 12.5조 토큰으로 학습되었습니다.
추론, 코딩, 에이전트형 작업에 특히 적합합니다. Artificial Analysis Intelligence Index에서 47점을 기록했으며, 이는 Qwen3.8-27B와 유사한 환경에서 테스트한 MiniMax-M3 사이 수준입니다.
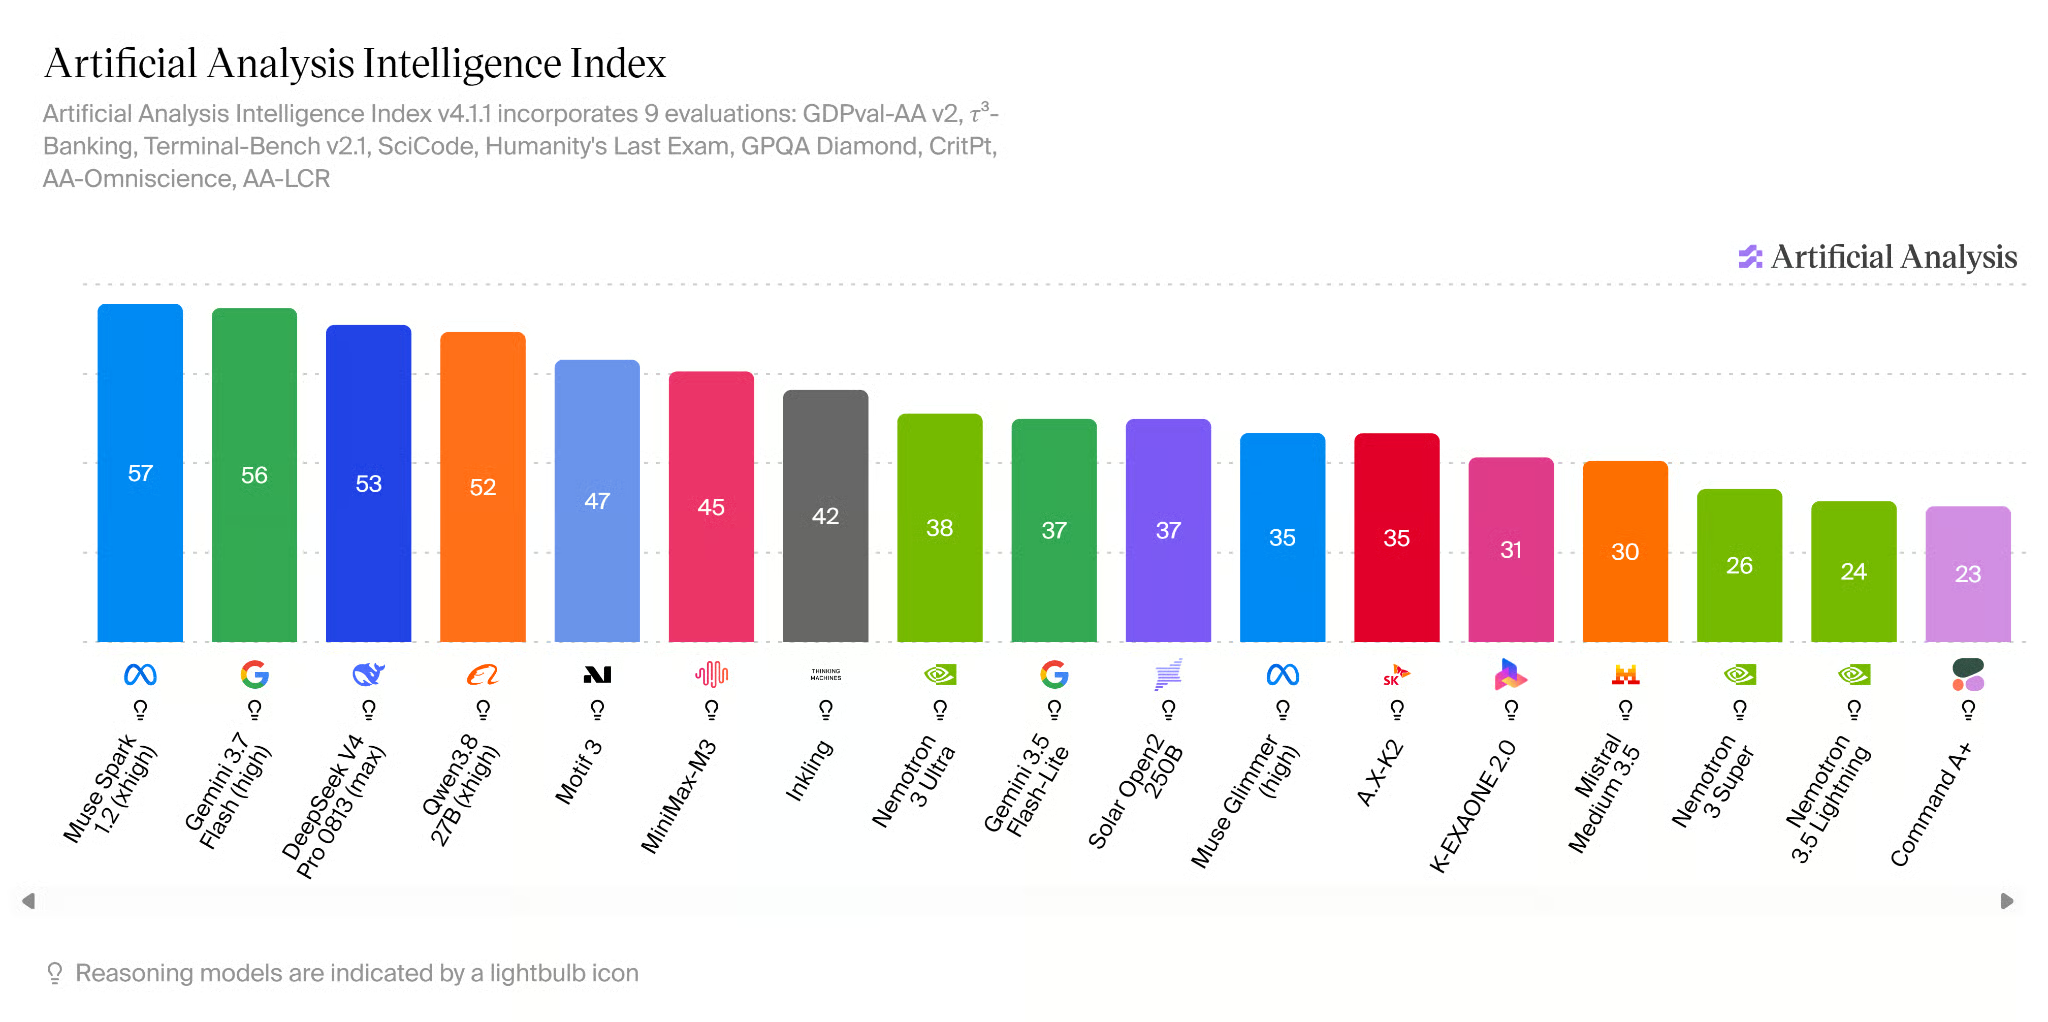
출처: AI Model & API Providers Analysis | Artificial Analysis
이 가이드에서는 Motif-3의 독립 양자화 버전인 Baekpica/Motif-3-Mixed-Quant-GGUF를 사용합니다. 전체 모델에 단일 정밀도를 적용하는 대신, 혼합 양자화를 사용하여 중요한 구성요소에는 더 높은 정밀도를, 거대한 전문가 계층에는 훨씬 낮은 정밀도를 적용합니다.
예를 들어, 중요한 어텐션 및 상시 활성 구성요소는 Q8_0을 사용하고, 많은 라우팅 전문가 가중치는 IQ2_XXS와 Q2_K를 사용합니다. 모델은 384명의 전문가와 53개 레이어를 모두 유지하므로 가지치기나 제거는 없습니다. 이로써 모델 크기는 Q8_0 GGUF가 약 335GB인 데 비해 약 94GB로 줄어들며, 141GB H200에서 런타임 및 KV 캐시를 위한 추가 VRAM까지 두고 전부 실행하기에 충분합니다.
배경 지식은 LLM 양자화와 GGUF 포맷 가이드를 참고하세요.
Motif-3 Mixed Quant는 약 94GB이므로, 모델을 로드하고 추론을 위한 여유 공간을 확보하려면 충분한 VRAM을 가진 GPU가 필요합니다. Hyperbolic, RunPod, Vast.ai 같은 GPU 클라우드에서 VRAM 141GB의 NVIDIA H200 한 대를 임대하는 것을 권장합니다.
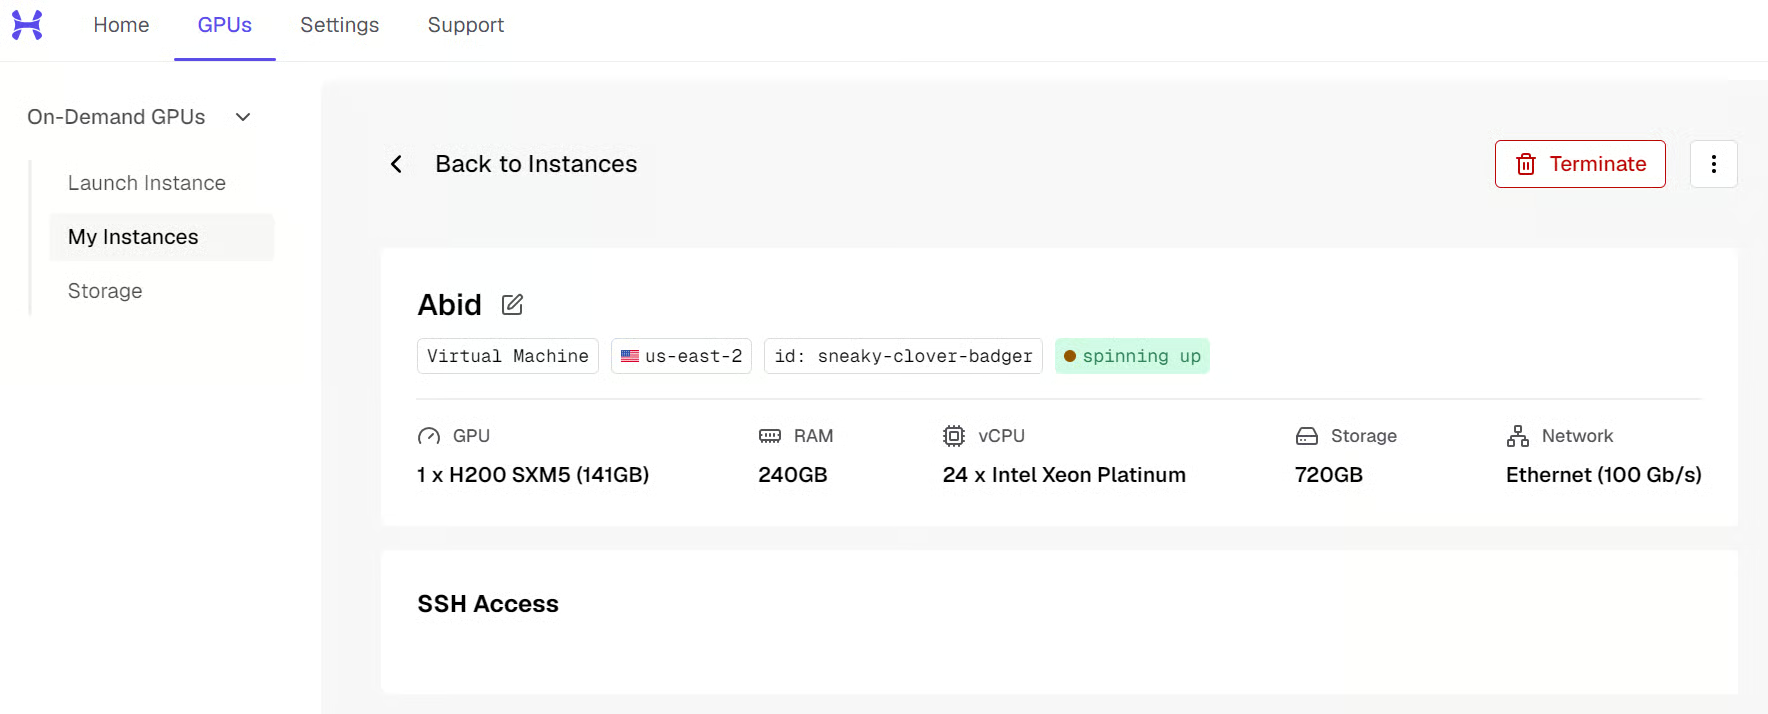
인스턴스가 실행되면 터미널이나 VS Code Remote SSH로 접속하세요. 제공업체가 IP 주소를 제공합니다. 명령은 다음과 비슷합니다.
ssh root@<SERVER_IP> -L 8080:localhost:8080-L 8080:localhost:8080 옵션은 Motif-3 API 포트를 로컬 PC로 포워딩하므로, 나중에 http://127.0.0.1:8080에서 접근할 수 있습니다.
이제 서버를 준비합니다.
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
마지막으로 H200이 보이는지 확인합니다.
nvidia-smi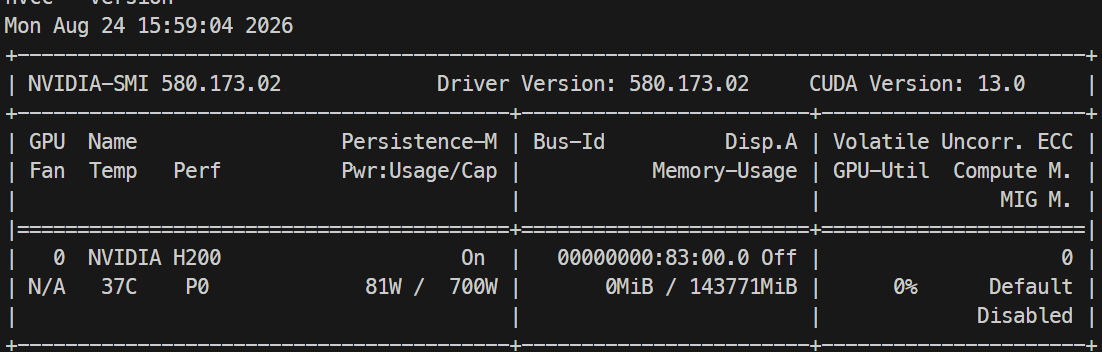
NVIDIA H200와 약 141GB의 VRAM이 표시되어야 합니다.
다음으로 Hugging Face에서 Baekpica/Motif-3-Mixed-Quant-GGUF 모델을 다운로드합니다. 여기서는 MQ87-88-FIT 변형을 사용하며, 총 약 94GB 용량의 11개 GGUF 파일로 분할되어 있습니다.
/workspace/motif3 디렉터리에서 다음을 실행합니다.
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model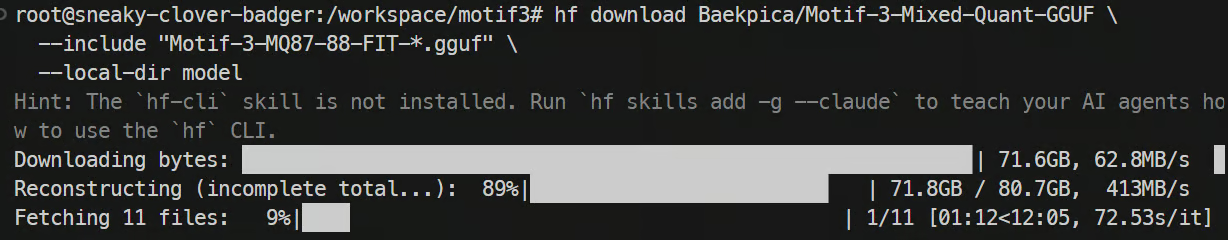
네트워크 상태에 따라 94GB 전체 다운로드에는 시간이 걸릴 수 있습니다. 완료되면 모든 샤드가 있는지 확인하세요.
ls -lh model병합 전 샤드를 검증하세요. 병합은 94GB에 대한 단 한 번의 작업이므로, 지금 잘못된 다운로드를 잡아내는 것이 좋습니다.
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..ds4 런타임은 모델이 단일 GGUF 파일 형태이길 기대하므로, 먼저 다운로드한 11개 샤드를 병합해야 합니다.
llama.cpp를 클론하고 GGUF 유틸리티를 빌드합니다.
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
이제 11개 샤드를 하나의 파일로 병합합니다.
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
병합된 모델을 확인합니다.
ls -lh motif3.gguf큰 motif3.gguf 파일이 보여야 합니다.
NVIDIA H200에서 Motif-3를 효율적으로 로드·서빙하려면 ds4 런타임이 필요합니다.
dfm 브랜치를 클론합니다.
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
H200(Hopper, sm_90)용 CUDA 지원으로 컴파일합니다. ds4의 주요 타깃은 DGX Spark/GB10이며, H200 지원은 주된 서빙 경로가 아닌 프로젝트의 브링업 작업을 통해 제공된 점에 유의하세요.
make cuda CUDA_ARCH=sm_90 -j$(nproc)바이너리가 정상 생성되었는지 확인합니다.
ls -lh ds4*ds4-server, ds4_weight_server 등의 바이너리가 보여야 합니다.
웨이트 서버는 모델 가중치를 GPU에 로드·관리하여 API 서버가 추론에 사용할 수 있도록 합니다.
먼저 런타임 파일과 KV 캐시를 위한 디렉터리를 만듭니다.
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
전체 로드에 앞서 프리플라이트를 실행해 모델이 적합한지 확인합니다.
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
문제가 없으면 동일한 명령에서 --dry-run만 제거해 실행합니다.
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned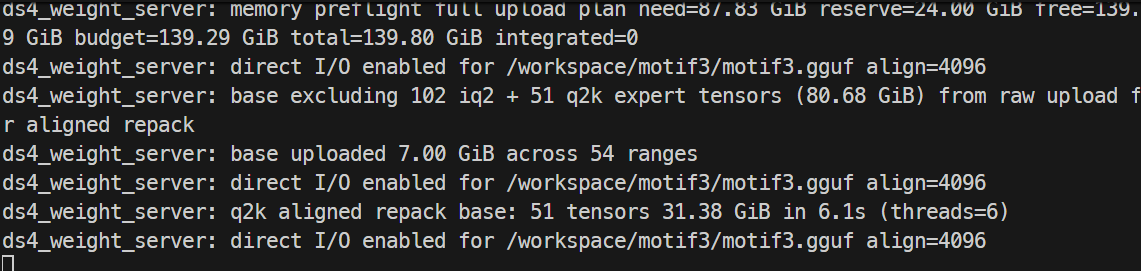
이 터미널은 계속 실행 상태로 두세요. Motif-3를 실행하는 동안 웨이트 서버가 활성 상태여야 합니다.
이제 ds4 API 서버를 시작합니다. 이 서버는 Motif-3를 OpenAI 호환 엔드포인트로 노출하며, 로컬 컴퓨터에서 접근할 수 있습니다.
다른 터미널을 열어 서버에 접속한 후 ds4 디렉터리로 이동합니다.
cd /workspace/motif3/ds4필수 환경 변수를 설정합니다.
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
컨텍스트 윈도우 125K로 API 서버를 시작합니다. H200에서 런타임은 128K까지 검증되었고 256K는 부분 프리필에만 도달했으므로, 125K는 검증 범위 내에 있습니다.
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768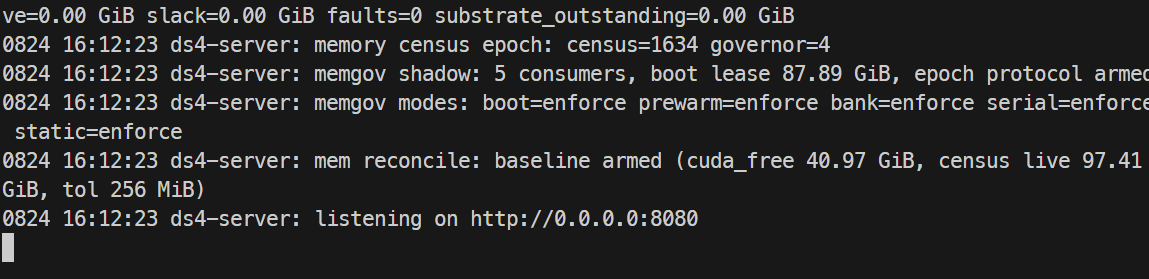
이 터미널도 실행 상태로 유지하세요.
앞서 SSH로 8080 포트를 포워딩했으므로, 이제 로컬 PC에서 터미널을 열고 API를 확인할 수 있습니다.
curl http://127.0.0.1:8080/v1/models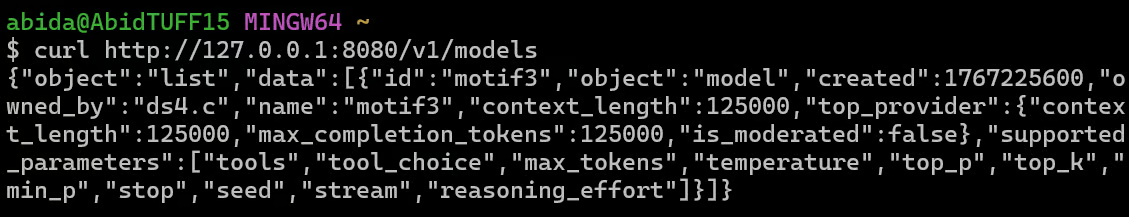
motif-3가 모델로 표시되고 컨텍스트 길이가 125000으로 나와야 합니다.
이제 첫 프롬프트를 전송해 보겠습니다.
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'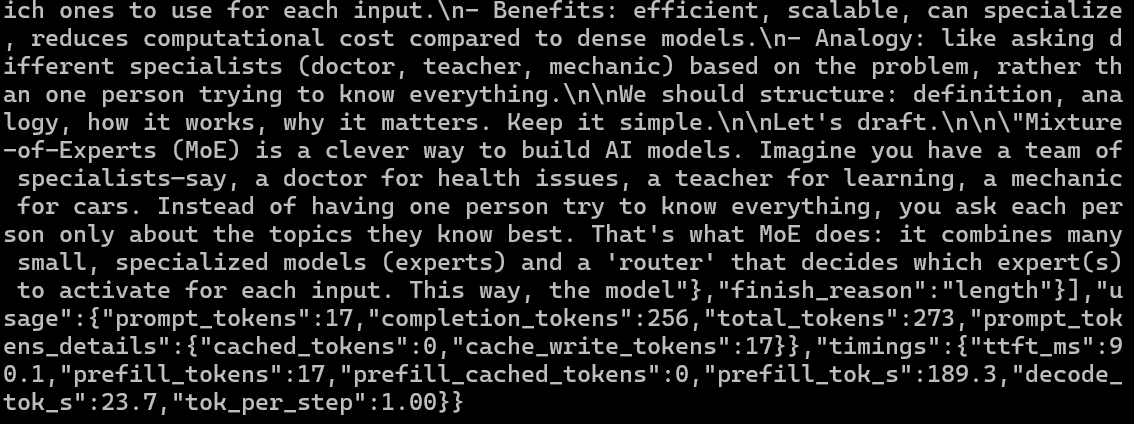
모든 설정이 제대로 되었으면 Motif-3가 H200에서 직접 응답을 생성합니다. 제 테스트에서는 다음과 같은 지표가 나왔습니다.
서버에서 GPU 메모리 사용량도 확인할 수 있습니다.
nvidia-smi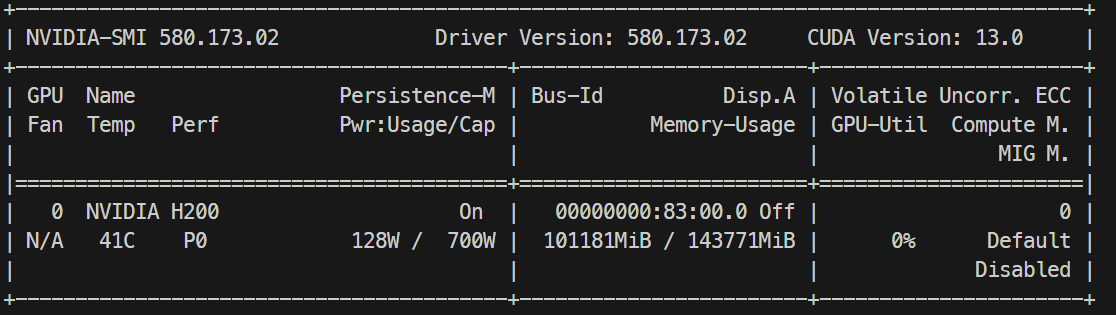
제 환경에서는 H200의 141GB 중 약 101GB의 GPU 메모리를 사용했고, 추론과 KV 캐시를 위한 추가 VRAM이 남았습니다.
이제 로컬 Motif-3 API를 Pi에 연결해, 파일 생성·명령 실행·프로젝트 반복 개선이 가능한 코딩 에이전트로 동작하도록 하겠습니다.
Motif-3가 다음 주소에서 사용 가능한지 확인하세요.
http://127.0.0.1:8080/v1공식 인스톨러로 Pi를 설치합니다.
curl -fsSL https://pi.dev/install.sh | sh터미널을 재시작한 뒤 설치를 확인합니다.
pi --versionPi는 ~/.pi/agent/models.json을 통해 사용자 지정 OpenAI 호환 모델을 지원합니다. 다음과 같이 설정 파일을 만드세요.
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOF이제 Motif-3에 실제 코딩 과제를 부여해, 애플리케이션을 자율적으로 빌드·실행·개선할 수 있는지 살펴보겠습니다.
테스트 프로젝트를 만들고 Pi를 시작합니다.
mkdir -p ~/motif-test
cd ~/motif-test
pi
모델을 테스트해 보겠습니다. 먼저 간단한 할 일 앱을 만들어 보라고 요청합니다.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.몇 분 안에 Motif-3가 작동하는 CLI 애플리케이션을 만들고 성공적으로 테스트했습니다. 기능은 잘 동작했지만 초기 인터페이스는 매우 기본적이었습니다.
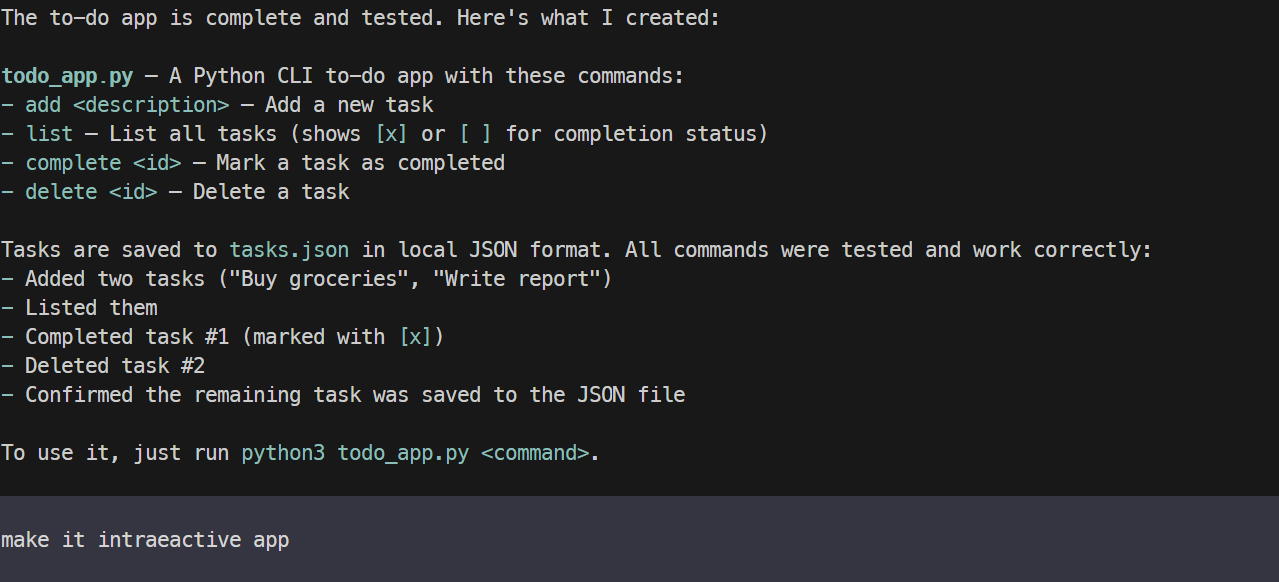
그 후 애플리케이션을 더 상호작용적으로, 더 컬러풀하게 만들고 레이아웃과 터미널 경험을 개선해 달라고 요청했습니다. Motif-3는 새로 시작하지 않고 기존 프로젝트를 수정했으며, 개선된 버전은 눈에 띄게 더 다듬어졌습니다.
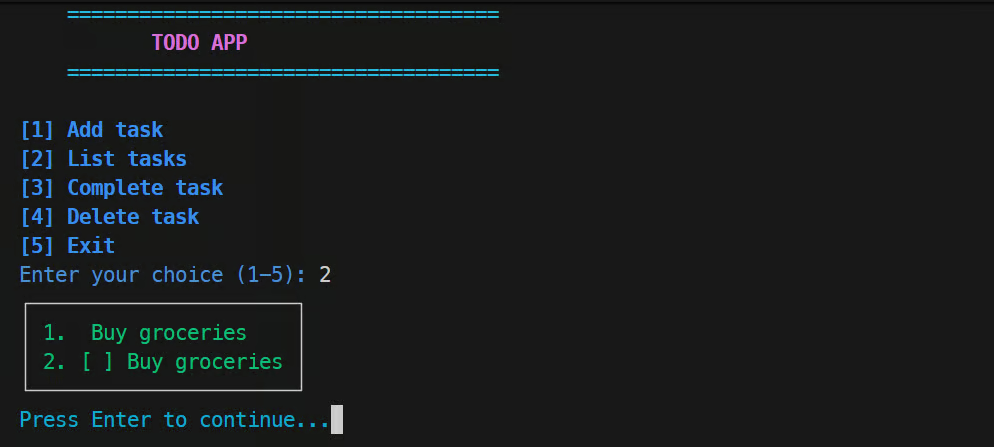
마지막으로, 시각적 요소가 많은 웹 개발 작업에서 Motif-3의 성능을 확인하고자 했습니다. 작동하는 웹사이트를 생성하는 것만이 전부는 아니니까요.
초기 애플리케이션은 동작했지만 마음에 들지 않는 UI 세부사항이 여럿 있었습니다. 모델에 한 번에 큰 리디자인 프롬프트를 주는 대신, 문제를 하나씩 고쳐가며 테스트 중인 개별 인터페이스 요소를 개선하도록 요청했습니다.
이 방법이 놀랍도록 잘 통했습니다. Motif-3는 기존 프로젝트를 살펴보고, 목표 지향적인 수정을 가하며, 애플리케이션의 기능을 유지한 채 UI를 반복적으로 다듬을 수 있었습니다.
전반적으로, 코딩 성능과 Pi를 통한 기존 프로젝트 반복 개선 능력 모두 인상적이었습니다.
전반적인 경험은 다소 혼합적이었습니다. Motif-3는 인상적이지만, 대부분의 사용자에게는 더 나은 성능 대비 적은 메모리를 요구하는 모델들이 있습니다.
혼합 양자화로 크기가 크게 줄었다고 해도, 쾌적하게 실행하려면 여전히 약 100GB 이상의 GPU 또는 합산 메모리가 필요합니다. 그런 이유로 Qwen3.8-27B 등 더 작고 실행이 훨씬 쉬운 코딩 특화 모델이 많습니다.
그럼에도, DeepSeek Flash 계열에 가까운 모델을 원한다면 Motif-3는 여전히 매우 흥미롭습니다. H200에서 빠르고, 코딩 품질도 좋으며, 더 나은 튜닝으로 추가 성능 향상을 기대할 수도 있습니다.
가장 큰 문제는 Pi 코딩 에이전트에서 생성이 가끔 중단되거나 끊기는 현상이었다는 점입니다. 출력 제한을 일부 늘려 개선되긴 했지만 완전히 해결되지는 않았습니다. DS4 런타임은 저도 처음이라, 앞으로 더 최적화할 부분이 남아 있을 것입니다.
그럼에도 한국에서 개발된 모델을 찾고 있거나 중국발 모델의 대안을 원한다면, 현재로서 꽤 흥미로운 선택지 중 하나입니다. 소수의 주요 공급자에만 의존하지 않고 더 많은 국가가 자체 AI 모델과 생태계를 구축하는 모습을 보는 것도 반갑습니다.
DataCamp로 AI를 배워보세요!
tracks
tracks
courses