
Cursus
Associate AI Engineer pour développeurs
26 h
Motif-3 est un modèle à grande échelle Mixture-of-Experts (MoE) de Motif Technologies, totalisant 314 milliards de paramètres tout en n’activant que 13,2 milliards de paramètres par token.
Il propose 384 experts routés, une fenêtre de contexte de 256K et a été entraîné sur environ 12,5 billions de tokens couvrant le code, les mathématiques, les STEM, des données multilingues et d’autres domaines.
Il est particulièrement adapté aux tâches de raisonnement, de codage et aux charges agentiques. Sur l’Artificial Analysis Intelligence Index, il atteint un score de 47, soit entre Qwen3.8-27B et MiniMax-M3, que nous avons testé dans une configuration similaire.
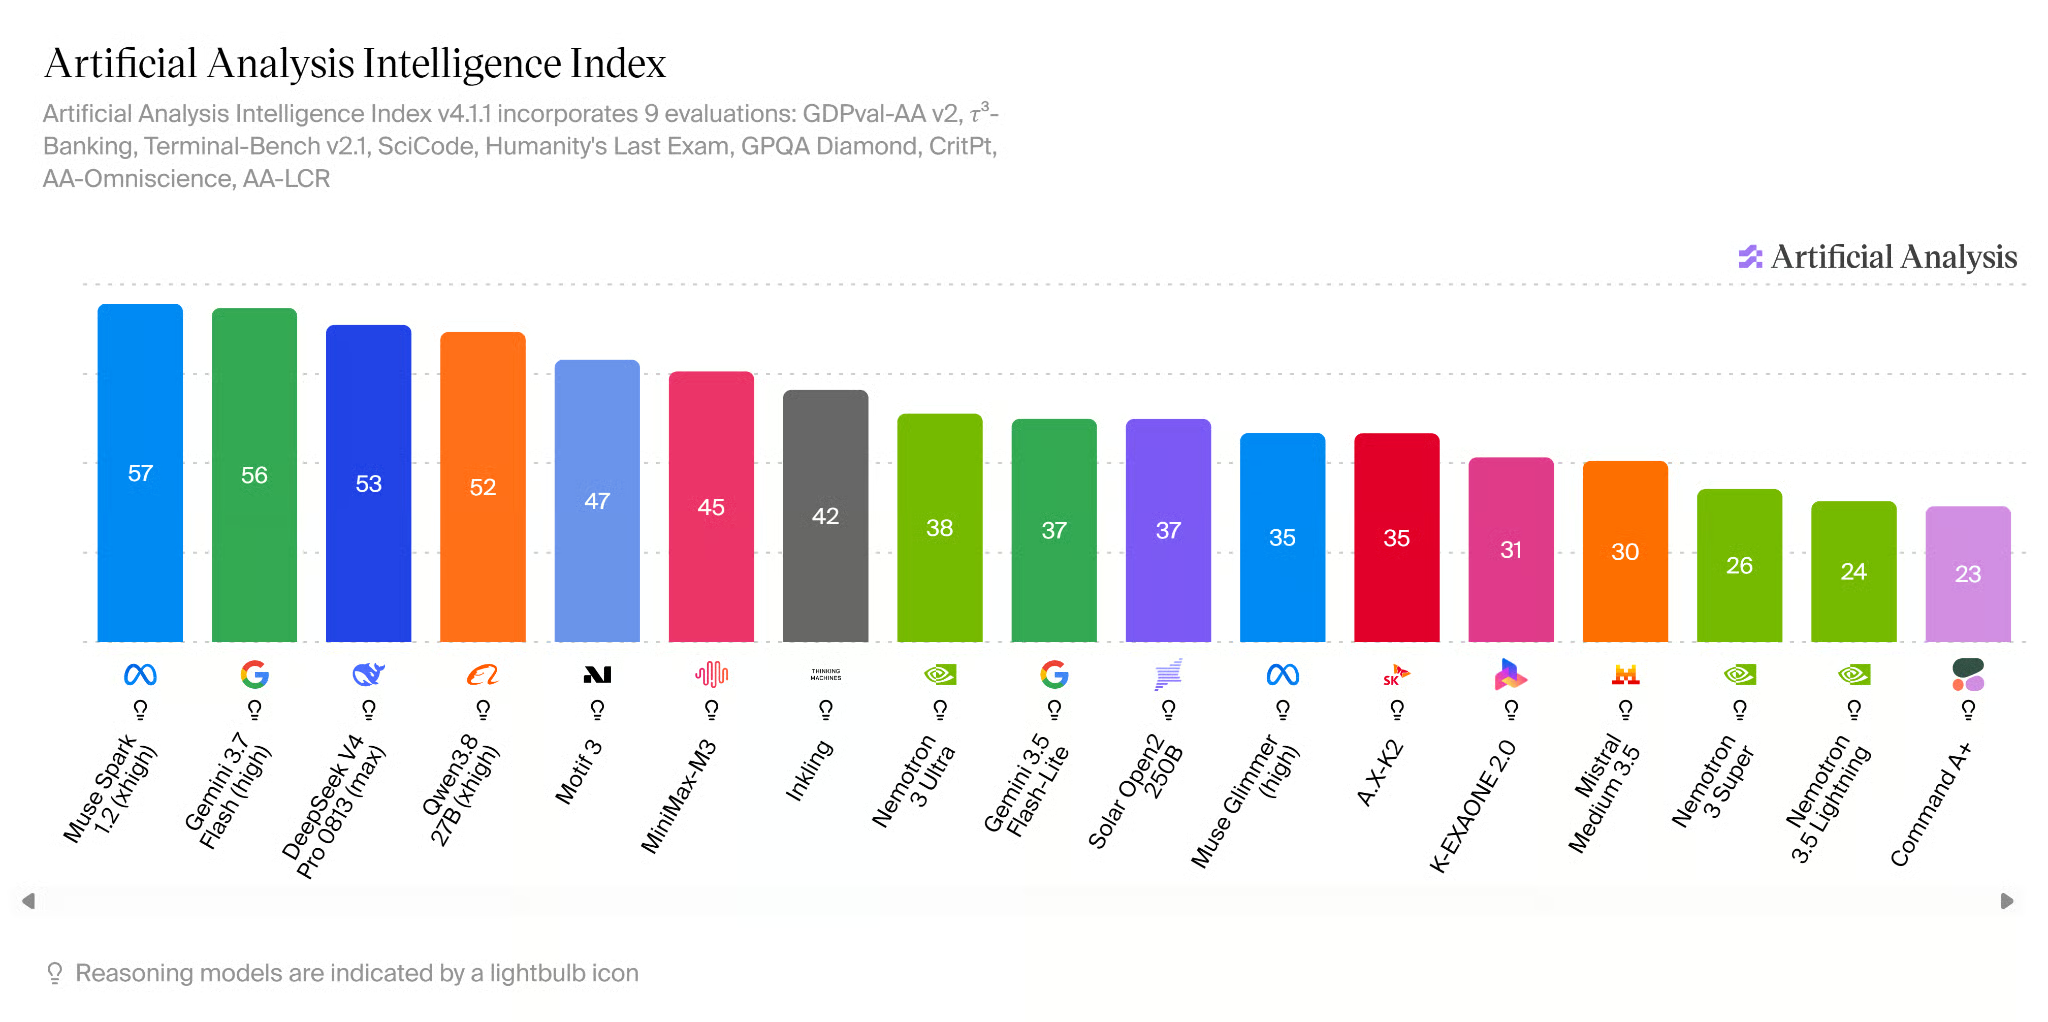
Source : AI Model & API Providers Analysis | Artificial Analysis
Pour ce guide, nous utilisons Baekpica/Motif-3-Mixed-Quant-GGUF, une version quantifiée de Motif-3 créée de manière indépendante. Au lieu d’une précision unique sur tout le modèle, il applique une quantification mixte, avec une précision plus élevée sur les composants critiques et beaucoup plus basse sur les couches d’experts massives.
Par exemple, l’attention et les composants toujours actifs utilisent Q8_0, tandis qu’une grande partie des poids d’experts routés utilisent IQ2_XXS et Q2_K. Le modèle conserve toujours les 384 experts et les 53 couches, rien n’est élagué ni supprimé. Cela ramène le modèle à environ 94 Go, contre environ 335 Go pour le GGUF en Q8_0, ce qui le rend suffisamment compact pour tourner entièrement sur une H200 de 141 Go, tout en laissant de la VRAM pour le runtime et le cache KV.
Pour aller plus loin, nous vous recommandons de lire nos guides sur la quantification des LLM et le format GGUF.
Motif-3 Mixed Quant pèse environ 94 Go, vous aurez donc besoin d’un GPU avec suffisamment de VRAM pour charger le modèle et garder de la marge pour l’inférence. Nous recommandons de louer une NVIDIA H200 unique avec 141 Go de VRAM auprès d’un fournisseur cloud GPU comme Hyperbolic, RunPod ou Vast.ai.
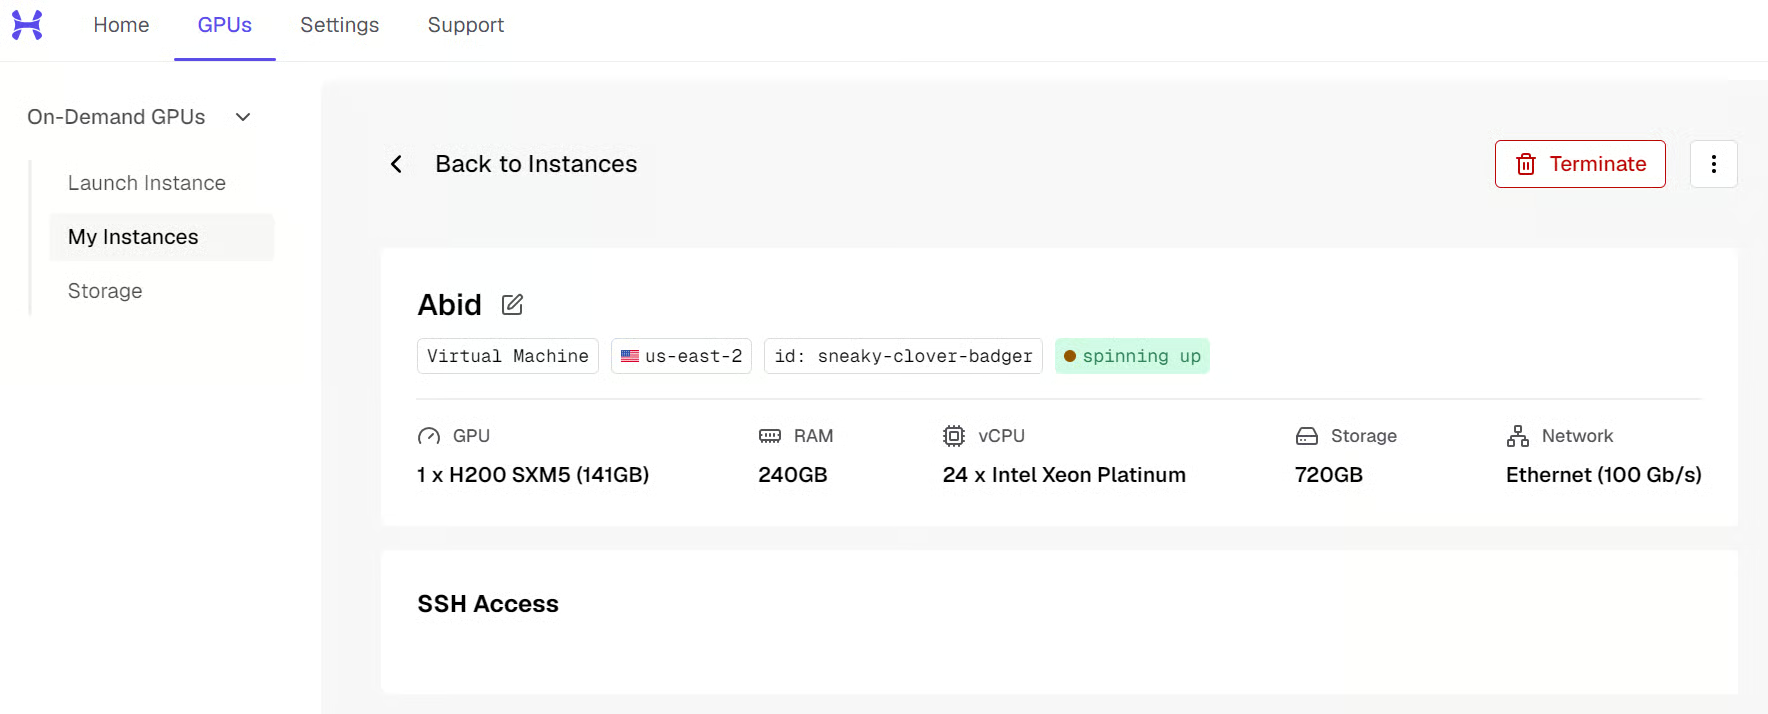
Une fois l’instance démarrée, connectez-vous depuis votre terminal ou via VS Code Remote SSH. Votre fournisseur vous transmettra l’adresse IP. La commande ressemblera à :
ssh root@<SERVER_IP> -L 8080:localhost:8080L’option -L 8080:localhost:8080 redirige également le port de l’API Motif-3 vers votre PC local, ce qui vous permettra ensuite d’y accéder sur http://127.0.0.1:8080.
Préparez maintenant le serveur :
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Enfin, vérifiez que la H200 est visible :
nvidia-smi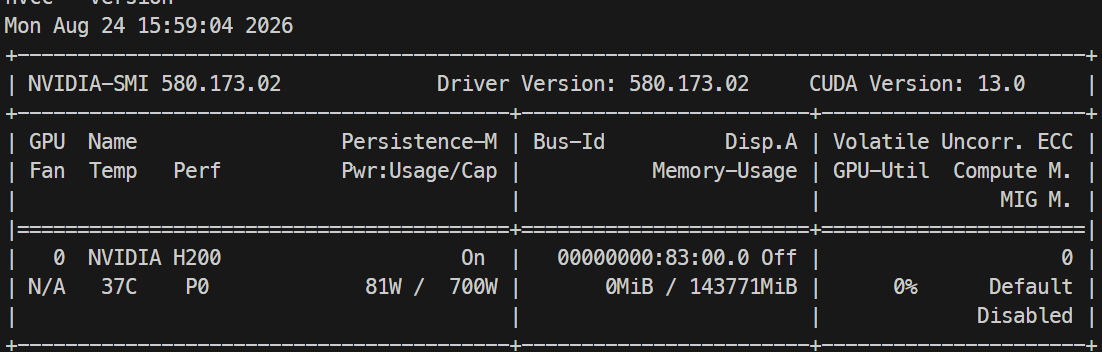
Vous devriez voir une NVIDIA H200 avec environ 141 Go de VRAM.
Téléchargez ensuite le modèle Baekpica/Motif-3-Mixed-Quant-GGUF depuis Hugging Face. Nous utilisons la variante MQ87-88-FIT, répartie en 11 fichiers GGUF pour une taille totale d’environ 94 Go.
Depuis le répertoire /workspace/motif3, exécutez :
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model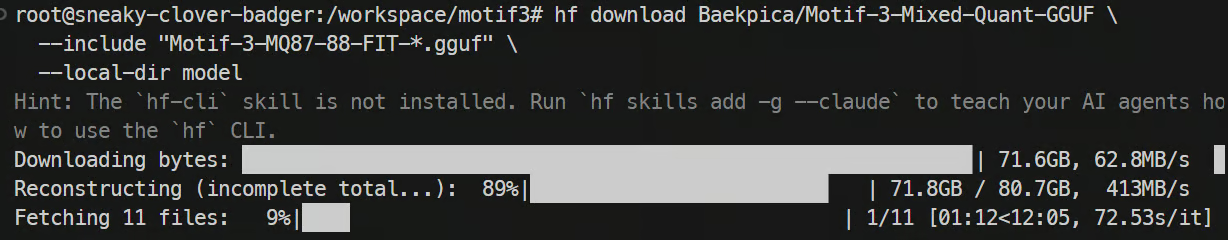
Selon votre connexion, le téléchargement des 94 Go peut prendre du temps. Une fois terminé, vérifiez que tous les shards sont présents :
ls -lh modelAvant la fusion, validez les shards. La fusion est une opération unique sur 94 Go, autant détecter un téléchargement corrompu dès maintenant :
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Le runtime ds4 attend le modèle sous forme d’un fichier GGUF unique, nous devons donc d’abord fusionner les 11 shards téléchargés.
Clonez llama.cpp et compilez son utilitaire GGUF :
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Fusionnez maintenant les 11 shards en un seul fichier :
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Contrôlez le modèle fusionné :
ls -lh motif3.ggufVous devriez voir un gros fichier motif3.gguf.
Nous avons besoin du runtime ds4 pour charger et servir Motif-3 efficacement sur la NVIDIA H200.
Clonez la branche dfm :
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compilez-la avec le support CUDA pour la H200 (Hopper, sm_90). Notez que la cible principale de ds4 est le DGX Spark/GB10, et que la prise en charge H200 provient des travaux d’amorçage du projet plutôt que du chemin de servitude principal :
make cuda CUDA_ARCH=sm_90 -j$(nproc)Vérifiez que les binaires ont bien été créés :
ls -lh ds4*Vous devriez voir des binaires comme ds4-server et ds4_weight_server.
Le weight server charge et gère les poids du modèle sur le GPU pour que le serveur d’API puisse les utiliser en inférence.
Créez d’abord les répertoires pour les fichiers runtime et le cache KV :
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Exécutez d’abord le pré-contrôle pour vérifier que le modèle tient avant de lancer le chargement complet :
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Si tout est OK, relancez la même commande sans --dry-run :
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned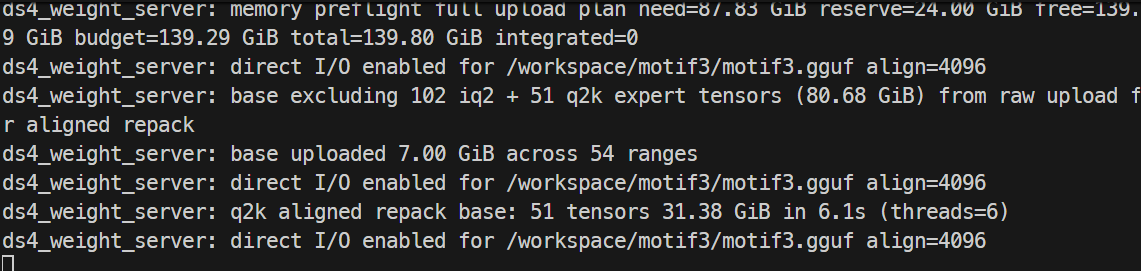
Laissez ce terminal ouvert. Le weight server doit rester actif pendant l’exécution de Motif-3.
Nous allons maintenant démarrer le serveur d’API ds4, qui expose Motif-3 via un endpoint compatible OpenAI accessible depuis votre ordinateur local.
Ouvrez un autre terminal, connectez-vous au serveur, puis placez-vous dans le répertoire ds4 :
cd /workspace/motif3/ds4Définissez les variables d’environnement requises :
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Démarrez le serveur d’API avec une fenêtre de contexte de 125K. Sur H200, le runtime est validé jusqu’à 128K, avec 256K limité à un prefill partiel, donc 125K reste dans la zone testée :
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768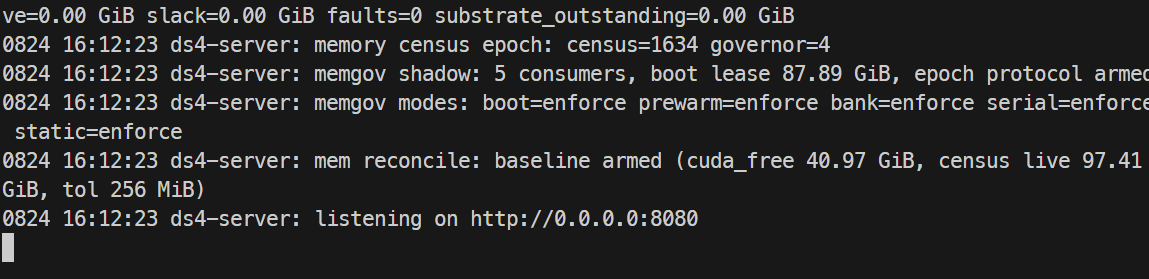
Laissez ce terminal ouvert.
Comme nous avons redirigé le port 8080 via SSH plus tôt, vous pouvez maintenant ouvrir un terminal sur votre PC local et interroger l’API :
curl http://127.0.0.1:8080/v1/models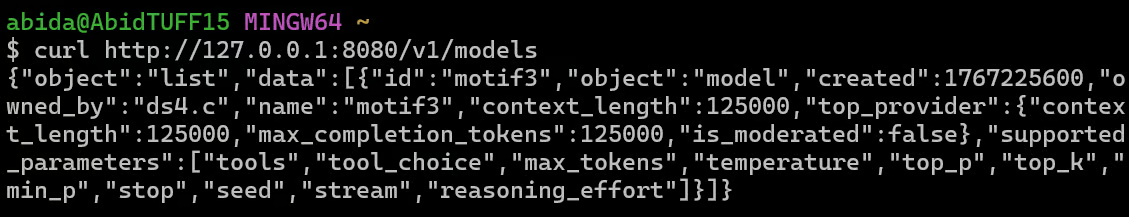
Vous devriez voir motif-3 listé comme modèle, avec une longueur de contexte de 125000.
Envoyez maintenant votre premier prompt :
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'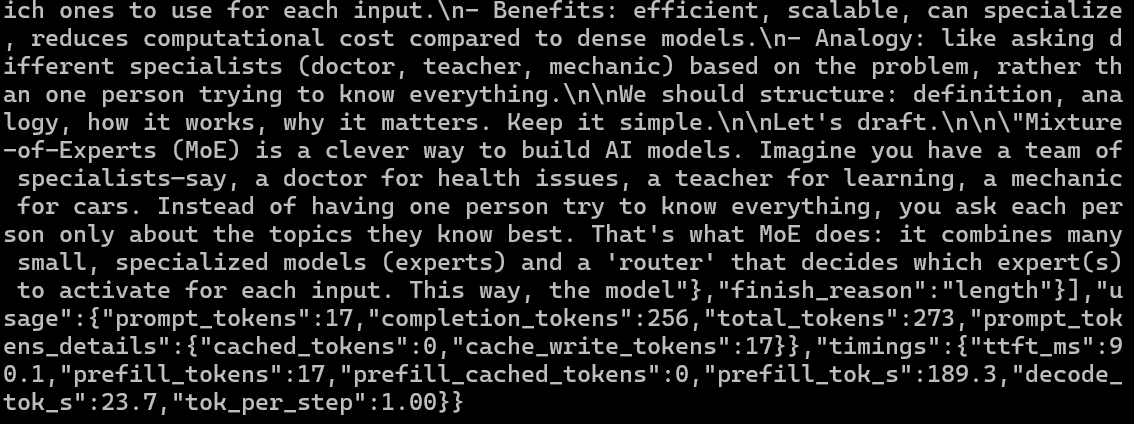
Si tout fonctionne, Motif-3 générera une réponse directement depuis votre H200. Dans mon test, le modèle a atteint les métriques suivantes :
Vous pouvez aussi vérifier l’utilisation mémoire GPU sur le serveur :
nvidia-smi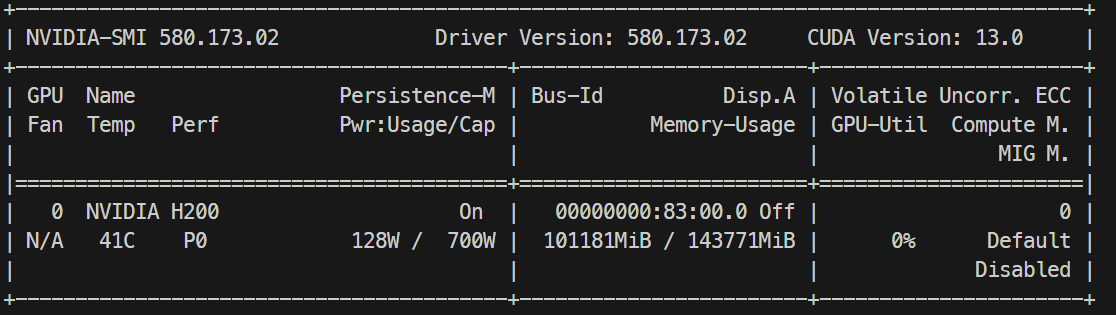
Dans ma configuration, Motif-3 a utilisé environ 101 Go des 141 Go de mémoire GPU reportés par la H200, laissant de la VRAM pour l’inférence et le cache KV.
Nous allons maintenant relier l’API locale de Motif-3 à Pi, afin que le modèle fonctionne comme un agent de code capable de créer des fichiers, d’exécuter des commandes et d’itérer sur un projet.
Assurez-vous que Motif-3 est toujours disponible à l’adresse :
http://127.0.0.1:8080/v1Installez Pi via l’installeur officiel :
curl -fsSL https://pi.dev/install.sh | shRedémarrez votre terminal, puis confirmez l’installation :
pi --versionPi prend en charge les modèles personnalisés compatibles OpenAI via ~/.pi/agent/models.json. Créez la configuration :
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFNous pouvons maintenant confier à Motif-3 une vraie tâche de développement et vérifier s’il peut créer, exécuter et améliorer une application de manière autonome.
Créez un projet de test et lancez Pi :
mkdir -p ~/motif-test
cd ~/motif-test
pi
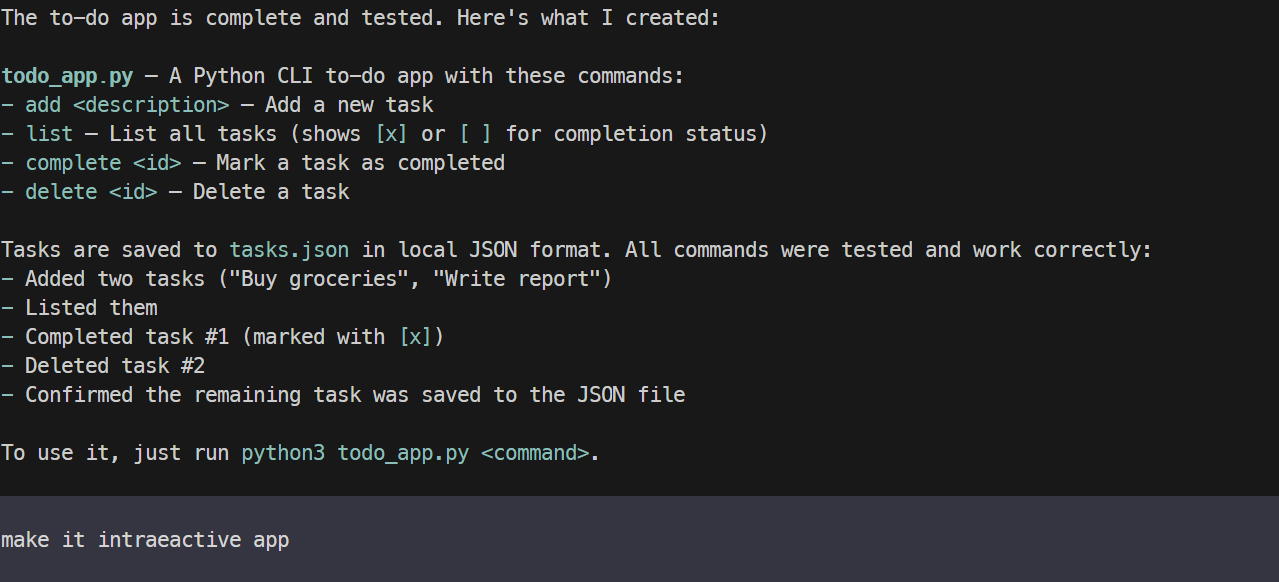
Testons le modèle. Nous allons d’abord lui demander de créer une application to-do simple.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.En quelques minutes, Motif-3 a créé une application CLI fonctionnelle et l’a testée avec succès. La logique était solide, mais l’interface initiale restait très basique.
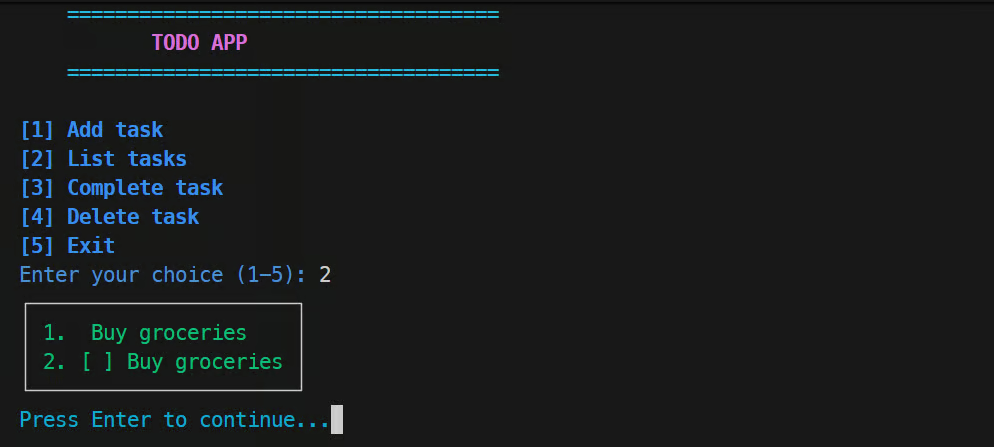
J’ai ensuite demandé à l’agent de rendre l’application plus interactive et colorée, d’améliorer la mise en page et l’expérience terminal. Motif-3 a modifié le projet existant plutôt que de repartir de zéro, et la version améliorée était nettement plus soignée.
Enfin, je voulais voir la performance de Motif-3 sur une tâche de développement web plus visuelle, où générer un site fonctionnel n’est qu’une partie du défi.
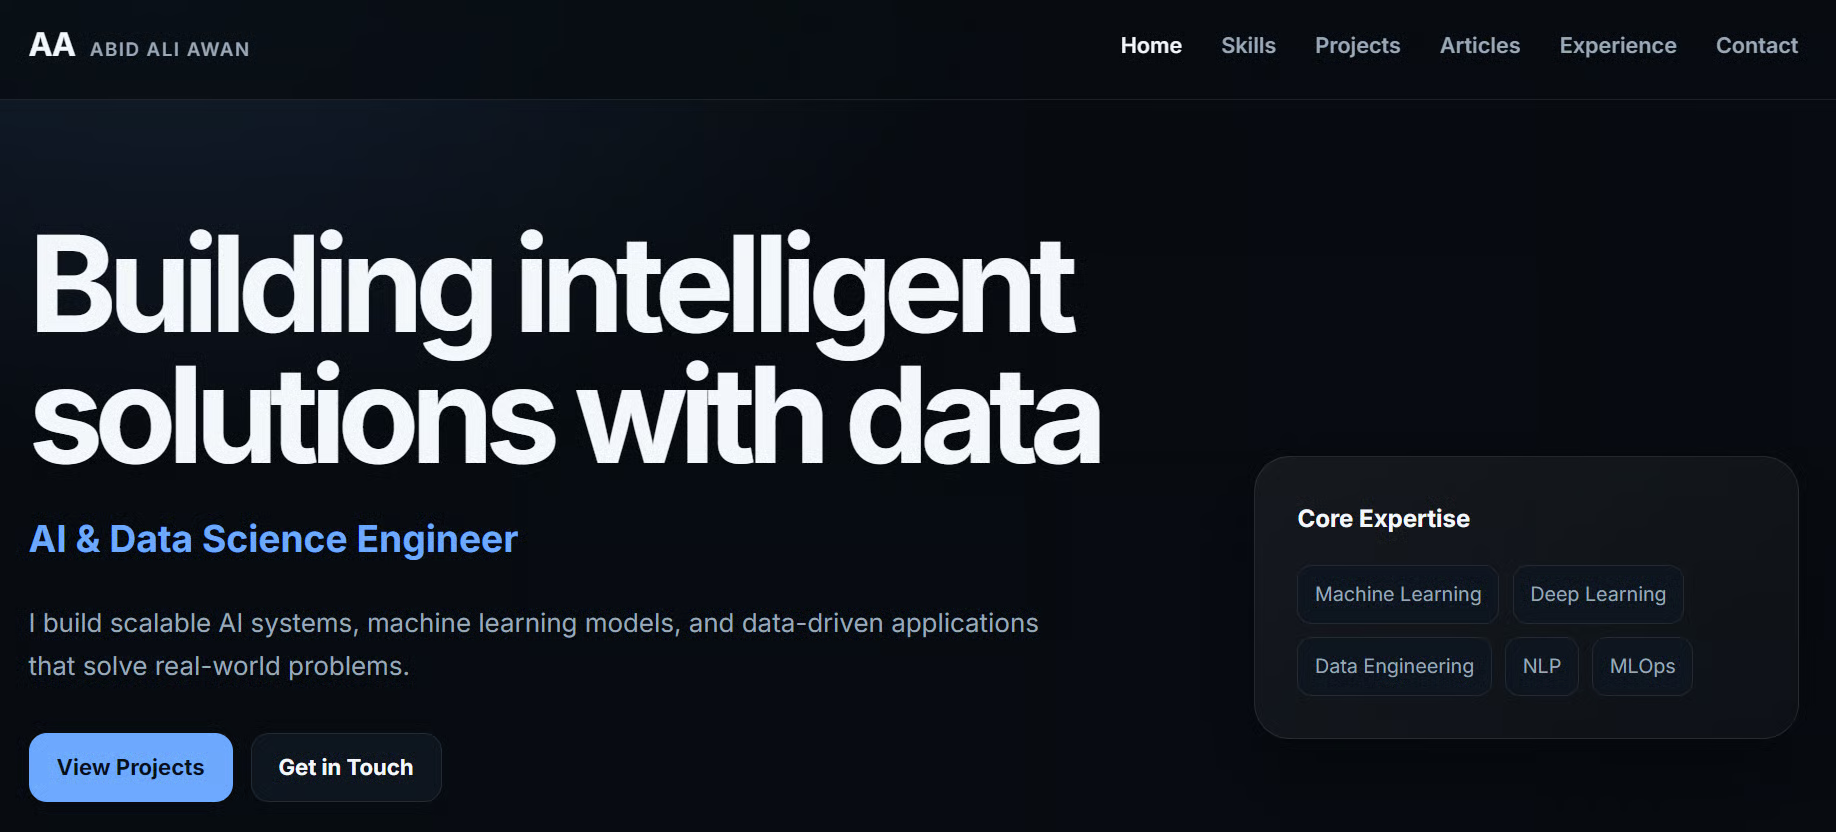
L’application initiale fonctionnait, mais plusieurs détails d’interface ne me convenaient pas. Plutôt que d’envoyer un unique prompt de refonte globale, je lui ai demandé de corriger les points un par un, en améliorant des éléments précis au fil des tests.
Cela a étonnamment bien marché. Motif-3 a su analyser le projet existant, apporter des modifications ciblées et affiner l’UI de façon itérative tout en gardant l’application pleinement fonctionnelle.
Globalement, j’ai été impressionné à la fois par ses capacités de codage et par sa faculté à itérer sur un projet existant via Pi.
Au final, mon expérience est un peu nuancée. Motif-3 est impressionnant, mais pour la plupart des cas, il existe des modèles plus légers et moins gourmands en mémoire.
Même avec la quantification mixte, qui réduit fortement la taille, il faut encore environ 100 Go ou plus de mémoire GPU (ou combinée) pour l’exécuter confortablement. Pour cette raison, de nombreux modèles plus petits sont bien plus simples à faire tourner, comme Qwen3.8-27B et d’autres modèles orientés code.
Cela dit, si vous cherchez quelque chose qui se rapproche de la classe DeepSeek Flash de modèles, Motif-3 reste très intéressant. Il est rapide sur H200, la qualité de code est bonne, et vous pouvez probablement en tirer davantage avec de meilleurs réglages.
Le principal souci que j’ai rencontré vient de l’agent de code Pi, où la génération s’arrêtait parfois ou était interrompue. J’ai relevé certaines limites de sortie, ce qui a aidé, sans toutefois résoudre complètement le problème. C’est aussi ma première utilisation du runtime DS4, il y a donc certainement encore des optimisations possibles.
Malgré tout, si vous recherchez spécifiquement un modèle développé en Corée, ou une alternative aux modèles développés en Chine, c’est l’une des options les plus intéressantes du moment. Et c’est encourageant de voir davantage de pays créer leurs propres modèles et écosystèmes d’IA, plutôt que de dépendre de quelques grands fournisseurs.
Apprenez l’IA avec DataCamp !
Cursus
Cursus
Cours