track
Inginer AI asociat pentru dezvoltatori
26 oră
Motif-3 este un model la scară largă Mixture-of-Experts (MoE) de la Motif Technologies, construit cu 314B parametri în total, activând doar 13,2B parametri per token.
Are 384 de experți rutați, o fereastră de context de 256K și a fost antrenat pe aproximativ 12,5 trilioane de tokeni care acoperă cod, matematică, STEM, date multilingve și alte domenii.
Este în mod special potrivit pentru raționament, programare și workload-uri agentice. Pe Artificial Analysis Intelligence Index, atinge un scor de 47, ceea ce îl plasează între Qwen3.8-27B și MiniMax-M3, pe care l-am testat într-o configurație similară.
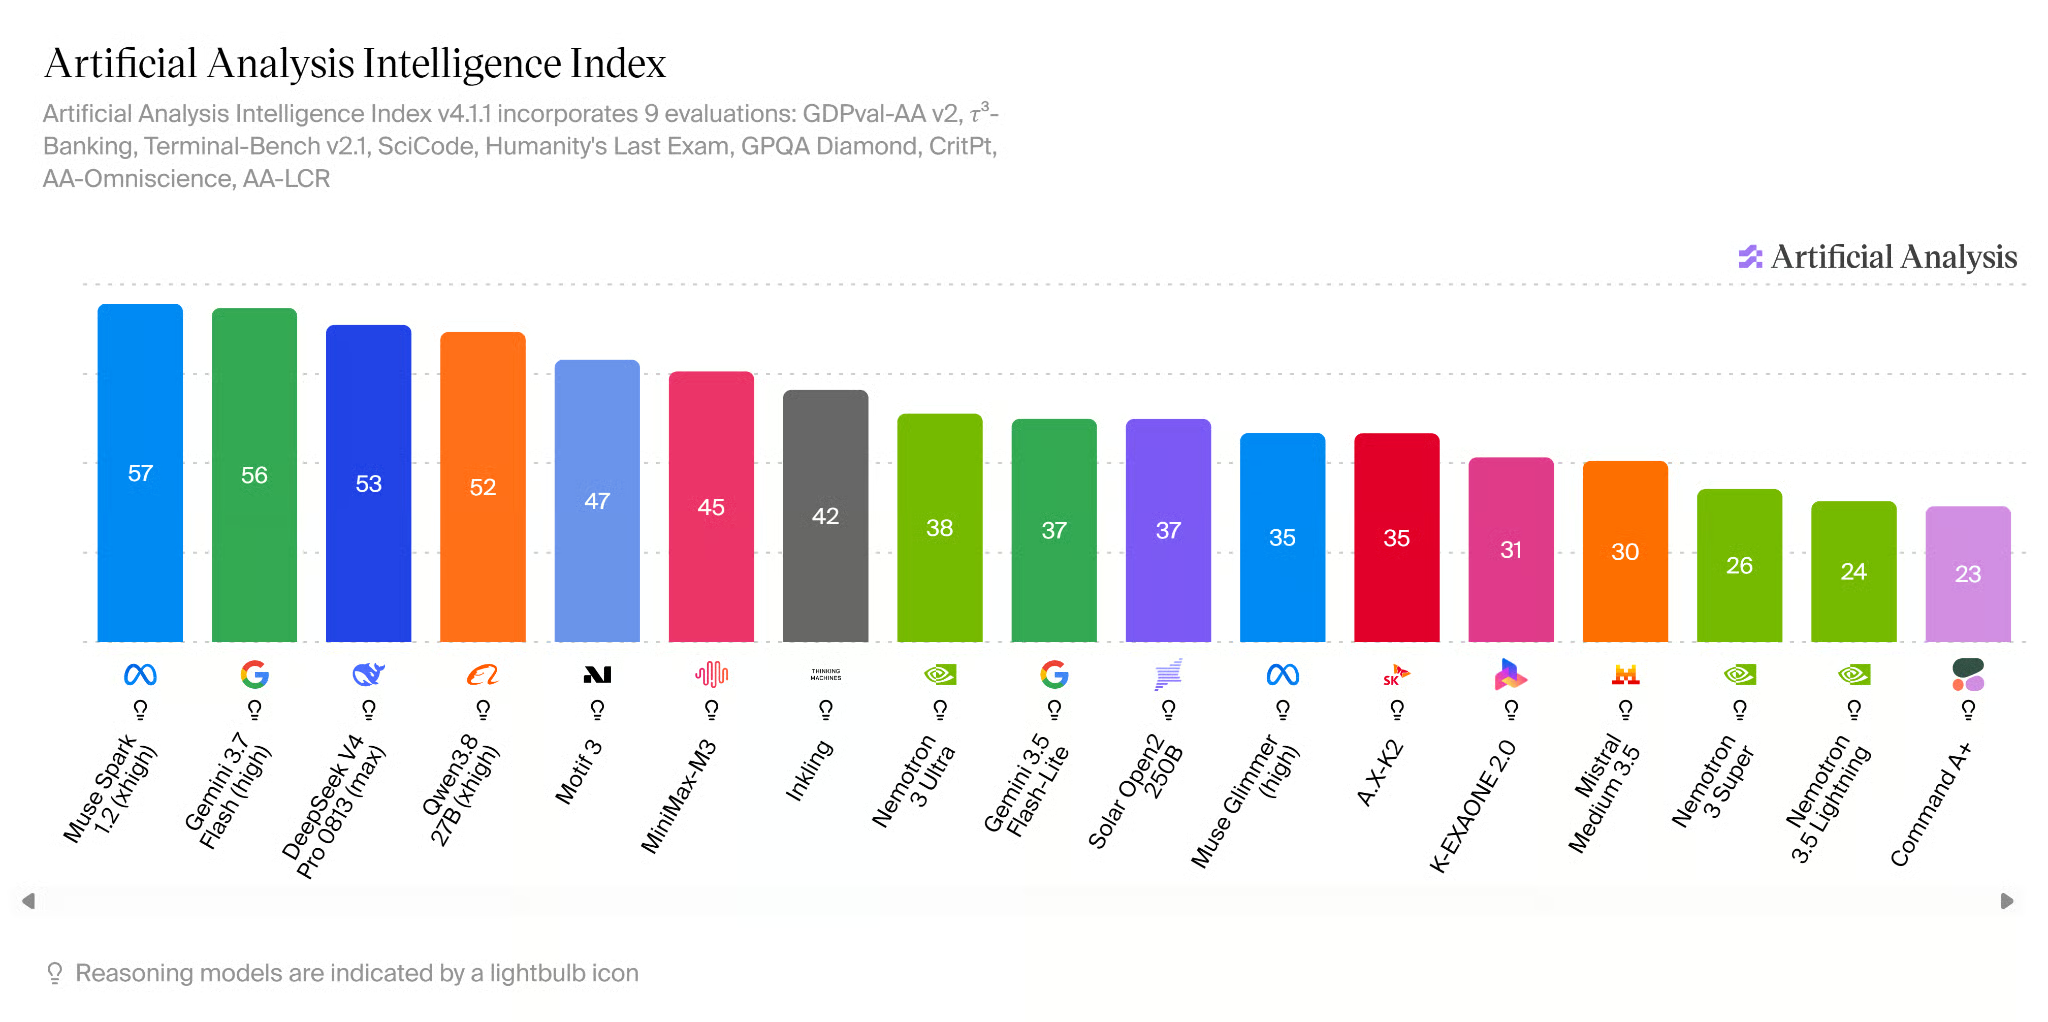
Sursă: AI Model & API Providers Analysis | Artificial Analysis
Pentru acest ghid, folosim Baekpica/Motif-3-Mixed-Quant-GGUF, o versiune cuantizată creată independent a lui Motif-3. În loc să folosească un singur nivel de precizie pentru întregul model, utilizează cuantizare mixtă, aplicând o precizie mai mare componentelor importante și o precizie mult mai mică straturilor uriașe de experți.
De exemplu, componentele importante de atenție și cele mereu active folosesc Q8_0, în timp ce o mare parte din greutățile experților rutați folosesc IQ2_XXS și Q2_K. Modelul păstrează în continuare toți cei 384 de experți și toate cele 53 de straturi, deci nimic nu este tăiat sau eliminat. Acest lucru reduce modelul la aproximativ 94 GB, comparativ cu circa 335 GB pentru Q8_0 GGUF, făcându-l suficient de mic pentru a rula integral pe un H200 de 141 GB, cu VRAM suplimentar disponibil pentru runtime și cache-ul KV.
Pentru mai multe informații de fundal, îți recomand să citești ghidurile noastre despre cuantizarea pentru LLM-uri și formatul GGUF.
Motif-3 Mixed Quant are în jur de 94 GB, deci vei avea nevoie de un GPU cu suficient VRAM pentru a încărca modelul și a lăsa loc pentru inferență. Îți recomand să închiriezi un singur NVIDIA H200 cu 141 GB VRAM de la un furnizor de cloud GPU precum Hyperbolic, RunPod sau Vast.ai.
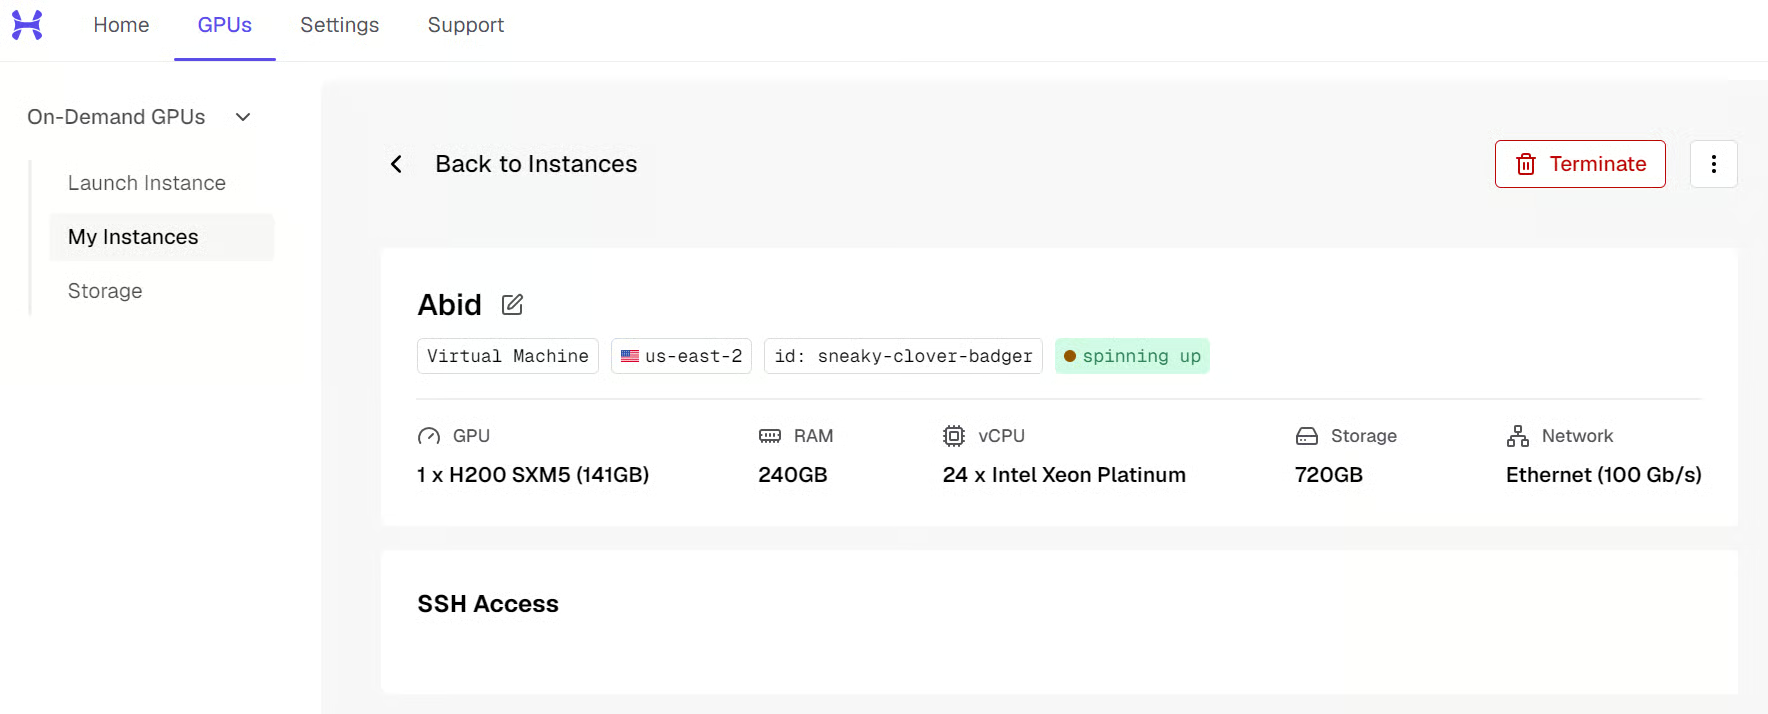
După ce instanța rulează, conectează-te la ea din terminal sau prin VS Code Remote SSH. Furnizorul îți va da adresa IP. Comanda va arăta similar cu:
ssh root@<SERVER_IP> -L 8080:localhost:8080Opțiunea -L 8080:localhost:8080 redirecționează și portul API-ului Motif-3 către PC-ul tău local, astfel încât mai târziu îl poți accesa la http://127.0.0.1:8080.
Acum pregătește serverul:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
În final, verifică dacă H200 este disponibil:
nvidia-smi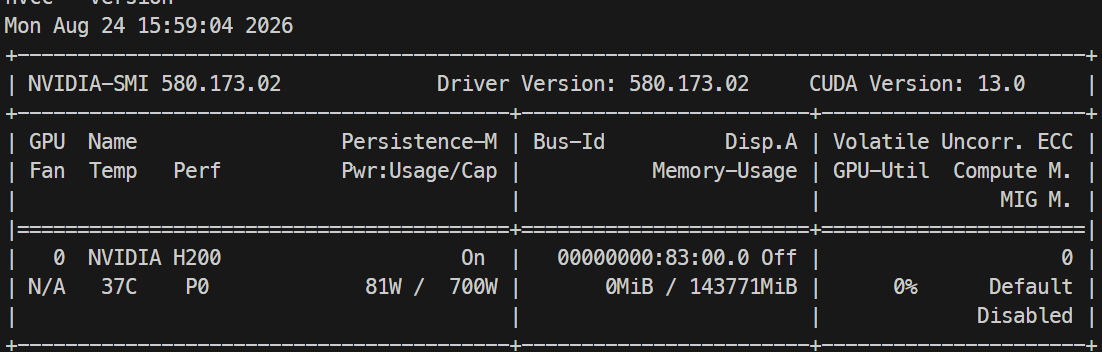
Ar trebui să vezi un NVIDIA H200 cu aproximativ 141 GB de VRAM.
În continuare, descarcă modelul Baekpica/Motif-3-Mixed-Quant-GGUF de pe Hugging Face. Folosim varianta MQ87-88-FIT, care este împărțită în 11 fișiere GGUF cu o dimensiune combinată de aproximativ 94 GB.
Din directorul /workspace/motif3, rulează:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model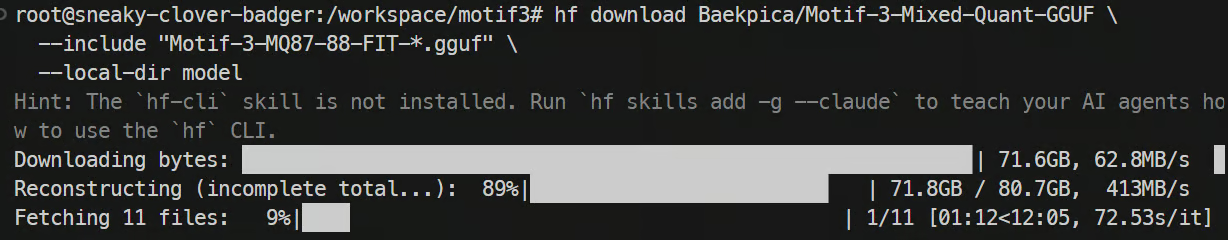
În funcție de conexiune, descărcarea celor 94 GB poate dura ceva timp. După finalizare, verifică dacă toate shard-urile sunt disponibile:
ls -lh modelÎnainte de îmbinare, verifică shard-urile. Îmbinarea este o operațiune unică pe 94 GB, deci merită să depistezi acum un download corupt:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Runtime-ul ds4 așteaptă modelul ca un singur fișier GGUF, așa că trebuie mai întâi să îmbinăm cele 11 shard-uri descărcate.
Clonează llama.cpp și construiește utilitarul GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Acum îmbină toate cele 11 shard-uri într-un singur fișier:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Verifică modelul îmbinat:
ls -lh motif3.ggufAr trebui să vezi un fișier mare motif3.gguf.
Avem nevoie de runtime-ul ds4 pentru a încărca și servi eficient Motif-3 pe NVIDIA H200.
Clonează ramura dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compileaz-o cu suport CUDA pentru H200 (Hopper, sm_90). Reține că ținta principală a ds4 este DGX Spark/GB10, iar suportul pentru H200 vine din munca de bring-up a proiectului, nu din calea sa principală de servire:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Verifică faptul că binarele au fost create cu succes:
ls -lh ds4*Ar trebui să vezi binare precum ds4-server și ds4_weight_server.
Weight server-ul încarcă și gestionează greutățile modelului pe GPU, astfel încât serverul API să le poată folosi pentru inferență.
Mai întâi, creează directoare pentru fișierele runtime și cache-ul KV:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Rulează preflight-ul mai întâi pentru a verifica dacă modelul va încăpea, înainte de a porni încărcarea completă:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Dacă trece, rulează aceeași comandă din nou fără --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned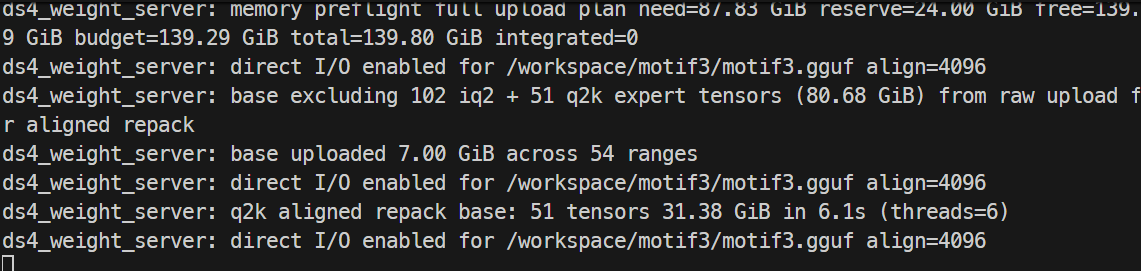
Păstrează acest terminal deschis. Weight server-ul trebuie să rămână activ cât timp rulezi Motif-3.
Acum vom porni serverul API ds4, care expune Motif-3 printr-un endpoint compatibil cu OpenAI pe care îl poți accesa de pe calculatorul tău local.
Deschide un alt terminal și conectează-te la server, apoi intră în directorul ds4:
cd /workspace/motif3/ds4Setează variabilele de mediu necesare:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Pornește serverul API cu o fereastră de context de 125K. Pe H200, runtime-ul este validat până la 128K, cu 256K ajungând doar la prefill parțial, așa că 125K se află chiar în zona testată:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768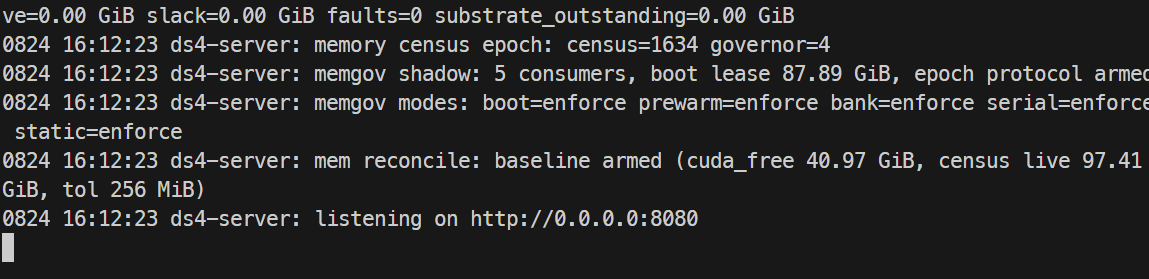
Păstrează acest terminal deschis.
Deoarece am redirecționat anterior portul 8080 prin SSH, acum poți deschide un terminal pe PC-ul tău local și să verifici API-ul:
curl http://127.0.0.1:8080/v1/models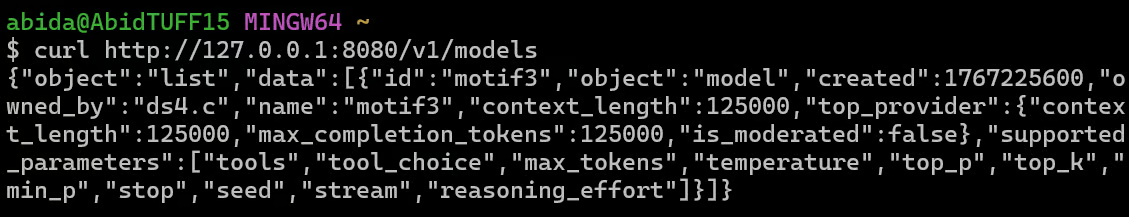
Ar trebui să vezi motif-3 listat ca model, cu o lungime a contextului de 125000.
Acum trimite primul tău prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'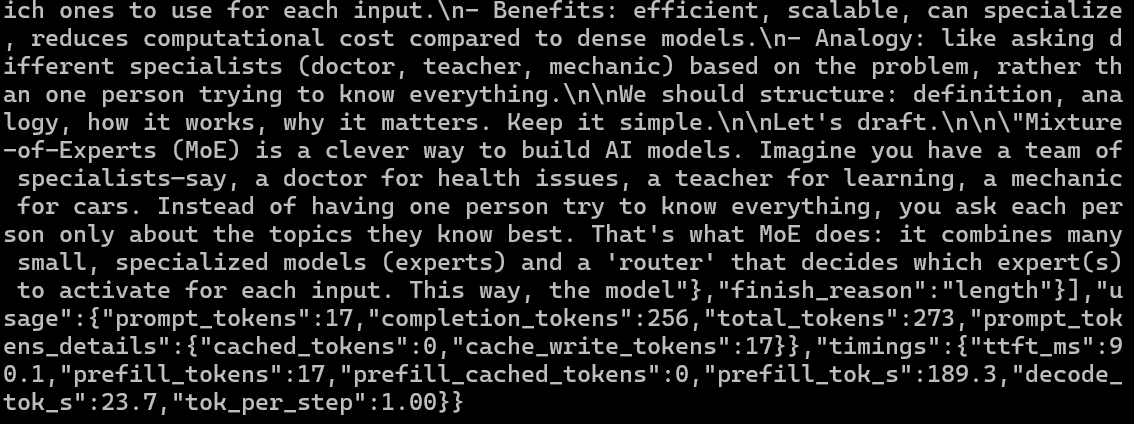
Dacă totul funcționează, Motif-3 va genera un răspuns direct de pe H200-ul tău. În testul meu, modelul a obținut următoarele valori:
Poți verifica și utilizarea memoriei GPU pe server:
nvidia-smi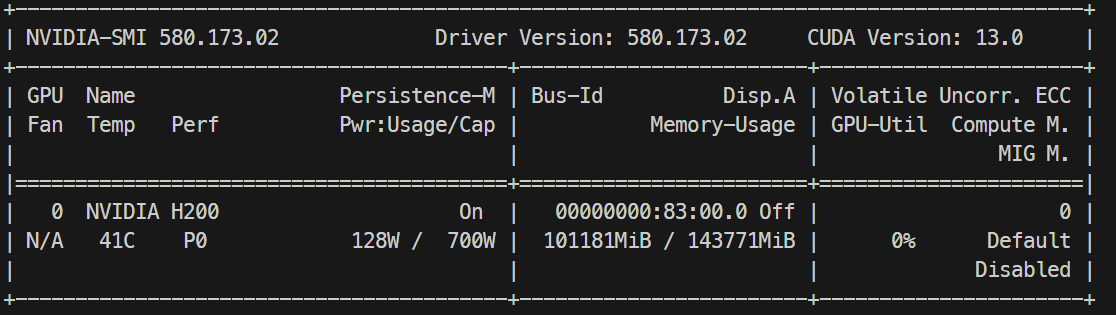
În configurația mea, Motif-3 a folosit aproximativ 101 GB din cei 141 GB de memorie GPU raportați ai H200, lăsând VRAM suplimentar disponibil pentru inferență și cache-ul KV.
Acum vom conecta API-ul local Motif-3 la Pi, permițând modelului să funcționeze ca un agent de codare care poate crea fișiere, rula comenzi și itera pe un proiect.
Asigură-te că Motif-3 este încă disponibil la:
http://127.0.0.1:8080/v1Instalează Pi folosind instalatorul oficial:
curl -fsSL https://pi.dev/install.sh | shRepornește terminalul, apoi confirmă instalarea:
pi --versionPi suportă modele personalizate compatibile cu OpenAI prin ~/.pi/agent/models.json. Creează configurația:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFAcum îi putem da lui Motif-3 o sarcină reală de codare și să vedem dacă poate construi, rula și îmbunătăți autonom o aplicație.
Creează un proiect de test și pornește Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
Hai să testăm modelul. Mai întâi, îi vom cere să construiască o aplicație simplă de to-do.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.În câteva minute, Motif-3 a creat o aplicație CLI funcțională și a testat-o cu succes. Funcționalitatea a fost bună, dar interfața inițială era foarte de bază.
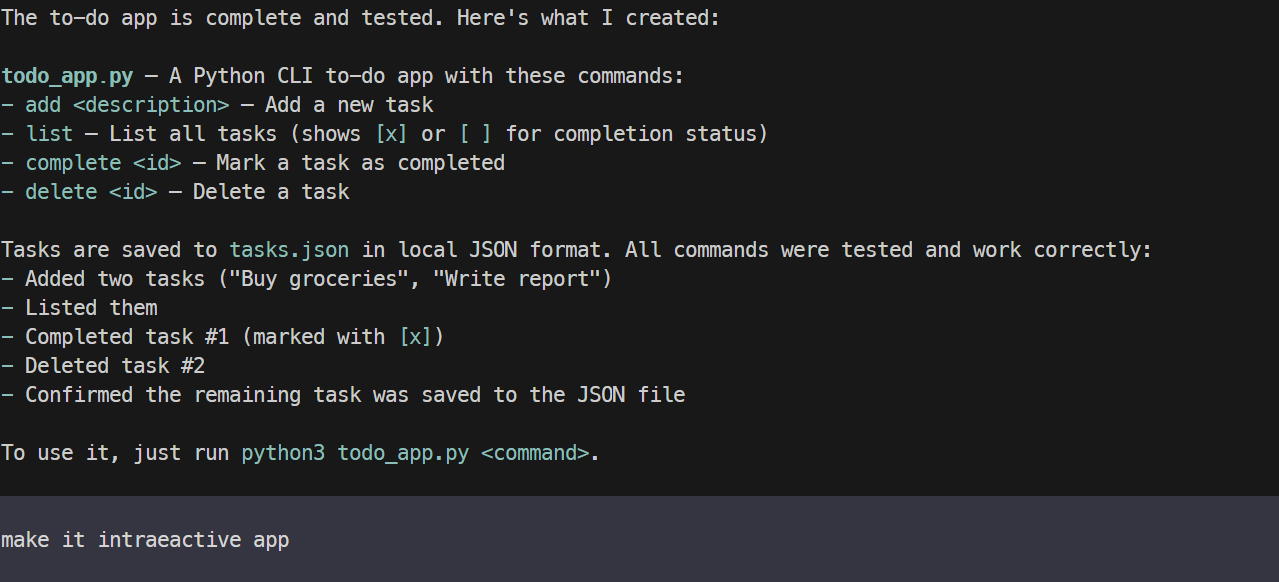
Apoi i-am cerut agentului să facă aplicația mai interactivă și colorată, să îmbunătățească layout-ul și experiența din terminal. Motif-3 a modificat proiectul existent în loc să o ia de la capăt, iar versiunea îmbunătățită a fost considerabil mai finisată.
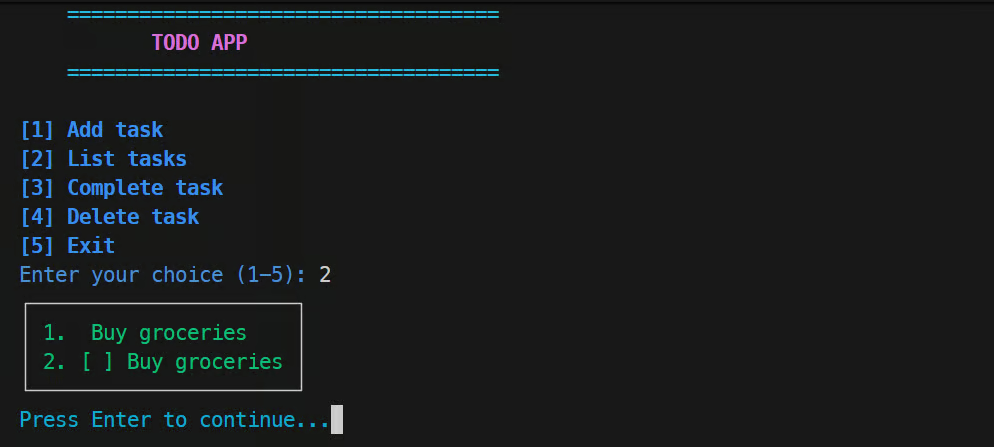
În final, am vrut să văd cum se descurcă Motif-3 într-o sarcină web mai vizuală, unde generarea unui site funcțional este doar o parte a provocării.
Aplicația inițială a funcționat, dar existau câteva detalii de UI care nu mi-au plăcut. În loc să dau modelului un singur prompt uriaș de redesign, i-am cerut să rezolve problemele pe rând, îmbunătățind părți individuale ale interfeței pe măsură ce le testam.
A funcționat surprinzător de bine. Motif-3 a putut inspecta proiectul existent, a făcut schimbări țintite și a rafinat UI-ul în mod repetat, menținând aplicația funcțională.
Per total, m-a impresionat atât performanța în codare, cât și abilitatea de a itera pe un proiect existent prin Pi.
Per total, experiența mea a fost puțin mixtă. Motif-3 este impresionant, dar există modele mai bune și mai puțin costisitoare ca memorie pe care le pot rula majoritatea oamenilor.
Chiar și cu cuantizarea mixtă, care reduce mult dimensiunea, tot ai nevoie de aproximativ 100 GB sau mai mult de memorie GPU sau combinată pentru a-l rula confortabil. Din cauza asta, există multe modele mai mici, mult mai ușor de rulat, precum Qwen3.8-27B și alte modele orientate pe codare.
Asta fiind spus, dacă vrei ceva mai aproape de clasa DeepSeek Flash a modelelor, Motif-3 rămâne foarte interesant. Este rapid pe un H200, calitatea codului este bună și probabil poți scoate mai multă performanță din el cu un tuning mai bun.
Problema principală pe care am avut-o a fost cu agentul de codare Pi, unde generarea se oprea uneori sau era întreruptă. Am mărit unele limite de output și a ajutat, dar nu a rezolvat complet problema. Este și prima mea utilizare a runtime-ului DS4, deci probabil că mai am ce optimiza pe viitor.
Totuși, dacă cauți în mod specific un model dezvoltat în Coreea sau vrei o alternativă la modelele dezvoltate în China, acesta este una dintre opțiunile mai interesante în acest moment. E, de asemenea, tare să vedem mai multe țări construindu-și propriile modele și ecosisteme de AI, în loc să depindă doar de câțiva furnizori mari.
Învăță AI cu DataCamp!
track
track
course