
Leerpad
Associate AI Engineer voor ontwikkelaars
26 Hr
Motif-3 is een grootschalig Mixture-of-Experts (MoE)-model van Motif Technologies, gebouwd met in totaal 314B parameters terwijl slechts 13,2B parameters per token worden geactiveerd.
Het bevat 384 gerouteerde experts, een contextvenster van 256K en is getraind op ongeveer 12,5 biljoen tokens met code, wiskunde, STEM, meertalige data en andere domeinen.
Het is vooral geschikt voor reasoning-, coding- en agentic-workloads. Op de Artificial Analysis Intelligence Index behaalt het een score van 47, wat het plaatst tussen Qwen3.8-27B en MiniMax-M3, die we in een vergelijkbare setup hebben getest.
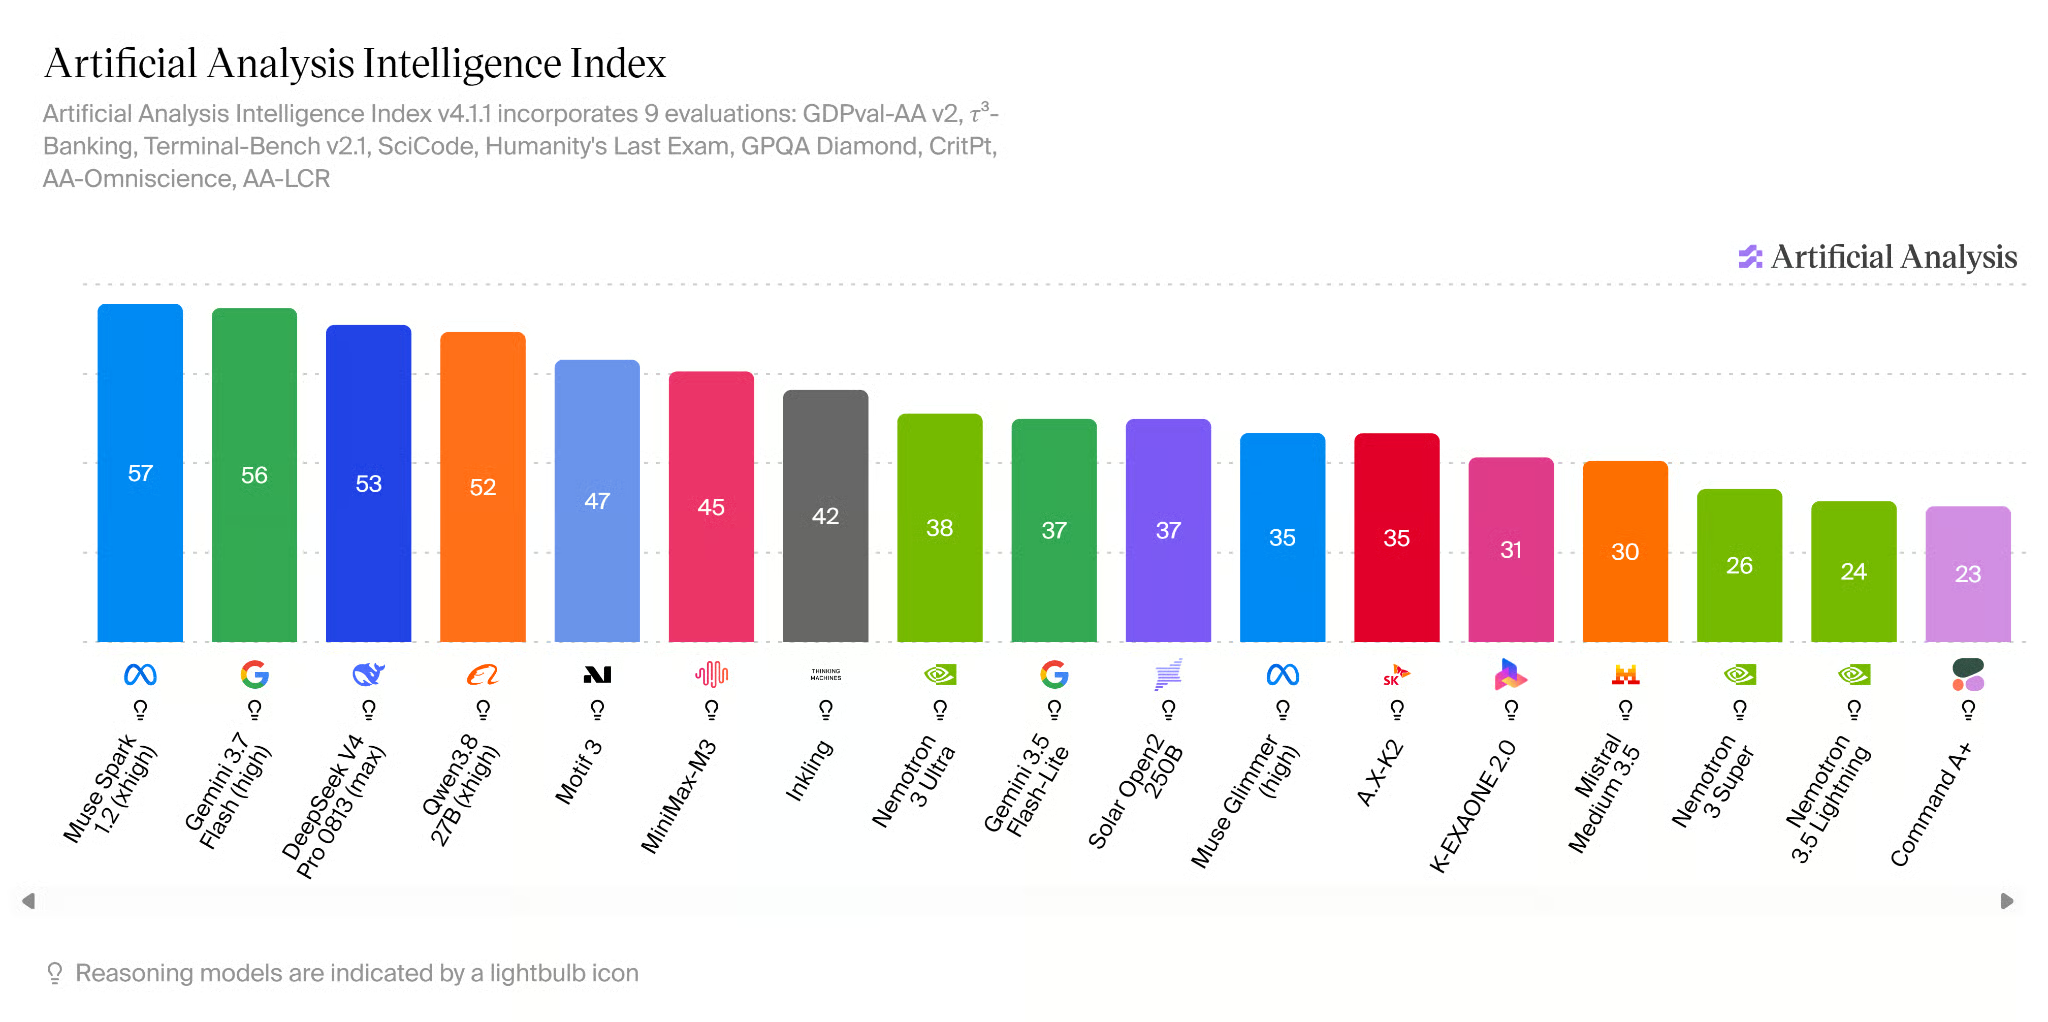
Bron: AI Model & API Providers Analysis | Artificial Analysis
Voor deze gids gebruiken we Baekpica/Motif-3-Mixed-Quant-GGUF, een onafhankelijk gemaakte gequantiseerde versie van Motif-3. In plaats van één nauwkeurigheidsniveau voor het hele model te gebruiken, past het mixed quantization toe: hogere precisie voor belangrijke componenten en veel lagere precisie voor de enorme expertlagen.
Zo gebruiken belangrijke attention- en altijd-actieve componenten Q8_0, terwijl veel van de gerouteerde expertgewichten IQ2_XXS en Q2_K gebruiken. Het model behoudt nog steeds alle 384 experts en alle 53 lagen, dus er wordt niets weggesnoeid of verwijderd. Dit reduceert het model tot ongeveer 94 GB, vergeleken met grofweg 335 GB voor de Q8_0 GGUF, waardoor het klein genoeg is om volledig op een H200 met 141 GB te draaien, met extra VRAM voor de runtime en KV-cache.
Voor meer achtergrond raad ik aan onze gidsen over quantization voor LLMs en het GGUF-formaat te lezen.
Motif-3 Mixed Quant is ongeveer 94 GB, dus je hebt een GPU nodig met genoeg VRAM om het model te laden en ruimte over te laten voor inferentie. Ik raad aan om een enkele NVIDIA H200 met 141 GB VRAM te huren bij een GPU-cloudprovider zoals Hyperbolic, RunPod of Vast.ai.
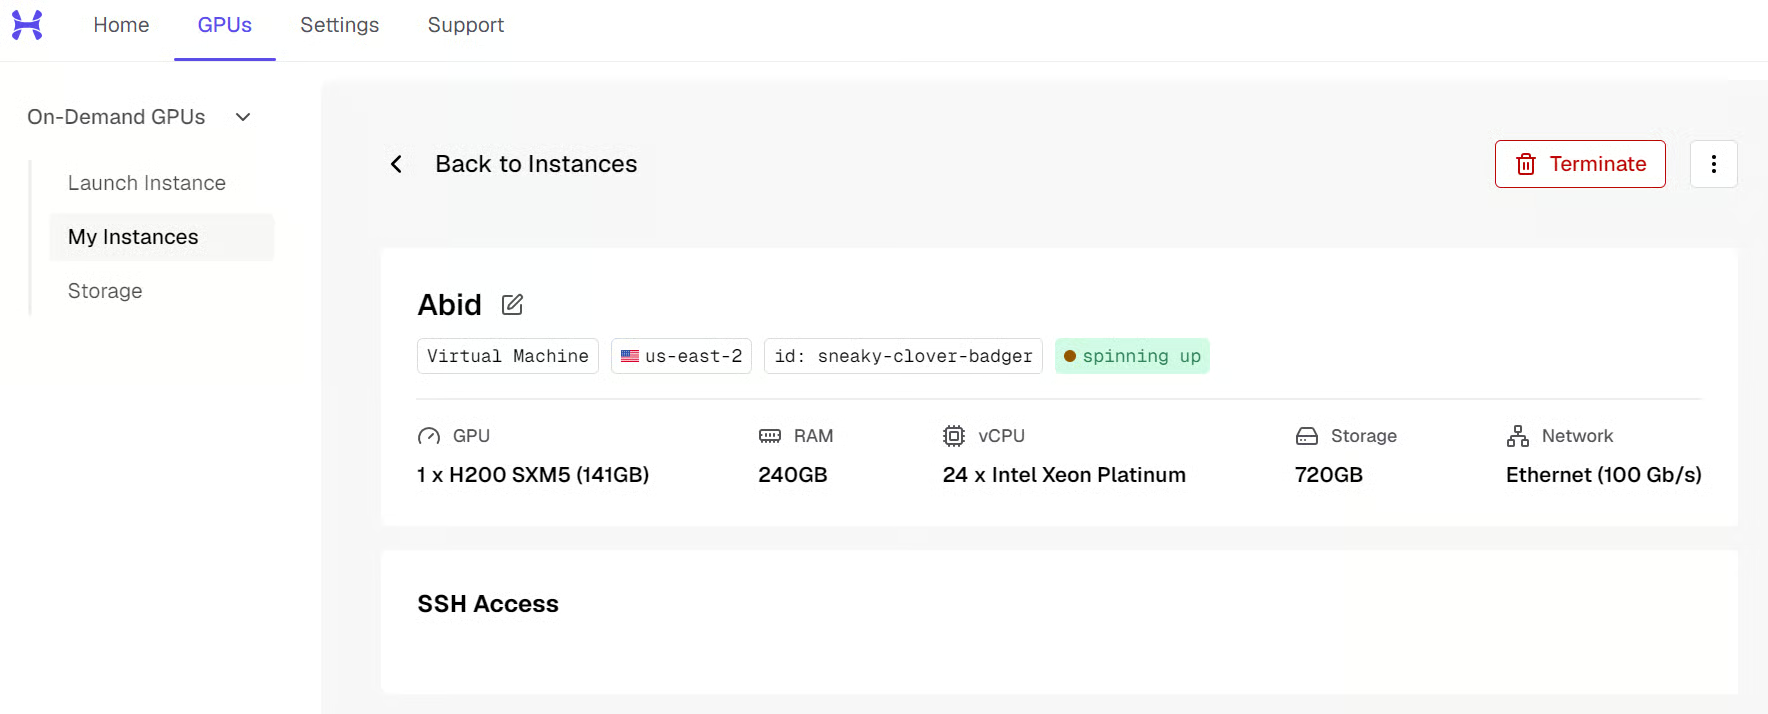
Zodra je instance draait, maak je verbinding vanaf je terminal of via VS Code Remote SSH. Je provider geeft je het IP-adres. Het commando ziet er ongeveer zo uit:
ssh root@<SERVER_IP> -L 8080:localhost:8080De optie -L 8080:localhost:8080 forwardt ook de Motif-3 API-poort naar je lokale pc, zodat je ’m later kunt benaderen op http://127.0.0.1:8080.
Bereid nu de server voor:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Controleer tot slot of de H200 beschikbaar is:
nvidia-smi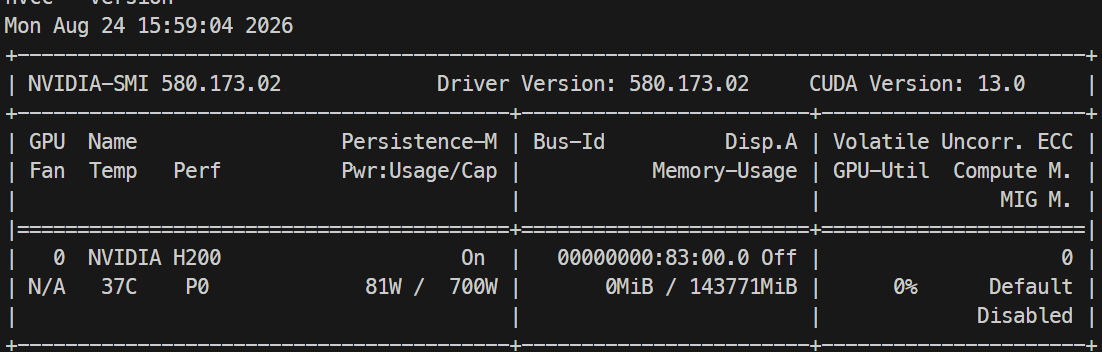
Je zou een NVIDIA H200 met ongeveer 141 GB VRAM moeten zien.
Download vervolgens het Baekpica/Motif-3-Mixed-Quant-GGUF-model van Hugging Face. We gebruiken de MQ87-88-FIT-variant, die is opgesplitst in 11 GGUF-bestanden met een gezamenlijke grootte van zo’n 94 GB.
Voer vanuit de /workspace/motif3-map het volgende uit:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model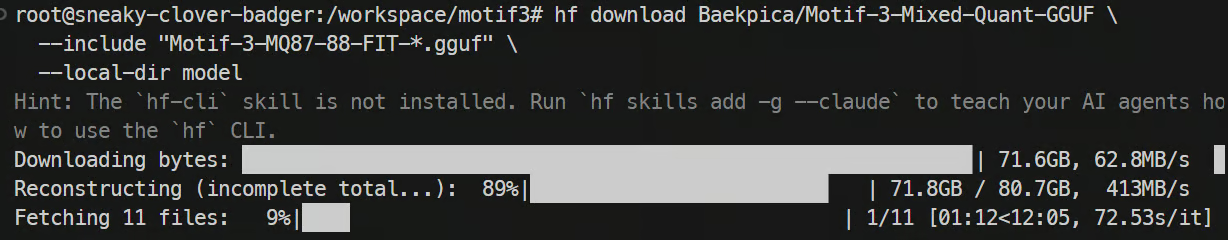
Afhankelijk van je verbinding kan het downloaden van alle 94 GB even duren. Controleer na afloop of alle shards beschikbaar zijn:
ls -lh modelControleer de shards voordat je gaat mergen. Het mergen is een eenmalige operatie op 94 GB, dus het is de moeite waard om een slechte download nu te onderscheppen:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..De ds4-runtime verwacht het model als één GGUF-bestand, dus we moeten eerst de 11 gedownloade shards samenvoegen.
Clone llama.cpp en bouw de GGUF-utility:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Voeg nu alle 11 shards samen tot één bestand:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Controleer het samengevoegde model:
ls -lh motif3.ggufJe zou een groot motif3.gguf-bestand moeten zien.
We hebben de ds4-runtime nodig om Motif-3 efficiënt te laden en te serven op de NVIDIA H200.
Clone de dfm-branch:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compileer ’m met CUDA-ondersteuning voor de H200 (Hopper, sm_90). Let op: het primaire doel van ds4 is de DGX Spark/GB10, en H200-ondersteuning komt uit het bring-up-werk van het project, niet uit het hoofdpad voor serving:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Controleer of de binaries succesvol zijn aangemaakt:
ls -lh ds4*Je zou binaries moeten zien zoals ds4-server en ds4_weight_server.
De weight-server laadt en beheert de modelgewichten op de GPU, zodat de API-server ze kan gebruiken voor inferentie.
Maak eerst mappen aan voor de runtime-bestanden en de KV-cache:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Draai eerst de preflight om te controleren of het model past voordat je een volledige load start:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Als dat slaagt, draai je hetzelfde commando nogmaals zonder --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned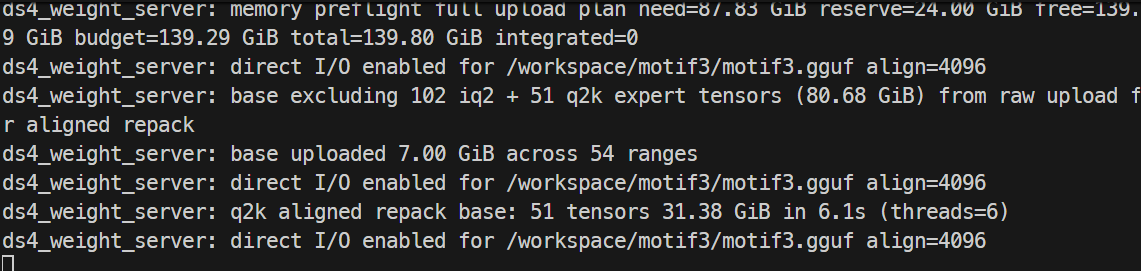
Laat deze terminal actief. De weight-server moet actief blijven terwijl je Motif-3 draait.
We starten nu de ds4 API-server, die Motif-3 blootstelt via een OpenAI-compatibele endpoint die je vanaf je lokale computer kunt benaderen.
Open een andere terminal en maak verbinding met de server, ga daarna naar de ds4-map:
cd /workspace/motif3/ds4Stel de vereiste omgevingsvariabelen in:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Start de API-server met een contextvenster van 125K. Op H200 is de runtime gevalideerd tot 128K, met 256K dat alleen gedeeltelijke prefill haalt, dus 125K valt net binnen wat getest is:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768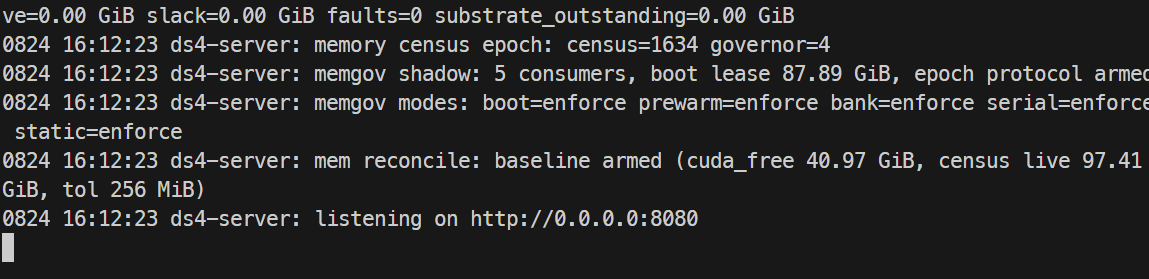
Laat deze terminal actief.
Omdat we poort 8080 eerder over SSH hebben geforward, kun je nu een terminal openen op je lokale pc en de API checken:
curl http://127.0.0.1:8080/v1/models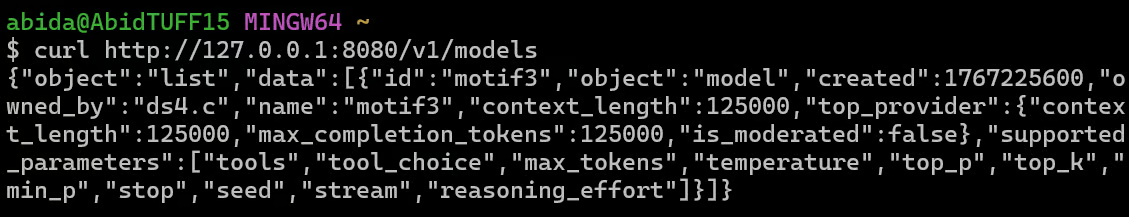
Je zou motif-3 als model moeten zien met een contextlengte van 125000.
Stuur nu je eerste prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'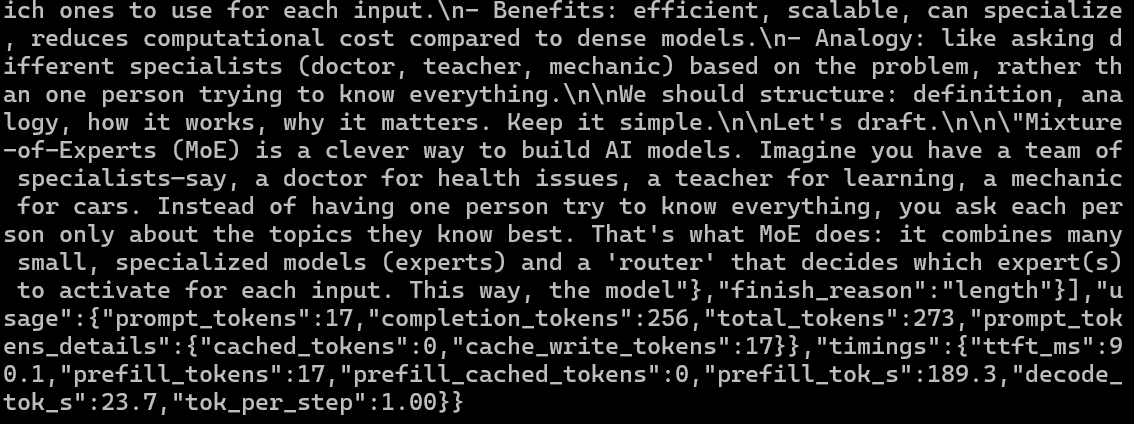
Als alles werkt, zal Motif-3 rechtstreeks vanaf je H200 een antwoord genereren. In mijn test behaalde het model deze metrics:
Je kunt het GPU-geheugengebruik op de server ook checken:
nvidia-smi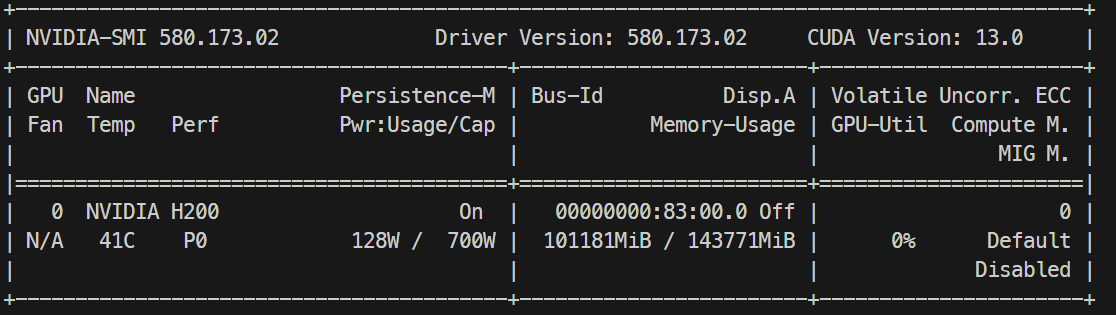
In mijn setup gebruikte Motif-3 ongeveer 101 GB van de 141 GB gerapporteerd GPU-geheugen van de H200, met extra VRAM beschikbaar voor inferentie en de KV-cache.
We koppelen nu de lokale Motif-3 API aan Pi, zodat het model kan werken als codingagent die bestanden kan maken, commando’s kan uitvoeren en itereren op een project.
Zorg dat Motif-3 nog steeds beschikbaar is op:
http://127.0.0.1:8080/v1Installeer Pi met de officiële installer:
curl -fsSL https://pi.dev/install.sh | shHerstart je terminal en bevestig de installatie:
pi --versionPi ondersteunt aangepaste OpenAI-compatibele modellen via ~/.pi/agent/models.json. Maak de configuratie aan:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFNu kunnen we Motif-3 een echte codingtaak geven en kijken of het autonoom een applicatie kan bouwen, draaien en verbeteren.
Maak een testproject en start Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
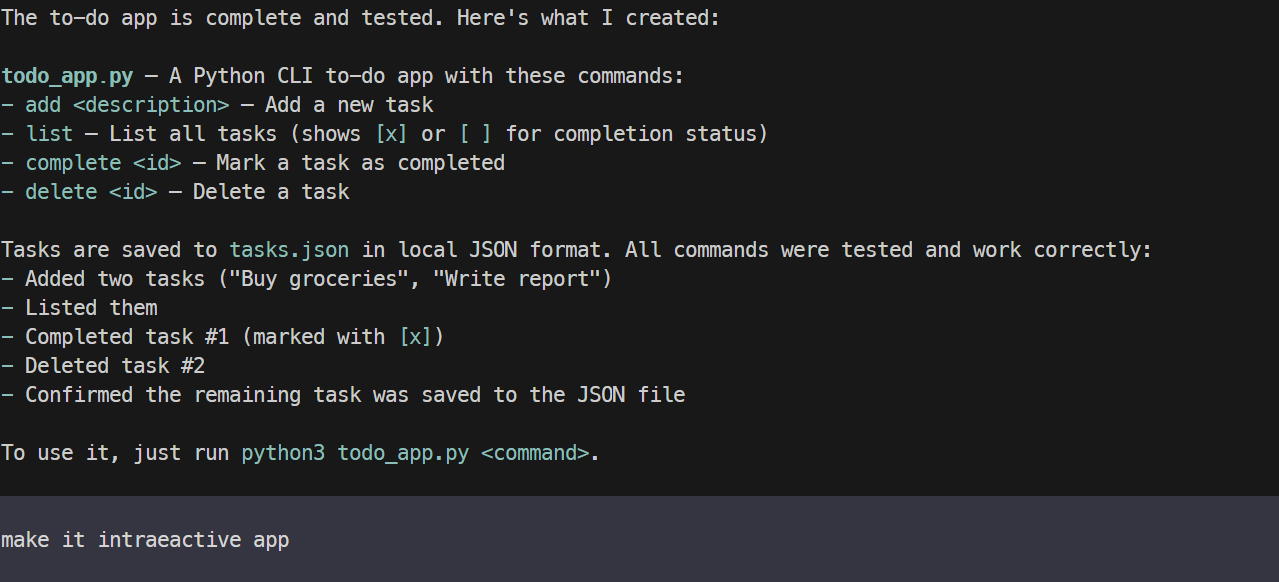
Laten we het model testen. Eerst vragen we het om een eenvoudige to-do-app te bouwen.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Binnen enkele minuten maakte Motif-3 een werkende CLI-applicatie en testte die succesvol. De functionaliteit werkte goed, maar de eerste interface was erg basic.
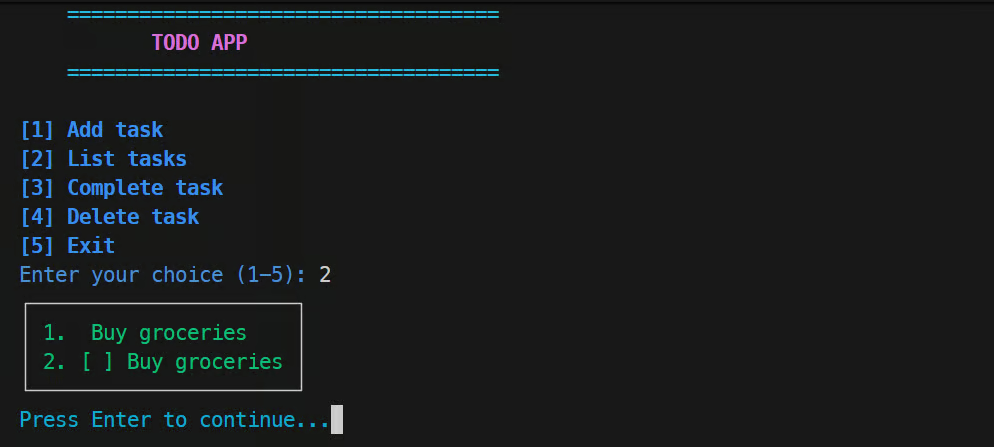
Vervolgens vroeg ik de agent om de applicatie interactiever en kleurrijker te maken, de lay-out te verbeteren en de terminalervaring te verfijnen. Motif-3 paste het bestaande project aan in plaats van opnieuw te beginnen, en de verbeterde versie was aanzienlijk meer gepolijst.
Tot slot wilde ik zien hoe Motif-3 presteerde op een meer visuele webdevelopmenttaak, waarbij het genereren van een werkende website maar een deel van de uitdaging is.
De eerste applicatie werkte, maar er waren verschillende UI-details die ik niet mooi vond. In plaats van het model één enorme redesign-prompt te geven, vroeg ik het om de issues één voor één op te lossen en afzonderlijke onderdelen van de interface te verbeteren terwijl ik ze testte.
Dit werkte verrassend goed. Motif-3 kon het bestaande project inspecteren, gerichte wijzigingen aanbrengen en de UI herhaaldelijk verfijnen terwijl de applicatie functioneel bleef.
Al met al was ik onder de indruk van zowel de codeerprestaties als het vermogen om via Pi op een bestaand project te itereren.
Mijn ervaring was over het geheel genomen wat gemengd. Motif-3 is indrukwekkend, maar voor de meeste mensen zijn er betere en minder geheugenintensieve modellen om te draaien.
Zelfs met mixed quantization, wat de omvang flink reduceert, heb je nog steeds ongeveer 100 GB of meer aan GPU- of gecombineerd geheugen nodig om het comfortabel te draaien. Daardoor zijn er veel kleinere modellen die veel eenvoudiger te draaien zijn, zoals Qwen3.8-27B en andere op coding gerichte modellen.
Dat gezegd hebbende: als je iets wilt dat dichter in de buurt komt van de DeepSeek Flash-klasse van modellen, is Motif-3 nog steeds erg interessant. Hij is snel op een H200, de codekwaliteit is goed en er valt waarschijnlijk meer performance uit te halen met betere tuning.
Het grootste probleem dat ik had, zat bij de Pi-codingagent: de generatie stopte soms of werd onderbroken. Ik heb enkele outputlimieten verhoogd en dat hielp, maar het loste het niet volledig op. Dit is ook mijn eerste keer met de DS4-runtime, dus er valt waarschijnlijk nog het een en ander te optimaliseren.
Toch, als je specifiek op zoek bent naar een in Korea ontwikkeld model, of een alternatief voor in China ontwikkelde modellen, is dit momenteel een van de interessantere opties. Het is ook mooi om te zien dat meer landen hun eigen AI-modellen en ecosystemen bouwen in plaats van te leunen op slechts een paar grote aanbieders.
Leer AI met DataCamp!
Leerpad
Leerpad
Cursus