
Programa
Associate AI Engineer para desenvolvedores
26 h
Motif-3 é um modelo em larga escala Mixture-of-Experts (MoE) da Motif Technologies, com 314B de parâmetros totais e apenas 13,2B ativados por token.
Ele traz 384 experts roteados, uma janela de contexto de 256K e foi treinado com cerca de 12,5 trilhões de tokens cobrindo código, matemática, STEM, dados multilíngues e outros domínios.
É especialmente adequado para tarefas de raciocínio, programação e workloads com agentes. No Artificial Analysis Intelligence Index, atinge a pontuação 47, ficando entre o Qwen3.8-27B e o MiniMax-M3, que testamos em uma configuração semelhante.
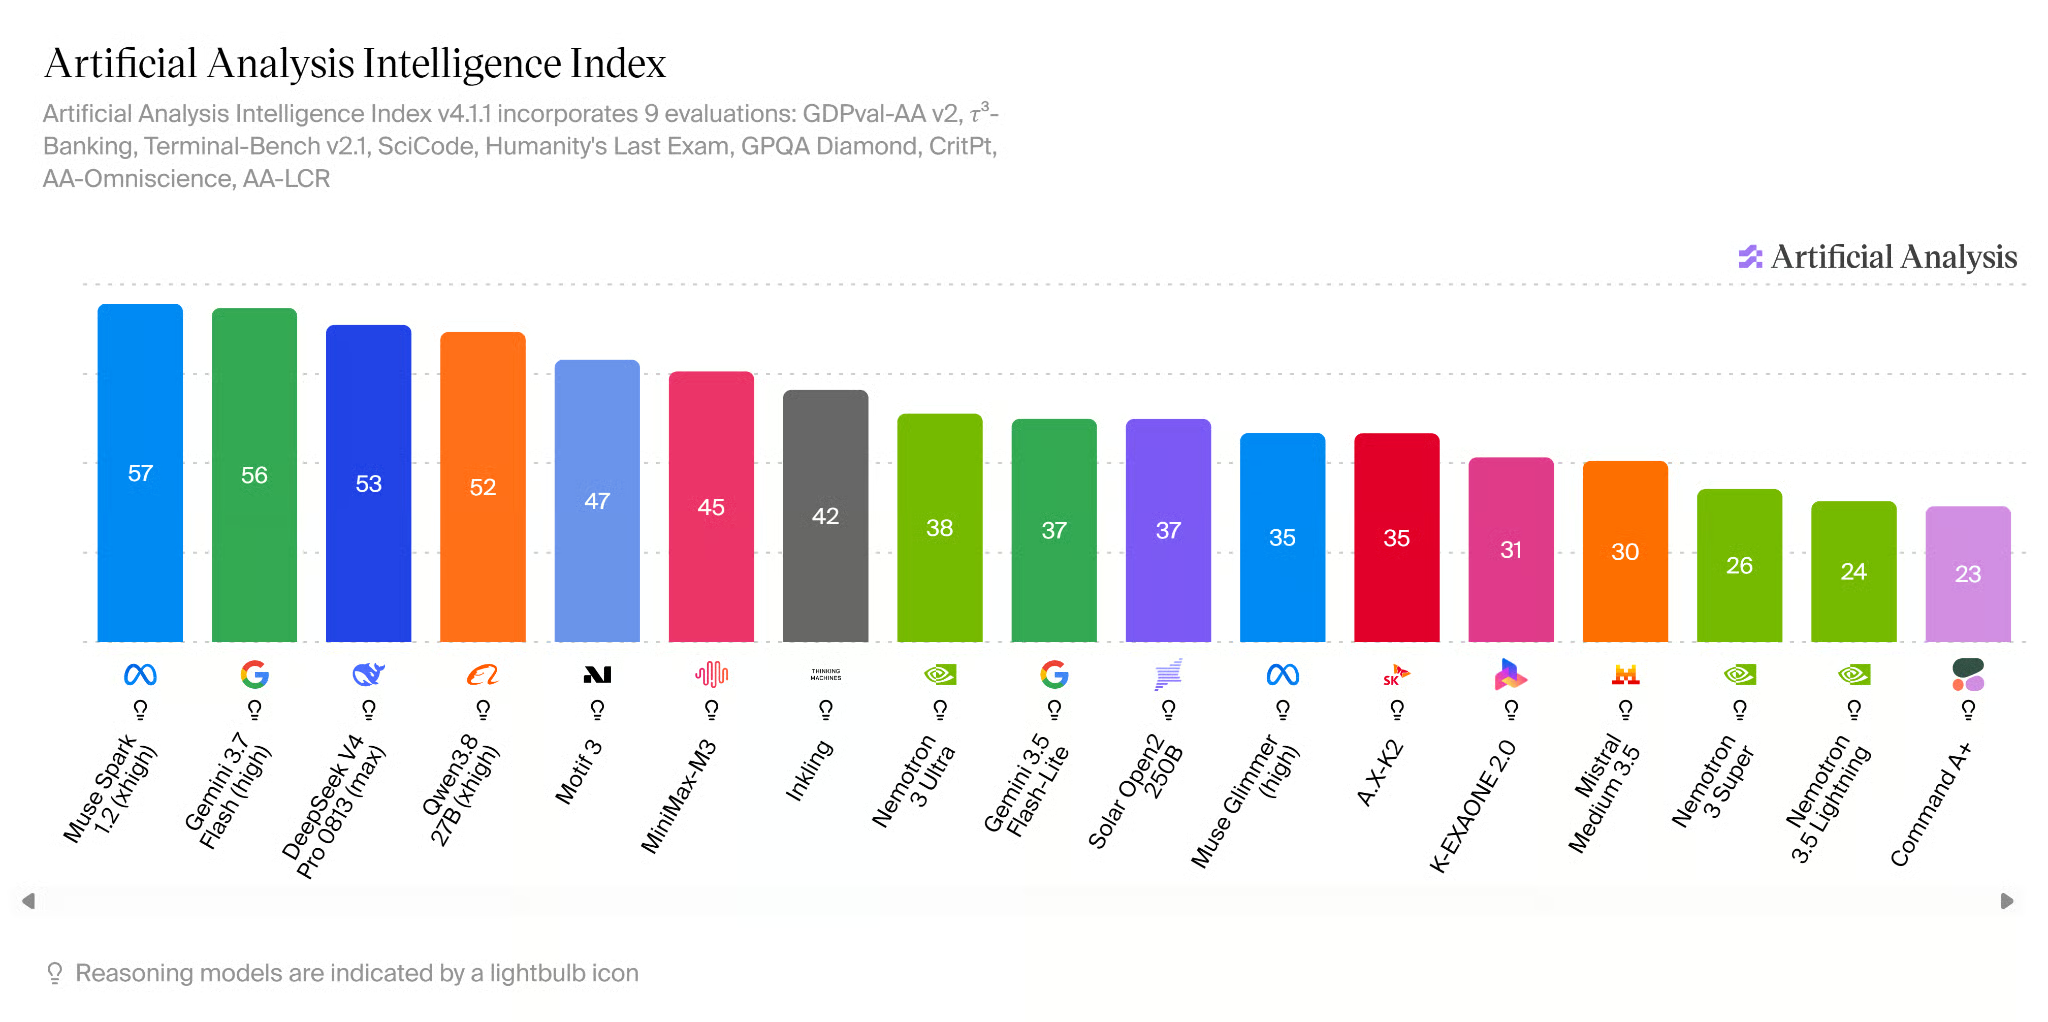
Fonte: AI Model & API Providers Analysis | Artificial Analysis
Para este guia, usamos o Baekpica/Motif-3-Mixed-Quant-GGUF, uma versão quantizada criada independentemente do Motif-3. Em vez de usar um único nível de precisão para o modelo todo, ele aplica quantização mista, com maior precisão nos componentes importantes e precisão bem menor nas camadas enormes de experts.
Por exemplo, componentes críticos de atenção e partes sempre ativas usam Q8_0, enquanto boa parte dos pesos dos experts roteados usa IQ2_XXS e Q2_K. O modelo mantém todos os 384 experts e todas as 53 camadas — nada é podado ou removido. Isso reduz o modelo para aproximadamente 94 GB, contra cerca de 335 GB no GGUF Q8_0, tornando-o pequeno o suficiente para rodar completamente em uma H200 de 141 GB com VRAM extra disponível para o runtime e o cache KV.
Para mais contexto, recomendo ler nossos guias sobre quantização para LLMs e o formato GGUF.
O Motif-3 Mixed Quant tem cerca de 94 GB, então você vai precisar de uma GPU com VRAM suficiente para carregar o modelo e ainda deixar espaço para a inferência. Recomendo alugar uma NVIDIA H200 única com 141 GB de VRAM de um provedor de nuvem de GPU como Hyperbolic, RunPod ou Vast.ai.
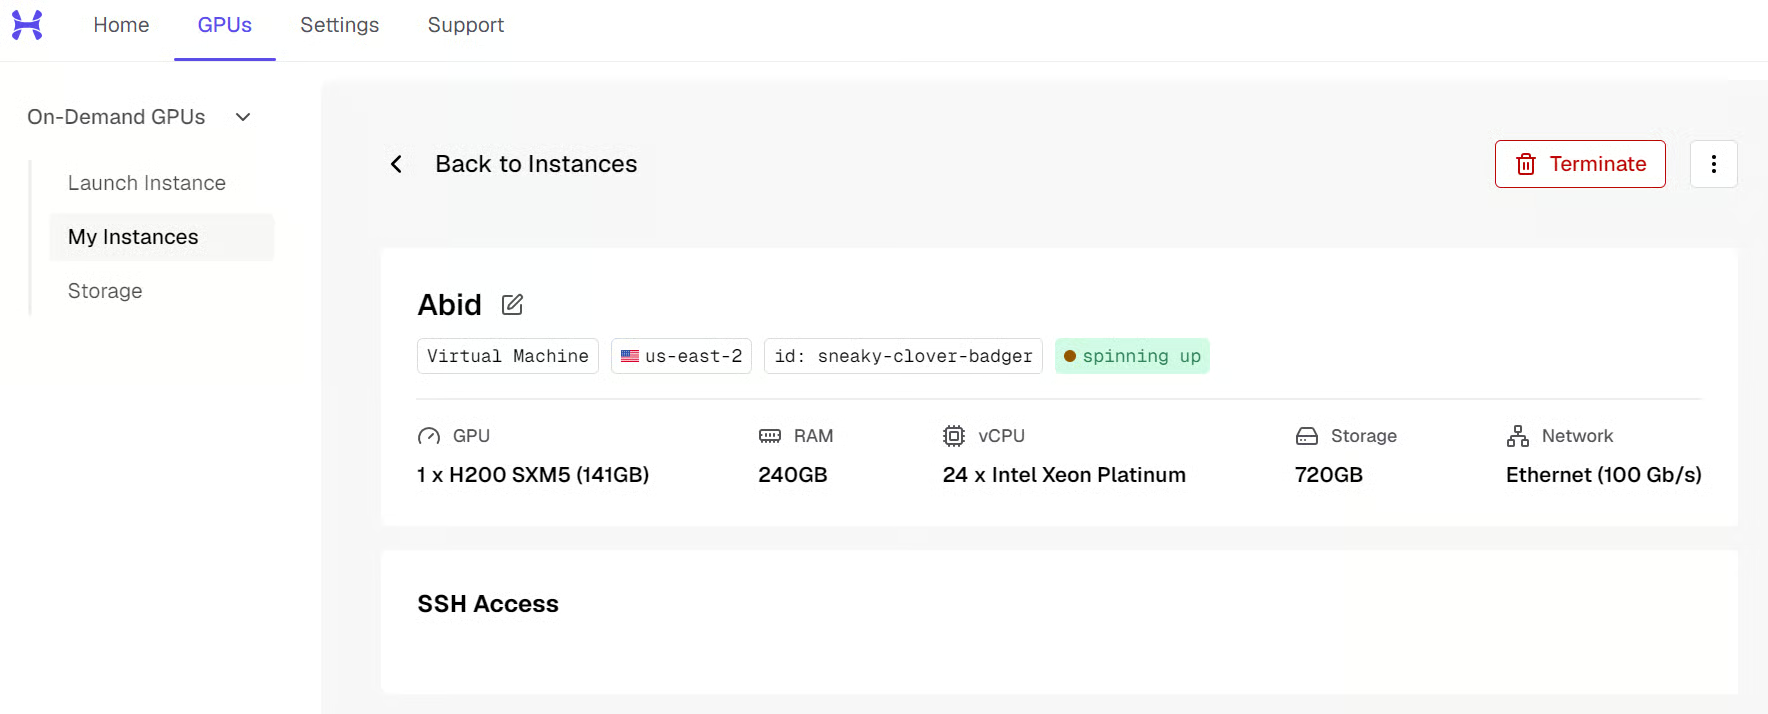
Quando sua instância estiver ativa, conecte-se a ela pelo terminal ou pelo VS Code Remote SSH. Seu provedor vai informar o IP. O comando será algo como:
ssh root@<SERVER_IP> -L 8080:localhost:8080A opção -L 8080:localhost:8080 também encaminha a porta da API do Motif-3 para seu PC local, então depois você pode acessá-la em http://127.0.0.1:8080.
Agora prepare o servidor:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Por fim, verifique se a H200 está disponível:
nvidia-smi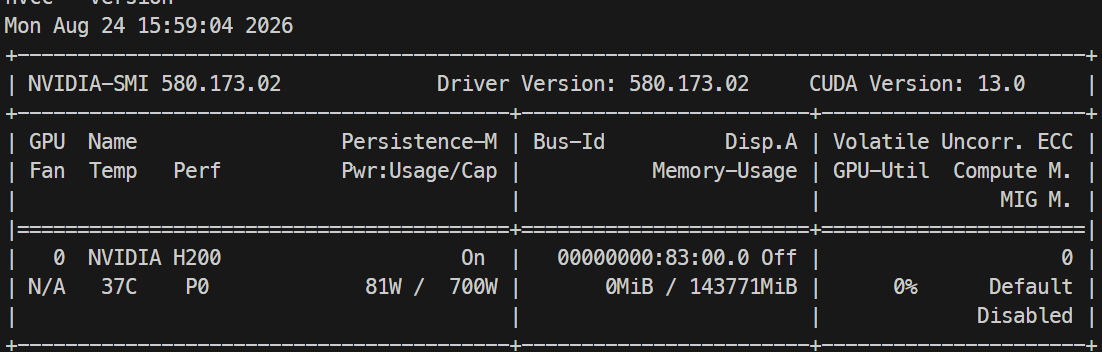
Você deve ver uma NVIDIA H200 com aproximadamente 141 GB de VRAM.
Em seguida, baixe o modelo Baekpica/Motif-3-Mixed-Quant-GGUF do Hugging Face. Estamos usando a variante MQ87-88-FIT, dividida em 11 arquivos GGUF com tamanho total de cerca de 94 GB.
No diretório /workspace/motif3, execute:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model
Dependendo da sua conexão, baixar todos os 94 GB pode levar um tempo. Ao concluir, verifique se todos os shards estão disponíveis:
ls -lh modelAntes de mesclar, valide os shards. A mesclagem é uma operação única em 94 GB, então vale a pena detectar qualquer download corrompido agora:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..O runtime ds4 espera o modelo em um único arquivo GGUF, então primeiro precisamos mesclar os 11 shards baixados.
Clone o llama.cpp e compile o utilitário GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Agora mescle os 11 shards em um único arquivo:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Verifique o modelo mesclado:
ls -lh motif3.ggufVocê deve ver um arquivo grande chamado motif3.gguf.
Precisamos do runtime ds4 para carregar e servir o Motif-3 com eficiência na NVIDIA H200.
Clone a branch dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compile com suporte a CUDA para a H200 (Hopper, sm_90). Note que o alvo principal do ds4 é o DGX Spark/GB10, e o suporte à H200 vem do trabalho de bring-up do projeto, não do caminho principal de serving:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Confira se os binários foram criados com sucesso:
ls -lh ds4*Você deve ver binários como ds4-server e ds4_weight_server.
O weight server carrega e gerencia os pesos do modelo na GPU para que o servidor de API possa usá-los na inferência.
Primeiro, crie diretórios para os arquivos do runtime e para o cache KV:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Execute o preflight primeiro para checar se o modelo vai caber antes de iniciar o carregamento completo:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Se passar, rode o mesmo comando novamente sem o --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned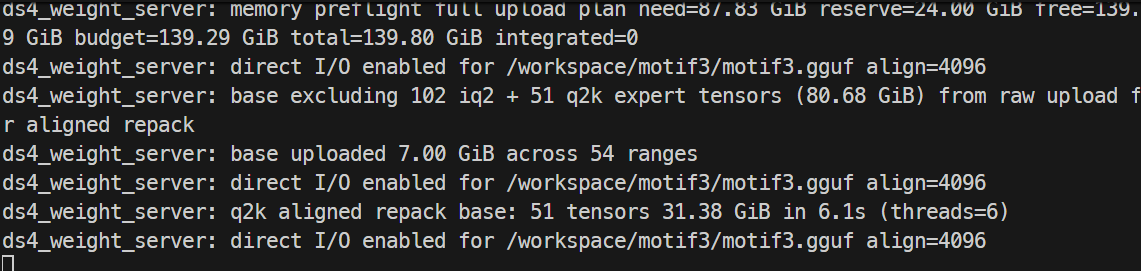
Mantenha este terminal aberto. O weight server precisa continuar ativo enquanto você executa o Motif-3.
Agora vamos iniciar o servidor de API do ds4, que expõe o Motif-3 por um endpoint compatível com OpenAI que você pode acessar do seu computador local.
Abra outro terminal e conecte-se ao servidor, depois entre no diretório ds4:
cd /workspace/motif3/ds4Defina as variáveis de ambiente exigidas:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Inicie o servidor de API com janela de contexto de 125K. Na H200, o runtime está validado até 128K; 256K só chega a prefill parcial, então 125K fica dentro do que foi testado:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768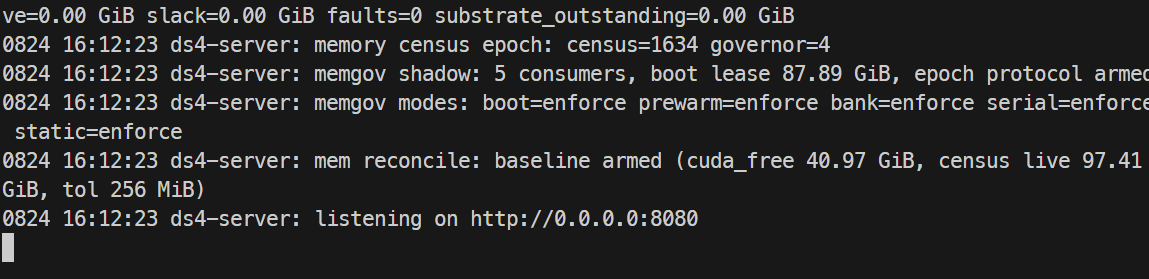
Mantenha este terminal aberto.
Como encaminhamos a porta 8080 via SSH antes, você já pode abrir um terminal no seu PC local e checar a API:
curl http://127.0.0.1:8080/v1/models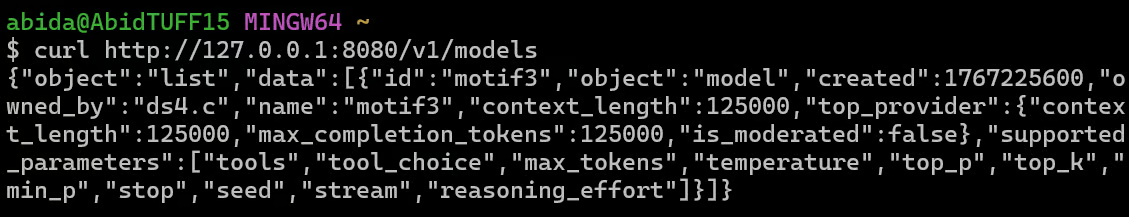
Você deve ver motif-3 listado como o modelo com comprimento de contexto de 125000.
Agora envie seu primeiro prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'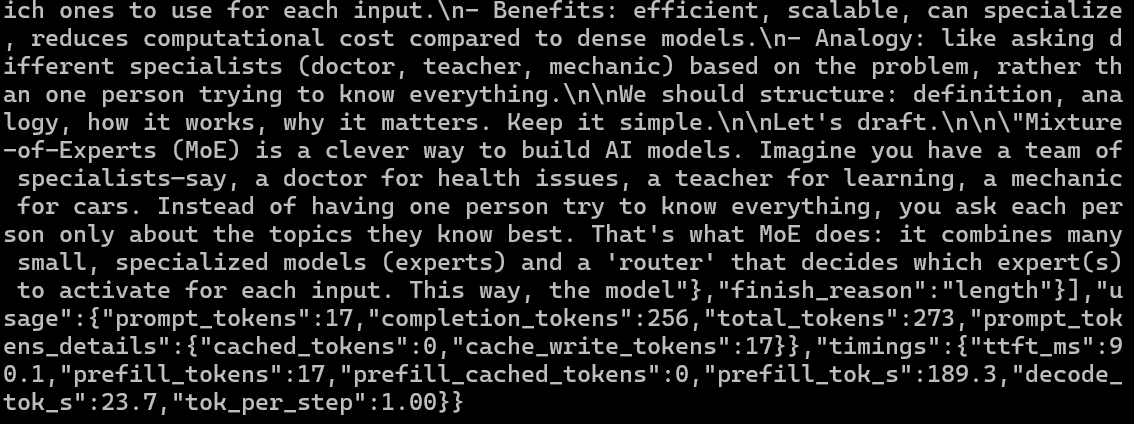
Se tudo estiver funcionando, o Motif-3 vai gerar a resposta diretamente da sua H200. No meu teste, o modelo atingiu estas métricas:
Você também pode checar o uso de memória da GPU no servidor:
nvidia-smi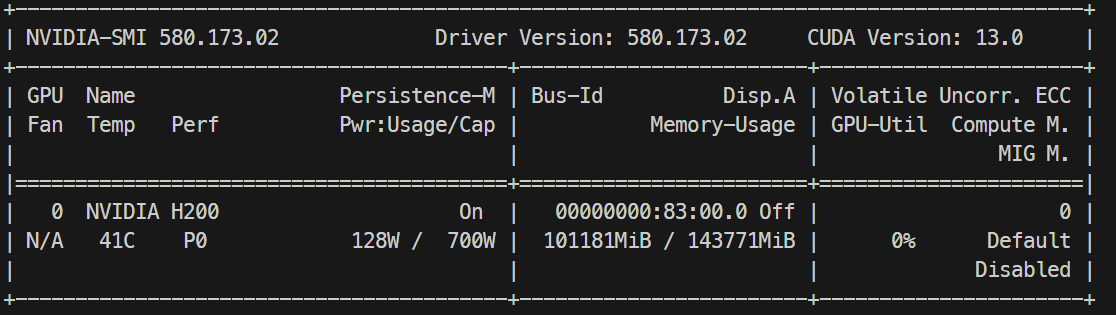
Na minha configuração, o Motif-3 usou cerca de 101 GB dos 141 GB de memória de GPU da H200, deixando VRAM adicional para a inferência e o cache KV.
Agora vamos conectar a API local do Motif-3 ao Pi, permitindo que o modelo atue como um agente de código capaz de criar arquivos, executar comandos e iterar em um projeto.
Confirme que o Motif-3 ainda está disponível em:
http://127.0.0.1:8080/v1Instale o Pi usando o instalador oficial:
curl -fsSL https://pi.dev/install.sh | shReinicie o terminal e confirme a instalação:
pi --versionO Pi suporta modelos customizados compatíveis com OpenAI via ~/.pi/agent/models.json. Crie a configuração:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFAgora podemos dar ao Motif-3 uma tarefa real de programação e ver se ele consegue construir, executar e aprimorar um aplicativo de forma autônoma.
Crie um projeto de teste e inicie o Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
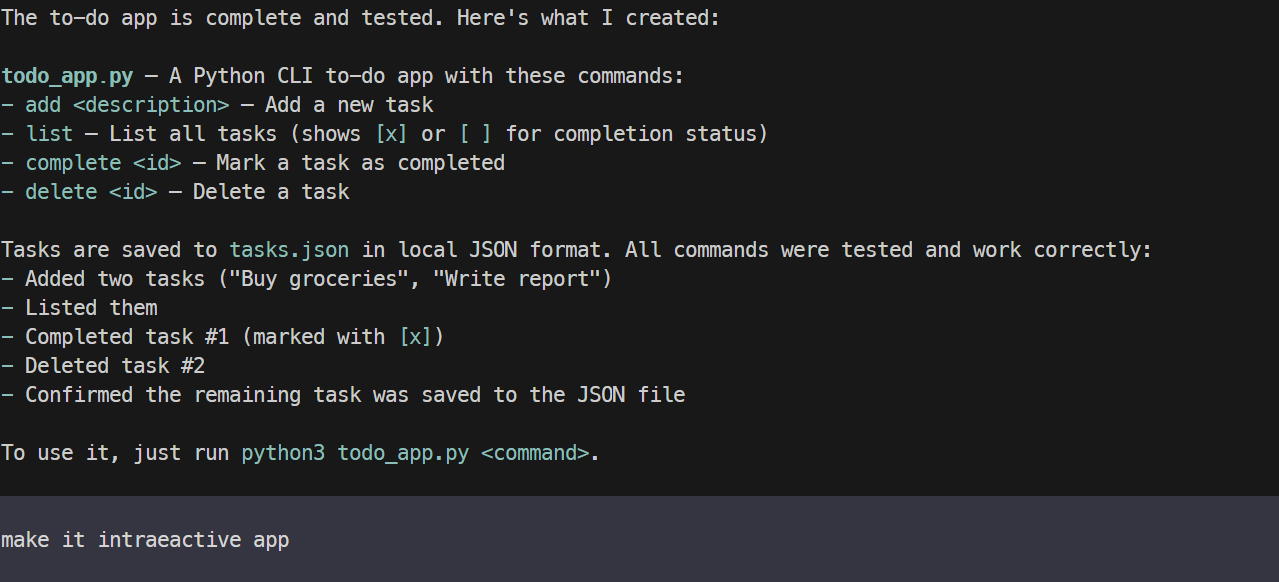
Vamos testar o modelo. Primeiro, vamos pedir para ele construir um app simples de lista de tarefas.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Em poucos minutos, o Motif-3 criou um aplicativo de CLI funcional e o testou com sucesso. A funcionalidade estava boa, mas a interface inicial era bem básica.
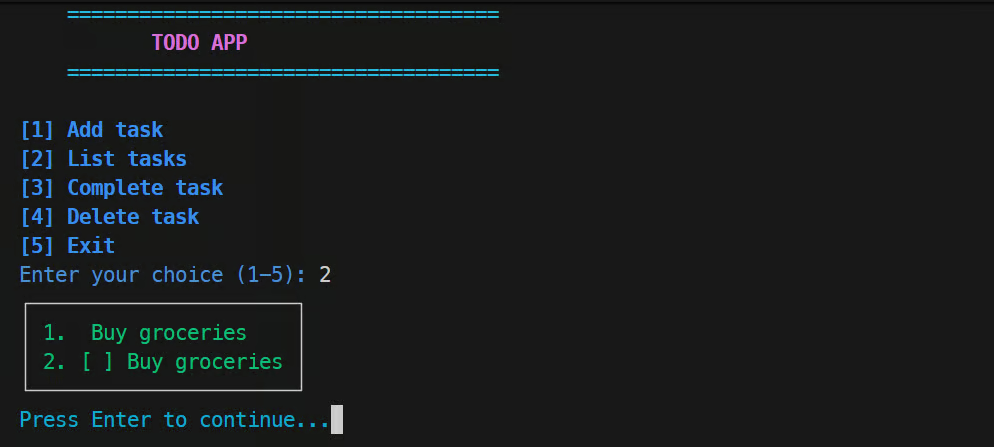
Depois, pedi ao agente para deixar o app mais interativo e colorido, melhorar o layout e a experiência no terminal. O Motif-3 modificou o projeto existente em vez de começar do zero, e a versão aprimorada ficou bem mais caprichada.
Por fim, quis ver como o Motif-3 se sairia em uma tarefa mais visual de desenvolvimento web, em que gerar um site funcional é só parte do desafio.
A aplicação inicial funcionou, mas havia vários detalhes de UI que eu não gostei. Em vez de dar um único prompt enorme de redesign, pedi para o modelo corrigir os problemas um a um, melhorando partes individuais da interface enquanto eu testava.
Isso funcionou surpreendentemente bem. O Motif-3 conseguiu inspecionar o projeto existente, fazer mudanças pontuais e refinar a UI repetidamente mantendo a aplicação funcional.
No geral, fiquei impressionado tanto com a qualidade do código quanto com a capacidade de iterar em um projeto existente via Pi.
No geral, minha experiência foi um pouco mista. O Motif-3 é impressionante, mas para a maioria das pessoas há modelos melhores e menos pesados em memória para rodar.
Mesmo com a quantização mista, que reduz bastante o tamanho, você ainda precisa de algo em torno de 100 GB ou mais de memória de GPU ou combinada para rodar com folga. Por isso, existem muitos modelos menores que são bem mais fáceis de executar, como o Qwen3.8-27B e outros modelos focados em código.
Dito isso, se você quer algo mais próximo da classe DeepSeek Flash de modelos, o Motif-3 continua muito interessante. Ele é rápido em uma H200, a qualidade do código é boa e provavelmente dá para extrair ainda mais desempenho com um tuning melhor.
O principal problema que tive foi com o agente de código Pi, em que a geração às vezes parava ou era interrompida. Aumentei alguns limites de saída e isso ajudou, mas não resolveu totalmente. Também é a minha primeira vez usando o runtime DS4, então provavelmente há mais otimizações que posso fazer no futuro.
Ainda assim, se você busca especificamente um modelo desenvolvido na Coreia, ou quer uma alternativa a modelos desenvolvidos na China, esta é uma das opções mais interessantes no momento. Também é legal ver mais países construindo seus próprios modelos e ecossistemas de IA, em vez de depender de poucos provedores.
Aprenda IA com a DataCamp!
Programa
Programa
Curso