Tracks
วิศวกร AI ระดับ Associate สำหรับนักพัฒนา
26 ชม.
Motif-3 เป็นโมเดล ขนาดใหญ่แบบ Mixture-of-Experts (MoE) จาก Motif Technologies ที่สร้างด้วยพารามิเตอร์รวม 314B โดยเปิดใช้งานเพียง 13.2B พารามิเตอร์ต่อ โทเค็น
มีผู้เชี่ยวชาญแบบ routed จำนวน 384 ราย หน้าต่างบริบท 256K (context window) และฝึกด้วยข้อมูลประมาณ 12.5 ล้านล้านโทเค็น ครอบคลุมโค้ด คณิตศาสตร์ STEM ข้อมูลหลายภาษา และโดเมนอื่นๆ
เหมาะอย่างยิ่งสำหรับงานที่ต้องใช้เหตุผล การเขียนโค้ด และงานเชิงเอเจนต์ บน Artificial Analysis Intelligence Index ทำคะแนนได้ 47 อยู่ระหว่าง Qwen3.8-27B และ MiniMax-M3 ซึ่งทดสอบในสภาพแวดล้อมใกล้เคียงกัน
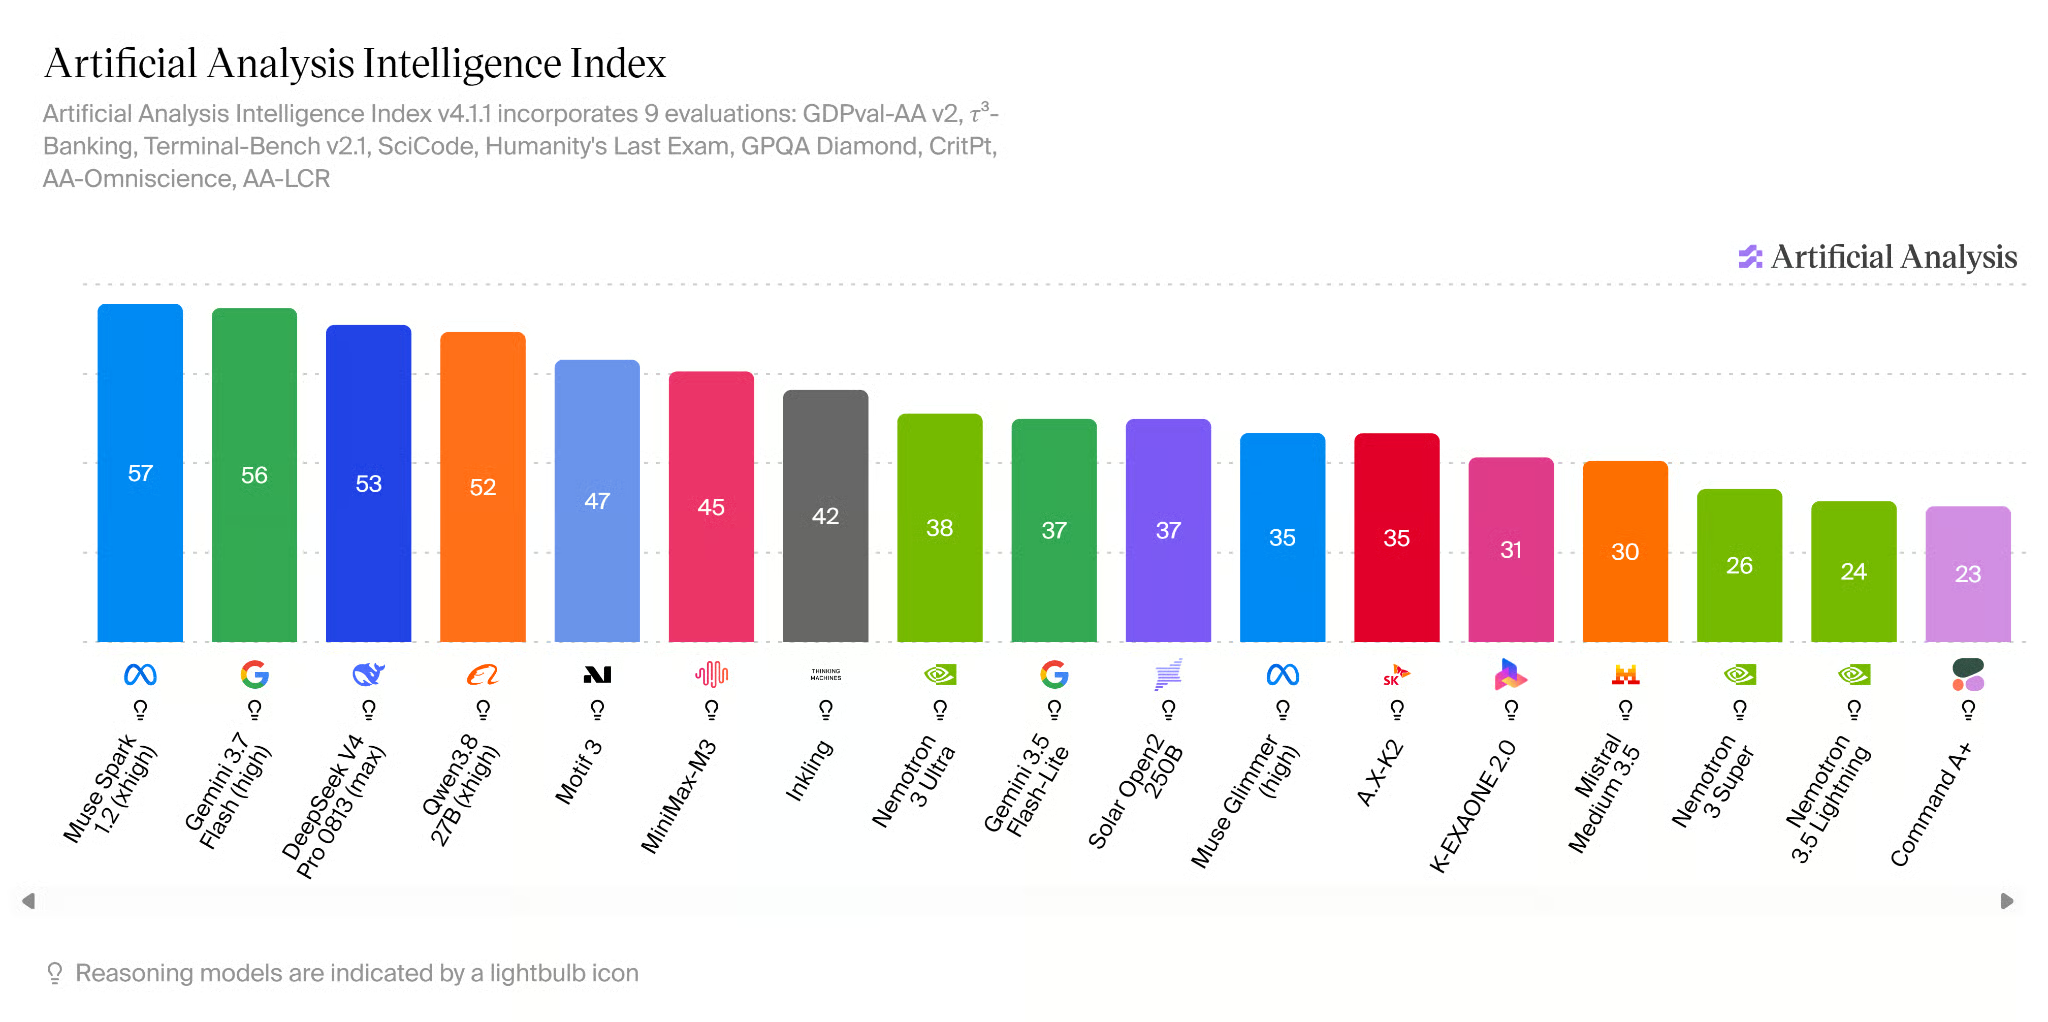
ที่มา: AI Model & API Providers Analysis | Artificial Analysis
สำหรับคู่มือนี้ เราใช้ Baekpica/Motif-3-Mixed-Quant-GGUF ซึ่งเป็นเวอร์ชันควอนไทซ์ของ Motif-3 ที่สร้างโดยอิสระ โดยไม่ใช้ความละเอียดเดียวกันทั้งโมเดล แต่ใช้การควอนไทซ์แบบผสม ให้ความละเอียดสูงกับองค์ประกอบสำคัญ และความละเอียดต่ำมากกับเลเยอร์ผู้เชี่ยวชาญขนาดมหึมา
เช่น องค์ประกอบ attention ที่สำคัญและส่วนที่ทำงานตลอดจะใช้ Q8_0 ขณะที่น้ำหนักของผู้เชี่ยวชาญแบบ routed จำนวนมากใช้ IQ2_XXS และ Q2_K โมเดลยังคงผู้เชี่ยวชาญทั้ง 384 ราย และทุก 53 เลเยอร์ไว้ครบ ไม่มีการตัดทอน ทำให้ขนาดลดลงเหลือประมาณ 94GB เทียบกับราว 335GB สำหรับ Q8_0 GGUF เล็กพอที่จะรันบน H200 ขนาด 141GB ได้ทั้งหมด พร้อม VRAM เหลือสำหรับรันไทม์และ KV cache
สำหรับพื้นฐานเพิ่มเติม แนะนำให้อ่านคู่มือเกี่ยวกับ การควอนไทซ์สำหรับ LLMs และ ฟอร์แมต GGUF
Motif-3 Mixed Quant มีขนาดประมาณ 94GB จึงต้องใช้ GPU ที่มี VRAM เพียงพอในการโหลดโมเดลและเหลือพื้นที่สำหรับการอนุมาน แนะนำให้เช่า NVIDIA H200 ตัวเดียวที่มี VRAM 141GB จากผู้ให้บริการคลาวด์ GPU อย่าง Hyperbolic, RunPod หรือ Vast.ai
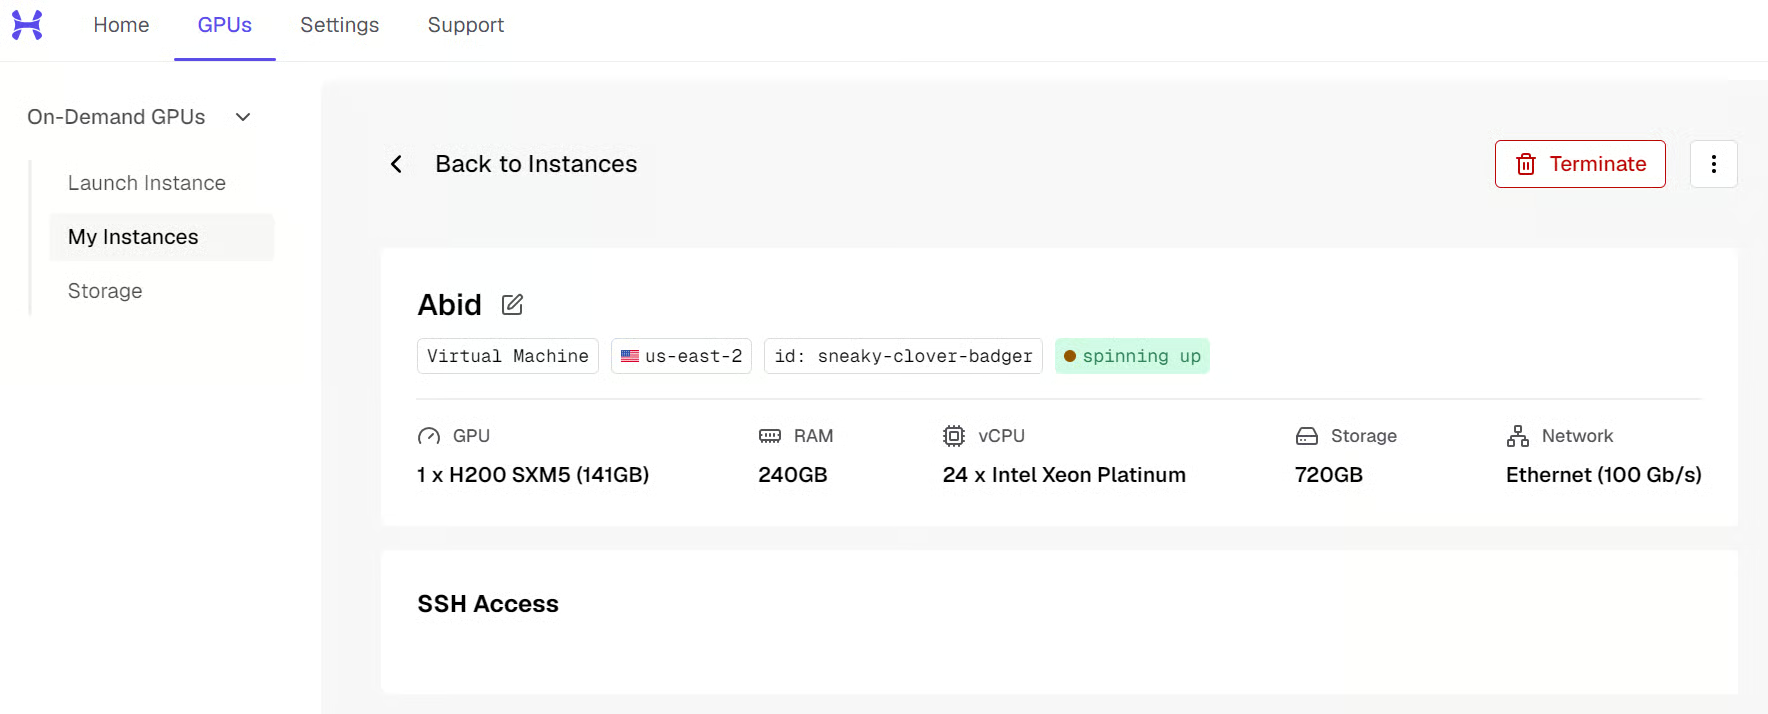
เมื่ออินสแตนซ์ทำงานแล้ว ให้เชื่อมต่อจากเทอร์มินัลหรือผ่าน VS Code Remote SSH ผู้ให้บริการจะให้ IP address คำสั่งจะมีลักษณะคล้าย:
ssh root@<SERVER_IP> -L 8080:localhost:8080ออปชัน -L 8080:localhost:8080 จะฟอร์เวิร์ดพอร์ต API ของ Motif-3 มายังเครื่องโลคัลด้วย ภายหลังจึงเข้าถึงได้ที่ http://127.0.0.1:8080.
จากนั้นเตรียมเซิร์ฟเวอร์:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
สุดท้าย ตรวจสอบว่า H200 พร้อมใช้งาน:
nvidia-smi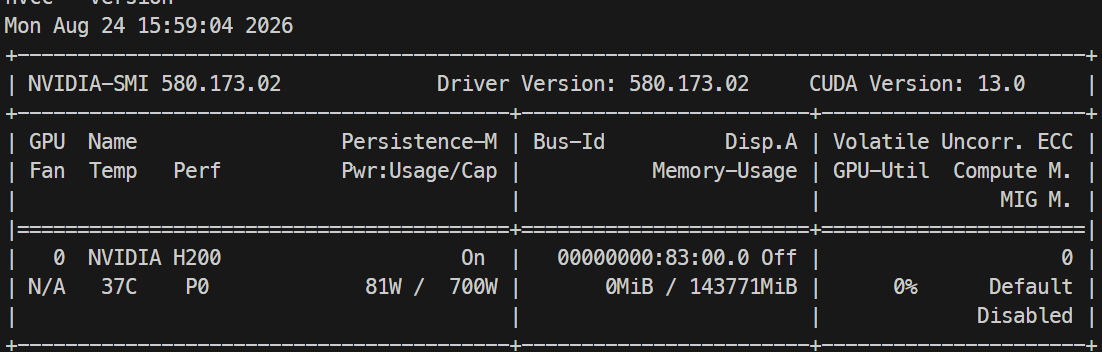
ควรเห็น NVIDIA H200 ที่มีหน่วยความจำ GPU ประมาณ 141GB
ถัดไป ดาวน์โหลดโมเดล Baekpica/Motif-3-Mixed-Quant-GGUF จาก Hugging Face เราใช้เวอร์ชัน MQ87-88-FIT ซึ่งถูกแยกเป็นไฟล์ GGUF 11 ไฟล์ รวมขนาดประมาณ 94GB
จากไดเรกทอรี /workspace/motif3 ให้รัน:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model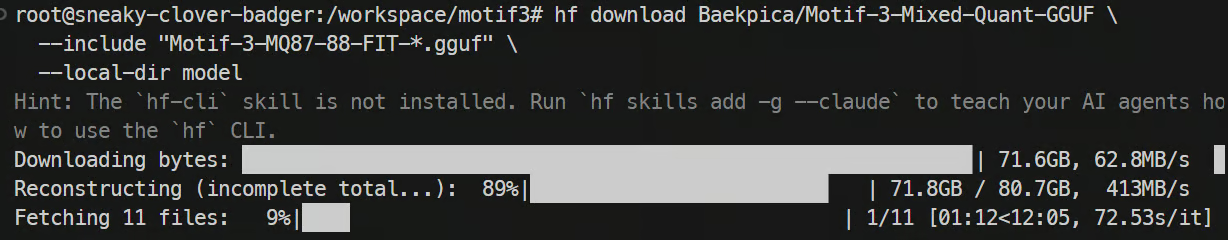
ขึ้นอยู่กับการเชื่อมต่อ การดาวน์โหลดทั้งหมด 94GB อาจใช้เวลาสักครู่ เมื่อเสร็จแล้ว ตรวจสอบว่ามีชาร์ดครบถ้วน:
ls -lh modelก่อนผสาน ให้ตรวจสอบชาร์ดก่อน การผสานเป็นการดำเนินการครั้งเดียวบนข้อมูล 94GB จึงควรจับความผิดพลาดในการดาวน์โหลดตั้งแต่ตอนนี้:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..รันไทม์ ds4 คาดหวังโมเดลเป็นไฟล์ GGUF เดียว ดังนั้นต้องผสานชาร์ดที่ดาวน์โหลดทั้ง 11 ชิ้นก่อน
โคลน llama.cpp และบิลด์ยูทิลิตี GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
ตอนนี้ผสานชาร์ดทั้ง 11 เป็นไฟล์เดียว:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
ตรวจสอบโมเดลที่ผสานแล้ว:
ls -lh motif3.ggufควรเห็นไฟล์ motif3.gguf ขนาดใหญ่
จำเป็นต้องใช้รันไทม์ ds4 เพื่อโหลดและให้บริการ Motif-3 บน NVIDIA H200 อย่างมีประสิทธิภาพ
โคลนสาขา dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
คอมไพล์ด้วยการรองรับ CUDA สำหรับ H200 (Hopper, sm_90) โปรดทราบว่าเป้าหมายหลักของ ds4 คือ DGX Spark/GB10 และการรองรับ H200 มาจากงาน bring-up ของโครงการ ไม่ใช่เส้นทางเสิร์ฟหลัก
make cuda CUDA_ARCH=sm_90 -j$(nproc)ตรวจสอบว่ามีไบนารีสร้างสำเร็จ:
ls -lh ds4*ควรเห็นไบนารีอย่างเช่น ds4-server และ ds4_weight_server.
weight server จะโหลดและจัดการน้ำหนักโมเดลบน GPU เพื่อให้ API server ใช้สำหรับการอนุมาน
ก่อนอื่น สร้างไดเรกทอรีสำหรับไฟล์รันไทม์และ KV cache:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
รัน preflight เพื่อตรวจสอบว่าโมเดลจะพอดี ก่อนลงมือโหลดเต็มรูปแบบ:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
หากผ่าน ให้รันคำสั่งเดิมอีกครั้งโดยไม่ใส่ --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned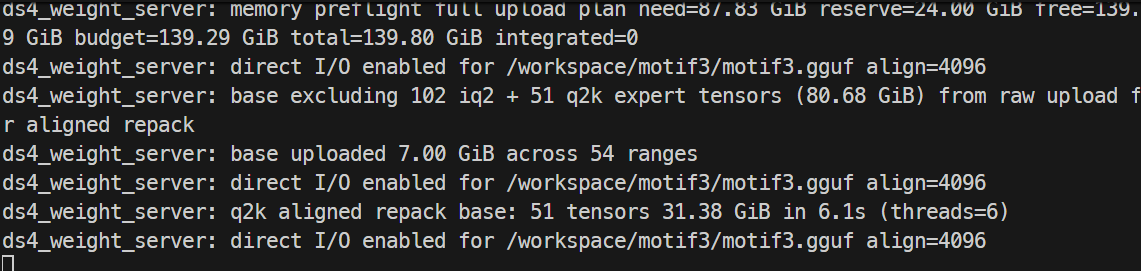
เปิดเทอร์มินัลนี้ค้างไว้ weight server ต้องทำงานต่อเนื่องระหว่างที่รัน Motif-3
ตอนนี้จะเริ่ม ds4 API server ซึ่งเปิดเผย Motif-3 ผ่านเอ็นด์พอยต์ที่เข้ากันได้กับ OpenAI และเข้าถึงได้จากคอมพิวเตอร์โลคัล
เปิดเทอร์มินัลอีกหน้าต่าง เชื่อมต่อไปยังเซิร์ฟเวอร์ จากนั้นไปที่ไดเรกทอรี ds4:
cd /workspace/motif3/ds4ตั้งค่าตัวแปรสภาพแวดล้อมที่จำเป็น:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
เริ่ม API server ด้วย context window 125K บน H200 ได้รับการตรวจสอบแล้วถึง 128K โดย 256K จะได้เพียง prefill บางส่วน ดังนั้น 125K จึงอยู่ในช่วงที่ทดสอบแล้ว:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768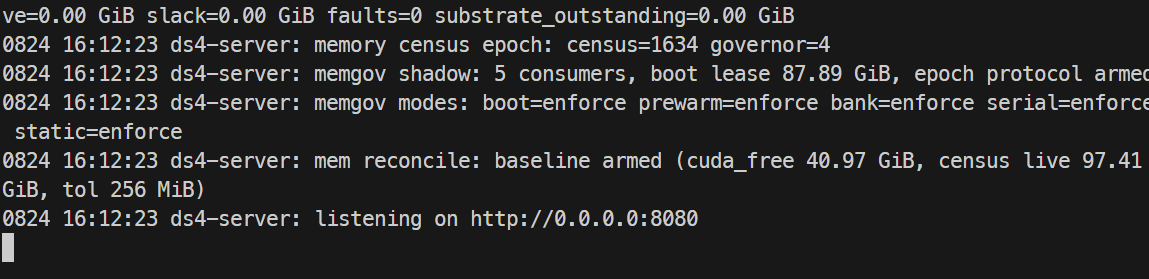
เปิดเทอร์มินัลนี้ค้างไว้
เนื่องจากได้ฟอร์เวิร์ดพอร์ต 8080 ผ่าน SSH ไว้ก่อนหน้า ตอนนี้สามารถเปิดเทอร์มินัล บนเครื่องโลคัล แล้วตรวจสอบ API ได้:
curl http://127.0.0.1:8080/v1/models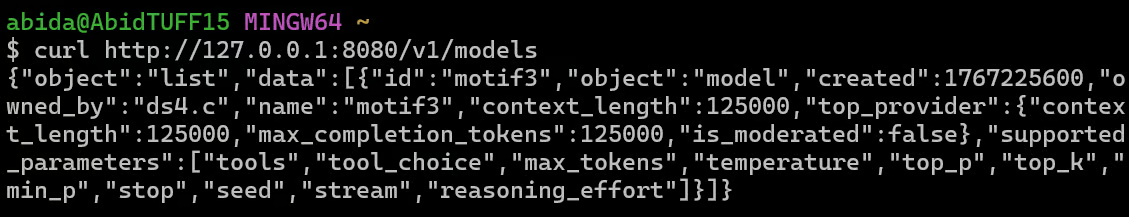
ควรเห็น motif-3 แสดงเป็นโมเดล พร้อมความยาวบริบท 125000.
ตอนนี้ส่งพรอมต์แรก:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'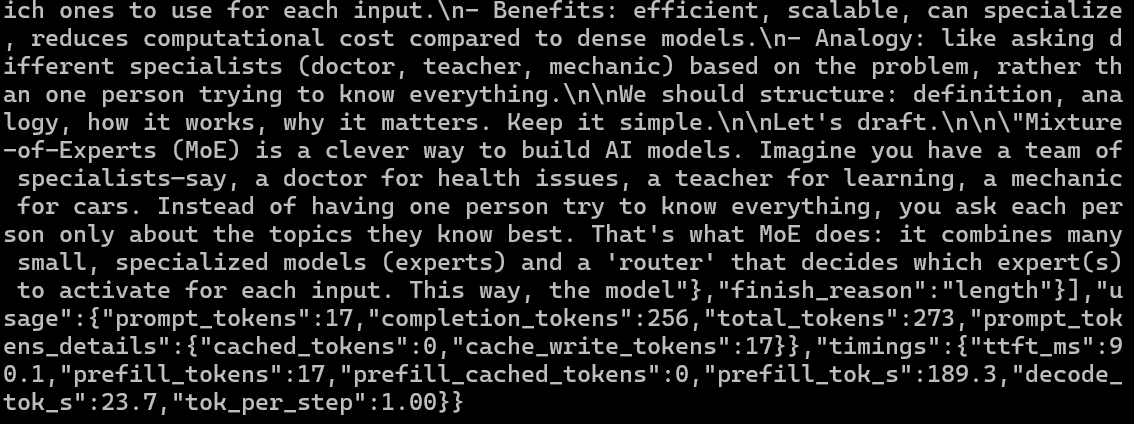
หากทุกอย่างทำงานได้ Motif-3 จะสร้างคำตอบจาก H200 โดยตรง ในการทดสอบ ได้ผลลัพธ์เมตริกดังนี้:
ยังสามารถตรวจสอบการใช้หน่วยความจำ GPU บนเซิร์ฟเวอร์ได้:
nvidia-smi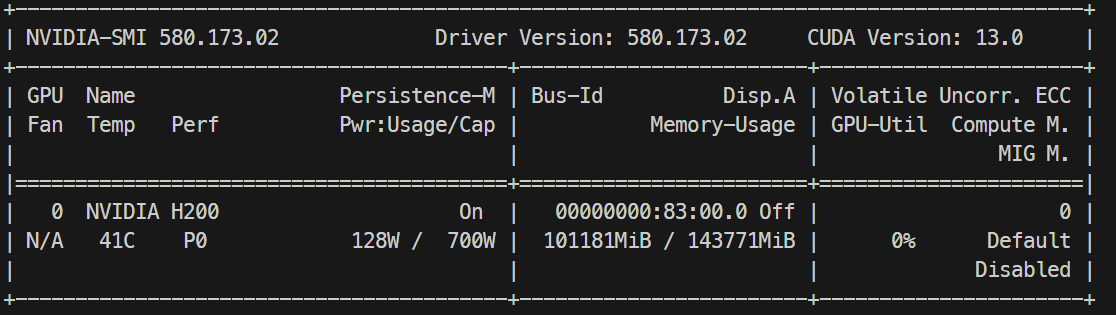
ในสภาพแวดล้อมทดสอบ Motif-3 ใช้หน่วยความจำ GPU ประมาณ 101GB จาก 141GB ที่ H200 รายงาน เหลือ VRAM สำหรับการอนุมานและ KV cache
ต่อไปจะเชื่อมต่อ API ของ Motif-3 โลคัลเข้ากับ Pi เพื่อให้โมเดลทำงานเป็นเอเจนต์โค้ดที่สามารถสร้างไฟล์ รันคำสั่ง และทำซ้ำงานในโปรเจ็กต์ได้
ตรวจสอบให้แน่ใจว่า Motif-3 ยังพร้อมใช้งานที่:
http://127.0.0.1:8080/v1ติดตั้ง Pi ด้วยตัวติดตั้งอย่างเป็นทางการ:
curl -fsSL https://pi.dev/install.sh | shรีสตาร์ตเทอร์มินัล จากนั้นยืนยันการติดตั้ง:
pi --versionPi รองรับโมเดลที่เข้ากันได้กับ OpenAI แบบกำหนดเองผ่าน ~/.pi/agent/models.json สร้างไฟล์คอนฟิก:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFตอนนี้สามารถมอบหมายงานโค้ดจริงให้ Motif-3 เพื่อดูว่าสามารถสร้าง รัน และปรับปรุงแอปพลิเคชันได้เองหรือไม่
สร้างโปรเจ็กต์ทดสอบและเริ่ม Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
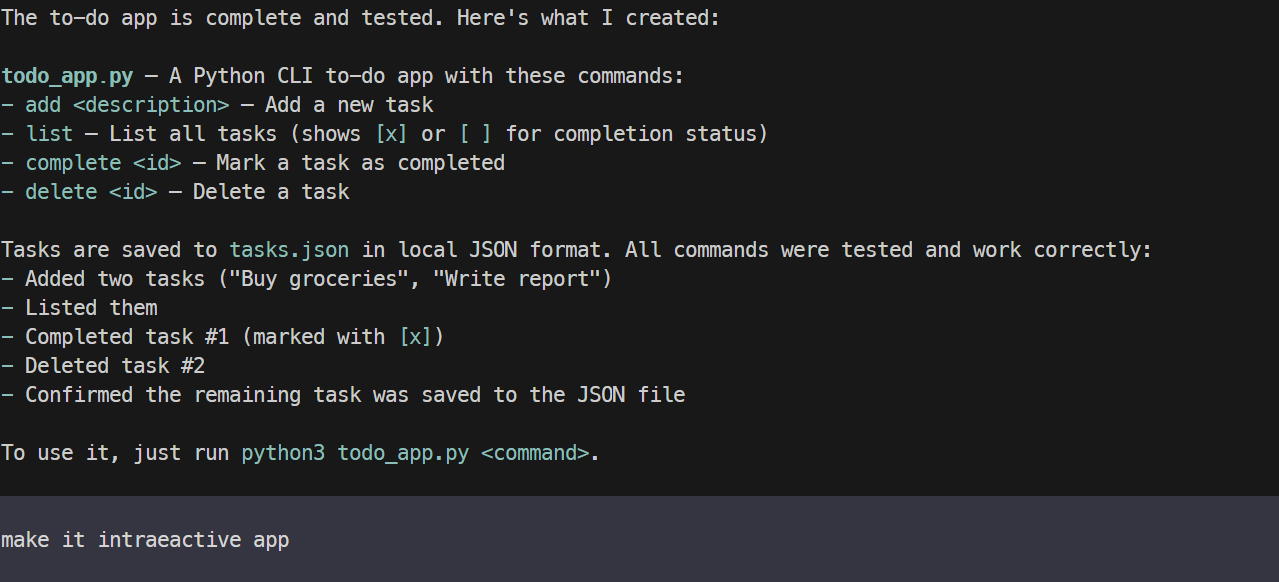
มาทดสอบโมเดลกัน เริ่มแรกจะให้สร้างแอป to-do แบบง่าย
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.ภายในไม่กี่นาที Motif-3 สร้างแอป CLI ที่ใช้งานได้และทดสอบสำเร็จ การทำงานเป็นไปด้วยดี แต่ส่วนติดต่อผู้ใช้เริ่มต้นยังพื้นฐานมาก
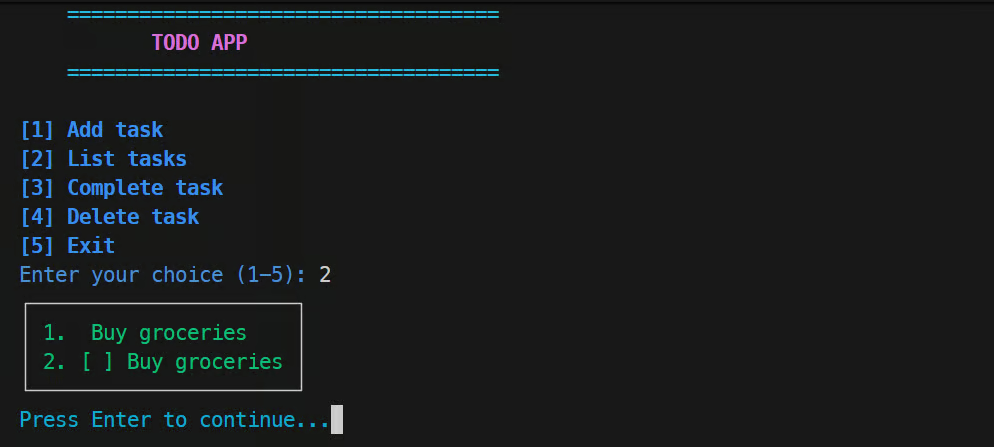
จากนั้นจึงขอให้เอเจนต์ทำให้แอปโต้ตอบได้มากขึ้นและมีสีสัน ปรับปรุงเลย์เอาต์ และยกระดับประสบการณ์ในเทอร์มินัล Motif-3 ปรับแก้โปรเจ็กต์เดิมแทนที่จะเริ่มใหม่ และเวอร์ชันที่ปรับปรุงดูเรียบร้อยขึ้นอย่างมาก
สุดท้าย ต้องการดูว่า Motif-3 ทำงานกับงานพัฒนาเว็บที่เน้นภาพได้อย่างไร ซึ่งการสร้างเว็บไซต์ที่ใช้งานได้เป็นเพียงส่วนหนึ่งของความท้าทาย
แอปเริ่มต้นใช้งานได้ แต่มีรายละเอียด UI หลายจุดที่ไม่ชอบ แทนที่จะให้พรอมต์รีดีไซน์ครั้งใหญ่ จึงขอให้แก้ปัญหาแต่ละข้อทีละอย่าง ปรับปรุงส่วนย่อยของอินเทอร์เฟซขณะทดสอบ
วิธีนี้ได้ผลเกินคาด Motif-3 ตรวจสอบโปรเจ็กต์ที่มีอยู่ ทำการเปลี่ยนแปลงแบบเจาะจง และขัดเกลา UI ซ้ำๆ โดยยังคงให้แอปทำงานได้ตามปกติ
โดยรวม ประทับใจทั้งด้านประสิทธิภาพการเขียนโค้ดและความสามารถในการทำซ้ำบนโปรเจ็กต์ที่มีอยู่ผ่าน Pi
โดยรวม ประสบการณ์ค่อนข้างหลากหลาย Motif-3 น่าประทับใจ แต่สำหรับคนส่วนใหญ่ยังมีโมเดลที่ดีกว่าและกินหน่วยความจำน้อยกว่าสำหรับการรัน
แม้จะควอนไทซ์แบบผสมซึ่งลดขนาดลงมากแล้ว ก็ยังต้องใช้หน่วยความจำ GPU หรือหน่วยความจำรวมราว 100GB ขึ้นไปเพื่อรันได้อย่างสบาย ด้วยเหตุนี้จึงมีโมเดลขนาดเล็กจำนวนมากที่รันได้ง่ายกว่า เช่น Qwen3.8-27B และโมเดลที่เน้นการโค้ดอื่นๆ
อย่างไรก็ดี หากต้องการสิ่งที่เข้าใกล้คลาสของ DeepSeek Flash Motif-3 ก็ยังน่าสนใจมาก รันได้เร็วบน H200 คุณภาพการโค้ดดี และน่าจะรีดประสิทธิภาพเพิ่มได้อีกด้วยการจูนที่ดีกว่า
ปัญหาหลักที่เจอคือกับเอเจนต์โค้ด Pi ซึ่งบางครั้งการสร้างผลลัพธ์จะหยุดหรือถูกขัดจังหวะ ได้เพิ่มลิมิตเอาต์พุตบางส่วนก็ช่วยได้ แต่ยังไม่แก้ได้ทั้งหมด นี่ยังเป็นครั้งแรกที่ใช้รันไทม์ DS4 จึงอาจมีสิ่งที่ปรับเพิ่มได้อีกในอนาคต
หากกำลังมองหาโมเดลที่พัฒนาโดยเกาหลี หรืออยากได้ทางเลือกนอกเหนือจากโมเดลที่พัฒนาโดยจีน นี่เป็นหนึ่งในตัวเลือกที่น่าสนใจในตอนนี้ และน่ายินดีที่เห็นหลายประเทศสร้างโมเดลและระบบนิเวศ AI ของตนเอง แทนที่จะพึ่งพาผู้ให้บริการรายใหญ่ไม่กี่ราย
เรียนรู้ AI กับ DataCamp!
Tracks
Tracks
Courses