Tracks
面向开发者的 AI 工程师助理
26小时
Motif-3 是来自 Motif Technologies 的大规模专家混合(MoE)模型,总参数量为 3140 亿,但每个 token 仅激活 132 亿参数。
它包含 384 个路由专家,支持 256K 上下文窗口,并在约 12.5 万亿 token 上完成训练,覆盖代码、数学、STEM、多语言数据及其他领域。
它尤其适合推理、编码和代理类工作负载。在 Artificial Analysis Intelligence Index 上得分 47,介于Qwen3.8-27B 和 MiniMax-M3(我们在类似环境中测试过)之间。
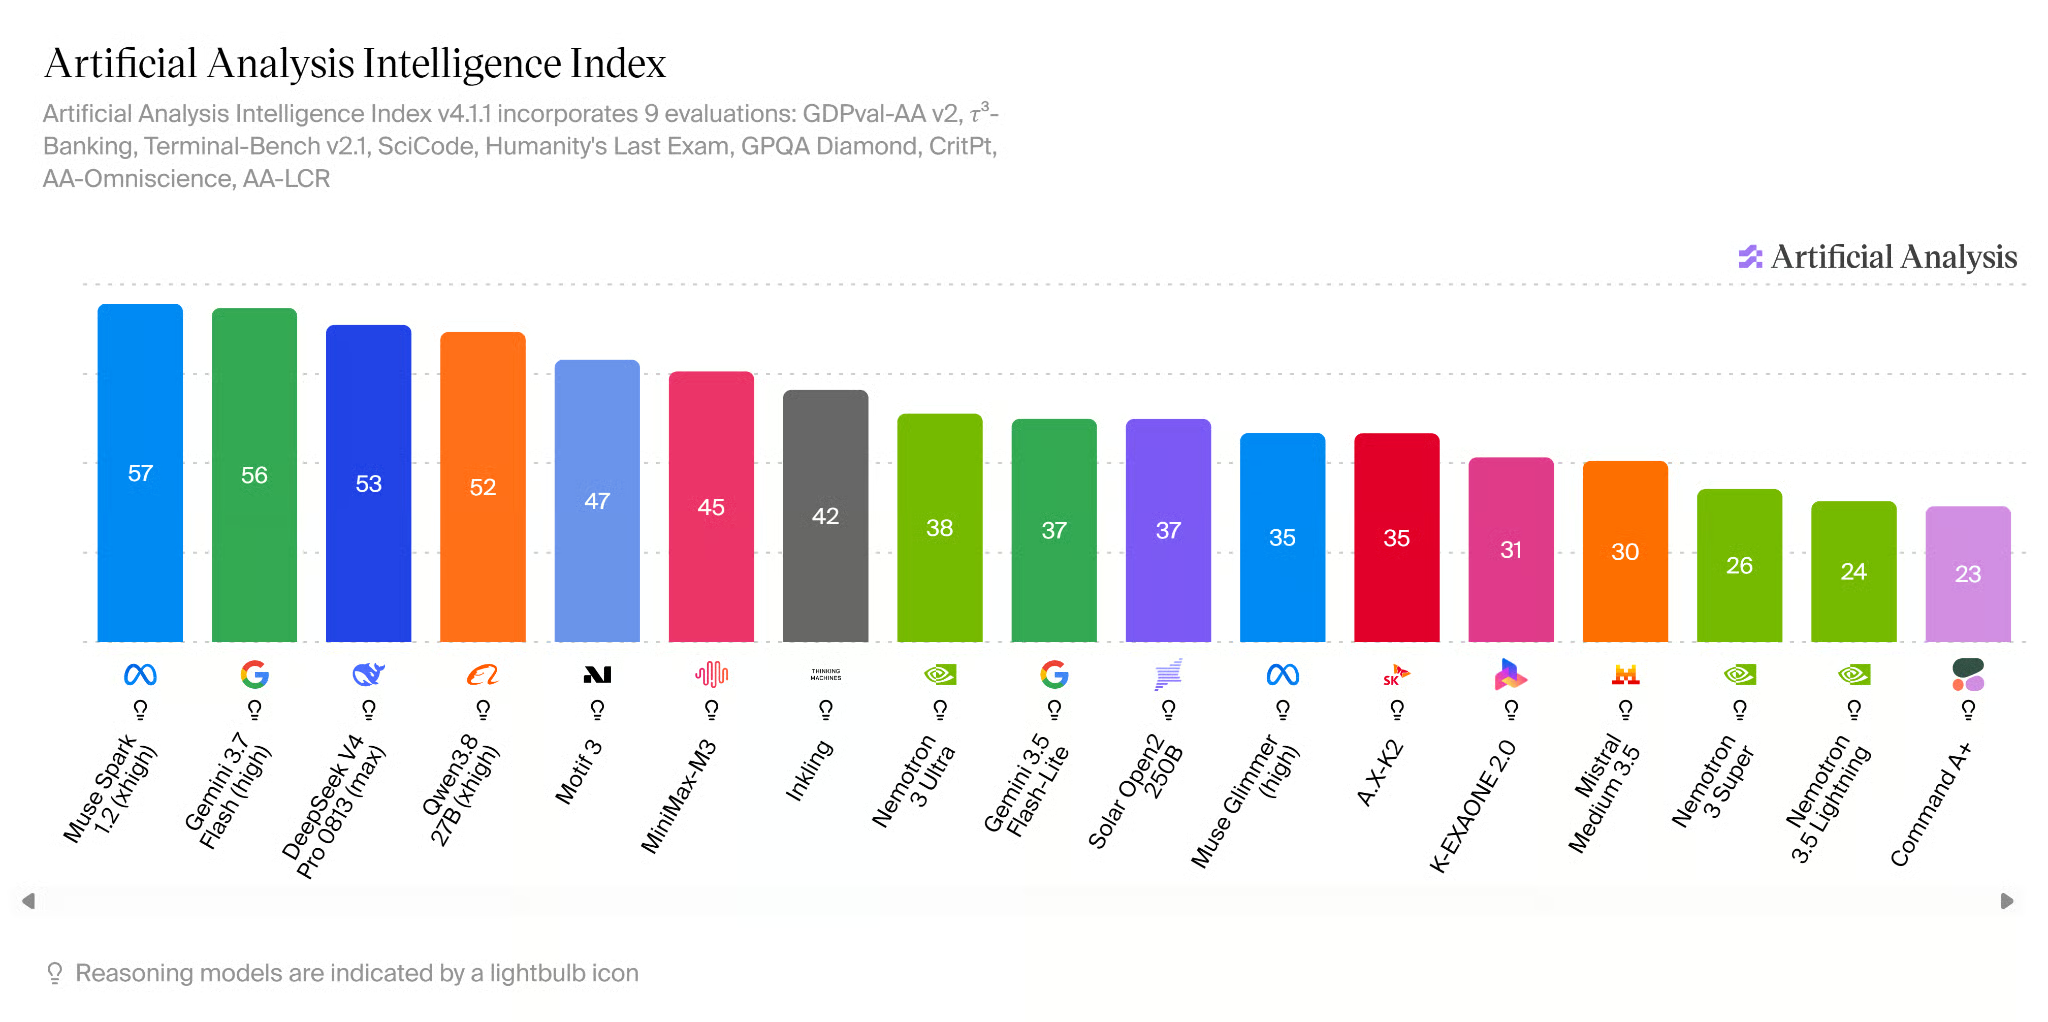
来源:AI Model & API Providers Analysis | Artificial Analysis
在本指南中,我们使用 Baekpica/Motif-3-Mixed-Quant-GGUF,这是一个独立制作的 Motif-3 量化版本。它不是对整个模型使用同一精度,而是采用混合量化,对关键组件使用更高精度,而对规模巨大的专家层使用更低精度。
例如,重要的注意力机制和始终激活的组件使用 Q8_0,而大部分路由专家权重使用 IQ2_XXS 和 Q2_K。该模型仍保留全部 384 个专家和全部 53 层,没有修剪或删除。因此模型大小约为 94GB,而 Q8_0 GGUF 大约为 335GB,使其足够小,可完全在 141GB 的 H200 上运行,同时为运行时和 KV 缓存留有额外显存。
想了解更多背景,建议阅读我们关于大语言模型量化和GGUF 格式的指南。
Motif-3 Mixed Quant 约为 94GB,您需要一块拥有足够显存的 GPU 来加载模型并为推理留出空间。建议从 Hyperbolic、RunPod 或 Vast.ai 等 GPU 云提供商租用一块 141GB 显存的 NVIDIA H200。
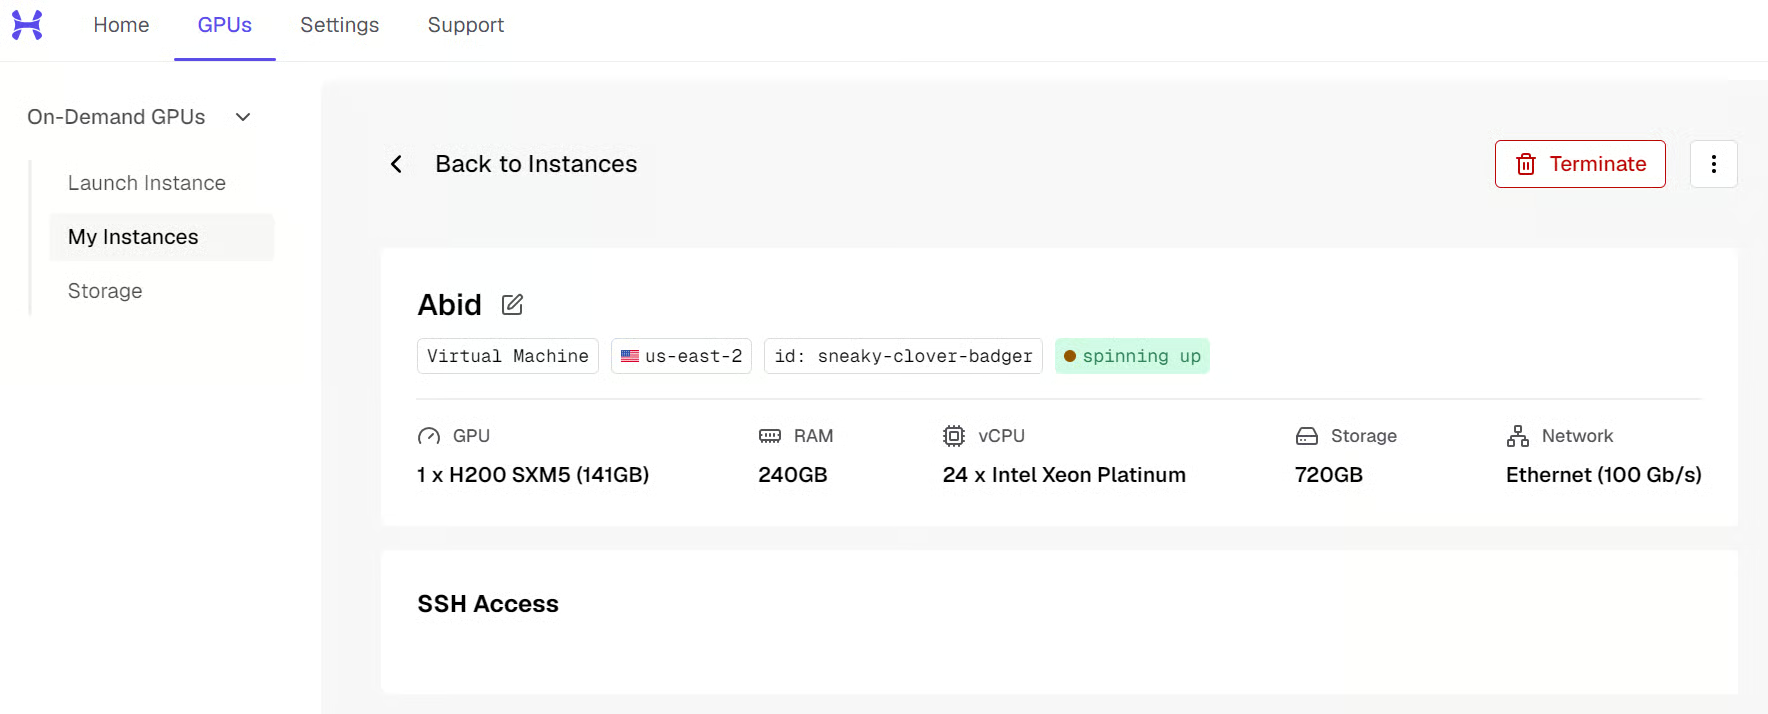
实例启动后,可通过终端或VS Code Remote SSH 连接。服务商会提供 IP 地址。命令类似于:
ssh root@<SERVER_IP> -L 8080:localhost:8080选项 -L 8080:localhost:8080 也会将 Motif-3 的 API 端口转发到您的本地电脑,稍后您可以通过 http://127.0.0.1:8080 访问。
现在准备服务器:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
最后,检查 H200 是否可用:
nvidia-smi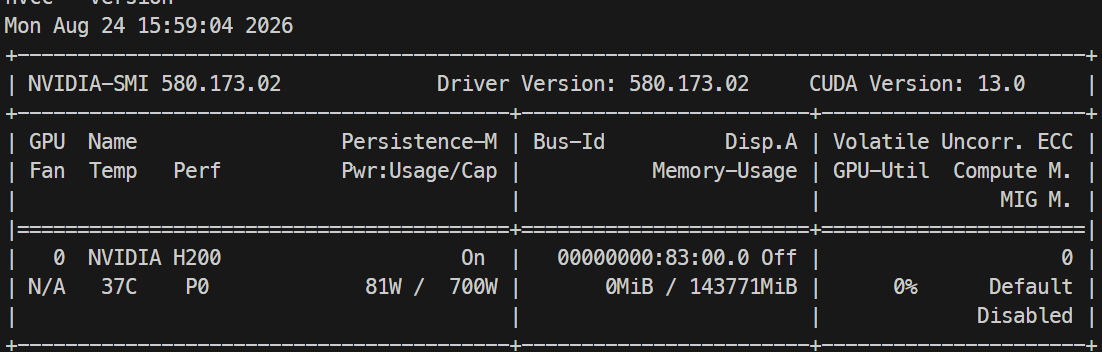
您应能看到一块 NVIDIA H200,显存约为 141GB。
接下来,从 Hugging Face 下载 Baekpica/Motif-3-Mixed-Quant-GGUF 模型。我们使用 MQ87-88-FIT 变体,它被拆分为 11 个 GGUF 文件,总大小约 94GB。
在 /workspace/motif3 目录中运行:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model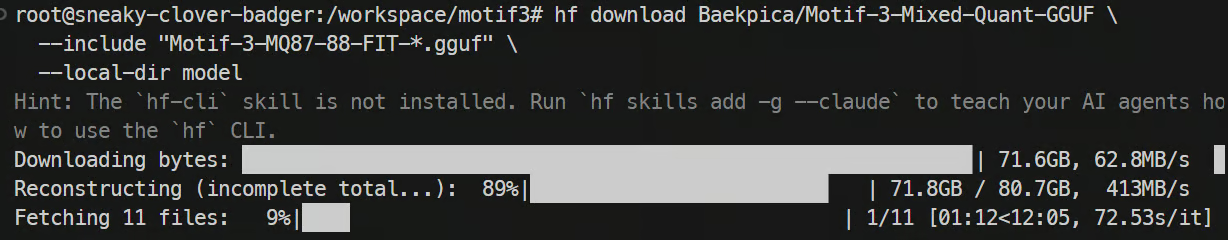
根据您的网络情况,下载全部 94GB 可能需要一些时间。完成后,检查所有分片是否齐全:
ls -lh model在合并前请校验分片。合并会对 94GB 的数据进行一次性操作,因此现在发现下载问题更省事:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..ds4 运行时期望模型为单一 GGUF 文件,因此我们需要先将下载的 11 个分片合并。
克隆 llama.cpp 并构建其 GGUF 工具:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
现在将 11 个分片合并为一个文件:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
检查合并后的模型:
ls -lh motif3.gguf您应该能看到一个较大的 motif3.gguf 文件。
我们需要 ds4 运行时,以在 NVIDIA H200 上高效加载并提供 Motif-3 服务。
克隆 dfm 分支:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
为 H200(Hopper,sm_90)开启 CUDA 支持进行编译。请注意,ds4 的主要目标是 DGX Spark/GB10,对 H200 的支持来自项目的移植工作,而非其主服务路径:
make cuda CUDA_ARCH=sm_90 -j$(nproc)检查可执行文件是否成功生成:
ls -lh ds4*您应能看到如 ds4-server、ds4_weight_server 等二进制文件。
权重服务器在 GPU 上加载并管理模型权重,以便 API 服务器可使用其进行推理。
首先,为运行时文件和 KV 缓存创建目录:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
先运行预检,确认模型能装载成功,再执行完整加载:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
如果通过预检,则在不带 --dry-run 的情况下再次运行同一命令:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned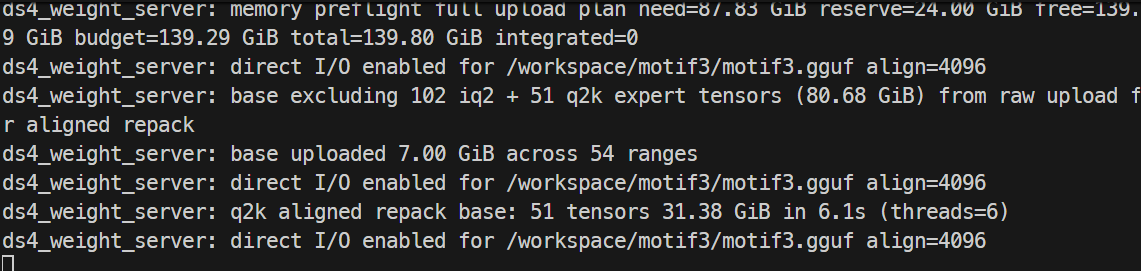
保持该终端运行。运行 Motif-3 期间,权重服务器需要保持活动状态。
现在我们将启动 ds4 API 服务器,它通过一个兼容 OpenAI 的端点对外暴露 Motif-3,您可以从本地电脑访问。
打开另一个终端连接到服务器,然后进入 ds4 目录:
cd /workspace/motif3/ds4设置所需环境变量:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
以 125K 上下文窗口启动 API 服务器。在 H200 上,运行时验证到 128K,256K 仅能部分预填,因此 125K 位于已测试范围内:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768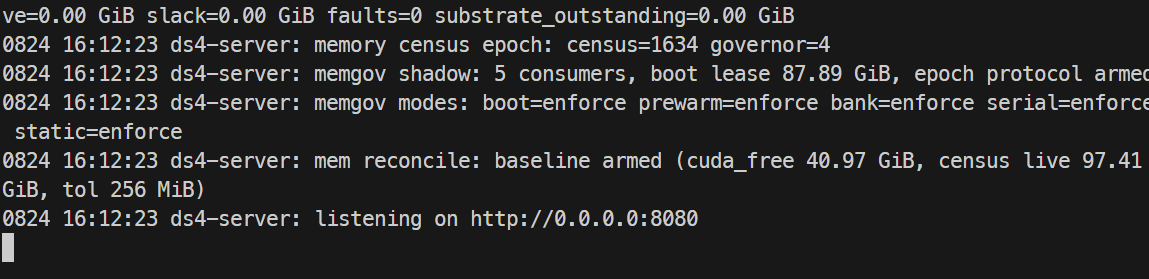
保持该终端运行。
由于我们之前通过 SSH 转发了 8080 端口,现在您可以在本地电脑打开一个终端并检查 API:
curl http://127.0.0.1:8080/v1/models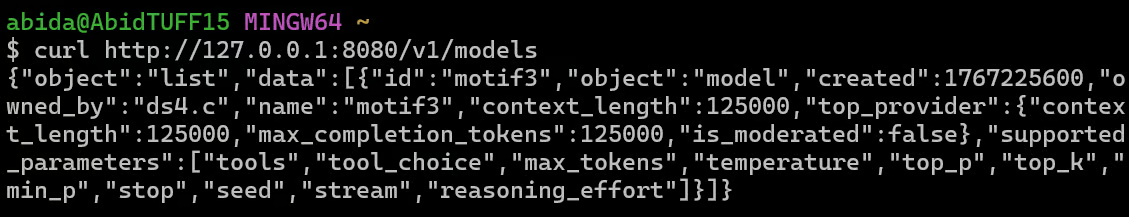
您应能看到列出了 motif-3 模型,且上下文长度为 125000。
现在发送您的第一个提示:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'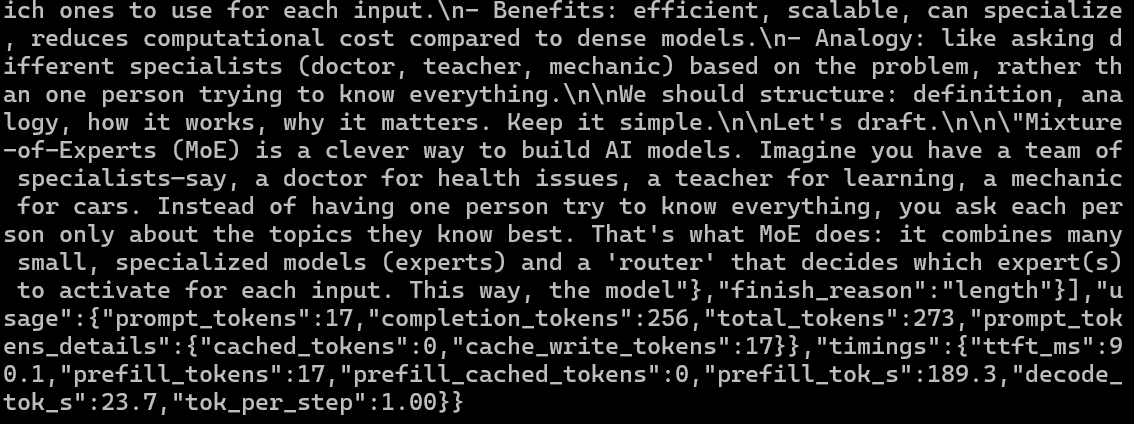
如果一切正常,Motif-3 将直接在您的 H200 上生成响应。在我的测试中,模型达到了以下指标:
您也可以在服务器上查看 GPU 内存使用情况:
nvidia-smi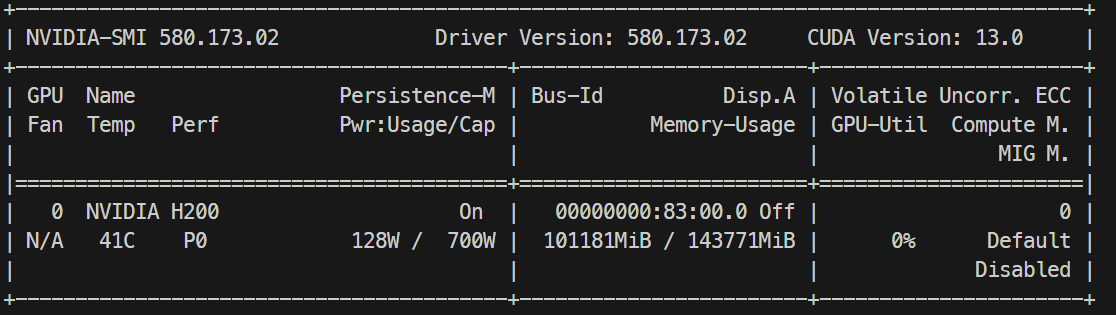
在我的设置中,Motif-3 占用了 H200 报告的 141GB 显存中的约 101GB,为推理和 KV 缓存保留了额外显存。
现在我们将把本地的 Motif-3 API 连接到 Pi,使模型可以作为编码代理创建文件、运行命令并对项目进行迭代。
请确保 Motif-3 仍可通过以下地址访问:
http://127.0.0.1:8080/v1使用官方安装程序安装 Pi:
curl -fsSL https://pi.dev/install.sh | sh重启您的终端,然后确认安装:
pi --versionPi 通过 ~/.pi/agent/models.json 支持自定义兼容 OpenAI 的模型。创建配置:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOF现在我们可以给 Motif-3 一个真实的编码任务,看看它能否自主构建、运行并改进一个应用。
创建一个测试项目并启动 Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
我们来测试一下模型。首先,我们让它构建一个简单的待办应用。
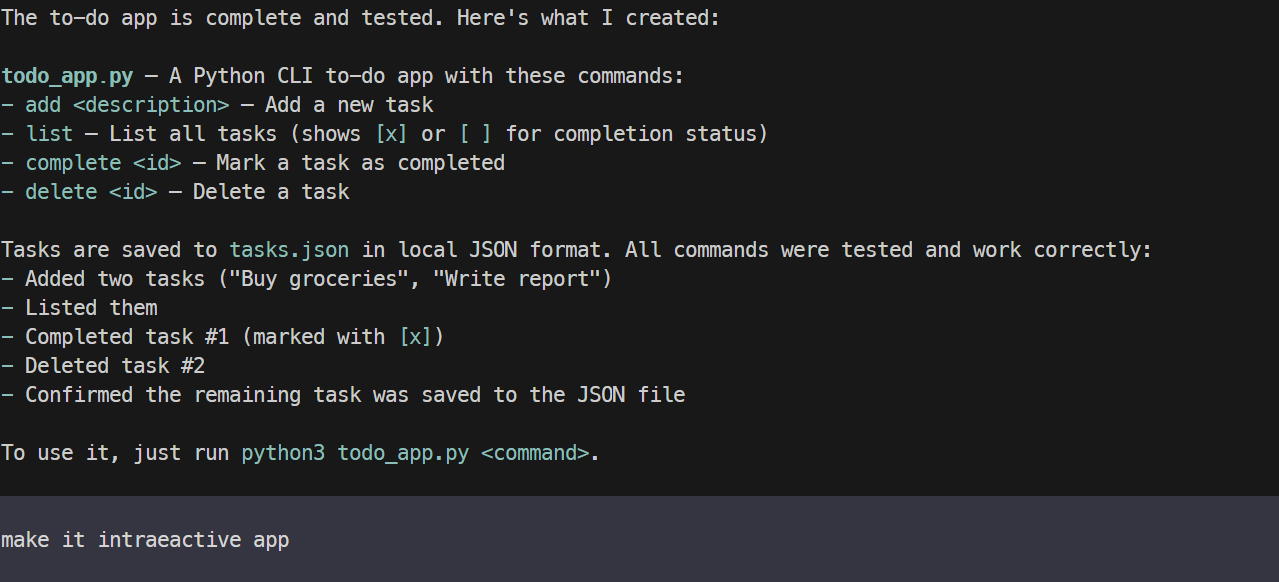
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.几分钟内,Motif-3 就创建了可用的 CLI 应用并成功进行了测试。功能表现良好,但初始界面非常基础。
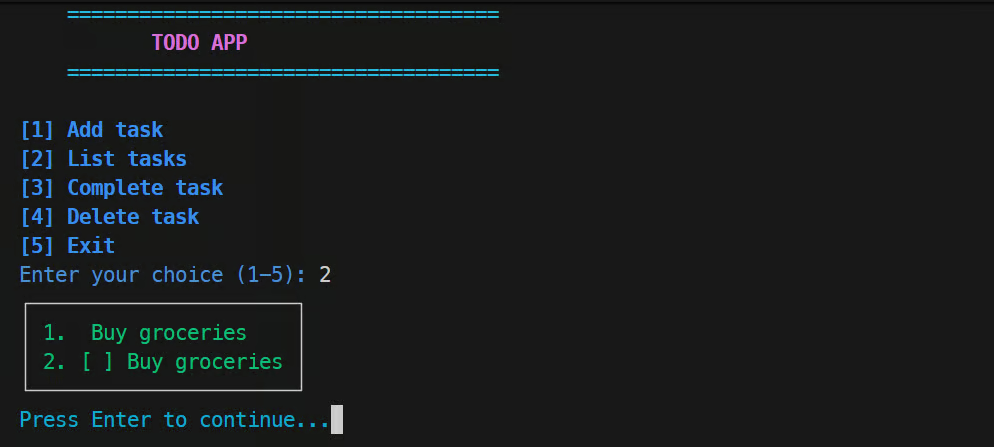
随后我让代理使应用更具交互性和色彩,改进布局并提升终端体验。Motif-3 没有重头开始,而是在现有项目上进行修改,改进后的版本更加精致。
最后,我想看看 Motif-3 在更具视觉性的 Web 开发任务上的表现,在这类任务中,生成可用网站只是挑战的一部分。
初始应用可以运行,但有一些我不喜欢的 UI 细节。我没有给模型一个庞大的重设计提示,而是逐条让它修复问题,在测试的同时改进界面的各个部分。
效果出乎意料地好。Motif-3 能够检查现有项目、进行针对性修改,并在保持应用可用的同时反复打磨 UI。
总体而言,我对它的编码表现以及通过 Pi 在现有项目上迭代的能力都印象深刻。
总体体验有点复杂。Motif-3 令人印象深刻,但对大多数人来说,还有更好且对内存要求更低的模型可供运行。
即使采用大幅减小体积的混合量化,您仍需要大约 100GB 或更多的 GPU 或合并内存才能舒适运行。因此,有许多更小的模型更易于使用,比如 Qwen3.8-27B 及其他偏向编码的模型。
话虽如此,如果您想要更接近DeepSeek Flash 这一类模型的选择,Motif-3 依然非常有趣。它在 H200 上速度很快,编码质量不错,而且通过更好的调优大概率还能挖掘更多性能。
我遇到的主要问题在于 Pi 编码代理,生成有时会停止或被中断。我提高了一些输出限制后情况有所改善,但并未完全解决。这也是我第一次使用 DS4 运行时,未来可能还有更多可优化的空间。
尽管如此,如果您特意寻找一款韩国研发的模型,或想要替代中国研发的模型,这是当下较有意思的选项之一。同样令人欣喜的是,越来越多国家在构建自己的 AI 模型与生态,而不是只依赖少数几家主要供应商。
与 DataCamp 一起学习 AI!
Tracks
Tracks
Courses