
Lernpfad
Associate AI Engineer für Entwickler
26 Std.
Motif-3 ist ein großskaliges Mixture-of-Experts (MoE)-Modell von Motif Technologies mit insgesamt 314 Milliarden Parametern, von denen pro Token nur 13,2 Milliarden aktiviert werden.
Es verfügt über 384 geroutete Experts, ein Kontextfenster von 256K und wurde auf rund 12,5 Billionen Tokens trainiert – einschließlich Code, Mathematik, MINT-Inhalten, mehrsprachigen Daten und weiteren Domänen.
Es eignet sich besonders gut für Reasoning, Coding und agentische Workloads. Auf dem Artificial Analysis Intelligence Index erreicht es einen Score von 47 und liegt damit zwischen Qwen3.8-27B und MiniMax-M3, das wir in einem ähnlichen Setup getestet haben.
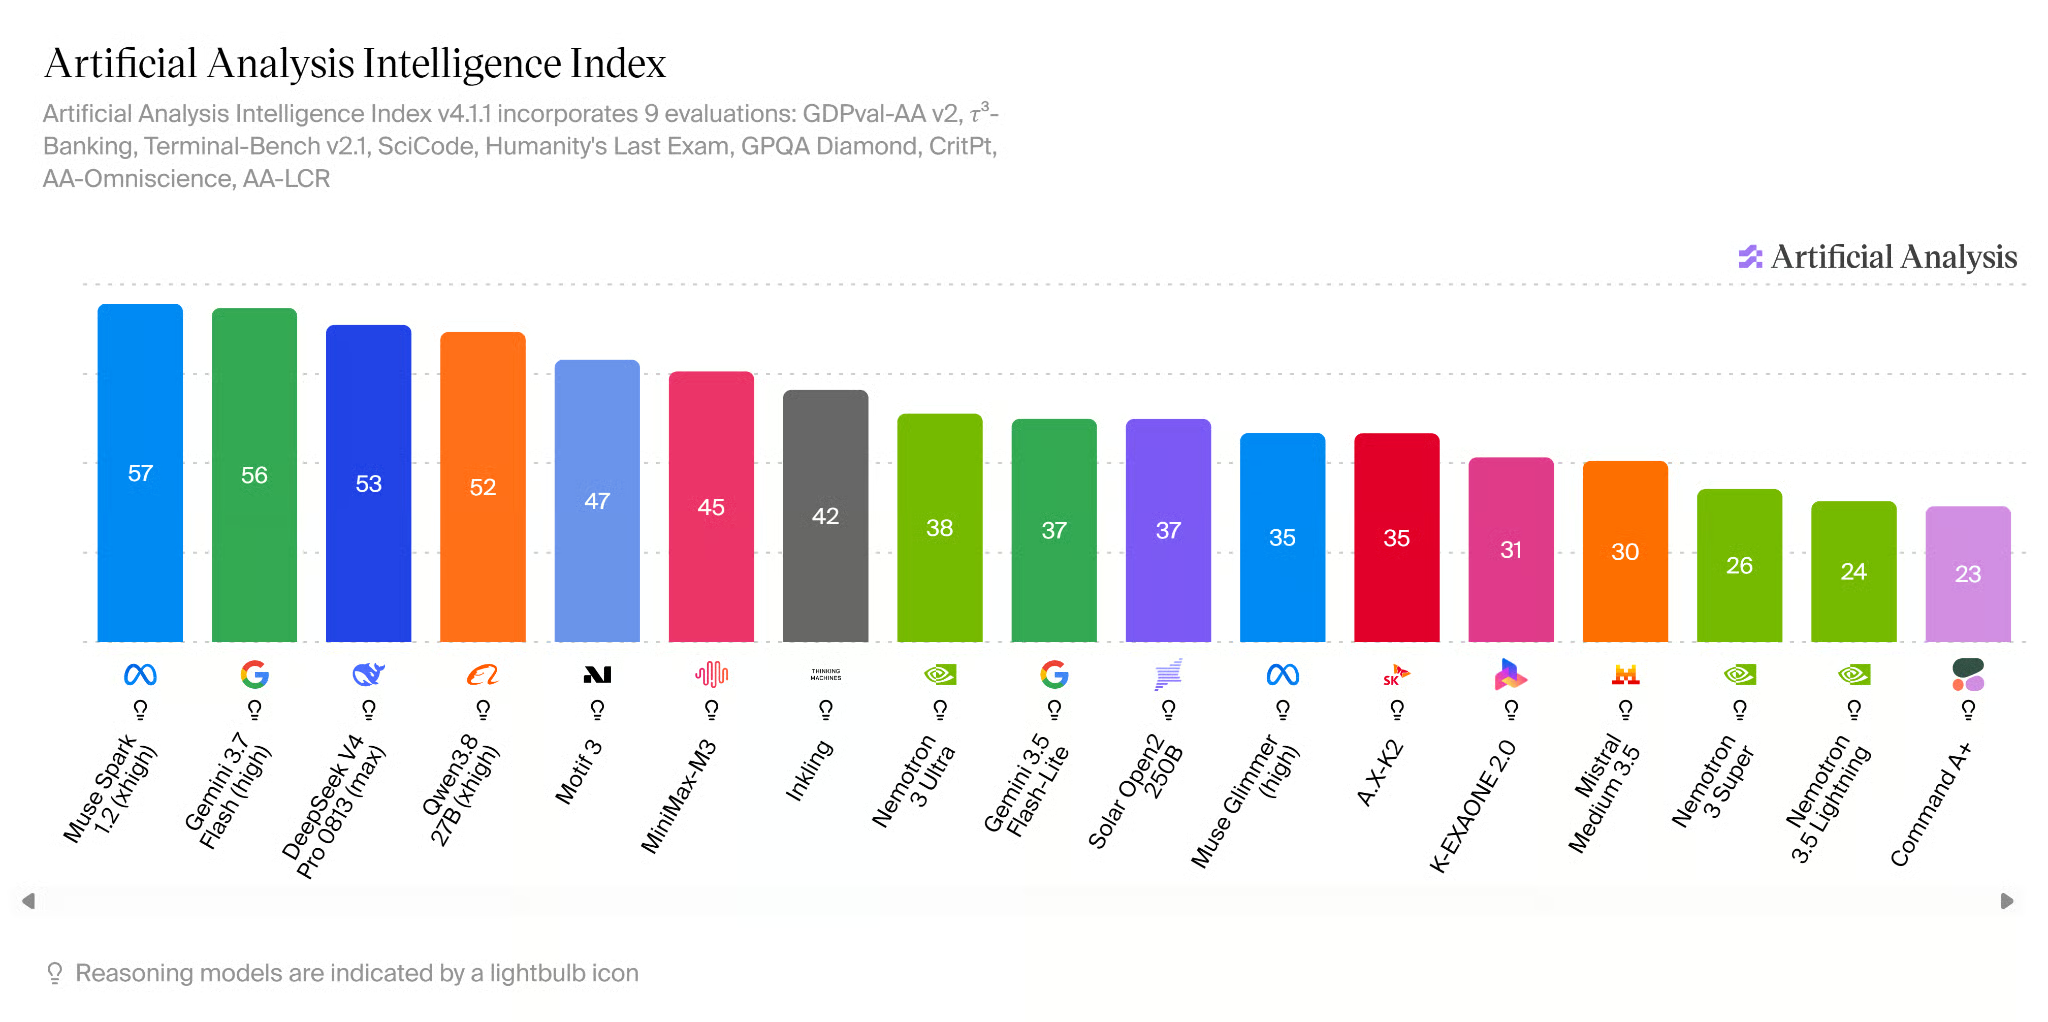
Quelle: AI Model & API Providers Analysis | Artificial Analysis
Für diesen Guide verwenden wir Baekpica/Motif-3-Mixed-Quant-GGUF, eine unabhängig erstellte quantisierte Version von Motif-3. Statt durchgängig eine Präzision zu nutzen, setzt sie auf gemischte Quantisierung: Wichtigere Komponenten laufen in höherer Präzision, während die enorm großen Expert-Layer deutlich niedriger quantisiert sind.
Beispielsweise verwenden zentrale Attention- und stets aktive Komponenten Q8_0, während ein Großteil der gerouteten Expert-Gewichte mit IQ2_XXS und Q2_K quantisiert ist. Das Modell behält dennoch alle 384 Experts und alle 53 Layer – es wird nichts beschnitten oder entfernt. Damit sinkt die Größe auf ungefähr 94 GB (gegenüber ca. 335 GB für Q8_0 GGUF) und ist klein genug, um vollständig auf einer H200 mit 141 GB VRAM zu laufen – mit zusätzlichem Spielraum für Runtime und KV-Cache.
Für mehr Hintergrund empfehle ich unsere Guides zur Quantisierung von LLMs und zum GGUF-Format.
Motif-3 Mixed Quant ist rund 94 GB groß. Du brauchst also eine GPU mit genügend VRAM, um das Modell zu laden und noch Platz für die Inferenz zu lassen. Ich empfehle eine einzelne NVIDIA H200 mit 141 GB VRAM von einem GPU-Cloud-Anbieter wie Hyperbolic, RunPod oder Vast.ai.
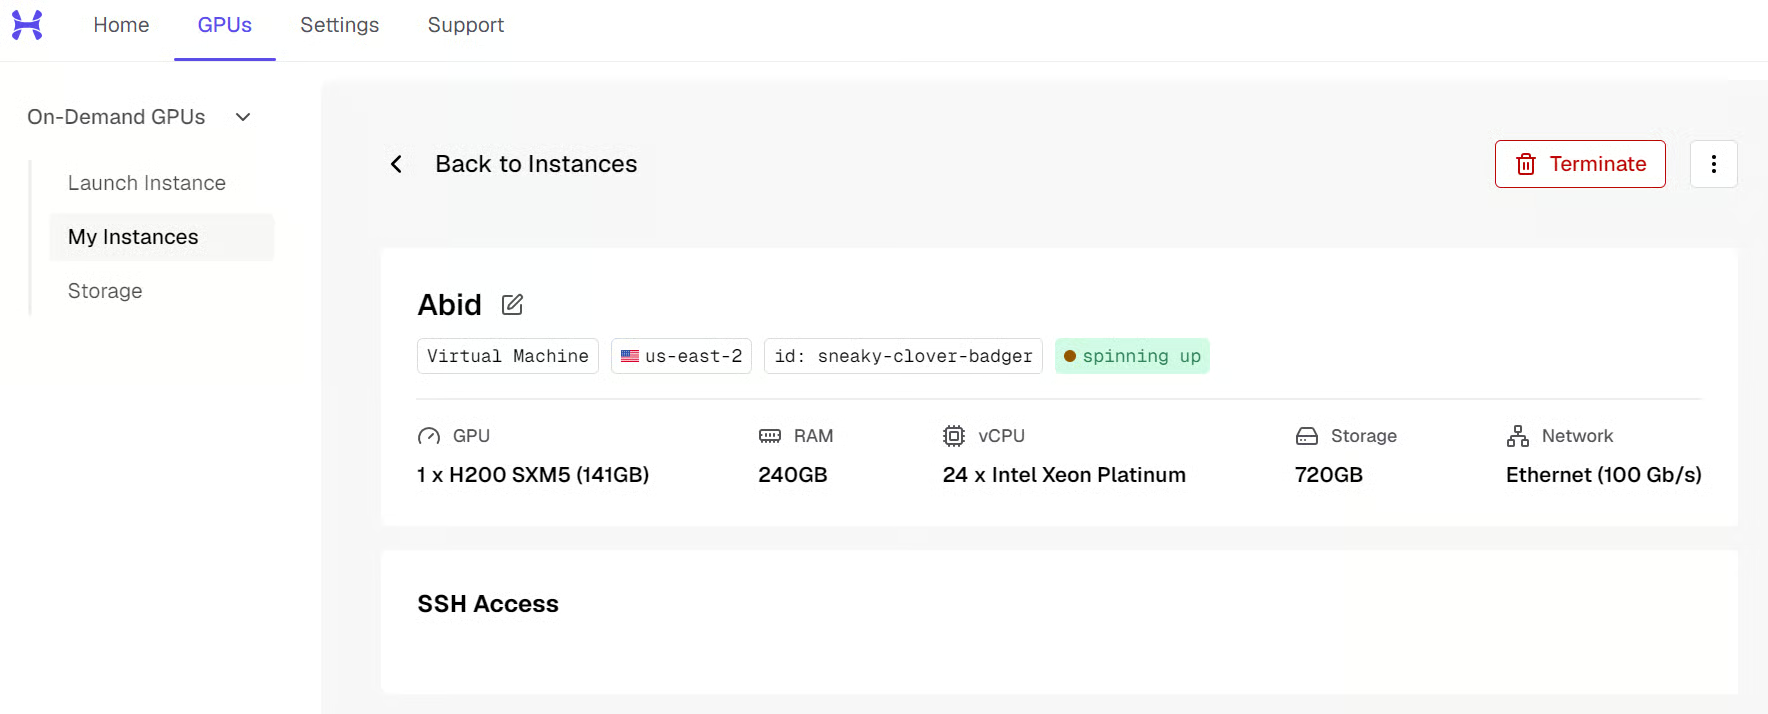
Sobald deine Instanz läuft, verbindest du dich per Terminal oder über VS Code Remote SSH. Die IP-Adresse bekommst du vom Provider. Der Befehl sieht ähnlich aus wie:
ssh root@<SERVER_IP> -L 8080:localhost:8080Die Option -L 8080:localhost:8080 leitet außerdem den Motif-3-API-Port auf deinen lokalen Rechner weiter. Später erreichst du sie unter http://127.0.0.1:8080.
Jetzt bereitest du den Server vor:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Zum Schluss prüfst du, ob die H200 verfügbar ist:
nvidia-smi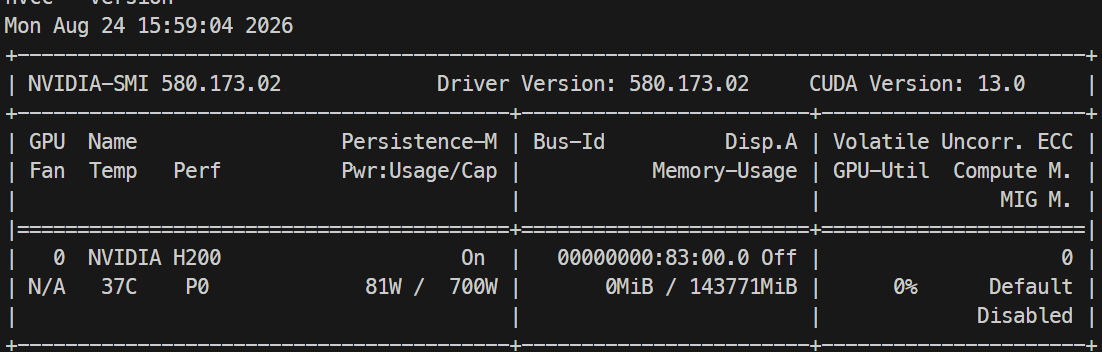
Du solltest eine NVIDIA H200 mit ungefähr 141 GB VRAM sehen.
Als Nächstes lädst du das Modell Baekpica/Motif-3-Mixed-Quant-GGUF von Hugging Face herunter. Wir nutzen die MQ87-88-FIT-Variante, die in 11 GGUF-Dateien aufgeteilt ist und zusammen etwa 94 GB umfasst.
Führe im Verzeichnis /workspace/motif3 aus:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model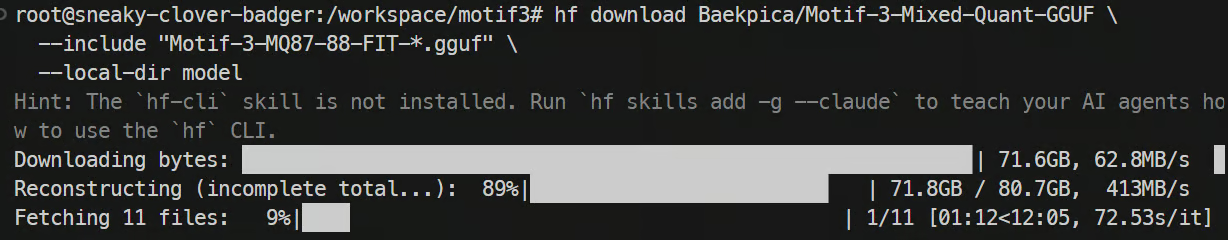
Je nach Verbindung kann der Download der 94 GB dauern. Prüfe danach, ob alle Shards vorhanden sind:
ls -lh modelVor dem Mergen solltest du die Shards verifizieren. Das Zusammenführen ist ein One-Shot-Vorgang über 94 GB – es lohnt sich, fehlerhafte Downloads jetzt zu entdecken:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Die ds4-Laufzeit erwartet das Modell als eine einzelne GGUF-Datei. Wir müssen also die 11 heruntergeladenen Shards mergen.
Klonen von llama.cpp und Bauen des GGUF-Tools:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Jetzt alle 11 Shards zu einer Datei mergen:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Das zusammengeführte Modell prüfen:
ls -lh motif3.ggufDu solltest eine große Datei motif3.gguf sehen.
Wir benötigen die ds4-Laufzeit, um Motif-3 effizient auf der NVIDIA H200 zu laden und bereitzustellen.
Klonen des dfm-Branches:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Mit CUDA-Support für die H200 (Hopper, sm_90) kompilieren. Beachte: Das Primärziel von ds4 ist die DGX Spark/GB10; H200-Support stammt aus dem Bring-up des Projekts und nicht aus dem Haupt-Serving-Pfad:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Prüfe, ob die Binärdateien erfolgreich erstellt wurden:
ls -lh ds4*Du solltest Binärdateien wie ds4-server und ds4_weight_server sehen.
Der Weight-Server lädt und verwaltet die Modellgewichte auf der GPU, damit der API-Server sie für die Inferenz nutzen kann.
Zuerst legst du Verzeichnisse für Runtime-Dateien und den KV-Cache an:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Führe zuerst den Preflight aus, um zu prüfen, ob das Modell passt, bevor du den vollständigen Ladevorgang startest:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Wenn das durchläuft, starte denselben Befehl ohne --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned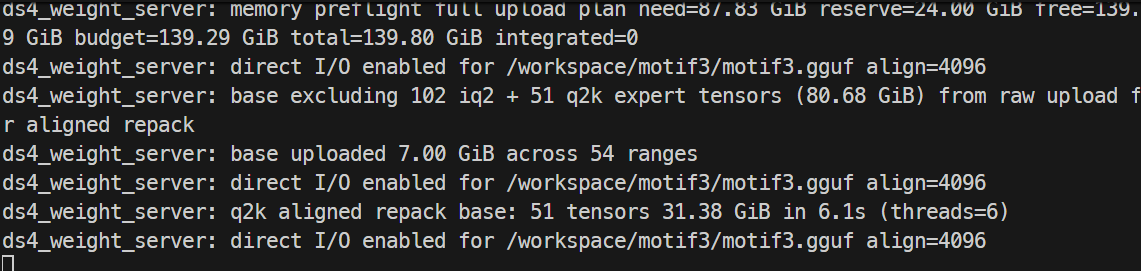
Lass dieses Terminal geöffnet. Der Weight-Server muss aktiv bleiben, während du Motif-3 nutzt.
Jetzt starten wir den ds4-API-Server. Er stellt Motif-3 über einen OpenAI-kompatiblen Endpoint bereit, auf den du von deinem lokalen Rechner aus zugreifen kannst.
Öffne ein weiteres Terminal, verbinde dich mit dem Server und wechsle in das Verzeichnis ds4:
cd /workspace/motif3/ds4Setze die benötigten Umgebungsvariablen:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Starte den API-Server mit einem 125K-Kontextfenster. Auf der H200 ist der Runtime-Pfad bis 128K validiert; 256K erreicht nur partielles Prefill. 125K liegt also innerhalb des getesteten Bereichs:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768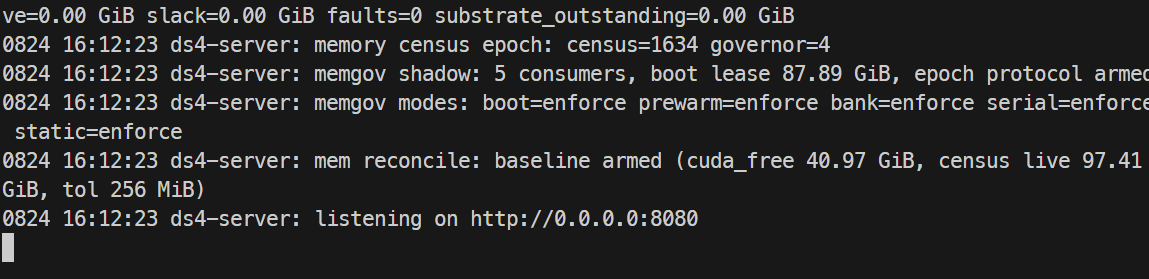
Lass dieses Terminal geöffnet.
Da wir Port 8080 vorhin per SSH weitergeleitet haben, kannst du jetzt ein Terminal auf deinem lokalen Rechner öffnen und die API prüfen:
curl http://127.0.0.1:8080/v1/models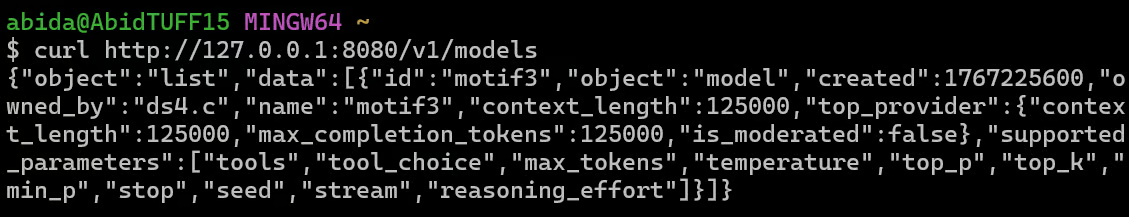
Du solltest motif-3 als Modell mit einer Kontextlänge von 125000 sehen.
Jetzt sendest du deinen ersten Prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'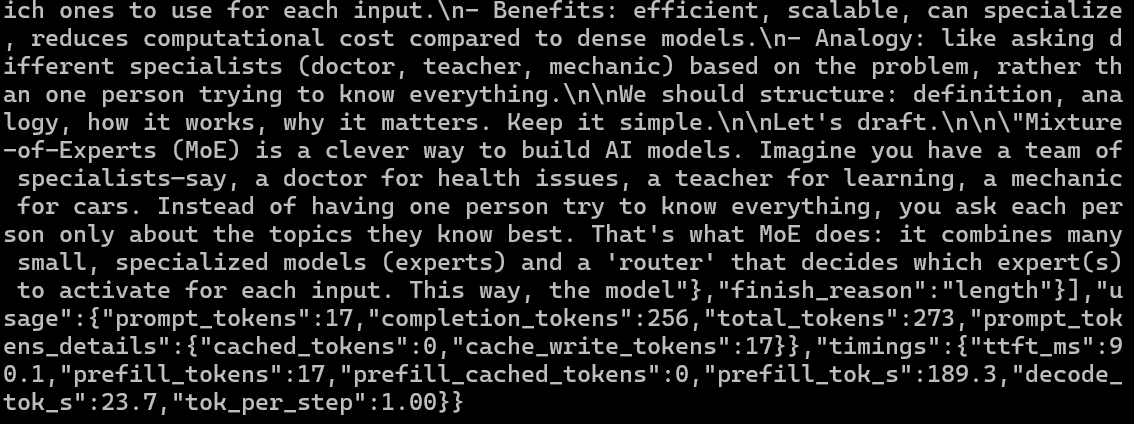
Wenn alles funktioniert, generiert Motif-3 die Antwort direkt von deiner H200. In meinem Test erzielte das Modell folgende Werte:
Du kannst auf dem Server auch die GPU-Speicherauslastung prüfen:
nvidia-smi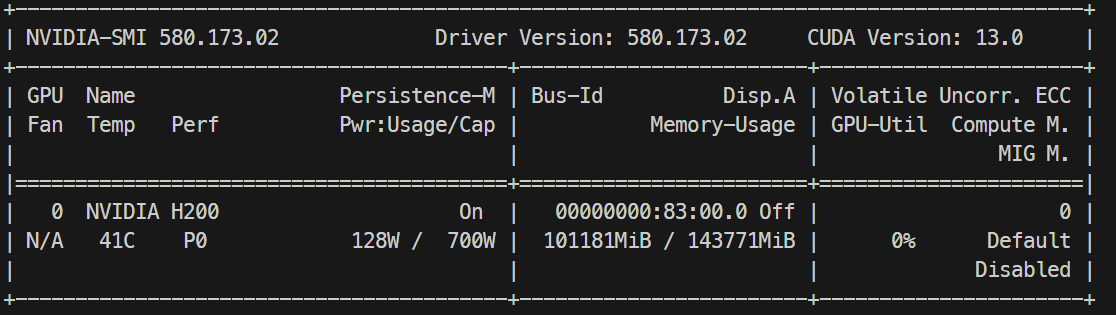
In meinem Setup belegte Motif-3 rund 101 GB der 141 GB VRAM der H200, mit zusätzlichem Puffer für Inferenz und den KV-Cache.
Jetzt verbinden wir die lokale Motif-3-API mit Pi, damit das Modell als Coding-Agent arbeiten kann: Dateien anlegen, Befehle ausführen und iterativ an einem Projekt arbeiten.
Stelle sicher, dass Motif-3 weiterhin hier erreichbar ist:
http://127.0.0.1:8080/v1Installiere Pi mit dem offiziellen Installer:
curl -fsSL https://pi.dev/install.sh | shStarte dein Terminal neu und prüfe die Installation:
pi --versionPi unterstützt benutzerdefinierte OpenAI-kompatible Modelle über ~/.pi/agent/models.json. Erstelle die Konfiguration:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFJetzt geben wir Motif-3 eine echte Coding-Aufgabe und sehen, ob es eine Anwendung selbstständig bauen, ausführen und verbessern kann.
Lege ein Testprojekt an und starte Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
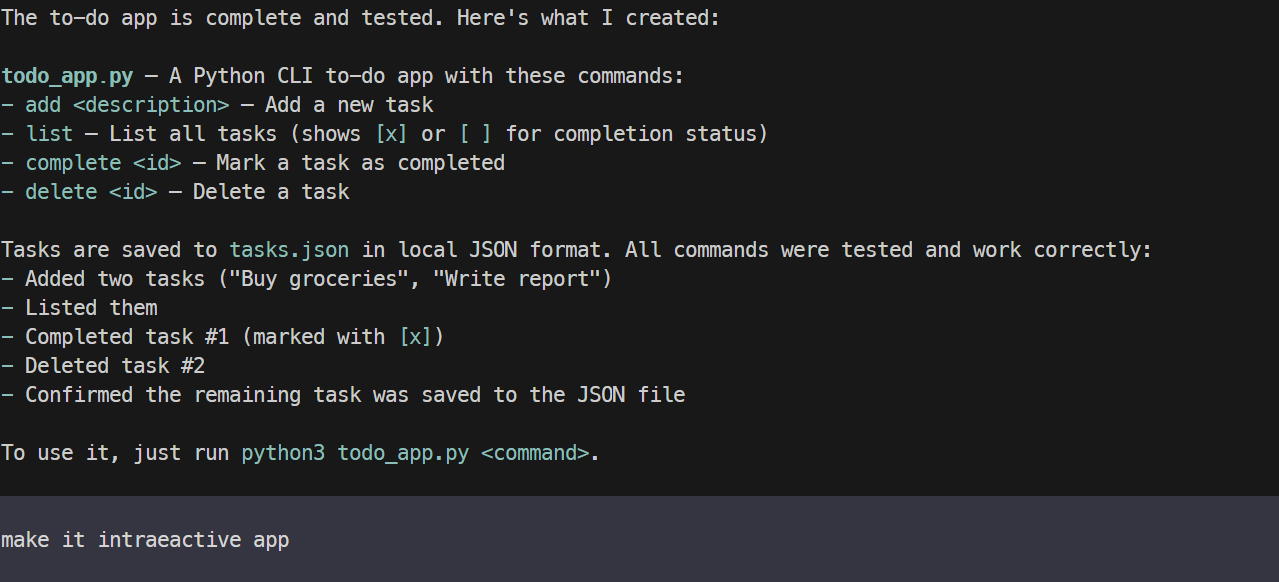
Testen wir das Modell: Zuerst lassen wir eine einfache To-do-App bauen.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Nach wenigen Minuten erstellte Motif-3 eine funktionierende CLI-Anwendung und testete sie erfolgreich. Die Funktionen liefen gut, aber die erste Oberfläche war sehr schlicht.
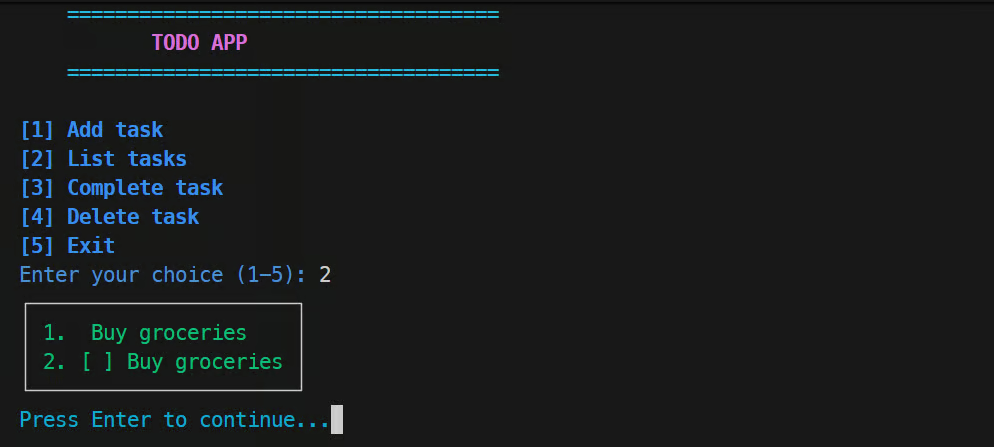
Anschließend bat ich den Agenten, die Anwendung interaktiver und farbiger zu machen, das Layout zu verbessern und die Terminal-Erfahrung aufzuwerten. Motif-3 passte das bestehende Projekt an, statt neu anzufangen, und die überarbeitete Version wirkte deutlich ausgereifter.
Zum Schluss wollte ich sehen, wie sich Motif-3 bei einer visuelleren Webentwicklungsaufgabe schlägt, bei der ein funktionierendes Frontend nur ein Teil der Herausforderung ist.
Die erste Version lief, aber einige UI-Details gefielen mir nicht. Anstatt einen einzigen, großen Redesign-Prompt zu geben, ließ ich das Modell die Punkte nacheinander verbessern und habe dabei jeden Bereich separat getestet.
Das funktionierte überraschend gut. Motif-3 konnte das bestehende Projekt inspizieren, gezielte Änderungen vornehmen und die UI wiederholt verfeinern – bei weiterhin funktionierender Anwendung.
Insgesamt war ich sowohl von der Coding-Performance als auch von der Fähigkeit, über Pi iterativ an einem bestehenden Projekt zu arbeiten, positiv überrascht.
Insgesamt war meine Erfahrung etwas gemischt. Motif-3 ist beeindruckend, aber für die meisten Anwendungsfälle gibt es bessere und speicherschonendere Modelle.
Selbst mit gemischter Quantisierung, die die Größe deutlich reduziert, brauchst du immer noch rund 100 GB oder mehr GPU- bzw. Gesamtspeicher, um es komfortabel zu betreiben. Daher gibt es viele kleinere Modelle, die deutlich einfacher zu nutzen sind – etwa Qwen3.8-27B und andere Coding-fokussierte Modelle.
Wenn du jedoch etwas in der DeepSeek Flash-Klasse von Modellen suchst, ist Motif-3 weiterhin sehr interessant. Es ist auf der H200 schnell, die Codequalität ist gut, und mit besserem Tuning ist vermutlich noch mehr Performance drin.
Das Hauptproblem lag bei mir beim Pi-Coding-Agenten: Die Generierung stoppte manchmal oder wurde unterbrochen. Ich habe einige Output-Limits erhöht, das half – löste es aber nicht vollständig. Es ist auch mein erster Einsatz der DS4-Laufzeit, daher gibt es wahrscheinlich noch Optimierungspotenzial.
Wenn du speziell ein in Korea entwickeltes Modell suchst oder eine Alternative zu in China entwickelten Modellen möchtest, gehört dieses derzeit zu den spannendsten Optionen. Und es ist großartig zu sehen, dass mehr Länder eigene KI-Modelle und Ökosysteme aufbauen, statt nur von wenigen großen Anbietern abhängig zu sein.
Lerne KI mit DataCamp!
Lernpfad
Lernpfad
Kurs