
programa
Associate AI Engineer para desarrolladores
26 h
Motif-3 es un modelo a gran escala Mixture-of-Experts (MoE) de Motif Technologies, con 314.000 millones de parámetros en total que activan solo 13.200 millones por token.
Cuenta con 384 expertos enrutados, una ventana de contexto de 256K y fue entrenado con unos 12,5 billones de tokens que abarcan código, matemáticas, STEM, datos multilingües y otros dominios.
Está especialmente bien adaptado al razonamiento, el desarrollo de código y las cargas de trabajo agentic. En el Artificial Analysis Intelligence Index obtiene una puntuación de 47, que lo sitúa entre Qwen3.8-27B y MiniMax-M3, que probamos en una configuración similar.
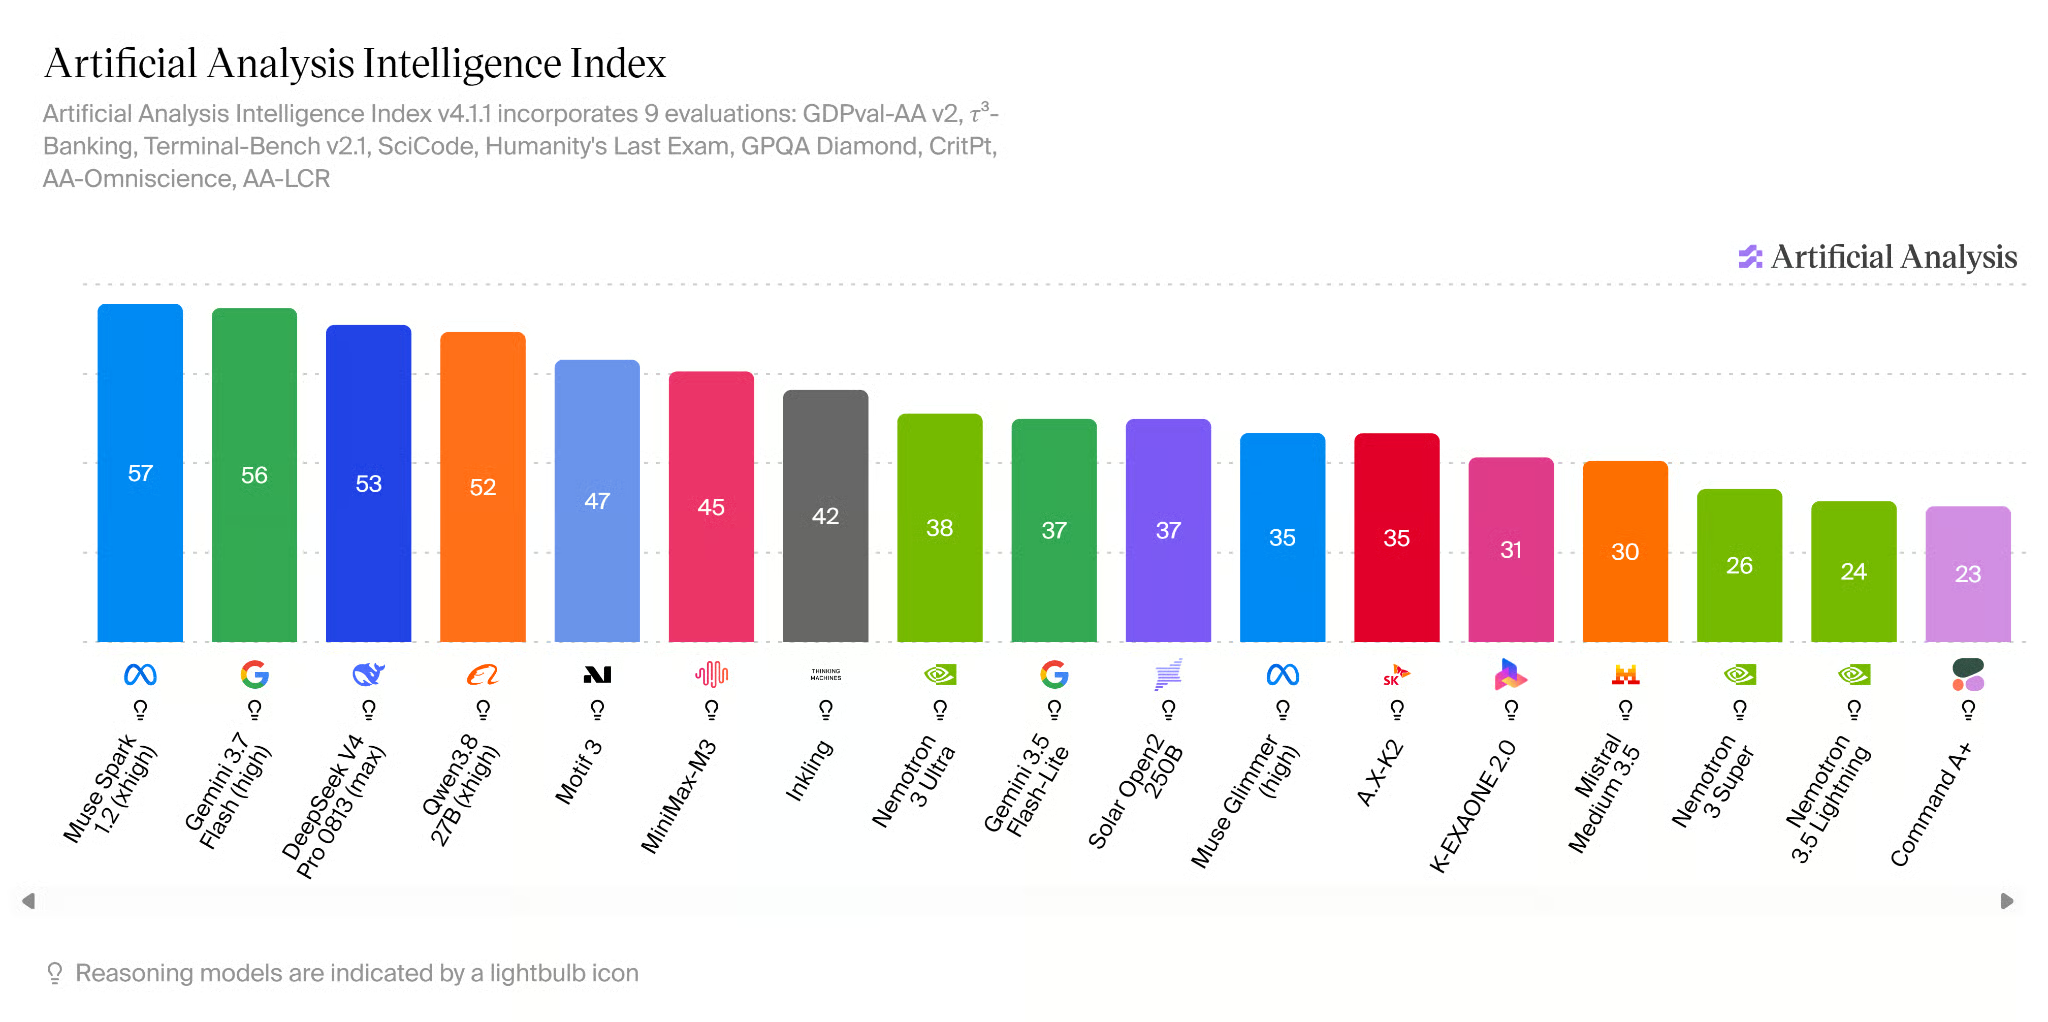
Fuente: AI Model & API Providers Analysis | Artificial Analysis
Para esta guía usamos Baekpica/Motif-3-Mixed-Quant-GGUF, una versión cuantizada de Motif-3 creada de forma independiente. En lugar de usar un único nivel de precisión en todo el modelo, aplica cuantización mixta, con mayor precisión en componentes críticos y mucha menor precisión en las enormes capas de expertos.
Por ejemplo, componentes importantes de atención y siempre activos usan Q8_0, mientras que gran parte de los pesos de expertos enrutados usan IQ2_XXS y Q2_K. El modelo mantiene los 384 expertos y las 53 capas, sin recortes ni eliminaciones. Esto reduce el modelo a aproximadamente 94 GB, frente a unos 335 GB para el GGUF Q8_0, haciéndolo lo bastante pequeño para ejecutarse íntegramente en una H200 de 141 GB con VRAM adicional para el runtime y la caché KV.
Para más contexto, te recomiendo leer nuestras guías sobre cuantización para LLMs y el formato GGUF.
Motif-3 Mixed Quant ocupa unos 94 GB, así que necesitas una GPU con VRAM suficiente para cargar el modelo y dejar margen para la inferencia. Te recomiendo alquilar una única NVIDIA H200 con 141 GB de VRAM en un proveedor de nube de GPU como Hyperbolic, RunPod o Vast.ai.
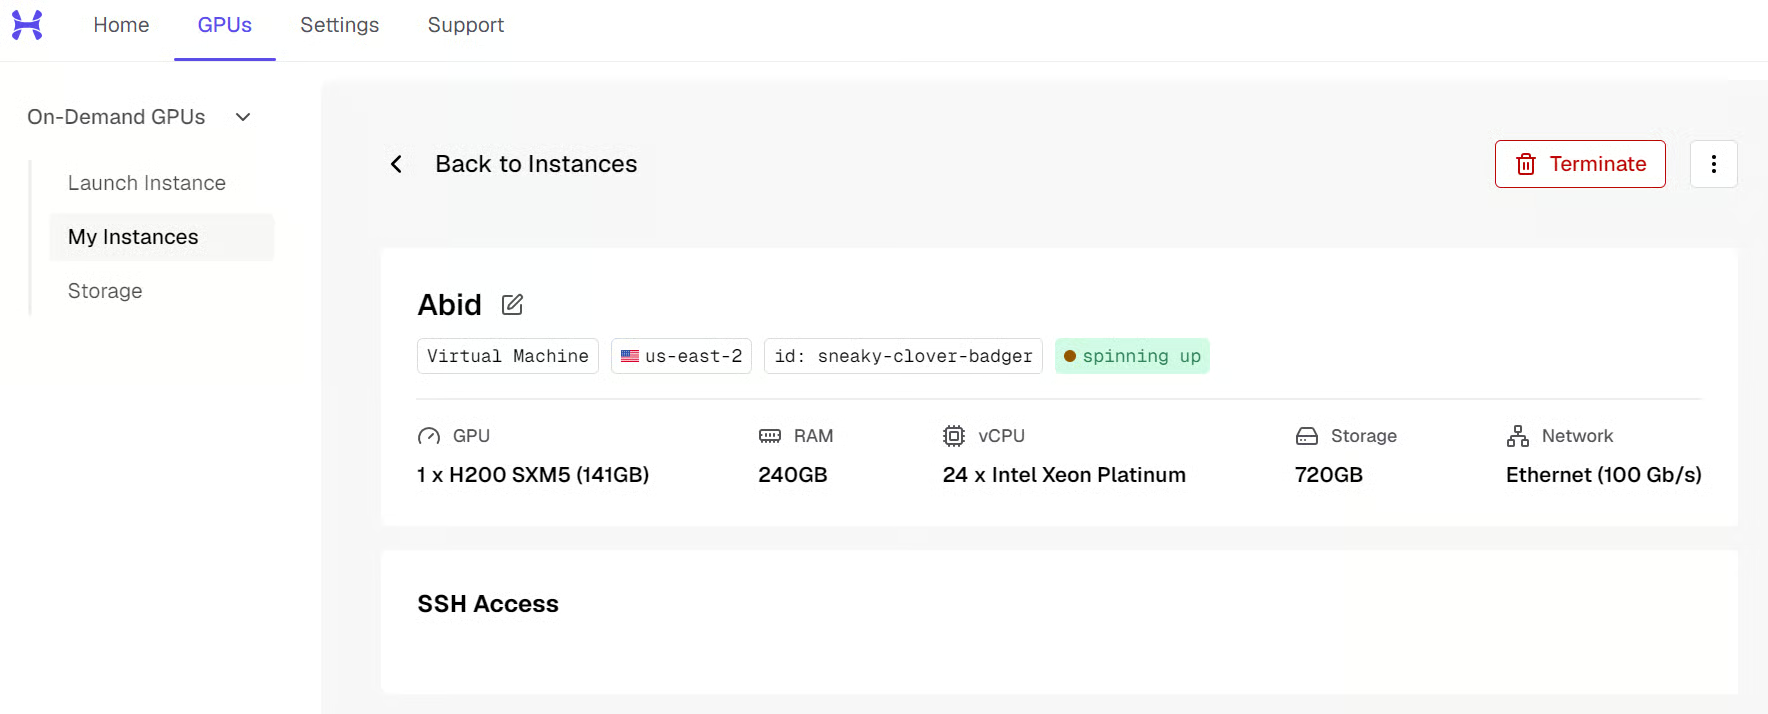
Cuando tu instancia esté en marcha, conéctate desde tu terminal o mediante VS Code Remote SSH. Tu proveedor te facilitará la IP. El comando será similar a:
ssh root@<SERVER_IP> -L 8080:localhost:8080La opción -L 8080:localhost:8080 también reenvía el puerto de la API de Motif-3 a tu PC local, así que después podrás acceder en http://127.0.0.1:8080.
Ahora prepara el servidor:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Por último, comprueba que la H200 está disponible:
nvidia-smi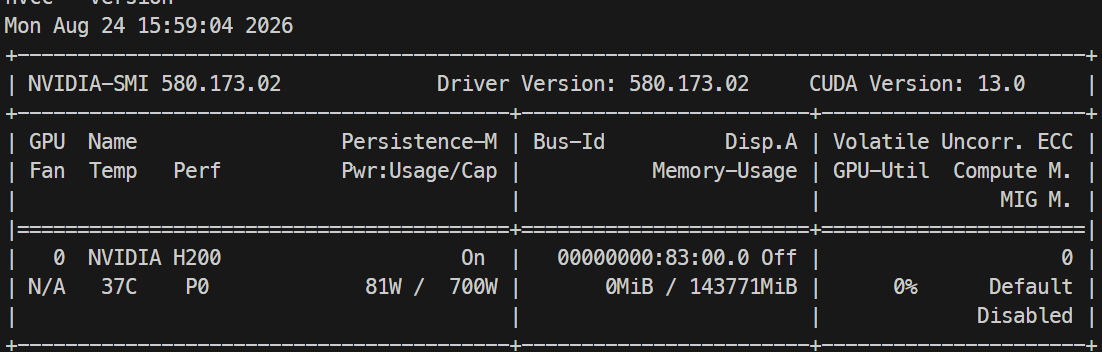
Deberías ver una NVIDIA H200 con aproximadamente 141 GB de VRAM.
A continuación, descarga el modelo Baekpica/Motif-3-Mixed-Quant-GGUF desde Hugging Face. Usamos la variante MQ87-88-FIT, dividida en 11 archivos GGUF con un tamaño conjunto de unos 94 GB.
Desde el directorio /workspace/motif3, ejecuta:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model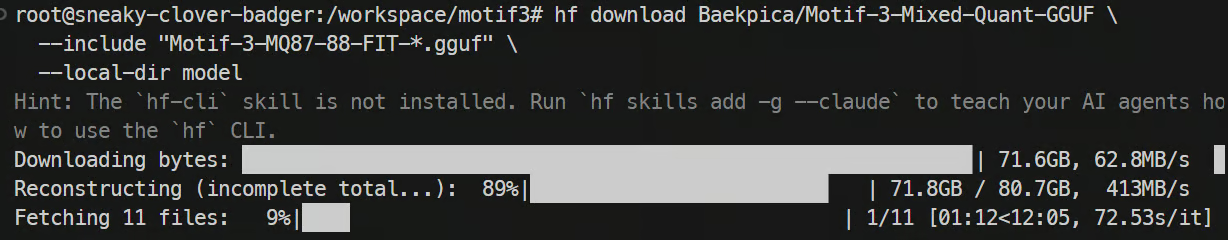
Según tu conexión, descargar los 94 GB puede tardar. Cuando termine, verifica que están todos los fragmentos:
ls -lh modelAntes de unirlos, comprueba los fragmentos. La unión es una operación única sobre 94 GB, así que merece la pena detectar ahora cualquier descarga corrupta:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..El runtime ds4 espera el modelo como un único archivo GGUF, así que primero hay que unir los 11 fragmentos descargados.
Clona llama.cpp y compila su utilidad GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Ahora une los 11 fragmentos en un solo archivo:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Comprueba el modelo unido:
ls -lh motif3.ggufDeberías ver un archivo grande motif3.gguf.
Necesitamos el runtime ds4 para cargar y servir Motif-3 de forma eficiente en la NVIDIA H200.
Clona la rama dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compílalo con soporte CUDA para la H200 (Hopper, sm_90). Ten en cuenta que el objetivo principal de ds4 es DGX Spark/GB10, y el soporte para H200 proviene del trabajo de bring-up del proyecto más que de su ruta principal de serving:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Comprueba que los binarios se han creado correctamente:
ls -lh ds4*Deberías ver binarios como ds4-server y ds4_weight_server.
El servidor de pesos carga y gestiona los weights del modelo en la GPU para que el servidor de la API los use en la inferencia.
Primero, crea directorios para los archivos del runtime y la caché KV:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Ejecuta primero el preflight para comprobar que el modelo cabe antes de comprometerte con la carga completa:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Si todo va bien, ejecuta el mismo comando sin --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned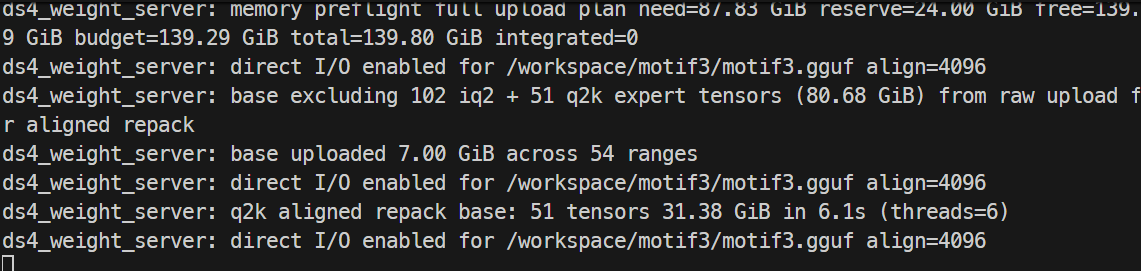
Mantén este terminal en ejecución. El servidor de pesos debe permanecer activo mientras ejecutes Motif-3.
Ahora iniciaremos el servidor de API de ds4, que expone Motif-3 mediante un endpoint compatible con OpenAI al que puedes acceder desde tu ordenador.
Abre otro terminal y conéctate al servidor; luego entra en el directorio ds4:
cd /workspace/motif3/ds4Configura las variables de entorno necesarias:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Inicia el servidor de API con una ventana de contexto de 125K. En H200, el runtime está validado hasta 128K; 256K solo alcanza prefill parcial, así que 125K se mantiene dentro de lo probado:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768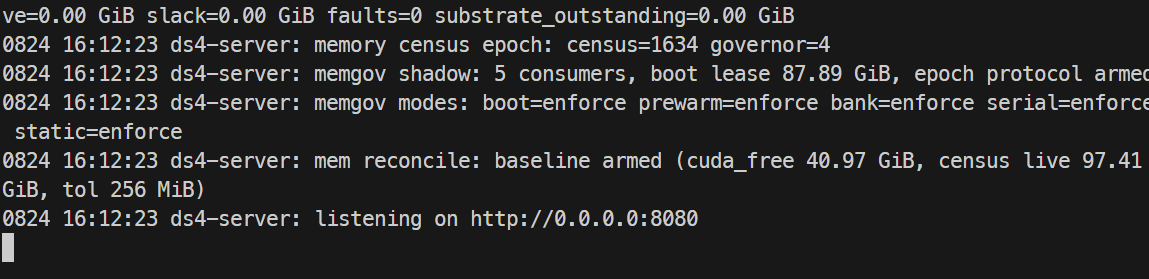
Deja este terminal ejecutándose.
Como reenviamos el puerto 8080 por SSH antes, ahora puedes abrir un terminal en tu PC y comprobar la API:
curl http://127.0.0.1:8080/v1/models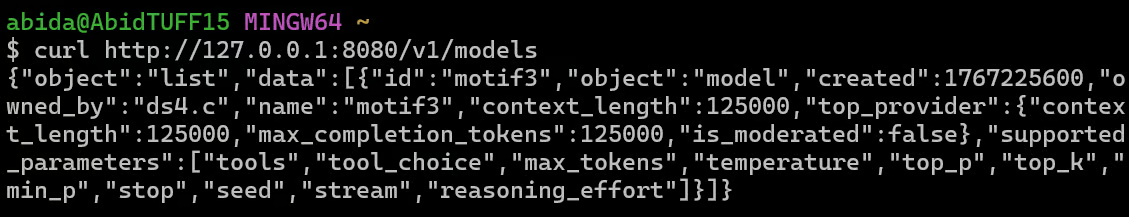
Deberías ver motif-3 como modelo con una longitud de contexto de 125000.
Ahora envía tu primer prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'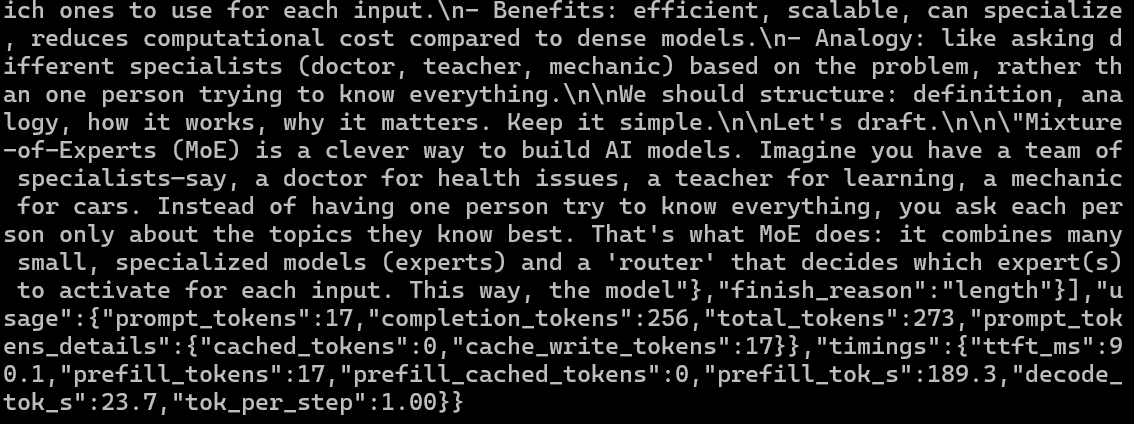
Si todo funciona, Motif-3 generará una respuesta directamente desde tu H200. En mi prueba, el modelo obtuvo estas métricas:
También puedes comprobar el uso de memoria de la GPU en el servidor:
nvidia-smi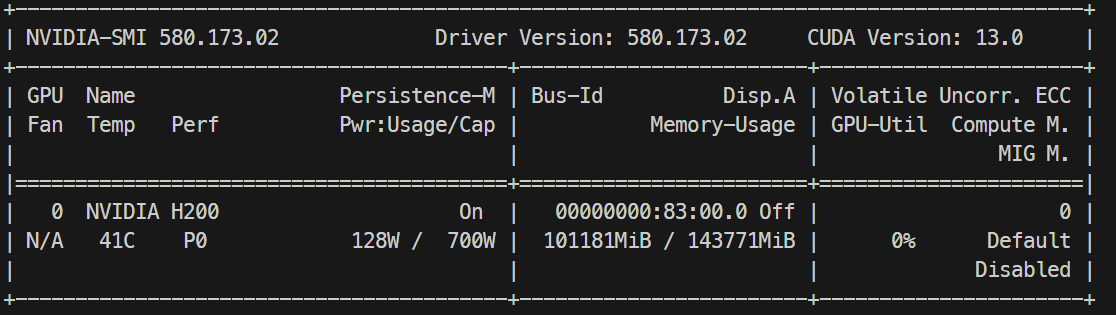
En mi configuración, Motif-3 utilizó aproximadamente 101 GB de los 141 GB de memoria de GPU reportados por la H200, dejando VRAM adicional disponible para la inferencia y la caché KV.
Ahora conectaremos la API local de Motif-3 a Pi, permitiendo que el modelo funcione como agente de código capaz de crear archivos, ejecutar comandos e iterar sobre un proyecto.
Asegúrate de que Motif-3 sigue disponible en:
http://127.0.0.1:8080/v1Instala Pi con el instalador oficial:
curl -fsSL https://pi.dev/install.sh | shReinicia tu terminal y confirma la instalación:
pi --versionPi admite modelos personalizados compatibles con OpenAI mediante ~/.pi/agent/models.json. Crea la configuración:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFAhora podemos darle a Motif-3 una tarea real de programación para ver si puede crear, ejecutar y mejorar una aplicación de forma autónoma.
Crea un proyecto de prueba e inicia Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
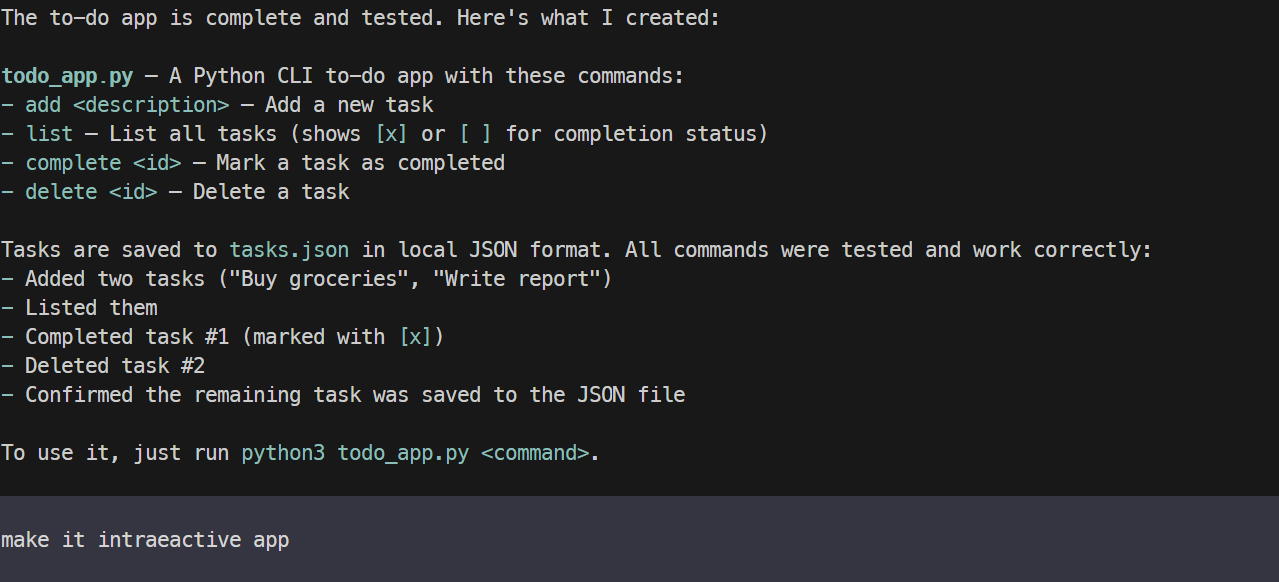
Vamos a probar el modelo. Primero, le pediremos que cree una app de tareas sencilla.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.En pocos minutos, Motif-3 creó una aplicación CLI funcional y la probó con éxito. La funcionalidad era buena, aunque la interfaz inicial era muy básica.
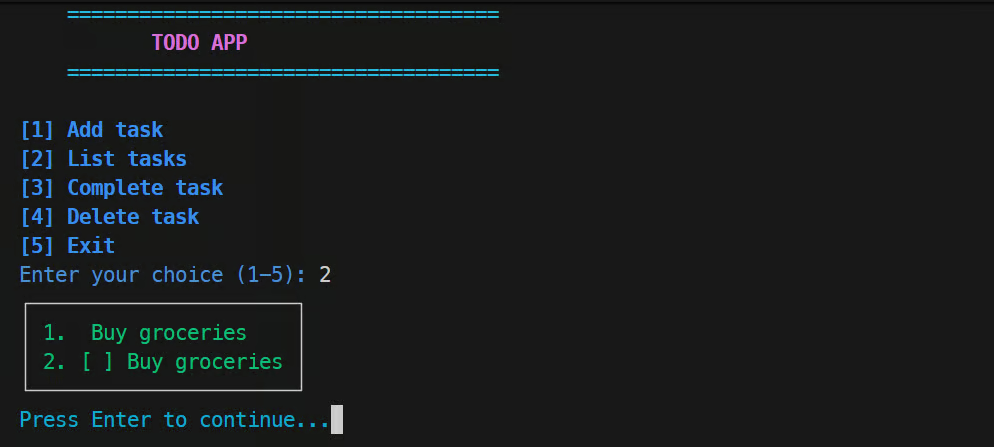
Después le pedí al agente que hiciera la aplicación más interactiva y colorida, mejorara el diseño y la experiencia en terminal. Motif-3 modificó el proyecto existente en lugar de empezar de cero, y la versión mejorada quedó mucho más pulida.
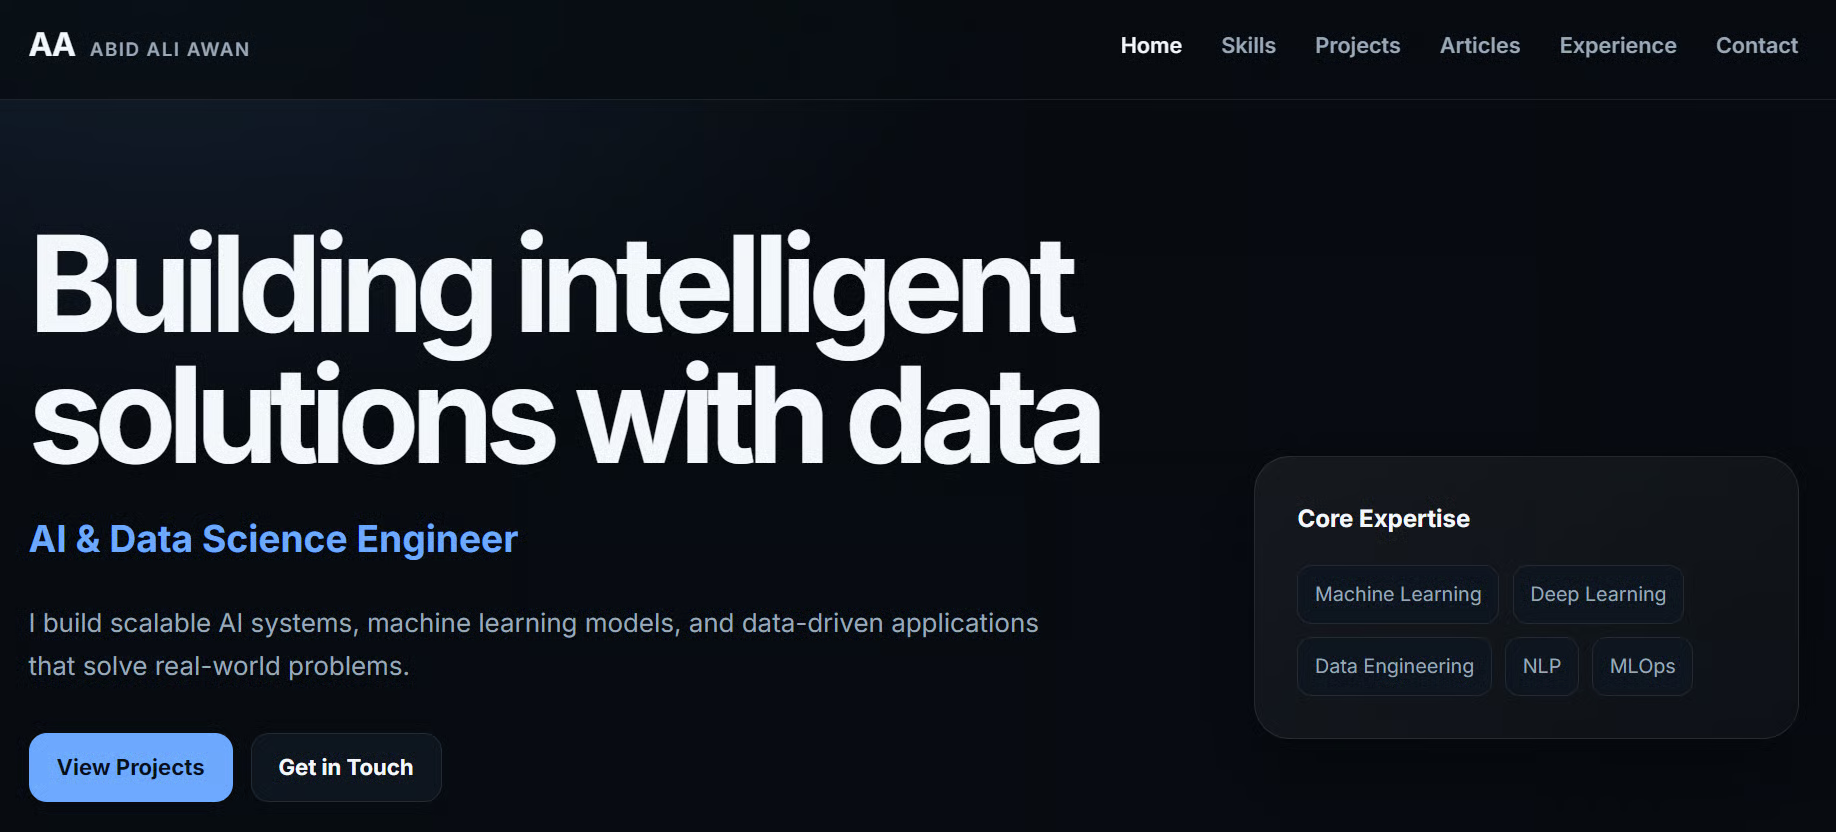
Por último, quise ver cómo rendía Motif-3 en una tarea más visual de desarrollo web, donde generar un sitio funcional es solo parte del reto.
La app inicial funcionaba, pero había varios detalles de la interfaz que no me gustaban. En lugar de darle al modelo un único prompt enorme de rediseño, le pedí que corrigiera los problemas uno a uno, mejorando partes concretas de la interfaz mientras las probaba.
Esto funcionó sorprendentemente bien. Motif-3 fue capaz de inspeccionar el proyecto existente, hacer cambios dirigidos y refinar la UI repetidamente manteniendo la aplicación funcional.
En general, me impresionó tanto su desempeño en programación como su capacidad para iterar sobre un proyecto existente mediante Pi.
En conjunto, mi experiencia fue algo desigual. Motif-3 impresiona, pero para la mayoría hay modelos mejores y menos exigentes en memoria.
Incluso con cuantización mixta, que reduce mucho el tamaño, sigues necesitando alrededor de 100 GB o más de memoria de GPU o combinada para ejecutarlo con comodidad. Por eso, hay muchos modelos más pequeños que son mucho más fáciles de ejecutar, como Qwen3.8-27B y otros orientados a código.
Dicho esto, si buscas algo más cercano a la clase DeepSeek Flash de modelos, Motif-3 sigue siendo muy interesante. Es rápido en una H200, la calidad del código es buena y probablemente puedas sacarle más rendimiento con un mejor tuning.
El principal problema lo tuve con el agente de código Pi, donde a veces la generación se detenía o se interrumpía. Aumenté algunos límites de salida y ayudó, pero no lo solucionó del todo. También es mi primera vez usando el runtime DS4, así que seguramente podré optimizar más en el futuro.
Aun así, si buscas específicamente un modelo desarrollado en Corea, o una alternativa a modelos desarrollados en China, este es de las opciones más interesantes ahora mismo. También es una buena noticia ver a más países construyendo sus propios modelos y ecosistemas de IA en lugar de depender solo de unos pocos proveedores grandes.
¡Aprende IA con DataCamp!
programa
programa
Curso