Track
Ассоциированный AI-инженер для разработчиков
26 ч
Motif-3 — это крупномасштабная Mixture-of-Experts (MoE) модель от Motif Technologies, содержащая в сумме 314 млрд параметров и активирующая лишь 13,2 млрд параметров на токен.
Она включает 384 маршрутизируемых эксперта, имеет контекстное окно 256K и обучалась примерно на 12,5 трлн токенов, охватывающих код, математику, STEM, многоязычные данные и другие домены.
Модель особенно хорошо подходит для задач рассуждения, программирования и агентных рабочих нагрузок. В Индексе Artificial Analysis Intelligence она набирает 47 баллов, что ставит её между Qwen3.8-27B и MiniMax-M3, который мы тестировали в схожей конфигурации.
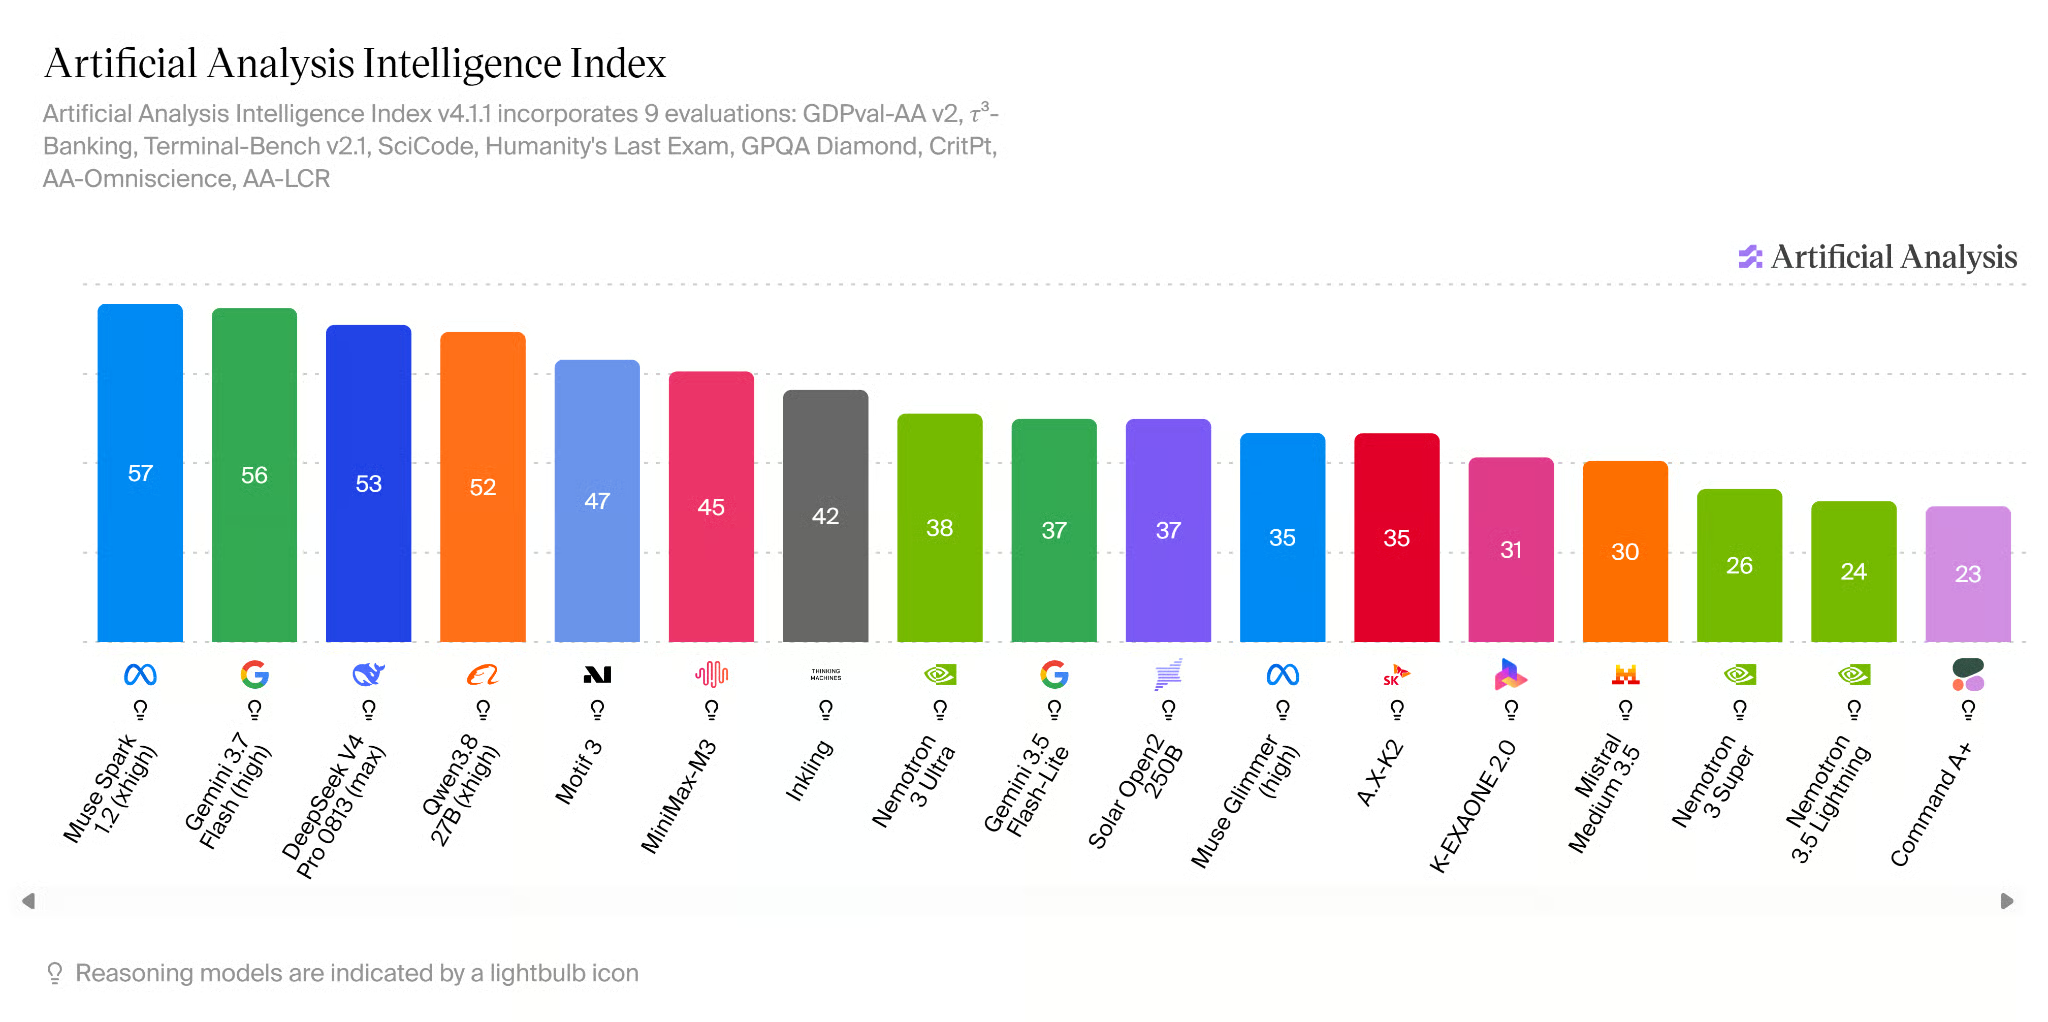
Источник: AI Model & API Providers Analysis | Artificial Analysis
В этом руководстве мы используем Baekpica/Motif-3-Mixed-Quant-GGUF — независимую квантованную версию Motif-3. Вместо единой точности для всей модели применяется смешанная квантизация: более высокая точность для важных компонентов и значительно более низкая — для огромных слоёв экспертов.
Например, важные компоненты внимания и всегда активные части используют Q8_0, тогда как значительная часть весов маршрутизируемых экспертов — IQ2_XXS и Q2_K. Модель по‑прежнему содержит всех 384 эксперта и все 53 слоя — ничего не обрезано и не удалено. Это уменьшает размер модели до примерно 94 ГБ по сравнению с ~335 ГБ для Q8_0 GGUF, делая её достаточно компактной для полного запуска на H200 с 141 ГБ и с дополнительной видеопамятью для рантайма и KV‑кэша.
Для дополнительного бэкграунда рекомендуем прочитать наши руководства по квантизации LLM и по формату GGUF.
Motif-3 Mixed Quant занимает около 94 ГБ, поэтому вам понадобится GPU с достаточной видеопамятью, чтобы загрузить модель и оставить место для инференса. Рекомендуется арендовать один NVIDIA H200 с 141 ГБ VRAM у облачного провайдера GPU, например Hyperbolic, RunPod или Vast.ai.
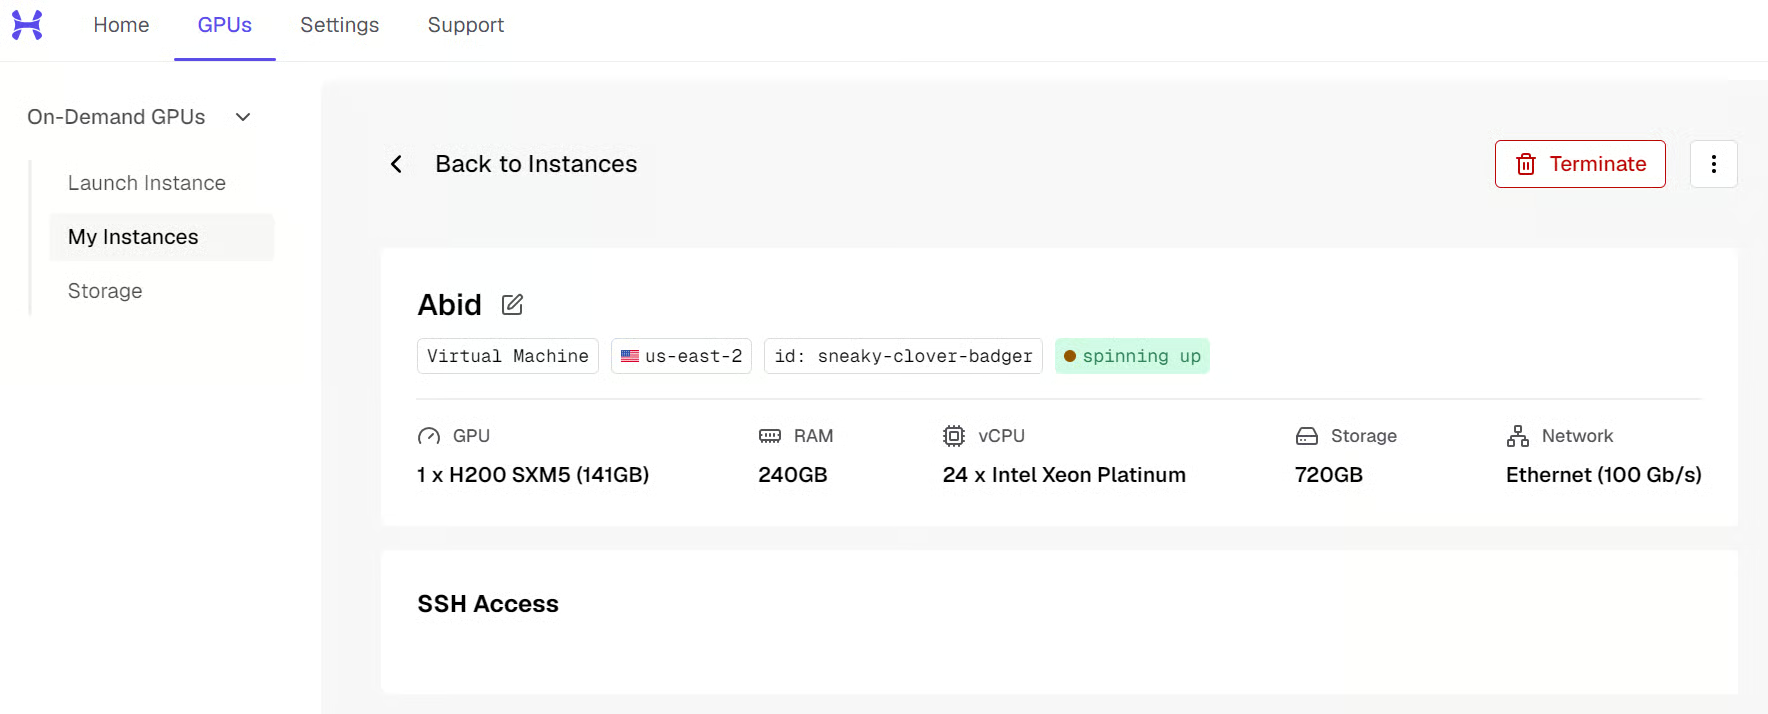
Когда инстанс будет запущен, подключитесь к нему из терминала или через VS Code Remote SSH. Провайдер предоставит IP‑адрес. Команда будет выглядеть примерно так:
ssh root@<SERVER_IP> -L 8080:localhost:8080Опция -L 8080:localhost:8080 также пробрасывает порт API Motif-3 на ваш локальный ПК, так что позже вы сможете обращаться к нему по адресу http://127.0.0.1:8080.
Теперь подготовьте сервер:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Наконец, проверьте доступность H200:
nvidia-smi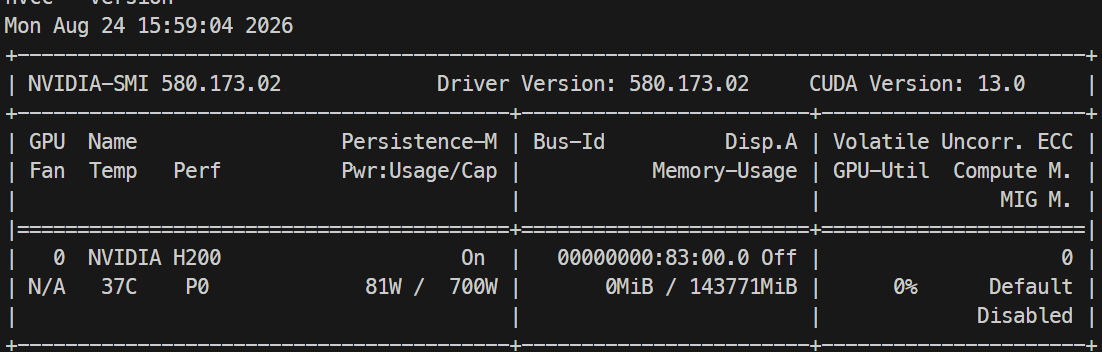
Вы должны увидеть NVIDIA H200 с примерно 141 ГБ видеопамяти.
Далее скачайте модель Baekpica/Motif-3-Mixed-Quant-GGUF с Hugging Face. Мы используем вариант MQ87-88-FIT, который разделён на 11 файлов GGUF суммарным размером около 94 ГБ.
Из каталога /workspace/motif3 выполните:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model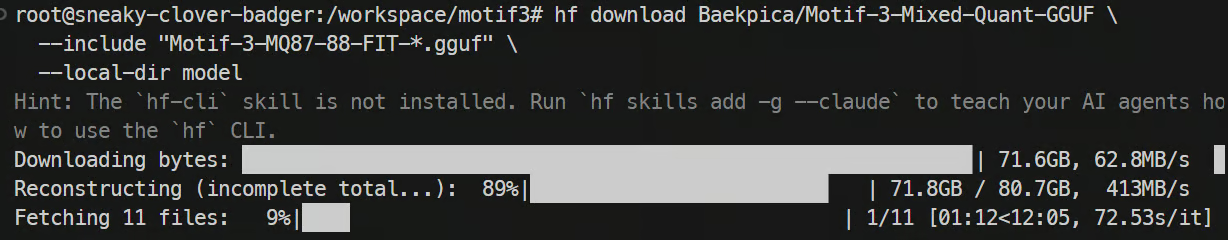
В зависимости от скорости соединения загрузка всех 94 ГБ может занять время. Когда всё будет готово, проверьте наличие всех шардов:
ls -lh modelПеред объединением проверьте шардированные файлы. Слияние — одноразовая операция на 94 ГБ, поэтому лучше вовремя обнаружить сбой загрузки:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Рантайм ds4 ожидает модель в виде единого файла GGUF, поэтому сначала нужно объединить 11 загруженных шардов.
Клонируйте llama.cpp и соберите утилиту GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Теперь объедините все 11 шардов в один файл:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Проверьте объединённую модель:
ls -lh motif3.ggufВы должны увидеть крупный файл motif3.gguf.
Нам нужен рантайм ds4, чтобы эффективно загружать и обслуживать Motif-3 на NVIDIA H200.
Клонируйте ветку dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Соберите с поддержкой CUDA для H200 (Hopper, sm_90). Учтите, что основная цель ds4 — DGX Spark/GB10, а поддержка H200 обеспечена в рамках начальных работ по проекту, а не основного пути сервинга:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Убедитесь, что бинарные файлы успешно созданы:
ls -lh ds4*Вы должны увидеть бинарники вроде ds4-server и ds4_weight_server.
Сервер весов загружает и управляет весами модели на GPU, чтобы сервер API мог использовать их для инференса.
Сначала создайте каталоги для файлов рантайма и KV‑кэша:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Сначала выполните предварительную проверку, чтобы убедиться, что модель поместится, прежде чем запускать полную загрузку:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Если проверка прошла, запустите ту же команду без --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned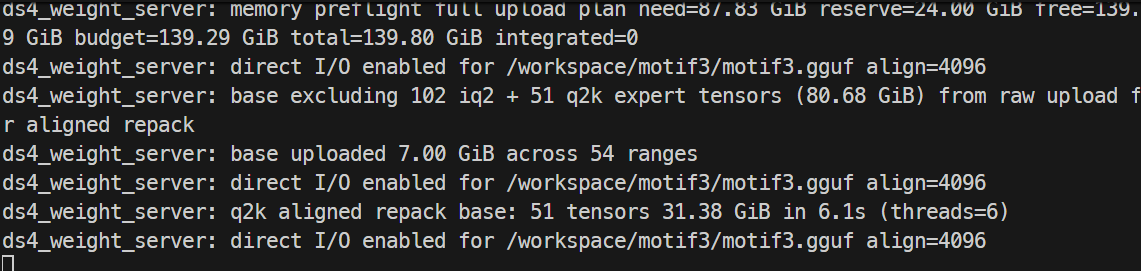
Оставьте этот терминал открытым. Сервер весов должен оставаться активным, пока вы запускаете Motif-3.
Теперь запустим сервер API ds4, который предоставляет Motif-3 через совместимую с OpenAI конечную точку, доступную с вашего локального компьютера.
Откройте второй терминал, подключитесь к серверу и перейдите в каталог ds4:
cd /workspace/motif3/ds4Задайте необходимые переменные окружения:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Запустите сервер API с контекстным окном 125K. На H200 рантайм валидирован до 128K, а 256K достигает лишь частичного префилла, поэтому 125K укладывается в протестированные рамки:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768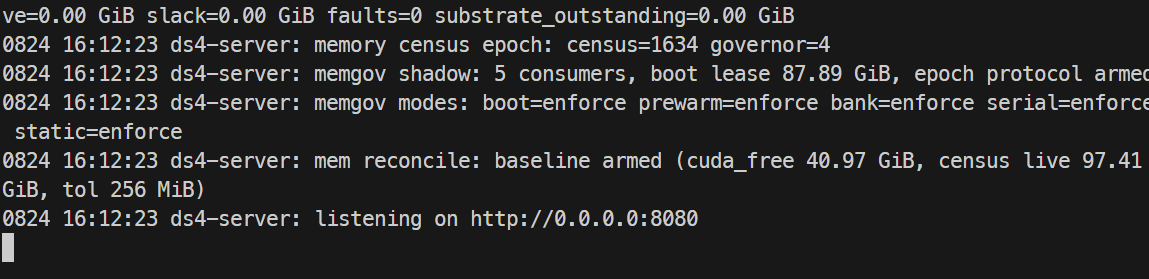
Оставьте этот терминал открытым.
Поскольку ранее мы пробросили порт 8080 по SSH, теперь вы можете открыть терминал на своём локальном ПК и проверить API:
curl http://127.0.0.1:8080/v1/models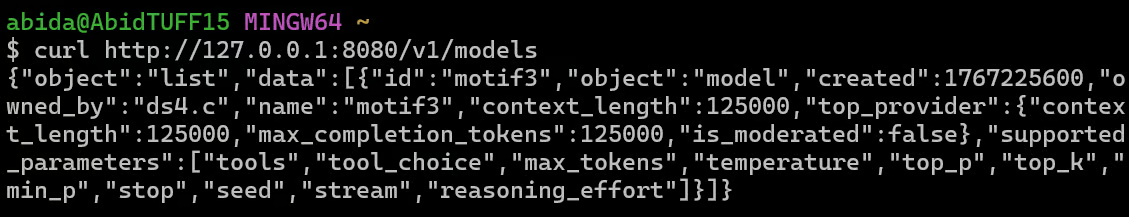
Вы должны увидеть, что модель motif-3 доступна с длиной контекста 125000.
Теперь отправьте первый запрос:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'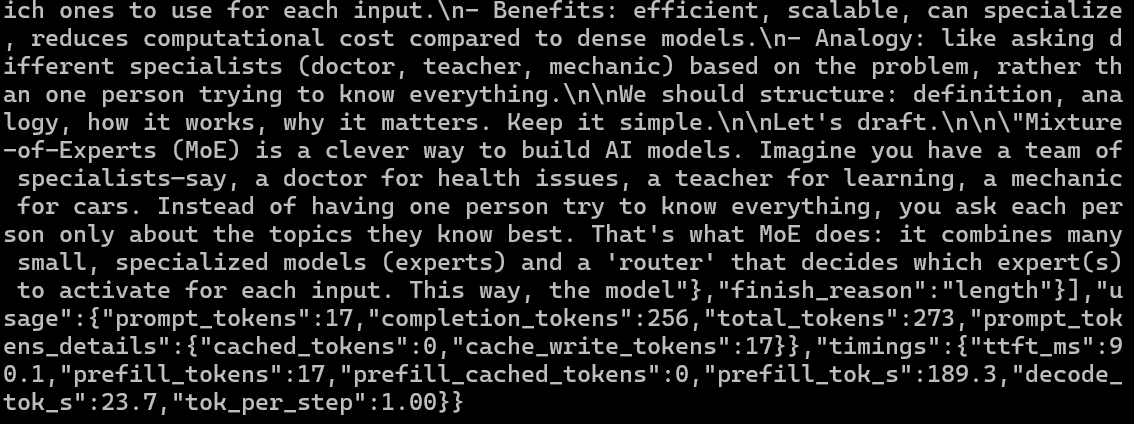
Если всё работает, Motif-3 сгенерирует ответ напрямую с вашего H200. В моём тесте модель показала такие метрики:
Вы также можете проверить использование памяти GPU на сервере:
nvidia-smi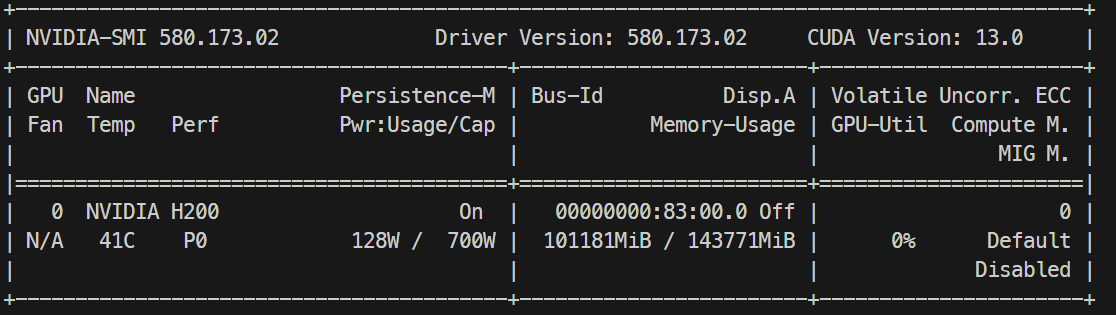
В моей конфигурации Motif-3 использовала примерно 101 ГБ из 141 ГБ доступной памяти GPU H200, оставляя дополнительную VRAM для инференса и KV‑кэша.
Теперь подключим локальный API Motif-3 к Pi, чтобы модель могла работать как кодовый агент, создающий файлы, выполняющий команды и итеративно дорабатывающий проект.
Убедитесь, что Motif-3 по‑прежнему доступна по адресу:
http://127.0.0.1:8080/v1Установите Pi с помощью официального инсталлятора:
curl -fsSL https://pi.dev/install.sh | shПерезапустите терминал, затем подтвердите установку:
pi --versionPi поддерживает пользовательские модели, совместимые с OpenAI, через ~/.pi/agent/models.json. Создайте конфигурацию:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFТеперь можно дать Motif-3 реальную задачу по программированию и посмотреть, сможет ли она самостоятельно собрать, запустить и улучшить приложение.
Создайте тестовый проект и запустите Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
Протестируем модель. Сначала попросим её собрать простое приложение со списком дел.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Через несколько минут Motif-3 создала рабочее CLI‑приложение и успешно его протестировала. Функциональность была хорошей, но начальный интерфейс — очень базовым.
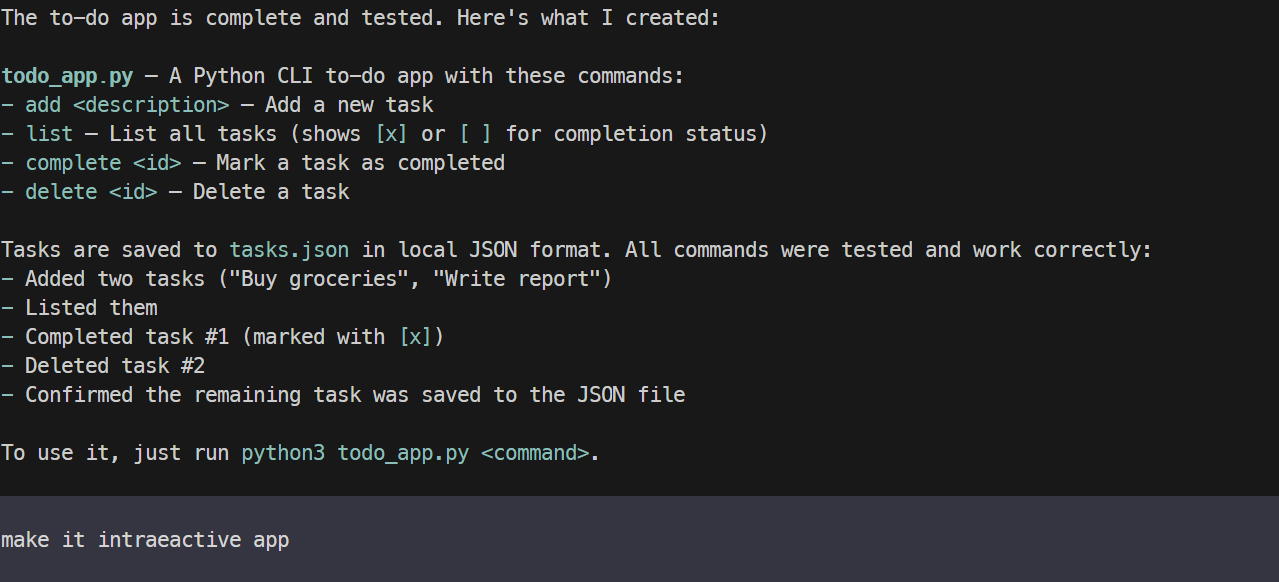
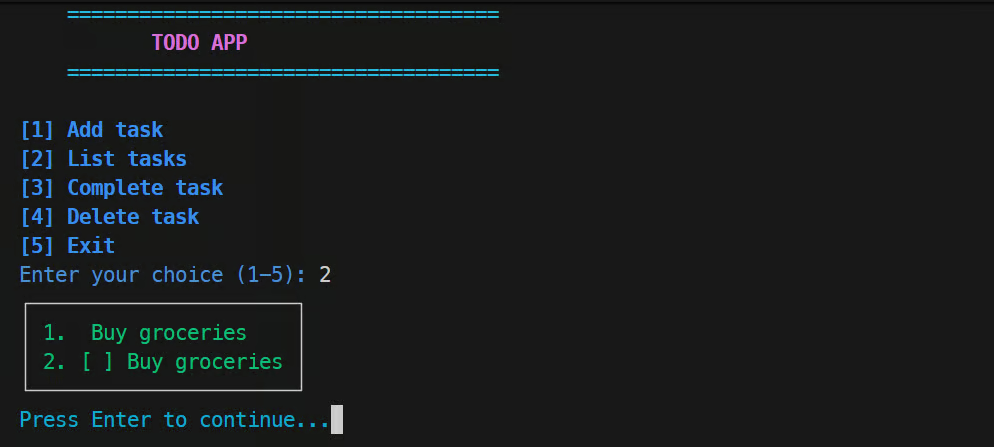
Затем я попросил(а) агента сделать приложение более интерактивным и цветным, улучшить компоновку и опыт работы в терминале. Motif-3 изменила существующий проект, а не начала заново, и улучшенная версия получилась заметно более отполированной.
Напоследок хотелось увидеть, как Motif-3 справится с более визуальной задачей веб‑разработки, где работающий сайт — лишь часть вызова.
Базовое приложение работало, но было несколько UI‑моментов, которые мне не понравились. Вместо того чтобы давать модели один огромный запрос на редизайн, я просил(а) исправлять проблемы по одной, улучшая отдельные части интерфейса по мере тестирования.
Это сработало удивительно хорошо. Motif-3 смогла изучить существующий проект, внести точечные изменения и многократно отшлифовать интерфейс, сохраняя при этом работоспособность приложения.
В целом впечатлила и производительность в кодинге, и способность итеративно дорабатывать существующий проект через Pi.
В целом впечатления смешанные. Motif-3 впечатляет, но для большинства пользователей есть модели лучше и менее требовательные к памяти.
Даже со смешанной квантизацией, которая сильно уменьшает размер, вам всё равно нужно около 100 ГБ и более видеопамяти или совокупной памяти, чтобы комфортно её запускать. Из‑за этого есть много меньших моделей, которые гораздо проще запустить, например Qwen3.8-27B и другие модели, ориентированные на код.
Тем не менее, если вам нужно что-то ближе к классу DeepSeek Flash моделей, Motif-3 остаётся очень интересным вариантом. На H200 она быстрая, качество кода хорошее, и, вероятно, можно выжать ещё больше производительности с лучшей настройкой.
Основная проблема была с кодовым агентом Pi: генерация иногда останавливалась или прерывалась. Я увеличил(а) некоторые лимиты вывода — это помогло, но проблему полностью не устранило. Это также мой первый опыт с рантаймом DS4, так что, вероятно, впереди ещё есть пространство для оптимизации.
И всё же, если вы специально ищете модель, разработанную в Корее, или хотите альтернативу моделям из Китая, это один из наиболее интересных вариантов прямо сейчас. Здорово видеть, как всё больше стран создают собственные модели ИИ и экосистемы вместо зависимости от нескольких крупных провайдеров.
Изучайте ИИ с DataCamp!
Track
Track
Course