
Tracks
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Motif-3 là một mô hình quy mô lớn Mixture-of-Experts (MoE) từ Motif Technologies, có tổng cộng 314 tỷ tham số nhưng chỉ kích hoạt 13,2 tỷ tham số trên mỗi token.
Mô hình có 384 expert định tuyến, cửa sổ ngữ cảnh 256K context window, và được huấn luyện trên khoảng 12,5 nghìn tỷ token bao phủ code, toán học, STEM, dữ liệu đa ngôn ngữ và các lĩnh vực khác.
Mô hình đặc biệt phù hợp với các tác vụ lập luận, viết mã, và công việc hướng tác nhân. Trên Artificial Analysis Intelligence Index, mô hình đạt điểm 47, nằm giữa Qwen3.8-27B và MiniMax-M3, mà chúng tôi đã thử nghiệm trong cấu hình tương tự.
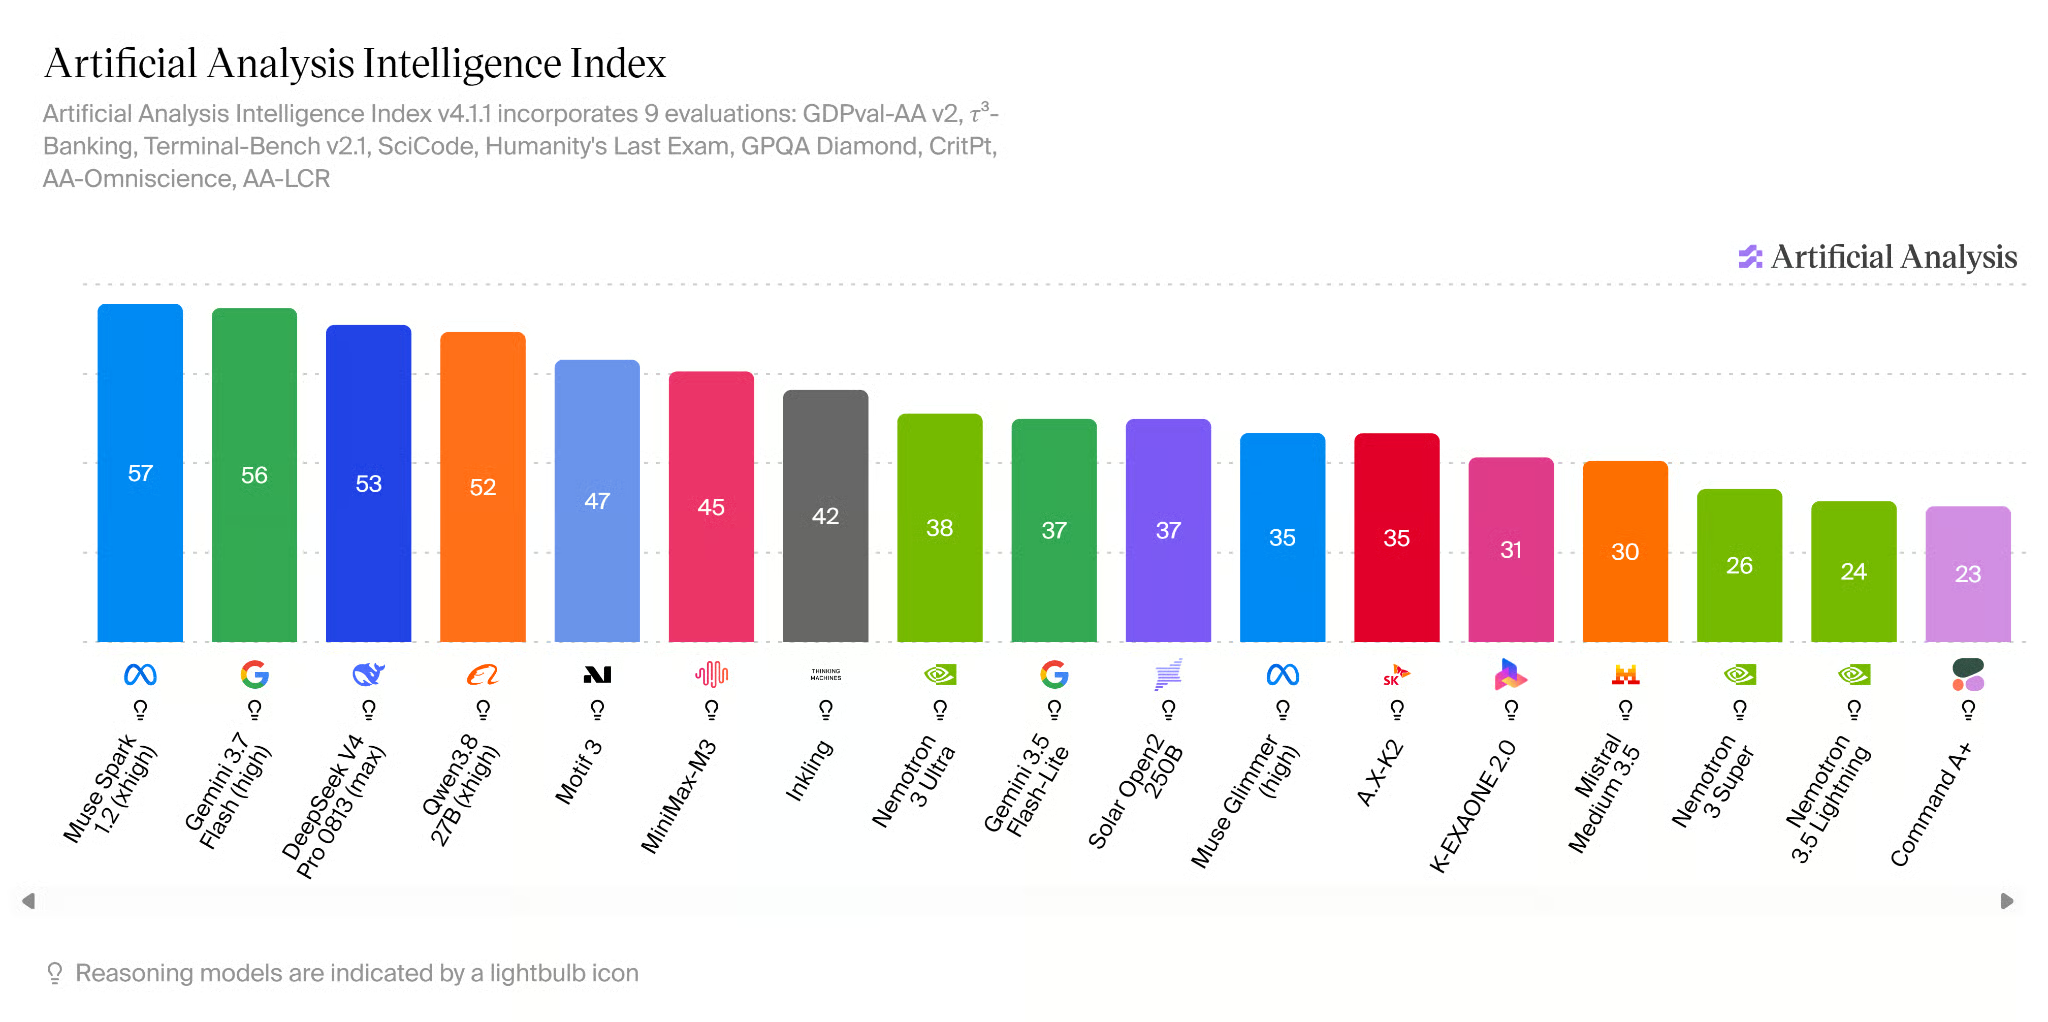
Nguồn: AI Model & API Providers Analysis | Artificial Analysis
Trong hướng dẫn này, chúng ta sử dụng Baekpica/Motif-3-Mixed-Quant-GGUF, một phiên bản lượng tử hoá của Motif-3 do cộng đồng tạo ra. Thay vì dùng một mức độ chính xác cho toàn bộ mô hình, nó dùng lượng tử hoá hỗn hợp, áp dụng độ chính xác cao hơn cho các thành phần quan trọng và độ chính xác thấp hơn nhiều cho các lớp expert khổng lồ.
Ví dụ, các thành phần attention quan trọng và luôn hoạt động dùng Q8_0, trong khi phần lớn trọng số expert định tuyến dùng IQ2_XXS và Q2_K. Mô hình vẫn giữ đủ 384 expert và 53 lớp, không cắt tỉa hay loại bỏ gì. Điều này giảm kích thước mô hình xuống khoảng 94GB, so với khoảng 335GB cho GGUF Q8_0, đủ nhỏ để chạy hoàn toàn trên H200 141GB và vẫn còn VRAM cho runtime và bộ nhớ đệm KV.
Để tìm hiểu thêm, tôi khuyến nghị đọc các hướng dẫn của chúng tôi về lượng tử hoá cho LLM và định dạng GGUF.
Motif-3 Mixed Quant khoảng 94GB, vì vậy bạn sẽ cần GPU có đủ VRAM để nạp mô hình và chừa chỗ cho suy luận. Tôi khuyên thuê một NVIDIA H200 đơn với 141GB VRAM từ nhà cung cấp đám mây GPU như Hyperbolic, RunPod hoặc Vast.ai.
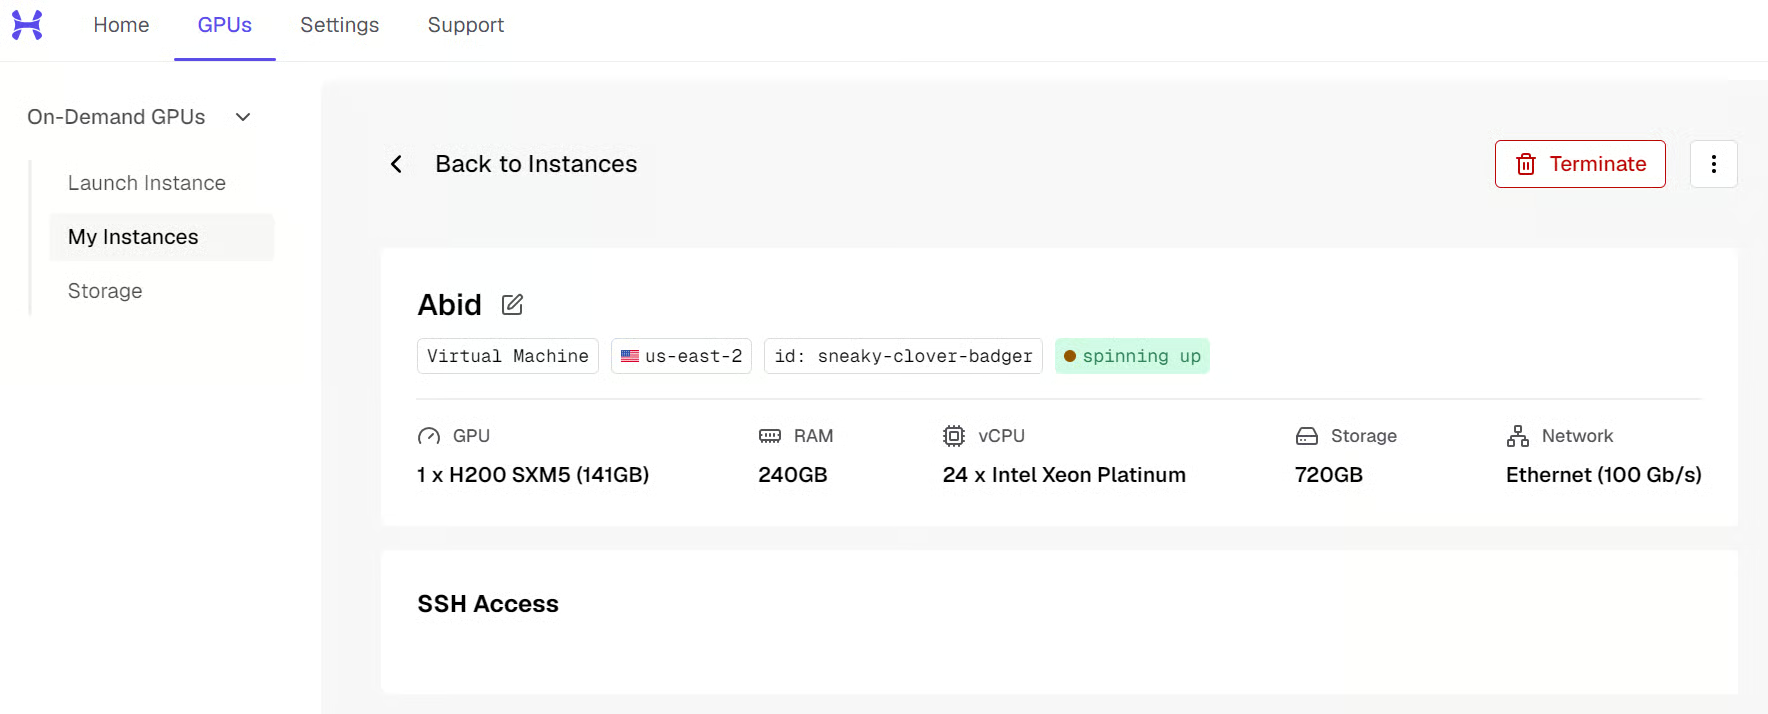
Khi phiên bản của bạn chạy, hãy kết nối tới nó từ terminal hoặc qua VS Code Remote SSH. Nhà cung cấp sẽ cho bạn địa chỉ IP. Lệnh sẽ tương tự như:
ssh root@<SERVER_IP> -L 8080:localhost:8080Tuỳ chọn -L 8080:localhost:8080 cũng chuyển tiếp cổng API Motif-3 tới PC cục bộ của bạn, để sau này bạn có thể truy cập tại http://127.0.0.1:8080.
Bây giờ hãy chuẩn bị máy chủ:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Cuối cùng, kiểm tra H200 có sẵn không:
nvidia-smi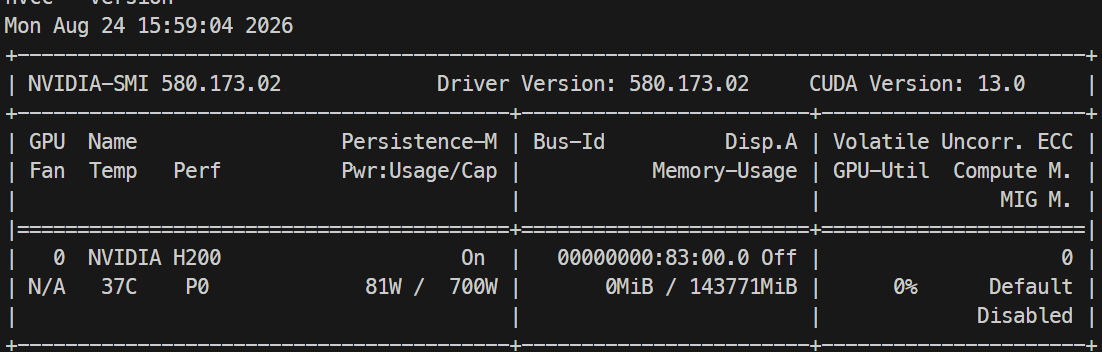
Bạn sẽ thấy NVIDIA H200 với khoảng 141GB VRAM.
Tiếp theo, tải mô hình Baekpica/Motif-3-Mixed-Quant-GGUF từ Hugging Face. Chúng ta dùng biến thể MQ87-88-FIT, được chia thành 11 tệp GGUF với tổng dung lượng khoảng 94GB.
Từ thư mục /workspace/motif3, chạy:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model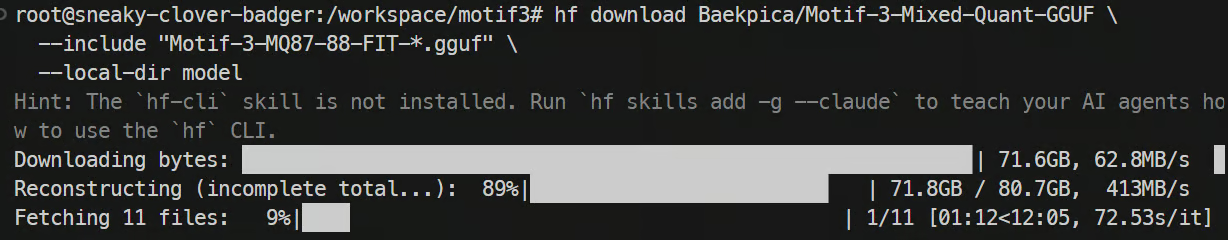
Tuỳ vào kết nối, việc tải toàn bộ 94GB có thể mất thời gian. Sau khi xong, kiểm tra tất cả các mảnh đã có:
ls -lh modelTrước khi gộp, hãy xác minh các mảnh. Việc gộp là thao tác một lần trên 94GB, nên đáng để phát hiện tải lỗi ngay bây giờ:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Runtime ds4 yêu cầu mô hình ở dạng một tệp GGUF duy nhất, nên trước tiên chúng ta cần gộp 11 mảnh đã tải.
Clone llama.cpp và build tiện ích GGUF của nó:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Bây giờ gộp cả 11 mảnh vào một tệp:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Kiểm tra mô hình đã gộp:
ls -lh motif3.ggufBạn sẽ thấy một tệp motif3.gguf lớn.
Chúng ta cần runtime ds4 để nạp và phục vụ Motif-3 hiệu quả trên NVIDIA H200.
Clone nhánh dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Biên dịch với hỗ trợ CUDA cho H200 (Hopper, sm_90). Lưu ý mục tiêu chính của ds4 là DGX Spark/GB10, còn hỗ trợ H200 đến từ quá trình bring-up của dự án chứ không phải đường phục vụ chính:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Kiểm tra các tệp nhị phân đã được tạo thành công:
ls -lh ds4*Bạn sẽ thấy các tệp nhị phân như ds4-server và ds4_weight_server.
Weight server nạp và quản lý trọng số mô hình trên GPU để máy chủ API dùng cho suy luận.
Trước tiên, tạo thư mục cho tệp runtime và bộ nhớ đệm KV:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Chạy preflight trước để kiểm tra mô hình sẽ vừa trước khi nạp đầy đủ:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Nếu qua bước đó, chạy lại cùng lệnh nhưng bỏ --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned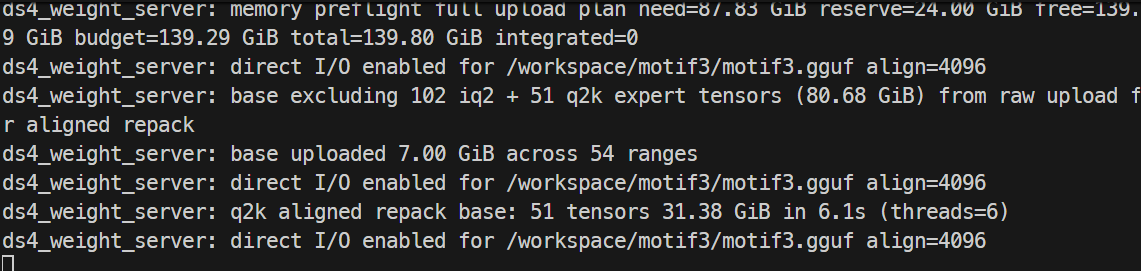
Giữ terminal này chạy. Weight server cần hoạt động liên tục khi bạn chạy Motif-3.
Giờ chúng ta sẽ khởi động máy chủ API ds4, cung cấp Motif-3 qua một endpoint tương thích OpenAI mà bạn có thể truy cập từ máy tính cục bộ.
Mở một terminal khác và kết nối tới máy chủ, sau đó chuyển vào thư mục ds4:
cd /workspace/motif3/ds4Thiết lập các biến môi trường bắt buộc:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Khởi động máy chủ API với cửa sổ ngữ cảnh 125K. Trên H200, đường runtime được kiểm chứng tới 128K, còn 256K chỉ đạt prefill một phần, nên 125K nằm trong phạm vi đã được thử nghiệm:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768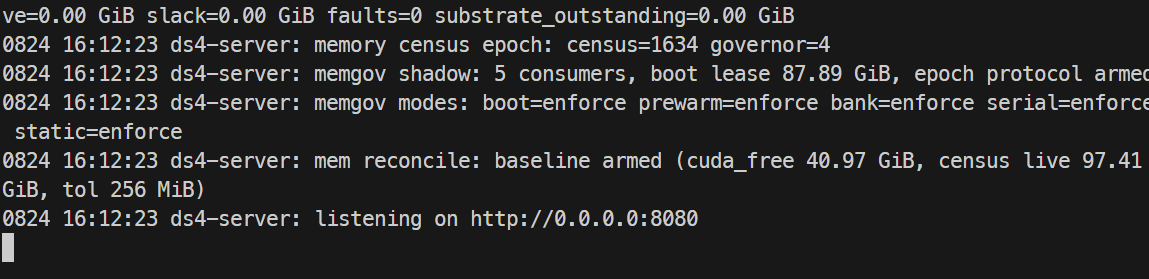
Giữ terminal này chạy.
Vì trước đó chúng ta đã chuyển tiếp cổng 8080 qua SSH, giờ bạn có thể mở terminal trên PC cục bộ và kiểm tra API:
curl http://127.0.0.1:8080/v1/models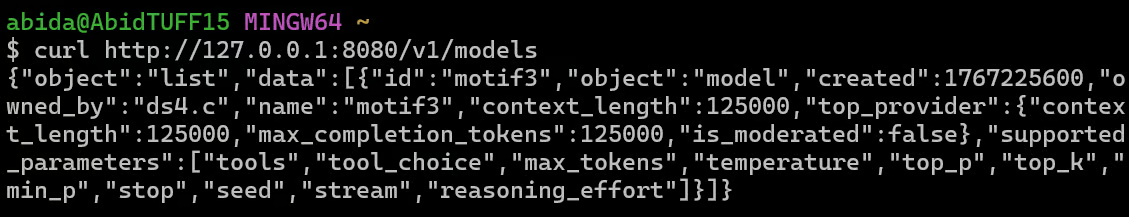
Bạn sẽ thấy motif-3 được liệt kê là mô hình với độ dài ngữ cảnh 125000.
Giờ hãy gửi prompt đầu tiên của bạn:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'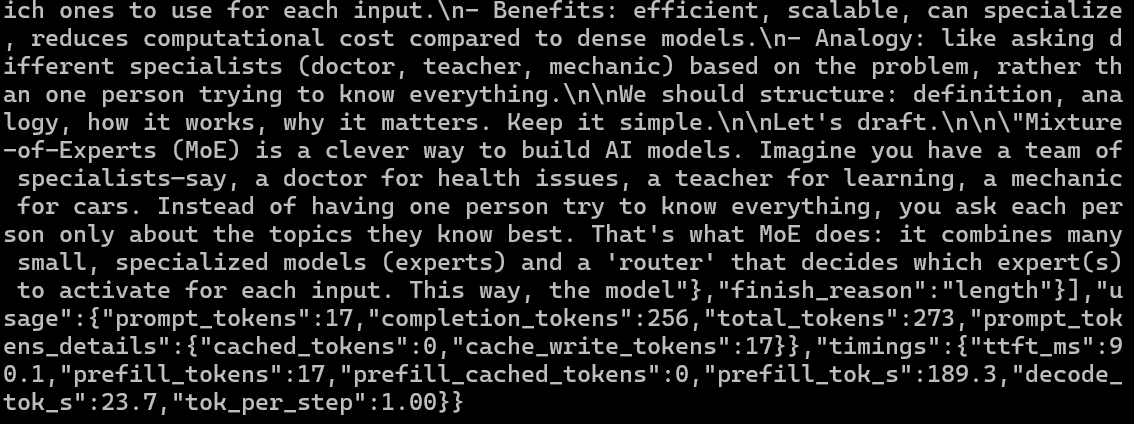
Nếu mọi thứ hoạt động, Motif-3 sẽ sinh phản hồi trực tiếp từ H200 của bạn. Trong thử nghiệm của tôi, mô hình đạt các chỉ số sau:
Bạn cũng có thể kiểm tra mức sử dụng bộ nhớ GPU trên máy chủ:
nvidia-smi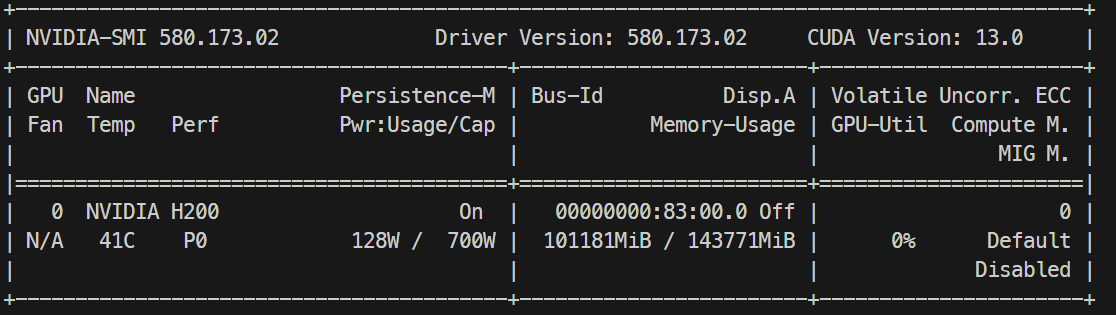
Trong thiết lập của tôi, Motif-3 dùng khoảng 101GB trong tổng 141GB bộ nhớ GPU H200, để lại thêm VRAM cho suy luận và bộ nhớ đệm KV.
Giờ chúng ta sẽ kết nối API Motif-3 cục bộ với Pi, cho phép mô hình hoạt động như một tác nhân mã hoá có thể tạo tệp, chạy lệnh và lặp trên một dự án.
Đảm bảo Motif-3 vẫn sẵn sàng tại:
http://127.0.0.1:8080/v1Cài đặt Pi bằng trình cài đặt chính thức:
curl -fsSL https://pi.dev/install.sh | shKhởi động lại terminal của bạn, sau đó xác nhận cài đặt:
pi --versionPi hỗ trợ các mô hình tuỳ chỉnh tương thích OpenAI qua ~/.pi/agent/models.json. Tạo cấu hình:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFGiờ chúng ta có thể giao cho Motif-3 một tác vụ mã hoá thực tế và xem liệu nó có thể tự động xây dựng, chạy và cải tiến một ứng dụng hay không.
Tạo một dự án thử nghiệm và khởi động Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
Hãy thử mô hình. Trước tiên, chúng ta sẽ yêu cầu nó xây dựng một ứng dụng to-do đơn giản.
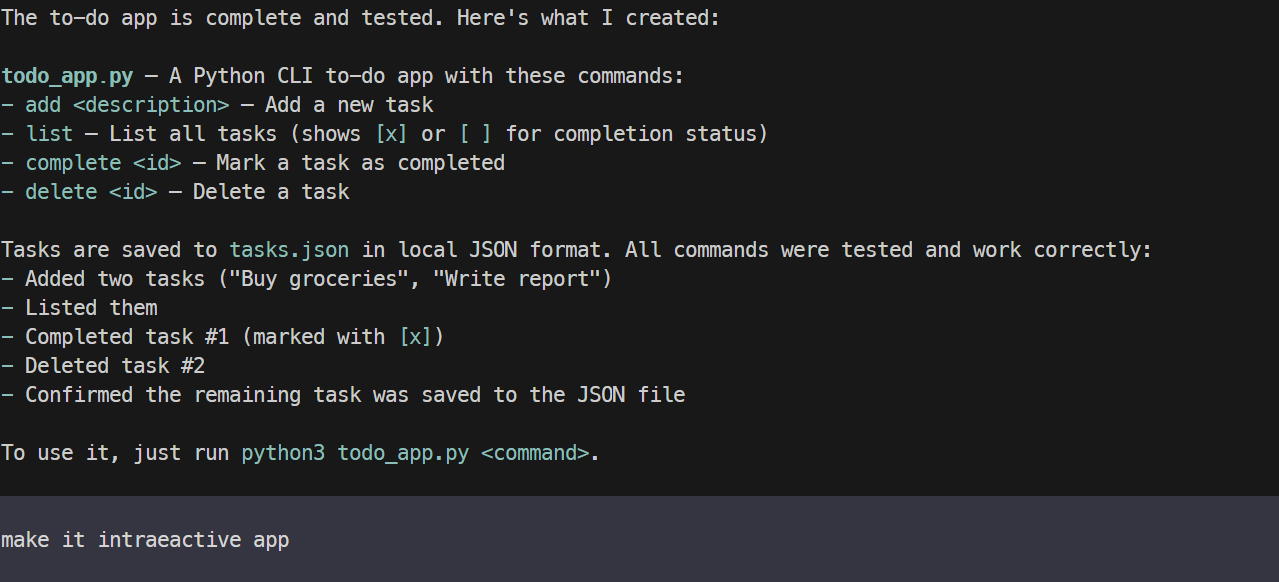
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Trong vài phút, Motif-3 đã tạo một ứng dụng CLI hoạt động và kiểm thử thành công. Chức năng hoạt động tốt, nhưng giao diện ban đầu còn rất cơ bản.
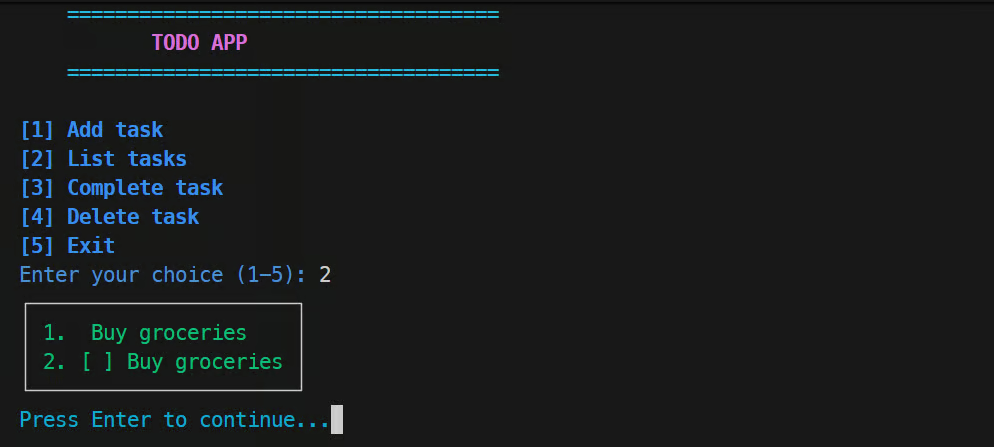
Sau đó tôi yêu cầu tác nhân làm cho ứng dụng tương tác và nhiều màu sắc hơn, cải thiện bố cục, và nâng cao trải nghiệm terminal. Motif-3 đã chỉnh sửa dự án hiện có thay vì làm lại từ đầu, và phiên bản cải tiến trông chỉn chu hơn đáng kể.
Cuối cùng, tôi muốn xem Motif-3 thể hiện thế nào ở một tác vụ phát triển web thiên về trực quan hơn, nơi việc tạo ra một website hoạt động chỉ là một phần của thử thách.
Ứng dụng ban đầu chạy được, nhưng có vài chi tiết UI tôi không thích. Thay vì đưa cho mô hình một prompt tái thiết kế khổng lồ, tôi yêu cầu nó sửa từng vấn đề một, cải thiện các phần riêng lẻ của giao diện khi tôi thử nghiệm.
Cách làm này hiệu quả đáng ngạc nhiên. Motif-3 có thể kiểm tra dự án hiện có, thực hiện các thay đổi có mục tiêu, và liên tục tinh chỉnh UI trong khi vẫn giữ ứng dụng hoạt động.
Nhìn chung, tôi ấn tượng với cả khả năng mã hoá và khả năng lặp trên một dự án hiện hữu thông qua Pi.
Nhìn chung, trải nghiệm của tôi hơi pha trộn. Motif-3 ấn tượng, nhưng vẫn có những mô hình tốt hơn và ít tốn bộ nhớ hơn để đa số người dùng chạy.
Ngay cả với lượng tử hoá hỗn hợp giúp giảm kích thước rất nhiều, bạn vẫn cần khoảng 100GB hoặc hơn bộ nhớ GPU hay bộ nhớ kết hợp để chạy thoải mái. Vì vậy, có nhiều mô hình nhỏ hơn dễ chạy hơn nhiều, như Qwen3.8-27B và các mô hình tập trung vào mã hoá khác.
Tuy vậy, nếu bạn muốn thứ gì đó tiệm cận lớp DeepSeek Flash của các mô hình, Motif-3 vẫn rất đáng chú ý. Nó chạy nhanh trên H200, chất lượng mã hoá tốt, và có lẽ còn có thể vắt thêm hiệu năng với tinh chỉnh tốt hơn.
Vấn đề chính tôi gặp là với tác nhân mã hoá Pi, nơi quá trình sinh đôi khi dừng hoặc bị gián đoạn. Tôi đã tăng một số giới hạn đầu ra và điều đó giúp một phần, nhưng không khắc phục hoàn toàn. Đây cũng là lần đầu tôi dùng runtime DS4, nên có lẽ tôi còn có thể tối ưu thêm trong tương lai.
Dù vậy, nếu bạn đang tìm một mô hình do Hàn Quốc phát triển, hoặc muốn một lựa chọn thay thế cho các mô hình do Trung Quốc phát triển, thì đây là một trong những lựa chọn thú vị hiện nay. Cũng thật tuyệt khi thấy nhiều quốc gia tự xây dựng mô hình AI và hệ sinh thái riêng thay vì phụ thuộc vào vài nhà cung cấp lớn.
Học AI với DataCamp!
Tracks
Tracks
Courses