track
Associate AI Engineer för utvecklare
26 timmar
Motif-3 är en storskalig Mixture-of-Experts (MoE)-modell från Motif Technologies, byggd med totalt 314B parametrar men aktiverar bara 13,2B parametrar per token.
Den har 384 routade experter, ett 256K kontextfönster och tränades på ungefär 12,5 biljoner tokens som spänner över kod, matematik, STEM, flerspråkig data och andra domäner.
Den lämpar sig särskilt väl för resonemang, kodning och agentiska arbetslaster. På Artificial Analysis Intelligence Index når den en poäng på 47, vilket placerar den mellan Qwen3.8-27B och MiniMax-M3, som vi testade i en liknande setup.
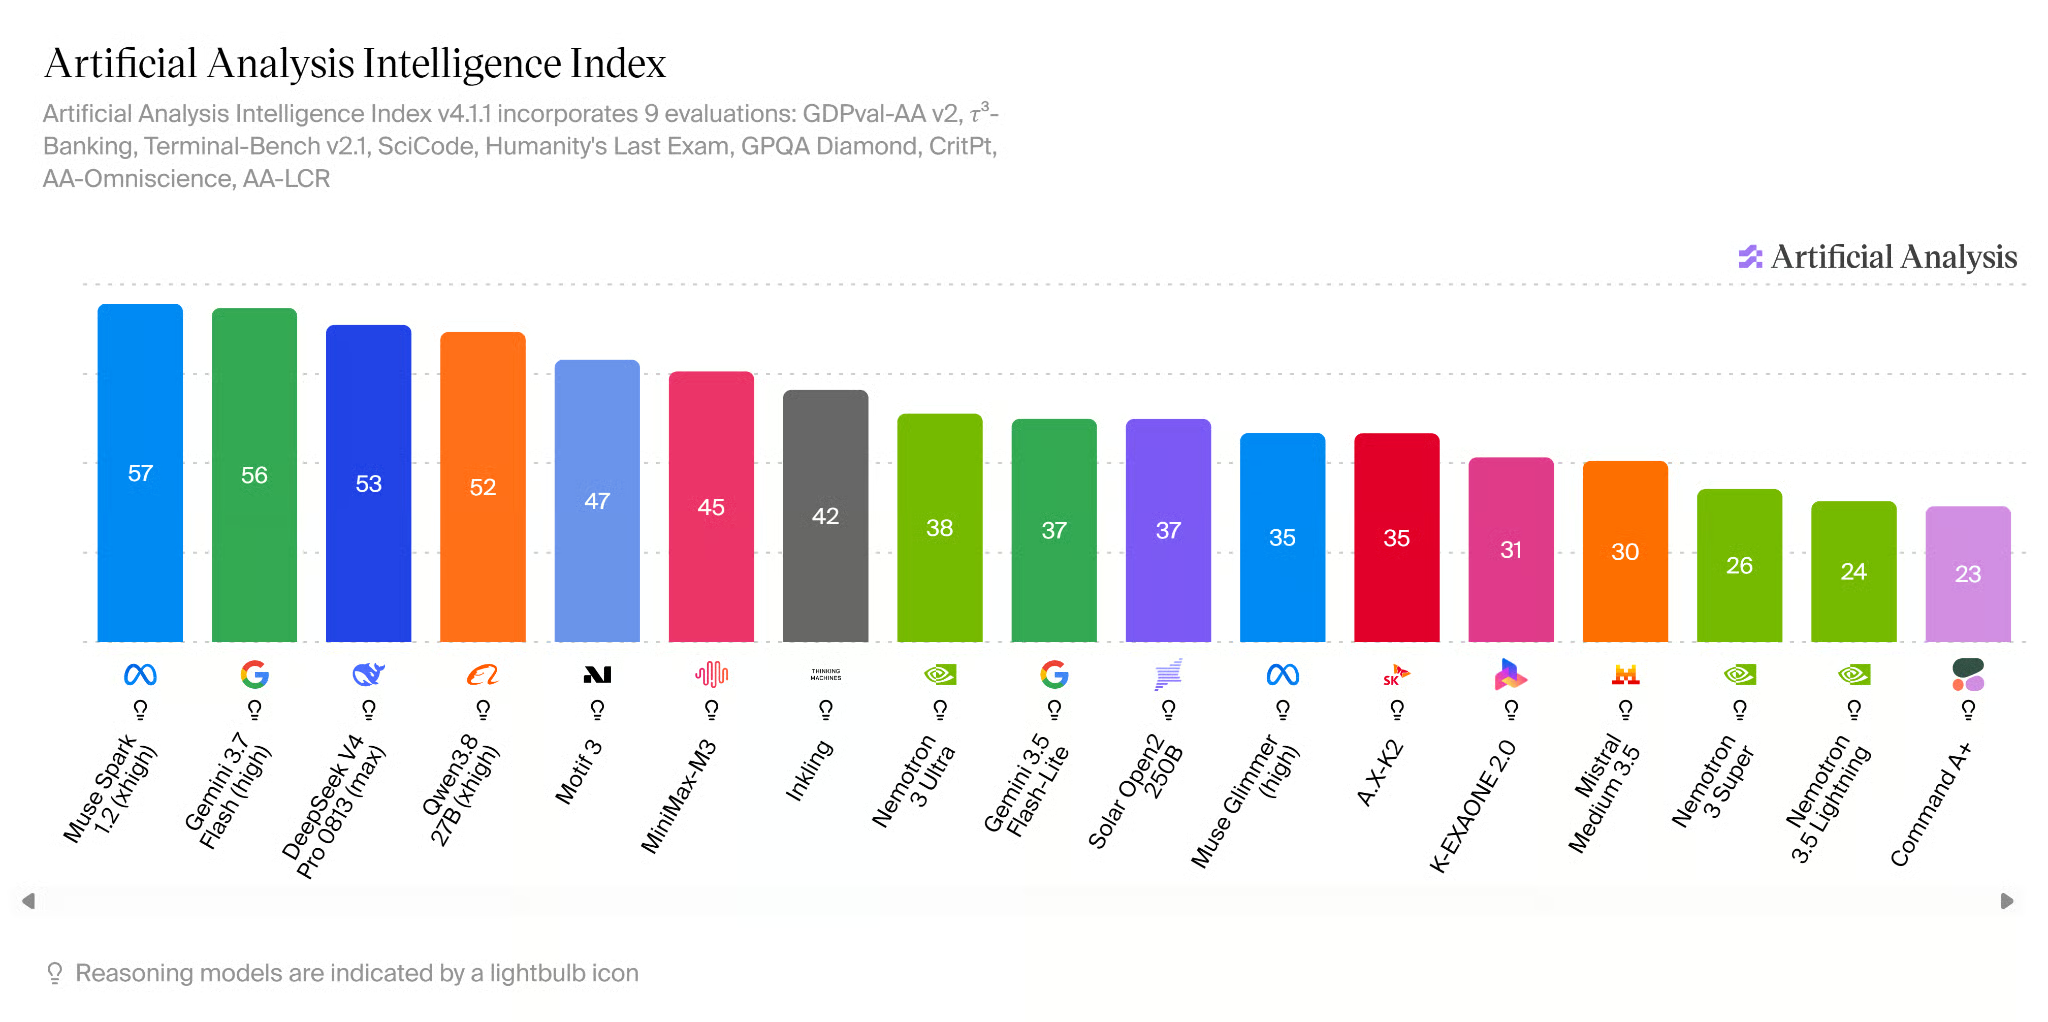
Källa: AI Model & API Providers Analysis | Artificial Analysis
För den här guiden använder vi Baekpica/Motif-3-Mixed-Quant-GGUF, en oberoende skapad kvantiserad version av Motif-3. I stället för att använda en precisionsnivå för hela modellen använder den mixkvantisering, med högre precision för viktiga komponenter och mycket lägre precision för de enorma expertlagren.
Till exempel använder viktiga attention- och alltid aktiva komponenter Q8_0, medan mycket av de routade expertvikterna använder IQ2_XXS och Q2_K. Modellen behåller fortfarande alla 384 experter och alla 53 lager, så inget beskärs eller tas bort. Detta minskar modellen till ungefär 94 GB, jämfört med cirka 335 GB för Q8_0 GGUF, vilket gör den tillräckligt liten för att köras helt på en 141 GB H200 med extra VRAM tillgängligt för runtime och KV-cache.
För mer bakgrund rekommenderar jag att läsa våra guider om kvantisering för LLM:er och GGUF-formatet.
Motif-3 Mixed Quant är runt 94 GB, så du behöver ett GPU-kort med tillräckligt VRAM för att ladda modellen och lämna utrymme för inferens. Jag rekommenderar att hyra en ensam NVIDIA H200 med 141 GB VRAM från en GPU-molnleverantör som Hyperbolic, RunPod eller Vast.ai.
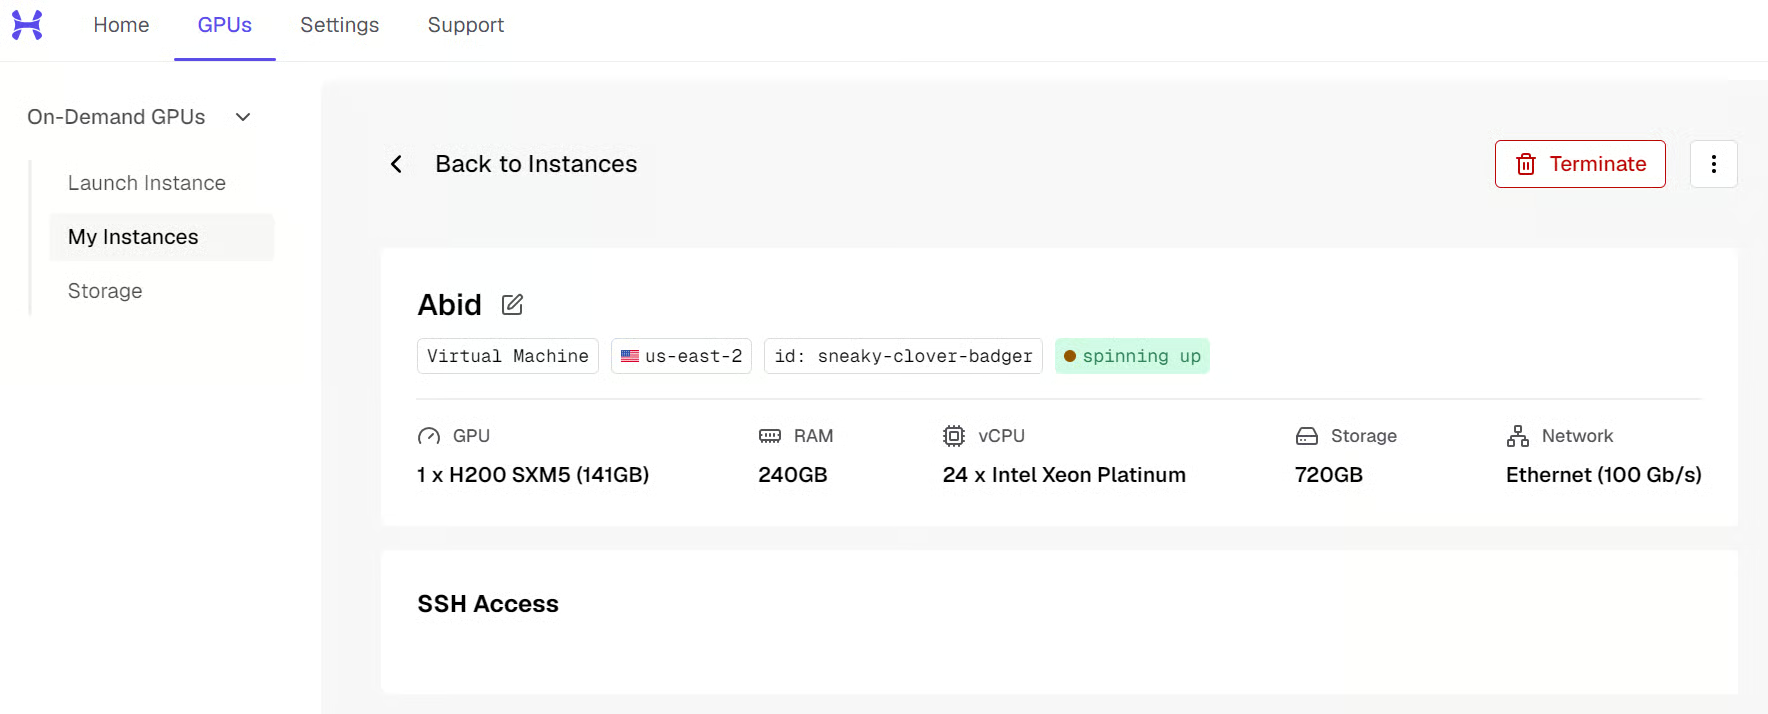
När din instans kör, anslut till den från din terminal eller via VS Code Remote SSH. Din leverantör ger dig IP-adressen. Kommandot kommer att se ut ungefär så här:
ssh root@<SERVER_IP> -L 8080:localhost:8080Flaggan -L 8080:localhost:8080 vidarebefordrar också Motif-3:s API-port till din lokala dator, så att du senare kan nå den på http://127.0.0.1:8080.
Förbered nu servern:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Kontrollera till sist att H200 är tillgänglig:
nvidia-smi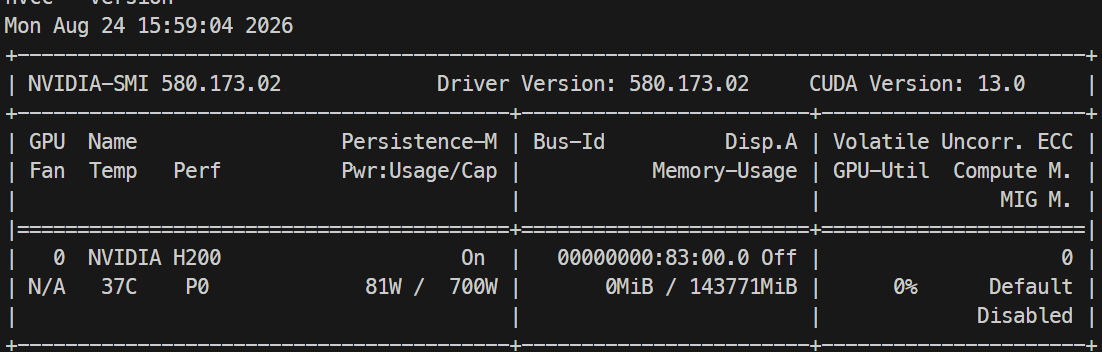
Du bör se en NVIDIA H200 med ungefär 141 GB VRAM.
Ladda därefter ner modellen Baekpica/Motif-3-Mixed-Quant-GGUF från Hugging Face. Vi använder varianten MQ87-88-FIT, som är uppdelad i 11 GGUF-filer med en total storlek på cirka 94 GB.
Från katalogen /workspace/motif3, kör:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model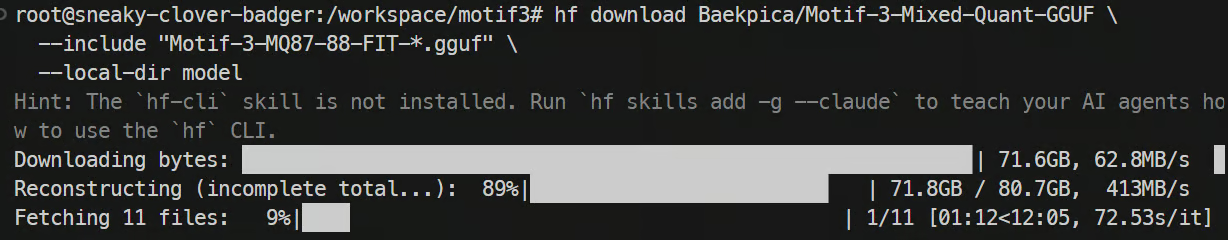
Beroende på din uppkoppling kan det ta tid att ladda ner alla 94 GB. När det är klart, kontrollera att alla shards finns:
ls -lh modelVerifiera shards innan hopslagning. Sammanfogningen är en engångsåtgärd på 94 GB, så det är värt att fånga en felaktig nedladdning nu:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..ds4-runtime förväntar sig modellen som en enda GGUF-fil, så vi behöver först slå ihop de 11 nedladdade shardsen.
Klona llama.cpp och bygg dess GGUF-verktyg:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Slå nu ihop alla 11 shards till en fil:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Kontrollera den sammanslagna modellen:
ls -lh motif3.ggufDu bör se en stor motif3.gguf-fil.
Vi behöver ds4-runtime för att ladda och serva Motif-3 effektivt på NVIDIA H200.
Klona grenen dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Kompilera den med CUDA-stöd för H200 (Hopper, sm_90). Notera att ds4:s primära mål är DGX Spark/GB10, och H200-stöd kommer från projektets bring-up-arbete snarare än dess huvudsakliga serving-väg:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Kontrollera att binärerna skapades:
ls -lh ds4*Du bör se binärer som ds4-server och ds4_weight_server.
Viktservern laddar och hanterar modellvikterna på GPU:n så att API-servern kan använda dem för inferens.
Skapa först kataloger för runtime-filer och KV-cache:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Kör preflight först för att kontrollera att modellen får plats innan du committar till en fullständig inladdning:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Om det passerar, kör samma kommando igen utan --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned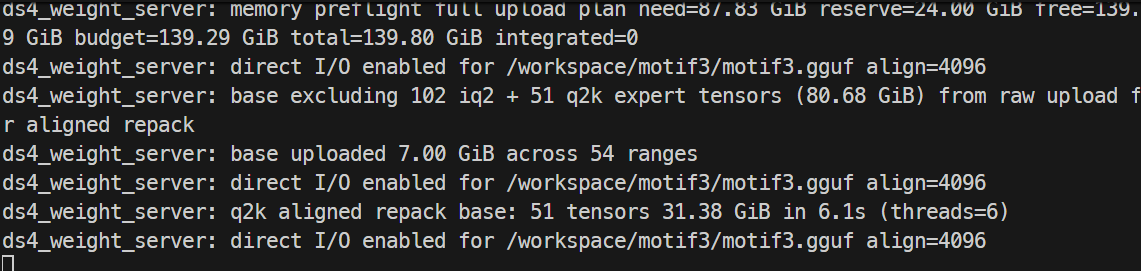
Håll den här terminalen igång. Viktservern måste vara aktiv medan du kör Motif-3.
Nu startar vi ds4 API-servern, som exponerar Motif-3 via en OpenAI-kompatibel endpoint som du kan nå från din lokala dator.
Öppna en annan terminal och anslut till servern, gå sedan in i ds4-katalogen:
cd /workspace/motif3/ds4Sätt nödvändiga miljövariabler:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Starta API-servern med ett 125K kontextfönster. På H200 är runtime validerad upp till 128K, med 256K som bara når partiell prefill, så 125K ligger precis inom det som har testats:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768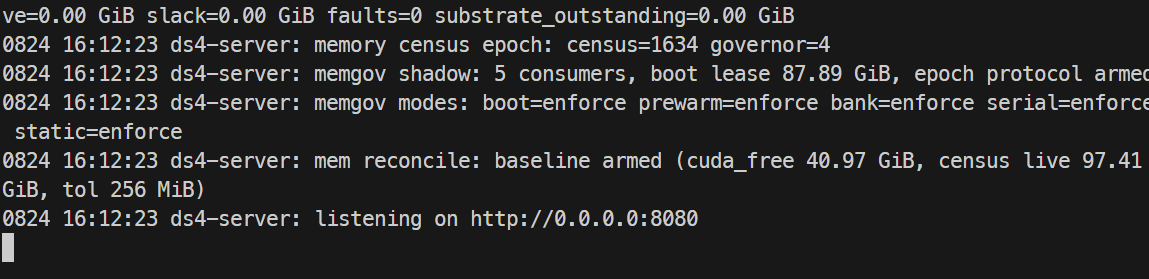
Håll den här terminalen igång.
Eftersom vi vidarebefordrade port 8080 över SSH tidigare kan du nu öppna en terminal på din lokala dator och kontrollera API:t:
curl http://127.0.0.1:8080/v1/models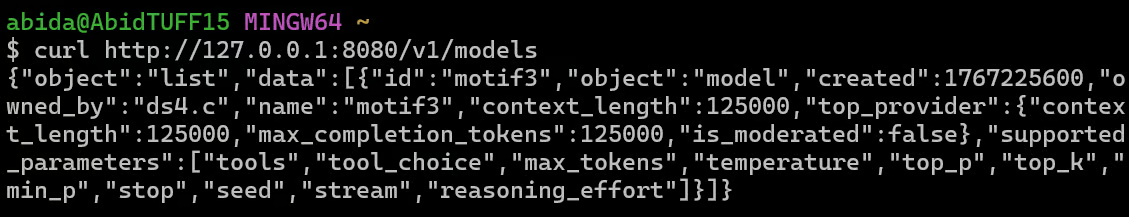
Du bör se motif-3 listad som modell med ett kontextlängd på 125000.
Skicka nu din första prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'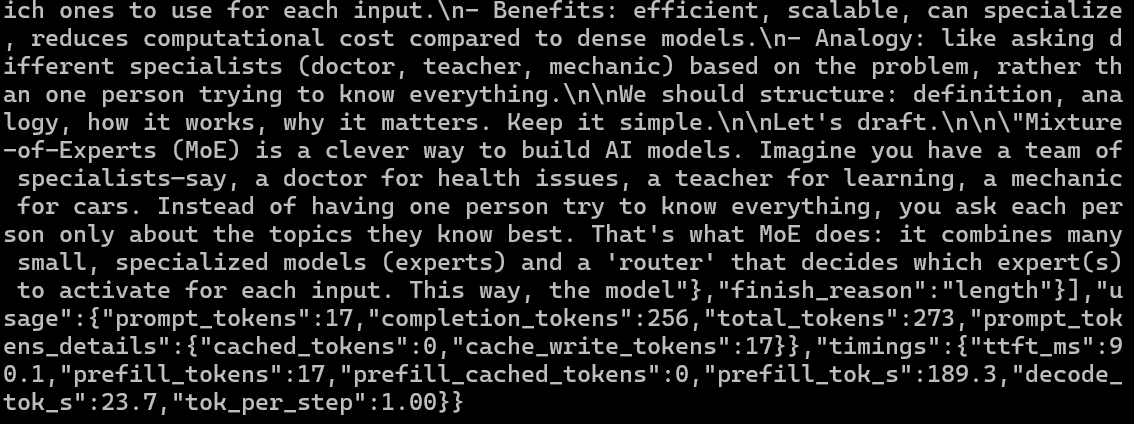
Om allt fungerar genererar Motif-3 ett svar direkt från din H200. I mitt test uppnådde modellen följande mätvärden:
Du kan också kontrollera GPU-minnesanvändningen på servern:
nvidia-smi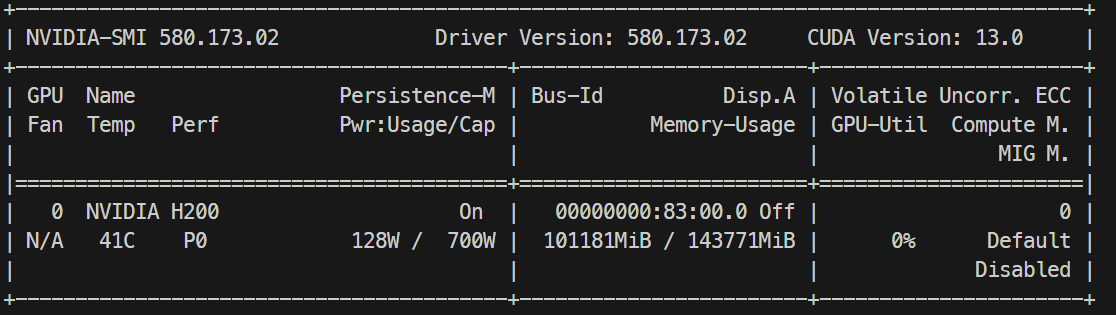
I min setup använde Motif-3 ungefär 101 GB av H200:s rapporterade 141 GB GPU-minne, vilket lämnade extra VRAM tillgängligt för inferens och KV-cache.
Nu kopplar vi det lokala Motif-3 API:t till Pi, så att modellen kan fungera som en kodagent som kan skapa filer, köra kommandon och iterera på ett projekt.
Säkerställ att Motif-3 fortfarande är tillgänglig på:
http://127.0.0.1:8080/v1Installera Pi med den officiella installern:
curl -fsSL https://pi.dev/install.sh | shStarta om din terminal och bekräfta sedan installationen:
pi --versionPi stöder anpassade OpenAI-kompatibla modeller via ~/.pi/agent/models.json. Skapa konfigurationen:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFNu kan vi ge Motif-3 en riktig koduppgift och se om den kan bygga, köra och förbättra en applikation autonomt.
Skapa ett testprojekt och starta Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
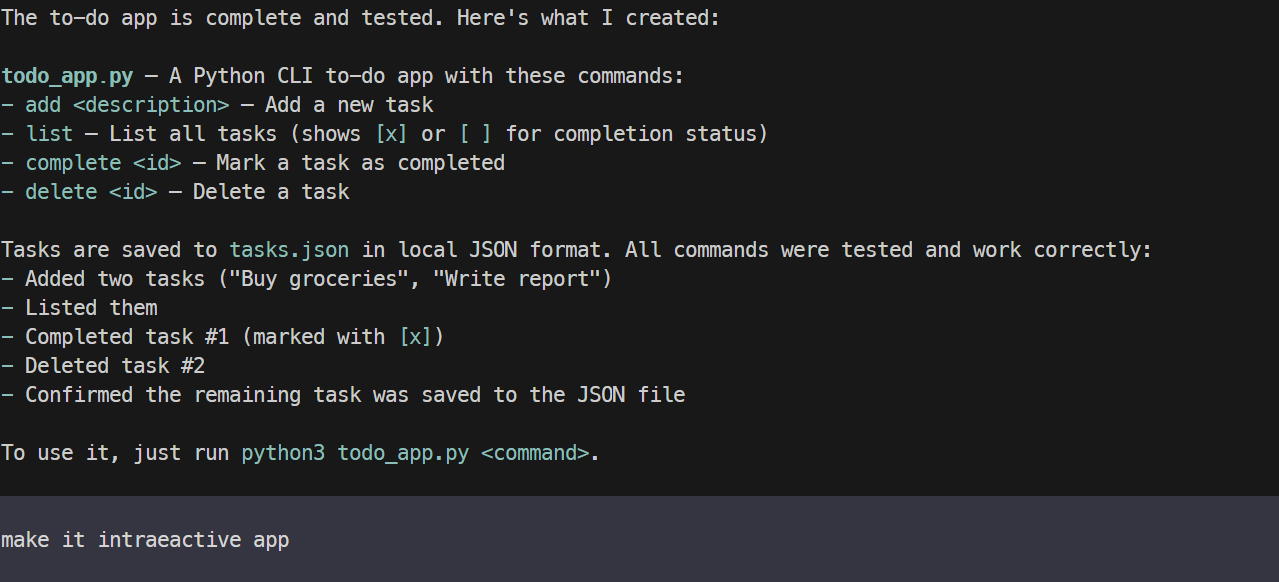
Låt oss testa modellen. Först ber vi den bygga en enkel att-göra-app.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Inom några minuter skapade Motif-3 en fungerande CLI-applikation och testade den framgångsrikt. Funktionaliteten fungerade bra, men det initiala gränssnittet var väldigt grundläggande.
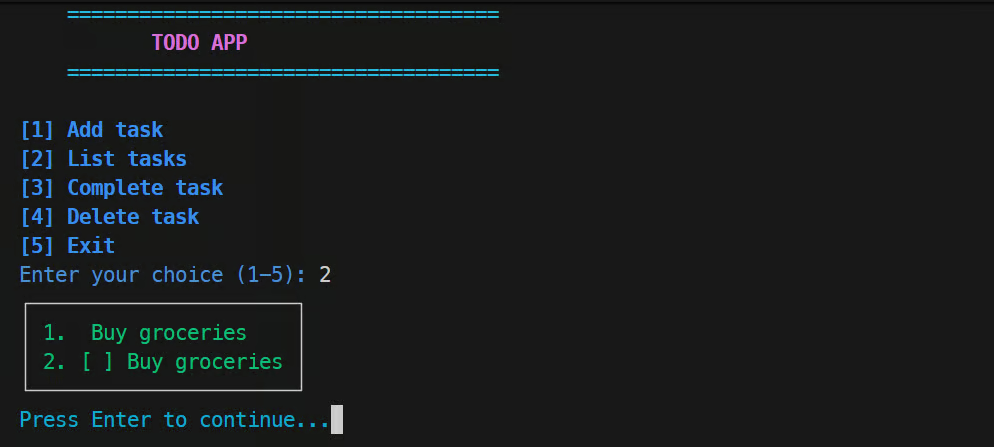
Jag bad sedan agenten att göra applikationen mer interaktiv och färgglad, förbättra layouten och förhöja terminalupplevelsen. Motif-3 modifierade det befintliga projektet istället för att börja om, och den förbättrade versionen var avsevärt mer polerad.
Avslutningsvis ville jag se hur Motif-3 presterade på en mer visuell webbutvecklingsuppgift, där att generera en fungerande webbplats bara är en del av utmaningen.
Den första applikationen fungerade, men det fanns flera UI-detaljer jag inte gillade. Istället för att ge modellen en stor omdesign-prompt bad jag den att fixa problemen ett i taget och förbättra enskilda delar av gränssnittet medan jag testade dem.
Detta fungerade förvånansvärt bra. Motif-3 kunde inspektera det befintliga projektet, göra riktade ändringar och upprepade gånger förfina UI:t samtidigt som applikationen förblev funktionell.
Överlag blev jag imponerad av både dess kodprestanda och dess förmåga att iterera på ett befintligt projekt via Pi.
Överlag var min upplevelse lite blandad. Motif-3 är imponerande, men för de flesta finns det bättre och mindre minneskrävande modeller att köra.
Även med mixkvantiseringen, som minskar storleken mycket, behöver du fortfarande runt 100 GB eller mer av GPU- eller kombinerat minne för att köra den bekvämt. På grund av det finns det många mindre modeller som är mycket enklare att köra, som Qwen3.8-27B och andra kodfokuserade modeller.
Med det sagt, om du vill ha något närmare DeepSeek Flash-klassen av modeller, är Motif-3 fortfarande väldigt intressant. Den är snabb på en H200, kodkvaliteten är bra och det finns troligen mer prestanda att hämta med bättre tuning.
Det största problemet jag hade var med Pi-kodagenten, där genereringen ibland stannade eller avbröts. Jag ökade vissa utgångsgränser och det hjälpte, men löste inte problemet helt. Det här är också min första gång med DS4-runtime, så det finns säkert mer jag kan optimera framöver.
Ändå, om du specifikt letar efter en koreanskt utvecklad modell, eller vill ha ett alternativ till kinesiskt utvecklade modeller, är detta ett av de mer intressanta alternativen just nu. Det är också kul att se fler länder bygga egna AI-modeller och ekosystem istället för att vara beroende av bara några få stora leverantörer.
Lär dig AI med DataCamp!
track
track
course