Track
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
Motif-3 एक बड़े पैमाने का Mixture-of-Experts (MoE) मॉडल है जो Motif Technologies का है, जिसमें कुल 314B पैरामीटर हैं जबकि प्रति टोकन केवल 13.2B पैरामीटर सक्रिय होते हैं।
इसमें 384 रूटेड एक्सपर्ट्स, 256K का कॉन्टेक्स्ट विंडो है, और इसे लगभग 12.5 ट्रिलियन टोकन पर प्रशिक्षित किया गया है, जिनमें कोड, गणित, STEM, बहुभाषी डेटा और अन्य डोमेन शामिल हैं।
यह विशेष रूप से रीजनिंग, कोडिंग और एजेंटिक वर्कलोड्स के लिए उपयुक्त है। Artificial Analysis Intelligence Index पर, यह 47 का स्कोर प्राप्त करता है, जो इसे Qwen3.8-27B और MiniMax-M3, जिसे हमने समान सेटअप में परखा, के बीच रखता है।
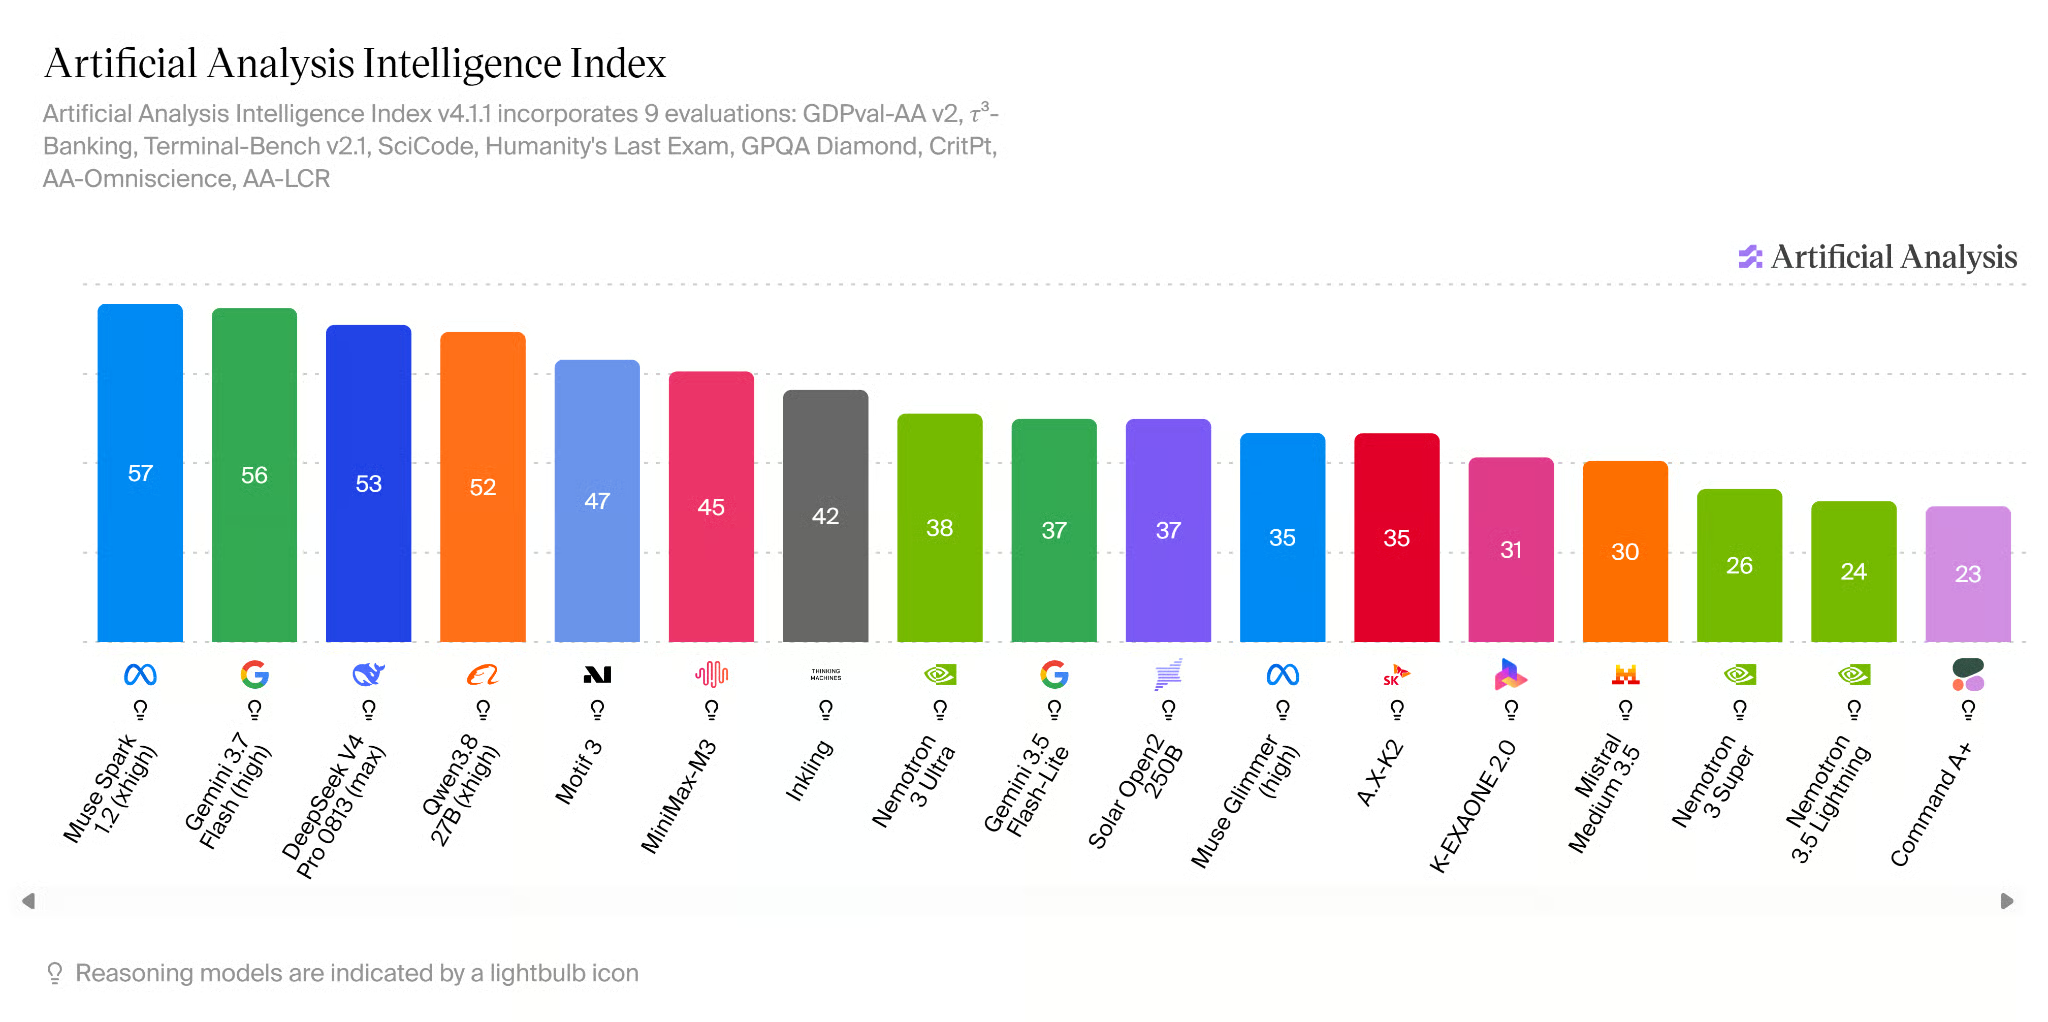
स्रोत: AI Model & API Providers Analysis | Artificial Analysis
इस गाइड में हम Baekpica/Motif-3-Mixed-Quant-GGUF का उपयोग कर रहे हैं, जो Motif-3 का स्वतंत्र रूप से बनाया गया क्वांटाइज़्ड संस्करण है। पूरे मॉडल के लिए एक ही प्रिसीजन स्तर उपयोग करने के बजाय, यह मिश्रित क्वांटाइज़ेशन अपनाता है—महत्वपूर्ण कंपोनेंट्स के लिए उच्च प्रिसीजन और विशाल एक्सपर्ट लेयर्स के लिए बहुत कम प्रिसीजन।
उदाहरण के लिए, महत्वपूर्ण अटेंशन और हमेशा-सक्रिय कंपोनेंट्स Q8_0 का उपयोग करते हैं, जबकि अधिकांश रूटेड एक्सपर्ट वेट्स IQ2_XXS और Q2_K का उपयोग करते हैं। मॉडल अभी भी सभी 384 एक्सपर्ट्स और सभी 53 लेयर्स रखता है, इसलिए कुछ भी प्रून या हटाया नहीं गया है। यह मॉडल को लगभग 94GB तक घटा देता है, जबकि Q8_0 GGUF के लिए यह लगभग 335GB होता, जिससे यह 141GB H200 पर पूरी तरह चलाने के लिए पर्याप्त छोटा हो जाता है और रनटाइम व KV कैश के लिए अतिरिक्त VRAM बचती है।
अधिक पृष्ठभूमि के लिए, हमारे LLMs के लिए क्वांटाइज़ेशन और GGUF फ़ॉर्मेट पर गाइड पढ़ने की सलाह देता हूँ।
Motif-3 Mixed Quant लगभग 94GB का है, इसलिए आपको ऐसा GPU चाहिए जिसमें मॉडल लोड करने और इन्फरेंस के लिए स्पेस बचाने लायक VRAM हो। मैं Hyperbolic, RunPod, या Vast.ai जैसे GPU क्लाउड प्रदाताओं से 141GB VRAM वाला एकल NVIDIA H200 किराए पर लेने की अनुशंसा करता हूँ।
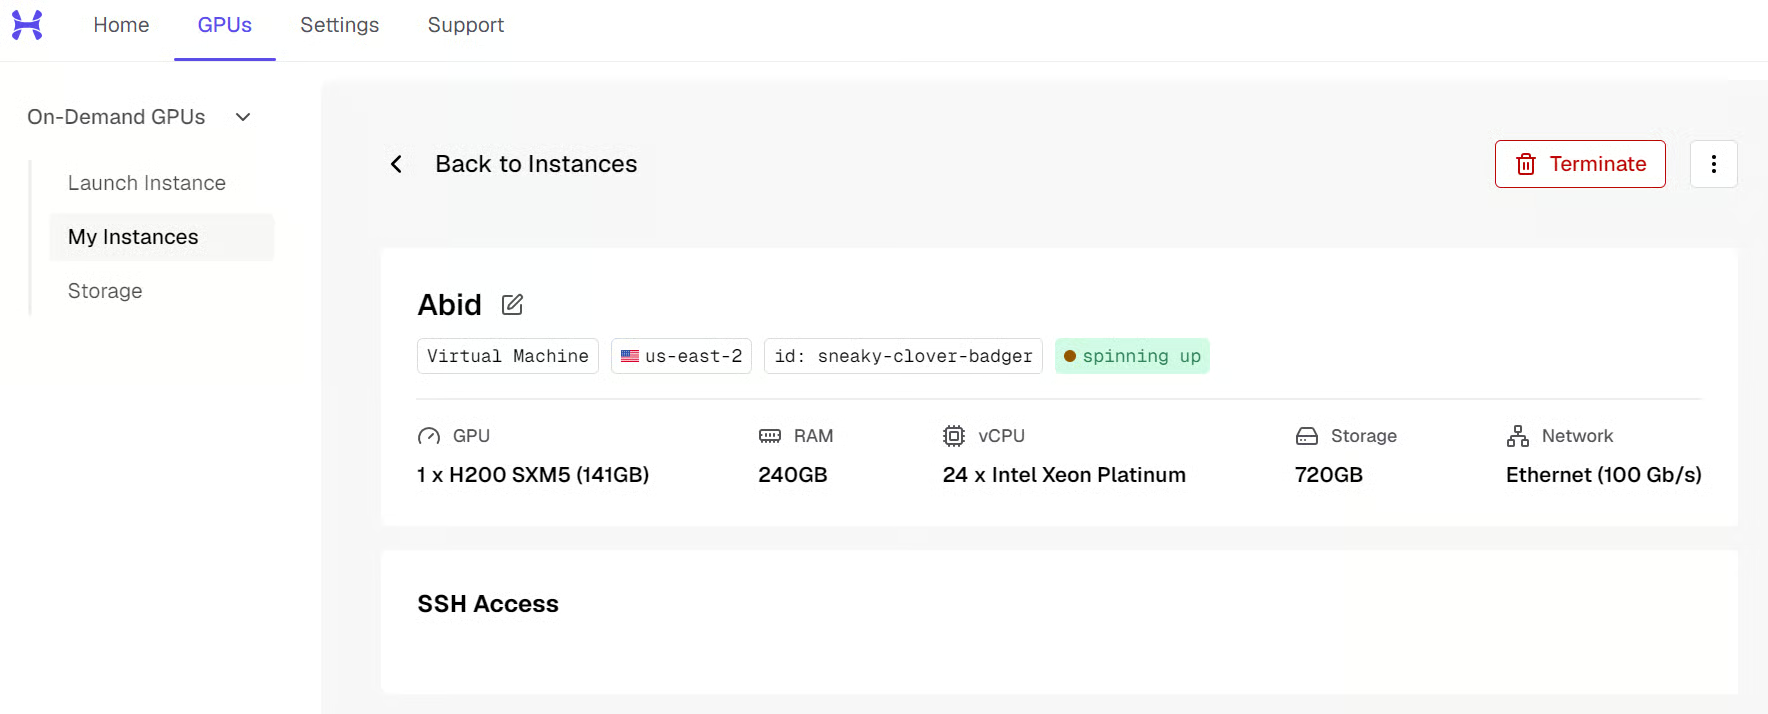
इंस्टेंस चलने के बाद, अपने टर्मिनल या VS Code Remote SSH के माध्यम से कनेक्ट करें। आपका प्रदाता IP पता देगा। कमांड कुछ ऐसा दिखेगा:
ssh root@<SERVER_IP> -L 8080:localhost:8080विकल्प -L 8080:localhost:8080 Motif-3 API पोर्ट को आपके लोकल PC पर भी फ़ॉरवर्ड करता है, ताकि बाद में आप इसे http://127.0.0.1:8080 पर एक्सेस कर सकें।
अब सर्वर को तैयार करें:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
अंत में, जाँचें कि H200 उपलब्ध है:
nvidia-smi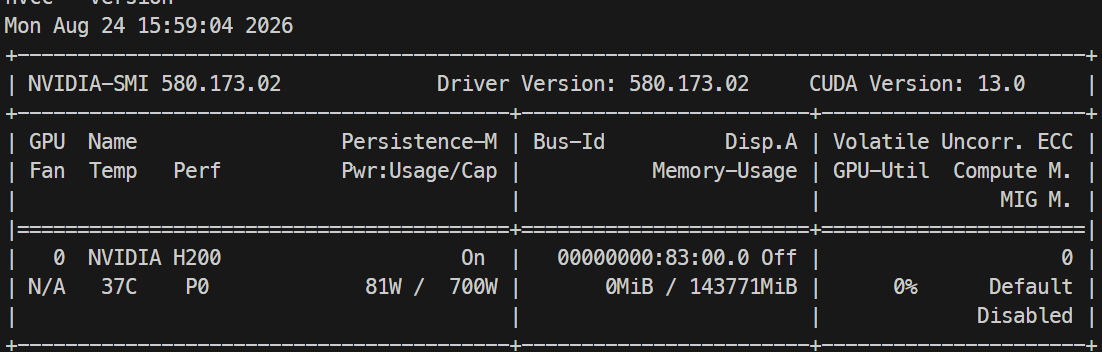
आपको लगभग 141GB VRAM वाला NVIDIA H200 दिखना चाहिए।
अब Hugging Face से Baekpica/Motif-3-Mixed-Quant-GGUF मॉडल डाउनलोड करें। हम MQ87-88-FIT वेरिएंट का उपयोग कर रहे हैं, जो 11 GGUF फाइलों में विभाजित है और कुल आकार लगभग 94GB है।
/workspace/motif3 डायरेक्टरी से, यह चलाएँ:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model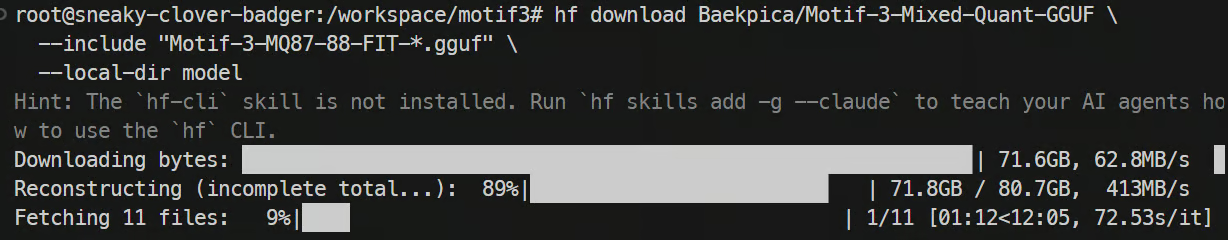
आपके कनेक्शन पर निर्भर करते हुए, पूरे 94GB डाउनलोड होने में समय लग सकता है। पूरा होने पर, सुनिश्चित करें कि सभी शार्ड मौजूद हैं:
ls -lh modelमर्ज करने से पहले, शार्ड्स को सत्यापित करें। 94GB पर यह एक बार का मर्ज ऑपरेशन है, इसलिए अभी किसी भी खराब डाउनलोड को पकड़ना फायदेमंद है:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..ds4 रनटाइम मॉडल को एकल GGUF फाइल के रूप में अपेक्षा करता है, इसलिए पहले हमें डाउनलोड किए गए 11 शार्ड्स को मर्ज करना होगा।
llama.cpp क्लोन करें और उसकी GGUF यूटिलिटी बनाएं:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
अब सभी 11 शार्ड्स को एक फाइल में मर्ज करें:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
मर्ज किए गए मॉडल की जाँच करें:
ls -lh motif3.ggufआपको एक बड़ा motif3.gguf फाइल दिखना चाहिए।
हमें NVIDIA H200 पर Motif-3 को कुशलता से लोड और सर्व करने के लिए ds4 रनटाइम की आवश्यकता होगी।
dfm ब्रांच क्लोन करें:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
इसे H200 (Hopper, sm_90) के लिए CUDA सपोर्ट के साथ कॉम्पाइल करें। ध्यान दें कि ds4 का प्राथमिक लक्ष्य DGX Spark/GB10 है, और H200 सपोर्ट प्रोजेक्ट के ब्रिंग-अप कार्य से आता है न कि इसके मुख्य सर्विंग पथ से:
make cuda CUDA_ARCH=sm_90 -j$(nproc)जाँचें कि बायनरी सफलतापूर्वक बन गई हैं:
ls -lh ds4*आपको ds4-server और ds4_weight_server जैसी बायनरी दिखनी चाहिए।
वेट सर्वर GPU पर मॉडल वेट्स को लोड और मैनेज करता है ताकि API सर्वर उन्हें इन्फरेंस के लिए उपयोग कर सके।
पहले, रनटाइम फाइलों और KV कैश के लिए डायरेक्टरी बनाएं:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
पूर्ण लोड से पहले प्रीफ्लाइट चलाएँ ताकि सुनिश्चित हो सके कि मॉडल फिट होगा:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
यदि यह पास हो जाए, तो वही कमांड --dry-run हटाकर चलाएँ:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned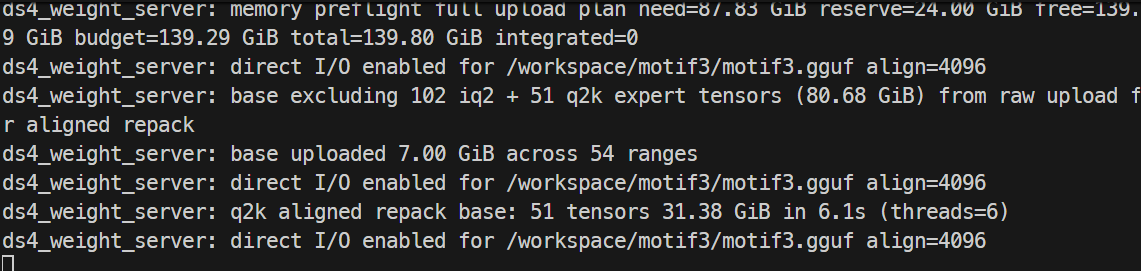
यह टर्मिनल चालू रखें। Motif-3 चलाते समय वेट सर्वर सक्रिय रहना चाहिए।
अब हम ds4 API सर्वर शुरू करेंगे, जो Motif-3 को OpenAI-संगत एंडपॉइंट के माध्यम से एक्सपोज़ करता है, जिसे आप अपने लोकल कंप्यूटर से एक्सेस कर सकते हैं।
एक और टर्मिनल खोलें और सर्वर से कनेक्ट करें, फिर ds4 डायरेक्टरी में जाएँ:
cd /workspace/motif3/ds4आवश्यक एनवायरनमेंट वेरिएबल्स सेट करें:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
125K कॉन्टेक्स्ट विंडो के साथ API सर्वर शुरू करें। H200 पर, रनटाइम 128K तक वेलिडेटेड है, जबकि 256K केवल आंशिक प्रीफिल तक पहुँचता है, इसलिए 125K परीक्षण सीमा के भीतर है:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768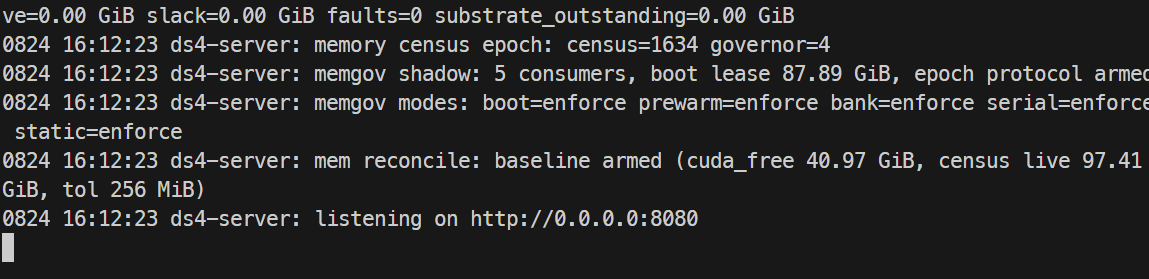
यह टर्मिनल चालू रखें।
क्योंकि हमने पहले SSH के जरिए पोर्ट 8080 फ़ॉरवर्ड किया था, अब आप अपने लोकल PC पर टर्मिनल खोलकर API जाँच सकते हैं:
curl http://127.0.0.1:8080/v1/models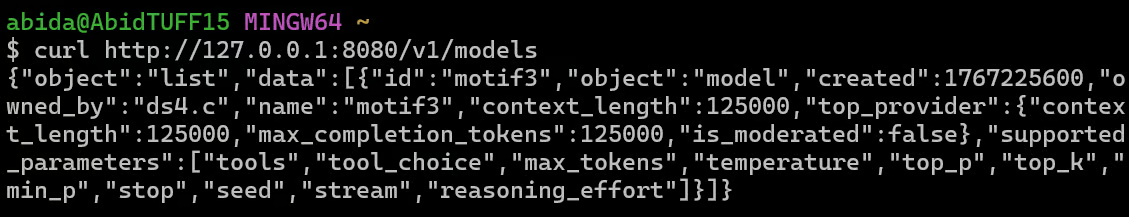
आपको motif-3 मॉडल सूचीबद्ध दिखाई देना चाहिए, जिसका कॉन्टेक्स्ट लेंथ 125000 है।
अब अपना पहला प्रॉम्प्ट भेजें:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'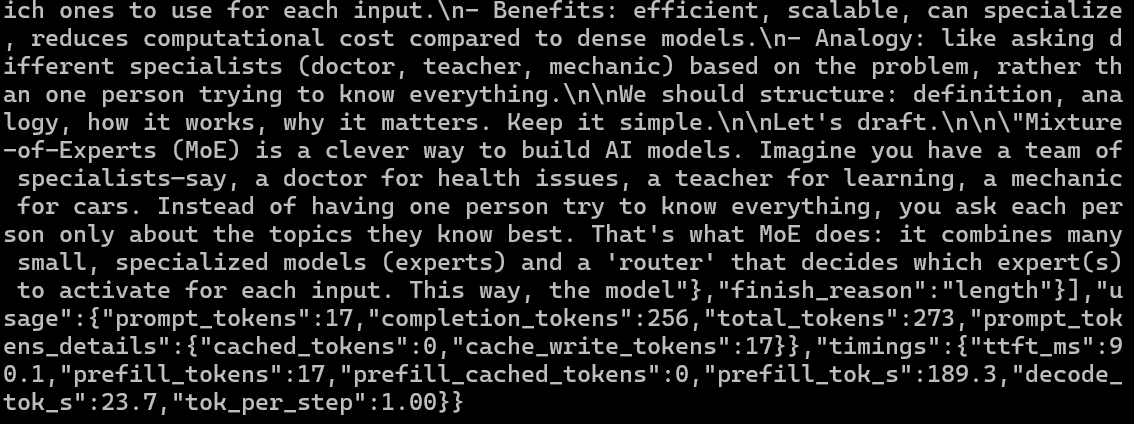
यदि सब ठीक है, तो Motif-3 आपके H200 से सीधे प्रतिक्रिया जेनरेट करेगा। मेरे परीक्षण में, मॉडल ने ये मेट्रिक्स हासिल किए:
आप सर्वर पर GPU मेमोरी उपयोग भी जाँच सकते हैं:
nvidia-smi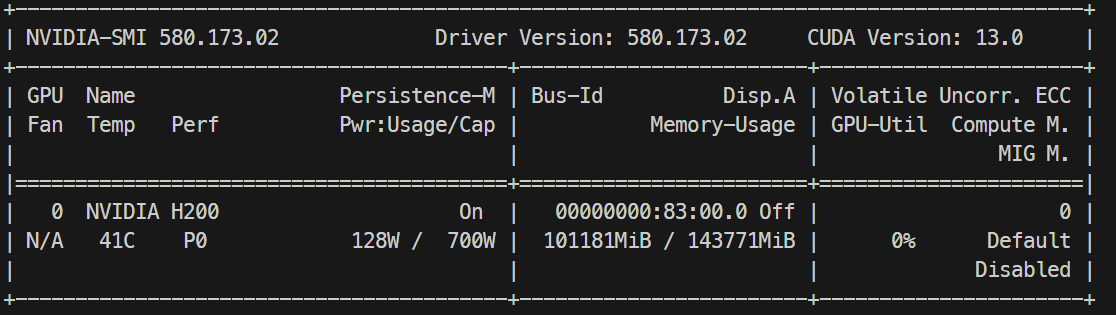
मेरे सेटअप में, Motif-3 ने H200 की 141GB रिपोर्टेड GPU मेमोरी में से लगभग 101GB का उपयोग किया, जिससे इन्फरेंस और KV कैश के लिए अतिरिक्त VRAM उपलब्ध रही।
अब हम लोकल Motif-3 API को Pi से कनेक्ट करेंगे, जिससे मॉडल एक कोडिंग एजेंट की तरह काम कर सकेगा—फाइलें बना सके, कमांड चला सके और किसी प्रोजेक्ट पर इटरेट कर सके।
सुनिश्चित करें कि Motif-3 यहाँ उपलब्ध है:
http://127.0.0.1:8080/v1Pi को आधिकारिक इंस्टॉलर से इंस्टॉल करें:
curl -fsSL https://pi.dev/install.sh | shअपना टर्मिनल रीस्टार्ट करें, फिर इंस्टॉलेशन की पुष्टि करें:
pi --versionPi ~/.pi/agent/models.json के माध्यम से कस्टम OpenAI-संगत मॉडलों को सपोर्ट करता है। यह कॉन्फ़िगरेशन बनाएँ:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFअब हम Motif-3 को एक वास्तविक कोडिंग टास्क देंगे और देखेंगे कि क्या यह स्वायत्त रूप से कोई एप्लिकेशन बना, चला और सुधार कर सकता है।
एक टेस्ट प्रोजेक्ट बनाएँ और Pi शुरू करें:
mkdir -p ~/motif-test
cd ~/motif-test
pi
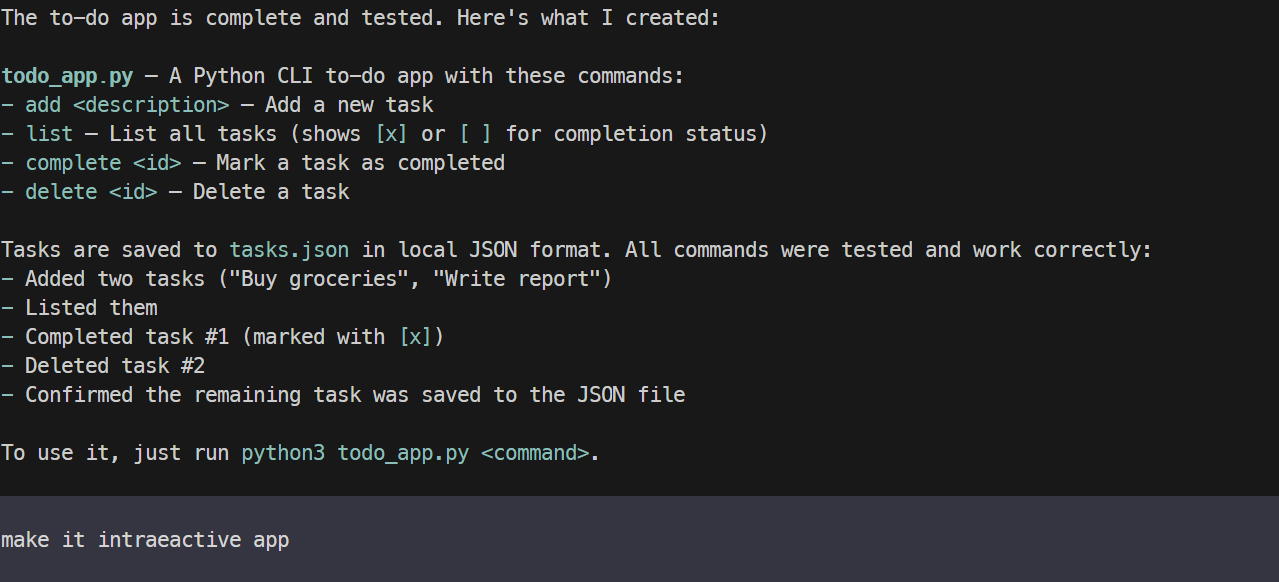
आइए मॉडल का परीक्षण करें। सबसे पहले, हम इसे एक साधारण टू-डू ऐप बनाने के लिए कहेंगे।
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.कुछ ही मिनटों में, Motif-3 ने एक काम करने वाला CLI एप्लिकेशन बनाया और सफलतापूर्वक उसका परीक्षण किया। कार्यक्षमता अच्छी थी, लेकिन शुरुआती इंटरफ़ेस बहुत बुनियादी था।
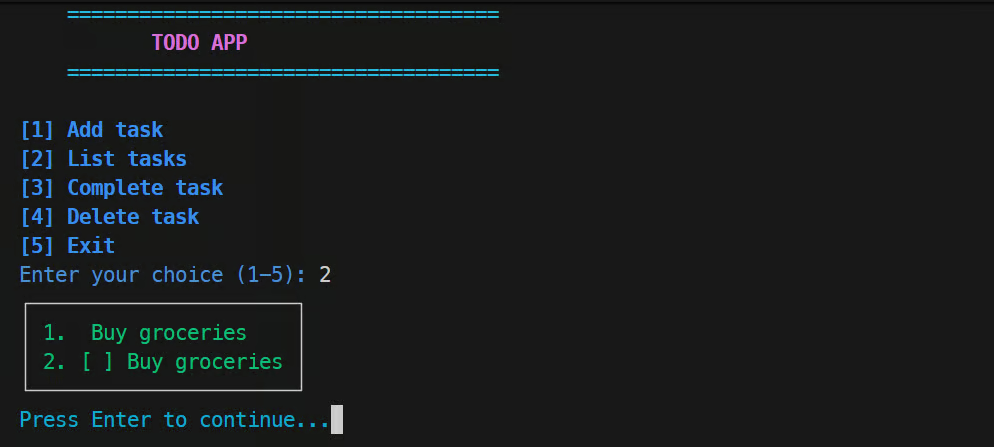
फिर मैंने एजेंट से एप्लिकेशन को अधिक इंटरएक्टिव और रंगीन बनाने, लेआउट सुधारने और टर्मिनल अनुभव बेहतर करने को कहा। Motif-3 ने फिर से शुरू करने के बजाय मौजूदा प्रोजेक्ट को संशोधित किया, और सुधरा हुआ संस्करण काफी ज्यादा परिष्कृत था।
अंत में, मैं देखना चाहता था कि Motif-3 एक अधिक विजुअल वेब डेवलपमेंट टास्क पर कैसा प्रदर्शन करता है, जहाँ एक काम करने वाली वेबसाइट बनाना केवल चुनौती का एक हिस्सा है।
शुरुआती एप्लिकेशन काम कर रहा था, लेकिन कई UI विवरण मुझे पसंद नहीं आए। मॉडल को एक विशाल रीडिज़ाइन प्रॉम्प्ट देने के बजाय, मैंने उससे मुद्दों को एक-एक करके ठीक करने के लिए कहा, और परीक्षण करते हुए इंटरफ़ेस के अलग-अलग हिस्सों को बेहतर कराया।
यह आश्चर्यजनक रूप से अच्छी तरह काम किया। Motif-3 मौजूदा प्रोजेक्ट का निरीक्षण करने, लक्षित बदलाव करने और एप्लिकेशन को कार्यात्मक रखते हुए UI को बार-बार परिष्कृत करने में सक्षम था।
कुल मिलाकर, मैं इसकी कोडिंग परफॉर्मेंस और Pi के माध्यम से मौजूदा प्रोजेक्ट पर इटरेट करने की क्षमता से प्रभावित हुआ।
कुल मिलाकर, मेरा अनुभव थोड़ा मिला-जुला रहा। Motif-3 प्रभावशाली है, लेकिन अधिकांश लोगों के लिए चलाने हेतु इससे बेहतर और कम मेमोरी-हेवी मॉडल मौजूद हैं।
मिश्रित क्वांटाइज़ेशन के बावजूद, जो आकार को काफी घटा देता है, इसे आराम से चलाने के लिए आपको अभी भी लगभग 100GB या अधिक GPU या संयुक्त मेमोरी की आवश्यकता होगी। इस वजह से, कई छोटे मॉडल चलाना कहीं आसान है, जैसे Qwen3.8-27B और अन्य कोडिंग-केंद्रित मॉडल।
यह कहा जाए, तो यदि आप DeepSeek Flash श्रेणी के मॉडलों के करीब कुछ चाहते हैं, तो Motif-3 अब भी काफ़ी दिलचस्प है। यह H200 पर तेज़ है, कोडिंग गुणवत्ता अच्छी है, और बेहतर ट्यूनिंग से संभवतः और प्रदर्शन निकाला जा सकता है।
मुख्य समस्या मुझे Pi कोडिंग एजेंट के साथ हुई, जहाँ कभी-कभी जनरेशन रुक जाती थी या बाधित हो जाती थी। मैंने कुछ आउटपुट लिमिट्स बढ़ाईं, जिससे मदद मिली, लेकिन समस्या पूरी तरह हल नहीं हुई। यह मेरा DS4 रनटाइम का भी पहला उपयोग था, इसलिए भविष्य में शायद मैं और अनुकूलन कर सकूँ।
फिर भी, यदि आप विशेष रूप से किसी कोरियाई-डेवलप्ड मॉडल की तलाश में हैं, या चीनी-डेवलप्ड मॉडलों का विकल्प चाहते हैं, तो यह फिलहाल अधिक दिलचस्प विकल्पों में से एक है। यह भी अच्छा है कि अधिक देश अपने स्वयं के AI मॉडल और इकोसिस्टम बना रहे हैं, बजाय केवल कुछ बड़े प्रदाताओं पर निर्भर रहने के।
DataCamp के साथ AI सीखें!
Track
Track
course