Tracks
開発者向けアソシエイトAIエンジニア
26時間
Motif-3 は大規模な Mixture-of-Experts(MoE) モデルで、Motif Technologies によって開発されました。総パラメータは 314B で、1トークンあたり 13.2B のパラメータのみがアクティブになります。
384 のルーティングエキスパート、256K のコンテキストウィンドウを備え、コード・数学・STEM・多言語データなど約 12.5 兆トークンで学習されています。
推論、コーディング、エージェントタスクに特に適しています。Artificial Analysis Intelligence Index ではスコア 47 を記録しており、Qwen3.8-27B と、同様のセットアップで検証した MiniMax-M3 の中間に位置します。
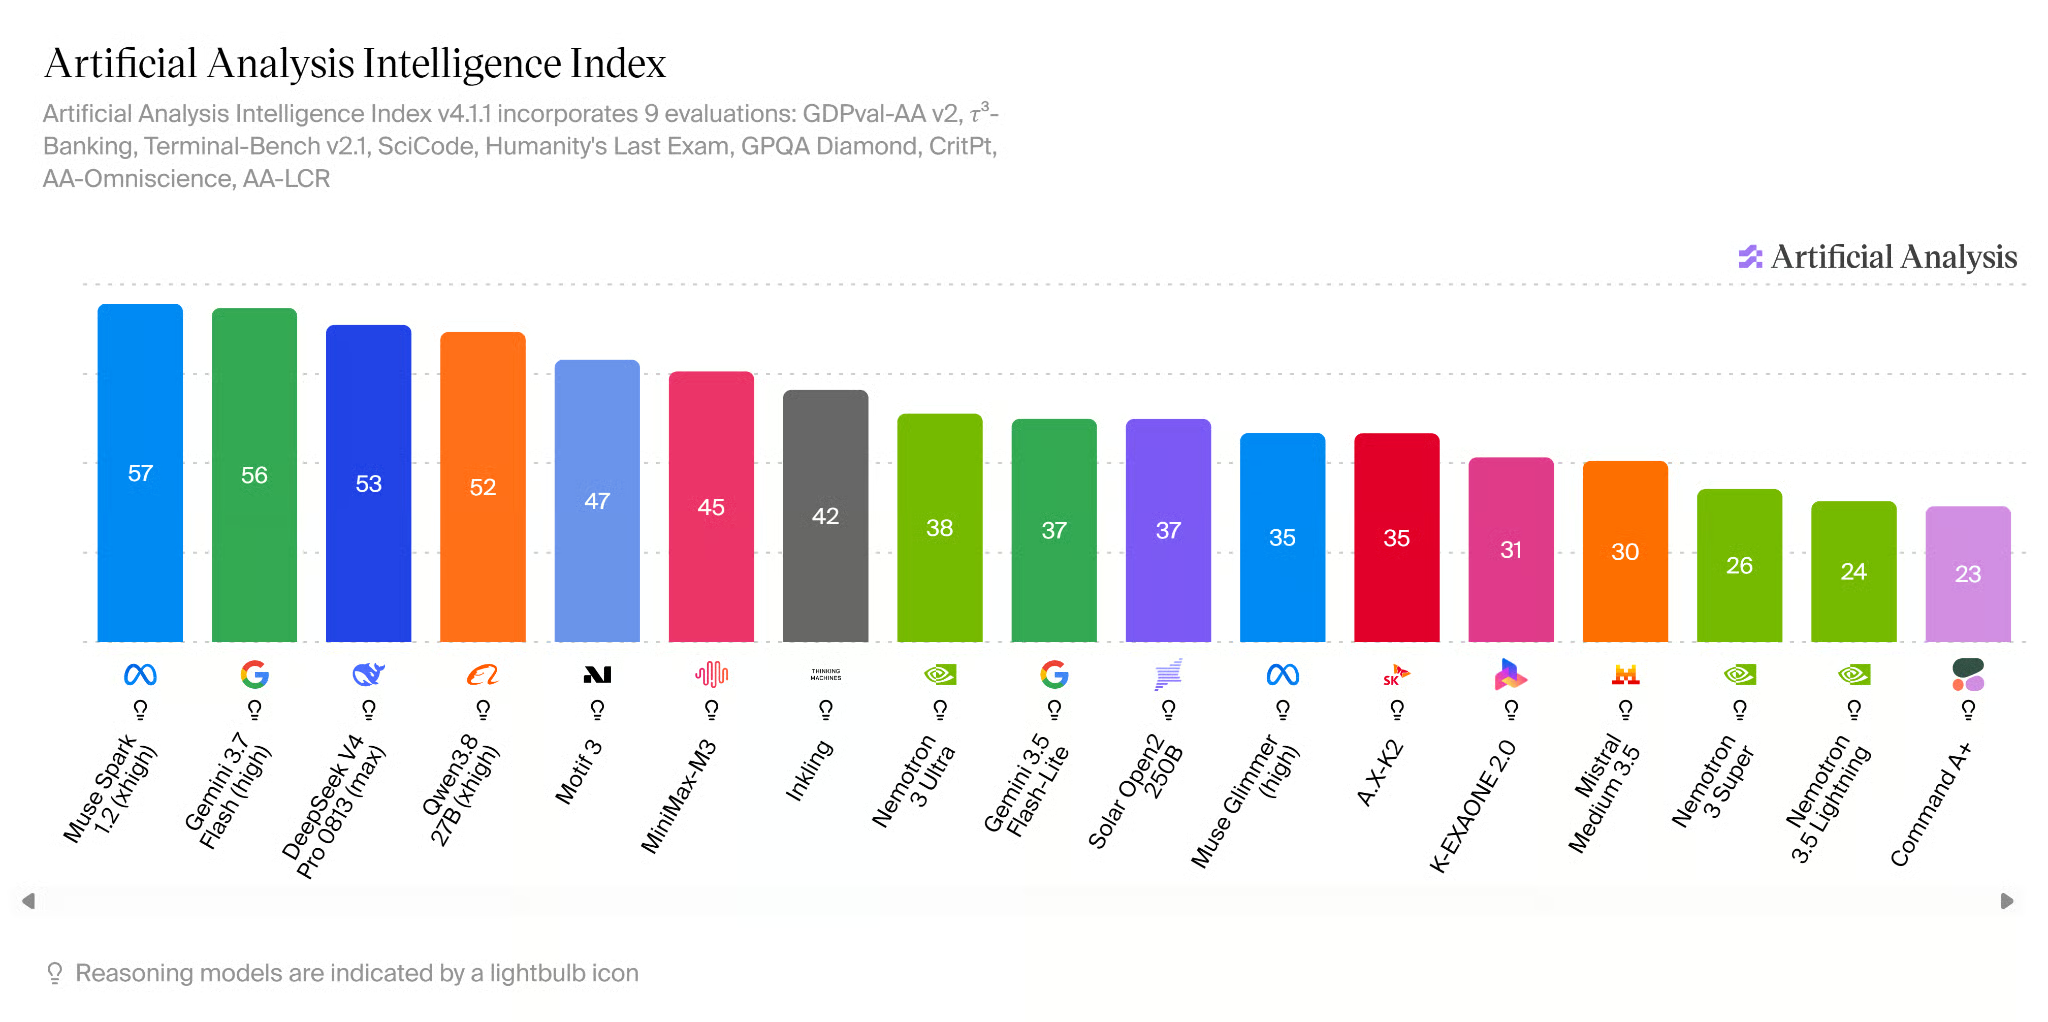
出典:AI Model & API Providers Analysis | Artificial Analysis
本ガイドでは、Baekpica/Motif-3-Mixed-Quant-GGUF という、Motif-3 の独立制作による量子化版を使用します。モデル全体で単一の精度を用いるのではなく、混合量子化を採用し、重要なコンポーネントには高精度を、巨大なエキスパート層にはより低い精度を適用します。
たとえば、重要なアテンションや常時アクティブなコンポーネントは Q8_0 を使用し、一方で多くのルーティングエキスパートの重みは IQ2_XXS や Q2_K を使用します。384 のエキスパートと 53 層はすべて保持され、刈り込みや削除はありません。これによりモデルは約 94GB に縮小され、Q8_0 GGUF の約 335GB と比べて小さくなり、141GB の H200 上でランタイムや KV キャッシュ用の VRAM を残したまま完全に実行可能になります。
背景知識として、LLM の量子化とGGUF 形式に関するガイドも参照してください。
Motif-3 Mixed Quant は約 94GB のため、モデルをロードし推論用の余裕も確保できる十分な VRAM を備えた GPU が必要です。Hyperbolic、RunPod、Vast.ai などの GPU クラウドから、141GB VRAM の単体 NVIDIA H200 を借りることを推奨します。
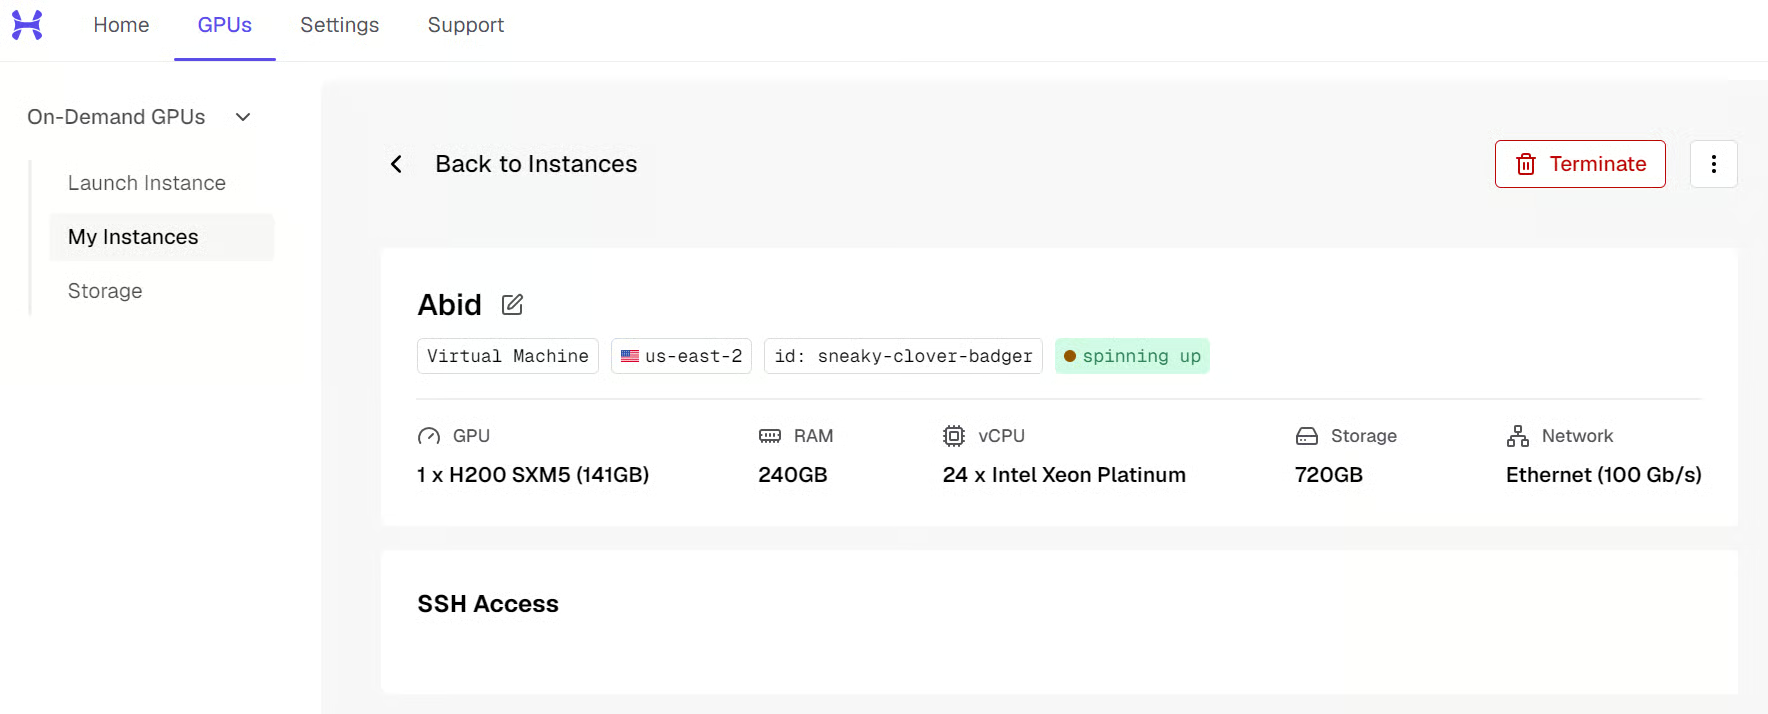
インスタンスが起動したら、ターミナルまたはVS Code Remote SSH で接続します。プロバイダーから IP アドレスが提供されます。コマンド例は次のようになります。
ssh root@<SERVER_IP> -L 8080:localhost:8080オプション -L 8080:localhost:8080 は、Motif-3 の API ポートもローカル PC に転送するため、後で http://127.0.0.1:8080 からアクセスできます。
続いてサーバーを準備します。
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
最後に、H200 が利用可能か確認します。
nvidia-smi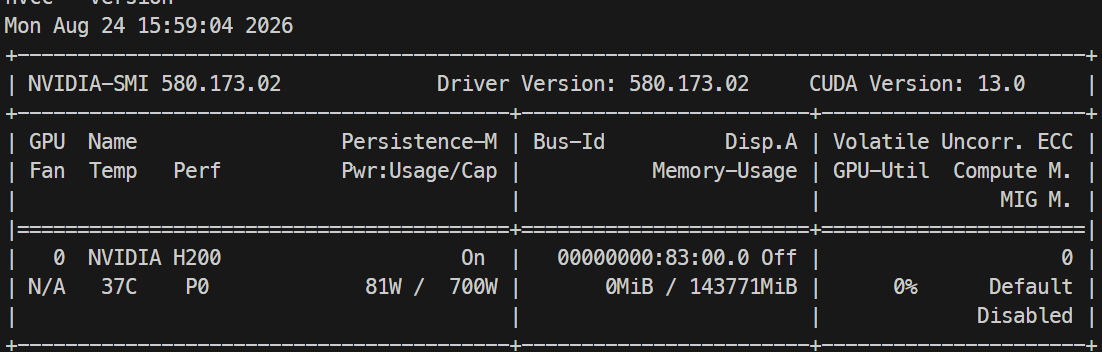
NVIDIA H200 と、およそ 141GB の VRAM が表示されるはずです。
次に、Hugging Face から Baekpica/Motif-3-Mixed-Quant-GGUF モデルをダウンロードします。ここでは MQ87-88-FIT 版を使用します。これは 11 個の GGUF ファイルに分割され、合計で約 94GB です。
/workspace/motif3 ディレクトリで次を実行します。
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model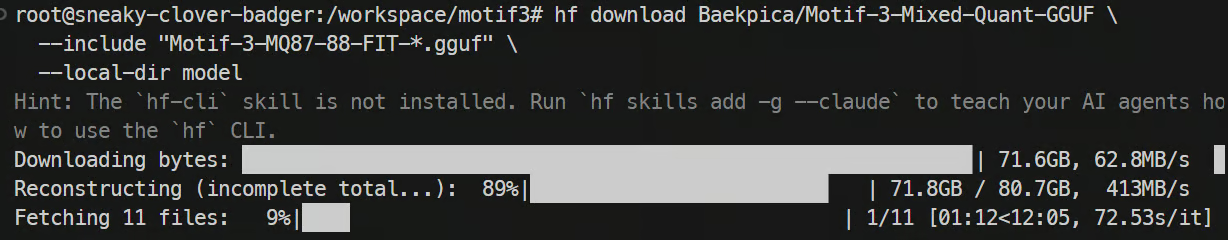
回線速度によっては 94GB 全体のダウンロードに時間がかかります。完了したら、すべての分割ファイルがそろっているか確認します。
ls -lh modelマージ前に分割ファイルを検証します。94GB のワンショット作業なので、ここで不完全なダウンロードを見つけておく価値があります。
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..ds4 ランタイムは単一の GGUF ファイルとしてモデルを想定しているため、ダウンロードした 11 個の分割ファイルをまずマージする必要があります。
llama.cpp をクローンし、GGUF ユーティリティをビルドします。
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
続いて、11 個すべてを 1 ファイルにマージします。
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
マージ後のモデルを確認します。
ls -lh motif3.gguf大きな motif3.gguf ファイルが表示されるはずです。
NVIDIA H200 上で Motif-3 を効率的にロード・提供するには、ds4 ランタイムが必要です。
dfm ブランチをクローンします。
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4H200(Hopper、sm_90)向けに CUDA サポート付きでコンパイルします。ds4 の主対象は DGX Spark/GB10 であり、H200 対応はメインの提供経路ではなく持ち上げ作業に由来する点に注意してください。
make cuda CUDA_ARCH=sm_90 -j$(nproc)バイナリが正常に作成されたか確認します。
ls -lh ds4*ds4-server や ds4_weight_server などのバイナリが表示されるはずです。
Weight サーバーは、API サーバーが推論で使用できるよう、モデルの重みを GPU 上にロード・管理します。
まず、ランタイムファイルと KV キャッシュ用のディレクトリを作成します。
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
フルロードを実行する前に、事前チェックで収まりそうか確認します。
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
--dry-run問題なければ、--dry-run を外して同じコマンドを実行します。
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned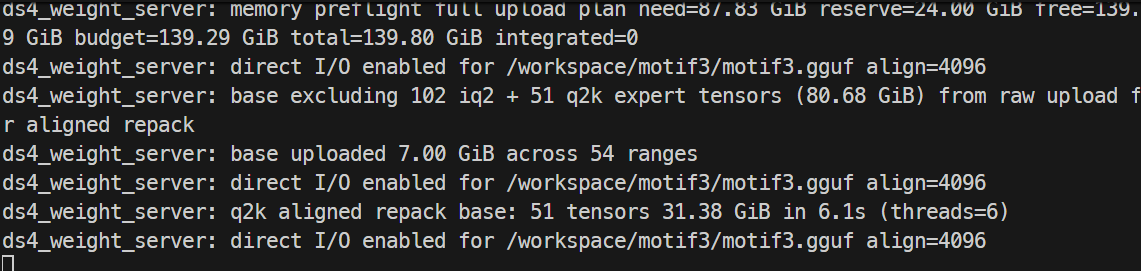
このターミナルは開いたままにしておきます。Motif-3 を実行している間、Weight サーバーは稼働状態を維持する必要があります。
次に ds4 の API サーバーを起動します。これにより、ローカル PC からアクセスできる OpenAI 互換のエンドポイントとして Motif-3 が公開されます。
別のターミナルを開いてサーバーに接続し、ds4 ディレクトリに移動します。
cd /workspace/motif3/ds4必要な環境変数を設定します。
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
125K のコンテキストウィンドウで API サーバーを起動します。H200 上ではランタイムは 128K まで検証済みで、256K は部分的なプリフィルに留まるため、125K は検証済みの範囲内です。
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768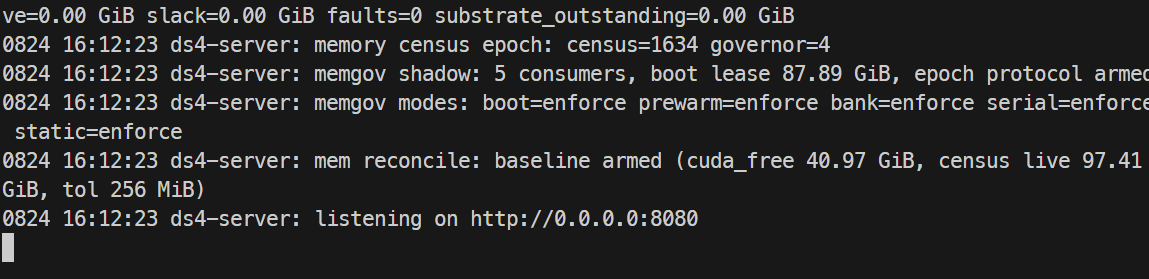
このターミナルは開いたままにしておきます。
先ほど SSH で 8080 をポート転送したため、ローカル PC 上のターミナルから次で API を確認できます。
curl http://127.0.0.1:8080/v1/models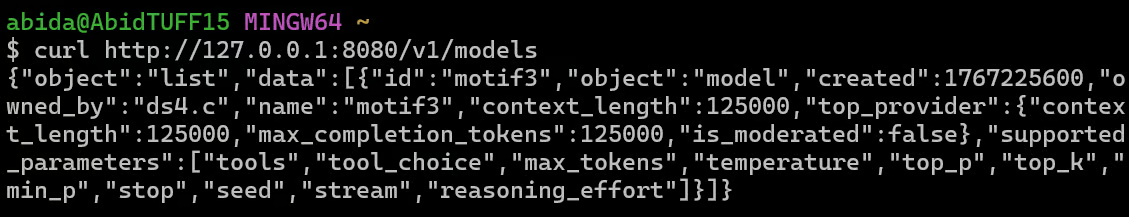
motif-3 が、コンテキスト長 125000 のモデルとして表示されるはずです。
では、最初のプロンプトを送ってみます。
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'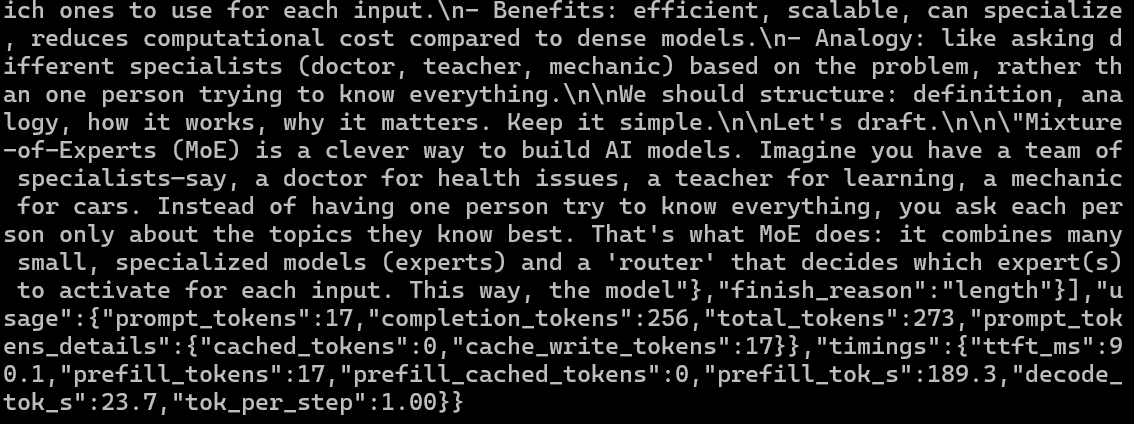
正常に動作していれば、Motif-3 が H200 から直接レスポンスを生成します。テストでは以下のメトリクスを記録しました。
サーバー側で GPU メモリの使用状況も確認できます。
nvidia-smi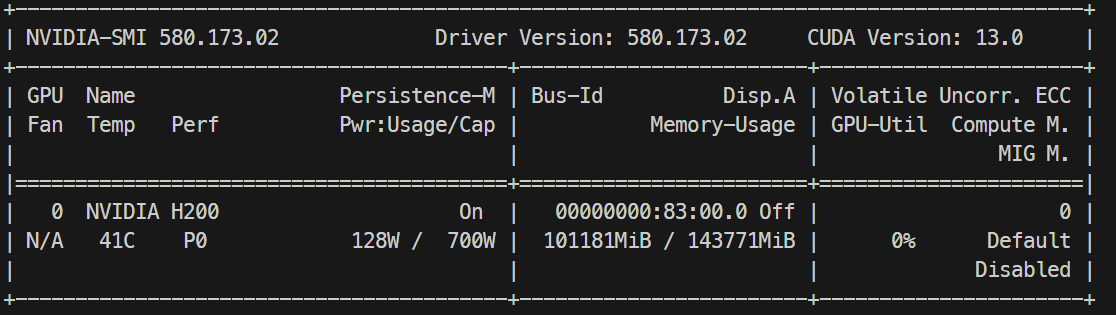
本環境では、H200 の 141GB のうち約 101GB を Motif-3 が使用し、推論や KV キャッシュ用に追加の VRAM が残りました。
ローカルの Motif-3 API を Pi に接続し、ファイル作成・コマンド実行・プロジェクトの反復改善ができるコーディングエージェントとして動作させます。
Motif-3 が次で利用可能であることを確認します。
http://127.0.0.1:8080/v1公式インストーラーで Pi をインストールします。
curl -fsSL https://pi.dev/install.sh | shターミナルを再起動し、インストールを確認します。
pi --versionPi は ~/.pi/agent/models.json を通じて OpenAI 互換のカスタムモデルをサポートします。設定ファイルを作成します。
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOF実際のコーディング課題を与え、アプリケーションを自律的に構築・実行・改善できるかを確認します。
テスト用プロジェクトを作成し、Pi を起動します。
mkdir -p ~/motif-test
cd ~/motif-test
pi
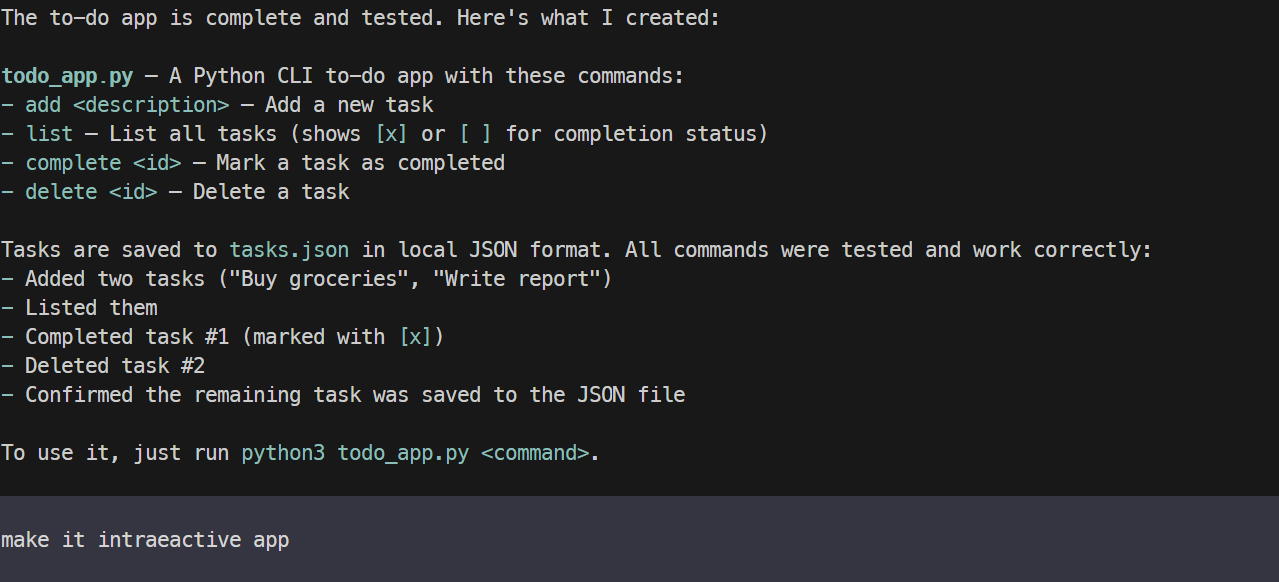
モデルをテストしましょう。まずはシンプルな ToDo アプリの作成を依頼します。
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.数分以内に、Motif-3 は動作する CLI アプリケーションを作成し、テストまで完了しました。機能は良好でしたが、初期のインターフェースはとても素朴でした。
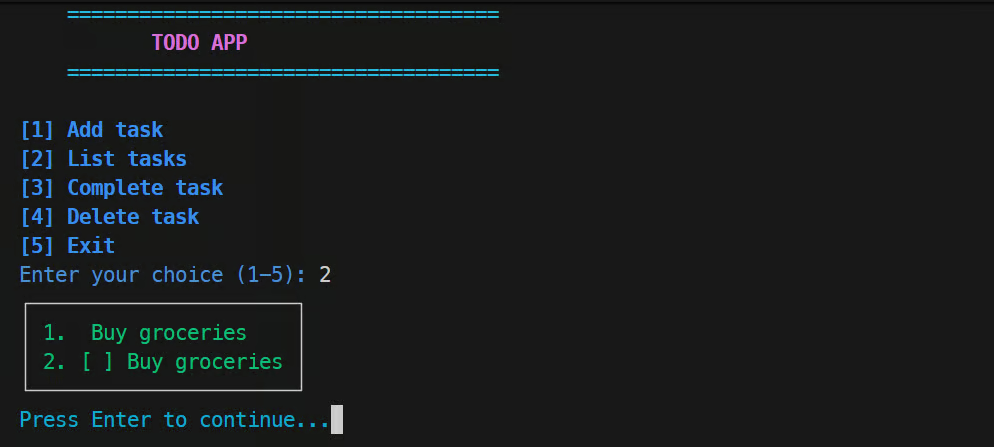
そこで、よりインタラクティブでカラフルにし、レイアウトとターミナルの体験を改善するよう依頼しました。Motif-3 は一から作り直すのではなく既存プロジェクトを改良し、仕上がりは格段に洗練されました。
最後に、よりビジュアルなウェブ開発タスクでの性能も見てみました。動くウェブサイトを生成するだけが課題ではないケースです。
初期バージョンは動作しましたが、UI には好ましくない点がいくつかありました。大きなリデザインの指示を 1 回で与えるのではなく、テストしながら気になる点を一つずつ修正するよう依頼しました。
これは驚くほどうまくいきました。Motif-3 は既存プロジェクトを調べ、狙いを定めた変更を加え、アプリの機能性を保ちながら UI を繰り返し洗練できました。
総じて、コーディング性能と、Pi を通じて既存プロジェクトを反復改善できる点の双方に感心しました。
全体として、体験はやや入り混じった印象でした。Motif-3 は見事ですが、多くの人にとっては、より優れた・省メモリなモデルを実行する選択肢もあります。
サイズを大きく削減する混合量子化を用いても、快適に動かすには 100GB 前後以上の GPU または合算メモリが必要です。そのため、Qwen3.8-27B や他のコーディング特化モデルなど、はるかに扱いやすい小型モデルが数多く存在します。
とはいえ、DeepSeek Flash クラスに近いモデルを求めるなら、Motif-3 は依然として非常に興味深い選択肢です。H200 上で高速に動作し、コーディング品質も良好で、チューニング次第ではさらに性能を引き出せる余地もあるでしょう。
主な課題は Pi のコーディングエージェントで、生成が時々停止または中断される点でした。出力上限をいくつか引き上げたことで改善しましたが、完全には解決しませんでした。DS4 ランタイムの使用も今回が初めてなので、今後さらに最適化できる余地はあるはずです。
それでも、韓国発のモデルを探している場合や、中国発モデルの代替を求めている場合には、現時点で特に興味深い選択肢の一つです。少数の大手プロバイダーに依存せず、各国が自前の AI モデルとエコシステムを構築しているのを見るのも嬉しいことです。
DataCamp で AI を学ぼう!
Tracks
Tracks
Courses