
Programma
Ingegnere AI associato per sviluppatori
26 h
Motif-3 è un modello su larga scala Mixture-of-Experts (MoE) di Motif Technologies, costruito con 314 miliardi di parametri totali attivandone solo 13,2 miliardi per token.
Dispone di 384 expert instradati, una finestra di contesto da 256.000 token ed è stato addestrato su circa 12,5 trilioni di token che coprono codice, matematica, STEM, dati multilingue e altri domini.
È particolarmente adatto a carichi di lavoro di ragionamento, coding e agenti. Sull'Artificial Analysis Intelligence Index, raggiunge un punteggio di 47, che lo colloca tra Qwen3.8-27B e MiniMax-M3, che abbiamo testato in una configurazione simile.
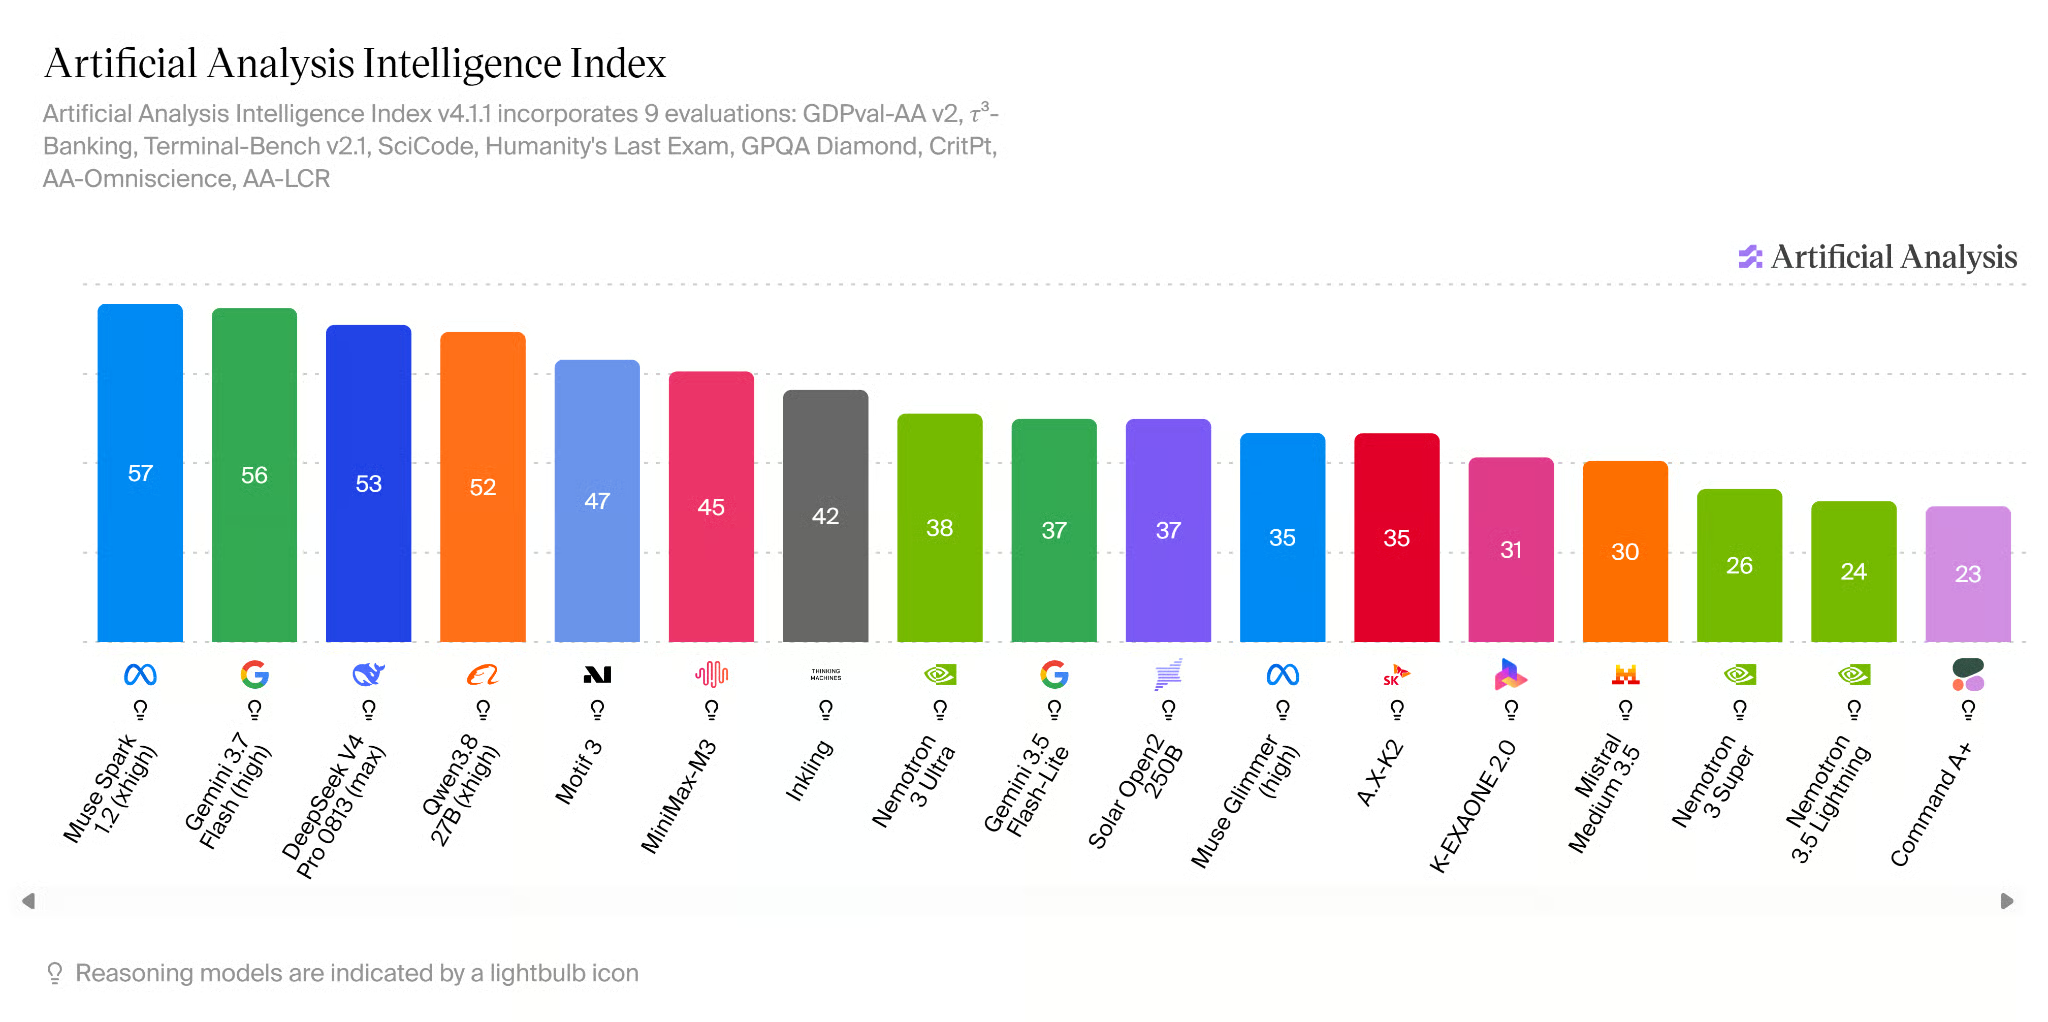
Fonte: AI Model & API Providers Analysis | Artificial Analysis
Per questa guida, usiamo Baekpica/Motif-3-Mixed-Quant-GGUF, una versione quantizzata di Motif-3 creata indipendentemente. Invece di usare un solo livello di precisione per l'intero modello, applica una quantizzazione mista, assegnando maggiore precisione ai componenti importanti e precisione molto più bassa agli enormi layer degli expert.
Ad esempio, componenti di attenzione e sempre attivi usano Q8_0, mentre gran parte dei pesi degli expert instradati usa IQ2_XXS e Q2_K. Il modello mantiene comunque tutti i 384 expert e tutti i 53 layer, quindi nulla è potato o rimosso. Questo riduce il modello a circa 94 GB, rispetto a circa 335 GB per il GGUF Q8_0, rendendolo abbastanza piccolo da essere eseguito interamente su un'H200 da 141 GB con VRAM aggiuntiva disponibile per runtime e KV cache.
Per maggiori informazioni di base, ti consiglio di leggere le nostre guide sulla quantizzazione per LLM e sul formato GGUF.
Motif-3 Mixed Quant è intorno ai 94 GB, quindi ti servirà una GPU con abbastanza VRAM per caricare il modello e lasciare spazio per l'inferenza. Ti consiglio di noleggiare una singola NVIDIA H200 con 141 GB di VRAM da un provider cloud GPU come Hyperbolic, RunPod o Vast.ai.
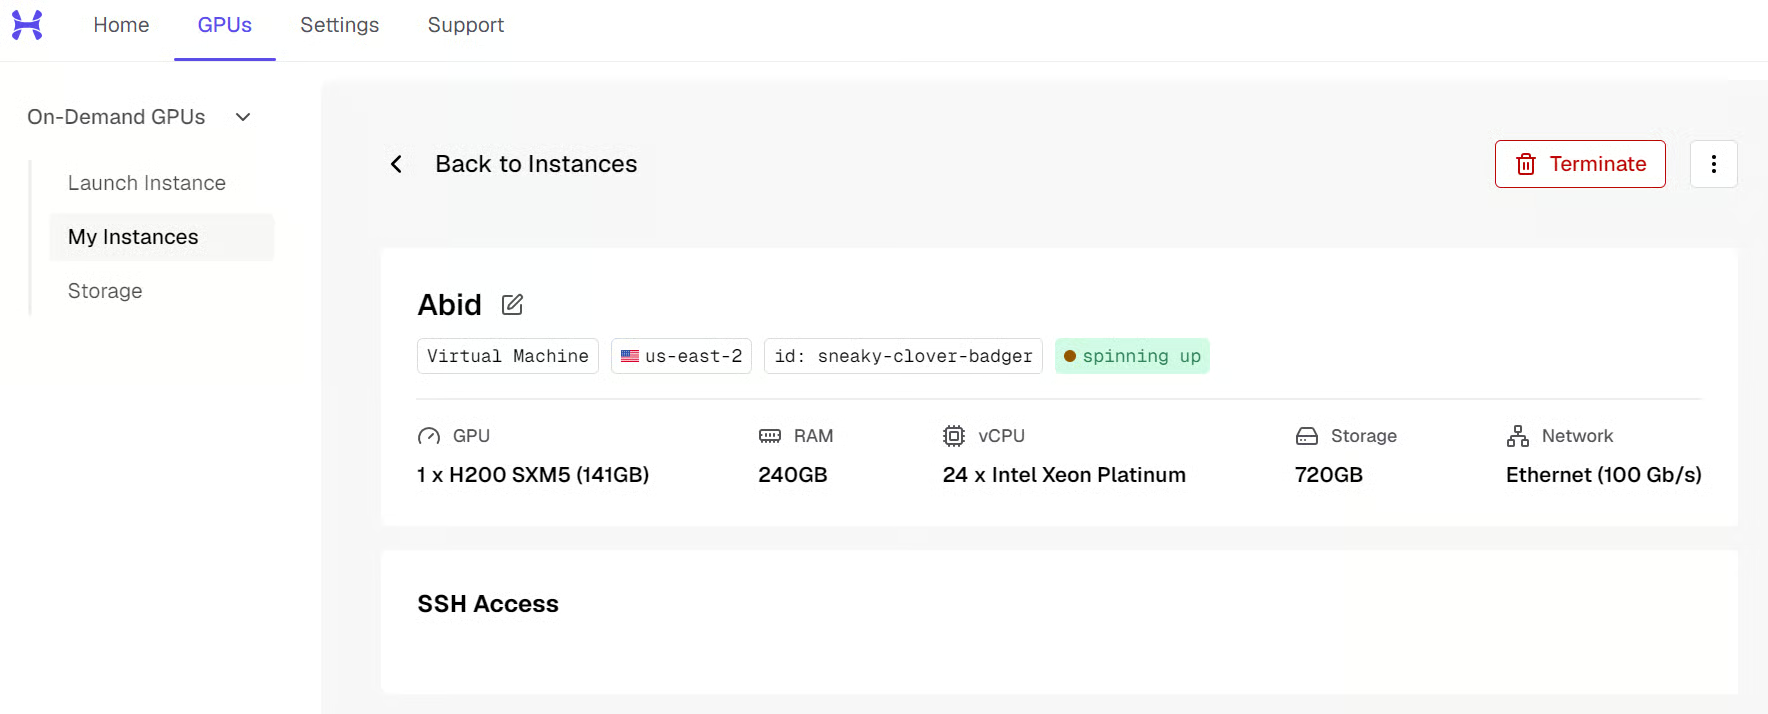
Quando l'istanza è attiva, connettiti dal tuo terminale o tramite VS Code Remote SSH. Il provider ti fornirà l'indirizzo IP. Il comando sarà simile a:
ssh root@<SERVER_IP> -L 8080:localhost:8080L'opzione -L 8080:localhost:8080 inoltra anche la porta dell'API di Motif-3 al tuo PC locale, così più tardi potrai accedervi su http://127.0.0.1:8080.
Ora prepara il server:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Infine, verifica che l'H200 sia disponibile:
nvidia-smi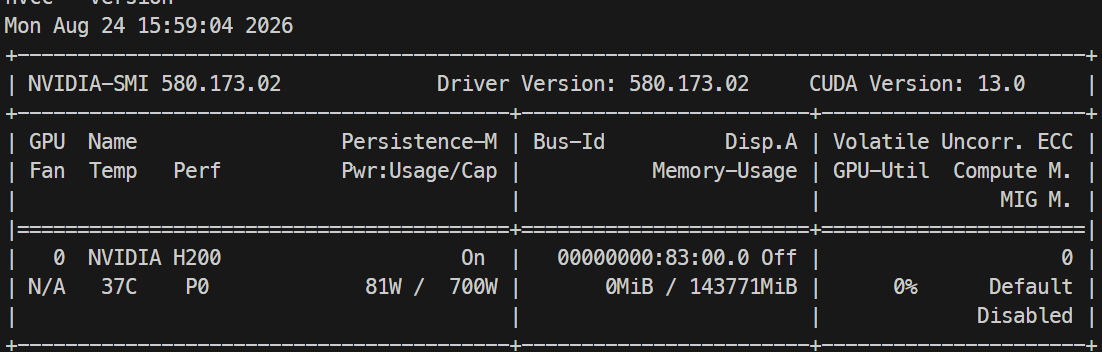
Dovresti vedere una NVIDIA H200 con circa 141 GB di VRAM.
Ora scarica il modello Baekpica/Motif-3-Mixed-Quant-GGUF da Hugging Face. Usiamo la variante MQ87-88-FIT, suddivisa in 11 file GGUF per una dimensione complessiva di circa 94 GB.
Dalla directory /workspace/motif3, esegui:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model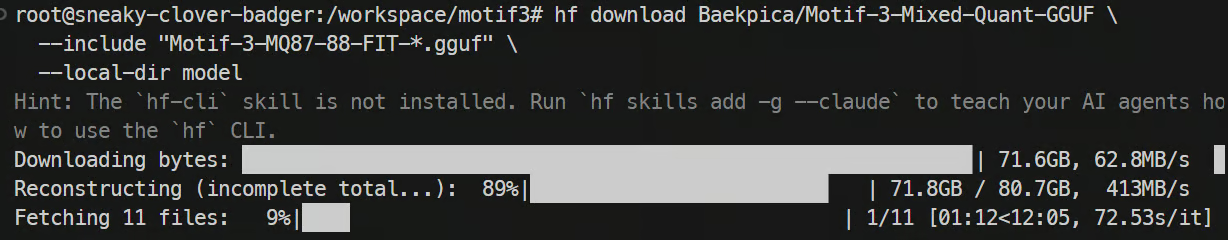
In base alla tua connessione, scaricare tutti i 94 GB potrebbe richiedere tempo. Al termine, verifica che tutti gli shard siano disponibili:
ls -lh modelPrima di unire, verifica gli shard. Il merge è un'operazione unica su 94 GB, quindi vale la pena intercettare ora un download corrotto:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Il runtime ds4 si aspetta il modello come un singolo file GGUF, quindi prima dobbiamo unire gli 11 shard scaricati.
Clona llama.cpp e compila la sua utility GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Ora unisci tutti gli 11 shard in un unico file:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Controlla il modello unito:
ls -lh motif3.ggufDovresti vedere un grande file motif3.gguf.
Ci serve il runtime ds4 per caricare e servire Motif-3 in modo efficiente su NVIDIA H200.
Clona il branch dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Compilalo con supporto CUDA per l'H200 (Hopper, sm_90). Nota che il target principale di ds4 è il DGX Spark/GB10, e il supporto H200 deriva dal lavoro di bring-up del progetto piuttosto che dal suo percorso di serving principale:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Verifica che i binari siano stati creati correttamente:
ls -lh ds4*Dovresti vedere binari come ds4-server e ds4_weight_server.
Il weight server carica e gestisce i pesi del modello sulla GPU così che il server API possa usarli per l'inferenza.
Per prima cosa, crea le directory per i file di runtime e la KV cache:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Esegui prima il preflight per controllare che il modello entri in memoria prima di impegnarti in un caricamento completo:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Se tutto va a buon fine, esegui di nuovo lo stesso comando senza --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned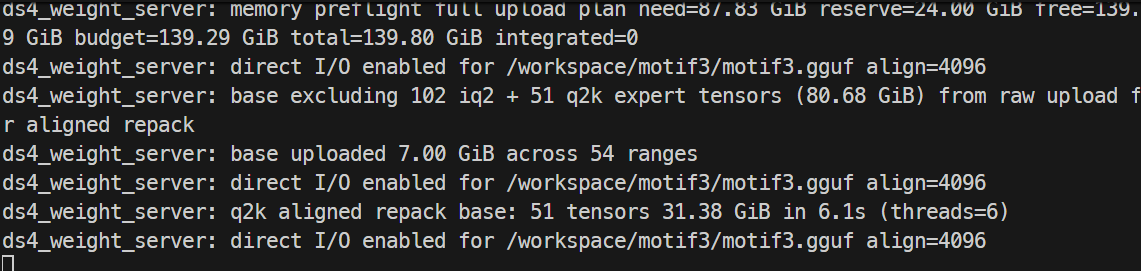
Mantieni questo terminale in esecuzione. Il weight server deve rimanere attivo mentre esegui Motif-3.
Ora avvieremo il server API ds4, che espone Motif-3 tramite un endpoint compatibile con OpenAI a cui puoi accedere dal tuo computer locale.
Apri un altro terminale e connettiti al server, quindi entra nella directory ds4:
cd /workspace/motif3/ds4Imposta le variabili d'ambiente richieste:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Avvia il server API con una finestra di contesto da 125K. Su H200, il runtime è validato fino a 128K, con 256K che raggiunge solo un prefill parziale, quindi 125K rientra appena entro ciò che è stato testato:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768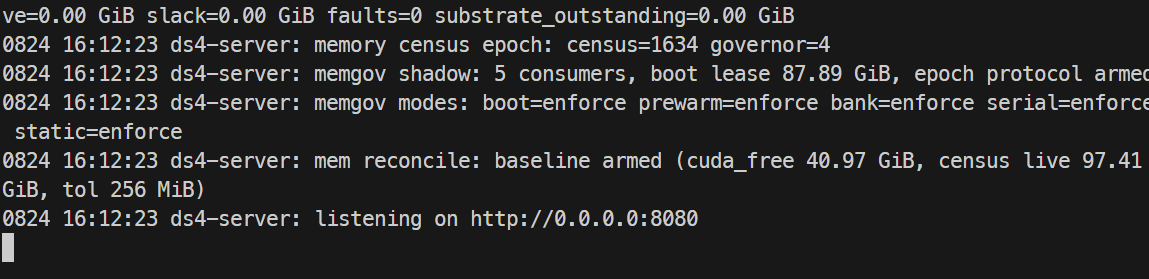
Mantieni questo terminale in esecuzione.
Poiché prima abbiamo inoltrato la porta 8080 via SSH, ora puoi aprire un terminale sul tuo PC locale e verificare l'API:
curl http://127.0.0.1:8080/v1/models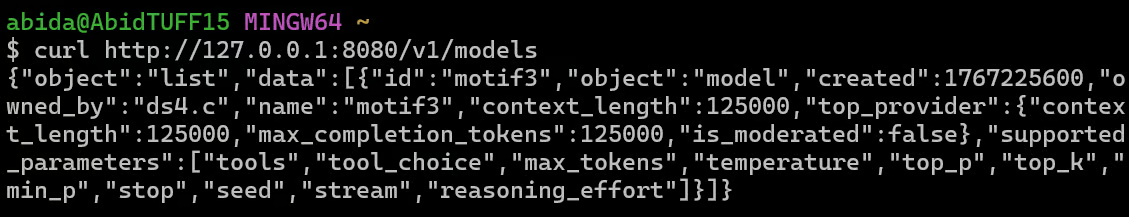
Dovresti vedere motif-3 elencato come modello con una lunghezza del contesto di 125000.
Ora invia il tuo primo prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'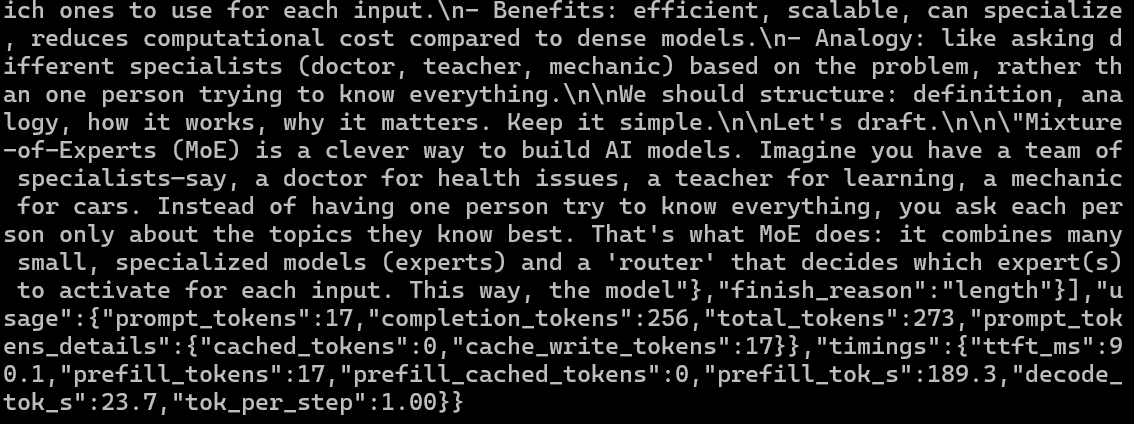
Se tutto funziona, Motif-3 genererà una risposta direttamente dalla tua H200. Nel mio test, il modello ha raggiunto queste metriche:
Puoi anche controllare l'uso della memoria GPU sul server:
nvidia-smi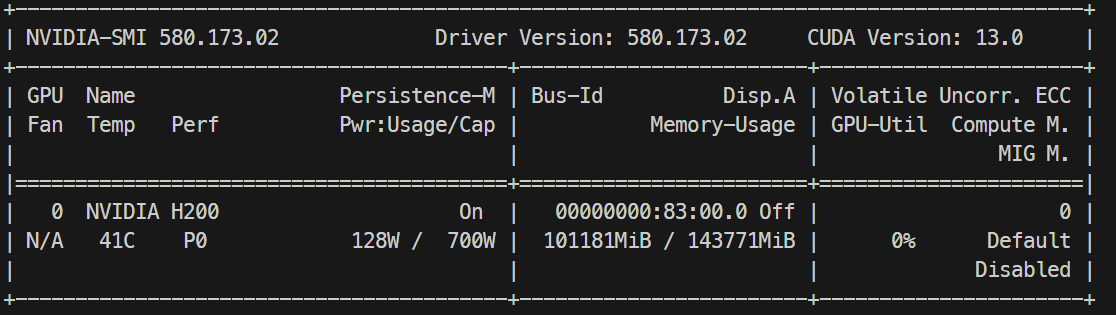
Nella mia configurazione, Motif-3 ha utilizzato circa 101 GB dei 141 GB di memoria GPU riportati dall'H200, lasciando VRAM aggiuntiva disponibile per l'inferenza e la KV cache.
Ora connetteremo l'API locale di Motif-3 a Pi, permettendo al modello di funzionare come agente di coding in grado di creare file, eseguire comandi e iterare su un progetto.
Assicurati che Motif-3 sia ancora disponibile su:
http://127.0.0.1:8080/v1Installa Pi usando l'installer ufficiale:
curl -fsSL https://pi.dev/install.sh | shRiavvia il terminale, quindi conferma l'installazione:
pi --versionPi supporta modelli personalizzati compatibili con OpenAI tramite ~/.pi/agent/models.json. Crea la configurazione:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFOra possiamo assegnare a Motif-3 un vero compito di coding e vedere se riesce a creare, eseguire e migliorare un'applicazione in modo autonomo.
Crea un progetto di test e avvia Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
Mettiamo alla prova il modello. Per iniziare, gli chiederemo di creare una semplice app to-do.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.Nel giro di pochi minuti, Motif-3 ha creato un'applicazione CLI funzionante e l'ha testata con successo. La funzionalità era buona, ma l'interfaccia iniziale era molto basilare.
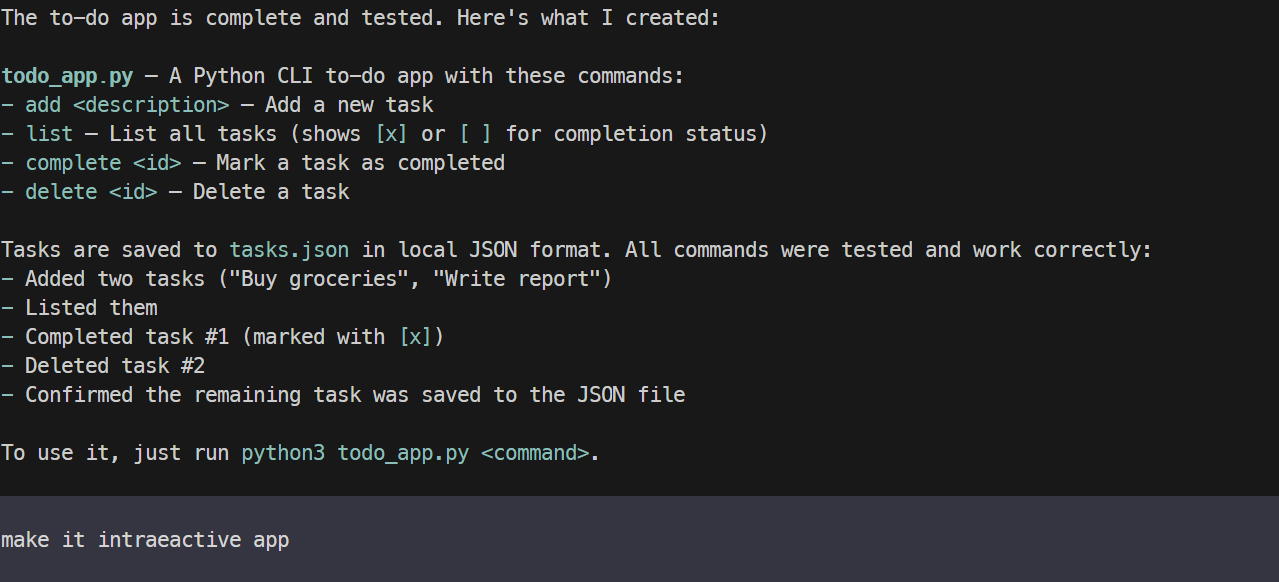
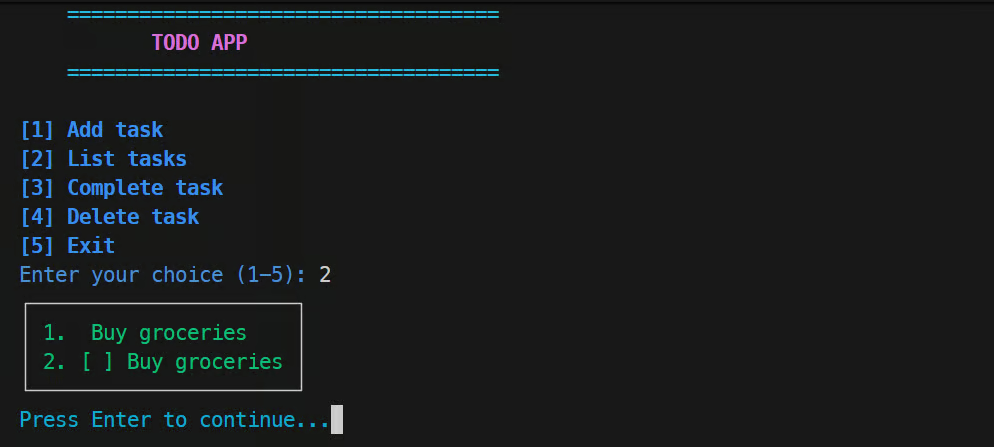
Ho poi chiesto all'agente di rendere l'applicazione più interattiva e colorata, migliorare il layout e l'esperienza da terminale. Motif-3 ha modificato il progetto esistente invece di ricominciare da zero, e la versione migliorata era notevolmente più curata.
Infine, volevo vedere come si comportasse Motif-3 su un compito di sviluppo web più visivo, dove generare un sito funzionante è solo parte della sfida.
L'applicazione iniziale funzionava, ma c'erano diversi dettagli UI che non mi piacevano. Invece di dare al modello un unico grande prompt di redesign, gli ho chiesto di correggere i problemi uno per uno, migliorando singole parti dell'interfaccia mentre le testavo.
Ha funzionato sorprendentemente bene. Motif-3 è stato in grado di ispezionare il progetto esistente, apportare modifiche mirate e perfezionare ripetutamente la UI mantenendo l'applicazione funzionale.
Nel complesso, mi ha colpito sia la qualità del coding sia la capacità di iterare su un progetto esistente tramite Pi.
Nel complesso, la mia esperienza è stata un po' mista. Motif-3 è impressionante, ma per la maggior parte delle persone esistono modelli migliori e meno onerosi in termini di memoria da eseguire.
Anche con la quantizzazione mista, che riduce molto la dimensione, servono comunque circa 100 GB o più di memoria GPU o combinata per eseguirlo comodamente. Per questo motivo, ci sono molti modelli più piccoli molto più semplici da far girare, come Qwen3.8-27B e altri modelli orientati al coding.
Detto ciò, se vuoi qualcosa di più vicino alla classe di modelli DeepSeek Flash, Motif-3 resta davvero interessante. È veloce su H200, la qualità del codice è buona e probabilmente si può ottenere ancora più performance con un tuning migliore.
Il principale problema che ho riscontrato è stato con l'agente di coding Pi, dove a volte la generazione si fermava o veniva interrotta. Ho aumentato alcuni limiti di output e questo ha aiutato, ma non ha risolto completamente il problema. È anche la mia prima volta con il runtime DS4, quindi probabilmente c'è altro che posso ottimizzare in futuro.
Detto questo, se cerchi specificamente un modello sviluppato in Corea, o vuoi un'alternativa ai modelli sviluppati in Cina, questa è una delle opzioni più interessanti al momento. È anche bello vedere più paesi costruire i propri modelli di IA e i propri ecosistemi invece di dipendere solo da pochi grandi provider.
Impara l'IA con DataCamp!
Programma
Programma
Corso