Track
Inżynier AI Associate dla programistów
26 godz.
Motif-3 to na dużą skalę Mixture‑of‑Experts (MoE) model od Motif Technologies, z łączną liczbą 314 mld parametrów, przy aktywowaniu jedynie 13,2 mld parametrów na token.
Posiada 384 routowanych ekspertów, 256K okno kontekstu i był trenowany na około 12,5 biliona tokenów obejmujących kod, matematykę, STEM, dane wielojęzyczne i inne dziedziny.
Jest szczególnie dobrze dopasowany do zadań wymagających rozumowania, kodowania i pracy agentskiej. W Artificial Analysis Intelligence Index osiąga wynik 47, co plasuje go między Qwen3.8‑27B a MiniMax‑M3, który testowaliśmy w podobnej konfiguracji.
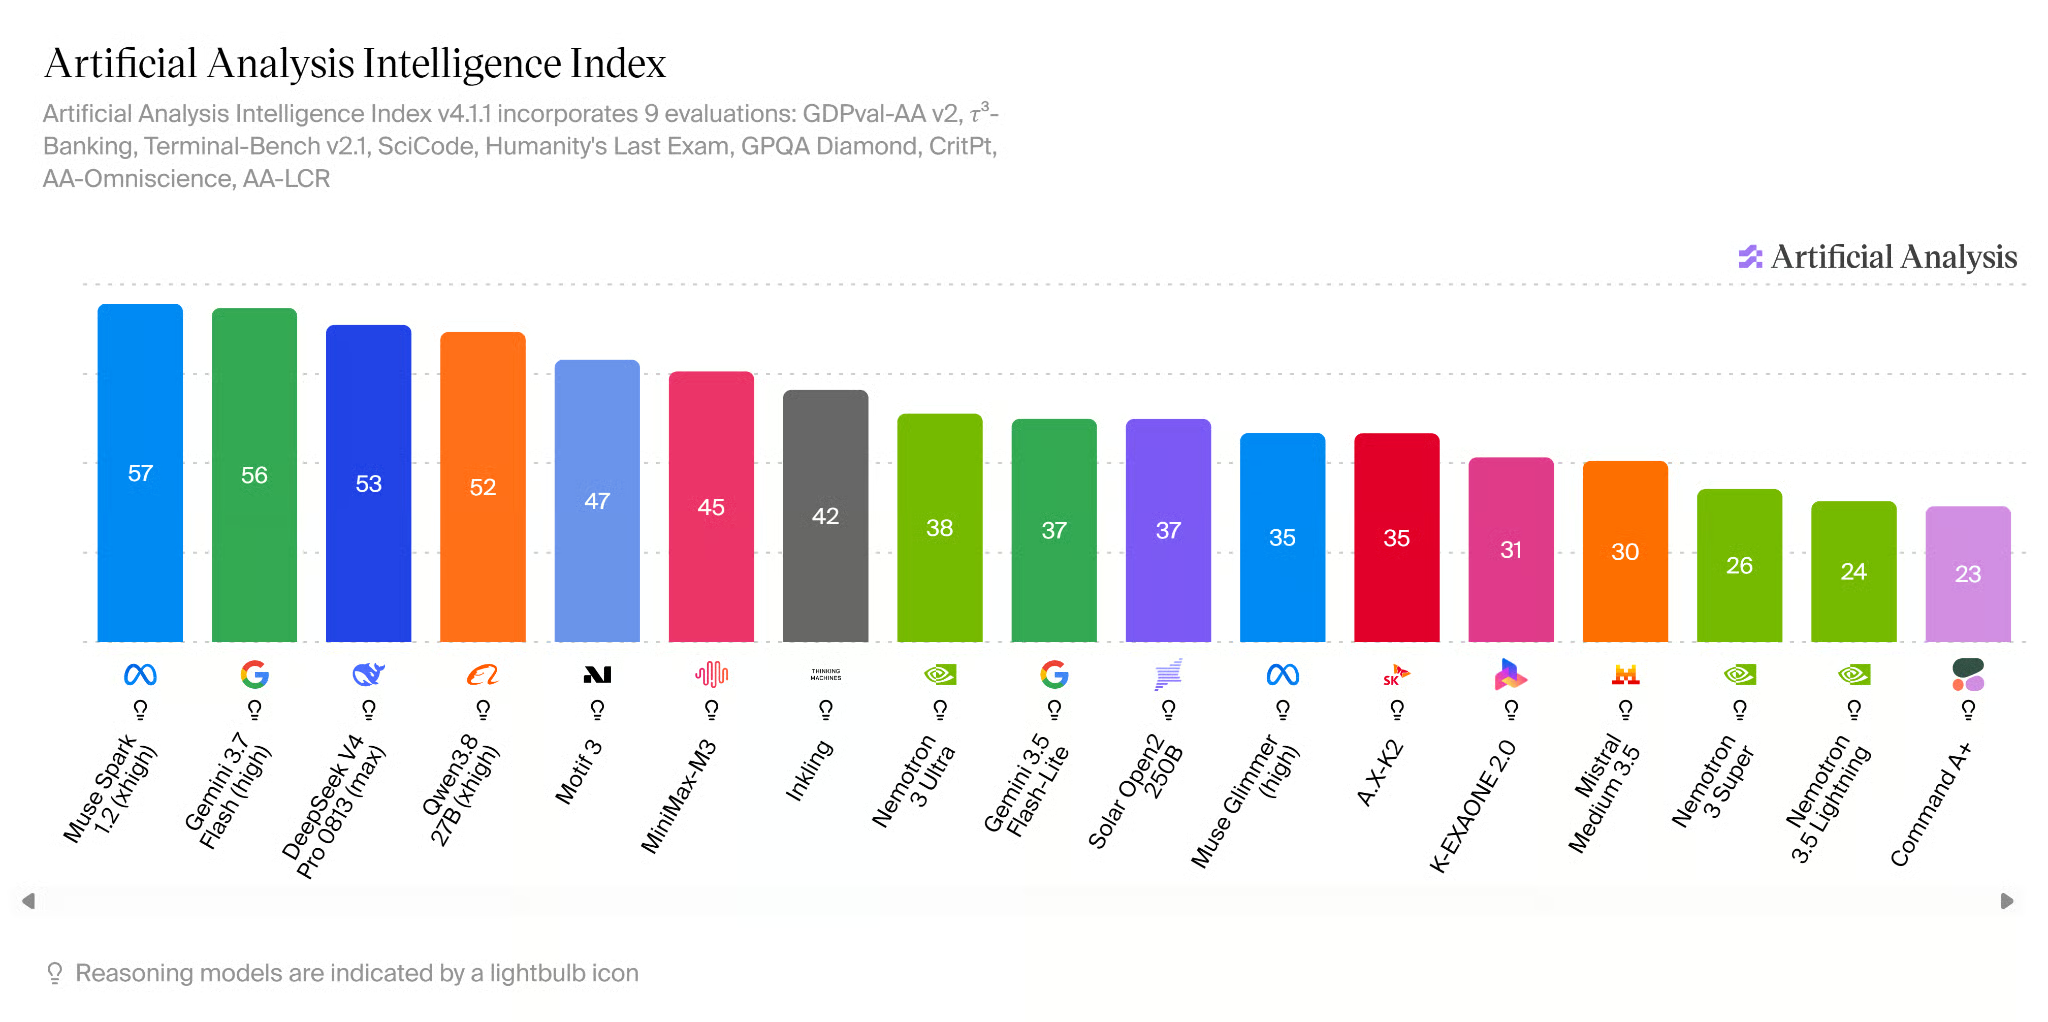
Źródło: AI Model & API Providers Analysis | Artificial Analysis
W tym przewodniku używamy Baekpica/Motif-3-Mixed-Quant-GGUF, niezależnie przygotowanej, skwantyzowanej wersji Motif-3. Zamiast używać jednego poziomu precyzji dla całego modelu, stosuje mieszaną kwantyzację, nadając wyższą precyzję ważnym komponentom, a znacznie niższą — ogromnym warstwom ekspertów.
Na przykład istotne elementy uwagi i zawsze aktywne komponenty używają Q8_0, podczas gdy wiele wag routowanych ekspertów korzysta z IQ2_XXS i Q2_K. Model wciąż zachowuje wszystkich 384 ekspertów i wszystkie 53 warstwy, więc nic nie jest przycinane ani usuwane. To zmniejsza model do około 94 GB, w porównaniu do około 335 GB dla Q8_0 GGUF, dzięki czemu jest wystarczająco mały, aby w całości działać na H200 z 141 GB, z dodatkowym VRAM na runtime i bufor KV.
Po więcej tła polecam nasze poradniki o kwantyzacji LLM‑ów i formacie GGUF.
Motif-3 Mixed Quant ma około 94 GB, więc potrzebujesz GPU z wystarczającym VRAM, aby załadować model i zostawić miejsce na inferencję. Polecam wynajęcie pojedynczej NVIDIA H200 ze 141 GB VRAM od dostawcy chmury GPU, takiego jak Hyperbolic, RunPod lub Vast.ai.
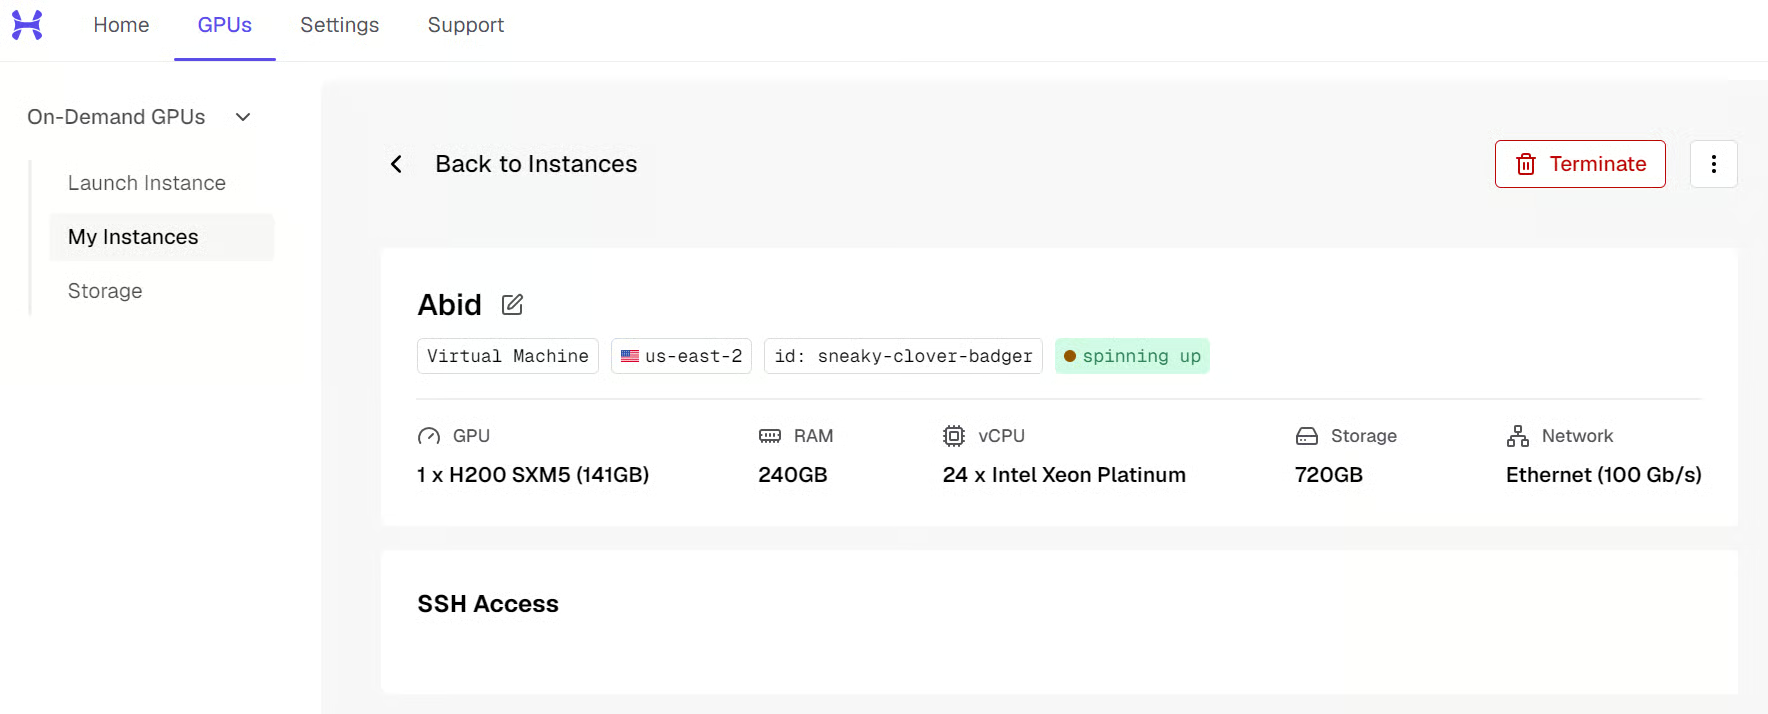
Gdy instancja działa, połącz się z nią z terminala lub przez VS Code Remote SSH. Dostawca poda adres IP. Polecenie będzie wyglądało podobnie do:
ssh root@<SERVER_IP> -L 8080:localhost:8080Opcja -L 8080:localhost:8080 przekierowuje też port API Motif-3 na twój lokalny komputer, więc później możesz uzyskać do niego dostęp pod adresem http://127.0.0.1:8080.
Teraz przygotuj serwer:
apt update
apt install -y git cmake build-essential python3-pip

pip install -U huggingface_hub

mkdir -p /workspace/motif3
cd /workspace/motif3
Na koniec sprawdź, czy H200 jest dostępny:
nvidia-smi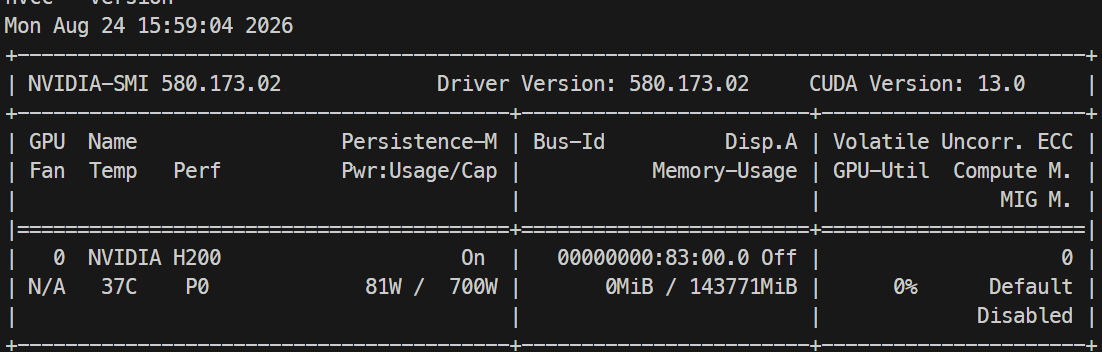
Powinieneś zobaczyć NVIDIA H200 z około 141 GB pamięci VRAM.
Następnie pobierz model Baekpica/Motif-3-Mixed-Quant-GGUF z Hugging Face. Używamy wariantu MQ87-88-FIT, który jest podzielony na 11 plików GGUF o łącznym rozmiarze około 94 GB.
Z katalogu /workspace/motif3 uruchom:
hf download Baekpica/Motif-3-Mixed-Quant-GGUF \
  --include "Motif-3-MQ87-88-FIT-*.gguf" \
  --include MQ87-88-FIT-SHA256SUMS \
  --local-dir model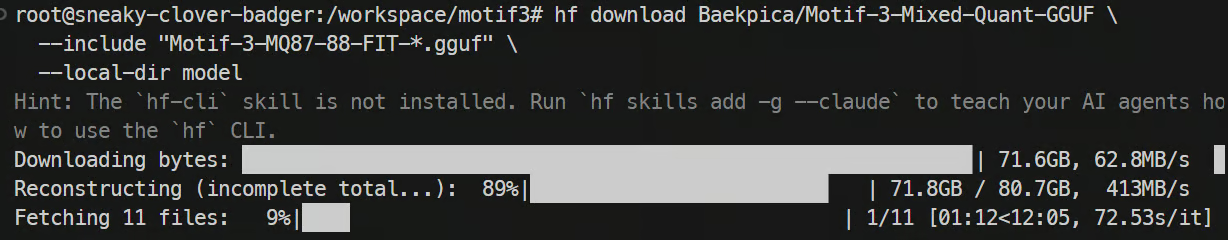
W zależności od łącza pobranie wszystkich 94 GB może chwilę potrwać. Po zakończeniu sprawdź, czy wszystkie shard’y są dostępne:
ls -lh modelPrzed scaleniem zweryfikuj shard’y. Łączenie to jednorazowa operacja na 94 GB, więc warto teraz wyłapać błędny download:
cd model && sha256sum -c MQ87-88-FIT-SHA256SUMS && cd ..Środowisko ds4 oczekuje modelu jako pojedynczego pliku GGUF, więc najpierw musimy scalić 11 pobranych shard’ów.
Sklonuj llama.cpp i zbuduj jego narzędzie GGUF:
git clone --depth 1 https://github.com/ggml-org/llama.cpp.git

cmake -S llama.cpp -B llama.cpp/build -DLLAMA_CURL=OFF

cmake --build llama.cpp/build \
  --target llama-gguf-split \
  -j$(nproc)
Teraz scal wszystkie 11 shard’ów w jeden plik:
./llama.cpp/build/bin/llama-gguf-split --merge \
  model/Motif-3-MQ87-88-FIT-00001-of-00011.gguf \
  motif3.gguf
Sprawdź scalony model:
ls -lh motif3.ggufPowinieneś zobaczyć duży plik motif3.gguf.
Potrzebujemy runtime ds4, aby efektywnie ładować i serwować Motif-3 na NVIDIA H200.
Sklonuj gałąź dfm:
git clone --branch dfm https://github.com/Baekpica/ds4.git
cd ds4
Skompiluj z obsługą CUDA dla H200 (Hopper, sm_90). Zwróć uwagę, że głównym celem ds4 jest DGX Spark/GB10, a wsparcie H200 pochodzi z prac wdrożeniowych projektu, a nie głównej ścieżki serwowania:
make cuda CUDA_ARCH=sm_90 -j$(nproc)Sprawdź, czy binaria zostały pomyślnie utworzone:
ls -lh ds4*Powinieneś zobaczyć binaria, takie jak ds4-server i ds4_weight_server.
Serwer wag ładuje i zarządza wagami modelu na GPU, aby serwer API mógł używać ich do inferencji.
Najpierw utwórz katalogi na pliki runtime i bufor KV:
mkdir -p /workspace/motif3/run
mkdir -p /workspace/motif3/kv
Uruchom preflight, aby sprawdzić, czy model się zmieści, zanim zaczniesz pełne ładowanie:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned \
  --dry-run
Jeśli to przejdzie, uruchom to samo polecenie ponownie bez --dry-run:
./ds4_weight_server \
  --base /workspace/motif3/motif3.gguf \
  --manifest /workspace/motif3/run/weights.manifest \
  --backend vmm \
  --scope base \
  --reserve-gb 24 \
  --no-repack-q8-aligned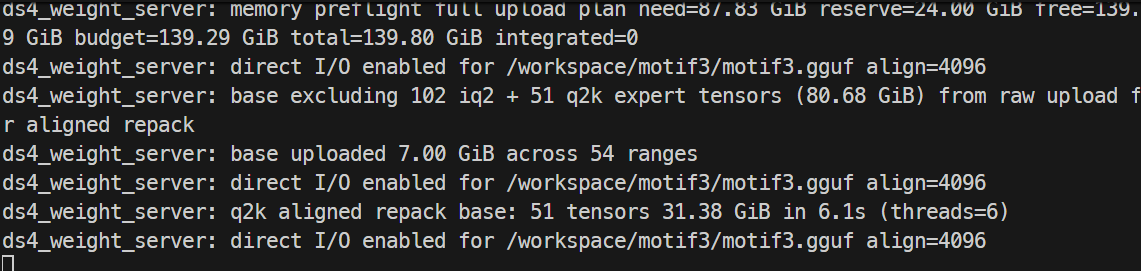
Pozostaw ten terminal uruchomiony. Serwer wag musi pozostać aktywny, gdy korzystasz z Motif-3.
Teraz uruchomimy serwer API ds4, który wystawia Motif-3 poprzez endpoint kompatybilny z OpenAI, dostępny z twojego lokalnego komputera.
Otwórz drugi terminal i połącz się z serwerem, potem przejdź do katalogu ds4:
cd /workspace/motif3/ds4Ustaw wymagane zmienne środowiskowe:
export DS4_CUDA_WEIGHT_IPC_MANIFEST=/workspace/motif3/run/weights.manifest
export DS4_CUDA_WEIGHT_IPC_SCOPE=base
export DS4_SERVER_COALESCE_MAX=2
export DS4_SERVER_COALESCE_MAX_TOKENS=4096
export DS4_MOTIF3_PREFILL_CHUNK=4096
Uruchom serwer API z oknem kontekstu 125K. Na H200 runtime jest zweryfikowany do 128K, a 256K osiąga tylko częściowy prefill, więc 125K mieści się w sprawdzonym zakresie:
./ds4-server \
  -m /workspace/motif3/motif3.gguf \
  --cuda \
  -c 125000 \
  --host 0.0.0.0 \
  --port 8080 \
  --no-spec \
  --kv-disk-dir /workspace/motif3/kv \
  --kv-disk-space-mb 32768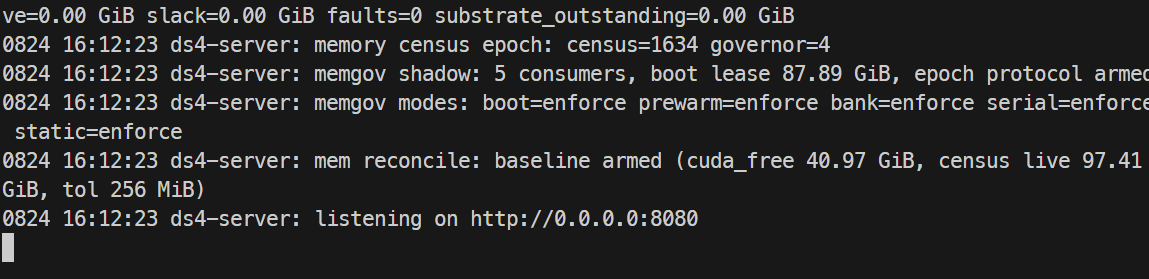
Pozostaw ten terminal uruchomiony.
Ponieważ wcześniej przekierowaliśmy port 8080 przez SSH, możesz teraz otworzyć terminal na swoim lokalnym komputerze i sprawdzić API:
curl http://127.0.0.1:8080/v1/models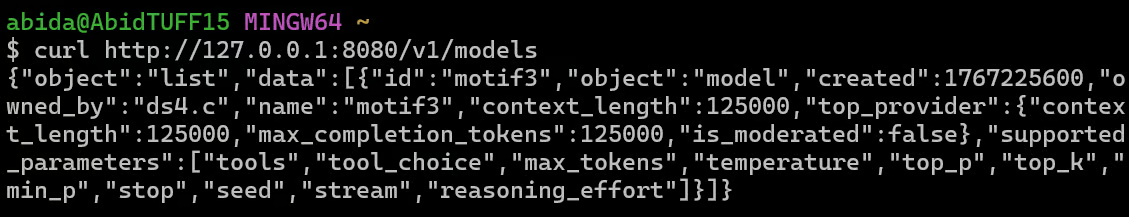
Powinieneś zobaczyć motif-3 na liście modeli z długością kontekstu 125000.
Wyślij teraz pierwszy prompt:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "motif-3",
    "messages": [
      {
        "role": "user",
        "content": "Explain mixture-of-experts models in simple terms."
      }
    ],
    "max_tokens": 256,
    "temperature": 0
  }'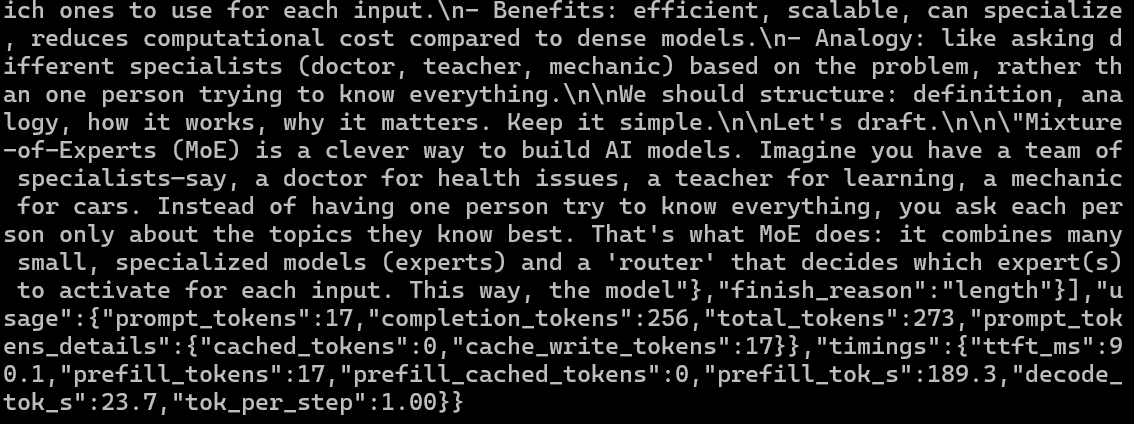
Jeśli wszystko działa, Motif-3 wygeneruje odpowiedź bezpośrednio z twojej H200. W moim teście model osiągnął następujące metryki:
Możesz też sprawdzić użycie pamięci GPU na serwerze:
nvidia-smi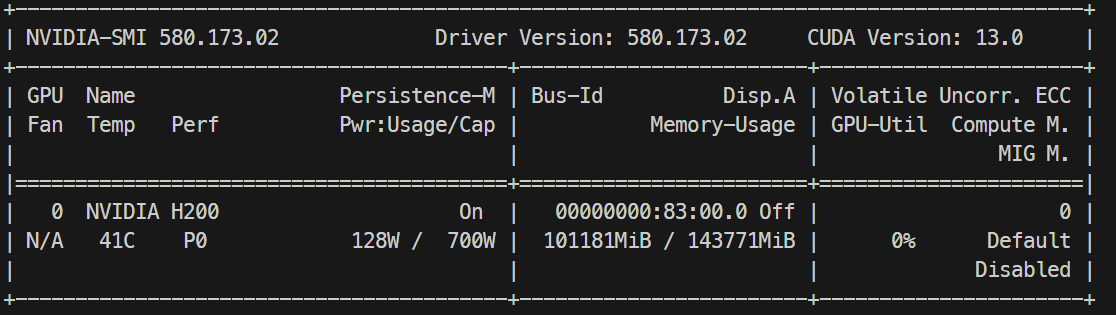
W mojej konfiguracji Motif-3 używał około 101 GB z 141 GB zgłaszanej pamięci GPU H200, pozostawiając dodatkowy VRAM na inferencję i bufor KV.
Teraz połączymy lokalne API Motif-3 z Pi, aby model działał jako agent kodujący, który potrafi tworzyć pliki, uruchamiać polecenia i iterować nad projektem.
Upewnij się, że Motif-3 jest nadal dostępny pod adresem:
http://127.0.0.1:8080/v1Zainstaluj Pi przy użyciu oficjalnego instalatora:
curl -fsSL https://pi.dev/install.sh | shZrestartuj terminal, a następnie potwierdź instalację:
pi --versionPi obsługuje niestandardowe modele kompatybilne z OpenAI poprzez ~/.pi/agent/models.json. Utwórz konfigurację:
mkdir -p ~/.pi/agent

cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "motif-local": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "models": [
        {
          "id": "motif-3",
          "name": "Motif-3",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 125000,
          "maxTokens": 125000
        }
      ]
    }
  }
}
EOFTeraz możemy dać Motif-3 realne zadanie programistyczne i sprawdzić, czy potrafi samodzielnie zbudować, uruchomić i ulepszać aplikację.
Utwórz projekt testowy i uruchom Pi:
mkdir -p ~/motif-test
cd ~/motif-test
pi
Przetestujmy model. Najpierw poprosimy go o zbudowanie prostej aplikacji to‑do.
Create a simple Python CLI to-do app that can add, list, complete, and delete tasks, save them locally to a JSON file, then run and test it.W ciągu kilku minut Motif-3 stworzył działającą aplikację CLI i pomyślnie ją przetestował. Funkcjonalność działała dobrze, ale początkowy interfejs był bardzo podstawowy.
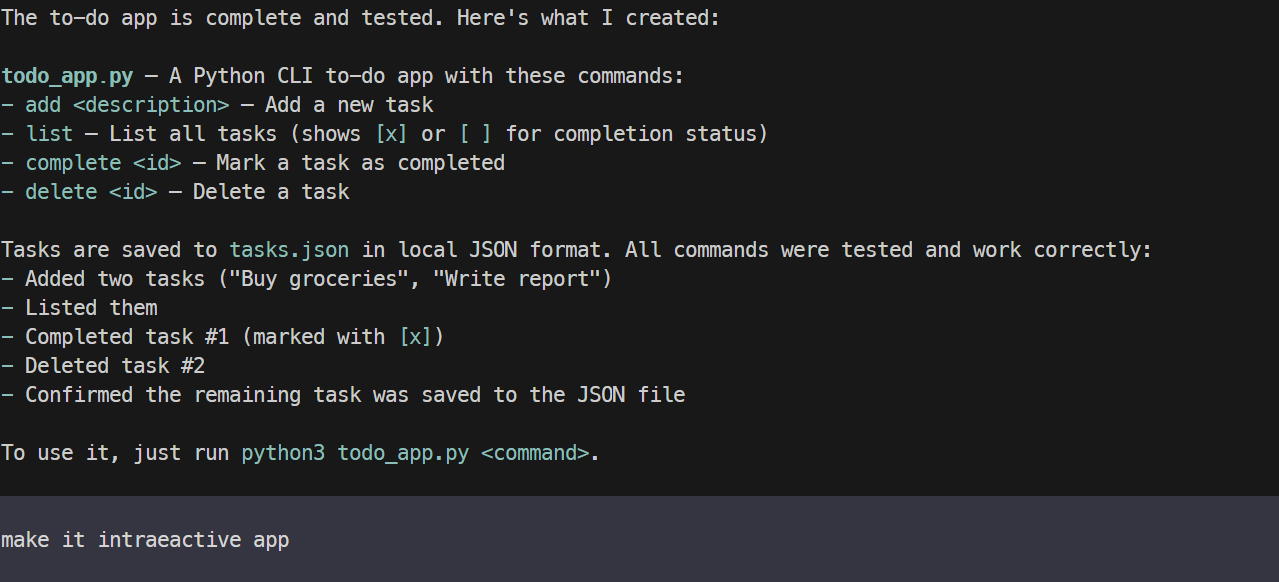
Następnie poprosiłem agenta o uczynienie aplikacji bardziej interaktywną i kolorową, poprawę układu i doświadczenia w terminalu. Motif-3 zmodyfikował istniejący projekt zamiast zaczynać od zera, a ulepszona wersja była wyraźnie bardziej dopracowana.
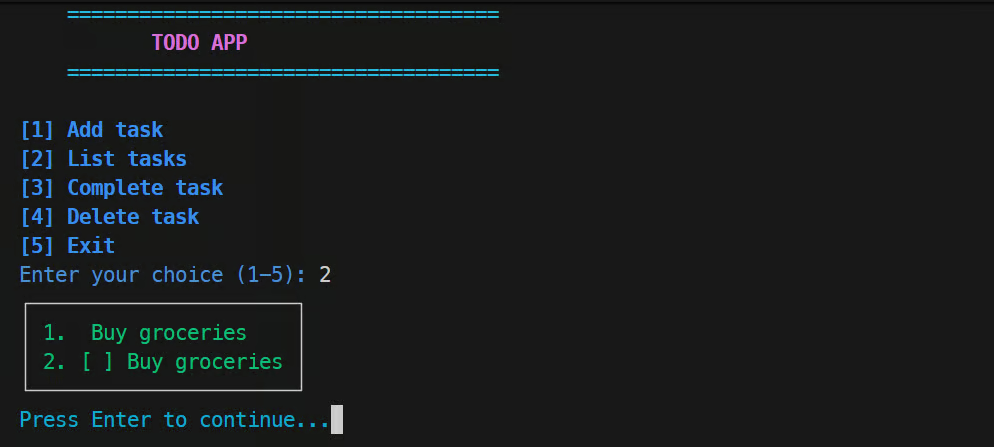
Na koniec chciałem zobaczyć, jak Motif-3 poradzi sobie z bardziej wizualnym zadaniem webowym, gdzie stworzenie działającej strony to tylko część wyzwania.
Początkowa aplikacja działała, ale było kilka detali UI, które mi się nie podobały. Zamiast dawać modelowi jeden wielki prompt do przeprojektowania, poprosiłem o poprawianie problemów po kolei, ulepszając poszczególne elementy interfejsu podczas testów.
To zadziałało zaskakująco dobrze. Motif-3 potrafił przejrzeć istniejący projekt, wprowadzać celowane zmiany i wielokrotnie udoskonalać UI, jednocześnie utrzymując działanie aplikacji.
Ogólnie byłem pod wrażeniem zarówno jakości kodowania, jak i zdolności do iteracji nad istniejącym projektem poprzez Pi.
Ogólnie moje wrażenia były mieszane. Motif-3 jest imponujący, ale dla większości osób istnieją lepsze i mniej pamięciożerne modele do uruchomienia.
Nawet przy mieszanej kwantyzacji, która mocno zmniejsza rozmiar, wciąż potrzebujesz około 100 GB lub więcej pamięci GPU bądź łącznej, by wygodnie go uruchomić. Z tego powodu jest wiele mniejszych modeli znacznie łatwiejszych do uruchomienia, takich jak Qwen3.8‑27B i inne modele nastawione na kodowanie.
Mimo to, jeśli szukasz czegoś bliższego klasie DeepSeek Flash modeli, Motif-3 nadal jest bardzo ciekawy. Jest szybki na H200, jakość kodowania jest dobra i prawdopodobnie da się z niego wycisnąć jeszcze więcej dzięki lepszemu strojeniu.
Główny problem miałem z agentem kodującym Pi, gdzie generowanie czasem się zatrzymywało albo przerywało. Zwiększyłem część limitów wyjścia i to pomogło, ale nie rozwiązało problemu całkowicie. To też mój pierwszy raz z runtime DS4, więc pewnie jest jeszcze co zoptymalizować w przyszłości.
Mimo wszystko, jeśli szukasz modelu rozwijanego w Korei lub alternatywy dla modeli z Chin, to obecnie jedna z ciekawszych opcji. Fajne jest też to, że coraz więcej krajów buduje własne modele i ekosystemy AI zamiast polegać tylko na kilku głównych dostawcach.
Ucz się AI z DataCamp!
Track
Track
course