
Leerpad
Basisprincipes van AI-business
12 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleVan het berekenen van kapitaalreserves tot het evalueren van marketingstrategieën: statistische analyse stuurt bijna elke beslissing bij een bank. Veel mensen—waaronder data scientists, analisten, managers, businessleads en toezichthouders—moeten vaak naar de analyses of de daarop gebaseerde rapporten kijken.
Voorspellingen van machinelearning- en statistische modellen kunnen een belangrijk onderdeel van die analyse zijn. Maar op deze manier gebruiken, wordt niet gezien als AI.
Van AI is sprake wanneer een model wordt gebruikt om een beslissing te automatiseren. De voorspellingen gaan een systeem in. Dat systeem bevat regels op basis van de voorspelling en andere variabelen die leiden tot een beslissing. We noemen dit “AI-systemen”.
Het team waarop ik werkte, ontwikkelde deze systemen vooral om nieuwe leningen automatisch goed te keuren. Het belangrijkste model dat deze systemen aanstuurt, noemen we een kredietrisicomodel.
Als je een lening aanvraagt bij een bank, doorloop je een beoordeling van je kredietrisico. Dat kan inhouden dat de verwachte verliespost bij wanbetaling wordt berekend of de kans dat je in gebreke blijft—oftewel de kans dat je door financiële problemen de lening niet kunt terugbetalen. Meestal is het die laatste voorspelling die bepaalt of een lening wordt goedgekeurd.
Al vóór de uitvinding van computers beoordeelden banken kredietrisico’s. Dit gebeurde vooral met een “kredietscorekaart”.
Zoals hieronder te zien is, bekijkt die verschillende kenmerken van een potentiële lener. Je krijgt een score op basis van de groep waarin je valt per kenmerk, en die worden bij elkaar opgeteld tot een eindscore. Hoe hoger je score, hoe kleiner de kans op wanbetaling.
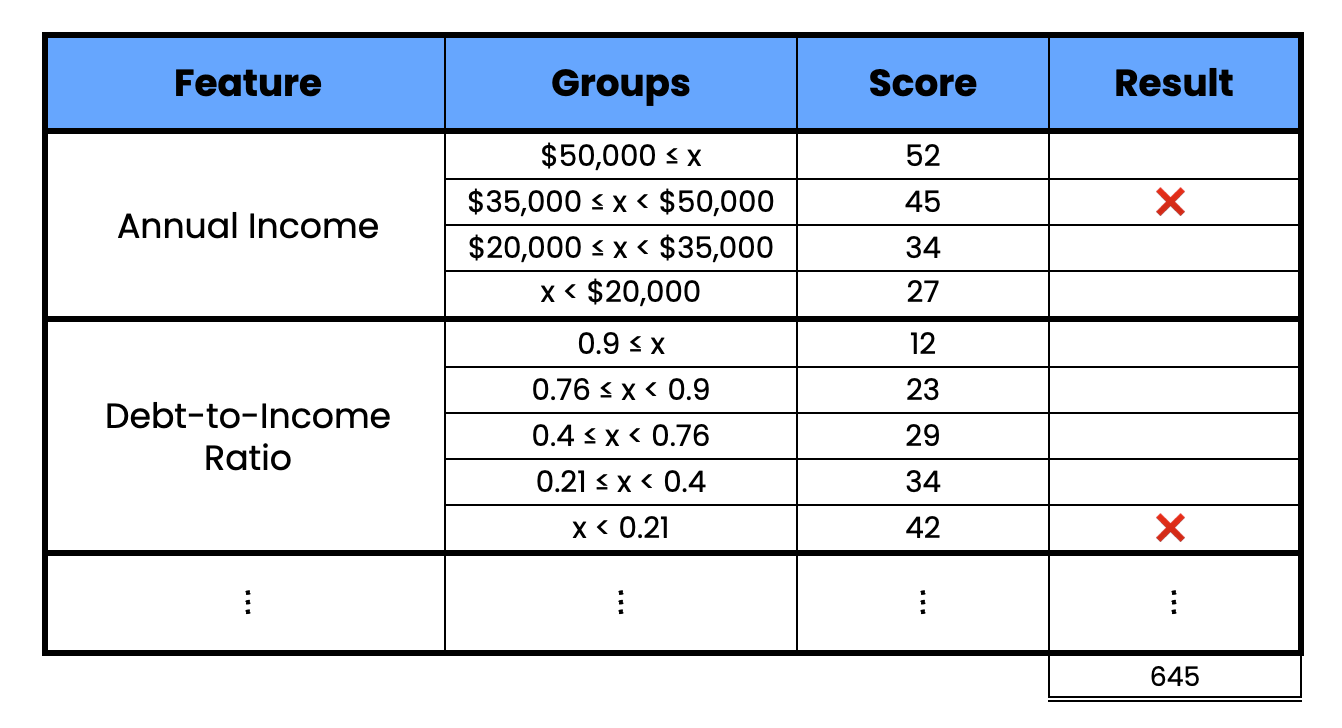
Voorbeeld van een kredietscorekaart (bron: auteur)
Vroeger werden deze vooral opgesteld op basis van “expert judgement”. Oftewel: iemand in pak bepaalde de waarden. En ja, dat was zo bevooroordeeld als het klinkt. Tegenwoordig hebben banken toegang tot enorme hoeveelheden data en rekenkracht om statistisch optimale scorekaarten te maken. Zoals we later bespreken, kan dat ook tot eerlijkere uitkomsten leiden.
Qua data is er veel om mee te werken. Intern heeft een bank toegang tot al je transactiegeschiedenis en je verleden met schulden. Extern hebben de meeste landen openbare registraties van eerdere schulden en wanbetalingen bij alle kredietinstellingen.
Al die bronnen kunnen worden gebruikt om modelfeatures te maken. Sommige banken gaan zelfs zo ver dat ze apparaatdata zoals je geolocatie gebruiken. Al kunnen ze dan al snel tegen regelgeving en ethische overwegingen aanlopen.
Het proces om deze scorekaarten te bouwen is flink veranderd, maar het eindproduct ziet er hetzelfde uit. Modelfeatures worden gediscretiseerd. Dit gebeurt met de Weight of Evidence (WOE) om de verschillen in wanbetalingspercentages per featuregroep te maximaliseren. Vervolgens kunnen we een score toekennen op basis van hoeveel een groep de kans op wanbetaling verandert. Net als voorheen kan de eindscore dan worden gebruikt om in te schatten hoe waarschijnlijk het is dat de lener in gebreke blijft.
Deze kredietscorekaarten vormen de basis van een AI-systeem dat leningen automatisch goedkeurt. In de simpelste vorm is er een strikte grenswaarde. Als de score daaronder ligt, wordt de lening geweigerd.
Er kunnen ook extra regels gelden op basis van de strategie van de bank, regelgeving of andere kenmerken zoals de leeftijd van de klant. Zoals we in de volgende sectie bespreken, kunnen complexere systemen voorspellingen uit meerdere modellen gebruiken.
In de praktijk worden deze AI-systemen gebruikt om persoonlijke leningen of kleine zakelijke leningen goed te keuren. Grotere bedragen zoals hypotheken of bedrijfsleningen worden niet volledig geautomatiseerd. Die gevallen zijn vaak te uniek of het bedrag te groot om te sanctioneren zonder dat een mens de eindbeslissing neemt. Vaak wordt de beslissing nog steeds genomen met behulp van een scorekaart.
Met alle vooruitgang in dataverzameling en automatisering zou je verwachten dat de onderliggende modellen complex zijn. Mis.
Logistische regressie wordt gebruikt om wanbetalingskansen te berekenen en scorekaarten te maken. In de sectie over uitdagingen bespreken we een paar redenen: de verklaarbaarheid van het model, regelgeving en eerlijkheid. Maar de hoofdreden is dat logistische regressie nauwkeurig genoeg is.
De wanbetaling waar we het over hadden, treedt op wanneer iemand in financiële problemen komt door slechte beslissingen of gebeurtenissen buiten de eigen controle. Belangrijk is dat deze mensen níet willen wanbetalen. Dat betekent dat de onderliggende verbanden die kredietrisico sturen, langzaam veranderen. Dat geeft ons de tijd om lineaire features te ontwerpen die deze verbanden op een uitlegbare manier vastleggen. Er zijn echter ook andere soorten wanbetaling die minder eenvoudig zijn.
In de geneeskunde voorspelt machine learning complexe zaken, zoals of een tumor goedaardig of kwaadaardig is. Stel je nu voor dat de tumor bewust was en van uiterlijk kon veranderen om detectie te vermijden. Dan wordt het probleem ineens veel moeilijker. Precies daarom is fraudedetectie zo lastig.
Er zijn veel soorten fraude. In de context van het automatisch goedkeuren van leningen is er sprake van fraude wanneer de lener nooit van plan was af te lossen. Het doel is de lening te krijgen en met het geld te verdwijnen. De lener kan het maandinkomen te hoog hebben opgegeven, verzwegen hebben dat er nog andere schulden zijn, of zelfs iemands identiteit hebben gestolen om de aanvraag te doen. Hoe ze het ook voor elkaar krijgen, we beschouwen dit als wanbetaling door fraude.
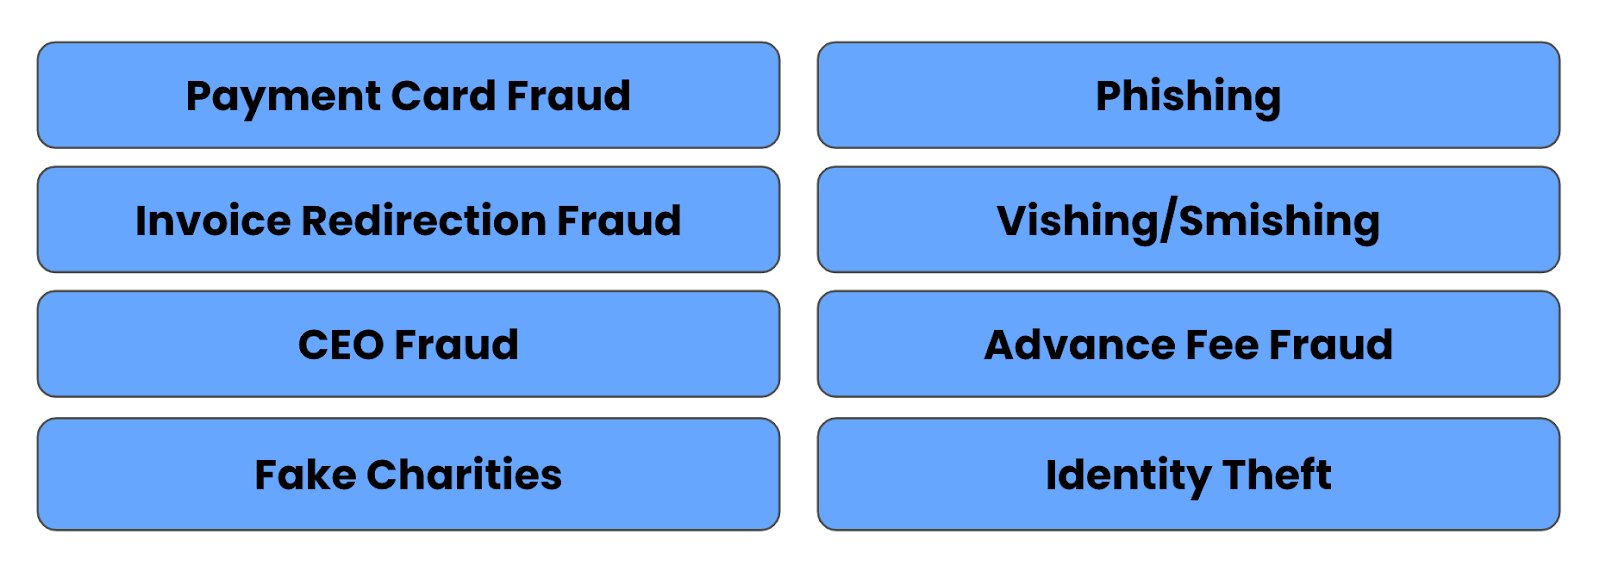
Soorten fraude (bron: auteur)
Bij kredietrisico kunnen we transacties aggregeren om een algemeen beeld van iemands gedrag te krijgen. Bij fraude kunnen individuele transacties belangrijk zijn. We kijken ook naar een diversere set databronnen, zoals apparaatdata en communicatiegeschiedenis.
Een andere factor is dat fraude voortdurend verandert, waardoor modellen sneller naar productie moeten. Dit alles betekent dat lineaire modellen vaak niet toereikend zijn.
Daarom is het gebruikelijk om niet-lineaire modellen te gebruiken zoals Random Forests en XGBoost. Neurale netwerken kunnen ook helpen als we tekstdata willen meenemen. Met deze modellen ligt er minder nadruk op feature engineering, wat kostbare tijd bespaart en ons in staat stelt gedrag te modelleren dat nog niet volledig begrepen is.
Het nadeel is dat dit nog steeds predictieve modellen zijn. We willen nieuwe fraudegevallen opsporen vóórdat ze gebeuren. Met predictieve modellen hebben we een trainingsset met gelabelde fraudegevallen nodig. Met andere woorden: we moeten eerst wachten tot fraude plaatsvindt!
Daarom kunnen we potentiële fraudegevallen ook beoordelen met unsupervised methoden zoals clusteralgoritmen of single-class modellen zoals Isolation Forest. Die kunnen klanten identificeren met afwijkend gedrag of, algemener gezegd, uitschieters.
Bij fraude moeten we ons ook zorgen maken over aanvallers die de modellen zelf targeten. Daarom overlappen fraudemodellen met een belangrijk deelgebied van kunstmatige intelligentie: adversarial machine learning.
Dit vakgebied probeert verborgen zwaktes in modellen te vinden die door aanvallers kunnen worden misbruikt. Iemand kan het model misleiden tot foute voorspellingen of gevoelige informatie laten prijsgeven. Bij poisoning-aanvallen wordt nepdata in het trainingsproces geïnjecteerd om modellen ongemerkt te corrumperen.
Voor het automatiseren van leningen is vooral het eerste relevant. Een fraudeur zal zich in feite als een goede klant proberen voor te doen. Het doel is manieren te vinden om het waargenomen kredietrisico te verlagen. Dat kan door het inkomen kunstmatig op te krikken of te liegen op het aanvraagformulier. Fraudomodellen dekken deze potentiële zwaktes in kredietrisicomodellen af. Tegelijk moeten ze zelf ook worden beoordeeld op mogelijke adversarial attacks.
Uiteindelijk zorgen de vele typen en de aard van fraude ervoor dat we vaak op complexere modellen moeten vertrouwen. In sommige gevallen kunnen deze modellen potentiële fraudegevallen vlaggen, die vervolgens grondiger door een mens worden beoordeeld.
Wat AI betreft, draaien fraudomodellen vaak naast kredietrisicomodellen in systemen die leningen automatisch goedkeuren. Ze vullen elkaar aan omdat ze wanbetaling om verschillende redenen proberen te voorspellen.
Zowel fraudedetectie als kredietrisicobeoordeling gaan over het werven van nieuwe klanten. De juiste klanten. Als ze die eenmaal hebben, krijgen banken een nieuw probleem: hoe houden ze ze vast? In de volgende twee secties verkennen we hoe AI kan helpen.
Banken gebruiken vergelijkbare AI-gestuurde strategieën om te voorspellen of een klant zal vertrekken. Dat kan betekenen dat ze hun bankrekening sluiten of van hypotheekverstrekker veranderen. Ze kunnen hun relatie ook verminderen zonder op te zeggen, bijvoorbeeld door een roodstandfaciliteit te verwijderen, een creditcard op te zeggen of een groot bedrag naar een andere bank over te maken.
Banken willen ingrijpen vóórdat dit gebeurt. Ze proberen ontevreden klanten te overtuigen met lagere rentetarieven, kortingen of andere speciale voordelen. Veel daarvan kan volledig geautomatiseerd.
Banken gebruiken modellen om te voorspellen of een persoon of bedrijf waarschijnlijk toekomstige betalingen mist (achterstand oploopt) of volledig in gebreke blijft. Opnieuw wil de bank ingrijpen voordat dit gebeurt. Ze kunnen financieel advies aanbieden of de mogelijkheid om de schuld te herstructureren. Zelfs een eenvoudige geautomatiseerde herinnering aan toekomstige betalingen kan effectief zijn.
Een ander gebied waar automatisering kan helpen, is wanneer klanten actief ondersteuning zoeken bij de bank. Ze hebben misschien advies nodig over het openen van een spaarrekening of het doen van online betalingen. Veel van deze vragen zijn repetitief en kunnen door een AI-gestuurde chatbot worden afgehandeld. Die kan sneller antwoorden en de complexere taken aan mensen overlaten.
Dit is ook een gebied waar de meest geavanceerde AI kan worden toegepast. Veel bedrijven updaten hun chatbots met LLM’s en generatieve AI. Deze krachtige modellen geven de chatbot van een bank een enorme boost, waardoor die complexere vragen kan afhandelen en zelfs persoonlijk advies kan geven. Voor dat laatste moeten we echter oppassen. Dat heeft te maken met de sterk gereguleerde omgeving waarin banken opereren.
De echte uitdagingen voor AI in het bankwezen zijn vaak niet technisch. Problemen rond datamanagement en modelontwikkeling zijn grotendeels opgelost. De obstakels voor het omarmen van geavanceerde AI-methoden komen voort uit de omgeving waarin banken opereren, gevestigde procedures en een lage risicotolerantie.
Sinds de financiële crisis van 2008 krijgen banken, laten we zeggen, minder ruimte om hun eigen gang te gaan. Ze opereren in een veel strenger gereguleerd klimaat, dat bepaalt hoeveel kapitaalreserves ze moeten aanhouden, welk risiconiveau ze mogen nemen en zelfs welke technologie ze mogen implementeren. Dat laatste betekent dat alleen bepaalde modeltypen op sommige taken mogen worden toegepast. Zo kan het zijn dat kapitaalreserves met een lineair model en vooraf gedefinieerde features moeten worden berekend.
Vaak is er behoefte aan duidelijkheid en verantwoording over het proces achter kredietbeslissingen. Dat betekent dat we aan een toezichthouder moeten uitleggen hoe modellen tot voorspellingen komen. Hoewel dit niet per se het type modellen beperkt, werpt het wel drempels op. Zoals genoemd is dit een van de redenen waarom lineaire modellen worden gebruikt voor kredietrisicomodellering. Elke prestatieverbetering van niet-lineaire modellen weegt niet op tegen de extra last om ze uit te leggen.
Bekijk de inzichten van Cynthia Rudin hierover:
In plaats van modellen te maken die van nature interpreteerbaar zijn, is er recent een explosie geweest aan werk rond “Explainable ML”, waarbij een tweede (posthoc) model wordt gemaakt om het eerste blackboxmodel uit te leggen. Dit is problematisch. Uitleg is vaak niet betrouwbaar en kan misleidend zijn, zoals we hieronder bespreken. Als we in plaats daarvan modellen gebruiken die van nature interpreteerbaar zijn, geven ze hun eigen uitleg, die trouw is aan wat het model daadwerkelijk berekent.
Cynthia Rudin, Duke University, Durham, NC, USA
Leer meer over AI!
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

