Lernpfad
KI-Grundlagen für Unternehmen
12 Std.
Trainiere dein Finanzteam mit DataCamp for Business. Umfassende Daten und KI-Schulungsressourcen sowie detaillierte Leistungseinblicke zur Unterstützung deiner Ziele.
Von der Berechnung von Kapitalreserven bis zur Bewertung von Marketingstrategien: Statistische Analysen fließen in nahezu jede Entscheidung einer Bank ein. Viele Menschen — darunter Data Scientists, Analystinnen, Manager, Business-Verantwortliche und Aufsichtsbehörden — müssen die Analysen oder darauf basierende Berichte einsehen.
Prognosen aus Machine-Learning- und Statistikmodellen können ein wichtiger Teil dieser Analysen sein. Ihre bloße Nutzung gilt jedoch noch nicht als KI.
Von KI sprechen wir, wenn ein Modell eine Entscheidung automatisiert. Seine Vorhersagen fließen in ein System ein. Dieses System enthält Regeln auf Basis der Vorhersage und weiterer Variablen, die zu einer Entscheidung führen. Diese nennen wir „KI-Systeme“.
Mein Team entwickelte vor allem solche Systeme, um neue Kredite automatisch zu genehmigen. Das wichtigste Modell in diesen Systemen ist das sogenannte Kreditrisikomodell.
Wenn du einen Kredit bei einer Bank beantragst, durchläufst du eine Kreditrisikobewertung. Dabei kann die erwartete Verlusthöhe im Falle eines Zahlungsausfalls berechnet werden oder die Wahrscheinlichkeit, dass du ausfällst — also den Kredit aufgrund finanzieller Schwierigkeiten nicht zurückzahlen kannst. Letztere Vorhersage treibt in der Regel die Entscheidung, einen Kredit zu genehmigen, maßgeblich.
Schon lange vor Erfindung des Computers bewerteten Banken Kreditrisiken. Üblich war dafür vor allem eine „Kredit-Scorecard“.
Wie unten zu sehen, berücksichtigt sie verschiedene Merkmale potenzieller Kreditnehmender. Du erhältst je nach Ausprägung eines Merkmals eine Punktzahl, alle Punkte werden aufsummiert. Je höher dein Score, desto geringer ist die Ausfallwahrscheinlichkeit.
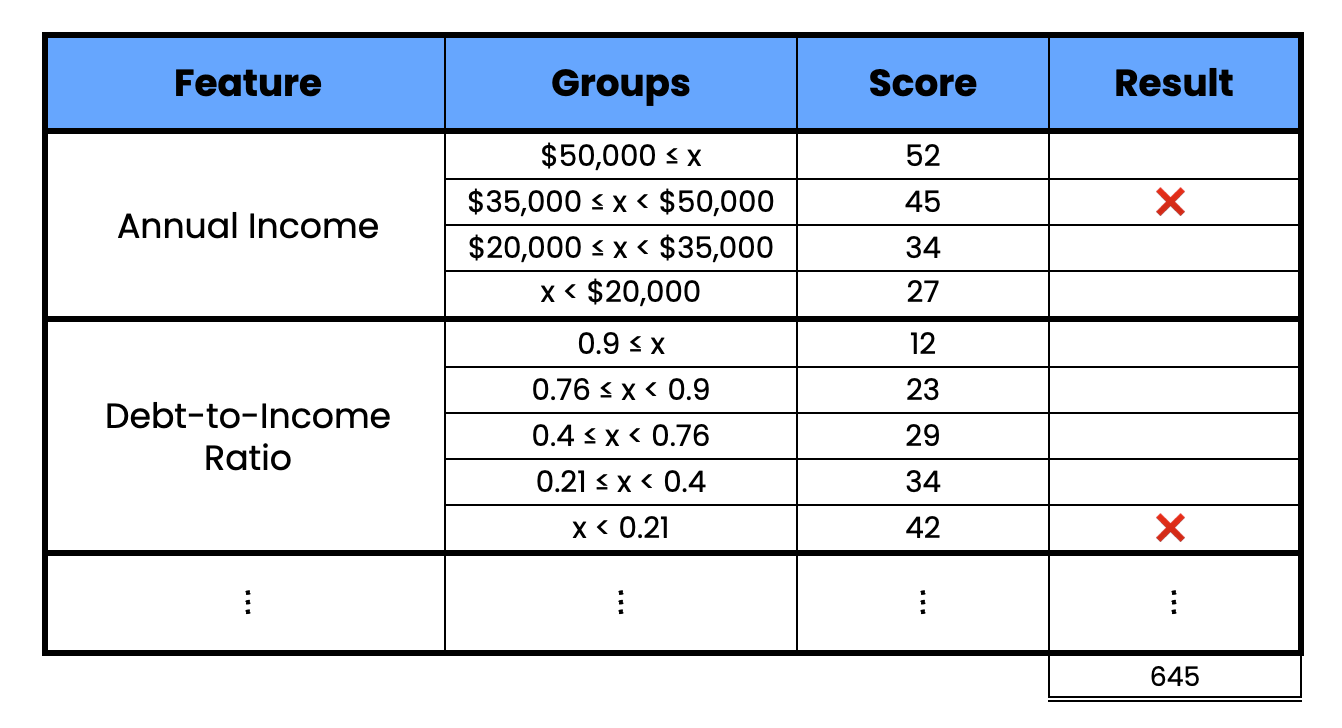
Beispiel einer Kredit-Scorecard (Quelle: Autor)
Früher entstanden diese Scorecards vor allem durch „Expert Judgment“ — sprich: Jemand im Anzug legte die Werte fest. Und ja, so voreingenommen, wie es klingt. Heute verfügen Banken über enorme Datenmengen und Rechenleistung, um statistisch optimale Scorecards zu bauen. Wie wir später sehen, kann das auch fairere Ergebnisse liefern.
An Daten mangelt es nicht. Intern hat eine Bank Zugriff auf deine gesamte Transaktionshistorie und dein bisheriges Zahlungsverhalten. Extern gibt es in den meisten Ländern öffentliche Register zu früheren Krediten und Ausfällen über alle Kreditinstitute hinweg.
All diese Quellen lassen sich in Modellmerkmale überführen. Manche Banken gehen sogar so weit, Gerätedaten wie Geolokation zu nutzen. Spätestens dann stoßen sie allerdings auf regulatorische und ethische Fragen.
Der Prozess zum Bau solcher Scorecards hat sich stark verändert, das Endprodukt sieht jedoch ähnlich aus. Merkmale werden diskretisiert. Dafür wird die Weight of Evidence (WOE) genutzt, um die Unterschiede in Ausfallraten je Merkmalsgruppe zu maximieren. Anschließend vergeben wir pro Gruppe eine Punktzahl, je nachdem, wie stark sie die Ausfallwahrscheinlichkeit verändert. So lässt sich — wie eh und je — aus dem Gesamtscore die Ausfallneigung eines Kreditnehmenden ableiten.
Diese Kredit-Scorecards bilden die Grundlage eines KI-Systems, das Kredite automatisch genehmigt. In der einfachsten Form gibt es einen harten Cutoff: Liegt der Score darunter, wird der Kredit abgelehnt.
Zusätzliche Regeln können sich aus der Bankstrategie, Regulierung oder Merkmalen wie dem Alter des Kunden ergeben. Wie wir im nächsten Abschnitt sehen, können komplexere Systeme Vorhersagen aus mehreren Modellen kombinieren.
In der Praxis kommen diese KI-Systeme bei Privatkrediten oder kleinen Geschäftskrediten zum Einsatz. Größere Summen wie Hypotheken oder Unternehmenskredite werden nicht vollständig automatisiert. Diese Fälle sind oft zu individuell oder die Beträge zu hoch, um ohne finale menschliche Entscheidung zu genehmigen. Häufig dient dennoch eine Scorecard als Entscheidungsgrundlage.
Angesichts der Fortschritte bei Datenerhebung und Automatisierung würdest du komplexe Modelle erwarten. Das ist jedoch ein Trugschluss.
Für die Schätzung von Ausfallwahrscheinlichkeiten und den Bau von Scorecards wird Logistische Regression verwendet. Gründe dafür erläutern wir im Abschnitt zu den Herausforderungen: Interpretierbarkeit, Regulierung und Fairness. Der Hauptgrund ist jedoch, dass die Logistische Regression hinreichend genau ist.
Bei den beschriebenen Ausfällen geraten Menschen durch Fehlentscheidungen oder äußere Umstände in finanzielle Schwierigkeiten. Wichtig ist: Niemand will absichtlich ausfallen. Die zugrunde liegenden Zusammenhänge im Kreditrisiko verändern sich daher langsam. Das gibt uns Zeit, lineare Merkmale zu entwickeln, die diese Beziehungen interpretierbar abbilden. Es gibt jedoch andere Arten von Ausfällen, die nicht so simpel sind.
Im Gesundheitswesen sagt Machine Learning komplexe Dinge voraus, etwa ob ein Tumor gut- oder bösartig ist. Stell dir nun vor, der Tumor wäre bewusst und könnte sein Aussehen ändern, um unentdeckt zu bleiben. Das macht das Problem schlagartig viel schwieriger. Ähnlich verhält es sich mit Betrugserkennung.
Es gibt viele Arten von Betrug. Im Kontext automatischer Kreditgenehmigung liegt Betrug vor, wenn der Kreditnehmende nie vorhatte, Rückzahlungen zu leisten. Ziel ist, den Kredit zu erhalten und mit dem Geld zu verschwinden. Dafür könnten Einkommen zu hoch angegeben, andere Schulden verschwiegen oder sogar eine fremde Identität genutzt werden. Egal wie: Wir sprechen dann von einem Ausfall aufgrund von Betrug.
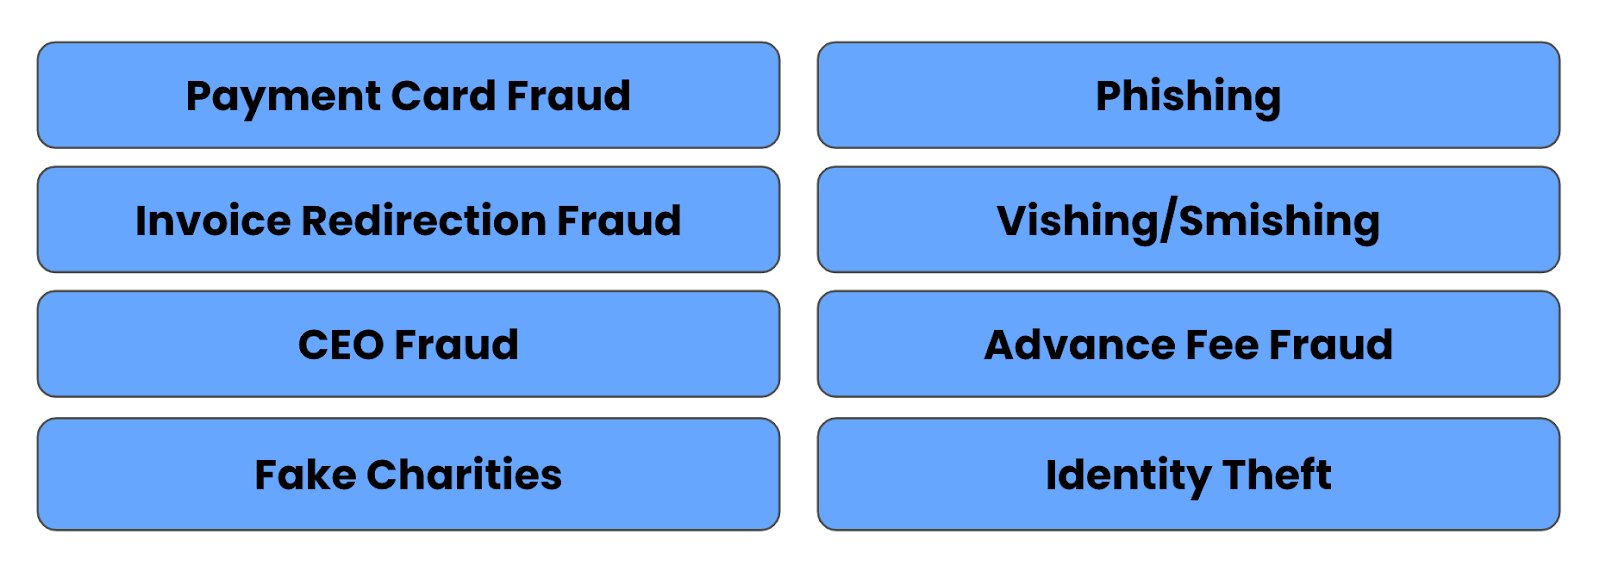
Betrugsarten (Quelle: Autor)
Beim Kreditrisiko können wir Transaktionen aggregieren, um das generelle Verhalten zu erfassen. Bei Betrug sind einzelne Transaktionen oft entscheidend. Zudem betrachten wir vielfältigere Datenquellen wie Gerätedaten und Kommunikationshistorien.
Ein weiterer Punkt: Da sich Betrugsmuster ständig verändern, müssen Modelle schneller in Produktion. Lineare Modelle stoßen hier häufig an Grenzen.
Daher kommen nichtlineare Modelle wie Random Forests und XGBoost häufig zum Einsatz. Sollen Textdaten einfließen, helfen auch Neuronale Netze. Bei diesen Modellen ist Feature Engineering weniger zentral, was Zeit spart und erlaubt, noch nicht vollständig verstandene Verhaltensweisen abzubilden.
Der Nachteil: Es bleiben Vorhersagemodelle. Wir wollen neue Betrugsfälle erkennen, bevor sie passieren. Für Prädiktionsmodelle brauchen wir jedoch einen Trainingsdatensatz mit gelabelten Betrugsfällen — sprich, wir müssen erst Betrug abwarten!
Deshalb prüfen wir potenziellen Betrug zusätzlich mit unüberwachten Methoden wie Clustering-Algorithmen oder Ein-Klassen-Modellen wie Isolation Forest. Diese helfen, Kundinnen und Kunden mit ungewöhnlichem Verhalten zu identifizieren — also Ausreißer.
Bei Betrug müssen wir auch Angriffe auf die Modelle selbst bedenken. Daher überschneiden sich Betrugsmodelle mit einem wichtigen KI-Zweig: adversariales Machine Learning.
Dieses Feld sucht nach verborgenen Schwachstellen in Modellen, die Angreifer ausnutzen können. So lässt sich ein Modell zu falschen Vorhersagen verleiten oder zur Preisgabe sensibler Informationen. Bei Poisoning-Angriffen werden Trainingsdaten manipuliert, um Modelle unbemerkt zu korrumpieren.
Für die Kreditautomatisierung ist Ersteres am relevantesten. Betrüger versuchen, sich wie gute Kundschaft darzustellen und ihre wahrgenommene Ausfallwahrscheinlichkeit zu senken — etwa durch künstlich erhöhtes Einkommen oder Falschangaben. Betrugsmodelle decken solche Schwachstellen von Kreditrisikomodellen ab, müssen aber selbst auf adversariale Angriffe geprüft werden.
Kurzum: Vielfalt und Dynamik von Betrug erfordern oft komplexere Modelle. In manchen Fällen markieren diese potenzielle Betrugsfälle, die anschließend von Menschen geprüft werden.
In KI-Systemen zur automatischen Kreditvergabe laufen Betrugs- und Kreditrisikomodelle oft parallel. Sie ergänzen sich, da sie Ausfälle aus unterschiedlichen Gründen prognostizieren.
Sowohl Betrugserkennung als auch Kreditrisikobewertung zielen auf die Kundengewinnung — die richtigen Kundinnen und Kunden. Sind sie gewonnen, stellt sich die nächste Frage: Wie bleiben sie der Bank treu? Die nächsten beiden Abschnitte zeigen, wie KI hilft.
Banken nutzen ähnliche KI-gestützte Strategien, um vorherzusagen, ob Kundschaft abwandert — etwa durch Kontoschließung oder Wechsel der Hypothekenbank. Auch ohne vollständigen Wechsel kann das Geschäft schrumpfen, z. B. durch das Entfernen des Dispos, Kündigen der Kreditkarte oder hohe Überweisungen zu einer anderen Bank.
Die Bank will eingreifen, bevor das passiert. Unzufriedene Kundinnen und Kunden werden mit niedrigeren Zinsen, Rabatten oder weiteren Vorteilen gehalten. Vieles davon lässt sich vollständig automatisieren.
Zudem prognostizieren Modelle, ob Personen oder Unternehmen künftige Raten verpassen (also in Rückstand geraten) oder komplett ausfallen. Auch hier will die Bank proaktiv handeln — etwa mit Finanzberatung oder der Möglichkeit zur Umschuldung. Schon eine einfache automatisierte Zahlungserinnerung kann wirken.
Ein weiteres Feld für Automatisierung ist der aktive Support. Ob Sparkonto einrichten oder Online-Zahlungen tätigen: Viele Anfragen wiederholen sich und lassen sich von einem KI-gestützten Chatbot beantworten. Das geht schneller und entlastet Menschen für komplexere Fälle.
Hier kommen auch die fortschrittlichsten KI-Modelle zum Einsatz. Viele Unternehmen rüsten ihre Bots mit LLMs und Generativer KI auf. Diese leistungsstarken Modelle erweitern die Fähigkeiten eines Bank-Chatbots deutlich — bis hin zu komplexeren Anfragen und persönlicher Beratung. Bei Letzterem ist jedoch Vorsicht geboten, nicht zuletzt wegen des stark regulierten Umfelds.
Die eigentlichen Hürden für KI im Banking sind häufig nicht technischer Natur. Probleme rund um Datenmanagement und Modellentwicklung sind weitgehend gelöst. Die Hürden für den Einsatz fortgeschrittener KI-Methoden entstehen durch das Umfeld, etablierte Prozesse und eine geringe Risikotoleranz.
Seit der Finanzkrise 2008 haben Banken deutlich weniger Spielraum. Sie agieren in einem strengen regulatorischen Rahmen, der Kapitalreserven, Risikoniveaus und sogar die einsetzbare Technologie vorgibt. Letzteres bedeutet, dass für manche Aufgaben nur bestimmte Modelltypen zulässig sind. So müssen Kapitalreserven teils mit linearen Modellen und vordefinierten Merkmalen berechnet werden.
Oft müssen Kreditentscheidungen nachvollziehbar begründet werden. Das heißt, wir müssen Aufsehern erklären, wie Modelle zu Vorhersagen gelangen. Das schränkt zwar nicht zwingend die Modellwahl ein, sorgt aber für Reibung. Wie erwähnt, ist dies ein Grund, warum lineare Modelle im Kreditrisiko dominieren: Der potenzielle Leistungsgewinn nichtlinearer Modelle wird durch den Erklärungsaufwand häufig aufgewogen.
Sieh dir dazu die Einschätzungen von Cynthia Rudin an:
Statt von vornherein verständliche Modelle zu entwickeln, gab es zuletzt eine Welle zu „Explainable ML“, bei der ein zweites (post-hoc) Modell das erste Blackbox-Modell erklären soll. Das ist problematisch. Solche Erklärungen sind oft unzuverlässig und können in die Irre führen. Wenn wir stattdessen von Natur aus interpretierbare Modelle verwenden, liefern sie ihre eigenen, dem tatsächlichen Rechnen des Modells treuen Erklärungen.
Cynthia Rudin, Duke University, Durham, NC, USA
Verändere dein Unternehmen, indem du deinem Team mit dem DataCamp for Business fortgeschrittene KI-Kenntnisse vermittelst. Erreiche bessere Einblicke und mehr Effizienz.
Erfahre mehr über KI!
Lernpfad
Kurs
Kurs