Cursus
Principes fondamentaux de l'intelligence artificielle dans le monde des affaires
12 h
Formez votre équipe financière avec DataCamp for Business. Des ressources complètes de formation aux données et à l'IA et des informations détaillées sur les performances pour soutenir vos objectifs.
Du calcul des réserves de capital à l’évaluation des stratégies marketing, l’analyse statistique éclaire quasiment toutes les décisions d’une banque. De nombreuses parties prenantes — data scientists, analystes, managers, responsables métiers, régulateurs — consultent ces analyses et les rapports associés.
Les prédictions issues de modèles statistiques et d’apprentissage automatique peuvent y jouer un rôle important. Toutefois, les utiliser ainsi ne relève pas à proprement parler de l’IA.
On parle d’IA lorsqu’un modèle permet d’automatiser une décision. Ses prédictions alimentent un système. Ce système applique des règles basées sur la prédiction et d’autres variables pour aboutir à une décision. Nous appelons ces systèmes des « systèmes d’IA ».
L’équipe dont je faisais partie développait principalement ce type de systèmes pour octroyer automatiquement de nouveaux prêts. Le modèle le plus crucial qui les alimente est le modèle de risque de crédit.
Quand vous demandez un prêt, vous passez une évaluation du risque de crédit. Elle peut inclure le calcul de la perte attendue en cas de défaut ou de la probabilité que vous fassiez défaut — c’est-à-dire que vous ne puissiez pas rembourser le prêt en raison de difficultés financières. C’est généralement cette dernière prédiction qui guide la décision d’octroyer (ou non) le prêt.
Bien avant l’informatique, les banques évaluaient déjà le risque de crédit. On utilisait principalement une « carte de score » (credit scorecard).
Comme ci-dessous, elle prend en compte différentes caractéristiques de l’emprunteur potentiel. Vous obtenez un score selon le groupe auquel vous appartenez pour chaque caractéristique, puis ces points sont additionnés pour un score final. Plus le score est élevé, moins le risque de défaut est important.
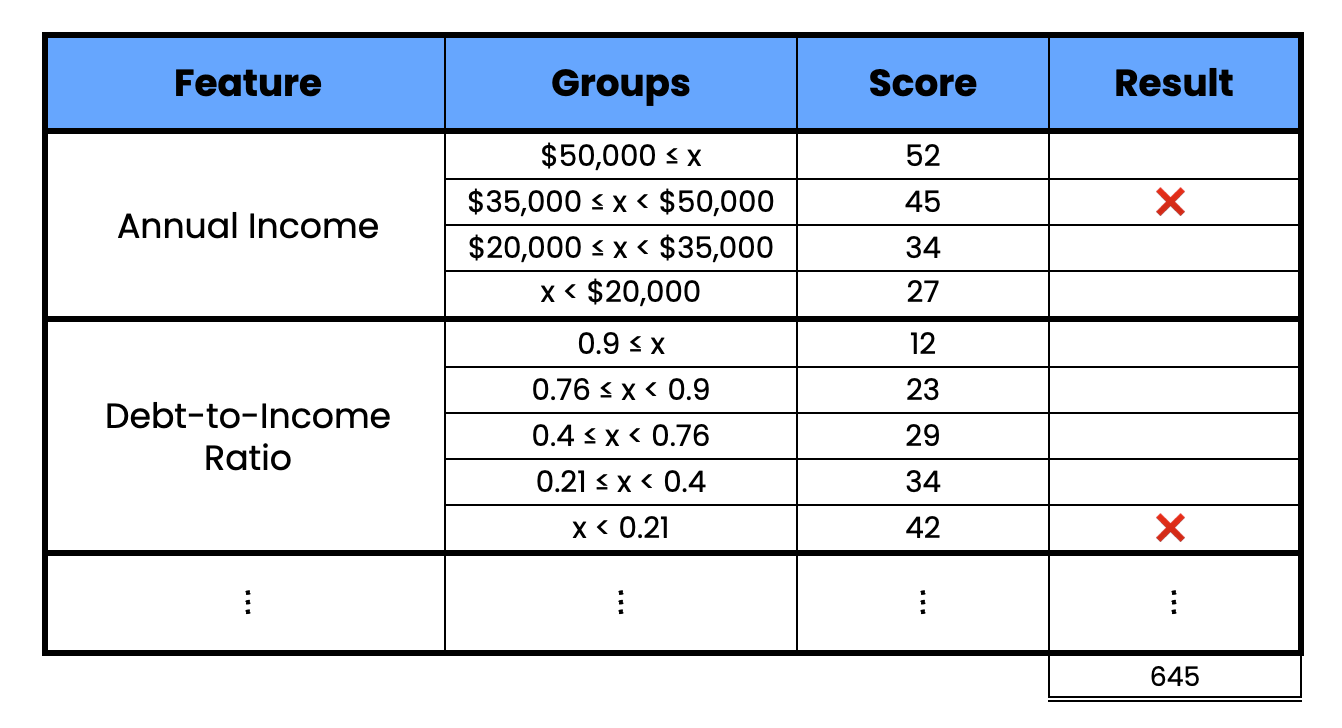
Exemple de carte de score de crédit (source : auteur)
Autrefois, ces barèmes reposaient surtout sur le « jugement d’expert » : en clair, une personne en costume fixait les valeurs. Et oui, c’était aussi biaisé que cela en a l’air. Désormais, les banques disposent d’immenses volumes de données et de puissance de calcul pour construire des scorecards statistiquement optimales. Comme nous le verrons, cela peut aussi conduire à des résultats plus équitables.
Côté données, la matière ne manque pas. En interne, une banque accède à tout votre historique de transactions et à vos comportements d’endettement passés. En externe, la plupart des pays tiennent des registres publics sur les dettes et défauts passés, tous établissements confondus.
Toutes ces sources servent à créer des variables de modèle. Certaines banques vont jusqu’à utiliser des données d’appareil, comme votre géolocalisation. Mais à ce stade, elles se heurtent à des considérations réglementaires et éthiques.
Le processus de construction de ces scorecards a beaucoup évolué, mais le produit final se ressemble. Les variables sont discrétisées. On utilise le Weight of Evidence (WOE) pour maximiser l’écart des taux de défaut entre groupes. On peut ensuite attribuer un score selon l’impact du groupe sur la probabilité de défaut. Comme auparavant, le score final sert à évaluer le risque de défaut d’un emprunteur.
Ces cartes de score constituent la base d’un système d’IA qui automatise l’octroi des prêts. Dans sa forme la plus simple, il s’agit d’un seuil strict : en deçà, le prêt est refusé.
Des règles complémentaires peuvent refléter la stratégie de la banque, la réglementation ou d’autres variables comme l’âge du client. Comme nous le verrons, des systèmes plus complexes peuvent agréger les prédictions de plusieurs modèles.
En pratique, ces systèmes d’IA servent à octroyer des prêts personnels ou aux petites entreprises. Les montants plus élevés, comme les hypothèques ou les prêts aux entreprises, ne sont pas entièrement automatisés : les cas sont trop spécifiques ou les sommes trop importantes pour se passer d’une décision humaine finale. Souvent, la décision s’appuie tout de même sur une scorecard.
Avec tous les progrès en collecte de données et en automatisation, on pourrait s’attendre à des modèles sophistiqués. Ce n’est pas le cas.
La régression logistique est utilisée pour estimer les probabilités de défaut et construire les scorecards. Nous en expliquons certaines raisons dans la partie défis : interprétabilité, réglementation, équité. Mais la raison principale est que la régression logistique est suffisamment précise.
Le défaut évoqué plus haut survient quand une personne rencontre des difficultés financières liées à de mauvaises décisions ou à des événements extérieurs. L’essentiel est que ces personnes ne souhaitent pas être en défaut. Les relations sous-jacentes qui déterminent le risque de crédit évoluent donc lentement. Nous avons le temps de concevoir des variables linéaires qui capturent ces relations de façon interprétable. D’autres types de défaut, en revanche, sont moins simples.
En médecine, l’apprentissage automatique prédit des phénomènes complexes, par exemple si une tumeur est bénigne ou maligne. Imaginez maintenant que la tumeur soit consciente et puisse changer d’apparence pour échapper au diagnostic : le problème devient nettement plus ardu. C’est une bonne analogie pour expliquer la difficulté de la détection de fraude.
Il existe de nombreux types de fraude. Dans le contexte de l’octroi automatisé des prêts, on parle de fraude lorsque l’emprunteur n’a jamais eu l’intention de rembourser. Son objectif est d’obtenir les fonds puis de disparaître. Il peut avoir surévalué ses revenus, dissimulé d’autres dettes, voire usurpé une identité. Quelle que soit la méthode, nous qualifierions ce défaut de fraude.
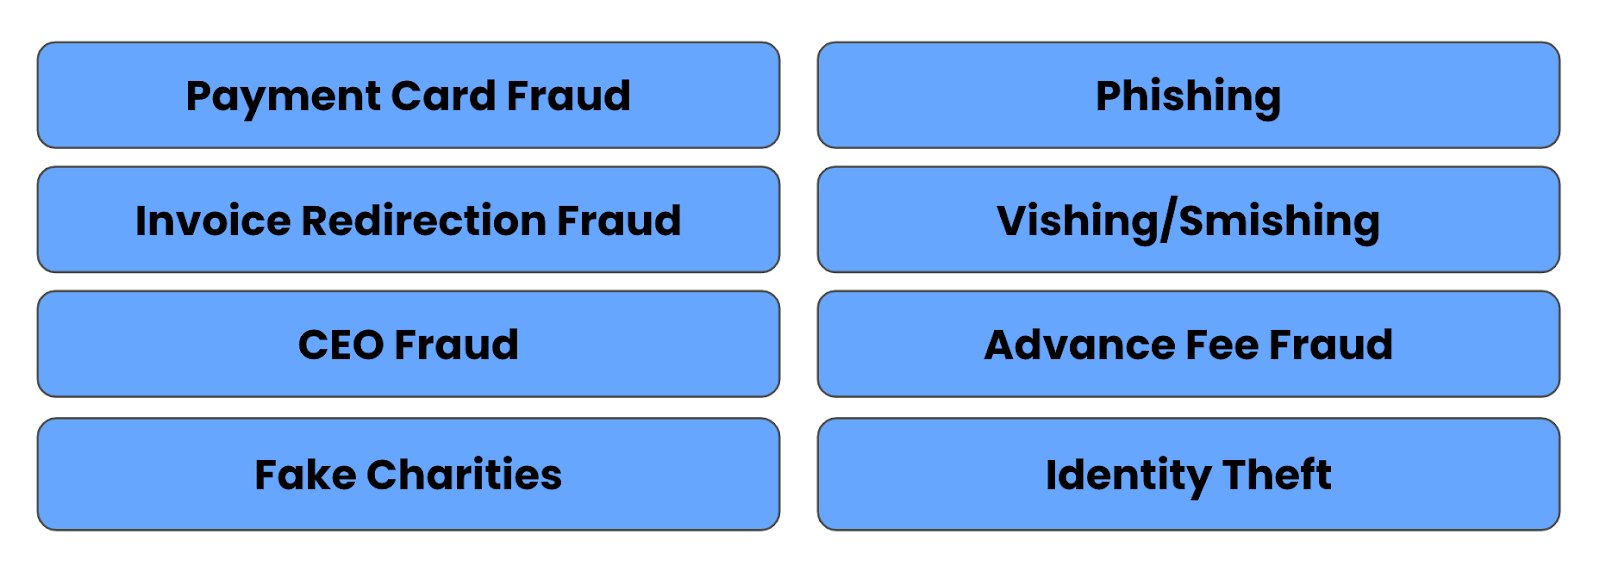
Types de fraude (source : auteur)
La nature du défaut lié au risque de crédit permet d’agréger les transactions pour dégager des tendances de comportement. Pour la fraude, chaque transaction peut compter. On examine aussi des sources plus variées, comme les données d’appareil et l’historique des communications.
Autre point : la fraude évolue sans cesse, il faut donc déployer les modèles plus vite. Tout cela rend les modèles linéaires souvent insuffisants.
C’est pourquoi l’on recourt fréquemment à des modèles non linéaires comme Random Forests et XGBoost. Les réseaux de neurones sont utiles pour intégrer des données texte. Avec ces modèles, on mise moins sur le feature engineering, ce qui gagne un temps précieux et permet de modéliser des comportements encore mal compris.
Limite : il s’agit toujours de modèles prédictifs. Nous voulons détecter de nouveaux cas avant qu’ils ne surviennent. Or ces modèles exigent un jeu d’entraînement labellisé — il faut donc d’abord attendre que la fraude se produise !
D’où l’intérêt de méthodes non supervisées comme le clustering ou des modèles à classe unique, par exemple Isolation Forest, pour repérer des comportements atypiques, bref des valeurs aberrantes.
Avec la fraude, il faut aussi craindre des attaquants qui ciblent les modèles eux-mêmes. Les modèles de fraude recouvrent donc un volet majeur de l’IA : l’apprentissage automatique adversarial.
Ce domaine vise à déceler des failles cachées exploitables par des attaquants. On peut tromper un modèle pour lui faire produire de mauvaises prédictions ou divulguer des informations sensibles. Les attaques par empoisonnement injectent de fausses données dans l’entraînement afin de corrompre les modèles à notre insu.
Pour l’automatisation des prêts, la première menace est la plus courante : un fraudeur cherche à ressembler à un bon client, à abaisser son risque perçu, par exemple en gonflant ses revenus ou en mentant dans sa demande. Les modèles anti-fraude servent à couvrir ces angles morts des modèles de risque de crédit, tout en étant eux-mêmes évalués contre des attaques adversariales.
Au final, la diversité et la nature des fraudes imposent souvent des modèles plus complexes. Dans certains cas, ces modèles signalent des suspicions qui seront examinées par un humain.
Côté IA, les modèles de fraude fonctionnent généralement en parallèle des modèles de risque de crédit dans les systèmes d’octroi automatique. Ils se complètent en prédisant des défauts pour des raisons différentes.
La détection de fraude et l’évaluation du risque concernent l’acquisition de nouveaux clients — les bons. Une fois acquis, un autre enjeu survient : comment les fidéliser ? Les deux prochaines sections montrent comment l’IA peut aider.
Les banques utilisent des stratégies similaires, dopées à l’IA, pour prédire si un client risque de partir : fermer son compte, changer d’établissement pour son hypothèque, ou réduire son activité sans partir (supprimer un découvert, annuler une carte de crédit, transférer un gros solde ailleurs).
L’idée est d’intervenir avant que ces événements n’arrivent, en proposant à temps des taux préférentiels, des remises ou des avantages. Une grande partie de ce processus peut être entièrement automatisée.
Les banques prédisent aussi si une personne ou une entreprise risque de manquer des paiements (entrer en arriérés) ou de faire défaut complètement. Là encore, elles cherchent à intervenir en amont : conseil financier, opportunité de restructurer la dette, ou même un simple rappel automatique des échéances peut suffire.
L’automatisation aide aussi quand les clients sollicitent activement la banque : ouvrir un livret, réaliser un virement en ligne, etc. Beaucoup de demandes étant répétitives, un chatbot alimenté par l’IA peut les traiter, répondre plus vite et laisser les cas complexes aux conseillers.
C’est également un domaine où l’IA la plus avancée s’applique. Nombre d’entreprises modernisent leurs bots avec des LLM et de l’IA générative. Ces modèles puissants démultiplient les capacités du chatbot : questions plus complexes, conseil personnalisé. Prudence, toutefois, pour ce dernier point, compte tenu de la forte réglementation du secteur.
Les véritables obstacles de l’IA dans la banque sont rarement techniques. Les problématiques de gestion des données et de développement de modèles sont globalement résolues. Les freins à l’adoption de méthodes d’IA avancées tiennent plutôt au contexte d’exploitation, aux procédures établies et à une aversion très forte au risque.
Depuis la crise de 2008, disons que la liberté d’action des banques s’est réduite. Elles évoluent dans un cadre réglementaire plus strict, qui fixe leurs réserves de capital, le niveau de risque autorisé et même les technologies déployables. Sur ce dernier point, certains types de modèles ne sont admis que pour certaines tâches : par exemple, les réserves de capital peuvent devoir être calculées avec un modèle linéaire et des variables prédéfinies.
Il faut souvent clarifier et justifier le processus de décision de crédit. Cela implique d’expliquer à un régulateur comment les modèles prédisent. Sans interdire formellement certains modèles, cela crée une inertie. Comme évoqué, c’est une des raisons de l’usage de modèles linéaires pour le risque de crédit : le gain marginal de performance des modèles non linéaires ne compense pas le fardeau explicatif supplémentaire.
Consultez les analyses de Cynthia Rudin sur ce sujet :
Plutôt que de concevoir des modèles intrinsèquement interprétables, on a récemment assisté à une explosion des travaux sur l’« explicabilité », où un second modèle (a posteriori) est créé pour expliquer un premier modèle boîte noire. C’est problématique : ces explications sont souvent peu fiables et peuvent induire en erreur. Si nous utilisons des modèles intrinsèquement interprétables, ils fournissent leurs propres explications, fidèles à ce que le modèle calcule réellement.
Cynthia Rudin, Duke University, Durham, NC, USA
Transformez votre entreprise en dotant votre équipe de compétences avancées en matière d'IA grâce à DataCamp for Business. Améliorez vos connaissances et votre efficacité.
En savoir plus sur l’IA !
Cursus
Cours
Cours