
Programma
Nozioni di base sull'intelligenza artificiale nel mondo degli affari
12 ore
Pratica and corso your progress.
Continua Con GoogleDal calcolo delle riserve di capitale alla valutazione delle strategie di marketing, l’analisi statistica informa quasi ogni decisione in banca. Molte persone, tra cui data scientist, analisti, manager, responsabili di business e regolatori, spesso devono esaminare l’analisi o i report basati su di essa.
Le previsioni di modelli di machine learning e statistici possono essere una parte importante di questa analisi. Tuttavia, usarli in questo modo non verrebbe considerato AI.
Parliamo di AI quando un modello viene utilizzato per automatizzare una decisione. Le sue previsioni vengono inserite in un sistema. Il sistema contiene regole basate sulla previsione e su altre variabili che portano a una decisione. Chiamiamo questi "sistemi di AI".
Il team in cui lavoravo si occupava principalmente di sviluppare questi sistemi per autorizzare automaticamente nuovi prestiti. Il modello più importante che guida questi sistemi è chiamato modello di rischio di credito.
Quando richiedi un prestito a una banca, verrai sottoposto a una valutazione del rischio di credito. Questo può comportare il calcolo della perdita attesa in caso di insolvenza o della probabilità che tu vada in default, cioè la probabilità che tu non riesca a rimborsare il prestito a causa di difficoltà finanziarie. È quest’ultima previsione che di solito guida la decisione di autorizzare (concederti) un prestito.
Fin da prima dell’invenzione dei computer, le banche effettuavano valutazioni del rischio di credito. Questo avveniva principalmente tramite una "credit scorecard".
Come si vede sotto, considera varie caratteristiche di un potenziale mutuatario. Otterrai un punteggio in base al gruppo in cui rientri per una data caratteristica e tutti i punteggi vengono sommati per ottenere un punteggio finale. Più alto è il punteggio, meno è probabile che tu vada in default.
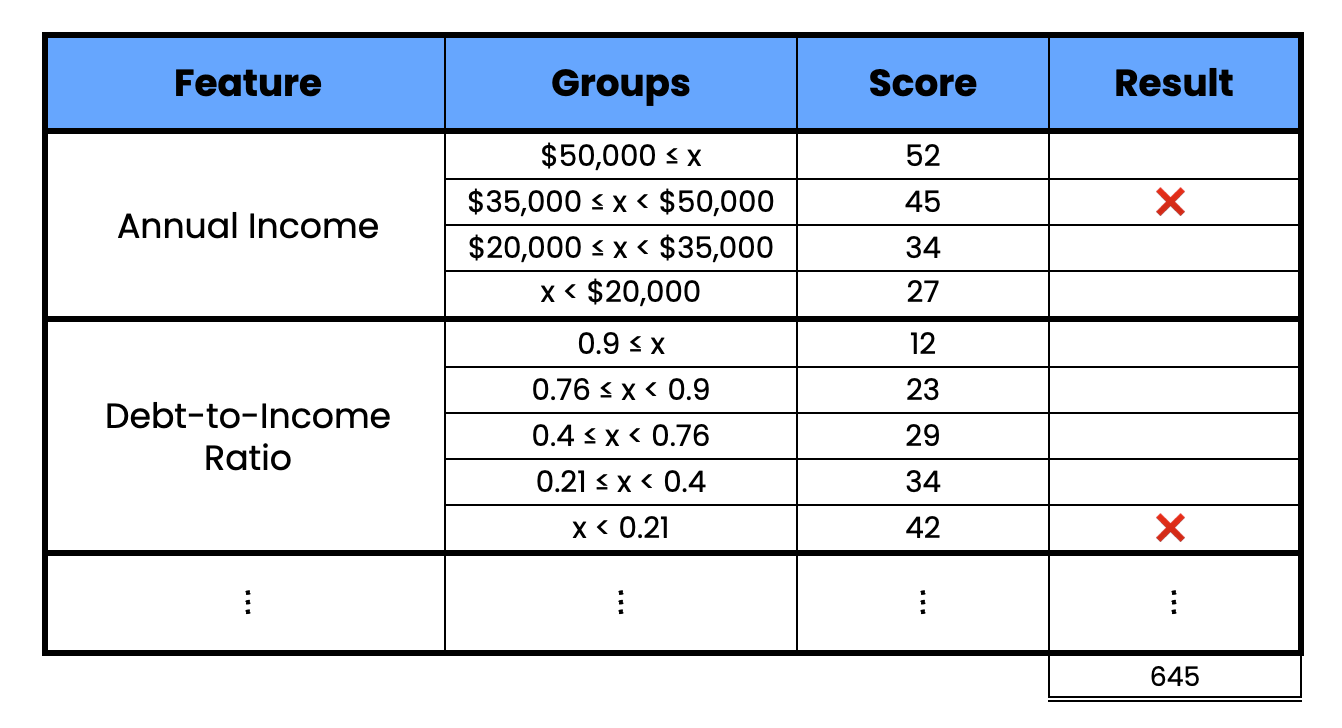
Esempio di credit scorecard (fonte: autore)
In passato, venivano create principalmente tramite "giudizio degli esperti". In altre parole, una persona in giacca e cravatta decideva i valori. E sì, era tanto fazioso quanto suona. Oggi, le banche hanno accesso a enormi quantità di dati e potenza computazionale per creare scorecard statisticamente ottimali. Come vedremo più avanti, questo può anche produrre risultati più equi.
Sul fronte dei dati, c’è molto materiale su cui lavorare. Internamente, una banca ha accesso a tutta la tua cronologia delle transazioni e ai comportamenti di debito passati. Esternamente, la maggior parte dei paesi dispone di registri pubblici su debiti e default passati in tutte le istituzioni creditizie.
Tutte queste fonti possono essere utilizzate per creare le feature del modello. Alcune banche possono spingersi fino a usare dati del dispositivo, come la tua geolocalizzazione. Anche se, a quel punto, potrebbero imbattersi in considerazioni normative ed etiche.
Il processo di costruzione di queste scorecard è cambiato molto, ma il prodotto finale appare lo stesso. Le feature del modello sono discretizzate. Questo viene fatto usando il Weight of Evidence (WOE) per massimizzare la differenza nei tassi di default tra i gruppi di ogni feature. Possiamo quindi assegnare un punteggio in base a quanto un gruppo modifica la probabilità di default. Così, come prima, il punteggio finale può essere usato per valutare la probabilità che il mutuatario vada in default su un prestito.
Queste credit scorecard costituiscono la base di un sistema di AI usato per autorizzare automaticamente i prestiti. Nella forma più semplice, c’è una soglia rigida. Se il punteggio è al di sotto di questa soglia, il prestito viene rifiutato.
Si possono anche applicare regole aggiuntive basate sulla strategia della banca, sulla regolamentazione o su altre caratteristiche come l’età del cliente. Come vedremo nella prossima sezione, sistemi più complessi possono usare le previsioni di più modelli.
In pratica, questi sistemi di AI vengono usati per autorizzare prestiti personali o per piccole imprese. Importi più grandi come mutui o prestiti corporate non sono completamente automatizzati. Questi casi possono essere troppo unici o la somma di denaro troppo elevata per essere autorizzata senza che un essere umano prenda la decisione finale. Spesso la decisione verrà comunque presa con l’aiuto di una scorecard.
Con tutti i progressi nella raccolta dei dati e nell’automazione, potresti aspettarti che i modelli sottostanti siano complessi. Ti sbaglieresti.
La regressione logistica è usata per calcolare le probabilità di default e creare le scorecard. Ne discutiamo alcune ragioni nella sezione sulle sfide. Hanno a che fare con l’interpretabilità del modello, la regolamentazione e l’equità. Tuttavia, la ragione principale è che la regressione logistica è sufficientemente accurata.
Il default di cui abbiamo parlato si verifica quando qualcuno incappa in difficoltà finanziarie a causa di decisioni sbagliate o eventi fuori dal suo controllo. Il punto importante è che queste persone non vogliono andare in default. Ciò significa che le relazioni sottostanti che guidano il rischio di credito si muovono lentamente. Questo ci dà il tempo di costruire feature lineari che catturino queste relazioni in modo interpretabile. Tuttavia, ci sono altri tipi di default che non sono così semplici.
In medicina, il machine learning predice cose complesse, come se un tumore è benigno o maligno. Ora, immagina se il tumore fosse cosciente e potesse cambiare aspetto per evitare di essere rilevato. All’improvviso il problema diventa molto più difficile. Allo stesso modo, ecco perché il rilevamento delle frodi è così arduo.
Esistono molti tipi di frode. Nel contesto dell’autorizzazione automatizzata dei prestiti, c’è frode quando il mutuatario non ha mai avuto l’intenzione di rimborsare. Il suo obiettivo è ottenere il prestito e sparire con i soldi. Il mutuatario potrebbe aver sovrastimato il reddito mensile, nascosto altri debiti da rimborsare o persino rubato l’identità di qualcuno per fare domanda. Qualunque sia il modo, considereremmo questo default dovuto a frode.
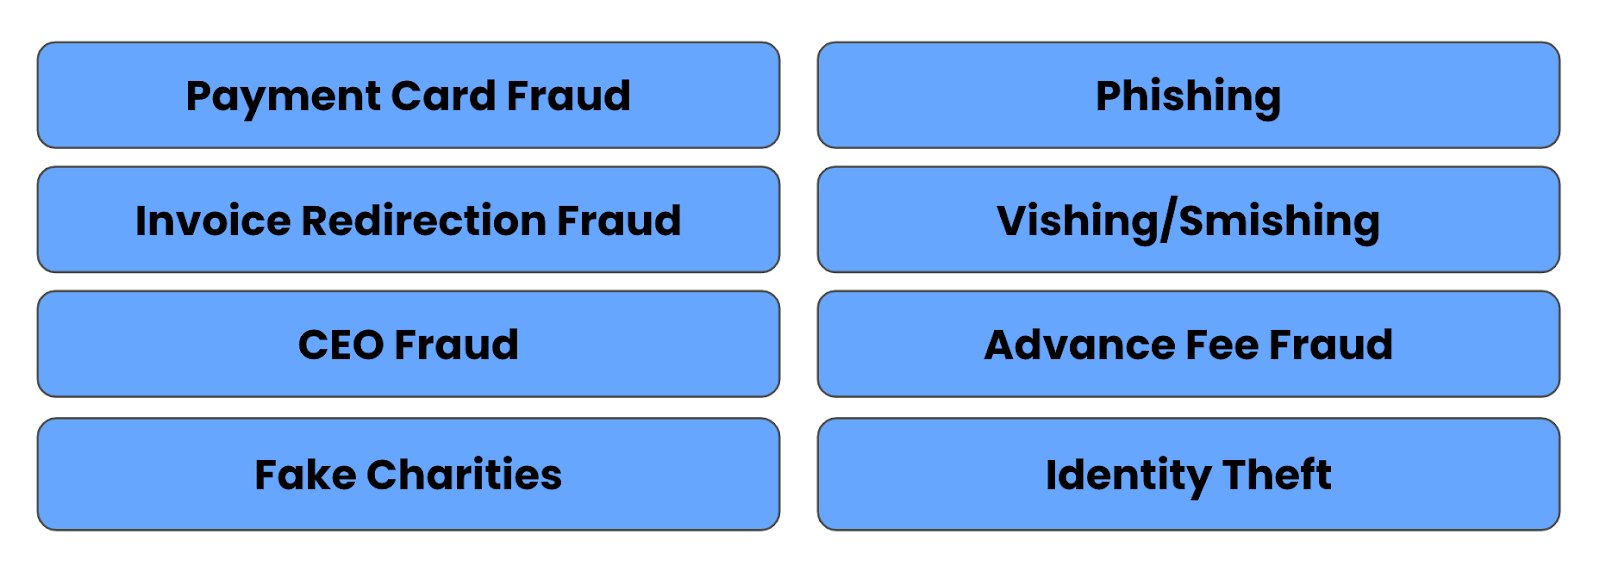
Tipi di frode (fonte: autore)
La natura del default legato al rischio di credito fa sì che possiamo aggregare le transazioni per ottenere un’idea generale del comportamento di una persona. Per la frode, possono essere importanti le singole transazioni. Consideriamo anche un set di fonti dati più diversificato, come i dati del dispositivo e la cronologia delle comunicazioni.
Un’altra considerazione è che, dato il carattere mutevole della frode, dobbiamo mettere in produzione i modelli più rapidamente. Tutto ciò significa che i modelli lineari spesso non sono all’altezza della sfida.
Per questo è comune usare modelli non lineari come Random Forest e XGBoost. Le reti neurali possono aiutare se vogliamo incorporare dati testuali. Con questi modelli si pone meno enfasi sull’ingegnerizzazione delle feature, risparmiando tempo prezioso e permettendoci di modellare comportamenti non completamente compresi.
Lo svantaggio è che sono comunque modelli predittivi. Vogliamo intercettare nuovi casi di frode prima che accadano. Con i modelli predittivi, abbiamo bisogno di un dataset di addestramento con casi di frode etichettati. In altre parole, dobbiamo prima aspettare che la frode avvenga!
Per questo possiamo anche valutare potenziali casi di frode con metodi non supervisionati, come algoritmi di clustering o modelli a singola classe come Isolation Forest. Questi possono aiutare a identificare clienti con comportamenti unici o, in termini più generali, outlier.
Con la frode dobbiamo anche preoccuparci di attaccanti che prendono di mira i modelli stessi. Ecco perché i modelli antifrode si sovrappongono a un ramo importante dell’intelligenza artificiale: l’adversarial machine learning.
Questo campo mira a trovare debolezze nascoste nei modelli che possano essere sfruttate dagli attaccanti. Qualcuno potrebbe ingannare il modello inducendolo a fare previsioni errate o a divulgare informazioni sensibili. Gli attacchi di poisoning implicano l’iniezione di dati falsi nel processo di training per corrompere i modelli senza che ce ne accorgiamo.
In termini di automazione dei prestiti, il primo è il più rilevante. In sostanza, un frodatore proverà a sembrare un buon cliente. Cercherà modi per ridurre il proprio rischio di credito percepito. Potrebbe farlo aumentando artificialmente il reddito o mentendo nella domanda. I modelli antifrode servono a coprire queste potenziali debolezze dei modelli di rischio di credito. Tuttavia, anche loro devono essere valutati per potenziali attacchi avversari.
In definitiva, la molteplicità e la natura delle frodi fanno sì che spesso dobbiamo affidarci a modelli più complessi. In alcuni casi, questi modelli possono contrassegnare potenziali frodi che poi verranno esaminate più a fondo da un umano.
Per quanto riguarda l’AI, i modelli antifrode spesso vengono eseguiti insieme ai modelli di rischio di credito nei sistemi usati per autorizzare automaticamente i prestiti. Si completano a vicenda perché mirano a prevedere il default per ragioni diverse.
Sia il rilevamento delle frodi sia la valutazione del rischio di credito riguardano l’acquisizione di nuovi clienti. Quelli giusti. Una volta acquisiti, le banche affrontano un altro problema: come trattenerli? Le prossime due sezioni esploreranno alcuni dei modi in cui l’AI può aiutare.
Le banche usano strategie simili basate sull’AI per prevedere se un cliente se ne andrà. Potrebbe significare chiudere il conto o cambiare fornitore del mutuo. Potrebbero anche ridurre l’operatività senza andarsene, eliminando un fido, cancellando una carta di credito o trasferendo una grossa somma a un’altra banca.
Le banche vogliono intervenire prima che questi eventi accadano. Cercheranno di convincere i clienti insoddisfatti con tassi di interesse più bassi, sconti o altri vantaggi speciali. Molto di questo può essere completamente automatizzato.
Le banche usano modelli per prevedere se una persona o un’azienda probabilmente salterà pagamenti futuri (cioè andrà in arretrato) o andrà completamente in default. Anche in questo caso, la banca vorrà intervenire prima che accada. Potrebbe offrire consulenza finanziaria o l’opportunità di ristrutturare il debito. Anche un semplice messaggio automatico che ricorda i pagamenti futuri può essere efficace.
Un’altra area in cui l’automazione può aiutare è quando i clienti cercano attivamente supporto dalla banca. Potrebbero aver bisogno di consigli per aprire un conto di risparmio o effettuare pagamenti online. Molte di queste richieste sono ripetitive e un chatbot basato su AI può gestirle. Può fornire risposte più rapide e lasciare i compiti più complessi agli umani.
È anche un’area in cui si possono applicare le AI più avanzate. Molte aziende stanno aggiornando i loro chatbot per usare LLM e AI generativa. Questi potenti modelli hanno potenziato i chatbot delle banche, permettendo loro di gestire richieste più complesse e persino fornire consigli personalizzati. Tuttavia, su quest’ultimo aspetto dovremmo essere cauti. C’entra con l’ambiente altamente regolamentato in cui operano le banche.
Le vere sfide affrontate dall’AI nel banking spesso non sono tecniche. I problemi relativi alla gestione dei dati e allo sviluppo dei modelli sono stati in gran parte risolti. Le difficoltà nell’adozione di metodi di AI avanzati derivano dall’ambiente in cui operano le banche, da procedure consolidate e da una bassa tolleranza al rischio.
Dalla crisi finanziaria del 2008, diciamo che alle banche non è più concessa molta libertà decisionale. Affrontano un ambiente normativo molto più rigido che determina l’ammontare da mantenere come riserve di capitale, il livello di rischio che possono assumere e persino i tipi di tecnologia che possono implementare. Quest’ultimo aspetto significa che solo alcuni tipi di modelli possono essere applicati a certi compiti. Ad esempio, le riserve di capitale potrebbero dover essere calcolate con un modello lineare e feature predefinite.
Spesso c’è la necessità di chiarire e giustificare il processo con cui si prendono decisioni di credito. Ciò significa spiegare a un regolatore come i modelli formulano previsioni. Sebbene questo non limiti necessariamente il tipo di modelli che possiamo usare, introduce resistenza. Come accennato, è uno dei motivi per cui si usano modelli lineari per il rischio di credito. Qualsiasi miglioramento prestazionale ottenuto con modelli non lineari viene compensato dall’onere maggiore di doverli spiegare.
Considera le riflessioni di Cynthia Rudin su questo tema:
Piuttosto che cercare di creare modelli intrinsecamente interpretabili, si è assistito di recente a un’esplosione di lavori sulla "Explainable ML", in cui si crea un secondo modello (post hoc) per spiegare il primo modello black box. Questo è problematico. Le spiegazioni spesso non sono affidabili e possono essere fuorvianti, come discutiamo sotto. Se invece usiamo modelli intrinsecamente interpretabili, essi forniscono da soli le proprie spiegazioni, fedeli a ciò che il modello calcola effettivamente.
Cynthia Rudin, Duke University, Durham, NC, USA
Scopri di più sull’AI!
Programma
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



