
बैंकिंग में AI के अनुप्रयोग
पूंजी आरक्षित की गणना से लेकर मार्केटिंग रणनीतियों के मूल्यांकन तक, सांख्यिकीय विश्लेषण बैंक में लगभग हर निर्णय को सूचित करता है। कई लोग—जिनमें डेटा वैज्ञानिक, विश्लेषक, प्रबंधक, व्यवसाय लीड और नियामक शामिल हैं—अक्सर विश्लेषण या उस पर आधारित रिपोर्टों को देखना चाहेंगे।
मशीन लर्निंग और सांख्यिकीय मॉडलों की भविष्यवाणियाँ इस विश्लेषण का एक महत्वपूर्ण हिस्सा हो सकती हैं। हालाँकि, इस तरह उनका उपयोग करना AI नहीं माना जाएगा।
AI तब होता है जब किसी निर्णय को स्वचालित करने के लिए मॉडल का उपयोग किया जाता है। इसकी भविष्यवाणियाँ एक प्रणाली में फीड की जाती हैं। यह प्रणाली भविष्यवाणी और अन्य चर पर आधारित नियमों को समेटे रहती है जो निर्णय तक पहुँचाती हैं। हम इन्हें “AI प्रणालियाँ” कहते हैं।
जिस टीम में मैं था, उसका प्राथमिक काम नए ऋण अपने-आप स्वीकृत करने के लिए ऐसी प्रणालियाँ विकसित करना था। इन प्रणालियों को संचालित करने वाला सबसे महत्वपूर्ण मॉडल क्रेडिट जोखिम मॉडल कहलाता है।
क्रेडिट जोखिम आकलन
जब आप बैंक से ऋण का अनुरोध करते हैं, तो आपका क्रेडिट जोखिम आकलन किया जाएगा। इसमें डिफॉल्ट की स्थिति में अपेक्षित हानि की गणना करना या आपके डिफॉल्ट करने की संभावना का अनुमान लगाना शामिल हो सकता है—यानी वित्तीय कठिनाई के कारण आप ऋण चुकाने में असमर्थ होंगे, इसकी संभावना। आमतौर पर यही दूसरी भविष्यवाणी ऋण स्वीकृत (देने) करने के निर्णय को संचालित करती है।
हम क्रेडिट जोखिम का मॉडल कैसे बनाते हैं
कंप्यूटर के आविष्कार से पहले से ही बैंक क्रेडिट जोखिम आकलन करते आ रहे हैं। यह मुख्य रूप से “क्रेडिट स्कोरकार्ड” का उपयोग करके किया जाता था।
जैसा कि नीचे दिखाया गया है, यह संभावित उधारकर्ता की विभिन्न विशेषताओं पर विचार करेगा। किसी दी गई विशेषता के लिए आप जिस समूह में आते हैं उसके आधार पर आपको अंक मिलते हैं, और सभी को जोड़कर अंतिम स्कोर प्राप्त होता है। आपका स्कोर जितना अधिक होगा, आपके डिफॉल्ट करने की संभावना उतनी ही कम होगी।
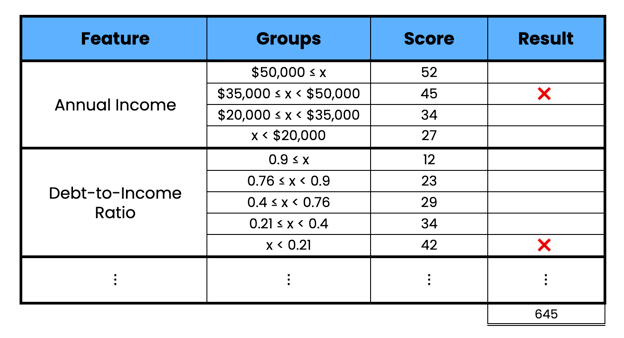
क्रेडिट स्कोरकार्ड का उदाहरण (स्रोत: लेखक)
पहले ये मुख्य रूप से “विशेषज्ञ निर्णय” के जरिए बनाए जाते थे। यानी किसी सूट पहने व्यक्ति ने मान तय किए। और हाँ, यह उतना ही पक्षपाती था जितना लगता है। अब, बैंकों के पास विशाल डेटा और संगणना शक्ति है ताकि सांख्यिकीय रूप से श्रेष्ठ स्कोरकार्ड बनाए जा सकें। जैसा कि हम आगे चर्चा करेंगे, इससे अधिक निष्पक्ष परिणाम भी मिल सकते हैं।
डेटा की दृष्टि से, काम करने के लिए बहुत कुछ है। आंतरिक रूप से, बैंक के पास आपके सभी लेन-देन इतिहास और पिछले ऋण व्यवहार की पहुँच होती है। बाहरी रूप से, अधिकांश देशों में सभी क्रेडिट संस्थानों में पिछले ऋणों और डिफॉल्ट्स के सार्वजनिक रिकॉर्ड होते हैं।
इन सभी स्रोतों का उपयोग मॉडल फीचर्स बनाने के लिए किया जा सकता है। कुछ बैंक डिवाइस डेटा, जैसे आपका जियोलोकेशन, तक का उपयोग करने तक जा सकते हैं। हालाँकि, वहाँ वे कुछ विनियामक और नैतिक विचारों से टकराना शुरू कर सकते हैं।
इन स्कोरकार्ड्स के निर्माण की प्रक्रिया काफी बदल गई है, लेकिन अंतिम उत्पाद वैसा ही दिखता है। मॉडल फीचर्स का विविक्तीकरण किया जाता है। यह Weight of Evidence (WOE) का उपयोग करके किया जाता है ताकि प्रत्येक फीचर समूह के साथ डिफॉल्ट दरों में अधिकतम अंतर हो। फिर हम एक स्कोर असाइन कर सकते हैं कि कोई समूह डिफॉल्ट की संभावना को कितना बदलता है। अतः, पहले की तरह, अंतिम स्कोर का उपयोग यह आकलन करने के लिए किया जा सकता है कि उधारकर्ता के ऋण डिफॉल्ट करने की कितनी संभावना है।
स्कोरकार्ड्स का उपयोग कैसे होता है
ये क्रेडिट स्कोरकार्ड्स एक AI प्रणाली का आधार बनाते हैं जिसका उपयोग ऋण अपने-आप स्वीकृत करने के लिए किया जाता है। इसकी सबसे सरल रूप-रेखा में, यह एक कड़ा कटऑफ है। यदि स्कोर इस कटऑफ से नीचे है, तो ऋण अस्वीकृत कर दिया जाता है।
अतिरिक्त नियम बैंक की रणनीति, विनियमन, या ग्राहक की आयु जैसी अन्य विशेषताओं पर भी आधारित हो सकते हैं। जैसा कि हम अगले खंड में चर्चा करेंगे, अधिक जटिल प्रणालियाँ कई मॉडलों की भविष्यवाणियों का उपयोग कर सकती हैं।
व्यवहार में, इन AI प्रणालियों का उपयोग व्यक्तिगत या छोटे व्यवसाय के ऋणों को स्वीकृत करने के लिए किया जाता है। बड़े अमाउंट, जैसे मॉर्गेज या कॉर्पोरेट लोन, पूरी तरह स्वचालित नहीं होते। ये मामले बहुत अनोखे हो सकते हैं या राशि इतनी बड़ी कि अंतिम निर्णय बिना मानव के नहीं लिया जा सकता। अक्सर निर्णय अभी भी स्कोरकार्ड की मदद से लिया जाएगा।
डेटा संग्रह और स्वचालन में सभी प्रगति के साथ, आप उम्मीद कर सकते हैं कि अंतर्निहित मॉडल जटिल होंगे। आप गलत होंगे।
डिफॉल्ट की संभावनाएँ निकालने और स्कोरकार्ड बनाने के लिए लॉजिस्टिक रिग्रेशन का उपयोग किया जाता है। हम चुनौतियों वाले खंड में इसके कुछ कारणों पर चर्चा करते हैं। ये मॉडल की व्याख्येयता, विनियमन, और निष्पक्षता से जुड़े हैं। हालाँकि, मुख्य कारण यह है कि लॉजिस्टिक रिग्रेशन पर्याप्त रूप से सटीक है।
जिस डिफॉल्ट की हमने बात की, वह तब होता है जब कोई व्यक्ति गलत फैसलों या अपने नियंत्रण से बाहर की घटनाओं के कारण वित्तीय मुश्किल में पड़ता है। महत्वपूर्ण बिंदु यह है कि ये लोग डिफॉल्ट करना नहीं चाहते। इसका मतलब है कि क्रेडिट जोखिम को संचालित करने वाले अंतर्निहित संबंध धीरे-धीरे बदलते हैं। यह हमें ऐसे रैखिक फीचर्स तैयार करने का समय देता है जो इन संबंधों को व्याख्यायोग्य तरीके से पकड़ें। हालाँकि, डिफॉल्ट के अन्य प्रकार भी हैं जो इतने सरल नहीं होते।
धोखाधड़ी का पता लगाना और रोकथाम
चिकित्सा में, मशीन लर्निंग जटिल चीजों की भविष्यवाणी करती है, जैसे कोई ट्यूमर सौम्य है या घातक। अब कल्पना करें कि ट्यूमर सचेत हो और पकड़े जाने से बचने के लिए अपना स्वरूप बदल सके। यह अचानक एक बहुत कठिन समस्या बन जाती है। इसी तरह, यही कारण है कि धोखाधड़ी का पता लगाना इतना कठिन है।
धोखाधड़ी के कई प्रकार होते हैं। स्वचालित ऋण स्वीकृति के संदर्भ में, धोखाधड़ी तब होती है जब उधारकर्ता ने कभी पुनर्भुगतान करने का इरादा ही नहीं किया। उसका लक्ष्य ऋण लेकर पैसे के साथ गायब होना है। उधारकर्ता ने अपनी मासिक आय बढ़ा-चढ़ाकर बताई हो सकती है, यह तथ्य छिपा सकता है कि उसके पास अन्य ऋण भी हैं, या आवेदन करने के लिए किसी की पहचान तक चुरा सकता है। वे जैसा भी यह करने में सफल हों, हम इसे धोखाधड़ीजन्य डिफॉल्ट मानेंगे।
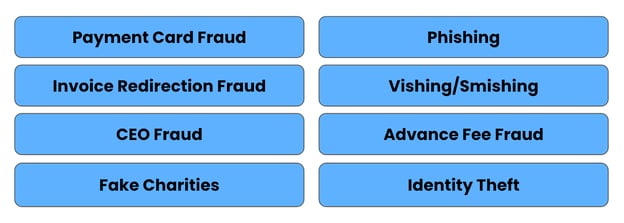
धोखाधड़ी के प्रकार (स्रोत: लेखक)
हम धोखाधड़ी की भविष्यवाणी कैसे करते हैं
क्रेडिट जोखिम डिफॉल्ट की प्रकृति का मतलब है कि हम किसी व्यक्ति के व्यवहार का सामान्य अंदाज़ा पाने के लिए लेन-देन को समेकित कर सकते हैं। धोखाधड़ी में, व्यक्तिगत लेन-देन महत्वपूर्ण हो सकते हैं। हम डिवाइस डेटा और संचार इतिहास जैसे अधिक विविध डेटा स्रोत भी देखते हैं।
एक और विचार यह है कि धोखाधड़ी की बदलती प्रकृति का मतलब है कि हमें मॉडलों को तेज़ी से जारी करना होगा। इस सबका मतलब है कि रैखिक मॉडल अक्सर चुनौती के अनुरूप नहीं होते।
इसीलिए Random Forests और XGBoost जैसे गैर-रैखिक मॉडलों का उपयोग आम है। यदि हम टेक्स्ट डेटा शामिल करना चाहें तो न्यूरल नेटवर्क भी मदद कर सकते हैं। इन मॉडलों के साथ, फीचर इंजीनियरिंग पर कम ज़ोर दिया जाता है, जिससे मूल्यवान समय बचता है और हमें ऐसे व्यवहारों का मॉडल बनाने की सुविधा मिलती है जिन्हें पूरी तरह समझा नहीं गया है।
नुकसान यह है कि ये सभी अभी भी भविष्यवाणी करने वाले मॉडल हैं। हम चाहते हैं कि नई धोखाधड़ी की घटनाओं को होने से पहले पकड़ लें। प्रेडिक्टिव मॉडलों के साथ, हमें लेबलयुक्त धोखाधड़ी मामलों का प्रशिक्षण डेटासेट चाहिए। दूसरे शब्दों में, हमें पहले धोखाधड़ी होने का इंतजार करना होगा!
इसीलिए हम अनसुपर्वाइज़्ड तरीकों, जैसे क्लस्टरिंग एल्गोरिदम या Isolation Forest जैसे सिंगल-क्लास मॉडलों का उपयोग करके संभावित धोखाधड़ी मामलों का आकलन भी कर सकते हैं। ये अनोखे व्यवहार वाले ग्राहकों या सामान्य शब्दों में आउटलायर्स की पहचान करने में मदद कर सकते हैं।
एडवर्सेरियल मशीन लर्निंग
धोखाधड़ी में, हमें मॉडलों को ही निशाना बनाने वाले हमलावरों की भी चिंता करनी होती है। यही कारण है कि धोखाधड़ी मॉडल कृत्रिम बुद्धिमत्ता की एक महत्वपूर्ण शाखा—एडवर्सेरियल मशीन लर्निंग—से ओवरलैप करते हैं।
यह क्षेत्र मॉडलों की छिपी कमजोरियों को खोजने का लक्ष्य रखता है जिनका हमलावर शोषण कर सकते हैं। कोई व्यक्ति मॉडल को गलत भविष्यवाणी करने या संवेदनशील जानकारी उगलवाने के लिए छल कर सकता है। पॉइज़निंग अटैक्स में प्रशिक्षण प्रक्रिया में नकली डेटा इंजेक्ट करके मॉडलों को हमारी जानकारी के बिना भ्रष्ट करना शामिल है।
ऋण स्वचालन के संदर्भ में, पहला अधिक प्रमुख है। मूलतः, एक फ्रॉडस्टर खुद को अच्छा ग्राहक दिखाने की कोशिश करेगा। वे अपने अनुमानित क्रेडिट जोखिम को घटाने के तरीके खोजने का लक्ष्य रखेंगे। यह अपनी आय को कृत्रिम रूप से बढ़ाकर या आवेदन में झूठ बोलकर हो सकता है। धोखाधड़ी मॉडल्स का उपयोग क्रेडिट जोखिम मॉडलों की इन संभावित कमजोरियों को कवर करने के लिए किया जाता है। फिर भी, स्वयं इन्हें भी संभावित एडवर्सेरियल हमलों के लिए परखा जाना चाहिए।
आखिरकार, धोखाधड़ी के कई प्रकार और उनकी प्रकृति का मतलब है कि हमें अक्सर अधिक जटिल मॉडलों पर निर्भर होना पड़ता है। कुछ मामलों में, ये मॉडल संभावित धोखाधड़ी के मामलों को फ़्लैग कर सकते हैं, जिनकी बाद में किसी मानव द्वारा अधिक गहन समीक्षा की जा सकती है।
AI के संदर्भ में, धोखाधड़ी मॉडल अक्सर ऋण स्वचालित रूप से स्वीकृत करने के लिए इस्तेमाल होने वाली प्रणालियों में क्रेडिट जोखिम मॉडलों के साथ-साथ चलते हैं। वे एक-दूसरे के पूरक हैं क्योंकि वे अलग-अलग कारणों से डिफॉल्ट की भविष्यवाणी करने का लक्ष्य रखते हैं।
धोखाधड़ी का पता लगाना और क्रेडिट जोखिम आकलन, दोनों नए ग्राहकों को प्राप्त करने के बारे में हैं—सही ग्राहकों को। एक बार जब वे उन्हें पा लेते हैं, तो बैंकों के सामने दूसरा सवाल होता है: उन्हें बनाए कैसे रखें? अगली दो धाराएँ देखेंगी कि AI कैसे मदद कर सकता है।
ग्राहक चर्न
बैंक यह अनुमान लगाने के लिए समान AI-संचालित रणनीतियाँ उपयोग करते हैं कि कोई ग्राहक छोड़ देगा या नहीं। इसका मतलब अपना बैंक खाता बंद करना या मॉर्गेज प्रदाता बदलना हो सकता है। वे बिना छोड़े भी अपना व्यवसाय घटा सकते हैं—ओवरड्राफ्ट हटाकर, क्रेडिट कार्ड रद्द करके, या बड़ी राशि किसी अन्य बैंक में स्थानांतरित करके।
बैंक चाहते हैं कि ये घटनाएँ होने से पहले ही वे हस्तक्षेप करें। वे असंतुष्ट ग्राहकों को कम ब्याज दरों, छूटों, या अन्य विशेष लाभों से मनाने की कोशिश करेंगे। इसका बहुत कुछ पूरी तरह स्वचालित प्रक्रिया हो सकता है।
बैंक यह भविष्यवाणी करने के लिए मॉडल का उपयोग करते हैं कि कोई व्यक्ति या व्यवसाय भविष्य के भुगतान चूकने की संभावना रखता है (यानी बकाया में जाएगा) या पूरी तरह डिफॉल्ट करेगा। फिर से, बैंक चाहते हैं कि यह होने से पहले वे कदम उठाएँ। वे वित्तीय सलाह दे सकते हैं या अपने ऋण का पुनर्गठन करने का अवसर प्रदान कर सकते हैं। यहाँ तक कि भविष्य के भुगतानों की याद दिलाने वाला एक साधारण स्वचालित संदेश भी प्रभावी हो सकता है।
ग्राहक सेवा और चैटबॉट्स
एक और क्षेत्र जहाँ स्वचालन मदद कर सकता है, वह है जब ग्राहक सक्रिय रूप से बैंक से सहायता माँगते हैं। उन्हें सेविंग्स खाता सेट करने या ऑनलाइन भुगतान करने पर सलाह की जरूरत हो सकती है। इनमे से कई प्रश्न दोहराए जाने वाले होंगे, और एक AI-संचालित चैटबॉट इन्हें सँभाल सकता है। यह तेज़ जवाब दे सकता है और अधिक जटिल कार्य मानवों के लिए छोड़ सकता है।
यह वह क्षेत्र भी है जहाँ सबसे उन्नत AI लागू किया जा सकता है। कई कंपनियाँ अपने चैटबॉट्स को LLMs और जनरेटिव AI का उपयोग करने के लिए अपडेट कर रही हैं। ये शक्तिशाली मॉडल बैंक के चैटबॉट को सुपरचार्ज कर चुके हैं, जिससे वह अधिक जटिल प्रश्नों को सँभाल सके और यहाँ तक कि व्यक्तिगत सलाह भी दे सके। हालाँकि, हमें बाद वाले के प्रति सावधान रहना चाहिए। यह उस अत्यधिक विनियमित वातावरण से जुड़ा है जिसमें बैंक काम करते हैं।
बैंकिंग में AI की चुनौतियाँ
बैंकिंग में AI के सामने आने वाली वास्तविक चुनौतियाँ अक्सर तकनीकी नहीं होतीं। डेटा प्रबंधन और मॉडल विकास के आसपास की समस्याएँ काफी हद तक सुलझ चुकी हैं। उन्नत AI तरीकों को अपनाने में आने वाली बाधाएँ बैंकों के परिचालन वातावरण, स्थापित प्रक्रियाओं, और जोखिम के प्रति कम सहनशीलता से आती हैं।
विनियमन, समझाने की क्षमता, और पारदर्शिता
2008 के वित्तीय संकट के बाद से, मान लीजिए कि बैंकों को अपने फैसले लेने की इतनी छूट नहीं दी जाती। वे कहीं अधिक कड़े नियामक वातावरण का सामना करते हैं जो यह निर्धारित करता है कि उन्हें पूंजी आरक्षित में कितना रखना है, वे कितना जोखिम ले सकते हैं, और यहाँ तक कि वे किस प्रकार की तकनीक लागू कर सकते हैं। अंतिम बिंदु का मतलब है कि कुछ कार्यों के लिए केवल कुछ प्रकार के मॉडल ही लागू किए जा सकते हैं। उदाहरण के लिए, पूंजी आरक्षित की गणना एक रैखिक मॉडल और पूर्वनिर्धारित फीचर्स से ही करनी पड़ सकती है।
अक्सर उधार निर्णय लेने की प्रक्रिया को स्पष्ट करने और औचित्य सिद्ध करने की आवश्यकता होती है। इसका मतलब नियामक को यह समझाना है कि मॉडल भविष्यवाणियाँ कैसे करते हैं। भले ही यह आवश्यक रूप से उन मॉडलों के प्रकारों को सीमित न करे जिन्हें हम उपयोग कर सकते हैं, यह प्रतिरोध तो पैदा करता ही है। जैसा कि उल्लेख किया गया, यही कारणों में से एक है कि क्रेडिट जोखिम मॉडलिंग में रैखिक मॉडलों का उपयोग होता है। गैर-रैखिक मॉडलों से प्रदर्शन में किसी भी सुधार को उन्हें समझाने के बढ़े हुए बोझ से कमतर आँका जाता है।
इस विषय पर Cynthia Rudin की अंतर्दृष्टि पर विचार करें:
ऐसे मॉडलों को बनाने की कोशिश करने के बजाय जो स्वभावतः व्याख्येय हों, हाल में “Explainable ML” पर काम का विस्फोट हुआ है, जहाँ पहले ब्लैक बॉक्स मॉडल को समझाने के लिए एक दूसरा (पोस्टहॉक) मॉडल बनाया जाता है। यह समस्याग्रस्त है। स्पष्टीकरण अक्सर विश्वसनीय नहीं होते और भ्रामक हो सकते हैं, जैसा कि हम नीचे चर्चा करते हैं। यदि हम इसके बजाय स्वभावतः व्याख्येय मॉडल का उपयोग करें, तो वे अपने स्पष्टीकरण स्वयं प्रदान करते हैं, जो वास्तव में मॉडल जो गणना करता है उसके अनुरूप होते हैं।
अन्य ऐसे अनुप्रयोग भी हैं जहाँ उन्नत तरीकों का उपयोग समझ में आता है। ग्राहक चर्न मॉडल और ग्राहक सेवा बॉट्स पर कम नियामक जांच हो सकती है।
धोखाधड़ी की भविष्यवाणी के लिए, बढ़ा हुआ प्रदर्शन ब्लैक बॉक्स मॉडलों को समझाने के काम में लगने वाले प्रयास के लिए पर्याप्त प्रेरणा देता है। इस स्थिति में, आपको अपने मॉडलों को समझाने के लिए SHAP जैसी एक्सप्लेनेबल AI विधियों का उपयोग करना पड़ेगा। संभवतः आपको एक्सप्लेनेबल AI विधि को भी समझाना पड़ेगा।
यदि आप SHAP और व्याख्येयता के बारे में और जानना चाहते हैं, तो SHAP मानों का यह परिचय और एक्सप्लेनेबल AI पर यह लेख देखें।
डेटा गोपनीयता और सुरक्षा
बैंकों के पास आपके जीवन के अंतरंग विवरणों तक पहुँच होती है। कल्पना कीजिए अगर किसी के हाथ आपके हर एक लेन-देन का रिकॉर्ड लग जाए। हर स्टोर जहाँ आप गए।
डेटा उल्लंघनों से बचने के लिए सुरक्षा कड़ी होनी चाहिए। यही एक मुख्य कारण है कि बैंक LLMs जैसी नई तकनीक से दूर रहेंगे। अक्सर इन मॉडलों का उपयोग करने के लिए डेटा को उनके API के जरिए किसी थर्ड पार्टी को भेजना पड़ता है। इसके सुरक्षा जोखिम संभावित फायदों से अधिक भारी पड़ते हैं।
साथ ही, बैंकों को इस बात के प्रति भी सजग रहना चाहिए कि वे अपने डेटा का उपयोग कैसे करते हैं। अब तक जिस विनियमन पर हमने चर्चा की, वह क्रेडिट जोखिम पर केंद्रित रहा है। बैंक अन्य विनियमों, जैसे GDPR, का भी सामना कर सकते हैं, जो यह सीमित करते हैं कि वे कौन सा डेटा एकत्र कर सकते हैं और उसका उपयोग कैसे कर सकते हैं।
इसके अतिरिक्त, EU AI अधिनियम यह सीमित करेगा कि AI का उपयोग कैसे किया जा सकता है। यह उन अन्य अनुप्रयोगों को प्रभावित कर सकता है जिन पर हमने चर्चा की। उदाहरण के लिए, उन्हें संभवतः आपके लेन-देन डेटा का उपयोग करके आपको नए उत्पादों का विपणन करने की अनुमति नहीं होगी। आप हमारे लेख What is the EU AI Act? A Summary Guide for Leaders में इस विधेयक के बारे में और जान सकते हैं।
नैतिक विचार
बैंकिंग में मॉडलों द्वारा लिए गए निर्णयों के गंभीर परिणाम हो सकते हैं। आपको मॉर्गेज से वंचित किया जा सकता है या किसी व्यवसाय को वह ऋण नहीं मिल सकता जिसकी उसे जीवित रहने के लिए सख्त जरूरत है।
यह बेहद आवश्यक है कि ये निर्णय निष्पक्षता से लिए जाएँ और किसी विशेष समूह के प्रति भेदभाव न करें। बैंक के अनुसार, यह कानून द्वारा आवश्यक हो सकता है या उसकी प्रतिष्ठा की रक्षा की इच्छा द्वारा प्रेरित।
स्वचालन में अन्याय को कम करने की क्षमता है। उधार निर्णयों का केंद्रीकरण करके और उन्हें अधिक पारदर्शी बनाकर, हम व्यक्तिगत मानव पूर्वाग्रहों के प्रभाव को कम कर सकते हैं। इसलिए यह और भी महत्वपूर्ण है कि उन निर्णयों को संचालित करने वाले मॉडल अन्यायपूर्ण न हों। इसे सुनिश्चित करने का एक तरीका एल्गोरिदमिक निष्पक्षता विश्लेषण का उपयोग करना है। यह लिंग, नस्ल और मूल देश जैसे संरक्षित चरों के आधार पर मॉडल प्रदर्शन का मूल्यांकन करता है।
बैंकों द्वारा अपनाई जाने वाली निष्पक्षता की एक और पद्धति ग्राहक को स्वचालित निर्णय को चुनौती देने की अनुमति देना है। उन्हें यह अनुरोध करने की भी अनुमति होनी चाहिए कि कोई निर्णय क्यों लिया गया। इसका मतलब है कि ऑटो स्वीकार और ऑटो अस्वीकार के साथ, प्रणालियों में तीसरा विकल्प होगा—“लेंडर को संदर्भित।” कोई मानव यह आकलन करेगा कि स्वचालित निर्णय क्यों लिया गया और अन्यायपूर्ण निर्णयों को सुधारेगा।
यह सभी अनुप्रयोगों में सरल रैखिक मॉडलों को प्राथमिकता देने का एक और कारण है। जैसा कि उल्लेख किया गया, ये स्वभावतः व्याख्येय हैं। इन्हें समझना आसान होने का मतलब है कि अधिक व्यापक समूह इनके आलोचनात्मक विश्लेषण कर सकते हैं। किसी भी समस्या की पहचान मॉडल के परिनियोजन से पहले की जा सकती है जो संभावित पक्षपात की ओर ले जाए।
बदलाव के प्रति प्रतिरोध
विनियमन, सुरक्षा चिंताएँ, और नैतिक विचार उन्नत AI तरीकों को अपनाने में बाधाएँ प्रस्तुत करते हैं। फिर भी, सबसे बड़ा अवरोध खुद बैंक हो सकता है।
बैंक, खासकर बड़े स्थापित बैंक, बहुत जोखिम-निरपेक्ष होते हैं। उनके पास मॉडल और स्कोरकार्ड बनाने के स्थापित तरीके हैं। वे तो वही ऐतिहासिक प्रारूप तक उपयोग करते हैं!
इन तरीकों से किसी भी विचलन के लिए महत्वपूर्ण औचित्य चाहिए होगा, और आपको प्रशासन की कई परतों को मनाना पड़ेगा। संक्षेप में, बड़े बैंक धीरे चलते हैं।
इसीलिए स्टार्ट-अप्स और फिनटेक कंपनियाँ इन तरीकों को अपनाने की बेहतर स्थिति में हैं। उनके पास प्रक्रियाएँ कम होती हैं और वे आमतौर पर कम जोखिम-निरपेक्ष होते हैं। हालाँकि, उनके पास बड़े बैंकों जैसी पूँजी और उन विनियमों का अनुपालन करने के लिए आवश्यक कार्यबल की कमी होती है जिनकी हमने बात की। समय के साथ, उन्नत AI से मिलने वाले बढ़ते मूल्य के जरिए छोटे खिलाड़ी इन फायदों में सेंध लगा सकते हैं।
लगातार अपस्किलिंग की आवश्यकता
जैसा कि हमने देखा, बैंकिंग क्षेत्र में AI लागू करने की चुनौतियाँ अनेक हैं—नियामकीय अनुपालन और मॉडल की व्याख्येयता से लेकर डेटा गोपनीयता और नैतिक विचारों तक। ये जटिलताएँ इस आवश्यकता को रेखांकित करती हैं कि फाइनेंस टीमें AI और डेटा साइंस से न केवल परिचित हों, बल्कि उन्हें जिम्मेदारी से और प्रभावी ढंग से लागू करने में दक्ष हों।
इस बदलते परिदृश्य में आगे बढ़ने के लिए, लगातार अपस्किलिंग आवश्यक है। सुनिश्चित करना कि आपकी फाइनेंस टीम डेटा साइंस और AI के ताज़ा ज्ञान से लैस है, केवल एक लाभ नहीं—प्रतिस्पर्धी बने रहने की शर्त है। यहीं DataCamp for Business जैसे प्लेटफ़ॉर्म काम आते हैं। डेटा साइंस, मशीन लर्निंग, और AI में व्यापक प्रशिक्षण संसाधन प्रदान करते हुए, DataCamp for Business आपकी टीम को डेटा-चालित माहौल में उत्कृष्टता पाने के लिए जरूरी औज़ार देता है। कस्टम लर्निंग पाथ और विस्तृत परफॉर्मेंस इनसाइट्स जैसी सुविधाओं के साथ, आप प्रगति की निगरानी कर सकते हैं और अपने विशिष्ट व्यवसायिक लक्ष्यों के अनुरूप सीखने के अनुभव को अनुकूलित कर सकते हैं।
अपस्किलिंग में निवेश करके, आप अपनी टीम को बैंकिंग में AI की चुनौतियों से सीधे निपटने में सक्षम बनाते हैं, यह सुनिश्चित करते हुए कि वे उद्योग के कड़े नियामकीय और नैतिक मानकों का पालन करते हुए उन्नत तरीकों को लागू करने के लिए तैयार हैं। अधिक जानने के लिए आज ही डेमो का अनुरोध करें।
बैंकिंग में AI का भविष्य
जब हम बैंकिंग में AI के भविष्य की ओर देखते हैं, तो हमें मानना होगा कि उन्नत तरीकों की महत्वपूर्ण भूमिका होगी।
जनरेटिव AI विशेष रूप से महत्वपूर्ण है। भले ही इन मॉडलों को ग्राहक-सामना अनुप्रयोगों में लागू करना जोखिम भरा हो सकता है, ये ऐसे उत्पादों और मॉडलों के विकास में उपयोगी हो सकते हैं जो ग्राहक-सामना हों। इन्हें क्रेडिट जोखिम की भविष्यवाणी करने के लिए नहीं, बल्कि क्रेडिट जोखिम मॉडल बनाने में मदद करने के लिए उपयोग किया जाता है। यह खास तौर पर तब सही है जब हम बैंकिंग में बनने वाले मॉडलों की नियमित प्रकृति पर विचार करते हैं।
कई बैंक इसे एक कदम आगे ले जाएंगे। बैंकों के पास, सभी संगठनों की तरह, बहुत सारा आंतरिक दस्तावेजीकरण होता है। इसमें कॉरपोरेट गवर्नेंस, ऐतिहासिक विश्लेषण, और मॉडलिंग प्रक्रियाएँ शामिल हो सकती हैं। LLMs द्वारा संचालित RAG प्रणालियाँ इस ज्ञान-संपदा को सर्चेबल डेटाबेस और आंतरिक चैटबॉट में बदल सकती हैं। आप इसे एक सहायक सहकर्मी की तरह समझ सकते हैं जो बैंक के बारे में सब कुछ जानता है और आपको जल्दी गति पकड़ने में मदद करने को आतुर रहता है।
कुछ कंपनियाँ ग्राहक-सामना उत्पादों में LLMs के उपयोग से जुड़े जोखिमों को भी झेल सकती हैं। ये आपकी बैंकिंग डेटा के आधार पर ग्राहकों को वित्तीय सलाह जैसी चीजों को स्वचालित कर सकते हैं। हालाँकि, मतिभ्रम और गलत सलाह की गंभीरता मिलकर स्थापित बैंकों के लिए इसे शायद बहुत जोखिम भरा बना देंगी—कम से कम मौजूदा LLM स्तर के साथ।
निष्कर्ष
बैंकिंग उद्योग में काम करने वाले एक डेटा वैज्ञानिक के रूप में, लगातार सीखना महत्वपूर्ण है, लेकिन साथ ही यह आलोचनात्मक रूप से सोचना भी कि नई तकनीक को कैसे लागू किया जा सकता है। हमने कई संभावित अनुप्रयोगों पर चर्चा की, जिनमें क्रेडिट जोखिम, धोखाधड़ी, और ग्राहक चर्न शामिल हैं।
नई तकनीक से अवगत रहना महत्वपूर्ण है क्योंकि उन्नत AI तरीके इनमें से कुछ क्षेत्रों में लागू किए जा सकते हैं। हालाँकि, अक्सर आप पाएँगे कि डेटा साइंस और मशीन लर्निंग की बुनियादी बातों की मजबूत समझ अधिक महत्वपूर्ण है।
जैसे-जैसे उद्योग परिपक्व होता है, हमें AI का अधिक समग्र दृष्टिकोण भी अपनाना होगा। जिम्मेदार AI कौशल ऐसे संसार में अत्यावश्यक हैं जहाँ मशीन लर्निंग बढ़ती जाँच-पड़ताल और कानून का सामना कर रही है। हमें समझना होगा कि मॉडलों की व्याख्या कैसे करें, यह सुनिश्चित करें कि वे निष्पक्ष हों, और संवेदनशील डेटा सुरक्षित रहे। ये कई नई चुनौतियाँ हैं जिनका बैंक सामना कर रहे हैं, और यदि हम AI अपनाना चाहते हैं तो हमें अनुकूलन करना होगा।
यदि आप जिम्मेदार AI के बारे में और जानना चाहते हैं, तो AI नैतिकता पर यह पाठ्यक्रम देखें।

कॉनर तटीय मॉनिटरिंग के लिए मशीन लर्निंग पर पीएचडी कर रहे हैं। उनके पास बैंकिंग और सेमीकंडक्टर मैन्युफैक्चरिंग उद्योग में डेटा साइंटिस्ट के रूप में काम करने का अनुभव भी है।
“1 बिलियन यूरो?” मुझे पक्का करना पड़ा कि मैंने सही सुना है।
जब मैंने सुना कि क्रेडिट जोखिम मॉडल एक साल में अपने-आप जितनी राशि स्वीकृत कर देंगे—वही मॉडल जिन पर मैं काम करने वाला था!—तो मैं दंग रह गया। और भी ज्यादा तब चौंका जब समझा कि इस पैसे को संभालने वाली AI प्रणालियाँ साधारण रिग्रेशन मॉडलों से संचालित थीं। इससे मुझे एक अहम सबक मिला—सर्वोत्तम समाधान हमेशा सबसे जटिल नहीं होता।
आयरलैंड के एक बड़े बैंक में काम करते हुए, मैंने AI के कई उपयोग देखे। ऋण स्वीकृति के अलावा, इनमें धोखाधड़ी का पता लगाना, चर्न मॉडलिंग, और ग्राहक सेवा बॉट्स शामिल हैं। हम इन सभी अनुप्रयोगों और इनके सामने आने वाली चुनौतियों पर बात करेंगे।
नियमन, मॉडल की व्याख्येयता, नैतिक विचार, और बदलाव के प्रति प्रतिरोध जैसी चुनौतियों के कारण, उद्योग अक्सर सरल समाधानों को तरजीह देता है। फिर भी, हम देखेंगे कि कुछ स्थानों पर उन्नत AI तरीकों की जरूरत पड़ती है। अंत में, हम चर्चा करेंगे कि भविष्य में इनमें से कुछ का उपयोग कैसे हो सकता है।
आप हमारे अलग वेबिनार में नेताओं को जिम्मेदारी से AI लागू करने के बारे में क्या जानना चाहिए खोज सकते हैं।