Programa
Fundamentos do Negócio de IA
12 h
Treine sua equipe financeira com o DataCamp for Business. Recursos abrangentes de treinamento em dados e IA e insights detalhados de desempenho para apoiar suas metas.
De calcular reservas de capital a avaliar estratégias de marketing, a análise estatística orienta quase todas as decisões de um banco. Muitas pessoas — cientistas de dados, analistas, gestores, líderes de negócio e reguladores — frequentemente precisam avaliar as análises ou os relatórios baseados nelas.
As previsões de modelos estatísticos e de machine learning podem ser parte importante dessa análise. No entanto, usá-los dessa forma não seria considerado IA.
Falamos em IA quando um modelo é usado para automatizar uma decisão. Suas previsões alimentam um sistema. Esse sistema contém regras baseadas na previsão e em outras variáveis que levam a uma decisão. Chamamos isso de “sistemas de IA”.
O time em que trabalhei atuava principalmente no desenvolvimento desses sistemas para aprovar automaticamente novos empréstimos. O modelo mais importante por trás desses sistemas é o chamado modelo de risco de crédito.
Quando você solicita um empréstimo a um banco, passa por uma avaliação de risco de crédito. Isso pode envolver calcular a perda esperada em caso de inadimplência ou a probabilidade de você ficar inadimplente — ou seja, a chance de não conseguir pagar o empréstimo por dificuldades financeiras. É essa segunda previsão que geralmente orienta a decisão de aprovar (conceder) um empréstimo.
Desde antes da invenção dos computadores, bancos já faziam avaliações de risco de crédito. Isso era feito principalmente por meio de um “scorecard de crédito”.
Como visto abaixo, ele considera vários atributos de um potencial tomador. Você recebe uma pontuação com base no grupo em que se enquadra para cada atributo, e todas as pontuações são somadas para chegar a um score final. Quanto maior seu score, menor a probabilidade de inadimplência.
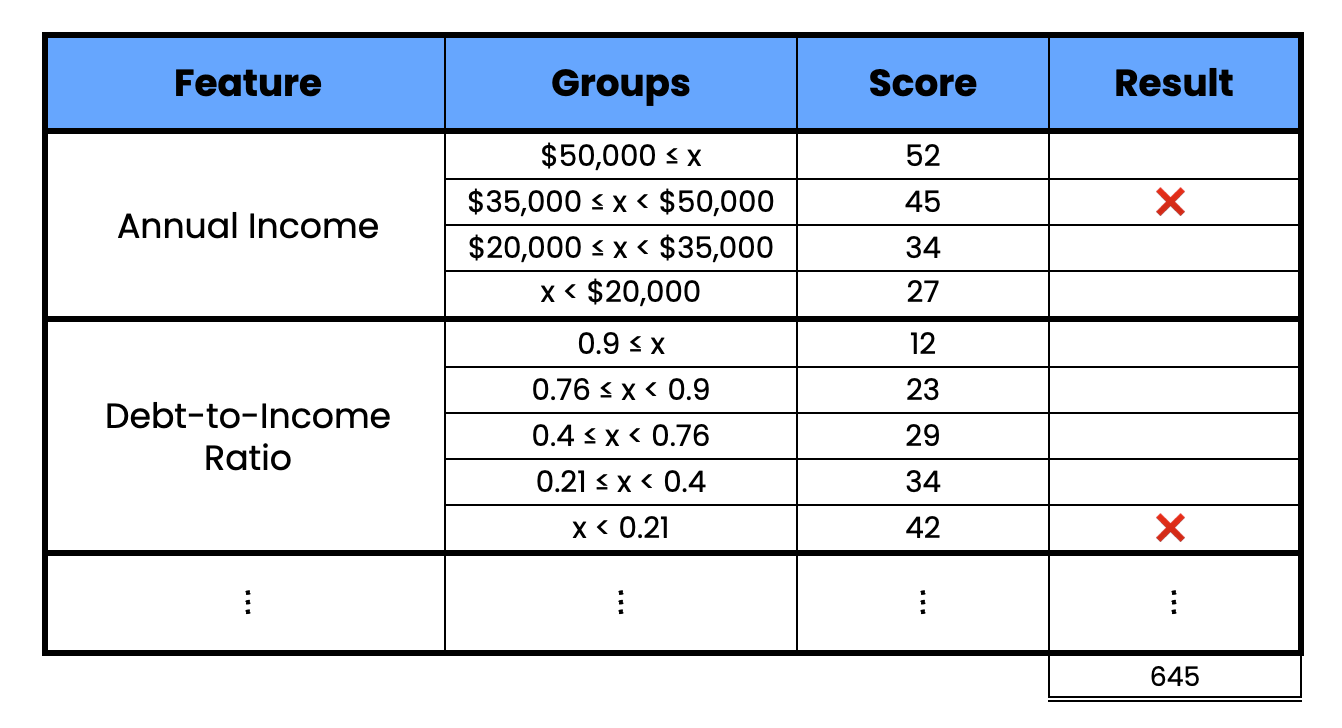
Exemplo de scorecard de crédito (fonte: autor)
No passado, eles eram criados principalmente por “juízo de especialistas”. Em outras palavras, alguém de terno definia os valores. E, sim, isso era tão tendencioso quanto parece. Hoje, os bancos têm acesso a grandes volumes de dados e poder computacional para criar scorecards estatisticamente ótimos. Como veremos adiante, isso também pode gerar resultados mais justos.
Em termos de dados, há muito com o que trabalhar. Internamente, um banco tem acesso a todo o seu histórico de transações e comportamento de pagamento de dívidas. Externamente, a maioria dos países possui registros públicos de dívidas e inadimplências em todas as instituições de crédito.
Todas essas fontes podem ser usadas para criar variáveis de modelo. Alguns bancos podem ir além e usar dados de dispositivo, como sua geolocalização. Embora, a partir desse ponto, eles podem esbarrar em questões regulatórias e éticas.
O processo de construção desses scorecards mudou muito, mas o produto final se parece com o de antes. As variáveis são discretizadas. Isso é feito usando o Weight of Evidence (WOE) para maximizar a diferença nas taxas de inadimplência entre grupos de cada variável. Em seguida, podemos atribuir uma pontuação com base no quanto cada grupo altera a probabilidade de inadimplência. Assim, como antes, o score final pode ser usado para avaliar a chance de o tomador atrasar um empréstimo.
Esses scorecards de crédito formam a base de um sistema de IA usado para aprovar empréstimos automaticamente. Na forma mais simples, há um corte rígido: se o score fica abaixo do limite, o empréstimo é negado.
Regras adicionais podem ser definidas conforme a estratégia do banco, a regulação ou outros atributos, como a idade do cliente. Como veremos na próxima seção, sistemas mais complexos podem usar previsões de vários modelos.
Na prática, esses sistemas de IA são usados para aprovar empréstimos pessoais ou para pequenos negócios. Valores maiores, como hipotecas ou crédito corporativo, não são totalmente automatizados. Esses casos podem ser muito únicos, ou o montante é grande demais para ser aprovado sem que um humano tome a decisão final. Muitas vezes, a decisão ainda será tomada com o apoio de um scorecard.
Com todos os avanços em coleta de dados e automação, você poderia esperar que os modelos por trás disso fossem complexos. Você se enganaria.
A regressão logística é usada para calcular probabilidades de inadimplência e criar scorecards. Discutimos alguns motivos para isso na seção de desafios: interpretabilidade do modelo, regulação e justiça. Porém, o principal motivo é que a regressão logística é suficientemente precisa.
A inadimplência de que falamos ocorre quando alguém enfrenta problemas financeiros por decisões ruins ou eventos fora do seu controle. O ponto importante é que essas pessoas não querem ficar inadimplentes. Isso significa que os relacionamentos subjacentes que determinam o risco de crédito se movem lentamente. Isso nos dá tempo para criar variáveis lineares que capturam esses relacionamentos de forma interpretável. Porém, há outros tipos de inadimplência que não são tão simples.
Na medicina, o machine learning prevê coisas complexas, como se um tumor é benigno ou maligno. Agora, imagine se o tumor fosse consciente e pudesse mudar sua aparência para evitar a detecção. De repente, o problema fica muito mais difícil. É por isso que detectar fraude é tão desafiador.
Existem muitos tipos de fraude. No contexto de aprovação automática de empréstimos, há fraude quando o tomador nunca pretendeu pagar. O objetivo é pegar o dinheiro e desaparecer. A pessoa pode ter superestimado sua renda mensal, escondido outras dívidas a pagar ou até roubado a identidade de alguém para fazer a solicitação. De qualquer forma que consiga, consideramos essa inadimplência por fraude.
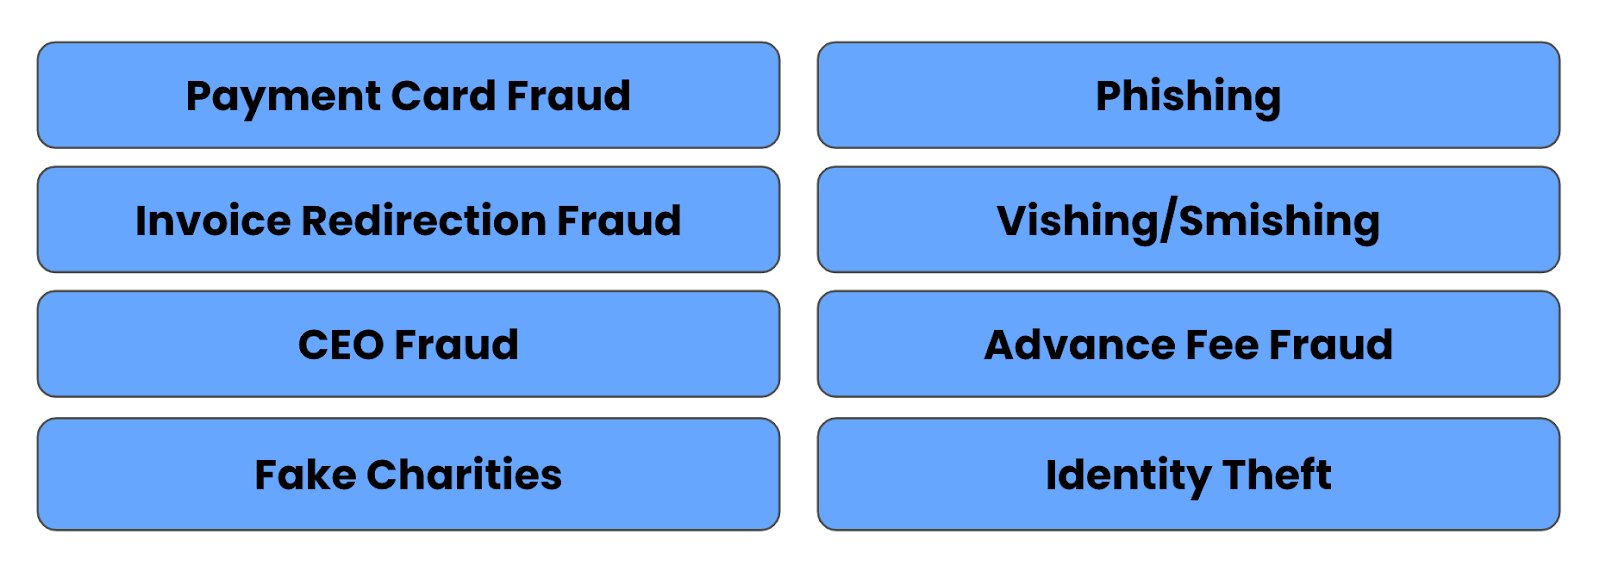
Tipos de fraude (fonte: autor)
Pela natureza da inadimplência de risco de crédito, podemos agregar transações para ter uma noção geral do comportamento da pessoa. Para fraude, transações individuais podem ser importantes. Também olhamos para um conjunto mais diverso de fontes de dados, como dados de dispositivo e histórico de comunicações.
Outra consideração é que, como a fraude muda de forma constante, precisamos colocar modelos em produção mais rápido. Tudo isso significa que modelos lineares muitas vezes não dão conta do recado.
Por isso é comum usar modelos não lineares, como Random Forests e XGBoost. Redes neurais também ajudam quando queremos incorporar dados de texto. Com esses modelos, colocamos menos ênfase em engenharia de atributos, ganhando tempo e permitindo modelar comportamentos que não entendemos completamente.
O lado negativo é que todos esses ainda são modelos preditivos. Queremos identificar novos casos de fraude antes de acontecerem. Com modelos preditivos, precisamos de um conjunto de treino com casos de fraude rotulados. Em outras palavras, primeiro precisamos esperar a fraude acontecer!
Por isso, também avaliamos potenciais casos de fraude com métodos não supervisionados, como algoritmos de clusterização ou modelos de classe única, como o Isolation Forest. Eles ajudam a identificar clientes com comportamentos atípicos ou, de forma geral, outliers.
Em fraudes, também precisamos nos preocupar com atacantes mirando os próprios modelos. Por isso, modelos de fraude se sobrepõem a um ramo importante da inteligência artificial: o adversarial machine learning.
Esse campo busca encontrar fraquezas ocultas em modelos que possam ser exploradas por atacantes. Alguém pode enganar o modelo para fazer previsões incorretas ou vazar informações sensíveis. Ataques de envenenamento envolvem injetar dados falsos no processo de treino para corromper modelos sem que percebamos.
No caso de automação de empréstimos, o primeiro tipo é o mais proeminente. Essencialmente, um fraudador tentará parecer um bom cliente. Ele buscará formas de reduzir o risco de crédito percebido, como inflar artificialmente a renda ou mentir na aplicação. Modelos de fraude cobrem essas potenciais brechas nos modelos de risco de crédito. Ainda assim, eles próprios devem ser avaliados para possíveis ataques adversariais.
Em última análise, a variedade e a natureza das fraudes frequentemente exigem modelos mais complexos. Em alguns casos, esses modelos sinalizam possíveis fraudes para uma análise mais profunda por um humano.
Em termos de IA, modelos de fraude geralmente rodam em paralelo aos de risco de crédito em sistemas que aprovam empréstimos automaticamente. Eles se complementam, pois buscam prever inadimplência por razões diferentes.
Tanto a detecção de fraude quanto a avaliação de risco de crédito tratam de adquirir novos clientes. Os clientes certos. Depois de conquistá-los, os bancos encaram outro problema: como mantê-los? As próximas duas seções mostram como a IA pode ajudar.
Os bancos usam estratégias com IA para prever se um cliente vai sair. Isso pode significar encerrar a conta ou trocar de credor imobiliário. Também podem reduzir o relacionamento sem sair de fato, cancelando o cheque especial, encerrando um cartão de crédito ou transferindo um grande valor para outro banco.
Os bancos querem agir antes que esses eventos ocorram. Eles tentam convencer clientes insatisfeitos com taxas menores, descontos ou outros benefícios. Muito disso pode ser totalmente automatizado.
Bancos também usam modelos para prever se uma pessoa ou empresa provavelmente vai atrasar pagamentos futuros (entrar em atraso) ou inadimplir de vez. Mais uma vez, o banco quer agir antes disso. Pode oferecer aconselhamento financeiro ou a chance de reestruturar a dívida. Até uma mensagem automática simples lembrando de pagamentos futuros pode ser eficaz.
Outra área em que a automação ajuda é quando clientes buscam ativamente suporte do banco. Eles podem precisar de orientação para abrir uma poupança ou fazer pagamentos online. Muitas dessas dúvidas são repetitivas e um chatbot com IA pode resolvê-las. Ele responde mais rápido e deixa as tarefas mais complexas para humanos.
Essa também é uma área em que a IA mais avançada pode ser aplicada. Muitas empresas estão atualizando seus chatbots com LLMs e IA generativa. Esses modelos poderosos turbinam o chatbot do banco, permitindo lidar com questões mais complexas e até oferecer conselhos personalizados. Porém, devemos ter cautela com esse último ponto — por conta do ambiente altamente regulado em que os bancos operam.
Os desafios reais da IA na área bancária muitas vezes não são técnicos. Problemas de gestão de dados e desenvolvimento de modelos em grande parte já foram resolvidos. Os obstáculos à adoção de métodos avançados de IA vêm do ambiente em que os bancos atuam, de procedimentos estabelecidos e da baixa tolerância ao risco.
Desde a crise financeira de 2008, digamos que os bancos não têm tanta liberdade para decidir sozinhos. Eles enfrentam um ambiente regulatório muito mais rígido, que determina o quanto precisam manter em reservas de capital, o nível de risco que podem assumir e até os tipos de tecnologia que podem implementar. Este último ponto significa que apenas certos tipos de modelos podem ser aplicados a algumas tarefas. Por exemplo, reservas de capital podem ter que ser calculadas com um modelo linear e variáveis predefinidas.
Frequentemente é preciso esclarecer e justificar o processo de tomada de decisão de crédito. Isso implica explicar a um regulador como os modelos fazem previsões. Embora isso não restrinja necessariamente o tipo de modelo que podemos usar, cria resistência. Como mencionado, esse é um dos motivos pelos quais modelos lineares são usados em risco de crédito. Qualquer ganho de desempenho com modelos não lineares é superado pelo peso extra de precisar explicá-los.
Considere as reflexões de Cynthia Rudin sobre o tema:
Em vez de tentar criar modelos intrinsecamente interpretáveis, houve recentemente uma explosão de trabalhos em “ML explicável”, em que um segundo modelo (pósexplicação) é criado para explicar o primeiro modelo caixa‑preta. Isso é problemático. As explicações muitas vezes não são confiáveis e podem ser enganosas, como discutimos abaixo. Se usarmos modelos intrinsecamente interpretáveis, eles fornecem suas próprias explicações, fiéis ao que o modelo realmente computa.
Cynthia Rudin, Duke University, Durham, NC, USA
Transforme seus negócios capacitando sua equipe com habilidades avançadas de IA por meio do DataCamp for Business. Obtenha melhores insights e eficiência.
Saiba mais sobre IA!
Programa
Curso
Curso
blog
Nahla Davies
15 min
blog
Maria Eugenia Inzaugarat
12 min
blog
Natasha Al-Khatib
14 min
blog
Bhavishya Pandit
7 min
blog
Javier Canales Luna
14 min
blog
Bhavishya Pandit
9 min