
Cursus
Concepten voor AWS-beveiliging en kostenbeheer
3 uur
11K
Met de zojuist genoemde functies in gedachten, hier een beknopt overzicht van de voordelen van Athena:
|
Voordeel |
Functie |
Beschrijving |
|
Kostenefficiëntie |
Pay-per-query-model |
Je betaalt alleen voor de data waarmee je queries interactie hebben; geen initiële kosten of complexe licenties; kostenoptimalisatie is mogelijk met partitionering, datacompressie en kolomgebaseerde formaten. |
|
Gebruiksgemak |
Serverless & standaard SQL |
Je hoeft geen infrastructuur op te zetten of te beheren; je kunt binnen enkele minuten beginnen met data bevragen met vertrouwde SQL-syntax, wat het toegankelijk en eenvoudig maakt. |
|
Flexibiliteit |
Ondersteuning voor meerdere formaten |
Ondersteunt een breed scala aan dataformaten (zoals CSV, JSON, Parquet), waardoor je data in het oorspronkelijke formaat direct vanuit S3 kunt bevragen, zonder ETL-processen. |
|
Snelle inzichten |
Snelle analyse & directe S3-queries |
Maakt directe data-analyse mogelijk dankzij de serverloze architectuur, zodat je snel inzichten uit S3-data haalt en de time-to-value voor datagedreven beslissingen verkort. |
We hebben Athena gedefinieerd en de functies en voordelen genoemd, maar waar gebruik je het voor? In dit deel behandelen we enkele van de populairste use-cases.
Amazon Athena wordt vaak gebruikt voor loganalyse, met name voor het bevragen en analyseren van logs die in Amazon S3 zijn opgeslagen. Organisaties genereren vaak enorme hoeveelheden logdata uit verschillende bronnen, zoals applicatielogs, serverlogs en accesslogs.
Door deze logs in S3 op te slaan en met Athena te bevragen, kunnen gebruikers snel trends identificeren, problemen diagnosticeren en systeemprestaties monitoren zonder een complexe setup.
Athena’s serverloze architectuur en ondersteuning voor standaard SQL maken het een uitstekend hulpmiddel voor ad-hoc data-exploratie. Of je nu data scientist, analist of engineer bent: met Athena kun je snel data in S3 bevragen zonder het in een traditionele database te laden.
Nu organisaties steeds vaker data lakes inzetten om grote hoeveelheden ruwe en verwerkte data op te slaan, fungeert Athena als een krachtige queryengine voor deze data lakes. Het laat je analyses uitvoeren direct op data in S3 en is daarmee een integraal onderdeel van een moderne data lake-architectuur.
Athena wordt ook vaak gebruikt als onderdeel van een business intelligence (BI)-stack, waarbij het integreert met BI-tools zoals Amazon QuickSight voor visualisatie en rapportage. Door data in S3 met Athena te bevragen en in QuickSight te visualiseren, kunnen organisaties interactieve dashboards en rapporten maken voor besluitvorming.
Als je bekend bent met Amazon Redshift, vraag je je misschien af hoe het verschilt van Athena.
Hoewel zowel Athena als Redshift met datasets werken, verschillen hun doelen. Redshift’s primaire use-case is datawarehousing en reguliere analytics met big data. AWS Athena richt zich op ad-hoc analyses van data die in S3 is opgeslagen.
Hier is een gedetailleerde vergelijking tussen Athena en Redshift:
|
Criteria |
Amazon Athena |
Amazon Redshift |
|
Architectuur |
Serverloze queryservice; draait SQL-queries direct op data in Amazon S3 met automatische schaalvergroting; geen infrastructuurbeheer. |
Volledig beheerd datawarehouse; vereist een datawarehousecluster met dedicated infrastructuur; kan schalen op basis van behoefte. Er is een Redshift Serverless-optie beschikbaar. |
|
Use-cases |
Ideaal voor ad-hoc query’s en analytics op S3-data en voor scenario’s die flexibiliteit en kostenefficiëntie prioriteren zonder datatransformatie. |
Geschikt voor complexe, grootschalige analytics en rapportage; ideaal voor gestructureerde data die vaak wordt bevraagd en getransformeerd. |
|
Kostenstructuur |
Pay-per-query-model: kosten op basis van de hoeveelheid data die door queries wordt gescand; kosteneffectief voor intermitterende of variërende workloads. |
Prijsstelling op basis van clustergrootte en gebruik; gereserveerde instances beschikbaar voor voorspelbare, hoge queryvolumes. |
|
Prestaties |
Afhankelijk van datasize en -formaat; te optimaliseren met partitionering en compressie; het best voor kleinere, minder complexe queries. |
Hoge prestaties voor complexe queries; gebruikt kolomopslag, parallelle verwerking en geavanceerde optimalisatie voor intensieve workloads. |
|
Dataintegratie |
Bevraagt data direct in S3 zonder transformatie of laden; ondersteunt diverse formaten en uitbreidbare connectors, waaronder Redshift. |
Vereist dat data in het warehouse wordt geladen, integreert met AWS-services en ondersteunt diverse data-invoermethoden, maar leest alleen uit eigen opgeslagen data. |
Tijd om praktisch aan de slag te gaan: Athena instellen en wat queries draaien!
Om AWS Athena te gebruiken heb je een AWS-account nodig. Als je die nog niet hebt, moet je er een aanmaken. Volg hiervoor de instructies in de AWS-setupgids.
Hoewel er geen free tier is voor AWS Athena, zou je 2-3 kleine testqueries (~10MB) moeten kunnen draaien om te begrijpen hoe het systeem werkt. Volg de instructies op het portaal en verifieer je identiteit. Log daarna in op je AWS-account.
Zoals alle Amazon AWS-producten gebruikt Athena IAM (identity and access management)-beleid voor rechten. Jij bent de rootgebruiker van je account en zou de rechten moeten hebben om Athena-queries op je eigen S3-buckets uit te voeren.
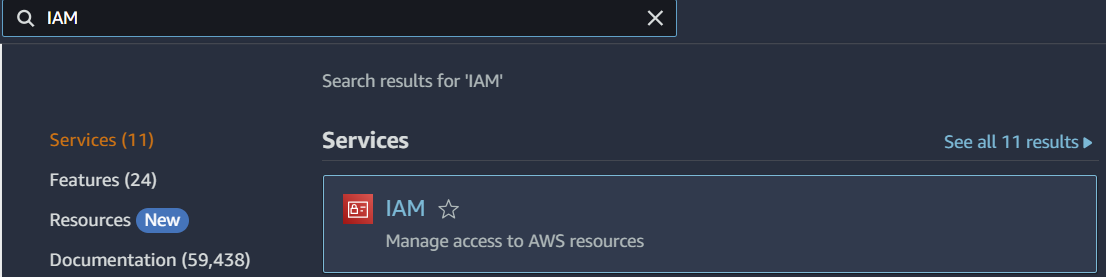
Je beheert IAM-rechten door in de bovenste zoekbalk in je AWS-startdashboard naar de IAM-service te zoeken en deze volledige IAM-gids te gebruiken. De AWS-documentatie geeft ook meer informatie over de specifieke setup van Athena.
Voordat we queries uitvoeren, moeten we een S3-bucket instellen om onze data op te slaan.
Amazon S3 staat voor Simple Storage Service en is een cruciaal onderdeel van hoe AWS opslag en data in de cloudomgeving beheert. Volg deze goed geschreven gids over het aanmaken van Amazon S3-buckets om de opslagomgeving voor onze data en queries te creëren.
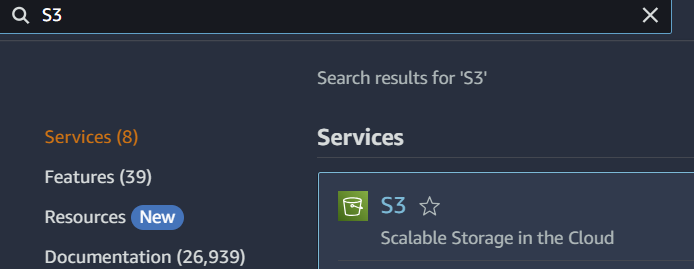
Kort gezegd: zoek de S3-service via de zoekbalk om op de S3-homepagina te komen:
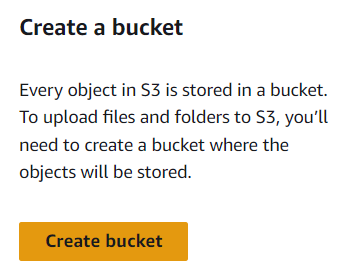
Op de homepage zie je rechts de knop “Create Bucket”. Volg de instructies op deze pagina om een bucket te maken waarin je Athena-service queryresultaten kan opslaan.
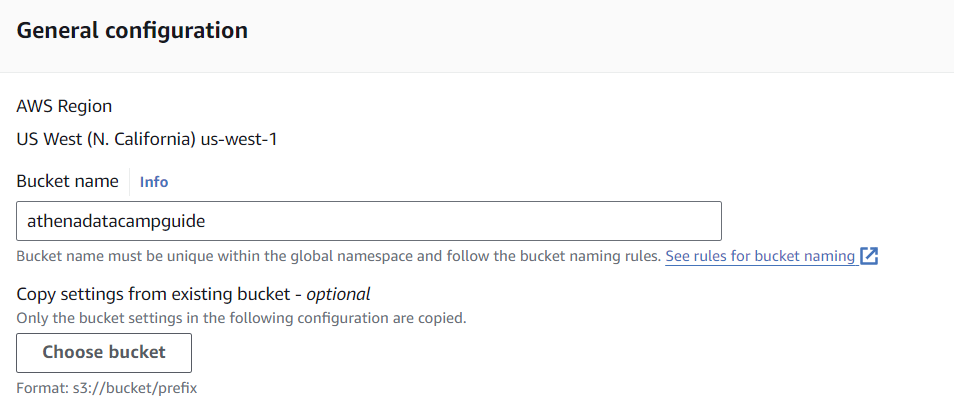
Ik maak een bucket genaamd “athenadatacampguide” met alle andere opties op standaard. Omdat bucketnamen wereldwijd uniek moeten zijn binnen AWS, moet jij voor deze tutorial een andere naam kiezen.
Nu moeten we deze bucket koppelen aan Athena. Ik ga naar de Athena-console en klik op “Edit Settings” in de kleine meldingbalk bovenaan.
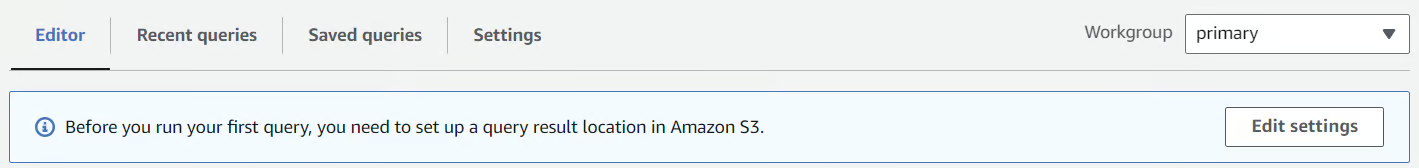
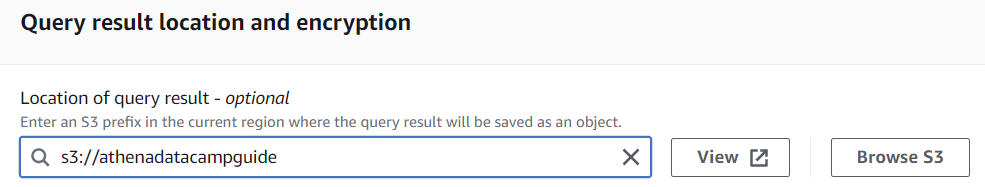
Daarna selecteer ik de zojuist gemaakte bucket. Gebruik de knop “Browse S3” rechts om je bucket te vinden of typ de naam met “s3://” ervoor.
Zodra de bucket is geselecteerd, klik je op “Save” en keer je terug naar de Editor door erop te klikken in de bovenste werkbalk.
AWS Athena organiseert data hiërarchisch. Het gebruikt “datacatalogi”—een groep databases, ook wel schema’s genoemd.
De tabellen die we bevragen staan binnen de databases. Om een nieuwe datacatalogus te maken, kun je Amazon Lambda gebruiken en met een externe databon aansluiten. De datacatalogus kan vervolgens worden opgeslagen als een Lambda-, Hive- of Glue-datacatalogus.
Standaard gebruikt AWS de Glue-service als centrale opslagplaats voor de datacatalogus. We richten ons op het opzetten van een database die onze tabellen voor queries bevat.
Ga in de Editor naar het Query Editor-paneel. Hier schrijven we onze queries om databases te maken, tabellen te bevragen en analyses uit te voeren.
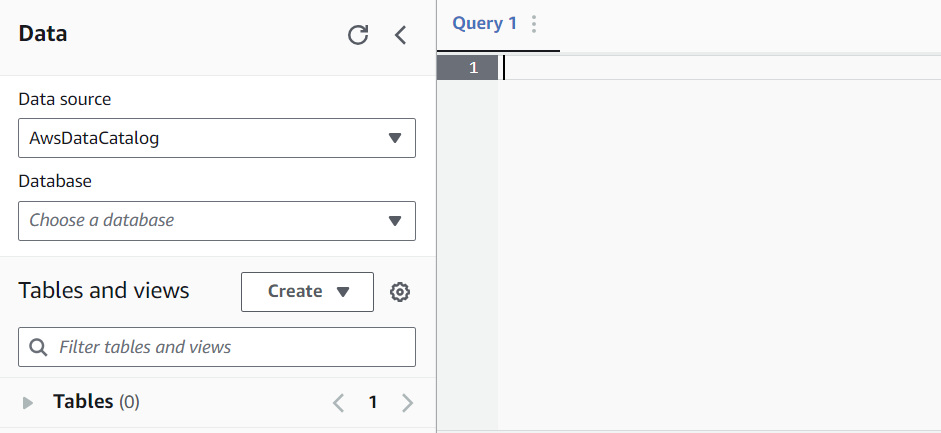
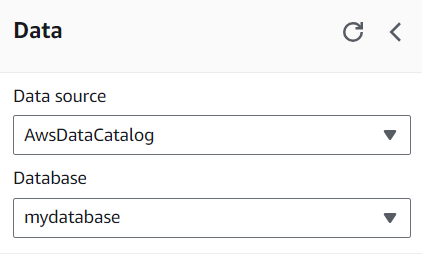
Om onze eerste database te maken, draaien we de volgende query:
CREATE DATABASE mydatabaseDoor deze query uit te voeren kun je in de linkerzijbalk onder “Database” een database selecteren.
Nu we een database hebben, richten we ons op het maken van een tabel zodat we iets kunnen bevragen!
Data in je database krijgen verschilt licht afhankelijk van je AWS-setup. Je kunt data gebruiken die is opgeslagen in een datawarehouse zoals Redshift of streaming data via AWS Kinesis en Lambda om tabellaire data te genereren.
Vandaag gebruiken we voorbeelddata uit voorbeeld-AWS CloudFront-logs. Vanwege de datacomplexiteit gebruikt een deel van het aanmaakproces RegEx-groepen om URL-data in kolommen te parseren.
Met de volgende SQL kunnen we een tabel maken. Let op: vervang hieronder “myregion” door je eigen AWS-regio.
CREATE EXTERNAL TABLE IF NOT EXISTS cloudfront_logs (
  Date DATE,
  Time STRING,
  Location STRING,
  Bytes INT,
  RequestIP STRING,
  Method STRING,
  Host STRING,
  Uri STRING,
  Status INT,
  Referrer STRING,
  os STRING,
  Browser STRING,
  BrowserVersion STRING
  )
  ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.RegexSerDe'
  WITH SERDEPROPERTIES (
  "input.regex" = "^(?!#)([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+([^ ]+)\\s+[^\(]+[\(]([^\;]+).*\%20([^\/]+)[\/](.*)
Als de tabel in de linkerzijbalk verschijnt, ben je klaar om te gaan bevragen!
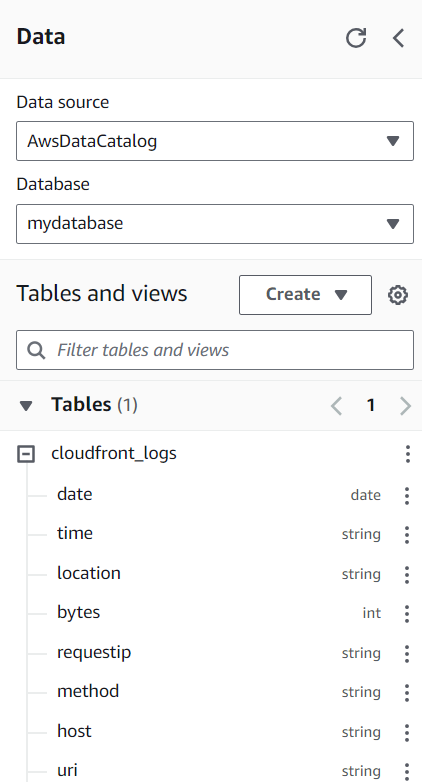
Queries schrijven in Athena lijkt op het schrijven van queries in traditionele SQL. Je schrijft en verstuurt de query naar Athena en de gewenste resultaten komen terug.
Een best practice is om je FROM-statements met de volgende syntax te schrijven: “DataSource”.“database”.“table”. Zo is er nooit onduidelijkheid over de herkomst van de data.
Laten we beginnen met een eenvoudige SELECT-instructie.
SELECT *
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
LIMIT 10
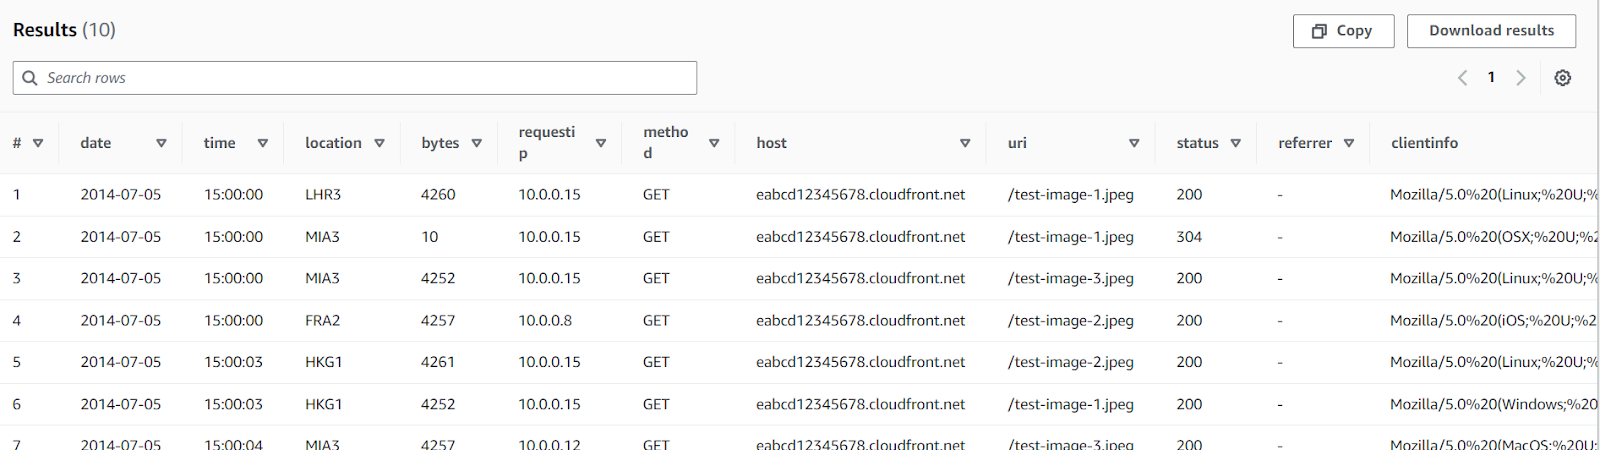
Dit zou een tabel met 10 resultaten moeten teruggeven. Athena laat je de resultaten kopiëren of downloaden. Tegelijkertijd worden deze resultaten opgeslagen in de S3-bucket die je aan je Athena-service hebt gekoppeld.
We kunnen zelfs eenvoudige GROUP BY-queries schrijven. Deze specifieke query laat zien hoeveel requestip (niet per se uniek) betrokken waren bij specifieke HTTP-methoden.
SELECT
   method,
   COUNT(requestip)
FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
GROUP BY 1
Een geweldige manier om Athena te benutten is voor complexere queries zoals windowfuncties. Dankzij Athena’s optimalisatie kunnen we ingewikkelde berekeningen sneller uitvoeren.
Zo kunnen we met Athena het ROW NUMBER() genereren voor elk record, gepartitioneerd op regio en datum en geordend op tijd aflopend. Vervolgens kunnen we met een WHERE-filter de meest recente rij per regio en datum selecteren door de eerste rij te pakken.
SELECT *
FROM (
   SELECT
      location,
      date,
      time,
      ROW_NUMBER() OVER(PARTITION BY location, date ORDER BY time DESC) row_num
   FROM "AwsDataCatalog"."mydatabase"."cloudfront_logs"
)
WHERE row_num = 1
Dit is nog maar het begin met Athena. Je kunt elke query schrijven waarvan je denkt dat die je helpt Athena’s mogelijkheden te benutten.
Net als elk ander dataverwerkingstool vereist AWS Athena een reeks best practices. Die maken je werk niet alleen makkelijker, maar verbeteren ook de prestaties.
Bovendien is AWS een cloudservice en worden kosten in rekening gebracht op basis van verschillende opslag- en rekenfactoren, dus deze praktijken kunnen tot aanzienlijke kostenbesparingen leiden!
Bepaalde dataformaten zijn handiger in AWS Athena. Omdat Athena uit een S3-bucket leest, levert een formaat dat gemakkelijk te lezen en gecomprimeerd is betere prestaties en lagere kosten op.
Ruwe data in CSV is misschien het meest eenvoudig, maar inefficiënt. Data opslaan in een gecomprimeerd formaat zoals Parquet of ORC bespaart kosten op het uitlezen van data.
Een extra voordeel van Parquet en ORC is kolomgebaseerde compressie. De optimizer van Athena kan daardoor alleen specifieke kolommen ophalen in plaats van de hele tabel te doorlopen voor berekeningen.
Partitioneren betekent een dataset regelmatig opsplitsen op basis van een bepaalde sleutel, zoals datum. We kunnen bijvoorbeeld dagelijkse partitions hebben waarbij de data automatisch per dag wordt gescheiden en opgeslagen.
Wanneer onze data is gepartitioneerd, kan de SQL-engine beter optimaliseren door alleen relevante partitions te bekijken. Dit vermindert direct de hoeveelheid gescande data en drukt de totale kosten.
Hoewel enige complexiteit bij data-analyse te verwachten is, kan het optimaliseren van queries de rekentijd en kosten verlagen. Een deel van de kosten komt niet direct van Athena, maar van andere services die AWS Athena gebruikt.
Het belangrijkste kostenonderdeel van Athena is het scannen en verwerken van data, maar je kunt ook kosten bij S3 krijgen als je enorme resultaten opslaat. We kunnen de prestaties verbeteren en kosten verlagen door queries te optimaliseren volgens de gebruikelijke SQL-best practices.
Bijvoorbeeld, het volgende helpt bij optimalisatie:
SELECT *LIMIT bij het testen van queriesDeze best practices verbeteren de prestaties en verlagen de kosten!
AWS Athena kan verbinden met Amazon CloudWatch om query-metrics op te slaan. Door de prestatielogs van queries te bekijken, kunnen we inefficiënte queries of problemen opsporen.
Zoals vermeld integreert AWS Athena met verschillende andere AWS-services, wat de mogelijkheden voor catalogiseren, visualiseren, verwerken en opslaan vergroot.
Hieronder hoe Athena samenwerkt met services zoals AWS Glue, Amazon QuickSight, AWS Lambda en Amazon Redshift.
Geïntegreerd met AWS Athena fungeert AWS Glue als centrale metadataopslag die data in Amazon S3 automatisch catalogiseert. Deze integratie elimineert handmatige schema-definities en stroomlijnt het bevragen van data in Athena.
Glue biedt ook ETL-mogelijkheden om data te transformeren en voor te bereiden voor optimale bevraging in Athena door taken zoals datacompressie, partitionering en formaatconversie te automatiseren, wat zorgt voor efficiënte en effectieve dataverwerking.
Amazon QuickSight integreert met AWS Athena om queryresultaten om te zetten in interactieve dashboards en rapporten. Dankzij deze koppeling kun je data direct uit Athena-queries visualiseren en snel visuele inzichten creëren.
QuickSight ondersteunt functies zoals automatische data-refreshes en geavanceerde analytics, waardoor het een krachtig hulpmiddel is om data te verkennen en te presenteren.
AWS Lambda automatiseert dataverwerkingsworkflows met Athena in een serverloze omgeving. Lambda-functies kunnen Athena-queries triggeren als reactie op events, zoals nieuwe data in S3, waardoor realtime verwerking mogelijk wordt.
Lambda kan ook vervolgacties automatiseren op basis van queryresultaten, waardoor schaalbare, eventgedreven workflows ontstaan zonder handmatig ingrijpen.
Hoewel Athena ideaal is voor ad-hoc bevraging van S3-data, biedt Amazon Redshift een robuuste oplossing voor gestructureerde en complexe analytics. Je kunt Athena gebruiken voor snelle analyses van ruwe data en Redshift voor intensievere, high-performance queries.
De integratie maakt databeweging tussen S3 en Redshift mogelijk, zodat je de sterke punten van beide services benut voor een complete analyticsoplossing.
AWS Athena is een krachtige query-engine die naadloos in het AWS-ecosysteem past. Door gebruikers snel toegang te geven tot data in S3-buckets en queryresultaten in S3 op te slaan, stelt AWS Athena je in staat flexibeler in je data te duiken. Het profiteert van andere AWS-services: serverless, schaalbaar en rechttoe rechtaan.
Wil je meer leren over AWS? DataCamp heeft verschillende bronnen:
Leer meer over AWS en data engineering met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

